


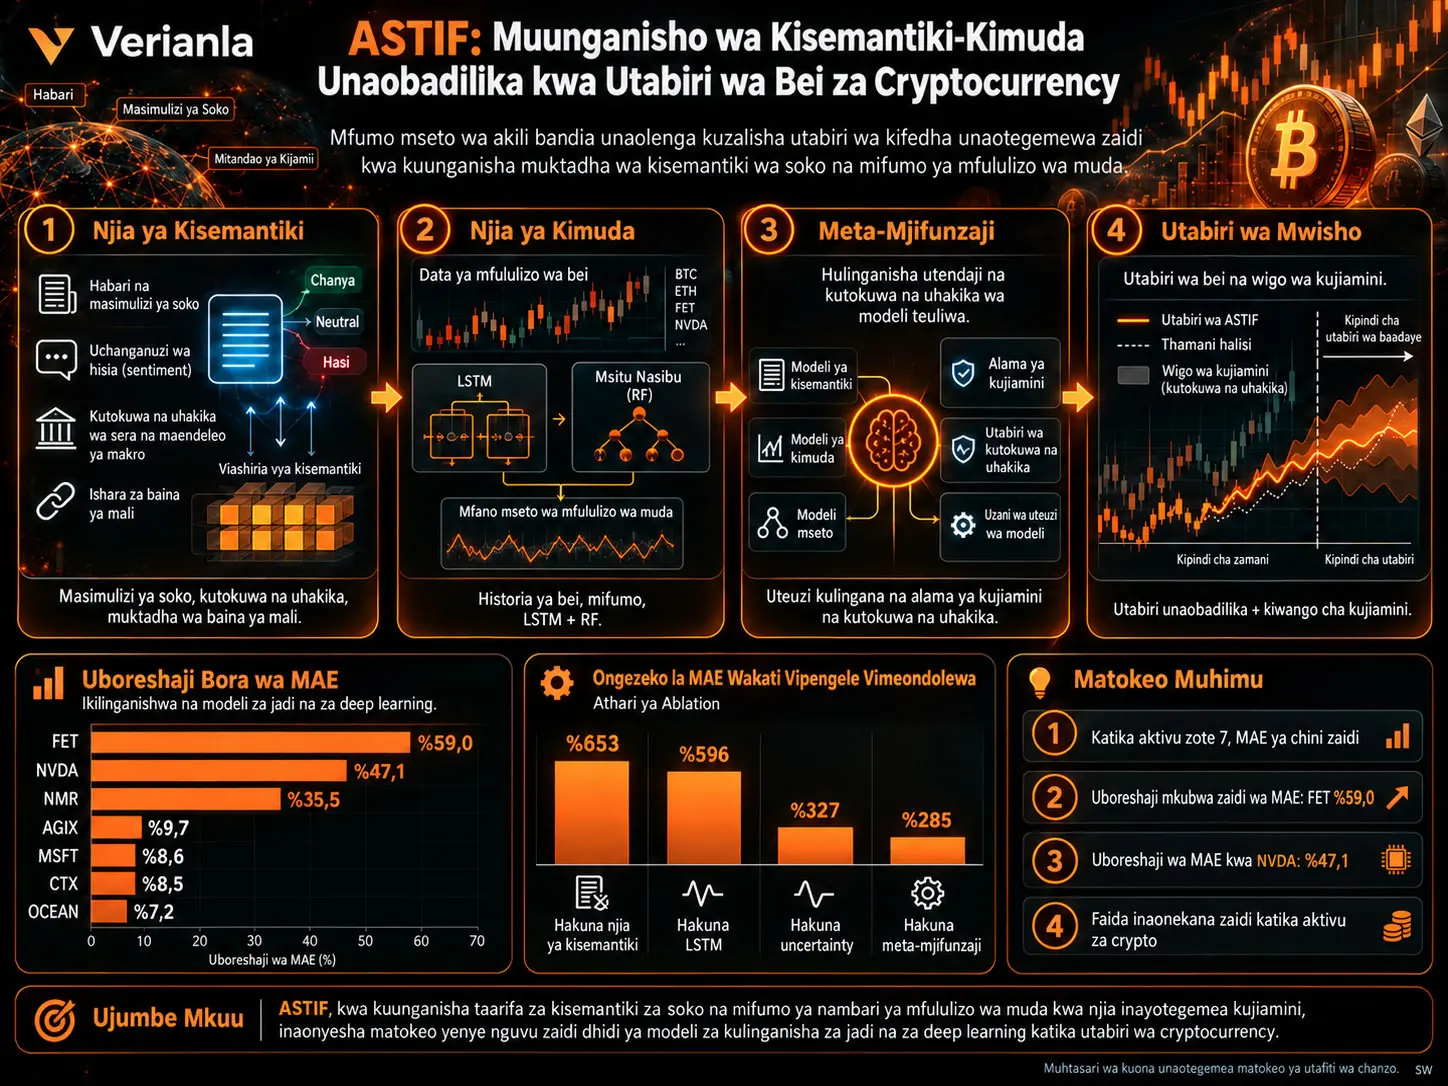
ASTIF — Adaptive Semantic-Temporal Integration Framework — ni usanifu wa kihierarkia wa utabiri wa kifedha unaochakata muktadha wa kisemantiki wa soko na mifumo ya mfululizo wa muda wa nambari katika njia tofauti za utabiri, kisha kufanya uchaguzi unaobadilika kati ya njia hizo kulingana na confidence na uncertainty ya utabiri. Utafiti unatokana na tatizo kwamba mienendo ya bei ya zamani pekee huenda isiwakilishe vya kutosha kutokuwa na uhakika wa kisera katika soko la cryptocurrency, simulizi za soko, viashiria vya sentiment na mahusiano ya cross-asset. ASTIF hushughulikia tatizo hili kwa vipengele vitatu: semantic predictor ya Small Language Model inayotegemea MirrorPrompt, temporal predictor ya mseto wa LSTM–Random Forest, na confidence-calibrated meta-learner inayotathmini uaminifu wa wataalamu hawa wawili.
Majaribio yalifanywa kwa data ya kila siku ya kipindi cha Januari 2020–Desemba 2024. Mali tano za crypto zinazohusishwa na AI — FET, AGIX, NMR, OCEAN na CTX — pamoja na hisa za NVIDIA na Microsoft zilitathminiwa. Ingizo la mfumo halijumuishi bei ya mali lengwa pekee; zaidi ya vipengele 29 vilitumika, vikijumuisha Bitcoin, Ethereum, sekta mbalimbali za token, fahirisi za hisa, ETF za mada, mafuta, dhahabu, cross-asset correlation, momentum, SMA/EMA, volatility, RSI, Bollinger Bands, Global Economic Policy Uncertainty na viashiria mbalimbali vya media/sentiment.
Kulingana na ulinganisho mkuu wa chanzo, ASTIF ilitoa MAE ya chini zaidi katika mali zote saba. Kupungua kwa MAE ikilinganishwa na baseline model bora kulikuwa %59,0 kwa FET, %47,1 kwa NVDA, %35,5 kwa NMR, %9,7 kwa AGIX, %8,6 kwa MSFT, %8,5 kwa CTX na %7,2 kwa OCEAN. Hata hivyo, ubora huu si sawa katika vipimo vyote vya makosa: katika Jedwali 1 ASTIF haitoi RMSE ya chini zaidi katika mali zote. Kwa hiyo matokeo hayapaswi kutafsiriwa kama “ASTIF ilishinda modeli zote katika metrics zote”.
Majaribio ya ablation yanaonyesha umuhimu wa semantic na temporal channels kufanya kazi pamoja. Katika hesabu ya ablation ya chanzo, wastani wa ongezeko la MAE uliripotiwa kuwa %653 wakati SLM semantic channel iliondolewa, %596 wakati kipengele cha LSTM kiliondolewa, %327 wakati uncertainty quantification iliondolewa na %285 wakati adaptive meta-learner iliondolewa. Hata hivyo, baseline values za NMR na FET katika sehemu hii ya ablation ni tofauti na ASTIF values katika jedwali kuu la performance; chanzo hakisawazishi wazi contexts hizi mbili za majaribio.
Utafiti si mfumo wa real-time cryptocurrency trading wala jaribio la mkakati wa uwekezaji. Hakuna tathmini iliyofanywa ya transaction cost, spread, slippage, portfolio return, Sharpe ratio, maximum drawdown au real-money P&L. Zaidi ya hayo, data iliyotumika ni historical daily data na chanzo kinaeleza wazi kama limitation kwamba real-time data feed na breaking-news information hazikujumuishwa katika mfumo.
ASTIF ni Nini na Inatofautianaje na Modeli Tuli za Utabiri wa Kifedha?
ASTIF ni usanifu wa ensemble unaobadilika unaounganisha Small Language Model channel inayochakata semantic market information na LSTM–Random Forest channel inayochakata mifumo ya kihistoria ya nambari katika mfumo mmoja wa utabiri, na kuamua kwa confidence-calibrated meta-learning ni channel ipi inayoaminika zaidi wakati huo. Tofauti yake kuu na static ensembles ni kwamba badala ya kutoa uzito usiobadilika uliowekwa mapema kwa wataalamu wawili, hutathmini confidence ya utabiri, uncertainty, model disagreement na market context kama meta-feature katika kila hatua ya uamuzi.
Tatizo ambalo utafiti unajaribu kutatua
Katika masoko ya cryptocurrency, mchakato wa uundaji wa bei si stationary. Tabia ya soko, kiwango cha volatility, hali za macroeconomic, maendeleo ya regulatory, mahusiano ya cross-asset na tabia za wawekezaji vinaweza kubadilika kadiri muda unavyopita. Kwa hiyo, hakuna uhakika kwamba aina ya utabiri iliyofanikiwa katika kipindi fulani itakuwa na mafanikio sawa katika market regime tofauti.
Kulingana na chanzo, mapengo matatu makuu yanajitokeza katika mbinu zilizopo. Kwanza, modeli nyingi za statistical, deep learning na Transformer hutumia static architectures ambazo hazibadilishi prediction strategy kulingana na market regime. Pili, semantic market information katika mifumo mingi ya hybrid huongezwa katika price inputs kama numerical feature moja tu, kama sentiment score. Tatu, cross-modal adaptation mechanisms zinazolinganishwa real-time reliability ya semantic na temporal predictors na kuamua ipi iaminiwe ni chache.
Maswali matatu ya utafiti
| Swali la utafiti | Jambo lililochunguzwa |
|---|---|
| RQ1 | ASTIF inafanyaje kwa usahihi na uthabiti wa utabiri ikilinganishwa na baseline za traditional machine learning, deep learning na Transformer? |
| RQ2 | Vipengele vinavyobadilika kama Confidence-based meta-learner na uncertainty quantification vinachangia kwa kiwango gani performance ya jumla? |
| RQ3 | Je, dual-channel semantic encoding hutoa matokeo bora kuliko numeric-only au semantic-only approaches? |
Vipengele vitatu vya msingi vya ASTIF
| Kipengele | Kazi kuu | Matokeo |
|---|---|---|
| MirrorPrompt SLM | Huchakata mlolongo wa bei katika numeric channel na market context katika semantic channel. | SLM prediction, confidence na uncertainty. |
| LSTM–Random Forest Temporal Learner | Hujifunza temporal dependencies na feature interactions. | ML prediction, uncertainty inayotegemea model disagreement na confidence. |
| Confidence-Calibrated Meta-Learner | Hutathmini wataalamu wote wawili kulingana na confidence, uncertainty na market context. | Uchaguzi wa SLM au ML channel na utabiri wa mwisho. |
Tatizo la utabiri wa kifedha linaformuliwaje?
Utafiti unashughulikia daily multi-asset time series chini ya regime shifts na heteroskedastic noise. \(X_t\) inaonyesha cross-asset signals, sentiment indicators na technical features wakati \(t\); \(p_t\) inaonyesha normalized target closing price.
\[ \hat{f}=\arg\min_f \mathbb{E}_{(X_t,p_t)\sim P_t} \left[ \ell\left(p_{t+1},f(X_{1:t},p_{1:t})\right) \right] \]
Hapa lengo ni kupunguza expected loss katika utabiri wa bei ya siku inayofuata chini ya \(P_t\), ambapo distribution inaweza kubadilika kadiri muda unavyopita. \(\ell\) inawakilisha absolute au squared error loss. Formula inaeleza kwa hisabati kwamba mfumo unalenga kutabiri si katika fixed data distribution pekee bali pia katika hali za soko zinazobadilika.
Ulimwengu wa data
| Kundi | Mifano ya mali / feature |
|---|---|
| Malengo ya crypto yanayohusishwa na AI | FET, AGIX, NMR, OCEAN, CTX |
| Malengo ya hisa za teknolojia | NVDA, MSFT |
| Soko kuu la crypto | BTC, ETH |
| Sekta za token | DeFi, NFT, Energy, Gold, Healthcare, Asset Management, Lending & Borrowing |
| Muktadha wa hisa/fahirisi | S&P, NASDAQ AI & Robotics, NASDAQ Internet, Dow Jones Basic Materials, Dow Jones Oil & Gas |
| Bidhaa | Mafuta ghafi, dhahabu |
| ETF za mada | Clean Energy, Robotics & AI, ROBO, Fintech Global ETF |
| Semantic/policy variables | Panic Index, Media Hype Index, Media Coverage Index, Fake News Index, Infodemic Index, GEPU |
Inaelezwa kwamba bei za cryptocurrency zilitoka CoinMarketCap, data ya mafuta kutoka Energy Information Administration na data mbalimbali za equity/index/ETF kutoka vyanzo vya Thomson Reuters.
Feature engineering
Variables zote huscale kwa mbinu ya Min-Max hadi range ya \([0,1]\):
\[ x_i'= \frac{x_i-\min(X)} {\max(X)-\min(X)} \]
Transformation hii huleta financial variables zenye scales tofauti katika numerical range moja. Hata hivyo, chanzo hakielezi kwa sentensi wazi kama values za \(\min(X)\) na \(\max(X)\) zilihesabiwa kutoka training set pekee. Ingawa utafiti unaeleza chronological split na lengo la kuepuka leakage, maelezo ya scaler fitting yangeweza kuripotiwa wazi zaidi kwa reproducibility.
Miongoni mwa technical features kuna momentum kwa lags tofauti:
\[ M_{t,k}= \frac{p_t-p_{t-k}}{p_{t-k}}, \qquad k\in\{1,2,3,5,7\} \]
SMA, EMA, rolling volatility, RSI, Bollinger Bands na rolling cross-asset correlation zinajumuishwa. Cross-asset correlation inaelezwa kama:
\[ \rho_{i,j}(t) = \operatorname{corr} \left( p_{i,t-w:t}, p_{j,t-w:t} \right) \]
.
MirrorPrompt ni Nini na Njia Mbili Zinatenganisha Nini?
MirrorPrompt ni muundo wa semantic predictor unaowasilisha hali ileile ya soko kwa Small Language Model kupitia representations mbili tofauti: numeric channel huhifadhi mlolongo wa bei za karibuni kama high-precision numerical representation, huku semantic channel ikizalisha natural-language context kutoka momentum, volatility, cross-asset indicators na sentiment/policy variables; hivyo quantitative pattern na contextual interpretation huchakatwa bila kupunguzwa kuwa raw feature vector moja.
Numeric channel
Numeric channel huwasilisha historical price sequence:
\[ n_t = [p_{t-w+1},p_{t-w+2},...,p_t] \]
katika muundo huu na kwa usahihi wa decimal places sita. Katika sehemu ya implementation, imeelezwa kuwa \(w=8\) historical prices zilitumika kwa MirrorPrompt.
Semantic channel
Semantic channel huzalisha context:
\[ S(c_t) = f_{\mathrm{template}} (\Delta p_t,\sigma_t,I_t,S_t) \]
kwa muundo huu. Hapa \(\Delta p_t\) inawakilisha price change, \(\sigma_t\) volatility, \(I_t\) cross-asset indicators na \(S_t\) sentiment/policy features.
Kuna tofauti muhimu: mfumo hausomi moja kwa moja breaking-news texts au live news stream. Semantic channel katika chanzo hubadilisha structured market na sentiment indicators kuwa template-driven natural-language descriptions.
Madirisha matatu yanayoingiliana na confidence-weighted prediction
MirrorPrompt huzalisha \(K=3\) overlapping windows. Kila window hutoa return prediction \(\hat r_k\) na confidence \(c_k\). Small Language Model huendeshwa kwa deterministic sampling, yaani kwa temperature \(\tau=0\).
\[ \hat r_{\mathrm{SLM}} = \frac{\sum_{k=1}^{K} c_k\hat r_k} {\sum_{k=1}^{K}c_k} \]
\[ c_{\mathrm{SLM}} = \frac{1}{K} \sum_{k=1}^{K}c_k \]
\[ u_{\mathrm{SLM}} = 1-\min(c_{\mathrm{SLM}},1) \]
Kwa hiyo return prediction ya window yenye confidence ya juu hupata uzito mkubwa katika ensemble result; uncertainty huhamishwa kwa meta-learner kama complement ya confidence.
Maelezo ya implementation ya SLM
Katika majaribio, Gemma-3-1b-it ilitumika kama Small Language Model kupitia LM Studio API. Response timeout iliripotiwa kuwa sekunde 30, default max_tokens=150, 600 kwa reasoning models, na temperature 0.
LSTM–Random Forest temporal predictor
Temporal channel huunganisha model families mbili tofauti. LSTM huchakata long na short dependencies katika historical sequence, huku Random Forest ikijaribu kunasa nonlinear interactions kati ya features.
LSTM ina layers tatu:
64 → 32 → 16 units
na hutumia sequence length \(L=10\), dropout 0,2, batch normalization, Adam optimizer na learning rate 0,001.
Operesheni kuu za LSTM cell zimewasilishwa katika chanzo kwa mfululizo huu:
\[ f_t=\sigma(W_f[h_{t-1},x_t]+b_f) \]
\[ i_t=\sigma(W_i[h_{t-1},x_t]+b_i) \]
\[ \tilde C_t= \tanh(W_C[h_{t-1},x_t]+b_C) \]
\[ C_t=f_t\odot C_{t-1}+i_t\odot\tilde C_t \]
\[ o_t=\sigma(W_o[h_{t-1},x_t]+b_o), \qquad h_t=o_t\odot\tanh(C_t) \]
Random Forest channel hutumia 100 tree. Chanzo kinatoa maximum depth kama 20 na kinalenga kupunguza overfitting kwa minimum-sample constraints.
Final temporal prediction katika implementation section ni fixed LSTM–RF mixture:
\[ \hat y^{ML} = 0.7\hat y^{LSTM} + 0.3\hat y^{RF} \]
.
Uncertainty ya temporal channel
Relative disagreement kati ya modeli mbili huhesabiwa kwa:
\[ u_{ML,t} = \frac{ |\hat y_{t+1}^{LSTM}-\hat y_{t+1}^{RF}| }{ \max( \hat y_{t+1}^{LSTM}, \hat y_{t+1}^{RF} ) } \]
Kisha:
\[ c_{ML,t}=1-u_{ML,t} \]
hutumika kupata confidence. Mbinu hii inategemea mantiki ya kutoa confidence ya juu wakati temporal models mbili zinakaribia matokeo yale yale, na confidence ya chini zinapotofautiana zaidi.
Meta-learner inaangalia nini?
Meta-learner ni Random Forest classifier inayofanya kazi juu ya \(z_t\) feature vector yenye vipimo 12. Meta-feature kuu zilizotolewa katika chanzo ni: confidence values za channels mbili, uncertainty values, relative difference kati ya predictions, tofauti za confidence na uncertainty, volatility, trend strength, recent model accuracy values na price momentum.
Meta-classifier hutumia 20 estimator na maximum depth 5. Chanzo pia kinataja minimum-sample constraints na temporal validation.
Meta-selection
Meta-selector hufafanuliwa kama:
\[ \delta(z_t)\in\{\mathrm{SLM},\mathrm{ML}\} \]
na huchagua prediction channel itakayotumika.
Relative disagreement ya channels mbili hupimwa kwa:
\[ d_t= \frac{ |\hat y_{t+1}^{SLM}-\hat y_{t+1}^{ML}| }{ \max( \hat y_{t+1}^{SLM}, \hat y_{t+1}^{ML} ) } \]
.
Confidence calibration
Chanzo huscale upya raw probability ya meta-classifier kulingana na average channel confidence:
\[ p_{\mathrm{cal}}= \begin{cases} 0.4+0.2(p_{\mathrm{raw}}-0.5), & \bar c<0.6\\ 0.3+0.4p_{\mathrm{raw}}, & 0.6\leq \bar c<0.8\\ 0.2+0.6p_{\mathrm{raw}}, & \bar c\geq0.8 \end{cases} \]
Hapa:
\[ \bar c= \frac{c_{SLM}+c_{ML}}{2} \]
na calibrated confidence hufungwa kwa kiwango cha juu cha 0,85. Kikomo hiki ni source-defined safety mechanism inayolenga kuzuia meta-learner kuwa overconfident hasa katika volatile conditions.
Sanity check
Final prediction lazima ibaki ndani ya normalized domain \([0,1]\). Pia single-step relative change inapaswa kutimiza:
\[ \frac{|\hat y_i-p_t|}{p_t}\leq\tau_{\max} \]
na katika chanzo:
\[ \tau_{\max}=0.5 \]
imetolewa. Prediction ikikiuka mipaka hii, mfumo unaweza kuhamia alternative model au kutumia conservative prediction capping.
Mbinu na Matokeo ya Utafiti
Mpangilio wa mafunzo na tathmini
| Kipengele | Thamani iliyotolewa katika chanzo |
|---|---|
| Kipindi cha data | Januari 2020 – Desemba 2024 |
| Marudio | Kila siku |
| Mgawanyo wa data wa jumla | %80 training, %20 test |
| Internal validation | %10 ya mwisho ya training section |
| Meta-learner anti-overfitting holdout | %30 temporal holdout katika maelezo tofauti ya mbinu ya chanzo |
| SLM | Gemma-3-1b-it |
| MirrorPrompt price window | w = 8 |
| MirrorPrompt ensemble | K = 3 windows |
| SLM temperature | 0 |
| LSTM structure | 64 → 32 → 16 |
| LSTM sequence length | L = 10 |
| Dropout | 0,2 |
| Optimizer | Adam |
| Learning rate | 0,001 |
| Batch size | 32 |
| Early stopping | 15 kwa Cross-validation, 25 epoch patience kwa final training |
| Temporal Random Forest | 100 tree, max depth 20 |
| Meta Random Forest | 20 estimator, max depth 5 |
| ML mixture | 0,7 LSTM + 0,3 RF |
| Maximum calibrated confidence | 0,85 |
| Single-step relative change limit | 0,5 |
Chanzo hakielezi vya kutosha jinsi %30 meta-learning temporal holdout na internal validation iliyotengwa kwa %10 ya mwisho ya training section zilivyotumika kwa uhusiano wa ndani kwa ndani. Kwa hiyo hazipaswi kuunganishwa kana kwamba ni uwiano mmoja.
LSTM training loss
\[ L_{LSTM} = \frac{1}{N} \sum_{i=1}^{N} (y_i-\hat y_{LSTM,i})^2 \]
Mean Squared Error loss hii huiwezesha LSTM kupunguza squared difference kati ya predicted na actual normalized price.
Lengo la training la Meta-learner
Ground-truth label ya Meta-learner huundwa kulingana na ni mtaalamu gani alitoa error ya chini katika validation data. Kwa Meta-classifier, chanzo hutumia cross-entropy kwa muundo:
\[ L_{meta} = -\frac{1}{T} \sum_{t=1}^{T} \left[ y_t^{SLM}\log P(SLM|z_t) + y_t^{ML}\log P(ML|z_t) \right] \]
.
\(y_t^{SLM}=1\) hutumika wakati SLM inatoa error ya chini katika hatua husika; \(y_t^{ML}=1-y_t^{SLM}\) hutumika wakati temporal model inafanya vizuri zaidi.
Metrics za tathmini
MAE:
\[ MAE= \frac{1}{n} \sum_{i=1}^{n} |y_i-\hat y_i| \]
RMSE:
\[ RMSE= \sqrt{ \frac{1}{n} \sum_{i=1}^{n} (y_i-\hat y_i)^2 } \]
na coefficient of determination:
\[ R^2= 1- \frac{ \sum_{i=1}^{n}(y_i-\hat y_i)^2 }{ \sum_{i=1}^{n}(y_i-\bar y)^2 } \]
hutumika. Chanzo pia kinaeleza kuwa reliability diagram na bin-based calibration error evaluation zilitumika kwa confidence calibration.
Baseline models zilizolinganishwa
| Model family | Modeli |
|---|---|
| Traditional machine learning | DTC, RFC, AdaBoost, SVM |
| Deep learning | LSTM, CNN-LSTM |
| Transformer | Standard Transformer, Informer, TFT |
| Mfumo uliopendekezwa | ASTIF |
Matokeo ya MAE na RMSE katika mali saba
| Mali | ASTIF MAE | ASTIF RMSE | Baseline MAE bora | Uboreshaji wa MAE |
|---|---|---|---|---|
| CTX | 0,0226 | 0,0576 | 0,0247 — LSTM | %8,5 |
| FET | 0,0133 | 0,0521 | 0,0324 — Informer | %59,0 |
| NMR | 0,0158 | 0,0305 | 0,0245 — Informer | %35,5 |
| OCEAN | 0,0168 | 0,0421 | 0,0181 — Informer | %7,2 |
| AGIX | 0,0213 | 0,0558 | 0,0236 — Informer | %9,7 |
| MSFT | 0,0222 | 0,0440 | 0,0243 — LSTM | %8,6 |
| NVDA | 0,0073 | 0,0130 | 0,0138 — Informer | %47,1 |
ASTIF kutoa MAE ya chini zaidi katika mali zote saba ndiyo matokeo yaliyo wazi zaidi ya ulinganisho katika utafiti. Faida kubwa zaidi ya kulinganisha iliripotiwa kwa FET, ya pili kwa NVDA, na ndogo zaidi kwa OCEAN.
Je, Ubora wa ASTIF Unatumika katika Vipimo Vyote vya Makosa?
Hapana. Ingawa chanzo kinatafsiri ASTIF kwa ujumla kuwa bora kuliko baseline zote, values za kina za Jedwali 1 zinaonyesha kuwa ASTIF ilitoa MAE ya chini zaidi katika mali zote saba, lakini RMSE ya chini zaidi katika NMR, MSFT na NVDA pekee; katika CTX LSTM ina RMSE ya chini, katika FET Informer/TFT, na katika OCEAN na AGIX Informer. Kwa hiyo hitimisho imara zaidi ni ubora wa MAE; “ubora wa moja kwa moja katika vipimo vyote” hauungwi mkono na jedwali la chanzo.
Tofauti ya kiwango cha mali kwa RMSE
| Mali | Modeli yenye RMSE ya chini zaidi | RMSE ya chini zaidi | ASTIF RMSE |
|---|---|---|---|
| CTX | LSTM | 0,0422 | 0,0576 |
| FET | Informer / TFT | 0,0447 | 0,0521 |
| NMR | ASTIF | 0,0305 | 0,0305 |
| OCEAN | Informer | 0,0256 | 0,0421 |
| AGIX | Informer | 0,0378 | 0,0558 |
| MSFT | ASTIF | 0,0440 | 0,0440 |
| NVDA | ASTIF | 0,0130 | 0,0130 |
Tofauti hii pia inaonyesha kuwa MAE na RMSE ni nyeti kwa sifa tofauti za error. Kwa sababu RMSE husquare errors kubwa, hutoa uzito mkubwa zaidi kwa idadi ndogo ya prediction deviations kubwa kuliko MAE.
Performance inayoonyeshwa na figures za chanzo
Kielelezo 3 cha chanzo kinaonyesha MAE values za ASTIF katika mali saba kando ya baseline bora, na tofauti katika FET na NVDA zinaonekana hasa. Kielelezo 4 kinaonyesha average MAE, R², error distribution na model comparison katika baadhi ya mali kwa panels nne. Kielelezo 5 kinalinganisha actual na predicted price trajectory lines kwa NMR, CTX, MSFT na NVDA.
Ukaribu wa kuona wa lines hizi si ushahidi wa trading profitability peke yake. Vilevile, low normalized price error si sawa na direction accuracy au risk-adjusted return; chanzo hakikufanya trading backtest ya aina hiyo.
Ablation: ni kipengele gani muhimu kwa kiwango gani?
| Configuration | Kipengele kilichoondolewa | NMR MAE | NMR RMSE | FET MAE | FET RMSE |
|---|---|---|---|---|---|
| ASTIF Baseline | Hakuna | 0,0109 | 0,0180 | 0,0146 | 0,0298 |
| Pure Machine Learning | SLM Channel | 0,0703 | 0,0881 | 0,1252 | 0,2459 |
| Non-Sequential ML | LSTM Modeling | 0,0618 | 0,0791 | 0,1201 | 0,2308 |
| Deterministic Framework | Uncertainty | 0,0420 | 0,0649 | 0,0682 | 0,1726 |
| Static Ensemble | Meta-Learner | 0,0367 | 0,0462 | 0,0629 | 0,1240 |
Katika hesabu ya wastani ya ongezeko ya chanzo, MAE huongezeka %653 semantic SLM channel ikiondolewa, %596 LSTM ikiondolewa, %327 uncertainty mechanism ikiondolewa na %285 meta-learner ikiondolewa.
Hata hivyo, ASTIF baseline values katika ablation table hii si sawa na NMR na FET ASTIF values katika performance Jedwali 1 kuu. Kwa kuwa chanzo hakielezi tofauti hii wazi, majedwali yanapaswa kushughulikiwa kama contexts tofauti za majaribio.
Je, Dual-channel encoding inachangia kweli?
Chanzo kinaripoti MAE 0,0133 kwa full dual-channel structure katika representative volatile crypto asset. Kwa numeric-only structure, MAE ni 0,0325, na kwa semantic-only structure ni 0,0378. Kulingana na hesabu ya chanzo, dual-channel approach hutoa maboresho ya takriban %59,0 na %64,7 mtawalia.
Katika asset ya pili ya tathmini, faida ya dual-channel inaelezwa kuwa ndogo zaidi: %3,4 ikilinganishwa na numeric-only approach na %14,9 ikilinganishwa na semantic-only approach.
Cross-asset context
Cross-asset expanded feature configuration ilitoa MAE 0,0278 na 0,0292 katika crypto assets mbili zilizochunguzwa; maboresho ya %15,5 na %9,6 yaliripotiwa ikilinganishwa na basic semantic configuration. Volatility–momentum features pia ziliripotiwa kuchangia, huku sentiment na market indicator features zikitoa faida ndogo lakini inayoweza kupimwa.
Temporal window sensitivity
Katika sensitivity analysis, chanzo kinaripoti window size 8 kama balance bora ya accuracy–efficiency. Window size 12 ilipotumika, FET MAE iliongezeka %47,3 na NMR MAE %42,0. Waandishi wanatafsiri hili kama overfitting behavior.
Pia imeelezwa kwamba two-model ensemble ilitoa maboresho ya MAE ya %5,3 na %4,3 kwa FET na NMR mtawalia ikilinganishwa na single-model structure; hitimisho likiwa kwamba complex ensemble structures si lazima ziwe bora zaidi.
Confidence distribution inaeleza nini?
Kielelezo 6 cha chanzo kinaonyesha confidence distributions za semantic na temporal channels. Semantic confidence distribution kwa ujumla imehamia kwenye higher-confidence region, huku temporal confidence ikijikita katika values za chini. Waandishi wanatafsiri kuwa meta-learner confidence huongezeka wakati channels mbili zinakaribiana; uncertainty huongezeka channels zinapotofautiana.
Matokeo haya hayamaanishi kwamba confidence values hupima risk yote ya soko halisi. Hizi ni indicators za uncertainty ndani ya prediction structure na calibration mechanism ya modeli yenyewe.
Hitimisho zinazoungwa mkono na utafiti
- ASTIF ilitoa error ya chini kuliko baseline zilizolinganishwa katika mali zote saba kwa kipimo cha MAE cha Jedwali 1.
- Faida ya MAE inabadilika kutoka %7,2 hadi %59,0 kulingana na mali.
- Kuondoa vipengele vya Semantic SLM, temporal LSTM, uncertainty quantification na meta-learning kulipunguza performance katika ablation conditions.
- Dual-channel encoding ilitoa matokeo bora kuliko single-channel structures katika majaribio ya chanzo.
- Cross-asset features na temporal context ya ukubwa wa kati ziliboresha accuracy katika baadhi ya majaribio.
- Confidence-aware model selection ilitoa mechanism mbadala kwa kuunganisha semantic na temporal experts kwa static weight moja katika majaribio ya chanzo.
Hitimisho ambazo utafiti hauungi mkono
Utafiti hauonyeshi kwamba ASTIF ndiyo modeli bora katika masoko yote ya kifedha au crypto assets zote. Test universe imezuiliwa kwa tokens tano zinazohusishwa na AI na hisa mbili za teknolojia.
Utafiti haukufanya real-money trading strategy, transaction cost, spread, slippage, order-book impact, Sharpe ratio, Sortino ratio, maximum drawdown au portfolio P&L test. Kwa hiyo haiwezi kusemwa kwamba low MAE ina maana moja kwa moja ya profitable trading strategy.
Utafiti si mfumo wa multi-step forecasting; kazi kuu ni next-step prediction. Multi-step forecasting imeelezwa katika chanzo kama eneo la future research.
Mfumo hautumii real-time news stream. Chanzo kinaeleza wazi kuwa historical data ilitumika na kwamba breaking news / real-time feed integration haipo.
Chanzo hakiungi mkono matokeo kwa p-values, confidence interval au multi random-seed performance distributions. Kwa hiyo hakuna hukumu ya nje ya chanzo inayoweza kutolewa kuhusu inferential statistical significance ya tofauti za baseline.
Mapungufu
| Kizuizi | Athari kwa tafsiri ya matokeo |
|---|---|
| Prompt engineering inahitaji domain expertise | Performance ya Semantic channel inaweza kuwa nyeti kwa prompt design. |
| Computational load | Real-time use inaweza kuwa ngumu katika resource-constrained environments. |
| Limited asset universe | Generalization kwa token mpya na alternative asset class haijaonyeshwa moja kwa moja. |
| Historical data | Tabia katika live market feed na breaking-news conditions haijajaribiwa. |
| Next-step forecast | Long multi-step horizon performance haijulikani. |
| Baseline difference kati ya majedwali makuu | Main benchmark na ablation baseline values za NMR na FET hazipaswi kuunganishwa moja kwa moja. |
| Maelezo ya validation ratios | Reproduction ya uhusiano kati ya %30 meta holdout na %10 internal validation ndani ya global split inahitaji maelezo ya ziada. |
| Hakuna inferential significance report | Chanzo hakijaonyesha significance ya model differences katika kiwango cha p-value au confidence interval. |
Mielekeo ya utafiti wa baadaye
Chanzo kinapendekeza future real-time data integration, automated prompt optimization kwa reinforcement learning, multi-step forecasting, broader asset class evaluation na edge computing optimization.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: ASTIF: Adaptive Semantic-Temporal Integration for Cryptocurrency Price Forecasting
Waandishi: Hafiz Saif Ur Rehman, Ling Liu, Kaleem Ullah Qasim
Corresponding author: Ling Liu
Taasisi: Southwestern University of Finance and Economics, Chengdu, Sichuan, China; Southwest Jiaotong University, Chengdu, Sichuan, China.
Aina ya chanzo: arXiv preprint.
arXiv: 2512.18661v1
Kategoria ya arXiv: cs.AI
Tarehe ya toleo la kwanza: 21 Desemba 2025.
Hali ya peer review: Kwa kuwa hakuna verified peer-reviewed journal publication iliyopatikana, imechukuliwa kama preprint.
Taarifa ya jarida: Katika manuscript text iliyochakatwa na ArXiv, field “journal: Nuclear Physics B” inaonekana; hata hivyo, kwa kuwa hakuna verified Nuclear Physics B publication record au independent journal DOI iliyopatikana kwa kichwa hiki, kauli hii haikutumika kama publication status.
DOI: Hakuna verified independent journal DOI. Inatambulika kupitia arXiv record 2512.18661.
Kipindi cha data: Januari 2020 – Desemba 2024.
Mali lengwa: FET, AGIX, NMR, OCEAN, CTX, MSFT, NVDA.
Modeli kuu: MirrorPrompt SLM + LSTM–Random Forest temporal learner + confidence-calibrated Random Forest meta-learner.
SLM: Gemma-3-1b-it, LM Studio API.
Metrics kuu za tathmini: MAE, RMSE, R² na calibration error.
Upatikanaji wa data: Hakuna Data Availability Statement tofauti au verified public dataset repository link katika PDF iliyotolewa.
Upatikanaji wa code: Hakuna verified GitHub au code repository link katika PDF iliyotolewa.
Ufadhili: Hakuna funding statement tofauti iliyogunduliwa katika PDF iliyotolewa.
Mgongano wa maslahi: Hakuna conflict-of-interest statement tofauti iliyogunduliwa katika PDF iliyotolewa.
Michango ya waandishi: Hakuna CRediT/author contributions statement tofauti iliyogunduliwa.
Leseni: Kwa kuwa open reuse license haikuweza kutambuliwa kwa kuaminika katika PDF iliyotolewa na primary bibliographic record iliyothibitishwa, license haikudhaniwa kuwepo. Source figures hazipaswi kunakiliwa moja kwa moja; numerical data na scientific relationships zinapaswa kuchorwa upya kwa kujitegemea kwa Verianla.
Maelezo ya tafsiri ndani ya chanzo: Jedwali 1 linaonyesha kwamba ASTIF ilitoa MAE ya chini zaidi katika targets zote lakini haikutoa RMSE ya chini zaidi katika targets zote. Kwa hiyo kauli ya jumla ya “outperforms all baselines” katika maelezo ya chanzo inapaswa kutafsiriwa kwa usalama zaidi katika context ya MAE na aggregate evaluation iliyowasilishwa katika chanzo.
Maelezo ya reproducibility ndani ya chanzo: NMR/FET ASTIF baseline values katika Jedwali 1 na Table 3 ni tofauti. Pia, application relationship kati ya %30 temporal holdout iliyotolewa kwa meta-learner na %10 internal validation ya mwisho ndani ya global %80/%20 split haijaelezwa kikamilifu katika chanzo.
Mpaka mkuu wa mbinu: Utafiti huu unapima next-step forecast performance kwenye historical daily data. Real-time news stream, live trading, transaction costs na real-money portfolio performance ziko nje ya experimental scope ya utafiti.
Hakimiliki/mbinu ya uwasilishaji: Maandishi ya Verianla hayazalishi upya sentensi au figure designs za utafiti chanzo. Mbinu, mathematics, experimental parameters, table values na result boundaries zimetolewa kutoka utafiti chanzo na kupangwa upya ndani ya independent educational Kiswahili structure.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *