


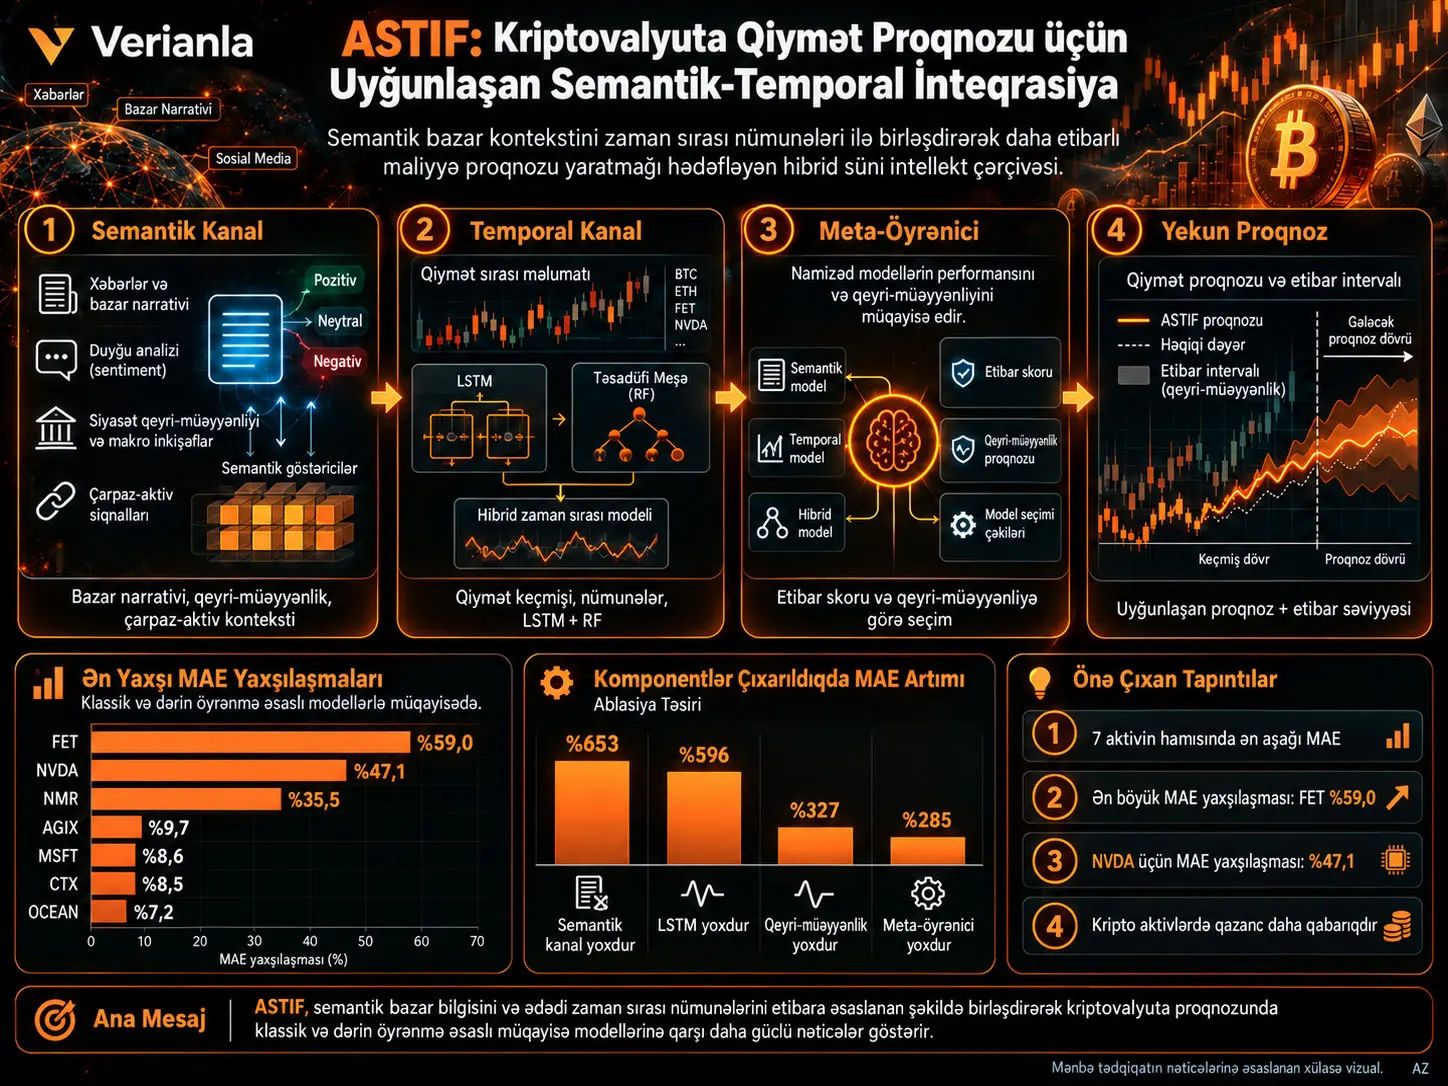
ASTIF — Adaptive Semantic-Temporal Integration Framework — semantik bazar kontekstini və ədədi zaman sırası nümunələrini ayrı proqnoz kanallarında emal edən, daha sonra proqnoz etibarı və qeyri-müəyyənliyinə əsasən bu kanallar arasında uyğunlaşan seçim edən iyerarxik maliyyə proqnozlaşdırma arxitekturasıdır. Tədqiqat yalnız keçmiş qiymət hərəkətlərinin kriptovalyuta bazarındakı siyasət qeyri-müəyyənliyini, bazar narrativlərini, sentiment göstəricilərini və çarpaz-aktiv əlaqələrini kifayət qədər təmsil etməyə bilməsi problemindən çıxış edir. ASTIF bu problemi üç komponentlə həll edir: MirrorPrompt əsaslı Small Language Model semantik proqnozlaşdırıcı, LSTM–Random Forest hibrid temporal proqnozlaşdırıcı və bu iki ekspertin etibarlılığını qiymətləndirən confidence-calibrated meta-learner.
Təcrübələr Yanvar 2020–Dekabr 2024 dövrünün gündəlik məlumatları üzərində aparılmışdır. Beş AI-əlaqəli kriptoaktiv — FET, AGIX, NMR, OCEAN və CTX — ilə NVIDIA və Microsoft səhmləri qiymətləndirilmişdir. Sistemin girişləri yalnız hədəf aktivin qiymətindən ibarət deyil; Bitcoin, Ethereum, müxtəlif token sektorları, səhm indeksləri, tematik ETF-lər, neft, qızıl, cross-asset correlation, momentum, SMA/EMA, volatillik, RSI, Bollinger Bands, Global Economic Policy Uncertainty və müxtəlif media/sentiment göstəricilərini əhatə edən 29-dan çox xüsusiyyətdən istifadə edilmişdir.
Mənbənin əsas müqayisəsinə görə ASTIF yeddi aktivin hamısında ən aşağı MAE-ni vermişdir. Ən yaxşı baseline modelə nisbətən MAE azalması FET üçün %59,0, NVDA üçün %47,1, NMR üçün %35,5, AGIX üçün %9,7, MSFT üçün %8,6, CTX üçün %8,5 və OCEAN üçün %7,2-dir. Lakin bu üstünlük bütün xəta ölçülərində eyni deyil: Cədvəl 1-də ASTIF bütün aktivlərdə ən aşağı RMSE-ni vermir. Buna görə tapıntı “ASTIF bütün metriklərdə bütün modelləri məğlub etdi” kimi şərh edilməməlidir.
Ablasiya təcrübələri semantik və temporal kanalların birlikdə işləməsinin vacib olduğunu göstərir. Mənbənin ablasiya hesabında SLM semantic channel çıxarıldıqda orta MAE artımı %653, LSTM komponenti çıxarıldıqda %596, uncertainty quantification çıxarıldıqda %327 və adaptive meta-learner çıxarıldıqda %285 olaraq hesabat verilib. Bununla yanaşı, bu ablasiya bölməsindəki NMR və FET baseline dəyərləri əsas performans cədvəlindəki ASTIF dəyərlərindən fərqlidir; mənbə iki təcrübə kontekstini açıq şəkildə uzlaşdırmır.
Tədqiqat real vaxt kriptovalyuta ticarət sistemi və ya investisiya strategiyası testi deyil. Tranzaksiya xərci, spread, slippage, portfel gəliri, Sharpe nisbəti, maksimum drawdown və ya real pul P&L qiymətləndirilməsi aparılmamışdır. Bundan əlavə istifadə olunan məlumat tarixi gündəlik məlumatdır və mənbə real-time data feed ilə breaking-news məlumatının sistemə daxil edilmədiyini açıq şəkildə məhdudiyyət kimi göstərir.
ASTIF Nədir və Statik Maliyyə Proqnozlaşdırma Modellərindən Necə Fərqlənir?
ASTIF semantik bazar məlumatını emal edən Small Language Model kanalı ilə tarixi ədədi nümunələri emal edən LSTM–Random Forest kanalını eyni proqnoz sistemində birləşdirən və hansı kanalın həmin anda daha etibarlı olduğuna confidence-calibrated meta-learning ilə qərar verən uyğunlaşan ensemble arxitekturasıdır. Statik ensemble-lardan əsas fərqi iki ekspertə əvvəlcədən müəyyən edilmiş dəyişməz çəki vermək əvəzinə proqnoz etibarı, qeyri-müəyyənlik, model uyğunsuzluğu və bazar kontekstini hər qərar addımında meta-feature kimi qiymətləndirməsidir.
Tədqiqatın həll etməyə çalışdığı problem
Kriptovalyuta bazarlarında qiymət formalaşması prosesi stasionar deyil. Bazar davranışı, volatillik səviyyəsi, makroiqtisadi şərtlər, tənzimləyici inkişaflar, cross-asset əlaqələri və investor davranışları zamanla dəyişə bilər. Buna görə müəyyən dövrdə uğurlu olan proqnozlaşdırma forması fərqli bazar rejimində eyni dərəcədə uğurlu olacağına zəmanət vermir.
Mənbəyə görə mövcud üsullarda üç əsas boşluq ön plana çıxır. Birincisi, bir çox statistik, deep learning və Transformer modeli proqnoz strategiyasını bazar rejiminə görə dəyişməyən statik arxitekturalardan istifadə edir. İkincisi, semantic market information əksər hibrid sistemlərdə yalnız bir sentiment skoru kimi ədədi xüsusiyyət şəklində qiymət girişlərinə əlavə edilir. Üçüncüsü, semantik və temporal proqnozlaşdırıcıların real-time etibarlılığını müqayisə edib hansına etibar ediləcəyini müəyyənləşdirən cross-modal adaptation mexanizmləri məhduddur.
Üç tədqiqat sualı
| Tədqiqat sualı | Araşdırılan mövzu |
|---|---|
| RQ1 | ASTIF ənənəvi machine learning, deep learning və Transformer baseline-larına qarşı proqnoz dəqiqliyi və sabitliyi baxımından necə performans göstərir? |
| RQ2 | Confidence-based meta-learner və uncertainty quantification kimi uyğunlaşan komponentlər ümumi performansa nə dərəcədə töhfə verir? |
| RQ3 | İki kanallı semantic encoding, numeric-only və ya semantic-only yanaşmalardan daha yaxşı nəticə verirmi? |
ASTIF-in üç əsas komponenti
| Komponent | Əsas vəzifə | Çıxış |
|---|---|---|
| MirrorPrompt SLM | Qiymət ardıcıllığını numeric channel-da, bazar kontekstini semantic channel-da emal edir. | SLM proqnozu, confidence və uncertainty. |
| LSTM–Random Forest Temporal Learner | Temporal asılılıqları və xüsusiyyət qarşılıqlı təsirlərini öyrənir. | ML proqnozu, model uyğunsuzluğuna əsaslanan uncertainty və confidence. |
| Confidence-Calibrated Meta-Learner | Hər iki eksperti confidence, uncertainty və bazar kontekstinə görə qiymətləndirir. | SLM və ya ML kanalının seçimi və yekun proqnoz. |
Maliyyə proqnozlaşdırma problemi necə formullaşdırılır?
Tədqiqat gündəlik çox-aktivli zaman sırasını rejim dəyişiklikləri və heteroskedastik səs-küy altında nəzərdən keçirir. \(X_t\), \(t\) anındakı cross-asset siqnalları, sentiment göstəriciləri və texniki xüsusiyyətləri; \(p_t\) isə normallaşdırılmış hədəf bağlanış qiymətini göstərir.
\[ \hat{f}=\arg\min_f \mathbb{E}_{(X_t,p_t)\sim P_t} \left[ \ell\left(p_{t+1},f(X_{1:t},p_{1:t})\right) \right] \]
Burada məqsəd, paylanmanın zamanla dəyişə bildiyi \(P_t\) altında növbəti günün qiymət proqnozundakı gözlənilən itkini azaltmaqdır. \(\ell\) mütləq və ya kvadratik xəta itkisini təmsil edir. Formula sistemin yalnız sabit məlumat paylanmasında deyil, dəyişən bazar şərtlərində proqnoz verməyi hədəflədiyini riyazi olaraq ifadə edir.
Məlumat kainatı
| Qrup | Aktiv / xüsusiyyət nümunələri |
|---|---|
| AI-əlaqəli kripto hədəflər | FET, AGIX, NMR, OCEAN, CTX |
| Texnologiya səhmi hədəfləri | NVDA, MSFT |
| Əsas kripto bazarı | BTC, ETH |
| Token sektorları | DeFi, NFT, Energy, Gold, Healthcare, Asset Management, Lending & Borrowing |
| Səhm/indeks konteksti | S&P, NASDAQ AI & Robotics, NASDAQ Internet, Dow Jones Basic Materials, Dow Jones Oil & Gas |
| Əmtəə | Xam neft, qızıl |
| Tematik ETF-lər | Clean Energy, Robotics & AI, ROBO, Fintech Global ETF-ləri |
| Semantic/policy dəyişənləri | Panic Index, Media Hype Index, Media Coverage Index, Fake News Index, Infodemic Index, GEPU |
Kriptovalyuta qiymətlərinin CoinMarketCap-dan, neft məlumatının Energy Information Administration-dan və müxtəlif equity/index/ETF məlumatlarının Thomson Reuters mənbələrindən alındığı bildirilir.
Xüsusiyyət mühəndisliyi
Bütün dəyişənlər Min-Max üsulu ilə \([0,1]\) intervalına miqyaslanır:
\[ x_i'= \frac{x_i-\min(X)} {\max(X)-\min(X)} \]
Bu çevirmə müxtəlif miqyaslardakı maliyyə dəyişənlərini ortaq ədədi intervala gətirir. Lakin mənbə \(\min(X)\) və \(\max(X)\) dəyərlərinin yalnız training set-dən hesablanıb-hesablanmadığını açıq cümlə ilə bildirmir. Tədqiqat xronoloji bölmə və leakage-dən qaçınma məqsədini ifadə etsə də scaler fitting təfərrüatı reproducibility baxımından daha açıq hesabat verilə bilərdi.
Texniki xüsusiyyətlər arasında fərqli gecikmələr üçün momentum:
\[ M_{t,k}= \frac{p_t-p_{t-k}}{p_{t-k}}, \qquad k\in\{1,2,3,5,7\} \]
SMA, EMA, rolling volatility, RSI, Bollinger Bands və rolling cross-asset correlation yer alır. Çarpaz-aktiv korrelyasiyası:
\[ \rho_{i,j}(t) = \operatorname{corr} \left( p_{i,t-w:t}, p_{j,t-w:t} \right) \]
şəklində ifadə olunur.
MirrorPrompt Nədir və İki Kanal Nəyi Ayırır?
MirrorPrompt eyni bazar vəziyyətini iki ayrı təmsil vasitəsilə Small Language Model-ə təqdim edən semantic predictor quruluşudur: numeric channel son qiymət ardıcıllığını yüksək dəqiqlikli ədədi təsvir kimi qoruyarkən semantic channel momentum, volatillik, cross-asset göstəriciləri və sentiment/policy dəyişənlərindən təbii dil konteksti yaradır; beləliklə kəmiyyət nümunəsi ilə kontekstual şərh tək bir xam feature vector-a endirilmədən emal edilir.
Numeric channel
Numeric channel keçmiş qiymət ardıcıllığını:
\[ n_t = [p_{t-w+1},p_{t-w+2},...,p_t] \]
şəklində və altı onluq mərtəbə dəqiqliyində təqdim edir. Tətbiq bölməsində MirrorPrompt üçün \(w=8\) keçmiş qiymətdən istifadə edildiyi bildirilir.
Semantic channel
Semantic channel konteksti:
\[ S(c_t) = f_{\mathrm{template}} (\Delta p_t,\sigma_t,I_t,S_t) \]
şəklində yaradır. Burada \(\Delta p_t\) qiymət dəyişikliyini, \(\sigma_t\) volatilliyi, \(I_t\) çarpaz-aktiv göstəricilərini və \(S_t\) sentiment/policy xüsusiyyətlərini təmsil edir.
Mühüm fərq var: sistem birbaşa breaking-news mətnlərini və ya canlı xəbər axınını oxumur. Mənbədəki semantic channel strukturlaşdırılmış bazar və sentiment göstəricilərini template-driven təbii dil açıqlamalarına çevirir.
Üç üst-üstə düşən pəncərə və confidence-weighted proqnoz
MirrorPrompt \(K=3\) üst-üstə düşən pəncərə yaradır. Hər pəncərə bir return proqnozu \(\hat r_k\) və confidence \(c_k\) verir. Small Language Model deterministic sampling ilə, yəni temperature \(\tau=0\) istifadə edilməklə işlədilir.
\[ \hat r_{\mathrm{SLM}} = \frac{\sum_{k=1}^{K} c_k\hat r_k} {\sum_{k=1}^{K}c_k} \]
\[ c_{\mathrm{SLM}} = \frac{1}{K} \sum_{k=1}^{K}c_k \]
\[ u_{\mathrm{SLM}} = 1-\min(c_{\mathrm{SLM}},1) \]
Beləliklə yüksək confidence verən pəncərənin return proqnozu ensemble nəticəsində daha yüksək çəki alır; uncertainty isə confidence-ın tamamlayıcısı kimi meta-learner-a ötürülür.
SLM tətbiq təfərrüatları
Təcrübələrdə Small Language Model kimi Gemma-3-1b-it LM Studio API vasitəsilə istifadə olunub. Response timeout 30 saniyə, standart max_tokens=150, reasoning modelləri üçün 600 və temperature dəyəri 0 olaraq hesabat verilir.
LSTM–Random Forest temporal predictor
Temporal kanal iki fərqli model ailəsini birləşdirir. LSTM keçmiş ardıcıllıqdakı uzun və qısa asılılıqları emal edərkən Random Forest xüsusiyyətlər arasındakı qeyri-xətti qarşılıqlı təsirləri tutmağa çalışır.
LSTM üç laydan ibarətdir:
64 → 32 → 16 vahid
və sequence length \(L=10\), dropout 0,2, batch normalization, Adam optimizer və learning rate 0,001 istifadə edir.
LSTM-nin əsas hüceyrə əməliyyatları mənbədə bu zəncirlə verilir:
\[ f_t=\sigma(W_f[h_{t-1},x_t]+b_f) \]
\[ i_t=\sigma(W_i[h_{t-1},x_t]+b_i) \]
\[ \tilde C_t= \tanh(W_C[h_{t-1},x_t]+b_C) \]
\[ C_t=f_t\odot C_{t-1}+i_t\odot\tilde C_t \]
\[ o_t=\sigma(W_o[h_{t-1},x_t]+b_o), \qquad h_t=o_t\odot\tanh(C_t) \]
Random Forest kanalı 100 tree istifadə edir. Mənbə maksimum depth dəyərini 20 olaraq verir və minimum-sample məhdudiyyətləri ilə overfitting-i məhdudlaşdırmağı hədəfləyir.
Yekun temporal prediction tətbiq bölməsində:
\[ \hat y^{ML} = 0.7\hat y^{LSTM} + 0.3\hat y^{RF} \]
şəklində sabit LSTM–RF qarışığıdır.
Temporal kanalın qeyri-müəyyənliyi
İki model arasındakı nisbi uyğunsuzluq:
\[ u_{ML,t} = \frac{ |\hat y_{t+1}^{LSTM}-\hat y_{t+1}^{RF}| }{ \max( \hat y_{t+1}^{LSTM}, \hat y_{t+1}^{RF} ) } \]
ilə hesablanır. Sonra:
\[ c_{ML,t}=1-u_{ML,t} \]
kimi confidence əldə edilir. Bu yanaşma iki temporal model eyni nəticəyə yaxınlaşdıqda daha yüksək, bir-birindən uzaqlaşdıqda daha aşağı etibar yaratmaq məntiqinə əsaslanır.
Meta-learner nəyə baxır?
Meta-learner 12 ölçülü \(z_t\) feature vector üzərində işləyən Random Forest classifier-dır. Mənbədə verilən əsas meta-feature-lar bunlardır: iki kanalın confidence dəyərləri, uncertainty dəyərləri, proqnozlar arasındakı nisbi fərq, confidence və uncertainty fərqləri, volatillik, trend gücü, son dövr model accuracy dəyərləri və qiymət momentumu.
Meta-classifier 20 estimator və maximum depth 5 istifadə edir. Mənbə əlavə olaraq minimum-sample məhdudiyyətlərindən və temporal validation-dan söz edir.
Meta-selection
Meta-selector:
\[ \delta(z_t)\in\{\mathrm{SLM},\mathrm{ML}\} \]
kimi müəyyən edilir və hansı proqnoz kanalının istifadə olunacağını seçir.
İki kanalın nisbi disagreement dəyəri:
\[ d_t= \frac{ |\hat y_{t+1}^{SLM}-\hat y_{t+1}^{ML}| }{ \max( \hat y_{t+1}^{SLM}, \hat y_{t+1}^{ML} ) } \]
ilə ölçülür.
Confidence calibration
Mənbə meta-classifier-ın xam probability dəyərini orta kanal confidence dəyərinə görə yenidən miqyaslayır:
\[ p_{\mathrm{cal}}= \begin{cases} 0.4+0.2(p_{\mathrm{raw}}-0.5), & \bar c<0.6\\ 0.3+0.4p_{\mathrm{raw}}, & 0.6\leq \bar c<0.8\\ 0.2+0.6p_{\mathrm{raw}}, & \bar c\geq0.8 \end{cases} \]
Burada:
\[ \bar c= \frac{c_{SLM}+c_{ML}}{2} \]
olub kalibrə edilmiş confidence dəyəri maksimum 0,85 ilə məhdudlaşdırılır. Bu sərhəd meta-learner-ın xüsusilə volatil şərtlərdə həddən artıq etibarlı davranmasının qarşısını almağı hədəfləyən mənbə-təyinli təhlükəsizlik mexanizmidir.
Sanity check
Yekun proqnoz \([0,1]\) normallaşdırılmış domain daxilində qalmalıdır. Bundan əlavə tək-addım nisbi dəyişmə:
\[ \frac{|\hat y_i-p_t|}{p_t}\leq\tau_{\max} \]
şərtinə tabedir və mənbədə:
\[ \tau_{\max}=0.5 \]
kimi verilib. Proqnoz bu sərhədləri pozarsa sistem alternativ modelə keçə və ya daha konservativ prediction capping tətbiq edə bilər.
Tədqiqatın Metodu və Nəticələri
Təlim və qiymətləndirmə quruluşu
| Maddə | Mənbədə verilən dəyər |
|---|---|
| Məlumat dövrü | Yanvar 2020 – Dekabr 2024 |
| Tezlik | Gündəlik |
| Qlobal məlumat bölgüsü | %80 training, %20 test |
| Daxili validation | Training bölməsinin son %10-u |
| Meta-learner anti-overfitting holdout | Mənbənin ayrıca metod açıqlamasında %30 temporal holdout |
| SLM | Gemma-3-1b-it |
| MirrorPrompt qiymət pəncərəsi | w = 8 |
| MirrorPrompt ensemble | K = 3 pəncərə |
| SLM temperature | 0 |
| LSTM strukturu | 64 → 32 → 16 |
| LSTM sequence length | L = 10 |
| Dropout | 0,2 |
| Optimizer | Adam |
| Learning rate | 0,001 |
| Batch size | 32 |
| Early stopping | Cross-validation üçün 15, final training üçün 25 epoch patience |
| Temporal Random Forest | 100 tree, max depth 20 |
| Meta Random Forest | 20 estimator, max depth 5 |
| ML qarışığı | 0,7 LSTM + 0,3 RF |
| Maximum calibrated confidence | 0,85 |
| Single-step relative change sərhədi | 0,5 |
%30 meta-learning temporal holdout ilə training bölməsinin son %10-una ayrılan internal validation-ın tam olaraq necə iç-içə tətbiq edildiyi mənbədə kifayət qədər açıqlanmır. Buna görə bunlar tək bir nisbət kimi birləşdirilməməlidir.
LSTM training itkisi
\[ L_{LSTM} = \frac{1}{N} \sum_{i=1}^{N} (y_i-\hat y_{LSTM,i})^2 \]
Bu Mean Squared Error itkisi LSTM-nin proqnozlaşdırılan və real normallaşdırılmış qiymət arasındakı kvadratik fərqi azaltmasını təmin edir.
Meta-learner training hədəfi
Meta-learner-ın ground-truth etiketi validation məlumatında hansı ekspertin daha aşağı xəta verdiyinə görə yaradılır. Meta-classifier üçün mənbədə cross-entropy formasında:
\[ L_{meta} = -\frac{1}{T} \sum_{t=1}^{T} \left[ y_t^{SLM}\log P(SLM|z_t) + y_t^{ML}\log P(ML|z_t) \right] \]
istifadə olunur.
\(y_t^{SLM}=1\), müvafiq addımda SLM daha aşağı xəta verdikdə; \(y_t^{ML}=1-y_t^{SLM}\) isə temporal model daha uğurlu olduqda istifadə edilir.
Qiymətləndirmə metrikləri
MAE:
\[ MAE= \frac{1}{n} \sum_{i=1}^{n} |y_i-\hat y_i| \]
RMSE:
\[ RMSE= \sqrt{ \frac{1}{n} \sum_{i=1}^{n} (y_i-\hat y_i)^2 } \]
və coefficient of determination:
\[ R^2= 1- \frac{ \sum_{i=1}^{n}(y_i-\hat y_i)^2 }{ \sum_{i=1}^{n}(y_i-\bar y)^2 } \]
istifadə olunur. Mənbə əlavə olaraq confidence calibration üçün reliability diagram və bin-bazlı calibration error qiymətləndirməsi apardığını bildirir.
Müqayisə edilən baseline modellər
| Model ailəsi | Modellər |
|---|---|
| Ənənəvi machine learning | DTC, RFC, AdaBoost, SVM |
| Deep learning | LSTM, CNN-LSTM |
| Transformer | Standard Transformer, Informer, TFT |
| Təklif olunan sistem | ASTIF |
Yeddi aktivdə MAE və RMSE nəticələri
| Aktiv | ASTIF MAE | ASTIF RMSE | Ən yaxşı baseline MAE | MAE yaxşılaşması |
|---|---|---|---|---|
| CTX | 0,0226 | 0,0576 | 0,0247 — LSTM | %8,5 |
| FET | 0,0133 | 0,0521 | 0,0324 — Informer | %59,0 |
| NMR | 0,0158 | 0,0305 | 0,0245 — Informer | %35,5 |
| OCEAN | 0,0168 | 0,0421 | 0,0181 — Informer | %7,2 |
| AGIX | 0,0213 | 0,0558 | 0,0236 — Informer | %9,7 |
| MSFT | 0,0222 | 0,0440 | 0,0243 — LSTM | %8,6 |
| NVDA | 0,0073 | 0,0130 | 0,0138 — Informer | %47,1 |
ASTIF-in yeddi aktivin hamısında ən aşağı MAE-ni verməsi tədqiqatın ən aydın müqayisəli nəticəsidir. Ən böyük nisbi qazanc FET-də, ikinci ən böyük qazanc NVDA-da, ən kiçik qazanc isə OCEAN-da hesabat verilib.
ASTIF-in Üstünlüyü Bütün Xəta Ölçülərində Keçərlidirmi?
Xeyr. Mənbə ASTIF-i ümumilikdə bütün baseline-lardan üstün kimi şərh etsə də Cədvəl 1-in təfərrüatlı dəyərləri ASTIF-in yeddi aktivin hamısında ən aşağı MAE-ni verdiyini, lakin ən aşağı RMSE-ni yalnız NMR, MSFT və NVDA-da verdiyini göstərir; CTX-də LSTM, FET-də Informer/TFT, OCEAN və AGIX-də Informer daha aşağı RMSE dəyərinə malikdir. Buna görə ən möhkəm nəticə MAE üstünlüyüdür; “bütün ölçülərdə mütləq üstünlük” mənbə cədvəli tərəfindən dəstəklənmir.
RMSE baxımından aktiv səviyyəsində fərqlənmə
| Aktiv | Ən aşağı RMSE modeli | Ən aşağı RMSE | ASTIF RMSE |
|---|---|---|---|
| CTX | LSTM | 0,0422 | 0,0576 |
| FET | Informer / TFT | 0,0447 | 0,0521 |
| NMR | ASTIF | 0,0305 | 0,0305 |
| OCEAN | Informer | 0,0256 | 0,0421 |
| AGIX | Informer | 0,0378 | 0,0558 |
| MSFT | ASTIF | 0,0440 | 0,0440 |
| NVDA | ASTIF | 0,0130 | 0,0130 |
Bu fərq MAE ilə RMSE-nin fərqli xəta xüsusiyyətlərinə həssas olduğunu da göstərir. RMSE böyük xətaları kvadratlaşdırdığı üçün az sayda böyük proqnoz yayınmasına MAE-dən daha çox çəki verir.
Mənbə şəkillərinin göstərdiyi performans
Mənbə Şəkil 3 ASTIF-in yeddi aktivdəki MAE dəyərlərini ən yaxşı baseline ilə yanaşı göstərir və xüsusilə FET ilə NVDA-dakı fərqlər nəzərəçarpandır. Şəkil 4; orta MAE, R², xəta paylanması və bəzi aktivlərdəki model müqayisəsini dörd paneldə göstərir. Şəkil 5 isə NMR, CTX, MSFT və NVDA üçün actual və predicted price trajectory xətlərini müqayisə edir.
Bu xətlərin vizual olaraq yaxın olması təkbaşına trading profitability sübutu deyil. Eyni şəkildə aşağı normallaşdırılmış qiymət xətası direction accuracy və ya risk-adjusted gəlir ilə eynimənalı deyil; mənbə bu cür trading backtest həyata keçirməyib.
Ablasiya: hansı komponent nə qədər vacibdir?
| Konfiqurasiya | Çıxarılan komponent | NMR MAE | NMR RMSE | FET MAE | FET RMSE |
|---|---|---|---|---|---|
| ASTIF Baseline | Yoxdur | 0,0109 | 0,0180 | 0,0146 | 0,0298 |
| Pure Machine Learning | SLM Channel | 0,0703 | 0,0881 | 0,1252 | 0,2459 |
| Non-Sequential ML | LSTM Modeling | 0,0618 | 0,0791 | 0,1201 | 0,2308 |
| Deterministic Framework | Uncertainty | 0,0420 | 0,0649 | 0,0682 | 0,1726 |
| Static Ensemble | Meta-Learner | 0,0367 | 0,0462 | 0,0629 | 0,1240 |
Mənbənin öz orta artım hesabında semantic SLM kanalı çıxarıldıqda MAE %653, LSTM çıxarıldıqda %596, uncertainty mexanizmi çıxarıldıqda %327 və meta-learner çıxarıldıqda %285 artır.
Lakin bu ablasiya cədvəlindəki ASTIF baseline dəyərləri əsas performans Cədvəl 1-dəki NMR və FET ASTIF dəyərləri ilə eyni deyil. Mənbə bu fərqi açıq şəkildə izah etmədiyinə görə cədvəllər fərqli təcrübə kontekstləri kimi nəzərdən keçirilməlidir.
Dual-channel encoding həqiqətən töhfə verirmi?
Mənbə təmsilçi bir volatil kriptoaktivdə tam dual-channel quruluş üçün MAE 0,0133 hesabat verir. Numeric-only quruluş üçün MAE 0,0325, semantic-only quruluş üçün 0,0378-dir. Mənbənin hesabına görə dual-channel yanaşma müvafiq olaraq təxminən %59,0 və %64,7 yaxşılaşma təmin edir.
İkinci qiymətləndirmə aktivində dual-channel üstünlüyünün daha kiçik olduğu bildirilir: numeric-only yanaşmaya nisbətən %3,4 və semantic-only yanaşmaya nisbətən %14,9.
Cross-asset context
Cross-asset expanded feature konfiqurasiyası araşdırılan iki kriptoaktivdə MAE 0,0278 və 0,0292 dəyərlərini verib; əsas semantic configuration-a nisbətən %15,5 və %9,6 yaxşılaşma hesabat verilib. Volatility–momentum xüsusiyyətlərinin də töhfə verdiyi, sentiment və market indicator xüsusiyyətlərinin isə daha məhdud, lakin ölçülə bilən qazanc yaratdığı qeyd olunub.
Temporal window həssaslığı
Mənbə sensitivity analysis-də pəncərə ölçüsü 8-i ən yaxşı accuracy–efficiency balansı kimi hesabat verir. Window size 12 istifadə edildikdə FET MAE-si %47,3 və NMR MAE-si %42,0 artıb. Müəlliflər bunu overfitting davranışı kimi şərh edirlər.
Əlavə olaraq iki-model ensemble-ın tək-model quruluşa nisbətən FET və NMR-də müvafiq olaraq %5,3 və %4,3 MAE yaxşılaşması təmin etdiyi bildirilmiş; daha mürəkkəb ensemble quruluşların mütləq daha yaxşı olmadığı nəticəsi çıxarılmışdır.
Confidence paylanması nə anlatır?
Mənbə Şəkil 6 semantic və temporal kanalların confidence paylanmalarını göstərir. Semantic confidence paylanması ümumilikdə daha yüksək confidence bölgəsinə sürüşərkən temporal confidence daha aşağı dəyərlərdə cəmlənir. Müəlliflər iki kanal bir-birinə yaxınlaşdığı hallarda meta-learner confidence-ının yüksəldiyini; kanallar ayrışdıqda uncertainty-nin artdığını şərh edirlər.
Bu nəticə confidence dəyərlərinin real bazar riskinin hamısını ölçdüyü mənasına gəlmir. Bunlar modelin öz proqnoz quruluşu və calibration mexanizmi daxilində qeyri-müəyyənlik göstəriciləridir.
Tədqiqatın dəstəklədiyi nəticələr
- ASTIF araşdırılan yeddi aktivin hamısında Cədvəl 1-in MAE ölçüsünə görə müqayisə edilən baseline-lardan daha aşağı xəta yaradıb.
- MAE üstünlüyü aktivə görə %7,2 ilə %59,0 arasında dəyişir.
- Semantic SLM, temporal LSTM, uncertainty quantification və meta-learning komponentlərinin çıxarılması ablasiya şərtlərində performansı aşağı salıb.
- Dual-channel encoding mənbə təcrübələrində single-channel quruluşlardan daha yaxşı nəticə verib.
- Cross-asset xüsusiyyətlər və orta böyüklükdə temporal context bəzi təcrübələrdə dəqiqliyi yaxşılaşdırıb.
- Confidence-aware model selection mənbə təcrübələrində semantic və temporal ekspertlərin tək statik çəki ilə birləşdirilməsinə alternativ mexanizm təmin edib.
Tədqiqatın dəstəkləmədiyi nəticələr
Tədqiqat ASTIF-in bütün maliyyə bazarlarında və ya bütün kriptoaktivlərdə ən yaxşı model olduğunu göstərmir. Test kainatı beş AI-əlaqəli token və iki texnologiya səhmi ilə məhduddur.
Tədqiqat real pul ilə al-sat strategiyası, tranzaksiya xərci, spread, slippage, order-book impact, Sharpe ratio, Sortino ratio, maximum drawdown və ya portfel P&L testi aparmayıb. Buna görə aşağı MAE-nin birbaşa gəlirli trading strategiyası demək olduğu deyilə bilməz.
Tədqiqat multi-step forecasting sistemi deyil; əsas vəzifə next-step prediction-dır. Multi-step forecasting mənbədə gələcək tədqiqat mövzusu kimi göstərilib.
Sistem real vaxt xəbər axınından istifadə etmir. Mənbə açıq şəkildə historical data istifadə etdiyini və breaking news / real-time feed inteqrasiyasının olmadığını bildirir.
Mənbə nəticələri p-dəyərləri, confidence interval və ya çoxsaylı random-seed performans paylanmaları ilə dəstəkləmir. Buna görə baseline fərqlərinin inferential statistical significance səviyyəsi barədə mənbə xaricində hökm vermək olmaz.
Məhdudiyyətlər
| Məhdudiyyət | Nəticələrin şərhinə təsiri |
|---|---|
| Prompt engineering domain ekspertliyi tələb edir | Semantic channel-ın performansı prompt dizaynına həssas ola bilər. |
| Hesablama yükü | Resource-constrained mühitlərdə real-time istifadə çətinləşə bilər. |
| Məhdud aktiv kainatı | Yeni token-lara və alternativ asset class-lara ümumiləşdirmə birbaşa göstərilməyib. |
| Historical data | Live market feed və breaking-news şərtlərində davranış sınaqdan keçirilməyib. |
| Next-step forecast | Uzun multi-step horizon performansı məlum deyil. |
| Əsas cədvəllər arasında baseline fərqi | NMR və FET üçün əsas benchmark ilə ablation baseline dəyərləri birbaşa birləşdirilməməlidir. |
| Validation nisbətlərinin izahı | %30 meta holdout ilə qlobal split daxilindəki %10 internal validation əlaqəsinin reproducibility-si əlavə izah tələb edir. |
| Inferential significance hesabatı yoxdur | Model fərqlərinin p-dəyəri və ya etibar intervalı səviyyəsində mənalılığı mənbə tərəfindən göstərilməyib. |
Gələcək tədqiqat istiqamətləri
Mənbə gələcəkdə real-time data inteqrasiyası, reinforcement learning ilə automated prompt optimization, multi-step forecasting, daha geniş asset class qiymətləndirməsi və edge computing optimization təklif edir.
Mənbə və Metod Qeydi
Orijinal başlıq: ASTIF: Adaptive Semantic-Temporal Integration for Cryptocurrency Price Forecasting
Müəlliflər: Hafiz Saif Ur Rehman, Ling Liu, Kaleem Ullah Qasim
Corresponding author: Ling Liu
Qurumlar: Southwestern University of Finance and Economics, Chengdu, Sichuan, China; Southwest Jiaotong University, Chengdu, Sichuan, China.
Mənbə növü: arXiv preprint.
arXiv: 2512.18661v1
arXiv kateqoriyası: cs.AI
İlk versiya tarixi: 21 Dekabr 2025.
Resenziya statusu: Təsdiqlənmiş resenziyalı jurnal nəşri tapılmadığı üçün preprint kimi nəzərdən keçirilib.
Jurnal məlumatı: ArXiv tərəfindən emal edilən manuscript mətnində “journal: Nuclear Physics B” sahəsi görünür; lakin bu başlıqla təsdiqlənə bilən Nuclear Physics B nəşr qeydi və ya müstəqil jurnal DOI-si tapılmadığı üçün bu ifadə nəşr statusu kimi istifadə olunmayıb.
DOI: Təsdiqlənmiş müstəqil jurnal DOI-si yoxdur. arXiv qeydi 2512.18661 üzərindən müəyyən edilir.
Məlumat dövrü: Yanvar 2020 – Dekabr 2024.
Hədəf aktivlər: FET, AGIX, NMR, OCEAN, CTX, MSFT, NVDA.
Əsas model: MirrorPrompt SLM + LSTM–Random Forest temporal learner + confidence-calibrated Random Forest meta-learner.
SLM: Gemma-3-1b-it, LM Studio API.
Əsas qiymətləndirmə metrikləri: MAE, RMSE, R² və calibration error.
Məlumat əlçatanlığı: Təqdim olunan PDF-də ayrıca Data Availability Statement və ya təsdiqlənə bilən public dataset repository linki yoxdur.
Kod əlçatanlığı: Təqdim olunan PDF-də təsdiqlənə bilən GitHub və ya kod repository linki yoxdur.
Maliyyələşdirmə: Təqdim olunan PDF-də ayrıca funding statement aşkarlanmayıb.
Maraqlar toqquşması: Təqdim olunan PDF-də ayrıca conflict-of-interest statement aşkarlanmayıb.
Müəllif töhfələri: Ayrı bir CRediT/müəllif töhfələri bəyanatı aşkarlanmayıb.
Lisenziya: Təqdim olunan PDF və təsdiqlənə bilən ilkin biblioqrafik qeyddə açıq yenidən istifadə lisenziyası etibarlı şəkildə aşkarlanmadığı üçün lisenziya fərz edilməyib. Mənbə fiqurları olduğu kimi kopyalanmamalı; ədədi məlumatlar və elmi əlaqələr Verianla üçün müstəqil şəkildə yenidən çəkilməlidir.
Mənbədaxili şərh qeydi: Cədvəl 1 ASTIF-in bütün hədəflərdə ən aşağı MAE-ni verdiyini göstərərkən bütün hədəflərdə ən aşağı RMSE-ni vermədiyini göstərir. Buna görə mənbə mətnindəki ümumi “outperforms all baselines” ifadəsi ən təhlükəsiz şəkildə MAE və mənbədə təqdim edilən toplu qiymətləndirmə kontekstində şərh edilməlidir.
Mənbədaxili reproducibility qeydi: Cədvəl 1 ilə Table 3-ün NMR/FET ASTIF baseline dəyərləri fərqlidir. Bundan əlavə meta-learner üçün verilən %30 temporal holdout ilə qlobal %80/%20 split daxilindəki son %10 internal validation arasındakı tətbiq əlaqəsi mənbədə tam açıqlanmayıb.
Əsas metod sərhədi: Bu tədqiqat tarixi gündəlik məlumat üzərində next-step forecast performansını ölçür. Real-time xəbər axını, canlı trading, tranzaksiya xərcləri və real pul portfel performansı tədqiqatın təcrübə əhatəsindən kənardadır.
Müəllif hüququ/təqdimat üsulu: Verianla mətni mənbə tədqiqatın cümlələrini və ya fiqur dizaynlarını yenidən istehsal etmir. Metod, riyaziyyat, təcrübə parametrləri, cədvəl dəyərləri və nəticə sərhədləri mənbə tədqiqatdan çıxarılaraq müstəqil öyrədici Azərbaycan dili quruluşunda yenidən təşkil edilib.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib