


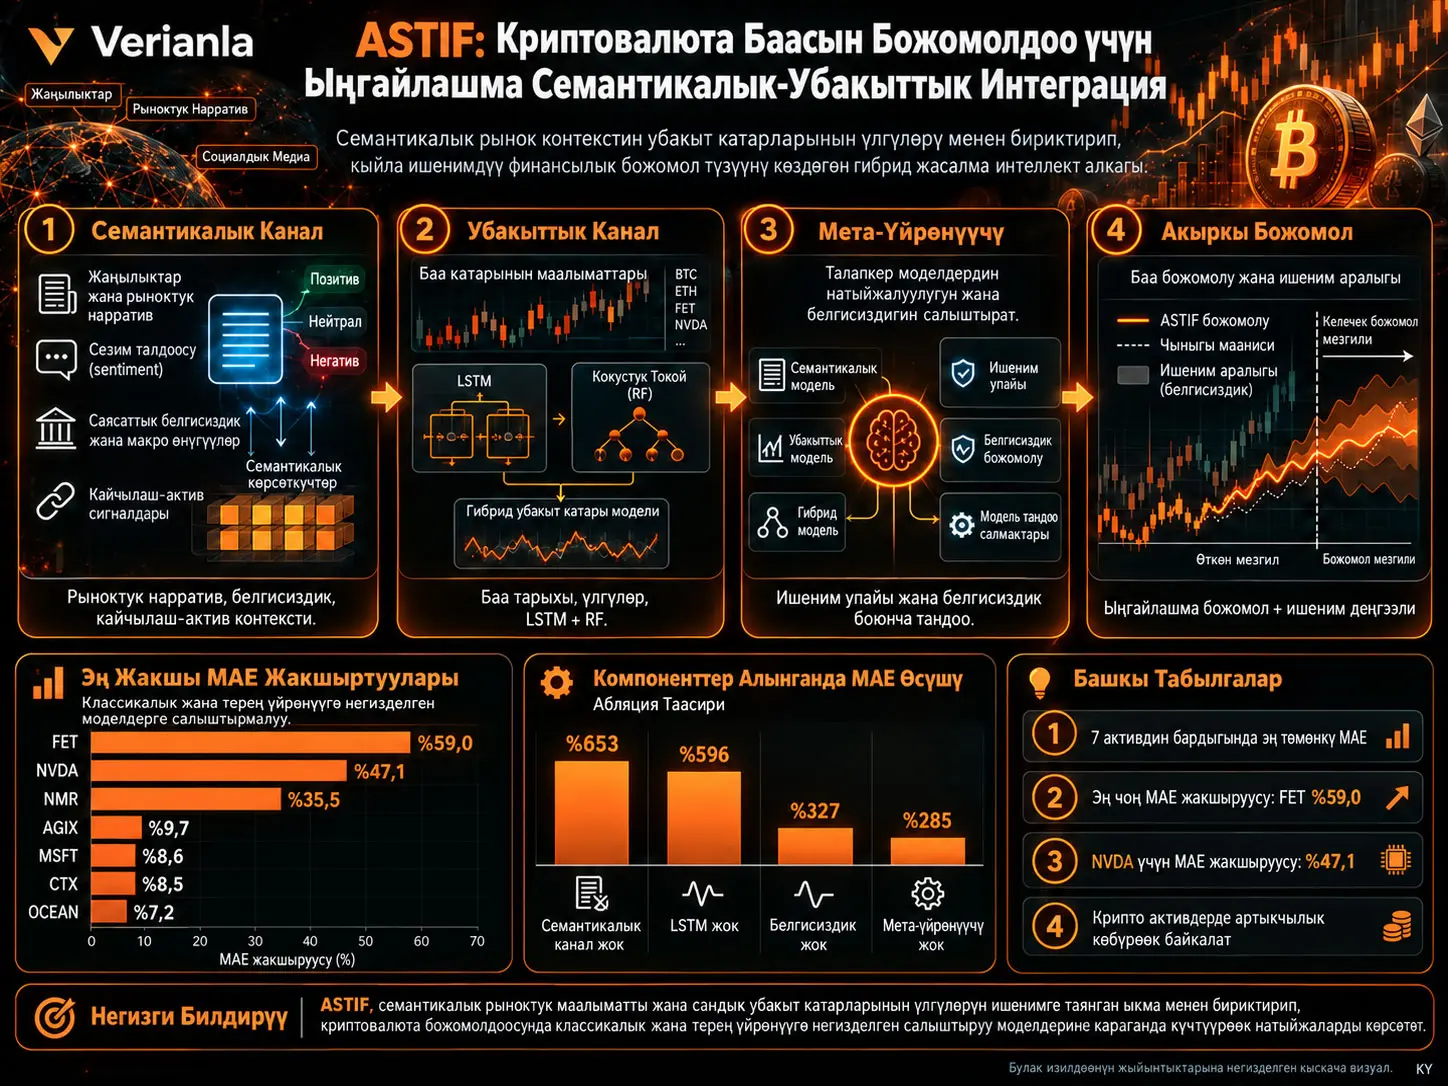
ASTIF — Adaptive Semantic-Temporal Integration Framework — семантикалык рынок контекстин жана сандык убакыт катарларынын үлгүлөрүн өзүнчө божомол каналдарында иштетип, андан кийин божомол ишенимдүүлүгү жана белгисиздигине жараша бул каналдардын ортосунда ыңгайлашма тандоо жүргүзгөн иерархиялык финансылык божомолдоо архитектурасы. Изилдөө мурунку баа кыймылдары гана криптовалюта рыногундагы саясаттык белгисиздикти, рыноктук нарративдерди, sentiment көрсөткүчтөрүн жана cross-asset байланыштарын жетиштүү деңгээлде чагылдырбай калышы мүмкүн деген көйгөйдөн чыгат. ASTIF бул көйгөйдү үч компонент менен чечет: MirrorPrompt негизиндеги Small Language Model семантикалык божомолдоочу, LSTM–Random Forest гибриддик убакыттык божомолдоочу жана бул эки эксперттин ишенимдүүлүгүн баалаган confidence-calibrated meta-learner.
Эксперименттер Январь 2020–Декабрь 2024 мезгилиндеги күнүмдүк маалыматтарда жүргүзүлгөн. AI менен байланышкан беш криптоактив — FET, AGIX, NMR, OCEAN жана CTX — ошондой эле NVIDIA жана Microsoft акциялары бааланган. Системанын кириштери максаттуу активдин баасынан гана турбайт; Bitcoin, Ethereum, ар кандай token секторлору, акция индекстери, тематикалык ETFтер, мунай, алтын, cross-asset correlation, momentum, SMA/EMA, волатилдүүлүк, RSI, Bollinger Bands, Global Economic Policy Uncertainty жана ар кандай media/sentiment көрсөткүчтөрүн камтыган 29 санынан ашык өзгөчөлүк колдонулган.
Булактын негизги салыштыруусуна ылайык ASTIF жети активдин баарында эң төмөн MAE берген. Эң жакшы baseline моделге салыштырмалуу MAE азайышы FET үчүн %59,0, NVDA үчүн %47,1, NMR үчүн %35,5, AGIX үчүн %9,7, MSFT үчүн %8,6, CTX үчүн %8,5 жана OCEAN үчүн %7,2. Бирок бул артыкчылык бардык ката өлчөмдөрүндө бирдей эмес: 1-таблицада ASTIF бардык активдерде эң төмөн RMSE бербейт. Ошондуктан жыйынтыкты “ASTIF бардык метрикаларда бардык моделдерди жеңди” деп чечмелөөгө болбойт.
Абляциялык эксперименттер семантикалык жана убакыттык каналдардын чогуу иштеши маанилүү экенин көрсөтөт. Булактын абляция эсебинде SLM semantic channel алынып салынганда орточо MAE өсүшү %653, LSTM компоненти алынып салынганда %596, uncertainty quantification алынып салынганда %327 жана adaptive meta-learner алынып салынганда %285 деп билдирилген. Ошол эле учурда бул абляция бөлүмүндөгү NMR жана FET baseline маанилери негизги performance таблицасындагы ASTIF маанилеринен айырмаланат; булак эки эксперименттик контекстти ачык түрдө шайкеш келтирбейт.
Изилдөө real-time криптовалюта соода системасы же инвестициялык стратегия тести эмес. Transaction cost, spread, slippage, портфель кирешеси, Sharpe ratio, maximum drawdown же реалдуу акча P&L баалоосу жүргүзүлгөн эмес. Мындан тышкары колдонулган маалымат тарыхый күнүмдүк маалымат болуп, булак real-time data feed жана breaking-news маалыматы система менен интеграцияланбаганын ачык түрдө чектөө катары белгилейт.
ASTIF Деген Эмне жана Статикалык Финансылык Божомолдоо Моделдеринен Кантип Айырмаланат?
ASTIF семантикалык рынок маалыматтарын иштеткен Small Language Model каналы менен тарыхый сандык үлгүлөрдү иштеткен LSTM–Random Forest каналын бир божомол системасында бириктирип, кайсы канал ошол учурда ишенимдүүрөөк экенин confidence-calibrated meta-learning аркылуу аныктаган ыңгайлашма ensemble архитектурасы. Статикалык ensemble моделдерден негизги айырмасы эки экспертке алдын ала белгиленген өзгөрбөс салмак берүүнүн ордуна божомол ишенимин, белгисиздикти, модель келишпестигин жана рынок контекстин ар бир чечим кадамында meta-feature катары баалайт.
Изилдөө чечүүгө аракет кылган көйгөй
Криптовалюта рынокторунда баа түзүлүү процесси стационардуу эмес. Рынок жүрүм-туруму, волатилдүүлүк деңгээли, макроэкономикалык шарттар, жөнгө салуучу өзгөрүүлөр, cross-asset байланыштары жана инвесторлордун жүрүм-туруму убакыт өтүшү менен өзгөрүшү мүмкүн. Ошондуктан белгилүү бир мезгилде ийгиликтүү болгон божомол ыкмасы башка рынок режиминде ошол эле деңгээлде ийгиликтүү болот деп кепилдик берүүгө болбойт.
Булакка ылайык учурдагы ыкмаларда үч негизги боштук бар. Биринчиден, көптөгөн статистикалык, deep learning жана Transformer моделдери божомол стратегиясын рынок режимине жараша өзгөртпөгөн статикалык архитектураларды колдонот. Экинчиден, semantic market information көпчүлүк гибрид системаларда бир эле sentiment score сыяктуу сандык өзгөчөлүк катары баа кириштерине кошулат. Үчүнчүдөн, семантикалык жана убакыттык божомолдоочулардын real-time ишенимдүүлүгүн салыштырып, кайсынысына ишенүү керек экенин аныктаган cross-modal adaptation механизмдери чектелүү.
Үч изилдөө суроосу
| Изилдөө суроосу | Каралган тема |
|---|---|
| RQ1 | ASTIF салттуу machine learning, deep learning жана Transformer baseline моделдерине салыштырмалуу божомол тактыгы жана туруктуулугу боюнча кандай натыйжа көрсөтөт? |
| RQ2 | Confidence-based meta-learner жана uncertainty quantification сыяктуу ыңгайлашма компоненттер жалпы натыйжага канчалык салым кошот? |
| RQ3 | Эки каналдуу semantic encoding, numeric-only же semantic-only ыкмаларга караганда жакшыраак натыйжа береби? |
ASTIFтин үч негизги компоненти
| Компонент | Негизги милдет | Чыгыш |
|---|---|---|
| MirrorPrompt SLM | Баалар тизмегин numeric channel ичинде, рынок контекстин semantic channel ичинде иштетет. | SLM божомолу, confidence жана uncertainty. |
| LSTM–Random Forest Temporal Learner | Убакыттык көз карандылыктарды жана өзгөчөлүктөрдүн өз ара аракеттенүүсүн үйрөнөт. | ML божомолу, модель келишпестигине негизделген uncertainty жана confidence. |
| Confidence-Calibrated Meta-Learner | Эки экспертти тең confidence, uncertainty жана рынок контексти боюнча баалайт. | SLM же ML каналын тандоо жана акыркы божомол. |
Финансылык божомолдоо көйгөйү кандай формулировкаланат?
Изилдөө күнүмдүк көп-активдүү убакыт катарын режим өзгөрүүлөрү жана гетероскедастикалык ызы-чуу шартында карайт. \(X_t\), \(t\) учурдагы cross-asset сигналдарын, sentiment көрсөткүчтөрүн жана техникалык өзгөчөлүктөрдү; \(p_t\) болсо нормалдаштырылган максаттуу жабылуу баасын көрсөтөт.
\[ \hat{f}=\arg\min_f \mathbb{E}_{(X_t,p_t)\sim P_t} \left[ \ell\left(p_{t+1},f(X_{1:t},p_{1:t})\right) \right] \]
Бул жерде максат — бөлүштүрүү убакыт өтүшү менен өзгөрө ала турган \(P_t\) шартында кийинки күндүн баасын божомолдоодогу күтүлгөн жоготууну азайтуу. \(\ell\) абсолюттук же квадраттык ката жоготуусун билдирет. Формула система туруктуу маалымат бөлүштүрүүдө гана эмес, өзгөрүп турган рынок шарттарында да божомол берүүгө багытталганын математикалык түрдө көрсөтөт.
Маалыматтар чөйрөсү
| Топ | Актив / өзгөчөлүк мисалдары |
|---|---|
| AI менен байланышкан крипто максаттар | FET, AGIX, NMR, OCEAN, CTX |
| Технология акцияларынын максаттары | NVDA, MSFT |
| Негизги крипто рыногу | BTC, ETH |
| Token секторлору | DeFi, NFT, Energy, Gold, Healthcare, Asset Management, Lending & Borrowing |
| Акция/индекс контексти | S&P, NASDAQ AI & Robotics, NASDAQ Internet, Dow Jones Basic Materials, Dow Jones Oil & Gas |
| Чийки зат | Чийки мунай, алтын |
| Тематикалык ETFтер | Clean Energy, Robotics & AI, ROBO, Fintech Global ETFтери |
| Semantic/policy өзгөрмөлөрү | Panic Index, Media Hype Index, Media Coverage Index, Fake News Index, Infodemic Index, GEPU |
Криптовалюта баалары CoinMarketCap булагынан, мунай маалыматы Energy Information Administration булагынан жана ар кандай equity/index/ETF маалыматтары Thomson Reuters булактарынан алынганы айтылат.
Өзгөчөлүктөрдү инженердик даярдоо
Бардык өзгөрмөлөр Min-Max ыкмасы менен \([0,1]\) аралыгына масштабдалат:
\[ x_i'= \frac{x_i-\min(X)} {\max(X)-\min(X)} \]
Бул өзгөртүү ар кандай масштабдагы финансылык өзгөрмөлөрдү жалпы сандык аралыкка алып келет. Бирок булак \(\min(X)\) жана \(\max(X)\) маанилери training set гана колдонулуп эсептелгенби же жокпу, муну ачык сүйлөм менен көрсөтпөйт. Изилдөө хронологиялык бөлүү жана leakageден качуу максатын билдиргени менен scaler fitting деталдары reproducibility жагынан ачыгыраак баяндалышы мүмкүн эле.
Техникалык өзгөчөлүктөрдүн арасында ар түрдүү кечигүүлөр үчүн momentum:
\[ M_{t,k}= \frac{p_t-p_{t-k}}{p_{t-k}}, \qquad k\in\{1,2,3,5,7\} \]
SMA, EMA, rolling volatility, RSI, Bollinger Bands жана rolling cross-asset correlation бар. Cross-asset корреляциясы:
\[ \rho_{i,j}(t) = \operatorname{corr} \left( p_{i,t-w:t}, p_{j,t-w:t} \right) \]
түрүндө берилет.
MirrorPrompt Деген Эмне жана Эки Канал Эмнени Бөлүп Көрсөтөт?
MirrorPrompt бир эле рынок абалын эки өзүнчө көрсөтмө аркылуу Small Language Modelге берген semantic predictor түзүмү: numeric channel акыркы баа тизмегин жогорку тактыктагы сандык көрсөтмө катары сактайт, ал эми semantic channel momentum, волатилдүүлүк, cross-asset көрсөткүчтөрү жана sentiment/policy өзгөрмөлөрүнөн табигый тил контекстин түзөт; ушундайча сандык үлгү менен контексттик түшүндүрмө бир эле чийки feature vectorга кыскартылбай иштетилет.
Numeric channel
Numeric channel мурунку баа тизмегин:
\[ n_t = [p_{t-w+1},p_{t-w+2},...,p_t] \]
түрүндө жана алты ондук орун тактыгында берет. Ишке ашыруу бөлүмүндө MirrorPrompt үчүн \(w=8\) мурунку баа колдонулганы айтылат.
Semantic channel
Semantic channel контекстти:
\[ S(c_t) = f_{\mathrm{template}} (\Delta p_t,\sigma_t,I_t,S_t) \]
түрүндө түзөт. Бул жерде \(\Delta p_t\) баа өзгөрүүсүн, \(\sigma_t\) волатилдүүлүктү, \(I_t\) cross-asset көрсөткүчтөрүн жана \(S_t\) sentiment/policy өзгөчөлүктөрүн билдирет.
Маанилүү айырма бар: система breaking-news тексттерин же түз эфирдеги жаңылык агымын түздөн-түз окубайт. Булактагы semantic channel структураланган рынок жана sentiment көрсөткүчтөрүн template-driven табигый тил түшүндүрмөлөрүнө айландырат.
Үч бири-бирин каптаган терезе жана confidence-weighted божомол
MirrorPrompt \(K=3\) бири-бирин каптаган терезе түзөт. Ар бир терезе return божомолун \(\hat r_k\) жана confidence \(c_k\) берет. Small Language Model deterministic sampling менен, башкача айтканда temperature \(\tau=0\) колдонулуп иштетилет.
\[ \hat r_{\mathrm{SLM}} = \frac{\sum_{k=1}^{K} c_k\hat r_k} {\sum_{k=1}^{K}c_k} \]
\[ c_{\mathrm{SLM}} = \frac{1}{K} \sum_{k=1}^{K}c_k \]
\[ u_{\mathrm{SLM}} = 1-\min(c_{\mathrm{SLM}},1) \]
Демек жогорку confidence берген терезенин return божомолу ensemble жыйынтыгында жогору салмак алат; uncertainty болсо confidenceтин толуктоочусу катары meta-learnerге өткөрүлөт.
SLM ишке ашыруу деталдары
Эксперименттерде Small Language Model катары Gemma-3-1b-it LM Studio API аркылуу колдонулган. Response timeout 30 секунда, стандарттык max_tokens=150, reasoning моделдери үчүн 600 жана temperature мааниси 0 деп берилет.
LSTM–Random Forest temporal predictor
Убакыттык канал эки башка модель үй-бүлөсүн бириктирет. LSTM өткөн тизмектеги узак жана кыска көз карандылыктарды иштетсе, Random Forest өзгөчөлүктөрдүн ортосундагы сызыктуу эмес өз ара аракеттенүүлөрдү кармоого аракет кылат.
LSTM үч катмардан турат:
64 → 32 → 16 бирдик
жана sequence length \(L=10\), dropout 0,2, batch normalization, Adam optimizer жана learning rate 0,001 колдонот.
LSTMнин негизги уяча операциялары булакта төмөнкү чынжыр менен берилет:
\[ f_t=\sigma(W_f[h_{t-1},x_t]+b_f) \]
\[ i_t=\sigma(W_i[h_{t-1},x_t]+b_i) \]
\[ \tilde C_t= \tanh(W_C[h_{t-1},x_t]+b_C) \]
\[ C_t=f_t\odot C_{t-1}+i_t\odot\tilde C_t \]
\[ o_t=\sigma(W_o[h_{t-1},x_t]+b_o), \qquad h_t=o_t\odot\tanh(C_t) \]
Random Forest каналы 100 tree колдонот. Булак maximum depth маанисин 20 деп берип, minimum-sample чектөөлөрү менен overfittingти чектөөнү көздөйт.
Акыркы temporal prediction ишке ашыруу бөлүмүндө:
\[ \hat y^{ML} = 0.7\hat y^{LSTM} + 0.3\hat y^{RF} \]
түрүндөгү туруктуу LSTM–RF аралашмасы.
Убакыттык каналдын белгисиздиги
Эки моделдин ортосундагы салыштырмалуу келишпестик:
\[ u_{ML,t} = \frac{ |\hat y_{t+1}^{LSTM}-\hat y_{t+1}^{RF}| }{ \max( \hat y_{t+1}^{LSTM}, \hat y_{t+1}^{RF} ) } \]
менен эсептелет. Андан кийин:
\[ c_{ML,t}=1-u_{ML,t} \]
түрүндө confidence алынат. Бул ыкма эки убакыттык модель бирдей жыйынтыкка жакындаганда жогорку, бири-биринен алыстаганда төмөн ишеним түзүү логикасына негизделет.
Meta-learner эмнеге карайт?
Meta-learner 12 өлчөмдүү \(z_t\) feature vector үстүндө иштеген Random Forest classifier. Булакта берилген негизги meta-featureлар төмөнкүлөр: эки каналдын confidence маанилери, uncertainty маанилери, божомолдордун ортосундагы салыштырмалуу айырма, confidence жана uncertainty айырмалары, волатилдүүлүк, тренд күчү, акыркы мезгилдеги модель accuracy маанилери жана баа momentumu.
Meta-classifier 20 estimator жана maximum depth 5 колдонот. Булак ошондой эле minimum-sample чектөөлөрүн жана temporal validationды эскерет.
Meta-selection
Meta-selector:
\[ \delta(z_t)\in\{\mathrm{SLM},\mathrm{ML}\} \]
түрүндө аныкталып, кайсы божомол каналы колдонуларын тандайт.
Эки каналдын салыштырмалуу disagreement мааниси:
\[ d_t= \frac{ |\hat y_{t+1}^{SLM}-\hat y_{t+1}^{ML}| }{ \max( \hat y_{t+1}^{SLM}, \hat y_{t+1}^{ML} ) } \]
менен өлчөнөт.
Confidence calibration
Булак meta-classifierдин чийки probability маанисин орточо канал confidence маанисине жараша кайра масштабдайт:
\[ p_{\mathrm{cal}}= \begin{cases} 0.4+0.2(p_{\mathrm{raw}}-0.5), & \bar c<0.6\\ 0.3+0.4p_{\mathrm{raw}}, & 0.6\leq \bar c<0.8\\ 0.2+0.6p_{\mathrm{raw}}, & \bar c\geq0.8 \end{cases} \]
Бул жерде:
\[ \bar c= \frac{c_{SLM}+c_{ML}}{2} \]
болуп, калибрленген confidence мааниси эң көп 0,85 менен чектелет. Бул чек meta-learnerдин өзгөчө волатилдүү шарттарда ашыкча ишенимдүү жүрүм-турумун алдын алууга багытталган булак-аныктаган коопсуздук механизми.
Sanity check
Акыркы божомол \([0,1]\) нормалдаштырылган domain ичинде калышы керек. Мындан тышкары бир-кадамдык салыштырмалуу өзгөрүү:
\[ \frac{|\hat y_i-p_t|}{p_t}\leq\tau_{\max} \]
шартына баш иет жана булакта:
\[ \tau_{\max}=0.5 \]
деп берилген. Божомол бул чектерди бузса система альтернативдүү моделге өтүшү же этият prediction capping колдонушу мүмкүн.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Окутуу жана баалоо тартиби
| Элемент | Булакта берилген маани |
|---|---|
| Маалымат мезгили | Январь 2020 – Декабрь 2024 |
| Жыштык | Күнүмдүк |
| Глобалдык маалымат бөлүштүрүү | %80 training, %20 test |
| Ички validation | Training бөлүгүнүн акыркы %10 бөлүгү |
| Meta-learner anti-overfitting holdout | Булактын өзүнчө ыкма түшүндүрмөсүндө %30 temporal holdout |
| SLM | Gemma-3-1b-it |
| MirrorPrompt баа терезеси | w = 8 |
| MirrorPrompt ensemble | K = 3 терезе |
| SLM temperature | 0 |
| LSTM түзүмү | 64 → 32 → 16 |
| LSTM sequence length | L = 10 |
| Dropout | 0,2 |
| Optimizer | Adam |
| Learning rate | 0,001 |
| Batch size | 32 |
| Early stopping | Cross-validation үчүн 15, final training үчүн 25 epoch patience |
| Temporal Random Forest | 100 tree, max depth 20 |
| Meta Random Forest | 20 estimator, max depth 5 |
| ML аралашмасы | 0,7 LSTM + 0,3 RF |
| Maximum calibrated confidence | 0,85 |
| Single-step relative change чеги | 0,5 |
%30 meta-learning temporal holdout менен training бөлүгүнүн акыркы %10 бөлүгүнө бөлүнгөн internal validation так кандайча бири-биринин ичинде колдонулганы булакта жетиштүү түшүндүрүлгөн эмес. Ошондуктан аларды бир гана катыш катары бириктирүүгө болбойт.
LSTM training жоготуусу
\[ L_{LSTM} = \frac{1}{N} \sum_{i=1}^{N} (y_i-\hat y_{LSTM,i})^2 \]
Бул Mean Squared Error жоготуусу LSTMге божомолдонгон жана чыныгы нормалдаштырылган баанын ортосундагы квадраттык айырманы азайтууга мүмкүндүк берет.
Meta-learner training максаты
Meta-learnerдин ground-truth белгиси validation маалыматында кайсы эксперт азыраак ката бергенине жараша түзүлөт. Meta-classifier үчүн булакта cross-entropy түрүндө:
\[ L_{meta} = -\frac{1}{T} \sum_{t=1}^{T} \left[ y_t^{SLM}\log P(SLM|z_t) + y_t^{ML}\log P(ML|z_t) \right] \]
колдонулат.
\(y_t^{SLM}=1\), тиешелүү кадамда SLM азыраак ката чыгарганда; \(y_t^{ML}=1-y_t^{SLM}\) болсо убакыттык модель ийгиликтүүрөөк болгондо колдонулат.
Баалоо метрикалары
MAE:
\[ MAE= \frac{1}{n} \sum_{i=1}^{n} |y_i-\hat y_i| \]
RMSE:
\[ RMSE= \sqrt{ \frac{1}{n} \sum_{i=1}^{n} (y_i-\hat y_i)^2 } \]
жана coefficient of determination:
\[ R^2= 1- \frac{ \sum_{i=1}^{n}(y_i-\hat y_i)^2 }{ \sum_{i=1}^{n}(y_i-\bar y)^2 } \]
колдонулат. Булак ошондой эле confidence calibration үчүн reliability diagram жана bin-негизиндеги calibration error баалоосун жүргүзгөнүн белгилейт.
Салыштырылган baseline моделдер
| Модель үй-бүлөсү | Моделдер |
|---|---|
| Салттуу machine learning | DTC, RFC, AdaBoost, SVM |
| Deep learning | LSTM, CNN-LSTM |
| Transformer | Standard Transformer, Informer, TFT |
| Сунушталган система | ASTIF |
Жети активдеги MAE жана RMSE жыйынтыктары
| Актив | ASTIF MAE | ASTIF RMSE | Эң жакшы baseline MAE | MAE жакшыртуусу |
|---|---|---|---|---|
| CTX | 0,0226 | 0,0576 | 0,0247 — LSTM | %8,5 |
| FET | 0,0133 | 0,0521 | 0,0324 — Informer | %59,0 |
| NMR | 0,0158 | 0,0305 | 0,0245 — Informer | %35,5 |
| OCEAN | 0,0168 | 0,0421 | 0,0181 — Informer | %7,2 |
| AGIX | 0,0213 | 0,0558 | 0,0236 — Informer | %9,7 |
| MSFT | 0,0222 | 0,0440 | 0,0243 — LSTM | %8,6 |
| NVDA | 0,0073 | 0,0130 | 0,0138 — Informer | %47,1 |
ASTIFтин жети активдин баарында эң төмөн MAE бериши — изилдөөнүн эң так салыштырма жыйынтыгы. Эң чоң салыштырмалуу пайда FETте, экинчи чоң пайда NVDAда, эң кичине пайда болсо OCEANда билдирилген.
ASTIFтин Артыкчылыгы Бардык Ката Өлчөмдөрүндө Күчүндөбү?
Жок. Булак ASTIFти жалпысынан бардык baseline моделдерден артык деп чечмелегени менен, 1-таблицанын деталдуу маанилери ASTIF жети активдин баарында эң төмөн MAE бергенин, бирок эң төмөн RMSEни NMR, MSFT жана NVDAда гана бергенин көрсөтөт; CTXте LSTM, FETте Informer/TFT, OCEAN жана AGIXте Informer төмөнүрөөк RMSE маанисине ээ. Ошондуктан эң бекем жыйынтык MAE артыкчылыгы болуп саналат; “бардык өлчөмдөрдө абсолюттук артыкчылык” булак таблицасы тарабынан колдоого алынбайт.
RMSE боюнча актив деңгээлиндеги айырма
| Актив | Эң төмөн RMSE модели | Эң төмөн RMSE | ASTIF RMSE |
|---|---|---|---|
| CTX | LSTM | 0,0422 | 0,0576 |
| FET | Informer / TFT | 0,0447 | 0,0521 |
| NMR | ASTIF | 0,0305 | 0,0305 |
| OCEAN | Informer | 0,0256 | 0,0421 |
| AGIX | Informer | 0,0378 | 0,0558 |
| MSFT | ASTIF | 0,0440 | 0,0440 |
| NVDA | ASTIF | 0,0130 | 0,0130 |
Бул айырма MAE менен RMSE ар кандай ката мүнөздөмөлөрүнө сезгич экенин да көрсөтөт. RMSE чоң каталарды квадратка көтөргөндүктөн, аз сандагы чоң божомол четтөөлөрүнө MAEге караганда көбүрөөк салмак берет.
Булак сүрөттөрү көрсөткөн натыйжа
Булактагы 3-сүрөт ASTIFтин жети активдеги MAE маанилерин эң жакшы baseline менен катар көрсөтөт жана өзгөчө FET менен NVDAдагы айырмалар ачык көрүнөт. 4-сүрөт; орточо MAE, R², ката бөлүштүрүүсү жана айрым активдердеги модель салыштыруусун төрт панелде көрсөтөт. 5-сүрөт болсо NMR, CTX, MSFT жана NVDA үчүн actual жана predicted price trajectory сызыктарын салыштырат.
Бул сызыктардын визуалдык жактан жакын болушу өз алдынча trading profitability далили эмес. Ошол сыяктуу эле төмөн нормалдаштырылган баа катасы direction accuracy же risk-adjusted киреше менен бирдей мааниге ээ эмес; булак мындай trading backtest жүргүзгөн эмес.
Абляция: кайсы компонент канчалык маанилүү?
| Конфигурация | Алынып салынган компонент | NMR MAE | NMR RMSE | FET MAE | FET RMSE |
|---|---|---|---|---|---|
| ASTIF Baseline | Жок | 0,0109 | 0,0180 | 0,0146 | 0,0298 |
| Pure Machine Learning | SLM Channel | 0,0703 | 0,0881 | 0,1252 | 0,2459 |
| Non-Sequential ML | LSTM Modeling | 0,0618 | 0,0791 | 0,1201 | 0,2308 |
| Deterministic Framework | Uncertainty | 0,0420 | 0,0649 | 0,0682 | 0,1726 |
| Static Ensemble | Meta-Learner | 0,0367 | 0,0462 | 0,0629 | 0,1240 |
Булактын өзүнүн орточо өсүш эсебинде semantic SLM каналы алынып салынганда MAE %653, LSTM алынып салынганда %596, uncertainty механизми алынып салынганда %327 жана meta-learner алынып салынганда %285 өсөт.
Бирок бул абляция таблицасындагы ASTIF baseline маанилери негизги performance 1-таблицасындагы NMR жана FET ASTIF маанилери менен бирдей эмес. Булак бул айырманы ачык түшүндүрбөгөндүктөн, таблицалар ар башка эксперименттик контексттер катары каралышы керек.
Dual-channel encoding чындап салым кошобу?
Булак өкүл катары алынган волатилдүү бир криптоактивде толук dual-channel түзүм үчүн MAE 0,0133 деп билдирет. Numeric-only түзүм үчүн MAE 0,0325, semantic-only түзүм үчүн 0,0378. Булактын эсебине ылайык dual-channel ыкмасы тиешелүүлүгүнө жараша болжол менен %59,0 жана %64,7 жакшыртуу берет.
Экинчи баалоо активинде dual-channel артыкчылыгы азыраак экени айтылат: numeric-only ыкмага салыштырмалуу %3,4 жана semantic-only ыкмага салыштырмалуу %14,9.
Cross-asset context
Cross-asset expanded feature конфигурациясы каралган эки криптоактивде MAE 0,0278 жана 0,0292 маанилерин берген; негизги semantic configurationга салыштырмалуу %15,5 жана %9,6 жакшыртуу билдирилген. Volatility–momentum өзгөчөлүктөрү да салым кошкону, sentiment жана market indicator өзгөчөлүктөрү болсо чектелүүрөөк, бирок өлчөнө турган пайда бергендиги айтылган.
Temporal window сезгичтиги
Булак sensitivity analysisте терезе өлчөмү 8 маанисин эң жакшы accuracy–efficiency тең салмак катары билдирет. Window size 12 колдонулганда FET MAEси %47,3 жана NMR MAEси %42,0 өскөн. Авторлор муну overfitting жүрүм-туруму катары чечмелешет.
Ошондой эле эки-model ensemble бир-model түзүмгө салыштырмалуу FET жана NMRде тиешелүүлүгүнө жараша %5,3 жана %4,3 MAE жакшыртуусун бергени айтылып, татаалыраак ensemble түзүмдөр сөзсүз жакшыраак эмес деген жыйынтык чыгарылган.
Confidence бөлүштүрүүсү эмнени билдирет?
Булактагы 6-сүрөт semantic жана temporal каналдардын confidence бөлүштүрүүлөрүн көрсөтөт. Semantic confidence бөлүштүрүүсү жалпы жонунан жогору confidence аймагына жылса, temporal confidence төмөнүрөөк маанилерге топтолот. Авторлор эки канал бири-бирине жакындаган учурларда meta-learner confidence жогорулай турганын; каналдар айырмаланганда uncertainty көбөйөрүн чечмелешет.
Бул жыйынтык confidence маанилери реалдуу рынок коркунучунун баарын өлчөйт дегенди билдирбейт. Алар моделдин өзүнүн божомол түзүмү жана calibration механизминин ичиндеги белгисиздик көрсөткүчтөрү.
Изилдөө колдогон жыйынтыктар
- ASTIF каралган жети активдин баарында 1-таблицанын MAE өлчөмүнө ылайык салыштырылган baseline моделдерден төмөн ката берген.
- MAE артыкчылыгы активге жараша %7,2 менен %59,0 аралыгында өзгөрөт.
- Semantic SLM, temporal LSTM, uncertainty quantification жана meta-learning компоненттерин алып салуу абляция шарттарында натыйжаны начарлаткан.
- Dual-channel encoding булак эксперименттеринде single-channel түзүмдөргө караганда жакшыраак натыйжа берген.
- Cross-asset өзгөчөлүктөр жана орточо өлчөмдөгү temporal context айрым эксперименттерде тактыкты жакшырткан.
- Confidence-aware model selection булак эксперименттеринде semantic жана temporal эксперттерди бир статикалык салмак менен бириктирүүгө альтернативдүү механизм берген.
Изилдөө колдобогон жыйынтыктар
Изилдөө ASTIF бардык финансылык рыноктордо же бардык криптоактивдерде эң жакшы модель экенин көрсөтпөйт. Тест чөйрөсү AI менен байланышкан беш token жана эки технология акциясы менен чектелген.
Изилдөө реалдуу акча менен соода стратегиясын, transaction cost, spread, slippage, order-book impact, Sharpe ratio, Sortino ratio, maximum drawdown же портфель P&L тестин жүргүзгөн эмес. Ошондуктан төмөн MAE түздөн-түз кирешелүү trading стратегиясын билдирет деп айтууга болбойт.
Изилдөө multi-step forecasting системасы эмес; негизги милдет next-step prediction. Multi-step forecasting булакта келечектеги изилдөө темасы катары көрсөтүлгөн.
Система real-time жаңылык агымын колдонбойт. Булак historical data колдонулганын жана breaking news / real-time feed интеграциясы жок экенин ачык билдирет.
Булак жыйынтыктарды p-маанилер, confidence interval же көп random-seed performance бөлүштүрүүлөрү менен колдобойт. Ошондуктан baseline айырмачылыктарынын inferential statistical significance деңгээли тууралуу булактан тышкары бүтүм чыгарууга болбойт.
Чектөөлөр
| Чектөө | Жыйынтыктарды чечмелөөгө таасири |
|---|---|
| Prompt engineering domain эксперттигин талап кылат | Semantic channelдын натыйжасы prompt дизайнына сезгич болушу мүмкүн. |
| Эсептөө жүгү | Resource-constrained чөйрөлөрдө real-time колдонуу кыйындашы мүмкүн. |
| Чектелген активдер чөйрөсү | Жаңы tokenдерге жана альтернативдүү asset classтарга жалпылоо түздөн-түз көрсөтүлгөн эмес. |
| Historical data | Live market feed жана breaking-news шарттарындагы жүрүм-турум сыналган эмес. |
| Next-step forecast | Узак multi-step horizon натыйжасы белгисиз. |
| Негизги таблицалар арасында baseline айырмасы | NMR жана FET үчүн негизги benchmark менен ablation baseline маанилерин түз бириктирүүгө болбойт. |
| Validation катыштарынын түшүндүрмөсү | %30 meta holdout менен глобалдык split ичиндеги %10 internal validation байланышын кайра өндүрүү кошумча түшүндүрмөнү талап кылат. |
| Inferential significance отчёту жок | Модель айырмачылыктарынын p-маани же ишеним аралыгы деңгээлиндеги маанилүүлүгү булак тарабынан көрсөтүлгөн эмес. |
Келечектеги изилдөө багыттары
Булак келечекте real-time data интеграциясын, reinforcement learning менен automated prompt optimization, multi-step forecasting, кеңири asset class баалоосун жана edge computing optimization сунуштайт.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталыш: ASTIF: Adaptive Semantic-Temporal Integration for Cryptocurrency Price Forecasting
Авторлор: Hafiz Saif Ur Rehman, Ling Liu, Kaleem Ullah Qasim
Corresponding author: Ling Liu
Мекемелер: Southwestern University of Finance and Economics, Chengdu, Sichuan, China; Southwest Jiaotong University, Chengdu, Sichuan, China.
Булак түрү: arXiv preprint.
arXiv: 2512.18661v1
arXiv категориясы: cs.AI
Биринчи версиянын датасы: 21 Декабрь 2025.
Рецензия абалы: Ырасталган рецензияланган журнал басылмасы табылбагандыктан preprint катары каралган.
Журнал маалыматы: ArXiv иштеткен manuscript текстинде “journal: Nuclear Physics B” талаасы көрүнөт; бирок ушул аталыш менен текшериле турган Nuclear Physics B басылма жазуусу же өзүнчө журнал DOIси табылбагандыктан, бул билдирүү басылма статусу катары колдонулган эмес.
DOI: Ырасталган өз алдынча журнал DOIси жок. arXiv жазуусу 2512.18661 аркылуу аныкталат.
Маалымат мезгили: Январь 2020 – Декабрь 2024.
Максаттуу активдер: FET, AGIX, NMR, OCEAN, CTX, MSFT, NVDA.
Негизги модель: MirrorPrompt SLM + LSTM–Random Forest temporal learner + confidence-calibrated Random Forest meta-learner.
SLM: Gemma-3-1b-it, LM Studio API.
Негизги баалоо метрикалары: MAE, RMSE, R² жана calibration error.
Маалымат жеткиликтүүлүгү: Берилген PDFте өзүнчө Data Availability Statement же текшериле турган public dataset repository шилтемеси жок.
Код жеткиликтүүлүгү: Берилген PDFте текшериле турган GitHub же код repository шилтемеси жок.
Каржылоо: Берилген PDFте өзүнчө funding statement аныкталган эмес.
Кызыкчылыктардын кагылышы: Берилген PDFте өзүнчө conflict-of-interest statement аныкталган эмес.
Автордук салымдар: Өзүнчө CRediT/автордук салым билдирүүсү аныкталган эмес.
Лицензия: Берилген PDF жана текшериле турган баштапкы библиографиялык жазууда ачык кайра колдонуу лицензиясы ишенимдүү түрдө аныкталбагандыктан, лицензия бар деп кабыл алынган эмес. Булактагы фигуралар түз көчүрүлбөшү; сандык маалыматтар жана илимий байланыштар Verianla үчүн өз алдынча кайра чийилиши керек.
Булак ичиндеги чечмелөө эскертүүсү: 1-таблица ASTIF бардык максаттарда эң төмөн MAE бергенин көрсөткөнү менен, бардык максаттарда эң төмөн RMSE бербегенин көрсөтөт. Ошондуктан булак баянындагы жалпы “outperforms all baselines” билдирүүсү эң коопсуз түрдө MAE жана булакта берилген жалпы баалоо контекстинде чечмелениши керек.
Булак ичиндеги reproducibility эскертүүсү: 1-таблица менен Table 3 ичиндеги NMR/FET ASTIF baseline маанилери айырмаланат. Ошондой эле meta-learner үчүн берилген %30 temporal holdout менен глобалдык %80/%20 split ичиндеги акыркы %10 internal validation ортосундагы колдонуу байланышы булакта толук түшүндүрүлгөн эмес.
Негизги ыкма чеги: Бул изилдөө тарыхый күнүмдүк маалыматта next-step forecast натыйжасын өлчөйт. Real-time жаңылык агымы, жандуу trading, transaction cost жана реалдуу акча портфель performance изилдөөнүн эксперименттик чегинен тышкары.
Автордук укук/баяндоо ыкмасы: Verianla тексти булак изилдөөнүн сүйлөмдөрүн же фигура дизайнын кайра чыгарбайт. Ыкма, математика, эксперимент параметрлери, таблица маанилери жана жыйынтык чектери булак изилдөөдөн алынып, өз алдынча үйрөтүүчү Кыргызча түзүмдө кайра уюштурулган.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген