


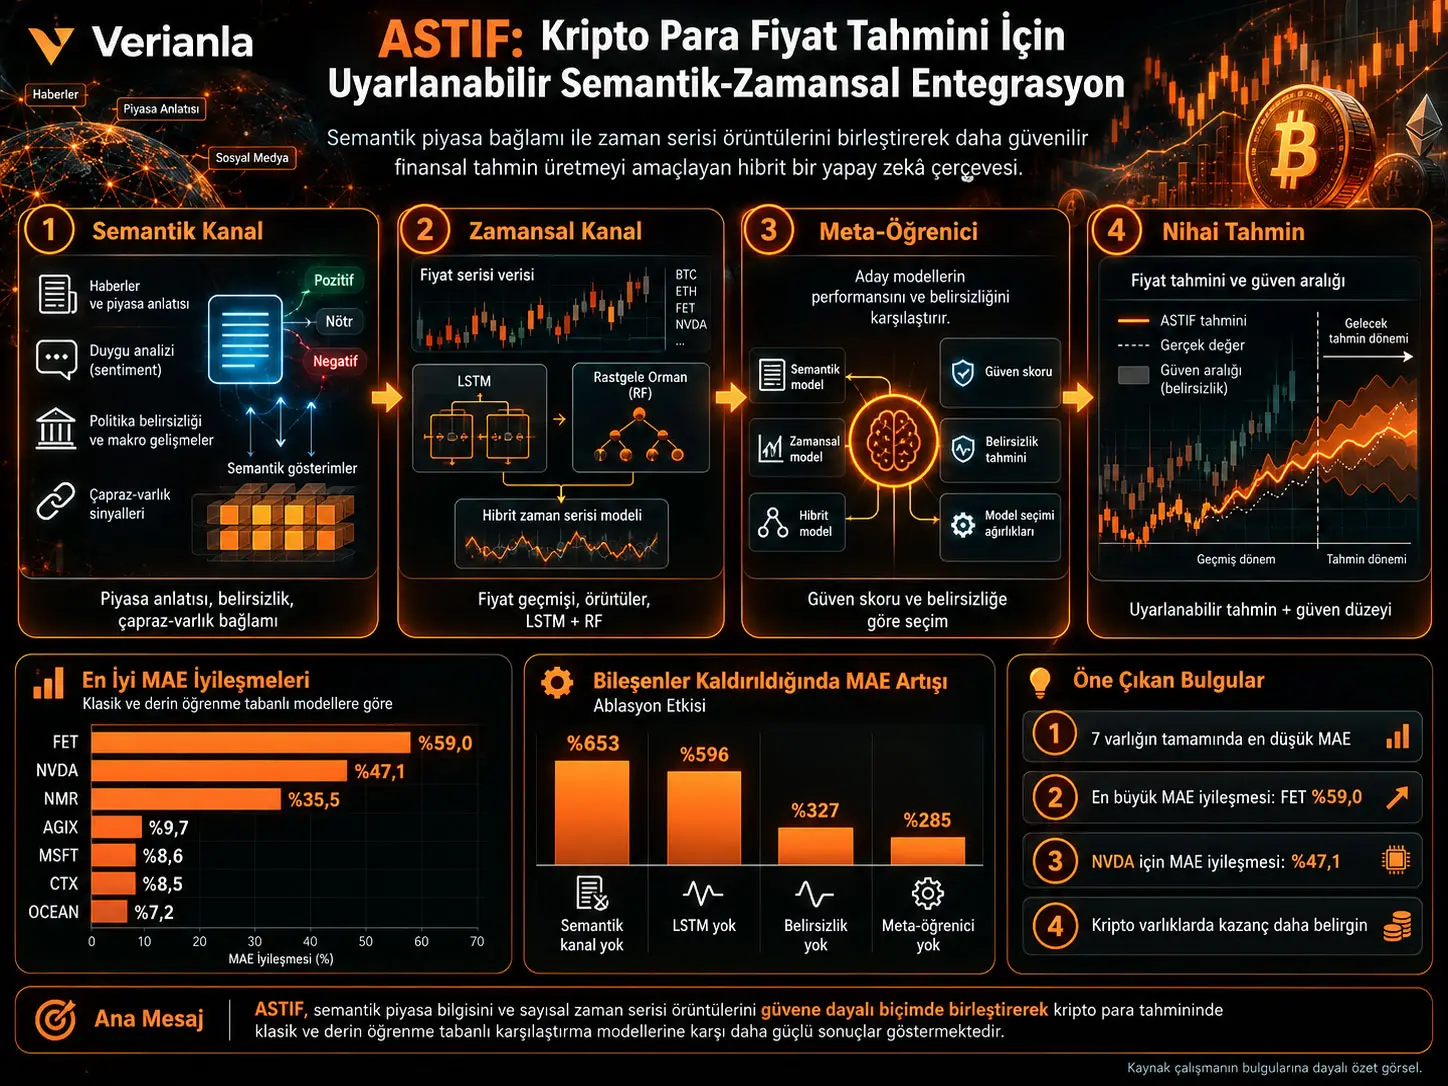
ASTIF — Adaptive Semantic-Temporal Integration Framework — semantik piyasa bağlamını ve sayısal zaman serisi örüntülerini ayrı tahmin kanallarında işleyen, ardından tahmin güveni ve belirsizliğine göre bu kanallar arasında uyarlanabilir seçim yapan hiyerarşik bir finansal tahmin mimarisidir. Çalışma, yalnız geçmiş fiyat hareketlerinin kripto para piyasasındaki politika belirsizliği, piyasa anlatıları, sentiment göstergeleri ve çapraz-varlık ilişkilerini yeterince temsil edemeyebileceği probleminden hareket etmektedir. ASTIF bu problemi üç bileşenle ele alır: MirrorPrompt tabanlı Small Language Model semantik tahminci, LSTM–Random Forest hibrit zamansal tahminci ve bu iki uzmanın güvenilirliğini değerlendiren confidence-calibrated meta-learner.
Deneyler Ocak 2020–Aralık 2024 dönemindeki günlük veriler üzerinde yürütülmüştür. Beş AI-bağlantılı kripto varlık — FET, AGIX, NMR, OCEAN ve CTX — ile NVIDIA ve Microsoft hisseleri değerlendirilmiştir. Sistemin girdileri yalnız hedef varlığın fiyatından oluşmaz; Bitcoin, Ethereum, çeşitli token sektörleri, hisse endeksleri, tematik ETF'ler, petrol, altın, cross-asset correlation, momentum, SMA/EMA, volatilite, RSI, Bollinger Bands, Global Economic Policy Uncertainty ve çeşitli medya/sentiment göstergelerini kapsayan 29'dan fazla özellik kullanılmıştır.
Kaynağın ana karşılaştırmasına göre ASTIF yedi varlığın tamamında en düşük MAE'yi vermiştir. En iyi baseline modele göre MAE azalması FET için %59,0, NVDA için %47,1, NMR için %35,5, AGIX için %9,7, MSFT için %8,6, CTX için %8,5 ve OCEAN için %7,2'dir. Ancak bu üstünlük bütün hata ölçütlerinde aynı değildir: Tablo 1'de ASTIF tüm varlıklarda en düşük RMSE'yi vermemektedir. Bu nedenle bulgu, “ASTIF bütün metriklerde bütün modelleri yendi” şeklinde yorumlanmamalıdır.
Ablasyon deneyleri semantik ve zamansal kanalların birlikte çalışmasının önemli olduğunu göstermektedir. Kaynağın ablasyon hesabında SLM semantic channel kaldırıldığında ortalama MAE artışı %653, LSTM bileşeni kaldırıldığında %596, uncertainty quantification kaldırıldığında %327 ve adaptive meta-learner kaldırıldığında %285 olarak raporlanmıştır. Bununla birlikte bu ablasyon bölümündeki NMR ve FET baseline değerleri ana performans tablosundaki ASTIF değerlerinden farklıdır; kaynak iki deney bağlamını açık biçimde uzlaştırmamaktadır.
Çalışma gerçek zamanlı kripto para işlem sistemi veya yatırım stratejisi testi değildir. İşlem maliyeti, spread, slippage, portföy getirisi, Sharpe oranı, maksimum drawdown veya gerçek para P&L değerlendirmesi yapılmamıştır. Ayrıca kullanılan veri tarihsel günlük veridir ve kaynak, gerçek zamanlı data feed ile breaking-news bilgisinin sisteme dâhil edilmediğini açıkça sınırlılık olarak belirtmektedir.
ASTIF Nedir ve Statik Finansal Tahmin Modellerinden Nasıl Ayrılır?
ASTIF, semantik piyasa bilgisini işleyen bir Small Language Model kanalı ile tarihsel sayısal örüntüleri işleyen LSTM–Random Forest kanalını aynı tahmin sisteminde birleştiren ve hangi kanalın o anda daha güvenilir olduğuna confidence-calibrated meta-learning ile karar veren uyarlanabilir bir ensemble mimarisidir. Statik ensemble'lardan temel farkı, iki uzmana önceden belirlenmiş değişmez bir ağırlık vermek yerine tahmin güveni, belirsizlik, model uyuşmazlığı ve piyasa bağlamını her karar adımında meta-feature olarak değerlendirmesidir.
Araştırmanın çözmeye çalıştığı problem
Kripto para piyasalarında fiyat üretim süreci durağan değildir. Piyasa davranışı, volatilite düzeyi, makroekonomik koşullar, düzenleyici gelişmeler, cross-asset ilişkiler ve yatırımcı davranışları zaman içinde değişebilir. Bu nedenle belirli bir dönemde başarılı olan tahmin biçiminin farklı piyasa rejiminde aynı derecede başarılı olması garanti değildir.
Kaynağa göre mevcut yöntemlerde üç temel boşluk öne çıkmaktadır. Birincisi, birçok istatistiksel, derin öğrenme ve Transformer modeli tahmin stratejisini piyasa rejimine göre değiştirmeyen statik mimariler kullanır. İkincisi, semantic market information çoğu hibrit sistemde yalnız tek bir sentiment skoru gibi sayısal bir özellik olarak fiyat girdilerine eklenir. Üçüncüsü, semantik ve zamansal tahmincilerin gerçek zamanlı güvenilirliğini karşılaştırıp hangisine güvenileceğini belirleyen cross-modal adaptation mekanizmaları sınırlıdır.
Üç araştırma sorusu
| Araştırma sorusu | İncelenen konu |
|---|---|
| RQ1 | ASTIF, geleneksel makine öğrenmesi, derin öğrenme ve Transformer baseline'larına karşı tahmin doğruluğu ve kararlılık bakımından nasıl performans gösteriyor? |
| RQ2 | Confidence-based meta-learner ve uncertainty quantification gibi uyarlanabilir bileşenler toplam performansa ne ölçüde katkı sağlıyor? |
| RQ3 | Çift kanallı semantic encoding, numeric-only veya semantic-only yaklaşımlardan daha iyi sonuç veriyor mu? |
ASTIF'in üç temel bileşeni
| Bileşen | Temel görev | Çıktı |
|---|---|---|
| MirrorPrompt SLM | Fiyat dizisini numeric channel'da, piyasa bağlamını semantic channel'da işler. | SLM tahmini, confidence ve uncertainty. |
| LSTM–Random Forest Temporal Learner | Zamansal bağımlılıkları ve özellik etkileşimlerini öğrenir. | ML tahmini, model uyuşmazlığına dayalı uncertainty ve confidence. |
| Confidence-Calibrated Meta-Learner | Her iki uzmanı confidence, uncertainty ve piyasa bağlamına göre değerlendirir. | SLM veya ML kanalının seçimi ve nihai tahmin. |
Finansal tahmin problemi nasıl formüle ediliyor?
Çalışma günlük çok-varlıklı zaman serisini rejim değişimleri ve heteroskedastik gürültü altında ele almaktadır. \(X_t\), \(t\) anındaki çapraz-varlık sinyalleri, sentiment göstergeleri ve teknik özellikleri; \(p_t\) ise normalize edilmiş hedef kapanış fiyatını gösterir.
\[ \hat{f}=\arg\min_f \mathbb{E}_{(X_t,p_t)\sim P_t} \left[ \ell\left(p_{t+1},f(X_{1:t},p_{1:t})\right) \right] \]
Burada amaç, dağılımın zaman içinde değişebildiği \(P_t\) altında bir sonraki günün fiyat tahminindeki beklenen kaybı azaltmaktır. \(\ell\) mutlak veya karesel hata kaybını temsil eder. Formül, sistemin yalnız sabit bir veri dağılımında değil değişen piyasa koşullarında tahmin yapmayı hedeflediğini matematiksel olarak ifade eder.
Veri evreni
| Grup | Varlık / özellik örnekleri |
|---|---|
| AI-bağlantılı kripto hedefleri | FET, AGIX, NMR, OCEAN, CTX |
| Teknoloji hissesi hedefleri | NVDA, MSFT |
| Temel kripto piyasası | BTC, ETH |
| Token sektörleri | DeFi, NFT, Energy, Gold, Healthcare, Asset Management, Lending & Borrowing |
| Hisse/endeks bağlamı | S&P, NASDAQ AI & Robotics, NASDAQ Internet, Dow Jones Basic Materials, Dow Jones Oil & Gas |
| Emtia | Ham petrol, altın |
| Tematik ETF'ler | Clean Energy, Robotics & AI, ROBO, Fintech Global ETF'leri |
| Semantic/policy değişkenleri | Panic Index, Media Hype Index, Media Coverage Index, Fake News Index, Infodemic Index, GEPU |
Kripto para fiyatlarının CoinMarketCap, petrol verisinin Energy Information Administration ve çeşitli equity/index/ETF verilerinin Thomson Reuters kaynaklarından alındığı belirtilmektedir.
Özellik mühendisliği
Bütün değişkenler Min-Max yöntemiyle \([0,1]\) aralığına ölçeklenmektedir:
\[ x_i'= \frac{x_i-\min(X)} {\max(X)-\min(X)} \]
Bu dönüşüm farklı ölçeklerdeki finansal değişkenleri ortak sayısal aralığa taşır. Ancak kaynak, \(\min(X)\) ve \(\max(X)\) değerlerinin yalnız eğitim setinden mi hesaplandığını açık bir cümleyle belirtmemektedir. Çalışma kronolojik bölme ve leakage'den kaçınma hedefini ifade etse de scaler fitting ayrıntısı yeniden üretilebilirlik açısından daha açık raporlanabilirdi.
Teknik özellikler arasında farklı gecikmeler için momentum:
\[ M_{t,k}= \frac{p_t-p_{t-k}}{p_{t-k}}, \qquad k\in\{1,2,3,5,7\} \]
SMA, EMA, rolling volatility, RSI, Bollinger Bands ve rolling cross-asset correlation bulunmaktadır. Çapraz-varlık korelasyonu:
\[ \rho_{i,j}(t) = \operatorname{corr} \left( p_{i,t-w:t}, p_{j,t-w:t} \right) \]
biçiminde ifade edilmektedir.
MirrorPrompt Nedir ve Çift Kanal Neyi Ayırır?
MirrorPrompt, aynı piyasa durumunu iki ayrı temsil üzerinden Small Language Model'e sunan bir semantic predictor yapısıdır: numeric channel son fiyat dizisini yüksek hassasiyetli sayısal gösterim olarak korurken semantic channel momentum, volatilite, cross-asset göstergeleri ve sentiment/policy değişkenlerinden doğal dil bağlamı üretir; böylece nicel örüntü ile bağlamsal yorum tek bir ham feature vektörüne indirgenmeden işlenir.
Numeric channel
Numeric channel geçmiş fiyat dizisini:
\[ n_t = [p_{t-w+1},p_{t-w+2},...,p_t] \]
biçiminde ve altı ondalık basamak hassasiyetinde sunmaktadır. Uygulama bölümünde MirrorPrompt için \(w=8\) geçmiş fiyat kullanıldığı belirtilmiştir.
Semantic channel
Semantic channel bağlamı:
\[ S(c_t) = f_{\mathrm{template}} (\Delta p_t,\sigma_t,I_t,S_t) \]
şeklinde üretmektedir. Burada \(\Delta p_t\) fiyat değişimini, \(\sigma_t\) volatiliteyi, \(I_t\) çapraz-varlık göstergelerini ve \(S_t\) sentiment/policy özelliklerini temsil eder.
Önemli bir ayrım vardır: sistem doğrudan breaking-news metinlerini veya canlı haber akışını okumamaktadır. Kaynaktaki semantic channel, yapılandırılmış piyasa ve sentiment göstergelerini template-driven doğal dil açıklamalarına dönüştürmektedir.
Üç örtüşen pencere ve confidence-weighted tahmin
MirrorPrompt \(K=3\) örtüşen pencere üretir. Her pencere bir return tahmini \(\hat r_k\) ve confidence \(c_k\) verir. Small Language Model deterministic sampling ile, yani temperature \(\tau=0\) kullanılarak çalıştırılır.
\[ \hat r_{\mathrm{SLM}} = \frac{\sum_{k=1}^{K} c_k\hat r_k} {\sum_{k=1}^{K}c_k} \]
\[ c_{\mathrm{SLM}} = \frac{1}{K} \sum_{k=1}^{K}c_k \]
\[ u_{\mathrm{SLM}} = 1-\min(c_{\mathrm{SLM}},1) \]
Dolayısıyla yüksek confidence veren pencerenin return tahmini ensemble sonucunda daha yüksek ağırlık alır; uncertainty ise confidence'ın tamamlayıcısı olarak meta-learner'a aktarılır.
SLM uygulama ayrıntıları
Deneylerde Small Language Model olarak Gemma-3-1b-it LM Studio API üzerinden kullanılmıştır. Response timeout 30 saniye, varsayılan max_tokens=150, reasoning modelleri için 600 ve temperature değeri 0 olarak raporlanmaktadır.
LSTM–Random Forest temporal predictor
Zamansal kanal iki farklı model ailesini birleştirir. LSTM geçmiş sıradaki uzun ve kısa bağımlılıkları işlerken Random Forest özellikler arasındaki doğrusal olmayan etkileşimleri yakalamaya çalışır.
LSTM üç katmandan oluşur:
64 → 32 → 16 birim
ve sequence length \(L=10\), dropout 0,2, batch normalization, Adam optimizer ve öğrenme oranı 0,001 kullanır.
LSTM'nin temel hücre işlemleri kaynakta şu zincirle verilmektedir:
\[ f_t=\sigma(W_f[h_{t-1},x_t]+b_f) \]
\[ i_t=\sigma(W_i[h_{t-1},x_t]+b_i) \]
\[ \tilde C_t= \tanh(W_C[h_{t-1},x_t]+b_C) \]
\[ C_t=f_t\odot C_{t-1}+i_t\odot\tilde C_t \]
\[ o_t=\sigma(W_o[h_{t-1},x_t]+b_o), \qquad h_t=o_t\odot\tanh(C_t) \]
Random Forest kanalı 100 tree kullanır. Kaynak maksimum depth değerini 20 olarak vermekte ve minimum-sample kısıtlarıyla overfitting'i sınırlandırmayı amaçlamaktadır.
Nihai temporal prediction uygulama bölümünde:
\[ \hat y^{ML} = 0.7\hat y^{LSTM} + 0.3\hat y^{RF} \]
şeklinde sabit bir LSTM–RF karışımıdır.
Zamansal kanalın belirsizliği
İki model arasındaki göreli uyuşmazlık:
\[ u_{ML,t} = \frac{ |\hat y_{t+1}^{LSTM}-\hat y_{t+1}^{RF}| }{ \max( \hat y_{t+1}^{LSTM}, \hat y_{t+1}^{RF} ) } \]
ile hesaplanmaktadır. Ardından:
\[ c_{ML,t}=1-u_{ML,t} \]
olarak confidence elde edilir. Bu yaklaşım, iki temporal model aynı sonuca yaklaştığında daha yüksek, birbirinden uzaklaştığında daha düşük güven üretme mantığına dayanır.
Meta-learner neye bakıyor?
Meta-learner 12 boyutlu bir \(z_t\) feature vector üzerinde çalışan Random Forest classifier'dır. Kaynakta verilen temel meta-feature'lar şunlardır: iki kanalın confidence değerleri, uncertainty değerleri, tahminler arasındaki göreli fark, confidence ve uncertainty farkları, volatilite, trend gücü, son dönem model accuracy değerleri ve fiyat momentumu.
Meta-classifier 20 estimator ve maximum depth 5 kullanır. Kaynak ayrıca minimum-sample kısıtlarından ve temporal validation'dan söz eder.
Meta-selection
Meta-selector:
\[ \delta(z_t)\in\{\mathrm{SLM},\mathrm{ML}\} \]
olarak tanımlanır ve hangi tahmin kanalının kullanılacağını seçer.
İki kanalın göreli disagreement değeri:
\[ d_t= \frac{ |\hat y_{t+1}^{SLM}-\hat y_{t+1}^{ML}| }{ \max( \hat y_{t+1}^{SLM}, \hat y_{t+1}^{ML} ) } \]
ile ölçülmektedir.
Confidence calibration
Kaynak meta-classifier'ın ham probability değerini ortalama kanal confidence değerine göre yeniden ölçeklemektedir:
\[ p_{\mathrm{cal}}= \begin{cases} 0.4+0.2(p_{\mathrm{raw}}-0.5), & \bar c<0.6\\ 0.3+0.4p_{\mathrm{raw}}, & 0.6\leq \bar c<0.8\\ 0.2+0.6p_{\mathrm{raw}}, & \bar c\geq0.8 \end{cases} \]
Burada:
\[ \bar c= \frac{c_{SLM}+c_{ML}}{2} \]
olup kalibre edilmiş confidence değeri en fazla 0,85 ile sınırlandırılmaktadır. Bu sınır, meta-learner'ın özellikle volatil koşullarda aşırı güvenli davranmasını önlemeyi amaçlayan kaynak-tanımlı bir güvenlik mekanizmasıdır.
Sanity check
Nihai tahmin \([0,1]\) normalize domain içinde kalmalıdır. Ayrıca tek-adım göreli değişim:
\[ \frac{|\hat y_i-p_t|}{p_t}\leq\tau_{\max} \]
koşuluna tabidir ve kaynakta:
\[ \tau_{\max}=0.5 \]
olarak verilmiştir. Bir tahmin bu sınırları ihlal ederse sistem alternatif modele geçebilir veya daha korumacı prediction capping uygulayabilir.
Çalışmanın Yöntemi ve Bulguları
Eğitim ve değerlendirme düzeni
| Öğe | Kaynakta verilen değer |
|---|---|
| Veri dönemi | Ocak 2020 – Aralık 2024 |
| Frekans | Günlük |
| Global veri bölümü | %80 eğitim, %20 test |
| İç doğrulama | Eğitim bölümünün son %10'u |
| Meta-learner anti-overfitting holdout | Kaynağın ayrı yöntem açıklamasında %30 temporal holdout |
| SLM | Gemma-3-1b-it |
| MirrorPrompt fiyat penceresi | w = 8 |
| MirrorPrompt ensemble | K = 3 pencere |
| SLM temperature | 0 |
| LSTM yapısı | 64 → 32 → 16 |
| LSTM sequence length | L = 10 |
| Dropout | 0,2 |
| Optimizer | Adam |
| Learning rate | 0,001 |
| Batch size | 32 |
| Early stopping | Cross-validation için 15, final training için 25 epoch patience |
| Temporal Random Forest | 100 tree, max depth 20 |
| Meta Random Forest | 20 estimator, max depth 5 |
| ML karışımı | 0,7 LSTM + 0,3 RF |
| Maximum calibrated confidence | 0,85 |
| Single-step relative change sınırı | 0,5 |
%30 meta-learning temporal holdout ile eğitim bölümünün son %10'una ayrılan internal validation'ın tam olarak nasıl iç içe uygulandığı kaynakta yeterince açıklanmamaktadır. Bu nedenle bunlar tek bir oranmış gibi birleştirilmemelidir.
LSTM eğitim kaybı
\[ L_{LSTM} = \frac{1}{N} \sum_{i=1}^{N} (y_i-\hat y_{LSTM,i})^2 \]
Bu Mean Squared Error kaybı, LSTM'nin tahmin edilen ve gerçek normalize fiyat arasındaki karesel farkı küçültmesini sağlar.
Meta-learner eğitim hedefi
Meta-learner'ın ground-truth etiketi, validation verisinde hangi uzmanın daha düşük hata verdiğine göre oluşturulur. Meta-classifier için kaynakta cross-entropy biçiminde:
\[ L_{meta} = -\frac{1}{T} \sum_{t=1}^{T} \left[ y_t^{SLM}\log P(SLM|z_t) + y_t^{ML}\log P(ML|z_t) \right] \]
kullanılmaktadır.
\(y_t^{SLM}=1\), ilgili adımda SLM daha düşük hata ürettiğinde; \(y_t^{ML}=1-y_t^{SLM}\) ise temporal model daha başarılı olduğunda kullanılır.
Değerlendirme metrikleri
MAE:
\[ MAE= \frac{1}{n} \sum_{i=1}^{n} |y_i-\hat y_i| \]
RMSE:
\[ RMSE= \sqrt{ \frac{1}{n} \sum_{i=1}^{n} (y_i-\hat y_i)^2 } \]
ve coefficient of determination:
\[ R^2= 1- \frac{ \sum_{i=1}^{n}(y_i-\hat y_i)^2 }{ \sum_{i=1}^{n}(y_i-\bar y)^2 } \]
kullanılmaktadır. Kaynak ayrıca confidence calibration için reliability diagram ve bin-bazlı calibration error değerlendirmesi yaptığını belirtmektedir.
Karşılaştırılan baseline modeller
| Model ailesi | Modeller |
|---|---|
| Geleneksel makine öğrenmesi | DTC, RFC, AdaBoost, SVM |
| Derin öğrenme | LSTM, CNN-LSTM |
| Transformer | Standard Transformer, Informer, TFT |
| Önerilen sistem | ASTIF |
Yedi varlıktaki MAE ve RMSE sonuçları
| Varlık | ASTIF MAE | ASTIF RMSE | En iyi baseline MAE | MAE iyileşmesi |
|---|---|---|---|---|
| CTX | 0,0226 | 0,0576 | 0,0247 — LSTM | %8,5 |
| FET | 0,0133 | 0,0521 | 0,0324 — Informer | %59,0 |
| NMR | 0,0158 | 0,0305 | 0,0245 — Informer | %35,5 |
| OCEAN | 0,0168 | 0,0421 | 0,0181 — Informer | %7,2 |
| AGIX | 0,0213 | 0,0558 | 0,0236 — Informer | %9,7 |
| MSFT | 0,0222 | 0,0440 | 0,0243 — LSTM | %8,6 |
| NVDA | 0,0073 | 0,0130 | 0,0138 — Informer | %47,1 |
ASTIF'in yedi varlığın tamamında en düşük MAE'yi vermesi çalışmanın en net karşılaştırmalı sonucudur. En büyük göreli kazanç FET'te, ikinci en büyük kazanç NVDA'da, en küçük kazanç ise OCEAN'da raporlanmıştır.
ASTIF'in Üstünlüğü Bütün Hata Ölçütlerinde Geçerli mi?
Hayır. Kaynak ASTIF'i genel olarak bütün baseline'lardan üstün olarak yorumlasa da Tablo 1'in ayrıntılı değerleri ASTIF'in yedi varlığın tamamında en düşük MAE'yi verdiğini, fakat en düşük RMSE'yi yalnız NMR, MSFT ve NVDA'da verdiğini göstermektedir; CTX'te LSTM, FET'te Informer/TFT, OCEAN ve AGIX'te Informer daha düşük RMSE değerine sahiptir. Bu nedenle en sağlam sonuç MAE üstünlüğüdür; “bütün ölçütlerde mutlak üstünlük” kaynak tablosu tarafından desteklenmez.
RMSE bakımından varlık düzeyindeki ayrım
| Varlık | En düşük RMSE modeli | En düşük RMSE | ASTIF RMSE |
|---|---|---|---|
| CTX | LSTM | 0,0422 | 0,0576 |
| FET | Informer / TFT | 0,0447 | 0,0521 |
| NMR | ASTIF | 0,0305 | 0,0305 |
| OCEAN | Informer | 0,0256 | 0,0421 |
| AGIX | Informer | 0,0378 | 0,0558 |
| MSFT | ASTIF | 0,0440 | 0,0440 |
| NVDA | ASTIF | 0,0130 | 0,0130 |
Bu fark MAE ile RMSE'nin farklı hata özelliklerine duyarlı olduğunu da gösterir. RMSE büyük hataları karelediği için az sayıdaki büyük tahmin sapmasına MAE'den daha fazla ağırlık verir.
Kaynak şekillerinin anlattığı performans
Kaynak Şekil 3, ASTIF'in yedi varlıktaki MAE değerlerini en iyi baseline ile yan yana göstermektedir ve özellikle FET ile NVDA'daki farklar belirgindir. Şekil 4; ortalama MAE, R², hata dağılımı ve bazı varlıklardaki model karşılaştırmasını dört panelde göstermektedir. Şekil 5 ise NMR, CTX, MSFT ve NVDA için actual ve predicted price trajectory çizgilerini karşılaştırmaktadır.
Bu çizgilerin görsel olarak yakın olması tek başına trading profitability kanıtı değildir. Aynı şekilde düşük normalize fiyat hatası, direction accuracy veya risk-adjusted getiri ile eşanlamlı değildir; kaynak bu tür bir trading backtest gerçekleştirmemiştir.
Ablasyon: hangi bileşen ne kadar önemli?
| Konfigürasyon | Kaldırılan bileşen | NMR MAE | NMR RMSE | FET MAE | FET RMSE |
|---|---|---|---|---|---|
| ASTIF Baseline | Yok | 0,0109 | 0,0180 | 0,0146 | 0,0298 |
| Pure Machine Learning | SLM Channel | 0,0703 | 0,0881 | 0,1252 | 0,2459 |
| Non-Sequential ML | LSTM Modeling | 0,0618 | 0,0791 | 0,1201 | 0,2308 |
| Deterministic Framework | Uncertainty | 0,0420 | 0,0649 | 0,0682 | 0,1726 |
| Static Ensemble | Meta-Learner | 0,0367 | 0,0462 | 0,0629 | 0,1240 |
Kaynağın kendi ortalama artış hesabında semantic SLM kanalı kaldırıldığında MAE %653, LSTM kaldırıldığında %596, uncertainty mekanizması kaldırıldığında %327 ve meta-learner kaldırıldığında %285 artmaktadır.
Ancak bu ablasyon tablosundaki ASTIF baseline değerleri ana performans Tablo 1'deki NMR ve FET ASTIF değerleriyle aynı değildir. Kaynak bu farkı açık biçimde açıklamadığından tablolar farklı deney bağlamları olarak ele alınmalıdır.
Dual-channel encoding gerçekten katkı sağlıyor mu?
Kaynak, temsilî bir volatil kripto varlıkta tam dual-channel yapı için MAE 0,0133 raporlamaktadır. Numeric-only yapı için MAE 0,0325, semantic-only yapı için 0,0378'dir. Kaynağın hesabına göre dual-channel yaklaşım sırasıyla yaklaşık %59,0 ve %64,7 iyileşme sağlamaktadır.
İkinci değerlendirme varlığında dual-channel avantajın daha küçük olduğu belirtilmektedir: numeric-only yaklaşıma göre %3,4 ve semantic-only yaklaşıma göre %14,9.
Cross-asset context
Cross-asset expanded feature yapılandırması iki incelenen kripto varlığında MAE 0,0278 ve 0,0292 değerlerini üretmiş; temel semantic configuration'a göre %15,5 ve %9,6 iyileşme raporlanmıştır. Volatility–momentum özelliklerinin de katkı sağladığı, sentiment ve market indicator özelliklerinin ise daha sınırlı fakat ölçülebilir kazanç oluşturduğu belirtilmiştir.
Temporal window duyarlılığı
Kaynak sensitivity analysis'te pencere boyutu 8'i en iyi accuracy–efficiency dengesi olarak raporlamaktadır. Window size 12 kullanıldığında FET MAE'si %47,3 ve NMR MAE'si %42,0 artmıştır. Yazarlar bunu overfitting davranışı olarak yorumlamaktadır.
Ayrıca iki-model ensemble'ın tek-model yapıya göre FET ve NMR'de sırasıyla %5,3 ve %4,3 MAE iyileştirmesi sağladığı belirtilmiş; daha karmaşık ensemble yapıların zorunlu olarak daha iyi olmadığı sonucu çıkarılmıştır.
Confidence dağılımı ne anlatıyor?
Kaynak Şekil 6 semantic ve temporal kanalların confidence dağılımlarını göstermektedir. Semantic confidence dağılımı genel olarak daha yüksek confidence bölgesine kayarken temporal confidence daha düşük değerlerde yoğunlaşmaktadır. Yazarlar, iki kanalın birbirine yaklaştığı durumlarda meta-learner confidence'ının yükseldiğini; kanallar ayrıştığında uncertainty'nin arttığını yorumlamaktadır.
Bu sonuç confidence değerlerinin gerçek piyasa riskinin tamamını ölçtüğü anlamına gelmez. Bunlar modelin kendi tahmin yapısı ve calibration mekanizması içindeki belirsizlik göstergeleridir.
Çalışmanın desteklediği sonuçlar
- ASTIF, incelenen yedi varlığın tamamında Tablo 1'in MAE ölçütüne göre karşılaştırılan baseline'lardan daha düşük hata üretmiştir.
- MAE avantajı varlığa göre %7,2 ile %59,0 arasında değişmektedir.
- Semantic SLM, temporal LSTM, uncertainty quantification ve meta-learning bileşenlerinin kaldırılması ablasyon koşullarında performansı düşürmüştür.
- Dual-channel encoding kaynak deneylerinde single-channel yapılardan daha iyi sonuç vermiştir.
- Cross-asset özellikler ve orta büyüklükte temporal context bazı deneylerde doğruluğu iyileştirmiştir.
- Confidence-aware model selection kaynak deneylerinde semantic ve temporal uzmanların tek statik ağırlıkla birleştirilmesine alternatif bir mekanizma sağlamıştır.
Çalışmanın desteklemediği sonuçlar
Çalışma, ASTIF'in bütün finansal piyasalarda veya bütün kripto varlıklarda en iyi model olduğunu göstermemektedir. Test evreni beş AI-bağlantılı token ve iki teknoloji hissesiyle sınırlıdır.
Çalışma gerçek para ile al-sat stratejisi, işlem maliyeti, spread, slippage, order-book impact, Sharpe ratio, Sortino ratio, maximum drawdown veya portföy P&L testi yapmamıştır. Bu nedenle düşük MAE'nin doğrudan kârlı trading stratejisi anlamına geldiği söylenemez.
Çalışma multi-step forecasting sistemi değildir; temel görev next-step prediction'dır. Multi-step forecasting kaynakta gelecek araştırma konusu olarak belirtilmiştir.
Sistem gerçek zamanlı haber akışı kullanmamaktadır. Kaynak açık biçimde historical data kullandığını ve breaking news / real-time feed entegrasyonunun bulunmadığını belirtmektedir.
Kaynak sonuçları p-değerleri, confidence interval veya çoklu random-seed performans dağılımlarıyla desteklememektedir. Bu nedenle baseline farklarının inferential statistical significance düzeyi hakkında kaynak dışı hüküm verilemez.
Sınırlılıklar
| Sınırlılık | Sonuçların yorumuna etkisi |
|---|---|
| Prompt engineering domain uzmanlığı gerektiriyor | Semantic channel'ın performansı prompt tasarımına duyarlı olabilir. |
| Hesaplama yükü | Resource-constrained ortamlarda gerçek zamanlı kullanım zorlaşabilir. |
| Sınırlı varlık evreni | Yeni tokenlar ve alternatif asset class'lara genelleme doğrudan gösterilmemiştir. |
| Historical data | Live market feed ve breaking-news koşullarında davranış test edilmemiştir. |
| Next-step forecast | Uzun multi-step horizon performansı bilinmemektedir. |
| Ana tablolar arasında baseline farkı | NMR ve FET için ana benchmark ile ablation baseline değerleri doğrudan birleştirilmemelidir. |
| Validation oranlarının açıklaması | %30 meta holdout ile global split içindeki %10 internal validation ilişkisinin yeniden üretimi ek açıklama gerektirir. |
| Inferential significance raporu yok | Model farklarının p-değeri veya güven aralığı düzeyinde anlamlılığı kaynak tarafından gösterilmemiştir. |
Gelecek çalışma yönleri
Kaynak gelecekte gerçek zamanlı veri entegrasyonu, reinforcement learning ile automated prompt optimization, multi-step forecasting, daha geniş asset class değerlendirmesi ve edge computing optimization önermektedir.
Kaynak ve Yöntem Notu
Özgün başlık: ASTIF: Adaptive Semantic-Temporal Integration for Cryptocurrency Price Forecasting
Yazarlar: Hafiz Saif Ur Rehman, Ling Liu, Kaleem Ullah Qasim
Corresponding author: Ling Liu
Kurumlar: Southwestern University of Finance and Economics, Chengdu, Sichuan, China; Southwest Jiaotong University, Chengdu, Sichuan, China.
Kaynak türü: arXiv preprint.
arXiv: 2512.18661v1
arXiv kategorisi: cs.AI
İlk sürüm tarihi: 21 Aralık 2025.
Hakemlik durumu: Doğrulanmış hakemli dergi yayını bulunmadığından preprint olarak ele alınmıştır.
Dergi bilgisi: ArXiv tarafından işlenen manuscript metninde “journal: Nuclear Physics B” alanı görünmektedir; ancak bu başlıkla doğrulanabilir bir Nuclear Physics B yayın kaydı veya bağımsız dergi DOI'si bulunamadığından bu ifade yayın statüsü olarak kullanılmamıştır.
DOI: Doğrulanmış bağımsız dergi DOI'si bulunmamaktadır. arXiv kaydı 2512.18661 üzerinden tanımlanır.
Veri dönemi: Ocak 2020 – Aralık 2024.
Hedef varlıklar: FET, AGIX, NMR, OCEAN, CTX, MSFT, NVDA.
Temel model: MirrorPrompt SLM + LSTM–Random Forest temporal learner + confidence-calibrated Random Forest meta-learner.
SLM: Gemma-3-1b-it, LM Studio API.
Temel değerlendirme metrikleri: MAE, RMSE, R² ve calibration error.
Veri erişilebilirliği: Sağlanan PDF'de ayrı bir Data Availability Statement veya doğrulanabilir public dataset repository bağlantısı bulunmamaktadır.
Kod erişilebilirliği: Sağlanan PDF'de doğrulanabilir bir GitHub veya kod repository bağlantısı bulunmamaktadır.
Finansman: Sağlanan PDF'de ayrı bir funding statement tespit edilmemiştir.
Çıkar çatışması: Sağlanan PDF'de ayrı bir conflict-of-interest statement tespit edilmemiştir.
Yazar katkıları: Ayrı bir CRediT/yazar katkıları bildirimi tespit edilmemiştir.
Lisans: Sağlanan PDF ve doğrulanabilen birincil bibliyografik kayıtta açık yeniden kullanım lisansı güvenilir biçimde tespit edilmediğinden lisans varsayılmamıştır. Kaynak figürleri birebir kopyalanmamalı; sayısal veriler ve bilimsel ilişkiler Verianla için bağımsız biçimde yeniden çizilmelidir.
Kaynak içi yorum notu: Tablo 1 ASTIF'in bütün hedeflerde en düşük MAE'yi verdiğini gösterirken bütün hedeflerde en düşük RMSE'yi vermediğini göstermektedir. Bu nedenle kaynak anlatısındaki genel “outperforms all baselines” ifadesi en güvenli biçimde MAE ve kaynakta sunulan toplu değerlendirme bağlamında yorumlanmalıdır.
Kaynak içi yeniden üretilebilirlik notu: Tablo 1 ile Table 3'ün NMR/FET ASTIF baseline değerleri farklıdır. Ayrıca meta-learner için verilen %30 temporal holdout ile global %80/%20 split içindeki son %10 internal validation arasındaki uygulama ilişkisi kaynakta tam olarak açıklanmamıştır.
Temel yöntem sınırı: Bu çalışma tarihsel günlük veri üzerinde next-step forecast performansını ölçmektedir. Gerçek zamanlı haber akışı, canlı trading, işlem maliyetleri ve gerçek para portföy performansı çalışmanın deney kapsamı dışında kalmaktadır.
Telif/anlatım yöntemi: Verianla metni kaynak çalışmanın cümlelerini veya şekil tasarımlarını yeniden üretmez. Yöntem, matematik, deney parametreleri, tablo değerleri ve sonuç sınırları kaynak çalışmadan çıkarılarak bağımsız öğretici Türkçe yapı içinde yeniden düzenlenmiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir