


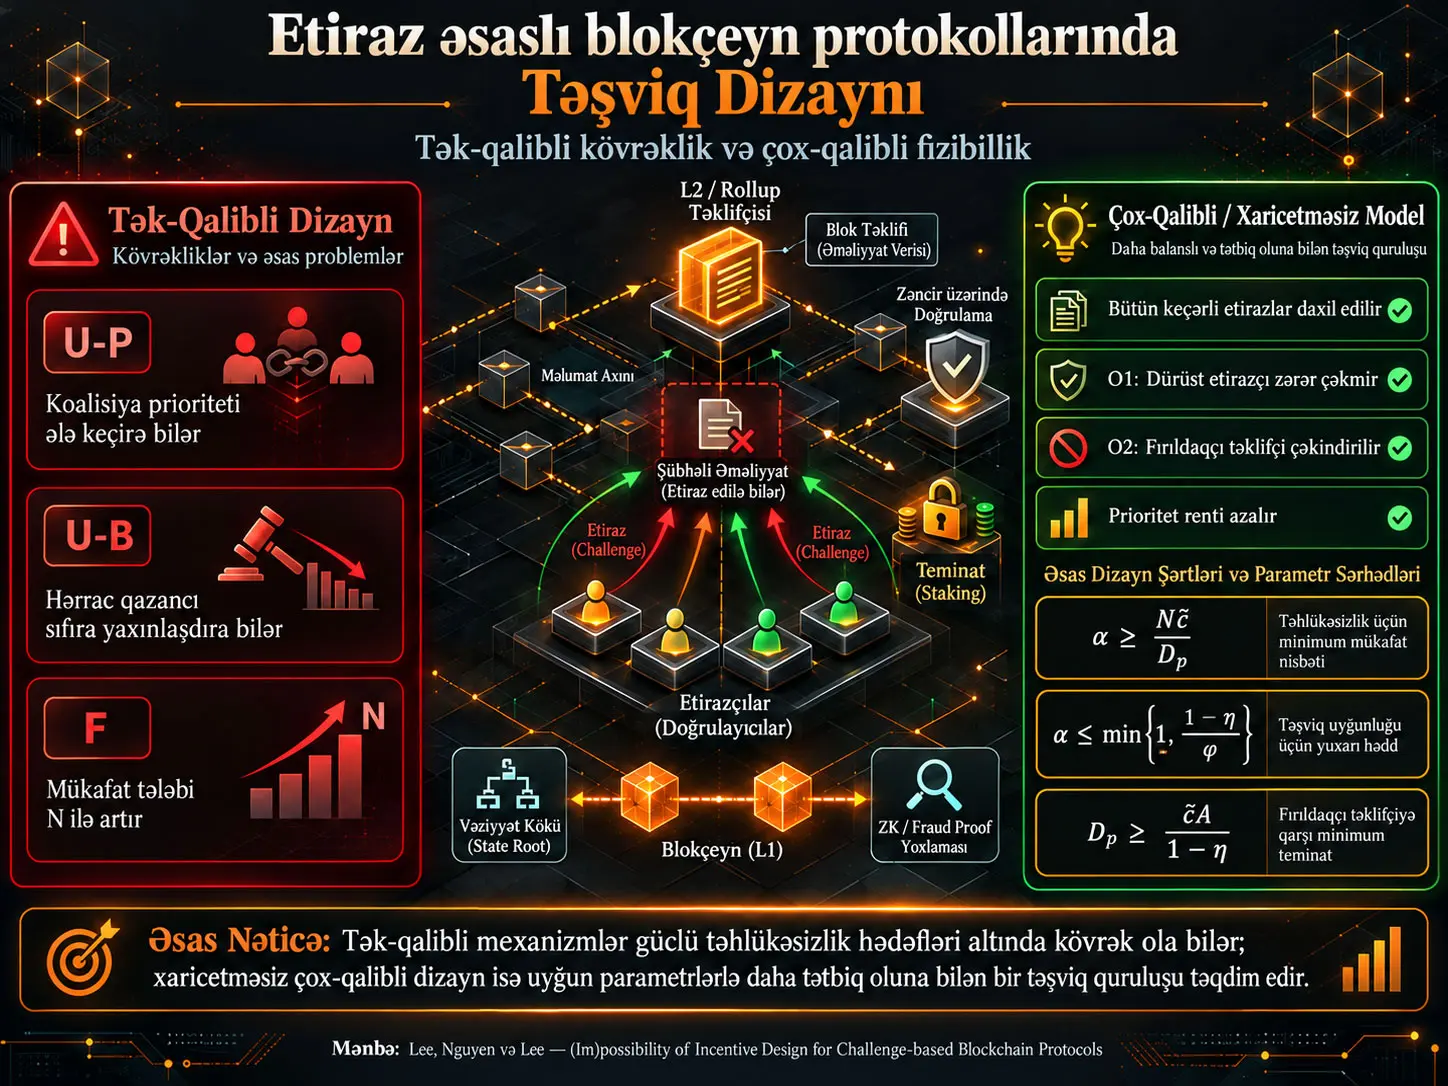
Etiraz əsaslı blokçeyn protokolu ağır hesablamanı zəncirdən kənarda yerinə yetirən və yalnız nəticəyə etiraz edildikdə zəncirüstü doğrulama mexanizmini işə salan təhlükəsizlik yanaşmasıdır. Bu tədqiqat belə bir sistemdə “ən azı bir dürüst doğrulayıcı var” fərziyyəsinin iqtisadi baxımdan həqiqətən davamlı olub-olmadığını nəzəri mexanizm dizaynı vasitəsilə araşdırır. Tədqiqatçılar dürüst etirazçıların zərərə düşməməsi ilə fırıldaqçı təklifçinin mənalı iqtisadi itki yaşaması məqsədlərinin tək-qalibli və çox-qalibli mükafat dizaynlarında eyni vaxtda təmin olunub-olunmadığını təhlil edirlər.
Modeldə \(N\) etirazçı, onların içində təklifçi ilə əməkdaşlıq edə bilən \(A<N/2\) ölçülü alt qrup, heterogen, lakin məlum yuxarı hədlərlə məhdudlaşdırılmış doğrulama xərcləri, təklifçi təminatı \(d_p\), etirazçılara ayrılan mükafat payı \(\alpha\), qaliblərin sayı \(m\) və sıralama xərci \(f\) mövcuddur. Əməliyyat sırası üç rejimdə nəzərdən keçirilir: təklifçi tərəfindən müəyyən edilən prioritet (U-P), xarici builder tərəfindən hərraca çıxarılan prioritet (U-B) və qısa gəliş intervalında təsadüfi püşkatmadan istifadə edən ədalətli sıralama (F).
Tədqiqatın ən güclü nəticəsi tək-qalibli sistemlər üçün ortaya çıxır. Təklifçi-prioritetli vəziyyətdə əməkdaş və ya Sybil etirazçı yeganə mükafat slotunu ələ keçirərək dürüst tərəflərin iştirakdan əvvəl zərərə düşməsinə səbəb ola bilər. Builder hərracında isə rəqabət qalibin əldə etdiyi iqtisadi artığı sıfıra yaxınlaşdırdığı üçün ilkin doğrulama xərci geri qazanılmaya bilər. Ədalətli sıralama bu iki problemi birbaşa daşımır, lakin tək mükafatın \(N\) iştirakçı arasında təsadüfi bölüşdürülməsi səbəbindən tələb olunan mükafat büdcəsi \(N\) ilə böyüyür və sistem miqyas həddinə çatır.
Bunun əksinə, bütün etibarlı etirazların qalib sayıldığı çox-qalibli, xaric-etməsiz dizaynda həm dürüst iştirakı, həm də çəkindirməni eyni vaxtda təmin edə bilən mükafat payı üçün açıq mümkünlük intervalı əldə olunur. Bununla belə, bu nəticə ideallaşdırılmış \(m=N\) və \(f=0\) şərtlərinə əsaslanır. Real dispute-window tutumu, məhdud blok sahəsi, əməliyyat haqları və çoxmərhələli protokol məntiqi tədqiqatın əsas modelindən kənardadır.
Etiraz əsaslı blokçeyn protokolu nədir?
Etiraz əsaslı blokçeyn protokolu bahalı hesablamanı standart olaraq zəncirdən kənarda saxlayan və yalnız təqdim edilmiş nəticənin düzgünlüyünə etiraz edildikdə on-chain doğrulama və ya fraud-proof prosesini işə salan protokollar ailəsidir; təhlükəsizlik, yanlış nəticə yayımlandıqda ən azı bir dürüst tərəfin bunu aşkar edib iqtisadi baxımdan etiraz etməyə hazır olmasından asılıdır.
Niyə belə mexanizmə ehtiyac var?
Blokçeynlərdə hər bir qovşağın eyni vəziyyəti yenidən hesablaması yoxlanıla bilməni təmin edir, lakin bahalıdır. Optimistic rollup və Truebit kimi sistemlər bu yükü azaltmaq üçün hesablamanı zəncirdən kənarda aparır və bütün zəncir imkanlarını yalnız mübahisə yarandıqda işə salır.
Bu arxitektura texniki baxımdan güclü görünsə də, iqtisadi sual yaranır: fırıldağı aşkar edən tərəf həqiqətən etiraz etmək istəyəcəkmi? Etirazçı əvvəlcə məlumatı yoxlamalı, fırıldağı aşkar etməli və sonra fraud proof əməliyyatını sona qədər aparmalıdır; bunların hamısı xərc tələb edir. Mükafat yalnız bir şəxsə verilirsə, çoxlu dürüst iştirakçının çəkdiyi doğrulama xərci qarşılıqsız qala bilər.
İkinci problem təklifçinin öz Sybil hesablarından və ya əməkdaş etirazçılardan istifadə edə bilməsidir. Fırıldaqçı təklifçi təminat itirsə belə, mükafatın bir hissəsi öz koalisiyasına geri qayıdırsa, real iqtisadi cəza dizaynerin nəzərdə tutduğundan aşağı ola bilər.
Tədqiqatın ədəbiyyatda hədəflədiyi boşluq
BoLD, Dave və digər fraud-proof sistemləri mübahisələrin texniki baxımdan necə həll ediləcəyini ətraflı izah edir. Bu tədqiqat isə başqa səviyyədə sual verir: müəyyən fraud-proof alqoritminin daxili detallarından asılı olmayaraq, mükafat və sıralama mexanizminin iqtisadi cəhətdən hansı şərtlərdə işləməsi mümkündür?
Bu səbəbdən model “mechanism-agnostic” saxlanılır. Məqsəd müəyyən rollup-ın bütün protokolunu simulyasiya etmək deyil, winner selection, priority ordering, xərc və koalisiya davranışı arasındakı əsas iqtisadi gərginliyi riyazi şəkildə təcrid etməkdir.
Oyunçular
| Simvol | Subyekt | Modeldəki rol |
|---|---|---|
| \(P\) | Təklifçi | Düzgün və ya fırıldaqçı state/proposal yayımlayan tərəf. |
| \(N\) | Ümumi etirazçı sayı | Müəyyən təklifi yoxlaya bilən iqtisadi aktorların cəmi. |
| \(A\) | Əməkdaş etirazçıların sayı | Təklifçi ilə koalisiya yaradan alt qrupun ölçüsü; fərziyyə \(A<N/2\). |
| \(\mathcal{A}\) | Koalisiya alt çoxluğu | Təklifçi ilə uyğun hərəkət edə bilən etirazçılar çoxluğu. |
| \(\phi=A/N\) | Koalisiya nisbəti | Ümumi etirazçılar içində əməkdaşların payı. |
Model normal-form və complete-information oyun kimi qurulub. Başqa sözlə, oyunçular ödəniş strukturunu bilir və strategiyalarını bu ortaq məlumat əsasında seçirlər.
Etiraz xərcinin iki komponenti
Hər etirazçının ümumi xərci:
\[ c_i=c_i^{\mathrm{init}}+c_i^{\mathrm{proc}} \]
kimi müəyyən edilir.
\(c_i^{\mathrm{init}}\) fırıldağı yoxlamaq və etibarlı etiraz başlatmaq üçün tələb olunan ilkin doğrulama xərcidir. \(c_i^{\mathrm{proc}}\) isə etiraz prosesini sona qədər aparmaq, məsələn, lazım olan zəncirüstü əməliyyatları icra etmək üçün tələb olunan proses xərcidir.
Xərclər etirazçılar arasında fərqli ola bilər, lakin məlum və sonlu yuxarı hədlərə malik olduqları fərz edilir:
\[ \tilde c^{\mathrm{init}} \geq \sup_i c_i^{\mathrm{init}}, \qquad \tilde c^{\mathrm{proc}} \geq \sup_i c_i^{\mathrm{proc}}. \]
Ümumi ən pis hal xərc həddi:
\[ \tilde c= \tilde c^{\mathrm{init}} + \tilde c^{\mathrm{proc}} \]
kimi müəyyən edilir. Beləliklə, hər etirazçı üçün \(c_i\leq\tilde c\) qəbul olunur.
Təklifçi təminatı necə bölüşdürülür?
Etibarlı fraud proof qəbul edildikdə təklifçinin \(D_p\) təminatı slash edilir. Bunun \(\alpha D_p\) hissəsi qalib etirazçılara mükafat kimi paylanır:
\[ 0<\alpha\leq1. \]
Qalan:
\[ (1-\alpha)D_p \]
məbləğ yandırılır. Mənbə bu partial-burning mexanizminin challenge protokollarında universal standart olduğunu iddia etmir; modeldə bu mexanizm koalisiya mükafatın bir hissəsini geri alsa belə, təklifçinin müəyyən iqtisadi itki yaşamasını təmin etmək üçün istifadə edilir.
\(m\) qalib varsa, bərabər bölüşdürmə qaydasına görə hər birinin bruto mükafatı:
\[ \frac{\alpha D_p}{m} \]
olur.
Best-effort participation fərziyyəsi
Model, açıq elan edilmiş konservativ haqq həddi və bildirilmiş inclusion capacity şəraitində gözlənilən xalis mükafatı mənfi olmayan doğrulayıcıların dispute window daxilində etibarlı challenge göndərməyə çalışdığını fərz edir.
Bu fərziyyə koalisiya baxımından mühüm nəticə yaradır. Dürüst tərəflər mükafat qazanmaq üçün challenge göndərdikdə, təklifçi ilə əməkdaşlıq edən tərəflər də slashed deposit-dən pay geri almaq üçün etibarlı challenge göndərməyə iqtisadi cəhətdən təşviq olunurlar. Mənbə bunu “coalition recapture” davranışı adlandırır.
Üç sıralama rejimi
| Rejim | Sıralamanı kim müəyyən edir? | Prioritet xərci | Əsas iqtisadi xüsusiyyət |
|---|---|---|---|
| U-P | Təklifçi | Dürüst etirazçı \(f^\star\) ödəyir; ödəniş koalisiya daxilində geri qayıtdığı üçün effektiv xərc sıfıra yaxınlaşa bilər. | Sybil/koalisiya tək slotu ələ keçirə bilər. |
| U-B | Xarici builder və ya block producer | Hərrac haqqı xarici builder-ə ödənir. | Rəqabət qalibin iqtisadi artığını sıfıra yaxınlaşdıra bilər. |
| F | Kimlik və ödənişdən asılı olmayan təsadüfi sıralama | \(f=0\) | Prioritet rentası aradan qalxır, lakin tək qalib olduqda qazanma ehtimalı \(1/N\)-ə düşür. |
Özəl dəyər və market-clearing fee
Bir priority slot üçün qalib etirazçının proses mərhələsindəki özəl dəyəri:
\[ v_i= \frac{\alpha D_p}{m} - c_i^{\mathrm{proc}} \]
kimi müəyyən edilir.
Builder hərracında bazarı təmizləyən haqq \(f^\star\), rəqabət artdıqca bu dəyərə yaxınlaşa bilər. Bu halda:
\[ v_i-f^\star\rightarrow0. \]
İlkin doğrulama xərci \(c_i^{\mathrm{init}}\) hərrac mərhələsinə çatdıqda sunk cost olduğundan, qalib slotdan qalan kiçik artığın bu xərci ödəməməsi tək-qalibli U-B rejiminin əsas problemidir.
Tək-qalibli challenge mükafatı niyə kövrəkdir?
Tək-qalibli challenge mükafatı, yalnız bir etirazçının ödəniş aldığı mühitdə sıralama gücünün və ya hərrac rəqabətinin dürüst iştirak gəlirini aradan qaldıra bilməsi və hətta ədalətli sıralamada qazanma ehtimalının \(1/N\)-ə düşməsi səbəbindən mənbədə müəyyən edilən güclü ex-ante fərdi rasionallıq hədəfi ilə gərginlik içindədir.
İki təhlükəsizlik hədəfi
O1 — Ex-ante fərdi rasionallıq:
\[ E[U_i]\geq0 \]
olmalıdır. Bu şərt sadəcə “bir dürüst etirazçı mənfəətli olsun” demir. Fırıldaq halında koalisiyada olmayan hər dürüst etirazçının iştirak qərarından əvvəl gözlənilən faydasının mənfi olmamasını tələb edir.
O2 — \(\eta\)-nisbətli çəkindirmə:
\[ Loss_{\mathrm{adv}} \geq \eta D_p, \qquad 0<\eta<1. \]
Burada məqsəd fırıldağın yalnız texniki cəhətdən düzəldilməsi deyil. Fırıldaq aşkarlandıqda təklifçi və onun koalisiyası təminatın müəyyən hissəsini həqiqətən itirməlidir.
Koalisiya mükafatın bir hissəsini geri ala bilər
Koalisiya nisbəti:
\[ \phi=\frac{A}{N} \]
olduqda və koalisiya etirazçı mükafatlarının \(\phi\) nisbətində hissəsini geri ala bildikdə təklifçi-koalisiya ümumi itkisi:
\[ Loss_{\mathrm{adv}} = D_p-\phi\alpha D_p = (1-\phi\alpha)D_p \]
olur.
Bu ifadə niyə sadəcə “təminat slash edildi” deməyin kifayət etmədiyini göstərir. Əgər slash edilmiş təminatın böyük hissəsini koalisiya yenidən qazanırsa, nominal slashing ilə real iqtisadi itki eyni deyil.
O1-in ümumi aşağı həddi
Daxil edilmiş dürüst qalibin xalis gəliri:
\[ \frac{\alpha D_p}{m}-c_i-f \]
olduğuna görə, ən pis hal xərci \(c_i=\tilde c\) altında:
\[ \alpha \geq \alpha_L(m,f) = \frac{m(\tilde c+f)}{D_p} \]
şərti O1-in aşağı həddidir.
Riyazi olaraq \(m\), \(f\) və ya \(\tilde c\) artdıqca tələb olunan \(\alpha\) böyüyür. \(D_p\) artdıqca eyni mükafat təhlükəsizliyi daha aşağı \(\alpha\) ilə təmin oluna bilər.
O2-nin yuxarı həddi
Çəkindirmə şərtindən:
\[ (1-\phi\alpha)D_p \geq \eta D_p \]
alınır. \(D_p>0\) üçün sadələşdirildikdə:
\[ \phi\alpha\leq1-\eta \]
və buna görə:
\[ \alpha \leq \min \left\{ 1, \frac{1-\eta}{\phi} \right\}. \]
Bu tənlik sistemin əsas gərginliyini göstərir: dürüst iştirak \(\alpha\)-nı yuxarı çəkmək istəyir, çəkindirmə isə koalisiya mükafatı geri ala bildiyi üçün \(\alpha\)-ya yuxarı hədd qoyur.
Koalisiya nisbəti məlum deyilsə konservativ hədd
Mənbənin \(A<N/2\), yəni \(\phi<1/2\) fərziyyəsində, \(\phi\)-dən asılı olmayan konservativ yetərli şərt:
\[ \alpha\leq2(1-\eta) \]
olur. Bu həddin həqiqətən \(1\)-dən kiçik və buna görə məhdudlaşdırıcı olması üçün:
\[ \eta>\frac{1}{2} \]
tələb olunur.
U-P: təklifçi-prioritetli tək-qalibli sistem
U-P rejimində təklifçi yeganə sıralama slotunu hərraca çıxarır. Əməkdaş Sybil etirazçının ödədiyi prioritet haqqı təklifçinin özünə qayıtdığı üçün koalisiya baxımından effektiv xərc sıfır ola bilər.
Mənbə göstərir ki, koalisiya bazarı təmizləmə qiymətindən bir qədər yüksək təklif verən Sybil etirazçı seçə və tək slotu deterministik şəkildə ala bilər. Bu halda dürüst etirazçı üçün:
\[ q_i=0 \]
və:
\[ E[U_i] = -c_i^{\mathrm{init}} <0. \]
Beləliklə, protokol parametrləri \(\alpha\) və \(D_p\) böyüdülsə belə, mənbə modelində O1 təmin edilə bilməz; problem mükafat məbləğindən əvvəl inclusion priority-də yaranır.
U-B: xarici builder hərracı
U-B vəziyyətində mükafat slotu təklifçi əvəzinə xarici builder tərəfindən satılır. Buna görə koalisiyanın haqqı geri alma üstünlüyü U-P ilə eyni deyil. Buna baxmayaraq başqa problem yaranır.
Etirazçının bidding mərhələsində slot dəyəri:
\[ v_i = \alpha D_p - c_i^{\mathrm{proc}} \]
və gözlənilən fayda:
\[ E[U_i] = q_i(v_i-f^\star) - c_i^{\mathrm{init}} \]
olur.
Rəqabətli hərracda \(f^\star\), \(v_i\)-yə yaxınlaşdıqda:
\[ v_i-f^\star\rightarrow0. \]
Beləliklə, ilkin xərc müsbət qaldığı müddətdə ex-ante fayda mənfi qala bilər. Mənbənin ikinci qeyri-mümkünlük nəticəsi bu mexanizmə əsaslanır.
Ədalətli sıralama təkbaşına problemi həll etmir
Ədalətli rejimdə qısa eyni-zamanlı arrival interval daxilindəki etibarlı etirazlar təsadüfi sıralanır və \(f\simeq0\) qəbul edilir. Tək qalib varsa, hər dürüst iştirakçının qazanma ehtimalı:
\[ \frac{1}{N} \]
olur.
Bir iştirakçının gözlənilən faydası:
\[ E[U_i] = \frac{1}{N} \left( \alpha D_p-c_i^{\mathrm{proc}} \right) - c_i^{\mathrm{init}} \]
şəklindədir.
Ən pis hal xərcləri istifadə edildikdə O1 üçün:
\[ \alpha D_p \geq N\tilde c^{\mathrm{init}} + \tilde c^{\mathrm{proc}} \]
tələb olunur.
Beləliklə, ədalətli sıralama Sybil priority capture problemini aradan qaldırsa da, tək-qalibli mükafat böyük \(N\) altında başqa miqyaslanma problemi yaradır. Tələb olunan reward pool iştirakçı sayı ilə böyüyərkən, O2 eyni zamanda \(\alpha\)-nı yuxarıdan məhdudlaşdırır.
Tədqiqatın üsulu və nəticələri
Tədqiqat üsulu
Tədqiqat empirik blockchain məlumatlarından istifadə etmir. Tədqiqatçılar mexanizm dizaynı yanaşması ilə iqtisadi oyun müəyyən edir; oyunçuları, xərcləri, koalisiya nisbətini, mükafat bölüşdürülməsini, sıralama formasını və təhlükəsizlik hədəflərini sabitləşdirərək hansı parametr bölgələrinin riyazi baxımdan mümkün olduğunu çıxarırlar.
| Element | Mənbə modelindəki tərif |
|---|---|
| Oyun növü | Complete-information normal-form challenge game |
| Təklifçi | \(P\) |
| Etirazçı sayı | \(N\) |
| Əməkdaş alt çoxluq | \(A<N/2\) |
| Koalisiya nisbəti | \(\phi=A/N\) |
| Təklifçi təminatı | \(D_p\) |
| Mükafat payı | \(\alpha\in(0,1]\) |
| Qalib sayı | \(m\) |
| Etirazçının ümumi xərci | \(c_i=c_i^{\mathrm{init}}+c_i^{\mathrm{proc}}\) |
| Ən pis hal xərci | \(\tilde c=\tilde c^{\mathrm{init}}+\tilde c^{\mathrm{proc}}\) |
| Prioritet haqqı | \(f\) |
| Minimum çəkindirmə səviyyəsi | \(\eta\in(0,1)\) |
Üç tək-qalibli rejimin nəticəsi
| Rejim | Əsas mexanizm | Mənbənin nəticəsi |
|---|---|---|
| U-P, \(m=1\) | Təklifçi koalisiyası tək priority slotunu Sybil etirazçı ilə ələ keçirə bilər. | O1 təmin edilə bilməz; dürüst etirazçı üçün \(q_i=0\) və \(E[U_i]=-c_i^{\mathrm{init}}<0\). |
| U-B, \(m=1\) | Rəqabətli priority auction qalib artığını sıfıra yaxınlaşdırır. | Müsbət ilkin xərc səbəbindən ex-ante O1 təmin edilə bilməz. |
| F, \(m=1\) | Hər etirazçının qazanma ehtimalı \(1/N\)-dir. | \(\alpha D_p\geq N\tilde c^{\mathrm{init}}+\tilde c^{\mathrm{proc}}\); böyük \(N\) altında miqyas həddi. |
Çox-qalibli xaric-etməsiz dizayn təşviq baxımından nə zaman mümkündür?
Çox-qalibli xaric-etməsiz dizayn, bütün \(N\) etibarlı etirazın mükafata daxil edildiyi \(m=N\) və sıralama rentasının aradan qalxdığı \(f=0\) şərtində, O1-in tələb etdiyi aşağı mükafat həddi O2-nin icazə verdiyi yuxarı mükafat həddini aşmırsa mümkündür.
Çox-qalibli ödəniş strukturu
Bütün \(N\) etibarlı etirazçı daxil edildikdə hər iştirakçının bruto mükafatı:
\[ \frac{\alpha D_p}{N} \]
olur.
Mənbənin xaric-etməsiz modelində priority slot qıtlığı aradan qalxdığı üçün:
\[ f=0 \]
qəbul olunur.
O1-in çox-qalibli aşağı həddi
Hər etirazçı üçün:
\[ \frac{\alpha D_p}{N} - \tilde c \geq0 \]
olmalıdır. Buradan:
\[ \alpha \geq \frac{N\tilde c}{D_p} \]
alınır.
O2-nin yuxarı həddi dəyişmir
Koalisiyanın real itki şərti yenə:
\[ \alpha \leq \min \left\{ 1, \frac{1-\eta}{\phi} \right\} \]
şəklindədir.
Mümkünlük intervalı
İki şərt birlikdə yazıldıqda:
\[ \boxed{ \alpha \in \left[ \frac{N\tilde c}{D_p}, \; \min \left\{ 1, \frac{1-\eta}{\phi} \right\} \right] } \]
alınır.
Intervalın boş olmaması üçün:
\[ \frac{N\tilde c}{D_p} \leq \min \left\{ 1, \frac{1-\eta}{\phi} \right\} \]
tələb olunur.
Bu nəticə tədqiqatın ən mühüm konstruktiv nəticəsidir. Tək-qalibli təhlil yalnız problemi göstərmir; çox-qalibli sistem üçün hansı mükafat və təminat parametrlərinin iki təhlükəsizlik hədəfini eyni vaxtda təmin edə biləcəyini də açıq şəkildə verir.
İki kalibrasiya rejimi
Yuxarı həddin hansı terminlə müəyyən edilməsinə görə iki vəziyyət yaranır.
Rejim 1:
\[ \alpha=1. \]
Bu halda bütün slashed deposit etirazçılara paylana bilər və mümkünlük üçün:
\[ D_p\geq N\tilde c \]
kimi \(N\) ilə böyüyən təminat tələbi yaranır. Bu, miqyasla məhdud rejimdir.
Rejim 2:
\[ \alpha = \frac{1-\eta}{\phi} <1. \]
\(\phi=A/N\) yerinə yazıldıqda mümkünlük şərti:
\[ \frac{N\tilde c}{D_p} \leq \frac{(1-\eta)N}{A} \]
olur.
\(N\) sadələşir:
\[ \frac{\tilde c}{D_p} \leq \frac{1-\eta}{A}. \]
Beləliklə:
\[ \boxed{ D_p \geq \frac{\tilde c A}{1-\eta} } \]
alınır.
“Scale-free” ifadəsi necə şərh edilməlidir?
Bu bərabərlikdə ümumi dürüst etirazçı sayı \(N\) görünmür. Tələb olunan təminat xərc həddi \(\tilde c\), koalisiyadakı mütləq aktor sayı \(A\) və minimum çəkindirmə səviyyəsi \(\eta\) ilə müəyyən edilir.
Lakin bu nəticə yalnız aktiv yuxarı həddin \((1-\eta)/\phi\) olduğu rejimdə keçərlidir. Bunun üçün:
\[ \frac{1-\eta}{\phi}<1 \]
və buna görə:
\[ \phi>1-\eta \]
olmalıdır.
Bu şərt ödənməzsə, yuxarı hədd yenidən \(1\) olur və:
\[ D_p\geq N\tilde c \]
formasındakı miqyasla məhdud rejimə qayıdılır. Buna görə mənbədə işlədilən “scale-free” anlayışı şərti mexanizm xüsusiyyətidir; bütün \(N\), \(A\), \(\eta\) kombinasiyalarında dəyişməz zəmanət deyil.
Güclü təhlükəsizlik hədəfləri nəticəni niyə dəyişir?
O1-in mövcud forması “ən azı bir dürüst etirazçı challenge göndərməyə hazır olsun” hədəfindən daha güclüdür. O1 fırıldaq halında hər dürüst iştirakçının ex-ante expected utility dəyərinin mənfi olmamasını tələb edir.
Əgər O1 zəiflədilərək yalnız bir dürüst tərəfin iqtisadi baxımdan həvəsli olması kifayət sayılsa, protokol təhlükəsizliyinin mənası dəyişər. Təhlükəsizlik artıq bütün permissionless iştirakçılar üçün dayanıqlı iqtisadi xüsusiyyət olmaqdan çıxar və müəyyən bazar şərtlərində müəyyən tərəfin challenge göndərməsindən asılı hala gələ bilər.
Eyni şəkildə O2 ləğv edilərək yalnız “fırıldaq sonda tutulsun” deyilərsə, təklifçinin hücumu təkrar-təkrar sınaması iqtisadi baxımdan ucuz qala bilər. Texniki correctness təmin olunsa belə, dispute əməliyyatlarının gas xərci, congestion və finality delay kimi xarici xərcləri istifadəçilər daşıya bilər.
Xərc geri ödənişi modeli necə dəyişə bilər?
Mənbə əsas modeldə gas və ya proving overhead kimi challenge xərclərinin protokol tərəfindən ayrıca reimbursed edildiyini fərz etmir. Real sistem bu xərcləri geri ödəmək istəsə, xərcin doğrulana bilməsi, süni xərc şişirtməsinin və Sybil splitting-in qarşısının alınması lazımdır.
Bu cür reimbursement O1-in aşağı həddini dəyişə bilər, lakin mənbə bunu ayrıca genişləndirmə istiqaməti kimi saxlayır; mövcud teoremlər avtomatik olaraq reimbursement ehtiva edən bütün protokollara tətbiq edilməməlidir.
Bərabər bölüşdürmə məcburidirmi?
Xeyr. Mənbə riyaziyyatın izlənilə bilməsi üçün qaliblər arasında bərabər bölüşdürmədən istifadə edir. Real protokol early-challenge və ya contribution-weighted reward tətbiq edə bilər.
Lakin daha yüksək erkən mükafat ordering power sahibi hücumçunun erkən inclusion üstünlüyünü daha dəyərli edə bilər. Beləliklə, dizayn yenidən tək-qalibli mexanizmə bənzəyən priority competition davranışı yarada bilər.
Real deployment niyə ideal xaric-etməsiz modelə tam uyğun gəlməyə bilər?
İdeal model \(m=N\) fərz edir; yəni dispute window daxilində hər etibarlı challenge-ın emal edilə bildiyini qəbul edir. Real zəncirlərdə blok tutumu və dispute müddəti sonludur.
Real sistemdə:
\[ m<N \]
ola bilər və inclusion scarcity geri qayıtdıqda:
\[ f>0 \]
ola biləcək priority rents yenidən ortaya çıxa bilər. Mənbənin gələcək tədqiqat təkliflərindən biri məhz bu finite-capacity rejimin mümkünlük bölgəsini necə daraltdığını ölçməkdir.
ZK fraud proof-lar baxımından nəticə
ZK əsaslı fraud proof bir dispute-i tək succinct proof ilə həll etməyə yaxınlaşdıqca protokol texniki baxımdan sadələşə bilər; lakin tək proof slotunun iqtisadi dəyəri arta bilər.
Proof generation ani olmadığı və xüsusi avadanlıq/əməliyyat hazırlığı tələb edə bildiyi üçün zərərli təklifçi fırıldaqçı instance-ı yayımlamadan əvvəl proof pipeline-ını hazırlamaq üstünlüyünə sahib ola bilər. Əgər yalnız ilk proof və ya çox az sayda proof mükafatlandırılırsa, bu precomputation advantage ordering power ilə birləşə bilər.
Mənbə buna görə ZK fraud proof dizaynlarında da yalnız kriptoqrafik düzgünlüyün deyil, challenge inclusion iqtisadiyyatının açıq şəkildə modelləşdirilməli olduğunu müdafiə edir.
Tədqiqatın dəstəklədiyi nəticələr
| Mənbə ilə dəstəklənən nəticə | Keçərli olduğu şərt |
|---|---|
| U-P tək-qalibli rejimdə O1 təmin edilə bilməz. | Mənbənin proposer-priority və coalition recycling fərziyyələri altında. |
| U-B tək-qalibli rejimdə O1 təmin edilə bilməz. | Rəqabətli priority auction və müsbət ilkin xərc altında. |
| Ədalətli tək-qalibli rejimdə mükafat tələbi \(N\) ilə böyüyür. | Təsadüfi tək qalib və mənbənin xərc modeli altında. |
| Xaric-etməsiz çox-qalibli modeldə O1 və O2 eyni vaxtda təmin edilə bilər. | \(m=N\), \(f=0\) və mümkünlük intervalı boş deyilsə. |
| Müəyyən kalibrasiya rejimində təminat şərtindən \(N\) sadələşir. | \(\phi>1-\eta\) olan nontrivial deterrence rejimində. |
Tədqiqatın dəstəkləmədiyi nəticələr
- Bütün single-winner blockchain sistemlərinin hər təhlükəsizlik tərifi altında riyazi cəhətdən qeyri-mümkün olduğu göstərilməyib.
- Multi-winner dizaynın real blockchain üzərində throughput, gas və ya latency baxımından praktik tətbiq oluna bilməsi eksperimental şəkildə göstərilməyib.
- BoLD, Dave və ya Cannon protokollarının hamısının mövcud formalarında təhlükəsiz olmadığı nəticəsi çıxarıla bilməz.
- ZK fraud proof istifadə edən bütün sistemlərdə təklifçinin praktik olaraq priority slotunu ələ keçirəcəyi göstərilməyib.
- Model real MEV paylanmasından, real gas-price zaman sıralarından və ya canlı builder auction məlumatlarından istifadə etmir.
- Scale-free təminat şərti bütün koalisiya nisbətləri və bütün \(N\) dəyərləri üçün şərtsiz zəmanət deyil.
Modelin əsas məhdudiyyətləri
Tək mərhələli abstraction: Real fraud-proof protokolları çoxsaylı challenge və response round-ları ehtiva edə bilər. Tədqiqat bunları bir challenge stage-ə endirir.
Complete information: Oyunçuların payoff strukturunun ortaq məlumat olduğu fərz edilir. Real sistemdə digər tərəflərin real xərcləri və hazır infrastrukturu məlum olmaya bilər.
Xərc yuxarı hədlərinin bilinə bilməsi: Teoremlər \(\tilde c^{\mathrm{init}}\) və \(\tilde c^{\mathrm{proc}}\) kimi konservativ, lakin məlum hədlərdən istifadə edir. Deployment mühitində bunların etibarlı kalibrlənməsi ayrıca problemdir.
Equal split: Multi-winner mükafatı bərabər bölünür. Başqa reward rules fərqli strateji davranışlar yarada bilər.
İdeal non-exclusion: Əsas müsbət nəticə bütün etibarlı challenge-ların emal oluna bildiyi ideal \(m=N\) rejiminə əsaslanır.
Ordering fee yanaşması: Xaric-etməsiz dizaynda priority value azaldığı üçün \(f=0\) istifadə olunur. Qismən tutum qıtlığı olan real sistemlərdə \(f\) yenidən müsbət ola bilər.
Gələcək tədqiqat istiqamətləri
Mənbə partial burning istifadə edən real non-exclusion/multi-winner prototipinin hazırlanmasını və performans ölçmələri ilə kalibrlənməsini təklif edir.
İkinci istiqamət partially efficient markets və daha real hücumçu davranışlarını ehtiva edən başdan-başa simulyasiyalardır.
Üçüncü istiqamət BoLD və Dave kimi multi-stage protokolların bütün mərhələlərini açıq şəkildə modelə əlavə etməkdir.
Dördüncü istiqamət ZK əsaslı single-shot fraud proof sistemlərində precomputation advantage ilə transaction ordering gücü arasındakı qarşılıqlı təsiri daha ətraflı təhlil etməkdir.
Mənbə və üsul qeydi
Orijinal başlıq: (Im)possibility of Incentive Design for Challenge-based Blockchain Protocols
Müəlliflər: Suhyeon Lee; Dieu-Huyen Nguyen; Donghwan Lee.
Affiliasiyalar: Tokamak Network; Suhyeon Lee üçün əlavə olaraq Hashed Open Research.
Yüklənmiş mənbə: arXiv:2512.20864v2 [cs.GT].
Yüklənmiş versiyanın tarixi: 5 fevral 2026.
İlk arXiv təqdimatı: 24 dekabr 2025.
arXiv DOI/daimi identifikator: 10.48550/arXiv.2512.20864.
Workshop: 10th Workshop on Trusted Smart Contracts — WTSC 2026, Financial Cryptography and Data Security 2026 ilə birlikdə, St. Kitts, 6 mart 2026.
Nəşr statusu: Tədqiqat WTSC 2026-nın rəsmi proqramında qəbul edilmiş/təqdim olunmuş workshop işidir. Yoxlanılan fayl isə arXiv v2 preprintidir.
Springer proceedings statusu: FC 2026 workshopları üçün Revised Selected Papers cildi Springer Lecture Notes in Computer Science, volume 16564 kimi elan edilib və dekabr 2026 nəşr tarixi göstərilir. Bu tədqiqat üçün yekun chapter DOI-si və dəqiq səhifə aralığı mövcud yoxlamada müəyyən edilmədiyi üçün əlavə edilməyib.
Elmi tədqiqat növü: Nəzəri mexanizm dizaynı və oyun nəzəriyyəsi.
Eksperiment/sahə vəziyyəti: Real şəbəkə eksperimenti, canlı rollup deployment testi və ya iqtisadi sahə ölçümü yoxdur.
Əsas analiz vahidi: Tək mərhələli fraud-challenge oyunu.
Əsas dizayn hədəfləri: O1 — bütün dürüst etirazçılar üçün ex-ante non-negative expected utility; O2 — aşkar edilmiş fırıldaqda adversarial coalition üçün ən azı \(\eta D_p\) iqtisadi itki.
Araşdırılan sıralama rejimləri: U-P — proposer-ordered priority; U-B — builder-ordered priority; F — fair ordering.
Araşdırılan mükafat strukturları: Single-winner \(m=1\); multi-winner/non-exclusion \(m=N\).
Əsas mümkünlük nəticəsi: \(m=N\) və \(f=0\) altında mükafat payı \(\alpha\), dürüst iştirakın aşağı həddi ilə çəkindirmənin yuxarı həddi arasında qaldıqda iki hədəf eyni vaxtda təmin edilə bilər.
Əsas scale-free şərti: Müvafiq nontrivial deterrence rejimində \(D_p\geq\tilde cA/(1-\eta)\); bu nəticə \(\phi>1-\eta\) rejim şərti ilə birlikdə oxunmalıdır.
Maliyyələşdirmə: Yüklənmiş PDF-də ayrıca funding statement yoxdur.
Maraqlar toqquşması: Yüklənmiş PDF-də ayrıca conflict-of-interest declaration yoxdur.
Məlumatların əlçatanlığı: Tədqiqat nəzəri olduğundan empirik məlumat dəsti təhlil edilmir; yüklənmiş PDF-də ayrıca Data Availability Statement yoxdur.
Kodun əlçatanlığı: Yüklənmiş PDF-də reference implementation və ya doğrulanmış public code repository göstərilməyib; mənbə bunu gələcək tədqiqat mövzusu kimi saxlayır.
Müəllif töhfələri: Ayrı CRediT contribution statement yoxdur.
Lisenziya: Yüklənmiş PDF üzərində açıq təkrar istifadə lisenziyası təsdiqlənməyib. Springer workshop volume səhifəsi IFCA 2026 copyright məlumatı verir; konkret chapter lisenziyası təsdiqlənmədiyi üçün müəllif hüquqları baxımından fail-closed yanaşması tətbiq edilib.
Mühüm şərh qeydi: Mənbənin single-winner “impossibility” nəticələri O1 və O2 formasındakı güclü permissionless-security hədəflərinə və müəyyən edilmiş ordering/cost modelinə aiddir. Daha zəif təhlükəsizlik hədəfləri və ya başqa payoff strukturları eyni teoremlərlə avtomatik əhatə olunmur.
Scale-free şərh qeydi: Lemma 3-dəki \(N\)-dən asılı olmayan təminat şərti dərhal sonrakı kalibrasiya müzakirəsindəki \(\phi>1-\eta\) rejim şərti ilə birlikdə qiymətləndirilməlidir.
Müəllif hüquqları/izah üsulu: Mənbənin orijinal abzas quruluşu, cədvəllərinin təqdimatı və ya ifadə dili yenidən istehsal edilməyib. Verianla mətni; mənbədə müəyyən edilən oyunçular, xərclər, tənliklər, teoremlər, rejimlər, nəticələr və məhdudiyyətlər çıxarılaraq müstəqil öyrədici struktur daxilində yenidən qurulub.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib