


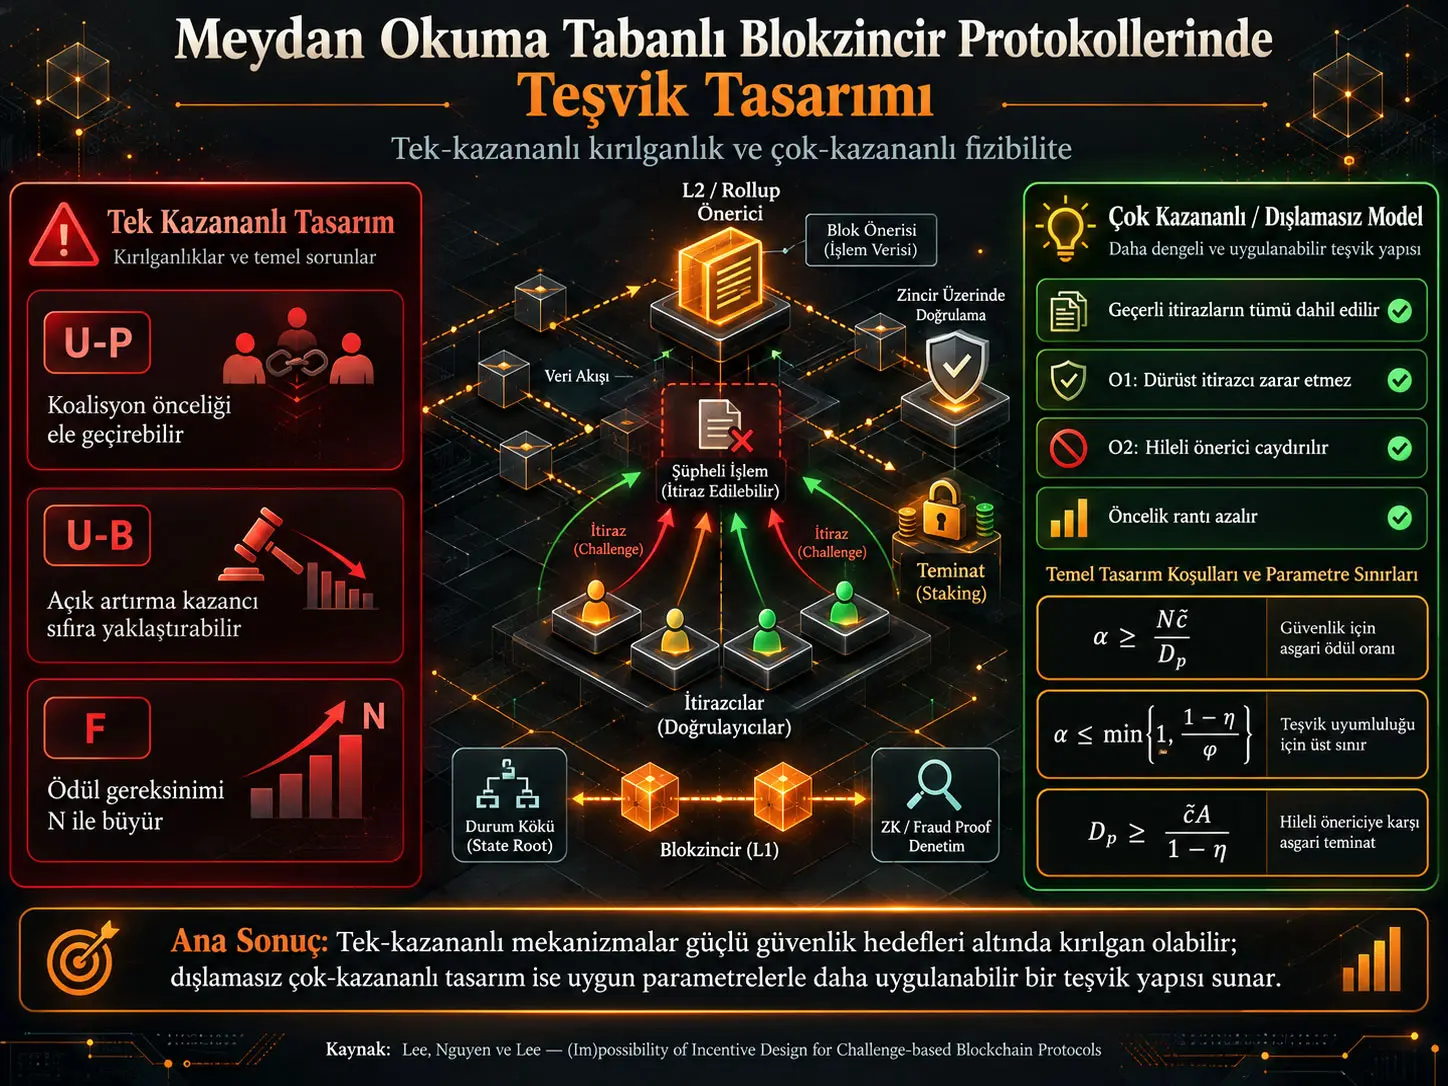
Meydan okuma tabanlı blokzincir protokolü, ağır hesaplamayı zincir dışında gerçekleştiren ve yalnız bir sonuç itiraz edildiğinde zincir üstü doğrulama mekanizmasını devreye alan bir güvenlik yaklaşımıdır. Bu çalışma, böyle bir sistemde “en az bir dürüst doğrulayıcı vardır” varsayımının ekonomik açıdan gerçekten sürdürülebilir olup olmadığını teorik mekanizma tasarımıyla incelemektedir. Araştırmacılar, dürüst itirazcıların zarar etmemesi ile hileli önericinin anlamlı ekonomik kayıp yaşaması hedeflerinin tek-kazananlı ve çok-kazananlı ödül tasarımlarında aynı anda karşılanıp karşılanamayacağını analiz etmektedir.
Modelde \(N\) itirazcı, bunların içinde önericiyle işbirliği yapabilen \(A
Çalışmanın en güçlü sonucu tek-kazananlı sistemler için ortaya çıkmaktadır. Önerici öncelikli durumda işbirlikçi veya Sybil itirazcı tek ödül yuvasını ele geçirerek dürüst tarafların katılım öncesi zarar etmesine yol açabilir. Builder açık artırmasında ise rekabet, kazananın elde ettiği ekonomik fazlayı sıfıra yaklaştırdığı için başlangıç doğrulama maliyeti geri kazanılamaz. Adil sıralama bu iki problemi doğrudan taşımasa da tek ödülün \(N\) katılımcı arasında rastgele paylaşılması nedeniyle gerekli ödül bütçesi \(N\) ile büyür ve sistem ölçek sınırına ulaşır.
Buna karşılık bütün geçerli itirazların kazanan olarak kabul edildiği çok-kazananlı dışlamasız tasarımda, ödül oranı için hem dürüst katılımı hem caydırıcılığı aynı anda sağlayabilen açık bir fizibilite aralığı elde edilmektedir. Bununla birlikte bu sonuç idealize edilmiş \(m=N\) ve \(f=0\) koşullarına dayanır. Gerçek dispute-window kapasitesi, sınırlı blok alanı, işlem ücretleri ve çok aşamalı protokol mantığı çalışmanın temel modelinin dışındadır.
Meydan Okuma Tabanlı Blokzincir Protokolü Nedir?
Meydan okuma tabanlı blokzincir protokolü, pahalı hesaplamayı varsayılan olarak zincir dışında bırakan ve yalnız gönderilen sonucun doğruluğuna itiraz edildiğinde on-chain doğrulama veya fraud-proof sürecini çalıştıran bir protokol ailesidir; güvenlik, yanlış sonuç yayımlandığında en az bir dürüst tarafın bunu tespit edip ekonomik olarak itiraz etmeye istekli olmasına bağlıdır.
Neden böyle bir mekanizmaya ihtiyaç duyulur?
Blokzincirlerde her düğümün aynı durumu yeniden hesaplaması doğrulanabilirlik sağlar ancak pahalıdır. Optimistic rollup ve Truebit benzeri sistemler bu yükü azaltmak için hesaplamayı zincir dışında yürütür ve zincirin tamamını yalnız anlaşmazlık durumunda kullanır.
Bu mimari teknik olarak güçlü görünse de ekonomik bir soru ortaya çıkar: hileyi tespit eden taraf gerçekten itiraz etmek isteyecek midir? Bir itirazcının önce veriyi doğrulaması, hileyi tespit etmesi ve ardından fraud proof işlemini sonuna kadar götürmesi maliyetlidir. Ödül yalnız bir kişiye verilirse çok sayıda dürüst katılımcının yaptığı doğrulama harcaması karşılıksız kalabilir.
İkinci sorun önericinin kendi Sybil hesaplarını veya işbirlikçi itirazcıları kullanabilmesidir. Hileli önerici teminat kaybetse bile ödülün bir kısmı kendi koalisyonuna geri dönerse gerçek ekonomik ceza tasarımcının öngördüğünden düşük olabilir.
Çalışmanın literatürde ele aldığı boşluk
BoLD, Dave ve başka fraud-proof sistemleri uyuşmazlıkların teknik olarak nasıl çözüleceğini ayrıntılandırmaktadır. Bu çalışma ise farklı bir düzeyde soru sorar: belirli bir fraud-proof algoritmasının iç ayrıntısından bağımsız olarak, ödül ve sıralama mekanizmasının ekonomik olarak hangi koşullarda çalışması mümkündür?
Bu nedenle model “mechanism-agnostic” tutulur. Amaç belirli bir rollup'ın bütün protokolünü simüle etmek değil, winner selection, priority ordering, maliyet ve koalisyon davranışı arasındaki temel ekonomik gerilimi matematiksel olarak izole etmektir.
Oyuncular
| Sembol | Varlık | Modeldeki rol |
|---|---|---|
| \(P\) | Önerici | Doğru veya hileli state/proposal yayımlayan taraf. |
| \(N\) | Toplam itirazcı sayısı | Belirli bir öneriyi doğrulayabilen ekonomik aktörlerin toplamı. |
| \(A\) | İşbirlikçi itirazcı sayısı | Önericiyle koalisyon oluşturan alt grubun büyüklüğü; varsayım \(A |
| \(\mathcal{A}\) | Koalisyon alt kümesi | Önericiyle uyumlu hareket edebilen itirazcı kümesi. |
| \(\phi=A/N\) | Koalisyon oranı | Toplam itirazcılar içindeki işbirlikçi payı. |
Model normal-form ve complete-information oyun olarak kurulmuştur. Başka bir ifadeyle oyuncular ödeme yapısını bilir ve stratejilerini bu ortak bilgi altında seçer.
İtiraz maliyetinin iki bileşeni
Her itirazcının toplam maliyeti:
\[ c_i=c_i^{\mathrm{init}}+c_i^{\mathrm{proc}} \]
olarak tanımlanır.
\(c_i^{\mathrm{init}}\), sahtekârlığı kontrol etmek ve geçerli bir itiraz başlatmak için gereken başlangıç doğrulama maliyetidir. \(c_i^{\mathrm{proc}}\) ise itiraz sürecini sonuna kadar yürütmek, örneğin gerekli zincir üstü işlemleri gerçekleştirmek için gereken işlem maliyetidir.
Maliyetler itirazcılar arasında farklı olabilir fakat bilinen sonlu üst sınırlara sahip olduğu varsayılır:
\[ \tilde c^{\mathrm{init}} \geq \sup_i c_i^{\mathrm{init}}, \qquad \tilde c^{\mathrm{proc}} \geq \sup_i c_i^{\mathrm{proc}}. \]
Toplam en kötü durum maliyet sınırı:
\[ \tilde c= \tilde c^{\mathrm{init}} + \tilde c^{\mathrm{proc}} \]
olarak tanımlanır. Böylece her itirazcı için \(c_i\leq\tilde c\) kabul edilir.
Önerici teminatı nasıl dağıtılır?
Geçerli bir fraud proof kabul edildiğinde önericinin \(D_p\) teminatı slash edilir. Bunun \(\alpha D_p\) bölümü kazanan itirazcılara ödül olarak dağıtılır:
\[ 0<\alpha\leq1. \]
Geriye kalan:
\[ (1-\alpha)D_p \]
miktarı yakılır. Kaynak, bu partial-burning mekanizmasının challenge protokollerinde evrensel standart olduğunu iddia etmez; modelde, koalisyon ödülün bir kısmını geri alsa bile önericinin belirli bir ekonomik kayıp yaşamasını güvence altına alabilmek için kullanır.
\(m\) kazanan varsa her birinin brüt ödülü eşit bölüşüm kuralıyla:
\[ \frac{\alpha D_p}{m} \]
olur.
Best-effort participation varsayımı
Model, kamuya açık muhafazakâr ücret sınırı ve ilan edilmiş inclusion capacity altında beklenen net ödülü negatif olmayan doğrulayıcıların dispute window içinde geçerli challenge göndermeye çalıştığını varsayar.
Bu varsayım koalisyon açısından önemli bir sonuç üretir. Dürüst tarafların ödül kazanmak için challenge gönderdiği durumda önericiyle işbirliği yapan taraflar da slashed deposit'ten pay geri kazanmak için geçerli challenge göndermeye ekonomik olarak yönelir. Kaynak bunu “coalition recapture” davranışı olarak tanımlar.
Üç sıralama rejimi
| Rejim | Sıralamayı kim belirler? | Öncelik maliyeti | Temel ekonomik özellik |
|---|---|---|---|
| U-P | Önerici | Dürüst itirazcı \(f^\star\) öder; koalisyon içinde ödeme geri döndüğü için etkin maliyet sıfıra yaklaşabilir. | Sybil/koalisyon tek slotu ele geçirebilir. |
| U-B | Dış builder veya block producer | Açık artırma ücreti dış builder'a ödenir. | Rekabet kazanan ekonomik fazlasını sıfıra yaklaştırabilir. |
| F | Kimlik ve ücretten bağımsız rastgele sıralama | \(f=0\) | Öncelik rantı kaldırılır fakat tek kazanan varsa kazanma olasılığı \(1/N\)'e düşer. |
Özel değer ve market-clearing fee
Bir priority slot için kazanan itirazcının işlem aşamasındaki özel değeri:
\[ v_i= \frac{\alpha D_p}{m} - c_i^{\mathrm{proc}} \]
olarak tanımlanır.
Builder açık artırmasında piyasa temizleme ücreti \(f^\star\), rekabet arttıkça bu değere yaklaşabilir. Bu durumda:
\[ v_i-f^\star\rightarrow0. \]
İlk doğrulama maliyeti \(c_i^{\mathrm{init}}\) açık artırma aşamasına gelindiğinde sunk cost olduğundan, kazanan slotundan kalan küçük fazlanın bu maliyeti karşılamaması temel tek-kazananlı U-B problemidir.
Tek Kazananlı Challenge Ödülü Neden Kırılgandır?
Tek kazananlı challenge ödülü, yalnız bir itirazcının ödeme aldığı ortamda sıralama gücü veya açık artırma rekabetinin dürüst katılım gelirini ortadan kaldırabilmesi ve adil sıralamada bile kazanma olasılığının \(1/N\)'e düşmesi nedeniyle kaynakta tanımlanan güçlü ex-ante bireysel rasyonellik hedefiyle gerilim içindedir.
İki güvenlik hedefi
O1 — Ex-ante bireysel rasyonellik:
\[ E[U_i]\geq0 \]
olmalıdır. Bu koşul yalnız “bir tane dürüst itirazcı kârlı olsun” demez. Hileli durumda koalisyonda olmayan her dürüst itirazcının katılım kararından önce beklenen faydasının negatif olmamasını ister.
O2 — \(\eta\)-oranlı caydırıcılık:
\[ Loss_{\mathrm{adv}} \geq \eta D_p, \qquad 0<\eta<1. \]
Burada amaç hilenin yalnız teknik olarak düzeltilmesi değildir. Hile tespit edildiğinde önerici ve koalisyonunun teminatın belirli bir oranını gerçekten kaybetmesi gerekir.
Koalisyon ödülün bir bölümünü geri alabilir
Koalisyon oranı:
\[ \phi=\frac{A}{N} \]
olduğunda ve koalisyon itirazcı ödüllerinden \(\phi\) oranında pay geri kazanabildiğinde önerici-koalisyon toplam kaybı:
\[ Loss_{\mathrm{adv}} = D_p-\phi\alpha D_p = (1-\phi\alpha)D_p \]
olur.
Bu ifade neden yalnız “teminat slash edildi” demenin yeterli olmadığını gösterir. Eğer slashed teminatın büyük bölümü koalisyon tarafından tekrar kazanılıyorsa nominal slashing ile gerçek ekonomik kayıp aynı şey değildir.
O1'in genel alt sınırı
Dahil edilen bir dürüst kazananın net getirisi:
\[ \frac{\alpha D_p}{m}-c_i-f \]
olduğundan en kötü durum maliyeti \(c_i=\tilde c\) altında:
\[ \alpha \geq \alpha_L(m,f) = \frac{m(\tilde c+f)}{D_p} \]
koşulu O1'in alt sınırıdır.
Matematiksel olarak \(m\), \(f\) veya \(\tilde c\) arttıkça gerekli \(\alpha\) büyür. \(D_p\) büyüdükçe aynı ödül güvenliği daha düşük \(\alpha\) ile sağlanabilir.
O2'nin üst sınırı
Caydırıcılık koşulundan:
\[ (1-\phi\alpha)D_p \geq \eta D_p \]
elde edilir. \(D_p>0\) için sadeleştirilirse:
\[ \phi\alpha\leq1-\eta \]
ve dolayısıyla:
\[ \alpha \leq \min \left\{ 1, \frac{1-\eta}{\phi} \right\}. \]
Bu denklem sistemin temel gerilimini gösterir: dürüst katılım \(\alpha\)'yı yukarı çekmek isterken caydırıcılık, koalisyon ödülü geri kazanabildiği için \(\alpha\)'ya üst sınır koyar.
Koalisyon oranı bilinmiyorsa muhafazakâr sınır
Kaynağın \(A
\[ \alpha\leq2(1-\eta) \]
olur. Bu sınırın gerçekten \(1\)'den küçük ve dolayısıyla kısıtlayıcı olması için:
\[ \eta>\frac{1}{2} \]
gereklidir.
U-P: önerici öncelikli tek-kazananlı sistem
U-P rejiminde önerici tek sıralama slotunu açık artırır. İşbirlikçi bir Sybil itirazcının ödediği öncelik ücreti önericinin kendisine döndüğünden koalisyon açısından etkin maliyet sıfır olabilir.
Kaynak, koalisyonun piyasa temizleme fiyatının biraz üzerinde teklif veren bir Sybil itirazcı seçebileceğini ve tek slotu deterministik olarak alabileceğini gösterir. Bu durumda dürüst itirazcı için:
\[ q_i=0 \]
ve:
\[ E[U_i] = -c_i^{\mathrm{init}} <0. \]
Dolayısıyla protokol parametreleri \(\alpha\) ve \(D_p\) büyütülse bile kaynak modelindeki O1 garanti edilemez; problem ödül miktarından önce inclusion priority'de ortaya çıkmaktadır.
U-B: dış builder açık artırması
U-B durumunda ödül slotu önerici yerine dış builder tarafından satılır. Bu nedenle koalisyonun ücret geri kazanma avantajı U-P ile aynı değildir. Buna rağmen başka bir problem ortaya çıkar.
İtirazcının bidding aşamasındaki slot değeri:
\[ v_i = \alpha D_p - c_i^{\mathrm{proc}} \]
ve beklenen fayda:
\[ E[U_i] = q_i(v_i-f^\star) - c_i^{\mathrm{init}} \]
olur.
Rekabetçi açık artırmada \(f^\star\), \(v_i\)'ye yaklaştığında:
\[ v_i-f^\star\rightarrow0. \]
Böylece başlangıç maliyeti pozitif olduğu sürece ex-ante fayda negatif kalabilir. Kaynağın ikinci imkânsızlık sonucu bu mekanizmaya dayanır.
Adil sıralama tek başına problemi çözmüyor
Adil rejimde kısa aynı-zamanlı arrival interval içindeki geçerli itirazlar rastgele sıralanır ve \(f\simeq0\) kabul edilir. Tek kazanan varsa her dürüst katılımcının kazanma olasılığı:
\[ \frac{1}{N} \]
olur.
Bir katılımcının beklenen faydası:
\[ E[U_i] = \frac{1}{N} \left( \alpha D_p-c_i^{\mathrm{proc}} \right) - c_i^{\mathrm{init}} \]
şeklindedir.
En kötü durum maliyetleri kullanıldığında O1 için:
\[ \alpha D_p \geq N\tilde c^{\mathrm{init}} + \tilde c^{\mathrm{proc}} \]
gereklidir.
Dolayısıyla adil sıralama Sybil priority capture problemini ortadan kaldırsa bile tek kazanan ödülü büyük \(N\) altında başka bir ölçeklenebilirlik problemi üretir. Gerekli reward pool katılımcı sayısıyla büyürken O2 aynı anda \(\alpha\)'yı yukarıdan sınırlar.
Çalışmanın Yöntemi ve Bulguları
Araştırmanın yöntemi
Çalışma ampirik blockchain verisi kullanmaz. Araştırmacılar mekanizma tasarımı yaklaşımıyla bir ekonomik oyun tanımlar; oyuncuları, maliyetleri, koalisyon oranını, ödül dağıtımını, sıralama biçimini ve güvenlik hedeflerini sabitleyerek hangi parametre bölgelerinin matematiksel olarak mümkün olduğunu türetir.
| Öğe | Kaynak modelindeki tanım |
|---|---|
| Oyun türü | Complete-information normal-form challenge game |
| Önerici | \(P\) |
| İtirazcı sayısı | \(N\) |
| İşbirlikçi alt küme | \(A |
| Koalisyon oranı | \(\phi=A/N\) |
| Önerici teminatı | \(D_p\) |
| Ödül oranı | \(\alpha\in(0,1]\) |
| Kazanan sayısı | \(m\) |
| İtirazcı toplam maliyeti | \(c_i=c_i^{\mathrm{init}}+c_i^{\mathrm{proc}}\) |
| En kötü durum maliyeti | \(\tilde c=\tilde c^{\mathrm{init}}+\tilde c^{\mathrm{proc}}\) |
| Öncelik ücreti | \(f\) |
| Minimum caydırma seviyesi | \(\eta\in(0,1)\) |
Tek-kazananlı üç rejimin sonucu
| Rejim | Ana mekanizma | Kaynak sonucu |
|---|---|---|
| U-P, \(m=1\) | Önerici koalisyonu tek priority slotunu Sybil itirazcıyla ele geçirebilir. | O1 garanti edilemez; dürüst itirazcı için \(q_i=0\) ve \(E[U_i]=-c_i^{\mathrm{init}}<0\). |
| U-B, \(m=1\) | Rekabetçi priority auction kazanan fazlasını sıfıra yaklaştırır. | Pozitif başlangıç maliyeti nedeniyle ex-ante O1 garanti edilemez. |
| F, \(m=1\) | Her itirazcının kazanma olasılığı \(1/N\). | \(\alpha D_p\geq N\tilde c^{\mathrm{init}}+\tilde c^{\mathrm{proc}}\); büyük \(N\) altında ölçek sınırı. |
Çok Kazananlı Dışlamasız Tasarım Ne Zaman Teşvik Açısından Fizibldir?
Çok kazananlı dışlamasız tasarım, bütün \(N\) geçerli itirazın ödüle dahil edildiği \(m=N\) ve sıralama rantının ortadan kalktığı \(f=0\) koşulunda, O1'in gerektirdiği alt ödül sınırı O2'nin izin verdiği üst ödül sınırını aşmıyorsa fizibldir.
Çok-kazananlı ödeme yapısı
Tüm \(N\) geçerli itirazcı dahil edildiğinde her katılımcının brüt ödülü:
\[ \frac{\alpha D_p}{N} \]
olur.
Kaynağın dışlamasız modelinde priority slot kıtlığı ortadan kalktığı için:
\[ f=0 \]
alınır.
O1'in çok-kazananlı alt sınırı
Her itirazcı için:
\[ \frac{\alpha D_p}{N} - \tilde c \geq0 \]
olmalıdır. Buradan:
\[ \alpha \geq \frac{N\tilde c}{D_p} \]
elde edilir.
O2 üst sınırı değişmez
Koalisyonun gerçek kayıp koşulu yine:
\[ \alpha \leq \min \left\{ 1, \frac{1-\eta}{\phi} \right\} \]
şeklindedir.
Fizibilite aralığı
İki koşul birlikte yazıldığında:
\[ \boxed{ \alpha \in \left[ \frac{N\tilde c}{D_p}, \; \min \left\{ 1, \frac{1-\eta}{\phi} \right\} \right] } \]
elde edilir.
Aralığın boş olmaması için:
\[ \frac{N\tilde c}{D_p} \leq \min \left\{ 1, \frac{1-\eta}{\phi} \right\} \]
gereklidir.
Bu sonuç çalışmanın en önemli yapıcı sonucudur. Tek-kazananlı analiz yalnız sorun göstermemekte; çok-kazananlı sistem için hangi ödül ve teminat parametrelerinin aynı anda iki güvenlik hedefini sağlayabileceğini de açıkça vermektedir.
İki kalibrasyon rejimi
Üst sınırın hangi terim tarafından belirlendiğine göre iki durum ortaya çıkar.
Rejim 1:
\[ \alpha=1. \]
Bu durumda bütün slashed deposit itirazcılara dağıtılabilir ve fizibilite için:
\[ D_p\geq N\tilde c \]
gibi \(N\) ile büyüyen bir teminat ihtiyacı ortaya çıkar. Bu ölçek-sınırlı rejimdir.
Rejim 2:
\[ \alpha = \frac{1-\eta}{\phi} <1. \]
\(\phi=A/N\) yerine yazıldığında fizibilite koşulu:
\[ \frac{N\tilde c}{D_p} \leq \frac{(1-\eta)N}{A} \]
olur.
\(N\) sadeleşir:
\[ \frac{\tilde c}{D_p} \leq \frac{1-\eta}{A}. \]
Dolayısıyla:
\[ \boxed{ D_p \geq \frac{\tilde c A}{1-\eta} } \]
elde edilir.
“Scale-free” ifadesi nasıl yorumlanmalı?
Bu eşitlikte toplam dürüst itirazcı sayısı \(N\) görünmez. Gerekli teminat, maliyet sınırı \(\tilde c\), koalisyondaki mutlak aktör sayısı \(A\) ve minimum caydırma seviyesi \(\eta\) ile belirlenmektedir.
Ancak bu sonuç yalnız aktif üst sınırın \((1-\eta)/\phi\) olduğu rejimde geçerlidir. Bunun için:
\[ \frac{1-\eta}{\phi}<1 \]
ve dolayısıyla:
\[ \phi>1-\eta \]
olmalıdır.
Bu koşul sağlanmazsa üst sınır yeniden \(1\) olur ve:
\[ D_p\geq N\tilde c \]
biçimindeki ölçek-sınırlı rejime geri dönülür. Bu nedenle kaynakta kullanılan “scale-free” kavramı koşullu bir mekanizma özelliğidir; bütün \(N\), \(A\), \(\eta\) kombinasyonlarında değişmez bir garanti değildir.
Güçlü güvenlik hedefleri neden sonucu değiştiriyor?
O1'in mevcut biçimi “en az bir dürüst itirazcı challenge göndermeye istekli olsun” hedefinden daha güçlüdür. O1, hileli durumda her dürüst katılımcının ex-ante expected utility değerinin negatif olmamasını ister.
Eğer O1 zayıflatılarak yalnız tek bir dürüst tarafın ekonomik olarak istekli olması yeterli görülürse protokolün güvenlik anlamı değişir. Güvenlik artık tüm permissionless katılımcılar için dayanıklı bir ekonomik özellik olmaktan çıkar ve belirli piyasa koşullarında belirli bir tarafın challenge göndermesine bağımlı hale gelebilir.
Benzer biçimde O2 kaldırılıp yalnız “hile sonunda yakalansın” denirse önericinin saldırıyı tekrar tekrar denemesi ekonomik olarak ucuz kalabilir. Teknik correctness sağlansa bile dispute işlemlerinin gas maliyeti, congestion ve finality delay gibi dışsal maliyetleri kullanıcılar üstlenebilir.
Maliyet geri ödemesi modeli nasıl değiştirebilir?
Kaynak temel modelde gas veya proving overhead gibi challenge maliyetlerinin ayrıca protokol tarafından reimbursed edildiğini varsaymaz. Gerçek bir sistem bu maliyetleri geri ödemek isterse maliyetin doğrulanabilir olması, yapay maliyet şişirmesinin ve Sybil splitting'in engellenmesi gerekir.
Bu tür reimbursement O1'in alt sınırını değiştirebilir ancak kaynak bunu ayrı bir genişletme ekseni olarak bırakmaktadır; mevcut teoremler otomatik olarak reimbursement içeren bütün protokollere uygulanmamalıdır.
Eşit bölüşüm zorunlu mu?
Hayır. Kaynak matematiğin izlenebilir olması için kazananlar arasında eşit bölüşüm kullanmaktadır. Gerçek protokol early-challenge veya contribution-weighted reward uygulayabilir.
Fakat daha yüksek erken ödül, ordering power sahibi saldırganın erken inclusion avantajını daha değerli hale getirebilir. Böylece tasarım tekrar tek-kazananlı mekanizmaya benzeyen priority competition davranışı üretebilir.
Gerçek deployment neden ideal dışlamasız modele tam uymayabilir?
İdeal model \(m=N\) varsayar; yani dispute window içinde her geçerli challenge'ın işlenebildiğini kabul eder. Gerçek zincirlerde blok kapasitesi ve dispute süresi sonludur.
Gerçek sistemde:
\[ m
olabilir ve inclusion scarcity geri döndüğünde:
\[ f>0 \]
olabilecek priority rents yeniden ortaya çıkabilir. Kaynağın gelecekteki araştırma önerilerinden biri tam olarak bu finite-capacity rejimin fizibilite bölgesini nasıl küçülttüğünü ölçmektir.
ZK fraud proof'lar açısından sonuç
ZK tabanlı fraud proof bir dispute'i tek succinct proof ile çözmeye yaklaştıkça protokol teknik olarak sadeleşebilir; ancak tek proof slotunun ekonomik değeri büyüyebilir.
Proof generation anlık olmadığı ve özel donanım/operasyonel hazırlık gerektirebildiği için kötü niyetli önerici hileli instance'ı yayımlamadan önce proof pipeline'ını hazırlama avantajına sahip olabilir. Eğer yalnız ilk proof veya çok küçük sayıda proof ödüllendiriliyorsa bu precomputation advantage ile ordering power birleşebilir.
Kaynak bu nedenle ZK fraud proof tasarımlarında da yalnız kriptografik doğruluğun değil, challenge inclusion ekonomisinin açıkça modellenmesi gerektiğini savunmaktadır.
Çalışmanın desteklediği sonuçlar
| Kaynak-destekli sonuç | Geçerli olduğu koşul |
|---|---|
| U-P tek-kazananlı rejimde O1 garanti edilemez. | Kaynağın proposer-priority ve coalition recycling varsayımları altında. |
| U-B tek-kazananlı rejimde O1 garanti edilemez. | Rekabetçi priority auction ve pozitif başlangıç maliyeti altında. |
| Adil tek-kazananlı rejimde ödül ihtiyacı \(N\) ile büyür. | Rastgele tek kazanan ve kaynak maliyet modeli altında. |
| Dışlamasız çok-kazananlı modelde O1 ve O2 aynı anda karşılanabilir. | \(m=N\), \(f=0\) ve fizibilite aralığı boş değilse. |
| Belirli kalibrasyon rejiminde teminat koşulundan \(N\) sadeleşir. | \(\phi>1-\eta\) olan nontrivial deterrence rejiminde. |
Çalışmanın desteklemediği sonuçlar
- Bütün single-winner blockchain sistemlerinin her güvenlik tanımı altında matematiksel olarak imkânsız olduğu gösterilmemiştir.
- Multi-winner tasarımın gerçek blockchain üzerinde throughput, gas veya latency bakımından uygulanabilirliği deneysel olarak gösterilmemiştir.
- BoLD, Dave veya Cannon protokollerinin tamamının mevcut halleriyle güvensiz olduğu sonucu çıkarılamaz.
- ZK fraud proof kullanan bütün sistemlerde önericinin pratikte priority slotunu ele geçireceği gösterilmemiştir.
- Model gerçek MEV dağılımı, gerçek gas-price zaman serisi veya canlı builder auction verisi kullanmamaktadır.
- Scale-free teminat koşulu bütün koalisyon oranları ve bütün \(N\) değerlerinde koşulsuz bir garanti değildir.
Modelin başlıca sınırlılıkları
Tek aşamalı abstraction: Gerçek fraud-proof protokolleri çok sayıda challenge ve response round'u içerebilir. Çalışma bunları tek bir challenge stage'e indirger.
Complete information: Oyuncuların payoff yapısının ortak bilgi olduğu varsayılır. Gerçek sistemde diğer tarafların gerçek maliyeti ve hazır altyapısı bilinmeyebilir.
Maliyet üst sınırlarının bilinebilirliği: Teoremler \(\tilde c^{\mathrm{init}}\) ve \(\tilde c^{\mathrm{proc}}\) gibi muhafazakâr fakat bilinen sınırlar kullanır. Deployment ortamında bunların güvenilir kalibrasyonu ayrı problemdir.
Equal split: Multi-winner ödülü eşit bölünmektedir. Başka reward rules farklı stratejik davranışlar oluşturabilir.
İdeal non-exclusion: Ana pozitif sonuç bütün geçerli challenge'ların işlenebildiği ideal \(m=N\) rejimine dayanır.
Ordering fee yaklaşımı: Dışlamasız tasarımda priority value azaldığı için \(f=0\) kullanılır. Kısmi kapasite kıtlığı bulunan gerçek sistemlerde \(f\) yeniden pozitif olabilir.
Gelecek çalışma yönleri
Kaynak, partial burning kullanan gerçek bir non-exclusion/multi-winner prototipinin geliştirilmesini ve performans ölçümleriyle kalibre edilmesini önermektedir.
İkinci yön, partially efficient markets ve daha gerçekçi saldırgan davranışları içeren uçtan uca simülasyonlardır.
Üçüncü yön BoLD ve Dave gibi multi-stage protokollerin bütün aşamalarını açıkça modele eklemektir.
Dördüncü yön, ZK tabanlı tek-shot fraud proof sistemlerinde precomputation advantage ile transaction ordering gücü arasındaki etkileşimi daha ayrıntılı analiz etmektir.
Kaynak ve Yöntem Notu
Özgün başlık: (Im)possibility of Incentive Design for Challenge-based Blockchain Protocols
Yazarlar: Suhyeon Lee; Dieu-Huyen Nguyen; Donghwan Lee.
Afiliyasyonlar: Tokamak Network; Suhyeon Lee için ek olarak Hashed Open Research.
Yüklenen kaynak: arXiv:2512.20864v2 [cs.GT].
Yüklenen sürüm tarihi: 5 Şubat 2026.
İlk arXiv gönderimi: 24 Aralık 2025.
arXiv DOI/kalıcı tanımlayıcı: 10.48550/arXiv.2512.20864.
Workshop: 10th Workshop on Trusted Smart Contracts — WTSC 2026, Financial Cryptography and Data Security 2026 ile birlikte, St. Kitts, 6 Mart 2026.
Yayın statüsü: Çalışma WTSC 2026 resmî programında kabul edilmiş/sunulmuş workshop çalışmasıdır. İncelenen dosya ise arXiv v2 preprintidir.
Springer proceedings durumu: FC 2026 workshopları için Revised Selected Papers cildi Springer Lecture Notes in Computer Science, volume 16564 olarak duyurulmuştur ve Aralık 2026 yayın tarihi listelenmektedir. Bu çalışma için nihai chapter DOI'si ve kesin sayfa aralığı mevcut doğrulamada belirlenemediği için eklenmemiştir.
Bilimsel çalışma türü: Teorik mekanizma tasarımı ve oyun teorisi.
Deney/saha durumu: Gerçek ağ deneyi, canlı rollup deployment testi veya ekonomik saha ölçümü yoktur.
Temel analiz birimi: Tek aşamalı fraud-challenge oyunu.
Ana tasarım hedefleri: O1 — bütün dürüst itirazcılar için ex-ante non-negative expected utility; O2 — tespit edilen hilede adversarial coalition için en az \(\eta D_p\) ekonomik kayıp.
İncelenen sıralama rejimleri: U-P — proposer-ordered priority; U-B — builder-ordered priority; F — fair ordering.
İncelenen ödül yapıları: Single-winner \(m=1\); multi-winner/non-exclusion \(m=N\).
Ana fizibilite sonucu: \(m=N\) ve \(f=0\) altında ödül oranı \(\alpha\), dürüst katılım alt sınırı ile caydırıcılık üst sınırı arasında kaldığında iki hedef aynı anda sağlanabilir.
Ana scale-free koşulu: İlgili nontrivial deterrence rejiminde \(D_p\geq\tilde cA/(1-\eta)\); bu sonuç \(\phi>1-\eta\) rejim koşuluyla birlikte okunmalıdır.
Finansman: Yüklenen PDF'de ayrı bir funding statement bulunmamaktadır.
Çıkar çatışması: Yüklenen PDF'de ayrı bir conflict-of-interest declaration bulunmamaktadır.
Veri erişilebilirliği: Çalışma teorik olduğundan bir ampirik veri seti analiz edilmemektedir; yüklenen PDF'de ayrı Data Availability Statement bulunmamaktadır.
Kod erişilebilirliği: Yüklenen PDF'de reference implementation veya doğrulanmış public code repository belirtilmemiştir; kaynak bunu gelecek çalışma konusu olarak bırakmaktadır.
Yazar katkıları: Ayrı CRediT contribution statement bulunmamaktadır.
Lisans: Yüklenen PDF üzerinde açık yeniden kullanım lisansı doğrulanmamıştır. Springer workshop volume sayfası IFCA 2026 copyright bilgisini vermektedir; spesifik chapter lisansı doğrulanmadığı için telif bakımından fail-closed yaklaşımı uygulanmıştır.
Önemli yorum notu: Kaynağın single-winner “impossibility” sonuçları O1 ve O2 biçimindeki güçlü permissionless-security hedeflerine ve tanımlanan ordering/cost modeline aittir. Daha zayıf güvenlik hedefleri veya başka payoff yapıları aynı teoremlerle otomatik olarak kapsanmaz.
Scale-free yorum notu: Lemma 3'teki \(N\)'den bağımsız teminat koşulu, hemen sonraki kalibrasyon tartışmasındaki \(\phi>1-\eta\) rejim şartıyla birlikte değerlendirilmelidir.
Telif/anlatım yöntemi: Kaynağın özgün paragraf örgüsü, tablolarının sunumu veya anlatım dili yeniden üretilmemiştir. Verianla metni; kaynakta tanımlanan oyuncular, maliyetler, denklemler, teoremler, rejimler, sonuçlar ve sınırlılıklar çıkarılarak bağımsız öğretici yapı içinde yeniden kurulmuştur.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir