


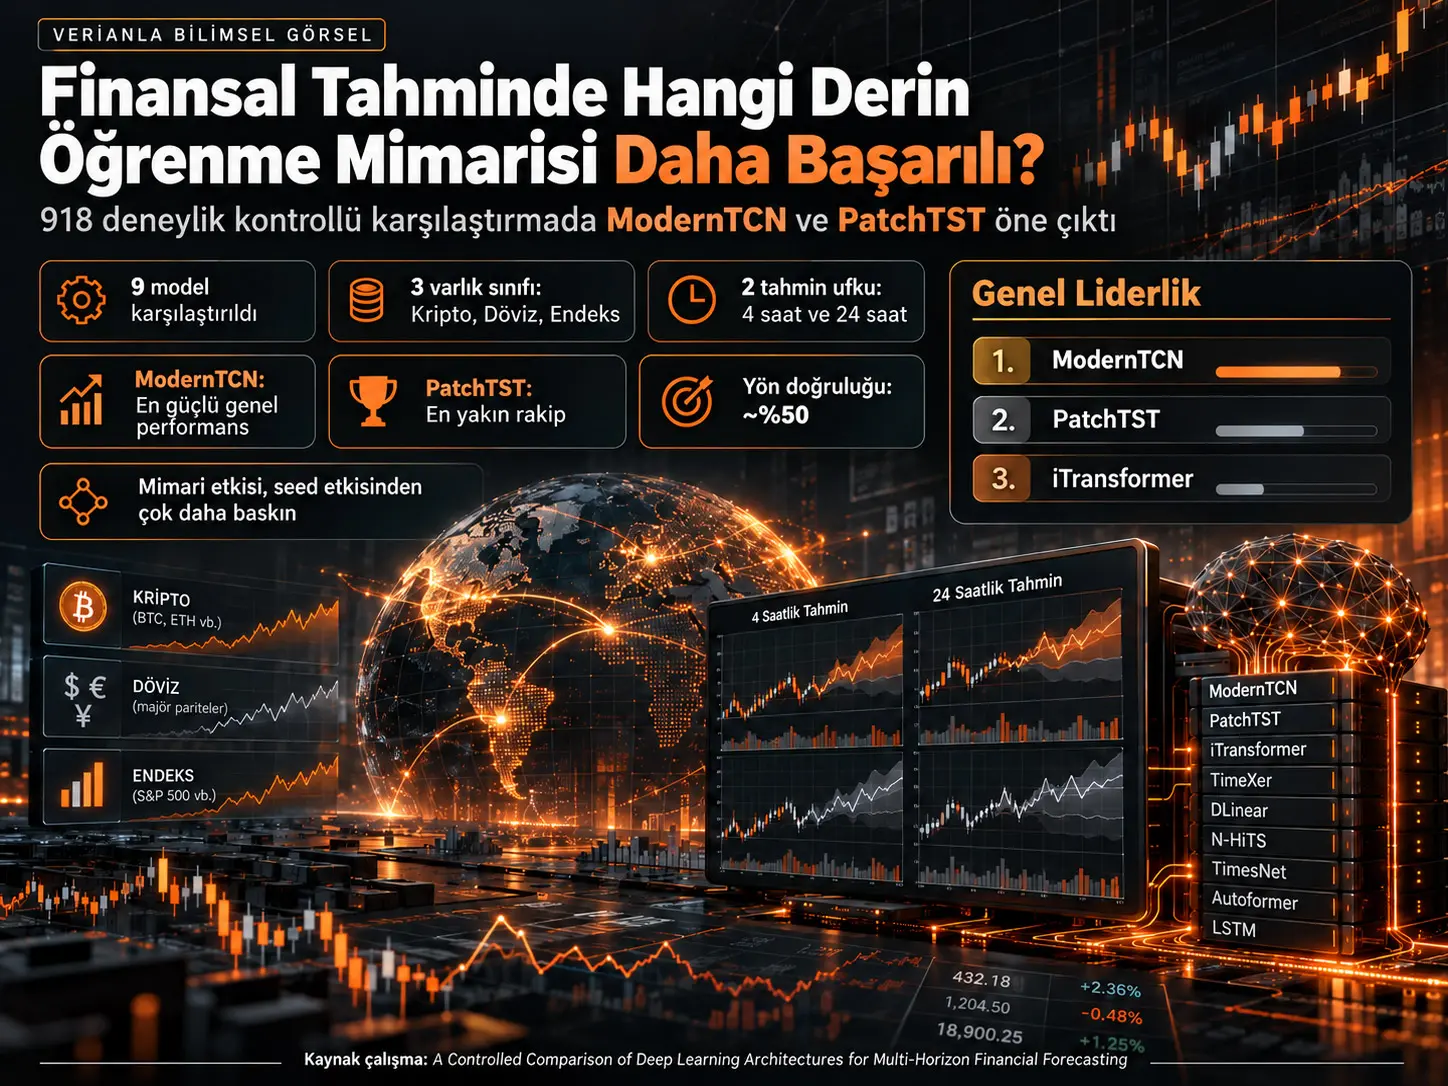
Bu çalışma, finansal zaman serilerinde çok ufuklu fiyat tahmini için kullanılan dokuz derin öğrenme mimarisini aynı deney protokolü altında karşılaştıran kontrollü bir benchmark çalışmasıdır. Autoformer, DLinear, iTransformer, LSTM, ModernTCN, N-HiTS, PatchTST, TimesNet ve TimeXer; kripto para, döviz ve hisse senedi endekslerinden oluşan üç varlık sınıfındaki 12 finansal araç üzerinde 4 saat ve 24 saat ileri tahmin görevlerinde değerlendirilmiştir. ModernTCN, büyük çekirdekli derinlik-ayrılabilir zamansal evrişimleri çok aşamalı aşağı örneklemeyle kullanan bir zaman serisi evrişim mimarisidir ve çalışmanın global sıralamasında 1,333 ortalama sıra ile ilk sıraya yerleşmiştir. PatchTST 2,000 ortalama sırayla ikinci olmuştur. Bununla birlikte bu sonuç, ModernTCN'nin her varlıkta veya her koşulda mutlak biçimde üstün olduğu anlamına gelmez; özellikle bazı kripto para çiftlerinde N-HiTS ve PatchTST en düşük RMSE değerini vermiştir.
Deney tasarımının ayırt edici yönü, modellerin farklı veri setleri veya farklı ayarlama bütçeleriyle değil aynı kontrollü süreçte sınanmasıdır. Toplam 918 çalıştırmanın 270'i hiperparametre optimizasyonu, 648'i ise dokuz model × 12 varlık × iki tahmin ufku × üç bağımsız seed kombinasyonundan oluşan nihai eğitimlerdir. Tüm modellere yalnız Açılış, En Yüksek, En Düşük, Kapanış ve Hacim değerlerinden oluşan OHLCV girdisi verilmiş; teknik gösterge, duygu verisi, emir defteri veya dışsal makroekonomik veri eklenmemiştir.
Global sonuçlar belirgin bir üç katmanlı sıralama göstermiştir. ModernTCN ve PatchTST üst grubu; iTransformer, TimeXer, DLinear ve N-HiTS orta grubu; TimesNet, Autoformer ve LSTM ise alt grubu oluşturmuştur. ModernTCN 24 varlık-ufuk değerlendirme noktasının 18'inde, yani %75'inde en düşük RMSE'yi elde etmiştir. Bununla birlikte ModernTCN ile PatchTST arasındaki küçük fark her varlıkta istatistiksel olarak ayrıştırılamamıştır; örneğin BTC/USDT için 24 saat ufkunda iki model arasındaki Diebold-Mariano karşılaştırması anlamlı değildir.
Çalışmanın ikinci önemli sonucu, fiyat seviyesini düşük hata ile tahmin etmek ile fiyatın yönünü tahmin etmek arasında güçlü bir ayrım bulunmasıdır. Dokuz model, üç varlık sınıfı ve iki tahmin ufkundan oluşan 54 model-sınıf-ufuk kombinasyonunda ortalama yön doğruluğu %50,08'dir. Bu değer yazı-tura düzeyinden ayırt edilememiştir. Dolayısıyla düşük RMSE veya MAE, otomatik olarak al-sat yönünün güvenilir biçimde tahmin edildiği anlamına gelmez.
Çalışma ayrıca model parametre sayısı arttıkça doğruluğun düzenli biçimde artmadığını göstermektedir. Yaklaşık 1.000 parametreli DLinear, yüz binlerce parametre kullanan bazı mimarilerden daha iyi sıralanmıştır. Bulgular, finansal zaman serisi tahmininde ham kapasiteden çok modelin zamansal yapıyı hangi indüktif önyargıyla temsil ettiğinin belirleyici olabileceğini desteklemektedir.
Araştırma problemi: “En büyük model” gerçekten en iyi tahminci mi?
Finansal zaman serilerinde derin öğrenme mimarilerinin sayısı hızla artarken modelleri adil biçimde karşılaştırmak kolay değildir. Bir mimariye daha fazla hiperparametre denemesi yapılması, yalnız tek random seed ile sonuç verilmesi, tek varlık sınıfının seçilmesi veya yalnız bir tahmin ufkunun kullanılması mimarinin gerçek gücü ile deney protokolünün etkisini birbirine karıştırabilir. Çalışma bu nedenle model ailesinden bağımsız tek bir deney düzeni kurarak mimari etkisini mümkün olduğunca izole etmeyi hedeflemektedir.
Yazar beş metodolojik boşluğu özellikle ele alır: eşit olmayan hiperparametre optimizasyonu bütçeleri, tek-seed değerlendirme, tek tahmin ufkuna dayalı karşılaştırmalar, çoklu ikili karşılaştırmalarda istatistiksel düzeltme eksikliği ve yalnız tek varlık sınıfıyla yapılan dar benchmarklar. Çalışmanın temel araştırma sorusu bu problemlerin aynı anda kontrol edildiği bir ortamda hangi zaman serisi mimarilerinin tutarlı biçimde öne çıktığıdır.
Dört hipotez
| Hipotez | Soru | Temel değerlendirme |
|---|---|---|
| H1 | Dokuz modelin performans sıralaması gerçekten eşit olmayan bir yapı mı gösteriyor? | Global sıralama, kazanma sayısı, Friedman–Iman–Davenport ve düzeltilmiş ikili karşılaştırmalar. |
| H2 | 4 saatlik ufukta iyi olan modeller 24 saatlik ufukta da göreli üstünlüklerini koruyor mu? | Varlık bazında Spearman sıra korelasyonu ve ufuklar arası hata artışı. |
| H3 | Performans farklılıklarında mimari seçimi mi, random seed mi daha önemli? | İki faktörlü varyans ayrıştırması ve sınıf içi korelasyon katsayısı. |
| H4 | Daha fazla parametre daha iyi tahmin anlamına geliyor mu? | Model büyüklüğü ile RMSE sırası arasındaki ilişki ve Jonckheere–Terpstra testi. |
Finansal Tahminde Mimari İndüktif Önyargı Neden Önemlidir?
Mimari indüktif önyargı, bir modelin zaman serisindeki hangi yapıların öğrenilmesini doğal olarak kolaylaştırdığını belirleyen tasarım tercihidir; bu çalışmada parametre sayısından daha büyük açıklayıcı öneme sahip olduğu görülmüştür. ModernTCN yerel ve çok ölçekli örüntüleri büyük çekirdekli evrişimlerle, PatchTST zaman serisini yamalara bölerek, N-HiTS çoklu zaman ölçeklerini hiyerarşik havuzlamayla, Autoformer ve TimesNet ise periyodik veya frekans temelli yapılarla temsil eder. Finansal veride bu farklı varsayımlar aynı parametre bütçesinde bile belirgin performans farkları üretmiştir.
Karşılaştırılan dokuz mimari
| Model | Aile | Temel mekanizma | Çalışmadaki temel yorumu |
|---|---|---|---|
| ModernTCN | TCN / CNN | Büyük çekirdekli depthwise evrişimler, çok aşamalı aşağı örnekleme, RevIN seçeneği | Genel sıralamada birinci ve en istikrarlı üst grup modeli. |
| PatchTST | Transformer | Zaman dizisini yamalara ayırma, kanal-bağımsız Transformer, RevIN | Genel sıralamada ikinci; ModernTCN'ye çok yakın üst grup performansı. |
| iTransformer | Transformer | Zaman adımları yerine değişkenler üzerinde ters çevrilmiş dikkat | Genel sıralamada üçüncü. |
| TimeXer | Transformer | Hedef ve dışsal değişkenleri ayıran çapraz dikkat | Genel sıralamada dördüncü. |
| DLinear | Doğrusal / MLP ailesi | Trend ve mevsimsellik ayrıştırması sonrası doğrusal eşlemeler | Yaklaşık 1.000 parametreyle dikkat çekici verimlilik. |
| N-HiTS | MLP | Çok oranlı pooling ve hiyerarşik interpolasyon | Bazı altcoinlerde niş üstünlük. |
| TimesNet | CNN | FFT ile periyot tespiti, 1B dizinin 2B yapıya dönüştürülmesi | Finansal saatlik veride alt grupta. |
| Autoformer | Transformer | Frekans alanında otokorelasyon ve seri ayrıştırması | Finansal saatlik veride alt grupta. |
| LSTM | RNN | Kapılı tekrarlayan hücreler ve yoğun projeksiyon başlığı | Bu protokolde son sırada; modern modellerden belirgin biçimde daha yüksek hata. |
Neden finansal zaman serileri zordur?
Finansal seriler fiziksel sistemler gibi sabit yasalarla ilerlemez. Dağılımlar zaman içinde değişebilir, getiriler ağır kuyruk gösterebilir, oynaklık kümelenebilir ve piyasa rejimleri aniden değişebilir. Çalışmanın 12 varlığa ilişkin saatlik log-getiri analizi de sıfıra yakın ortalama getiriler, belirgin ağır kuyruklar ve varlık sınıfları arasında büyük oynaklık farkları göstermektedir. Kripto paralarda saatlik oynaklık yaklaşık %1 ölçeğindeyken dövizlerde yaklaşık %0,1, endekslerde yaklaşık %0,2 civarındadır.
Bu yapı, yalnız bir fiyat eğrisini ezberleyen model yerine farklı zaman ölçeklerindeki değişimleri ve dağılım kaymasını yönetebilen temsillerin neden önemli olabileceğini açıklamaktadır. Ancak bu açıklama mekanik bir nedensellik kanıtı değildir; araştırmanın mimari karşılaştırma bulgularını anlamlandıran model-tasarım yorumudur.
Varlık evreni
| Sınıf | Finansal araçlar | Frekans | Her varlık için kullanılan gözlem |
|---|---|---|---|
| Kripto para | BTC/USDT, ETH/USDT, BNB/USDT, ADA/USDT | H1, saatlik | En güncel 30.000 zaman adımı |
| Döviz | EUR/USD, USD/JPY, GBP/USD, AUD/USD | H1, saatlik | En güncel 30.000 zaman adımı |
| Hisse senedi endeksleri | Dow Jones, S&P 500, NASDAQ 100, DAX | H1, saatlik | En güncel 30.000 zaman adımı |
Girdi neden yalnız OHLCV?
Tüm modellere aynı beş kanal verilmiştir: Open, High, Low, Close ve Volume. Hedef değişken gelecek Close fiyatıdır. Teknik indikatör, gecikmeli getiri, takvim değişkeni, haber, duygu analizi veya emir defteri eklenmemesi bilinçli bir kontroldür. Böylece performans farkının mümkün olduğunca özellik mühendisliğinden değil model mimarisinden gelmesi hedeflenmiştir.
Bu seçim aynı zamanda önemli bir yorum sınırı oluşturur. Haber, order-book, teknik indikatör veya daha zengin dışsal değişkenleri özellikle kullanmak üzere tasarlanan bir mimarinin burada aldığı sıra, o modelin tüm olası finansal tahmin görevlerindeki kesin sırası değildir.
Doğrudan çok-adımlı tahmin
Her model bütün tahmin ufkunu tek ileri geçişte üretmektedir. Model girdisi \(X_t \in \mathbb{R}^{w \times 5}\), çıktı ise gelecekteki kapanış fiyatlarından oluşan \(\hat{y}_{t+1:t+h}\) vektörüdür:
\[ \hat{y}_{t+1:t+h}=f_{\theta}(X_t), \qquad h \in \{4,24\}. \]
Burada \(w\) geçmişe bakış penceresi, \(h\) tahmin ufku, \(f_{\theta}\) öğrenilebilir parametreleri \(\theta\) ile tanımlanan modeldir. Dört saatlik görev için \(w=24\), 24 saatlik görev için \(w=96\) kullanılmıştır. Modeller bir önceki tahmini tekrar giriş olarak kullanmadığından klasik rekürsif çok-adımlı tahminde ortaya çıkan hata birikimi bu deney tasarımına dâhil değildir.
Normalizasyon ve veri sızıntısının önlenmesi
Her varlığın en güncel 30.000 saatlik kaydı kullanılmıştır. Z-skor normalizasyonunun ortalama ve standart sapması yalnız eğitim bölümünde hesaplanmış ve aynı dönüştürme doğrulama ile test verisine uygulanmıştır. Böylece gelecekteki dağılım bilgisinin ölçekleyici üzerinden eğitim sürecine sızması önlenmiştir. Tahminler değerlendirme öncesinde yeniden özgün fiyat ölçeğine çevrilmiştir.
| Bölüm | Oran | Yaklaşık örnek sayısı | Kural |
|---|---|---|---|
| Eğitim | %70 | 21.000 | İlk kronolojik bölüm |
| Doğrulama | %15 | 4.500 | Sonraki kronolojik bölüm |
| Test | %15 | 4.500 | En son kronolojik bölüm |
Hiçbir aşamada zaman sırası karıştırılmamıştır.
Çalışmanın Yöntemi ve Bulguları
Beş aşamalı kontrollü deney protokolü
| Aşama | İşlem | Bilimsel amaç |
|---|---|---|
| 1 | Sabit seed ile Bayesian hiperparametre optimizasyonu | Modellere eşit HPO bütçesi ayırmak. |
| 2 | Varlık sınıfı başına en iyi konfigürasyonun dondurulması | Her varlığa ayrı ayar yaparak asset-level overfitting oluşmasını önlemek. |
| 3 | Üç bağımsız seed ile nihai eğitim | Random başlangıç etkisini ölçmek. |
| 4 | RMSE, MAE ve DA sonuçlarının seed'ler üzerinde birleştirilmesi | Ortalama performansı ve başlangıç belirsizliğini birlikte raporlamak. |
| 5 | Benchmark ve istatistiksel doğrulama | Sıralamanın yalnız görsel farklara değil istatistiksel kanıta dayanmasını sağlamak. |
Hiperparametre optimizasyonu
Optuna Tree-structured Parzen Estimator kullanılmıştır. Her model × varlık sınıfı × tahmin ufku kombinasyonu için beş HPO denemesi ayrılmış ve HPO seed'i 42 olarak sabitlenmiştir. Temsilci varlıklar kripto için BTC/USDT, forex için EUR/USD ve endeksler için Dow Jones'tur. HPO sırasında her trial en fazla 50 epoch çalıştırılmıştır.
Beş trial geniş bir hiperparametre uzayı için sınırlı bir bütçedir. Yazar bunu tüm mimarilere simetrik bir bütçe uygulamak ve finansal veride geçici piyasa rejimlerine aşırı uyum riskini azaltmak amacıyla tercih etmektedir. Bununla birlikte bu karar çalışmanın önemli sınırlılıklarından biridir; daha geniş HPO bütçesi özellikle orta sıralardaki modellerin konumunu değiştirebilir.
Nihai eğitim protokolü
- Seed'ler: 123, 456 ve 789.
- Azami epoch: 100.
- Optimizasyon: Adam.
- Weight decay: \(10^{-4}\).
- Öğrenme oranı zamanlayıcısı: ReduceLROnPlateau.
- Scheduler patience: 5; azaltma katsayısı: 0,5; minimum öğrenme oranı: \(10^{-6}\).
- Early stopping patience: 15.
- Minimum iyileşme eşiği: \(10^{-4}\).
- Gradient clipping: \(\ell_2\) normu 1,0 ile sınırlandırılmıştır.
- Kayıp fonksiyonu: Mean Squared Error.
Eğitim kaybı:
\[ \mathcal{L}(\theta)=\frac{1}{n}\sum_{i=1}^{n}\left\|y_i-\hat{y}_i\right\|^2. \]
Bu kayıp büyük tahmin hatalarını karesel olarak cezalandırır. Aynı amaç fonksiyonunun tüm modellerde kullanılması, bir mimarinin farklı bir eğitim hedefi sayesinde yapay avantaj kazanmasını önlemektedir.
RMSE, MAE ve Yön Doğruluğu Aynı Şeyi mi Ölçer?
Hayır. RMSE ve MAE tahmin edilen fiyat ile gerçekleşen fiyat arasındaki büyüklük hatasını ölçerken yön doğruluğu, fiyat değişiminin işaretinin doğru tahmin edilip edilmediğini ölçer. Bu çalışmada modeller RMSE ve MAE bakımından belirgin biçimde ayrışırken yön doğruluğu yaklaşık %50 düzeyinde kalmıştır; bu nedenle iyi bir fiyat-seviyesi tahmincisinin otomatik olarak iyi bir al-sat yönü tahmincisi olduğu sonucuna varılamaz.
RMSE
\[ \mathrm{RMSE}= \sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2}. \]
RMSE büyük hatalara daha yüksek ağırlık verir ve çalışmanın birincil sıralama ölçütüdür.
MAE
\[ \mathrm{MAE}= \frac{1}{n}\sum_{i=1}^{n}|y_i-\hat{y}_i|. \]
MAE mutlak hata büyüklüğünü ölçer ve uç hatalara RMSE kadar güçlü karesel ceza uygulamaz. Çalışmada RMSE ile MAE sıralamalarının çok yüksek uyum göstermesi, model sıralamasının tek bir hata metriğine özgü olmadığını desteklemektedir.
Directional Accuracy
\[ \mathrm{DA}= \frac{1}{n} \sum_{i=1}^{n} \mathbf{1} \left[ \operatorname{sign}(\hat{y}_i-\hat{y}_{i-1}) = \operatorname{sign}(y_i-y_{i-1}) \right]. \]
Bu metrik, tahmin edilen fiyat hareketinin yönü ile gerçekleşen yönün eşleştiği adımların oranını ölçer.
Toplam deney ölçeği
| Deney bileşeni | Hesaplama | Çalıştırma sayısı |
|---|---|---|
| HPO | 9 model × 3 temsilci varlık × 2 ufuk × 5 trial | 270 |
| Nihai eğitim | 9 model × 12 varlık × 2 ufuk × 3 seed | 648 |
| Toplam | 270 + 648 | 918 |
Global performans sıralaması
| Sıra | Model | Aile | Ortalama sıra | Medyan sıra | Birincilik |
|---|---|---|---|---|---|
| 1 | ModernTCN | CNN / TCN | 1,333 | 1,000 | 18 / 24 (%75) |
| 2 | PatchTST | Transformer | 2,000 | 2,000 | 3 / 24 (%12,5) |
| 3 | iTransformer | Transformer | 3,667 | 3,000 | 0 |
| 4 | TimeXer | Transformer | 4,292 | 4,000 | 0 |
| 5 | DLinear | MLP / Linear | 4,958 | 5,000 | 0 |
| 6 | N-HiTS | MLP / Linear | 5,250 | 6,000 | 3 / 24 (%12,5) |
| 7 | TimesNet | CNN | 7,708 | 8,000 | 0 |
| 8 | Autoformer | Transformer | 7,833 | 8,000 | 0 |
| 9 | LSTM | RNN | 7,958 | 9,000 | 0 |
Bu tablo iki önemli noktayı gösterir. Birincisi, model ailesi tek başına başarıyı açıklamaz: Transformer ailesi hem ikinci sıradaki PatchTST'yi hem de sekizinci sıradaki Autoformer'ı içerir; benzer biçimde CNN ailesinde ModernTCN birinciyken TimesNet yedincidir. İkincisi, spesifik zamansal temsil mekanizması geniş “Transformer/CNN/RNN” etiketinden daha ayırt edici görünmektedir.
Varlık bazında en düşük RMSE'yi veren model
| Sınıf | Varlık | 4 saat | 24 saat |
|---|---|---|---|
| Kripto | BTC/USDT | PatchTST | ModernTCN |
| Kripto | ETH/USDT | N-HiTS | N-HiTS |
| Kripto | BNB/USDT | ModernTCN | ModernTCN |
| Kripto | ADA/USDT | N-HiTS | PatchTST |
| Forex | EUR/USD | ModernTCN | ModernTCN |
| Forex | USD/JPY | ModernTCN | ModernTCN |
| Forex | GBP/USD | PatchTST | ModernTCN |
| Forex | AUD/USD | ModernTCN | ModernTCN |
| Endeks | DAX | ModernTCN | ModernTCN |
| Endeks | Dow Jones | ModernTCN | ModernTCN |
| Endeks | S&P 500 | ModernTCN | ModernTCN |
| Endeks | NASDAQ 100 | ModernTCN | ModernTCN |
Tablodan doğrudan hesaplandığında ModernTCN kripto dışındaki forex ve endeks değerlendirmelerinin toplam 16 noktasından 15'ini kazanmıştır. Tek istisna GBP/USD için 4 saatlik tahminde PatchTST'dir. Yalnız 24 saatlik ufuk dikkate alındığında ModernTCN forex ve endekslerde 8/8 noktada en düşük RMSE'yi vermektedir. Kaynağın tartışma metnindeki “24 saatte 16/16” ifadesi bu tabloyla sayısal olarak uyuşmadığından burada tablo verileri esas alınmıştır.
Varlık sınıfı düzeyindeki hata sonuçları
| Model | Kripto RMSE | Kripto MAE | Forex RMSE | Forex MAE | Endeks RMSE | Endeks MAE |
|---|---|---|---|---|---|---|
| Autoformer | 532,21 | 393,83 | 0,2068 | 0,1551 | 179,66 | 136,24 |
| DLinear | 323,48 | 220,87 | 0,1279 | 0,0940 | 123,80 | 90,67 |
| iTransformer | 320,83 | 217,99 | 0,1136 | 0,0785 | 113,72 | 79,13 |
| LSTM | 2398,94 | 2041,58 | 3,6679 | 3,5858 | 1548,56 | 1478,21 |
| ModernTCN | 314,66 | 211,14 | 0,1098 | 0,0750 | 110,89 | 76,09 |
| N-HiTS | 352,91 | 255,77 | 0,2356 | 0,1977 | 135,01 | 101,04 |
| PatchTST | 314,87 | 211,70 | 0,1108 | 0,0761 | 111,71 | 77,04 |
| TimesNet | 352,92 | 249,41 | 0,2127 | 0,1596 | 172,98 | 131,61 |
| TimeXer | 318,38 | 215,24 | 0,1174 | 0,0815 | 114,09 | 79,19 |
Üç varlık sınıfında da ModernTCN'nin sınıf ortalaması en düşük RMSE ve MAE değerini vermektedir. PatchTST her üç sınıfta da çok yakın ikinci gruptadır. Kripto para sonuçlarında ModernTCN ile PatchTST arasındaki ortalama RMSE farkı yaklaşık %0,07 gibi çok küçüktür; bu nedenle kripto alanında “tek tartışmasız kazanan” yorumu tablonun gösterdiğinden daha güçlü bir iddia olur.
24 Saatlik Tahmin Ufku Modellerin Sıralamasını Bozuyor mu?
Genel olarak hayır: mutlak tahmin hatası 24 saatlik ufukta belirgin biçimde büyürken modellerin göreli sırası büyük ölçüde korunmuştur. On iki varlığın tamamında 4 ve 24 saatlik model sıralamaları arasındaki Spearman korelasyonu pozitif ve anlamlıdır; birleşik Stouffer testi de ufuklar arası sıra kararlılığını güçlü biçimde desteklemektedir. Bununla birlikte orta gruptaki bazı modeller varlık bazında birkaç sıra yukarı veya aşağı kayabilmektedir.
BTC/USDT örneği
| Model | RMSE, 4 saat | RMSE, 24 saat | Artış |
|---|---|---|---|
| Autoformer | 1284,90 | 2670,00 | %107,8 |
| DLinear | 772,00 | 1644,10 | %113,0 |
| iTransformer | 743,50 | 1651,30 | %122,1 |
| LSTM | 8029,90 | 10878,70 | %35,5 |
| ModernTCN | 731,60 | 1617,40 | %121,1 |
| N-HiTS | 930,50 | 1724,50 | %85,3 |
| PatchTST | 731,10 | 1619,10 | %121,5 |
| TimesNet | 793,60 | 1840,40 | %131,9 |
| TimeXer | 750,30 | 1624,90 | %116,6 |
LSTM'nin göreli artış yüzdesinin daha düşük görünmesi daha iyi uzun-ufuk performansından kaynaklanmamaktadır; 4 saatlik başlangıç hatası zaten diğer modellerden çok daha yüksektir. Bu örnek, yüzde bozulmanın başlangıç seviyesi bilinmeden yorumlanmaması gerektiğini gösterir.
Ufuklar arası sıra kararlılığının istatistiksel kanıtı
On iki varlığın 4 ve 24 saatlik model sıralamaları arasında Spearman \(\rho\) değerleri 0,683 ile 1,000 arasında değişmiştir. EUR/USD için sıra tam olarak korunmuştur. On iki varlığın tek yönlü p-değerlerini birleştiren Stouffer testi:
\[ Z_S = 6{,}17,\qquad p=3{,}47\times10^{-10} \]
sonucunu vermiştir. Bu sonuç, üst sıraların uzun tahmin ufkunda tamamen dağılmadığını ve göreli mimari üstünlüğün önemli ölçüde korunduğunu desteklemektedir.
Seed etkisi ne kadar büyük?
| Varyans bileşeni | Ham RMSE | Z-normalize, tüm modeller | Z-normalize, LSTM hariç |
|---|---|---|---|
| Model / mimari | 99,90% | 48,32% | 68,33% |
| Seed | 0,01% | 0,04% | 0,02% |
| Artık / model × bağlam etkileşimi | 0,09% | 51,64% | 31,66% |
Ham ölçekte mimarinin %99,90'lık payı çarpıcıdır; ancak bu değer LSTM'nin diğer modellere kıyasla çok büyük hatalarından etkilenmektedir. Bu nedenle z-normalize sonuç daha dengeli yorumlanmalıdır. LSTM hariç modern modeller arasında bile mimari payı %68,33, seed payı yalnız %0,02'dir. Dolayısıyla çalışmanın asıl sağlam sonucu “her durumda tam %99,90 mimari etkisi vardır” değil, seed varyansının bütün analiz biçimlerinde çok küçük kalması ve mimari seçiminin seed seçiminden çok daha önemli olmasıdır.
24 saatlik üç temsilci varlıkta sınıf içi korelasyon katsayısı 0,99'un üzerindedir. Bu da modeller arasındaki farkların random başlangıçtan ziyade mimari kimlikle ilişkili olduğunu bağımsız bir istatistiksel yöntemle desteklemektedir.
Global anlamlılık testi
| Kapsam | Friedman \(\chi^2\) | Iman–Davenport F | p | Blok sayısı |
|---|---|---|---|---|
| Tüm varlıklar | 156,49 | 101,36 | < 10-15 | 24 |
| Kripto | 49,23 | 23,34 | < 10-15 | 8 |
| Forex | 56,00 | 49,00 | < 10-15 | 8 |
| Endeksler | 60,40 | 117,44 | < 10-15 | 8 |
Global Friedman–Iman–Davenport testi, dokuz modelin eşit beklenen sıraya sahip olduğu sıfır hipotezini güçlü biçimde reddetmektedir. Global düzeyde yapılan 36 Holm-düzeltilmiş Wilcoxon karşılaştırmasının 33'ü anlamlıdır. Anlamlı olmayan üç çift TimeXer–iTransformer, Autoformer–TimesNet ve DLinear–N-HiTS'tir. Bu yapı, global üç katmanlı sıralamanın yalnız görsel bir sıralama olmadığını desteklemektedir.
ModernTCN ile PatchTST arasındaki fark her piyasada aynı derecede açık değildir
BTC/USDT için 24 saatlik Diebold–Mariano testinde ModernTCN ile PatchTST arasındaki fark Holm düzeltmesinden sonra anlamlı değildir (\(p_{\mathrm{Holm}}=0{,}453\)). EUR/USD'de ise aynı iki modelin 24 saatlik karşılaştırmasında ModernTCN lehine fark çok güçlü biçimde ayrışmıştır (\(p_{\mathrm{Holm}}=2{,}77\times10^{-24}\)). Bu sonuç, tek global sıralamanın her varlıkta aynı istatistiksel ayrışma gücünü taşımadığını göstermektedir.
Parametre sayısı performansı açıklıyor mu?
Hayır; çalışmada monoton bir karmaşıklık-performans ilişkisi bulunmamıştır. Yaklaşık 1.000 parametreli DLinear globalde beşinci sıradayken yaklaşık 438.000 parametreli Autoformer sekizinci sıradadır. Yaklaşık 103.000 parametreli PatchTST ikinci, yaklaşık 230.000 parametreli ModernTCN birinci sıradadır.
Üç parametre büyüklüğü grubunu değerlendiren Jonckheere–Terpstra testlerinin hiçbirinde anlamlı monoton ilişki bulunmamıştır; altı varlık-sınıfı × ufuk kombinasyonunun tamamında \(p>0{,}35\) raporlanmıştır. Bu nedenle “daha büyük ağ = daha düşük tahmin hatası” biçimindeki basit bir genelleme çalışma tarafından desteklenmemektedir.
Yön doğruluğu: en kritik negatif bulgu
| Ölçüm | Sonuç |
|---|---|
| Model × sınıf × ufuk kombinasyonu | 54 |
| Ortalama directional accuracy | %50,08 |
| Anlamlı biçimde %50'den ayrılan kombinasyon | Yok |
MSE ile eğitilmiş modeller fiyat seviyesine yakın tahminler üretse de saatlik fiyat değişiminin yönünü güvenilir biçimde tahmin edememiştir. BTC/USDT, 24 saat örneğindeki tek örneklem z-testlerinde de Holm düzeltmesinden sonra hiçbir model %50 düzeyinden anlamlı biçimde ayrılmamıştır.
Bu bulgu özellikle önemlidir çünkü bir modelin gerçek fiyat eğrisini görsel olarak yakından izlemesi, değişim işaretini doğru tahmin ettiği anlamına gelmez. Finansal işlem stratejisinin amacı yön tahmini ise MSE'ye dayalı fiyat regresyonundan farklı bir eğitim amacı, yönsel surrogate loss veya ayrı olasılıksal karar katmanı gerekebilir. Çalışma böyle bir modeli test etmemiştir; bunu gelecek çalışma yönü olarak önermektedir.
Model bazında yorum
ModernTCN: 24 değerlendirme noktasının 18'inde birinci olarak en tutarlı modeldir. Büyük çekirdekli depthwise evrişimler, çok aşamalı aşağı örnekleme ve RevIN, finansal verinin farklı zaman ölçeklerindeki yapısını modellemek için etkili bir bileşim göstermiştir. Bununla birlikte bu mekanizmaların tek başına nedensel olarak üstünlüğü “kanıtladığı” söylenemez; sonuç mimarinin tamamına aittir.
PatchTST: Yama tabanlı tokenizasyon ile yerel zaman örüntüsünü ve Transformer dikkati ile daha geniş bağımlılıkları birleştirir. Globalde ikinci sıradadır ve ModernTCN'ye çok yakın sonuçlar vermektedir. BTC/USDT için 4 saatlik RMSE 731,05, ModernTCN için 731,63'tür; fark yalnız yaklaşık %0,08'dir.
iTransformer ve TimeXer: Genel orta grubun üst kısmındadır. iTransformer OHLCV değişkenlerinin zamansal yörüngelerini token olarak değerlendirirken TimeXer hedef ile diğer değişkenler arasındaki çapraz dikkati açık biçimde modeller.
DLinear: Çok küçük parametre bütçesine rağmen beşinci sıradadır. Bu sonuç, karmaşık dikkat veya tekrarlayan yapılara sahip olmanın finansal tahminde otomatik avantaj yaratmadığını göstermektedir.
N-HiTS: Genel sıralamada altıncı olmakla birlikte ETH/USDT'de her iki ufukta ve ADA/USDT'de 4 saatlik ufukta en düşük RMSE'yi elde etmiştir. Bu nedenle global ortalama sıra tek başına bütün varlık-spesifik avantajları gizleyebilir.
TimesNet ve Autoformer: Her iki model de periyodiklik veya frekans alanı yapısına belirgin vurgu yapar ve bu benchmarkta alt grupta kalmıştır. Yazar, saatlik finansal serilerde güçlü ve durağan periyodik yapıların sınırlı olmasının bu sonucu açıklayabileceğini tartışmaktadır; bu yorum doğrudan deneysel mekanizma ayrıştırması değildir.
LSTM: Çalışmanın klasik recurrent referansıdır. Hataları kategoriye bağlı olarak en iyi modelden yaklaşık 7–33 kat yüksek olmuş ve global sıralamada sonuncu kalmıştır. Bu sonuç yalnız burada kullanılan doğrudan çok-adımlı, OHLCV-only ve ortak eğitim protokolü için geçerlidir; tüm olası LSTM uygulamalarının genel olarak başarısız olduğunu kanıtlamaz.
Çalışmanın desteklediği sonuçlar
- Dokuz mimarinin performansı eşit değildir.
- ModernTCN ve PatchTST bu deney tasarımında açık üst grubu oluşturmuştur.
- 4 saatten 24 saate geçildiğinde mutlak hata artmasına rağmen göreli model sıralaması büyük ölçüde korunmuştur.
- Seed başlangıç değişkenliği mimari ve varlık-bağlam etkilerine göre çok küçüktür.
- Model parametre sayısı ile tahmin başarısı arasında monoton bir ilişki bulunmamıştır.
- MSE ile eğitilmiş modeller saatlik yön tahmininde %50 düzeyinden anlamlı biçimde ayrılamamıştır.
- Bazı varlıklarda global liderden farklı modeller en düşük RMSE'yi verebilir.
Çalışmanın desteklemediği sonuçlar
- ModernTCN'nin bütün finansal piyasalar, frekanslar ve veri tiplerinde kesin olarak en iyi model olduğu sonucu çıkarılamaz.
- Düşük RMSE'nin kârlı al-sat stratejisi ürettiği gösterilmemiştir.
- İşlem maliyeti, slippage, market impact, pozisyon büyüklüğü, Sharpe oranı veya maksimum drawdown test edilmemiştir.
- Günlük, dakikalık, tick-level veya H4 veride aynı sıralamanın korunacağı gösterilmemiştir.
- Emtia, tahvil, gelişmekte olan piyasa varlıkları veya geniş altcoin evreninde genelleme yapılmamıştır.
- Haber, sentiment, teknik gösterge ve order-book verisi eklenirse mimari sıralamasının aynı kalacağı gösterilmemiştir.
- Çalışma canlı forward-walk işlem ortamında gerçek zamanlı deploy edilmiş bir sistem testi değildir.
Sınırlılıklar
| Sınırlılık | Bilimsel etkisi |
|---|---|
| HPO başına yalnız 5 trial | Geniş arama uzayına sahip modellerin optimum konfigürasyonuna ulaşmasını sınırlayabilir; özellikle orta grup sırası değişebilir. |
| Kategori içi ikili testlerde yalnız 8 blok | Holm düzeltmesi altında istatistiksel güç düşüktür. |
| Yalnız OHLCV girdi | Sentiment, emir defteri veya teknik göstergelerden yararlanan modellerin potansiyelini yansıtmayabilir. |
| Yalnız saatlik veri | Sonuçlar tick, dakika, H4 veya günlük frekanslara otomatik genellenemez. |
| 12 finansal araç | Emtia, sabit getirili menkul kıymetler ve gelişmekte olan piyasalar kapsam dışıdır. |
| Yalnız 4 ve 24 saatlik ufuk | Ufuk bozulmasının tam eğrisi bilinmemektedir. |
| Cohen's d raporlanmamış | Standartlaştırılmış etki büyüklüğüyle çalışmalar arası karşılaştırma sınırlıdır. |
| Batch test seti | Rolling yeniden eğitimli canlı forward-walk deploy performansını göstermez. |
Yeniden üretilebilirlik
Çalışmanın kaynak kodu, yapılandırma dosyaları, verileri, HPO kayıtları, dondurulmuş hiperparametreler, 648 eğitilmiş model checkpoint'i, değerlendirme çıktıları ve istatistiksel test sonuçları proje deposunda paylaşılmıştır. Random seed yönetimi Python, NumPy, PyTorch CPU/CUDA ve PYTHONHASHSEED katmanlarında uygulanmıştır; cuDNN için deterministic=True ve benchmark=False kullanılmıştır.
Bununla birlikte torch.use_deterministic_algorithms(True) etkinleştirilmemiştir. Bu nedenle aynı yazılım konfigürasyonunda dahi farklı GPU mimarileri arasında küçük floating-point farklılıkları teorik olarak kalabilir. Üç bağımsız seed kullanılması bu belirsizliğin deney sonuçları içindeki büyüklüğünü ölçmeye yardımcı olmaktadır.
Gelecek çalışma önerileri
Kaynak, özellikle daha büyük hiperparametre arama bütçelerini, Cohen's d etki büyüklüklerini, yönsel kayıp fonksiyonlarını, daha geniş tahmin ufuklarını, daha fazla altcoin ve varlık sınıfını, zengin özellik setlerini, ModernTCN ile PatchTST gibi farklı indüktif önyargıları birleştiren heterojen ensemble'ları, alternatif zaman frekanslarını ve rolling forward-walk değerlendirmeyi öncelikli araştırma yönleri olarak belirtmektedir.
Kaynak ve Yöntem Notu
Özgün çalışma: A Controlled Comparison of Deep Learning Architectures for Multi-Horizon Financial Forecasting: Evidence from 918 Experiments
Yazar: Nabeel Ahmad Saidd
Kurum: Dr. A.P.J. Abdul Kalam Technical University (AKTU)
Kaynak türü: arXiv preprint / hesaplamalı finansal zaman serisi benchmark çalışması.
arXiv: 2603.16886v1
İlk sürüm tarihi: 27 Şubat 2026.
arXiv kategorisi: q-fin.ST.
DOI: Sağlanan PDF'de ve doğrulanan arXiv kaydında DOI belirtilmemiştir.
Dergi / cilt / sayı: Sağlanan sürüm için doğrulanmış hakemli dergi künyesi bulunmamaktadır; bu nedenle çalışma hakemli dergi makalesi gibi sunulmamalıdır.
Resmî kaynak: https://arxiv.org/abs/2603.16886
Proje deposu: https://github.com/NabeelAhmad9/compare_forecasting_models
Lisans: Proje deposunun güncel lisans açıklamasında makale ve eşlik eden şekiller için Creative Commons Attribution 4.0 International (CC BY 4.0), kaynak kod için MIT License belirtilmektedir. Sağlanan PDF'nin kendisinde tam lisans etiketi görünmediğinden bu bilgi repository beyanına dayanmaktadır.
Finansman: Sağlanan PDF'de ayrı bir finansman beyanı tespit edilmemiştir.
Çıkar çatışması: Yazar, araştırmayı, analizi veya sonuçları etkileyebilecek bilinen bir rekabet eden finansal çıkar veya kişisel ilişki bulunmadığını beyan etmektedir.
Veri ve kod erişilebilirliği: Çalışma, ham ve işlenmiş veriler, konfigürasyonlar, HPO kayıtları, checkpoint'ler ve benchmark çıktılarının proje deposunda bulunduğunu belirtmektedir.
Temel yöntem sınırı: Sonuçlar 12 varlık, saatlik OHLCV veri, 4 ve 24 saatlik tahmin ufku, sınırlı HPO bütçesi ve batch biçimindeki tarihsel test seti için geçerlidir. Gerçek zamanlı işlem kârlılığı veya canlı piyasa deploy performansı test edilmemiştir.
Kaynak içi sayısal tutarsızlık notu: Tablo 8'e göre ModernTCN forex ve endekslerin 16 toplam değerlendirme noktasının 15'ini, 24 saatlik alt kümenin ise 8/8'ini kazanmıştır. Tartışmadaki “24 saatte 16/16” ifadesi tabloyla uyuşmamaktadır. Ayrıca Tablo 9 ModernTCN'yi forex RMSE'de 0,1098 ile birinci gösterirken metindeki bir yerde PatchTST'nin 0,1108 değeri “kategori lideri” olarak nitelenmiştir. Verianla anlatımında nicel tablolar esas alınmıştır.
Telif ve anlatım yöntemi: Bu içerik özgün çalışmanın cümle veya paragraf yapısını yeniden üretmez. Kaynaktaki yöntem, sayısal sonuç, denklem ve yorum sınırları bilimsel olgular düzeyinde çıkarılarak Verianla için bağımsız öğretici yapı içinde yeniden düzenlenmiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir