


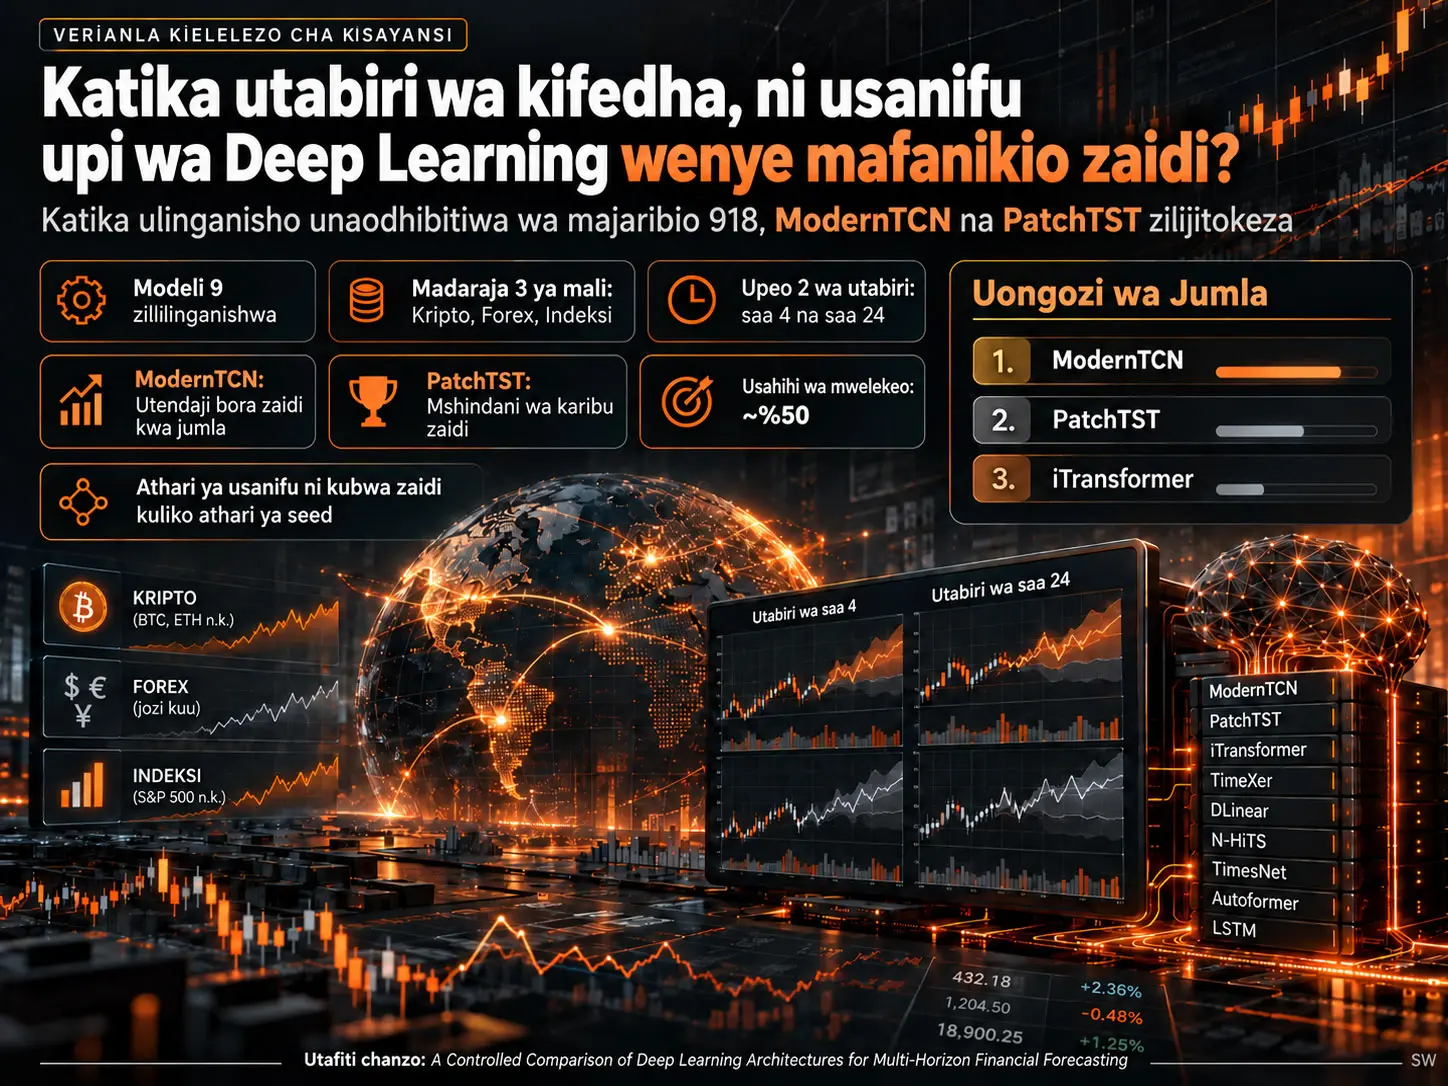
Utafiti huu ni benchmark inayodhibitiwa inayolinganisha usanifu tisa wa deep learning unaotumika kwa utabiri wa bei wa upeo mbalimbali katika mfululizo wa muda wa kifedha chini ya itifaki ileile ya majaribio. Autoformer, DLinear, iTransformer, LSTM, ModernTCN, N-HiTS, PatchTST, TimesNet na TimeXer zilitathminiwa katika kazi za utabiri wa saa 4 na saa 24 mbele kwenye vyombo 12 vya kifedha kutoka katika madaraja matatu ya mali yanayojumuisha sarafu za kidijitali, fedha za kigeni na fahirisi za hisa. ModernTCN ni usanifu wa konvolusheni wa mfululizo wa muda unaotumia konvolusheni za muda za depthwise zenye kernel kubwa pamoja na downsampling ya hatua nyingi na uliingia nafasi ya kwanza katika upangaji wa jumla wa utafiti kwa wastani wa nafasi 1,333. PatchTST ilikuwa ya pili kwa wastani wa nafasi 2,000. Hata hivyo, matokeo haya hayamaanishi kwamba ModernTCN ni bora kabisa katika kila mali au kila hali; hasa katika baadhi ya jozi za sarafu za kidijitali, N-HiTS na PatchTST zilitoa thamani ya chini zaidi ya RMSE.
Kipengele kinachotofautisha muundo wa majaribio ni kwamba modeli hazikujaribiwa kwa seti tofauti za data au bajeti tofauti za tuning, bali katika mchakato uleule uliodhibitiwa. Kati ya jumla ya uendeshaji 918, 270 zilikuwa za uboreshaji wa hyperparameter, huku 648 zikiwa mafunzo ya mwisho yanayotokana na mchanganyiko wa modeli tisa × mali 12 × upeo miwili ya utabiri × seed tatu huru. Modeli zote zilipewa ingizo la OHLCV pekee lenye thamani za Open, High, Low, Close na Volume; hakuna kiashiria cha kiufundi, data ya sentiment, order book au data ya nje ya uchumi mkuu iliyoongezwa.
Matokeo ya jumla yalionyesha upangaji wazi wa tabaka tatu. ModernTCN na PatchTST ziliunda kundi la juu; iTransformer, TimeXer, DLinear na N-HiTS kundi la kati; na TimesNet, Autoformer na LSTM kundi la chini. ModernTCN ilipata RMSE ya chini zaidi katika 18 kati ya pointi 24 za tathmini za mali-upeo, yaani %75. Hata hivyo, tofauti ndogo kati ya ModernTCN na PatchTST haikuweza kutenganishwa kitakwimu katika kila mali; kwa mfano, kwa BTC/USDT katika upeo wa saa 24, ulinganisho wa Diebold-Mariano kati ya modeli hizo mbili haukuwa na umuhimu wa kitakwimu.
Matokeo ya pili muhimu ya utafiti ni kuwepo kwa tofauti kubwa kati ya kutabiri kiwango cha bei kwa kosa dogo na kutabiri mwelekeo wa bei. Katika michanganyiko 54 ya modeli-daraja-upeo inayoundwa na modeli tisa, madaraja matatu ya mali na upeo miwili ya utabiri, usahihi wa wastani wa mwelekeo ulikuwa %50,08. Thamani hii haikuweza kutofautishwa na kiwango cha kurusha sarafu. Kwa hiyo, RMSE au MAE ya chini haimaanishi kiotomatiki kwamba mwelekeo wa kununua au kuuza umetabiriwa kwa kuaminika.
Utafiti pia unaonyesha kwamba usahihi hauongezeki kwa utaratibu kadiri idadi ya vigezo vya modeli inavyoongezeka. DLinear yenye takriban vigezo 1.000 iliwekwa juu kuliko baadhi ya usanifu unaotumia mamia ya maelfu ya vigezo. Matokeo yanaunga mkono kwamba katika utabiri wa mfululizo wa muda wa kifedha, jambo muhimu linaweza kuwa si uwezo ghafi pekee bali jinsi modeli inavyowakilisha muundo wa muda kupitia upendeleo wa kiinduktivu.
Tatizo la utafiti: Je, “modeli kubwa zaidi” kweli ndiyo mtabiri bora?
Wakati idadi ya usanifu wa deep learning katika mfululizo wa muda wa kifedha inaongezeka kwa kasi, si rahisi kulinganisha modeli kwa haki. Kufanya majaribio zaidi ya hyperparameter kwa usanifu mmoja, kutoa matokeo kwa random seed moja pekee, kuchagua daraja moja tu la mali au kutumia upeo mmoja tu wa utabiri kunaweza kuchanganya nguvu halisi ya usanifu na athari ya itifaki ya majaribio. Kwa hiyo utafiti huu unalenga kutenga athari ya usanifu kadiri iwezekanavyo kwa kuanzisha mpangilio mmoja wa majaribio usiotegemea familia ya modeli.
Mwandishi anashughulikia hasa mapengo matano ya kimetodolojia: bajeti zisizo sawa za uboreshaji wa hyperparameter, tathmini ya seed moja, ulinganisho unaotegemea upeo mmoja wa utabiri, ukosefu wa marekebisho ya kitakwimu katika ulinganisho mwingi wa jozi, na benchmark finyu zinazotumia daraja moja tu la mali. Swali kuu la utafiti ni ni usanifu gani wa mfululizo wa muda unaojitokeza kwa uthabiti katika mazingira ambapo matatizo haya yanadhibitiwa kwa wakati mmoja.
Hipothesia nne
| Hipothesia | Swali | Tathmini kuu |
|---|---|---|
| H1 | Je, upangaji wa utendaji wa modeli tisa unaonyesha kweli muundo usio sawa? | Upangaji wa jumla, idadi ya ushindi, Friedman–Iman–Davenport na ulinganisho wa jozi uliorekebishwa. |
| H2 | Je, modeli zinazofanya vizuri katika upeo wa saa 4 zinahifadhi ubora wao wa kulinganisha katika upeo wa saa 24? | Uhusiano wa nafasi wa Spearman kwa kila mali na ongezeko la kosa kati ya upeo. |
| H3 | Katika tofauti za utendaji, uchaguzi wa usanifu ni muhimu zaidi au random seed? | Utenganishaji wa variance wa vipengele viwili na intraclass correlation coefficient. |
| H4 | Je, vigezo vingi zaidi vinamaanisha utabiri bora zaidi? | Uhusiano kati ya ukubwa wa modeli na nafasi ya RMSE pamoja na jaribio la Jonckheere–Terpstra. |
Kwa Nini Upendeleo wa Kiinduktivu wa Usanifu ni Muhimu katika Utabiri wa Kifedha?
Upendeleo wa kiinduktivu wa usanifu ni uchaguzi wa muundo unaoamua ni miundo ipi katika mfululizo wa muda ambayo modeli inawezeshwa kujifunza kwa urahisi zaidi kiasili; katika utafiti huu ulionekana kuwa na umuhimu mkubwa zaidi wa kueleza matokeo kuliko idadi ya vigezo. ModernTCN huwakilisha ruwaza za ndani na za viwango vingi kwa konvolusheni zenye kernel kubwa, PatchTST kwa kugawa mfululizo wa muda katika patches, N-HiTS kwa pooling ya kihierarkia ya mizani mingi ya muda, huku Autoformer na TimesNet zikiwakilisha miundo ya mzunguko au inayotegemea frequency. Katika data ya kifedha, dhana hizi tofauti zilisababisha tofauti dhahiri za utendaji hata chini ya bajeti ileile ya vigezo.
Usanifu tisa uliolinganishwa
| Modeli | Familia | Utaratibu mkuu | Tafsiri kuu katika utafiti |
|---|---|---|---|
| ModernTCN | TCN / CNN | Konvolusheni za depthwise zenye kernel kubwa, downsampling ya hatua nyingi, chaguo la RevIN | Ya kwanza katika upangaji wa jumla na modeli thabiti zaidi ya kundi la juu. |
| PatchTST | Transformer | Kugawa mfululizo wa muda katika patches, Transformer isiyotegemea channel, RevIN | Ya pili katika upangaji wa jumla; utendaji wa kundi la juu ulio karibu sana na ModernTCN. |
| iTransformer | Transformer | Attention iliyogeuzwa juu ya vigezo badala ya hatua za muda | Ya tatu katika upangaji wa jumla. |
| TimeXer | Transformer | Cross-attention inayotenganisha lengo na vigezo vya nje | Ya nne katika upangaji wa jumla. |
| DLinear | Familia ya Linear / MLP | Ramani za linear baada ya kutenganisha trend na seasonality | Ufanisi unaovutia kwa takriban vigezo 1.000. |
| N-HiTS | MLP | Pooling ya viwango vingi na interpolesheni ya kihierarkia | Ubora maalumu katika baadhi ya altcoin. |
| TimesNet | CNN | Ugunduzi wa period kwa FFT, kubadilisha mfululizo wa 1B kuwa muundo wa 2B | Katika kundi la chini kwa data ya kifedha ya kila saa. |
| Autoformer | Transformer | Autocorrelation katika frequency domain na utenganishaji wa mfululizo | Katika kundi la chini kwa data ya kifedha ya kila saa. |
| LSTM | RNN | Seli za kurudia zenye gates na dense projection head | Ya mwisho katika itifaki hii; kosa kubwa zaidi kuliko modeli za kisasa. |
Kwa nini mfululizo wa muda wa kifedha ni mgumu?
Mfululizo wa kifedha hauendi kwa sheria thabiti kama mifumo ya kimwili. Usambazaji unaweza kubadilika kwa muda, returns zinaweza kuwa na heavy tails, volatility inaweza kujikusanya, na regimes za soko zinaweza kubadilika ghafla. Uchambuzi wa hourly log-return wa mali 12 katika utafiti pia unaonyesha returns za wastani zilizo karibu na sifuri, heavy tails zilizo wazi na tofauti kubwa za volatility kati ya madaraja ya mali. Katika sarafu za kidijitali, volatility ya kila saa iko takriban katika kiwango cha %1, katika forex takriban %0,1, na katika fahirisi takriban %0,2.
Muundo huu unaeleza kwa nini uwakilishi unaoweza kushughulikia mabadiliko katika mizani tofauti za muda na distribution shift unaweza kuwa muhimu kuliko modeli inayokariri tu mkunjo mmoja wa bei. Hata hivyo, maelezo haya si uthibitisho wa causal mechanism; ni tafsiri ya muundo wa modeli inayosaidia kuelewa matokeo ya ulinganisho wa usanifu.
Ulimwengu wa mali
| Daraja | Vyombo vya kifedha | Frequency | Uchunguzi uliotumika kwa kila mali |
|---|---|---|---|
| Sarafu za kidijitali | BTC/USDT, ETH/USDT, BNB/USDT, ADA/USDT | H1, kila saa | Hatua 30.000 za muda za karibuni zaidi |
| Forex | EUR/USD, USD/JPY, GBP/USD, AUD/USD | H1, kila saa | Hatua 30.000 za muda za karibuni zaidi |
| Fahirisi za hisa | Dow Jones, S&P 500, NASDAQ 100, DAX | H1, kila saa | Hatua 30.000 za muda za karibuni zaidi |
Kwa nini ingizo ni OHLCV pekee?
Modeli zote zilipewa channel tano zilezile: Open, High, Low, Close na Volume. Kigezo lengwa ni bei ya baadaye ya Close. Kutoweka kiashiria cha kiufundi, return iliyocheleweshwa, kigezo cha kalenda, habari, uchambuzi wa sentiment au order book ni udhibiti wa makusudi. Kwa njia hii, lengo lilikuwa kufanya tofauti ya utendaji itokane kadiri iwezekanavyo na usanifu wa modeli badala ya feature engineering.
Chaguo hili pia linaweka mpaka muhimu wa tafsiri. Nafasi ambayo usanifu ulioundwa mahsusi kutumia habari, order-book, viashiria vya kiufundi au vigezo vya nje vilivyo tajiri zaidi unapata hapa si nafasi yake ya mwisho katika kazi zote zinazowezekana za utabiri wa kifedha.
Utabiri wa moja kwa moja wa hatua nyingi
Kila modeli huzalisha upeo mzima wa utabiri katika forward pass moja. Ingizo la modeli ni \(X_t \in \mathbb{R}^{w \times 5}\), na toleo ni vekta \(\hat{y}_{t+1:t+h}\) ya bei za kufunga za baadaye:
\[ \hat{y}_{t+1:t+h}=f_{\theta}(X_t), \qquad h \in \{4,24\}. \]
Hapa \(w\) ni dirisha la kuangalia nyuma, \(h\) ni upeo wa utabiri, na \(f_{\theta}\) ni modeli inayofafanuliwa na vigezo vinavyojifunzwa \(\theta\). Kwa kazi ya saa nne \(w=24\), na kwa kazi ya saa 24 \(w=96\) ilitumika. Kwa kuwa modeli hazitumii tena utabiri uliopita kama ingizo, mkusanyiko wa kosa unaotokea katika utabiri wa kawaida wa recursive multi-step haujajumuishwa katika muundo huu wa majaribio.
Normalization na kuzuia data leakage
Kwa kila mali zilitumika rekodi 30.000 za saa za karibuni zaidi. Wastani na standard deviation ya Z-score normalization zilihesabiwa katika sehemu ya mafunzo pekee na transformation ileile ikatumika kwa data ya validation na test. Kwa njia hii, taarifa kuhusu usambazaji wa baadaye ilizuiwa kuvuja kupitia scaler kwenda kwenye mchakato wa mafunzo. Utabiri ulirejeshwa kwenye kiwango cha awali cha bei kabla ya tathmini.
| Sehemu | Uwiano | Idadi ya takriban ya sampuli | Kanuni |
|---|---|---|---|
| Mafunzo | %70 | 21.000 | Sehemu ya kwanza ya kronolojia |
| Validation | %15 | 4.500 | Sehemu inayofuata ya kronolojia |
| Test | %15 | 4.500 | Sehemu ya mwisho kabisa ya kronolojia |
Mpangilio wa muda haukuchanganywa katika hatua yoyote.
Mbinu na Matokeo ya Utafiti
Itifaki ya majaribio inayodhibitiwa ya hatua tano
| Hatua | Mchakato | Lengo la kisayansi |
|---|---|---|
| 1 | Uboreshaji wa Bayesian wa hyperparameter kwa seed iliyowekwa | Kutenga bajeti sawa ya HPO kwa modeli. |
| 2 | Kufungia configuration bora kwa kila daraja la mali | Kuzuia asset-level overfitting kwa kufanya tuning tofauti kwa kila mali. |
| 3 | Mafunzo ya mwisho kwa seed tatu huru | Kupima athari ya mwanzo wa random. |
| 4 | Kuunganisha matokeo ya RMSE, MAE na DA juu ya seed | Kuripoti pamoja utendaji wa wastani na kutokuwa na uhakika wa mwanzo. |
| 5 | Benchmark na uthibitishaji wa kitakwimu | Kuhakikisha upangaji hautegemei tofauti za kuona pekee bali ushahidi wa kitakwimu. |
Uboreshaji wa hyperparameter
Optuna Tree-structured Parzen Estimator ilitumika. Kwa kila mchanganyiko wa modeli × daraja la mali × upeo wa utabiri, trial tano za HPO zilitengwa na HPO seed ikawekwa kuwa 42. Mali wakilishi ni BTC/USDT kwa crypto, EUR/USD kwa forex na Dow Jones kwa fahirisi. Wakati wa HPO, kila trial iliendeshwa kwa upeo wa 50 epoch.
Trial tano ni bajeti ndogo kwa nafasi pana ya hyperparameter. Mwandishi alichagua hili ili kutumia bajeti ya ulinganifu kwa usanifu wote na kupunguza hatari ya kuzoea kupita kiasi regimes za muda za soko katika data ya kifedha. Hata hivyo, uamuzi huu ni mojawapo ya mapungufu muhimu ya utafiti; bajeti kubwa zaidi ya HPO inaweza kubadilisha nafasi za modeli hasa katika kundi la kati.
Itifaki ya mafunzo ya mwisho
- Seed: 123, 456 na 789.
- Upeo wa epoch: 100.
- Optimization: Adam.
- Weight decay: \(10^{-4}\).
- Scheduler ya learning rate: ReduceLROnPlateau.
- Scheduler patience: 5; kipengele cha kupunguza: 0,5; learning rate ya chini kabisa: \(10^{-6}\).
- Early stopping patience: 15.
- Kizingiti cha chini cha uboreshaji: \(10^{-4}\).
- Gradient clipping: norma ya \(\ell_2\) imewekewa kikomo cha 1,0.
- Loss function: Mean Squared Error.
Training loss:
\[ \mathcal{L}(\theta)=\frac{1}{n}\sum_{i=1}^{n}\left\|y_i-\hat{y}_i\right\|^2. \]
Loss hii huadhibu makosa makubwa ya utabiri kwa njia ya mraba. Kutumia objective function ileile kwa modeli zote kunazuia usanifu mmoja kupata faida bandia kwa sababu ya lengo tofauti la mafunzo.
Je, RMSE, MAE na Usahihi wa Mwelekeo Hupima Kitu Kilekile?
Hapana. RMSE na MAE hupima ukubwa wa kosa kati ya bei iliyotabiriwa na bei iliyotokea, wakati usahihi wa mwelekeo hupima kama ishara ya mabadiliko ya bei ilitabiriwa kwa usahihi. Katika utafiti huu, modeli zilitofautiana wazi katika RMSE na MAE, lakini usahihi wa mwelekeo ulisalia karibu na kiwango cha %50; kwa hiyo haiwezi kuhitimishwa kwamba mtabiri mzuri wa kiwango cha bei ni moja kwa moja mtabiri mzuri wa mwelekeo wa biashara.
RMSE
\[ \mathrm{RMSE}= \sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2}. \]
RMSE huweka uzito mkubwa zaidi kwenye makosa makubwa na ndiyo kipimo cha msingi cha upangaji katika utafiti.
MAE
\[ \mathrm{MAE}= \frac{1}{n}\sum_{i=1}^{n}|y_i-\hat{y}_i|. \]
MAE hupima ukubwa wa kosa la absolute na haitoi adhabu kali ya mraba kwa makosa makubwa kama RMSE. Ulinganifu wa juu sana kati ya upangaji wa RMSE na MAE katika utafiti unaunga mkono kwamba upangaji wa modeli haukuwa maalumu kwa metric moja tu ya kosa.
Directional Accuracy
\[ \mathrm{DA}= \frac{1}{n} \sum_{i=1}^{n} \mathbf{1} \left[ \operatorname{sign}(\hat{y}_i-\hat{y}_{i-1}) = \operatorname{sign}(y_i-y_{i-1}) \right]. \]
Metric hii hupima sehemu ya hatua ambazo mwelekeo wa harakati ya bei iliyotabiriwa unalingana na mwelekeo halisi.
Kiwango cha jumla cha majaribio
| Kipengele cha majaribio | Hesabu | Idadi ya uendeshaji |
|---|---|---|
| HPO | 9 model × 3 mali wakilishi × 2 upeo × 5 trial | 270 |
| Mafunzo ya mwisho | 9 model × 12 mali × 2 upeo × 3 seed | 648 |
| Jumla | 270 + 648 | 918 |
Upangaji wa utendaji wa jumla
| Nafasi | Modeli | Familia | Wastani wa nafasi | Median ya nafasi | Ushindi |
|---|---|---|---|---|---|
| 1 | ModernTCN | CNN / TCN | 1,333 | 1,000 | 18 / 24 (%75) |
| 2 | PatchTST | Transformer | 2,000 | 2,000 | 3 / 24 (%12,5) |
| 3 | iTransformer | Transformer | 3,667 | 3,000 | 0 |
| 4 | TimeXer | Transformer | 4,292 | 4,000 | 0 |
| 5 | DLinear | MLP / Linear | 4,958 | 5,000 | 0 |
| 6 | N-HiTS | MLP / Linear | 5,250 | 6,000 | 3 / 24 (%12,5) |
| 7 | TimesNet | CNN | 7,708 | 8,000 | 0 |
| 8 | Autoformer | Transformer | 7,833 | 8,000 | 0 |
| 9 | LSTM | RNN | 7,958 | 9,000 | 0 |
Jedwali hili linaonyesha mambo mawili muhimu. Kwanza, familia ya modeli peke yake haielezi mafanikio: familia ya Transformer inajumuisha PatchTST iliyo nafasi ya pili na Autoformer iliyo nafasi ya nane; vivyo hivyo katika familia ya CNN, ModernTCN ni ya kwanza huku TimesNet ikiwa ya saba. Pili, utaratibu maalumu wa uwakilishi wa muda unaonekana kuwa na uwezo mkubwa zaidi wa kutofautisha kuliko lebo pana ya “Transformer/CNN/RNN”.
Modeli iliyotoa RMSE ya chini zaidi kwa kila mali
| Daraja | Mali | Saa 4 | Saa 24 |
|---|---|---|---|
| Crypto | BTC/USDT | PatchTST | ModernTCN |
| Crypto | ETH/USDT | N-HiTS | N-HiTS |
| Crypto | BNB/USDT | ModernTCN | ModernTCN |
| Crypto | ADA/USDT | N-HiTS | PatchTST |
| Forex | EUR/USD | ModernTCN | ModernTCN |
| Forex | USD/JPY | ModernTCN | ModernTCN |
| Forex | GBP/USD | PatchTST | ModernTCN |
| Forex | AUD/USD | ModernTCN | ModernTCN |
| Fahirisi | DAX | ModernTCN | ModernTCN |
| Fahirisi | Dow Jones | ModernTCN | ModernTCN |
| Fahirisi | S&P 500 | ModernTCN | ModernTCN |
| Fahirisi | NASDAQ 100 | ModernTCN | ModernTCN |
Ikihesabiwa moja kwa moja kutoka kwenye jedwali, ModernTCN ilishinda pointi 15 kati ya 16 za tathmini za forex na fahirisi nje ya crypto. Isipokuwa pekee ni PatchTST kwa GBP/USD katika utabiri wa saa 4. Upeo wa saa 24 pekee ukizingatiwa, ModernTCN ilitoa RMSE ya chini zaidi katika pointi 8/8 za forex na fahirisi. Kwa kuwa kauli “16/16 katika saa 24” katika mjadala wa chanzo hailingani kimahesabu na jedwali hili, data ya jedwali ndiyo imetumika hapa.
Matokeo ya kosa katika kiwango cha daraja la mali
| Modeli | Crypto RMSE | Crypto MAE | Forex RMSE | Forex MAE | Fahirisi RMSE | Fahirisi MAE |
|---|---|---|---|---|---|---|
| Autoformer | 532,21 | 393,83 | 0,2068 | 0,1551 | 179,66 | 136,24 |
| DLinear | 323,48 | 220,87 | 0,1279 | 0,0940 | 123,80 | 90,67 |
| iTransformer | 320,83 | 217,99 | 0,1136 | 0,0785 | 113,72 | 79,13 |
| LSTM | 2398,94 | 2041,58 | 3,6679 | 3,5858 | 1548,56 | 1478,21 |
| ModernTCN | 314,66 | 211,14 | 0,1098 | 0,0750 | 110,89 | 76,09 |
| N-HiTS | 352,91 | 255,77 | 0,2356 | 0,1977 | 135,01 | 101,04 |
| PatchTST | 314,87 | 211,70 | 0,1108 | 0,0761 | 111,71 | 77,04 |
| TimesNet | 352,92 | 249,41 | 0,2127 | 0,1596 | 172,98 | 131,61 |
| TimeXer | 318,38 | 215,24 | 0,1174 | 0,0815 | 114,09 | 79,19 |
Katika madaraja yote matatu ya mali, wastani wa daraja wa ModernTCN hutoa RMSE na MAE za chini zaidi. PatchTST iko katika kundi la pili lililo karibu sana katika madaraja yote matatu. Katika matokeo ya crypto, tofauti ya wastani ya RMSE kati ya ModernTCN na PatchTST ni ndogo sana, takriban %0,07; kwa hiyo, tafsiri ya “mshindi mmoja asiye na ubishi” katika crypto ingekuwa dai lenye nguvu kuliko jedwali linavyoonyesha.
Je, Upeo wa Utabiri wa Saa 24 Unaharibu Upangaji wa Modeli?
Kwa ujumla, hapana: ingawa kosa la absolute la utabiri huongezeka kwa kiasi kikubwa katika upeo wa saa 24, nafasi za kulinganisha za modeli kwa kiasi kikubwa hubaki thabiti. Katika mali zote kumi na mbili, uhusiano wa Spearman kati ya upangaji wa modeli wa saa 4 na saa 24 ni chanya na wenye umuhimu; jaribio la Stouffer lililounganishwa pia linaunga mkono kwa nguvu uthabiti wa upangaji kati ya upeo. Hata hivyo, baadhi ya modeli katika kundi la kati zinaweza kupanda au kushuka nafasi chache kulingana na mali.
Mfano wa BTC/USDT
| Modeli | RMSE, saa 4 | RMSE, saa 24 | Ongezeko |
|---|---|---|---|
| Autoformer | 1284,90 | 2670,00 | %107,8 |
| DLinear | 772,00 | 1644,10 | %113,0 |
| iTransformer | 743,50 | 1651,30 | %122,1 |
| LSTM | 8029,90 | 10878,70 | %35,5 |
| ModernTCN | 731,60 | 1617,40 | %121,1 |
| N-HiTS | 930,50 | 1724,50 | %85,3 |
| PatchTST | 731,10 | 1619,10 | %121,5 |
| TimesNet | 793,60 | 1840,40 | %131,9 |
| TimeXer | 750,30 | 1624,90 | %116,6 |
Kuonekana kwa asilimia ndogo ya ongezeko la LSTM hakutokani na utendaji bora wa upeo mrefu; kosa lake la mwanzo la saa 4 tayari ni kubwa sana kuliko la modeli nyingine. Mfano huu unaonyesha kwamba kuzorota kwa asilimia hakupaswi kutafsiriwa bila kujua kiwango cha kuanzia.
Ushahidi wa kitakwimu wa uthabiti wa upangaji kati ya upeo
Kati ya upangaji wa modeli wa saa 4 na saa 24 kwa mali kumi na mbili, thamani za Spearman \(\rho\) zilitofautiana kutoka 0,683 hadi 1,000. Kwa EUR/USD, upangaji ulihifadhiwa kikamilifu. Jaribio la Stouffer linalounganisha p-values za upande mmoja za mali kumi na mbili:
\[ Z_S = 6{,}17,\qquad p=3{,}47\times10^{-10} \]
lilitoa matokeo hayo. Matokeo haya yanaunga mkono kwamba nafasi za juu hazikutawanyika kabisa katika upeo mrefu wa utabiri na ubora wa kulinganisha wa usanifu ulihifadhiwa kwa kiasi kikubwa.
Athari ya seed ni kubwa kiasi gani?
| Kipengele cha variance | RMSE ghafi | Z-normalize, modeli zote | Z-normalize, bila LSTM |
|---|---|---|---|
| Modeli / usanifu | 99,90% | 48,32% | 68,33% |
| Seed | 0,01% | 0,04% | 0,02% |
| Residual / mwingiliano wa modeli × muktadha | 0,09% | 51,64% | 31,66% |
Katika kiwango ghafi, sehemu ya %99,90 ya usanifu ni ya kuvutia; hata hivyo, thamani hii inaathiriwa na makosa makubwa sana ya LSTM ikilinganishwa na modeli nyingine. Kwa hiyo, matokeo ya z-normalize yanapaswa kutafsiriwa kwa uwiano zaidi. Hata kati ya modeli za kisasa bila LSTM, sehemu ya usanifu ni %68,33, huku sehemu ya seed ikiwa %0,02 tu. Kwa hiyo, hitimisho kuu thabiti la utafiti si kwamba “kuna athari kamili ya usanifu ya %99,90 katika kila hali”, bali kwamba variance ya seed inabaki ndogo sana katika aina zote za uchambuzi na uchaguzi wa usanifu ni muhimu zaidi kuliko uchaguzi wa seed.
Katika mali tatu wakilishi za saa 24, intraclass correlation coefficient iko juu ya 0,99. Hii inaunga mkono kwa mbinu huru ya kitakwimu kwamba tofauti kati ya modeli zinahusiana zaidi na utambulisho wa usanifu kuliko mwanzo wa random.
Jaribio la umuhimu wa jumla
| Wigo | Friedman \(\chi^2\) | Iman–Davenport F | p | Idadi ya block |
|---|---|---|---|---|
| Mali zote | 156,49 | 101,36 | < 10-15 | 24 |
| Crypto | 49,23 | 23,34 | < 10-15 | 8 |
| Forex | 56,00 | 49,00 | < 10-15 | 8 |
| Fahirisi | 60,40 | 117,44 | < 10-15 | 8 |
Jaribio la jumla la Friedman–Iman–Davenport linakataa kwa nguvu nadharia batili kwamba modeli tisa zina nafasi inayotarajiwa sawa. Kati ya ulinganisho 36 wa Wilcoxon uliorekebishwa kwa Holm katika kiwango cha jumla, 33 una umuhimu. Jozi tatu zisizo na umuhimu ni TimeXer–iTransformer, Autoformer–TimesNet na DLinear–N-HiTS. Muundo huu unaunga mkono kwamba upangaji wa jumla wa tabaka tatu si upangaji wa kuona tu.
Tofauti kati ya ModernTCN na PatchTST si wazi kwa kiwango kilekile katika kila soko
Katika jaribio la Diebold–Mariano la saa 24 kwa BTC/USDT, tofauti kati ya ModernTCN na PatchTST haina umuhimu baada ya marekebisho ya Holm (\(p_{\mathrm{Holm}}=0{,}453\)). Kwa EUR/USD, katika ulinganisho wa saa 24 wa modeli hizohizo mbili, tofauti kwa manufaa ya ModernTCN ilitenganishwa kwa nguvu sana (\(p_{\mathrm{Holm}}=2{,}77\times10^{-24}\)). Matokeo haya yanaonyesha kwamba upangaji mmoja wa jumla hauna nguvu ileile ya kutenganisha kitakwimu katika kila mali.
Je, idadi ya vigezo inaeleza utendaji?
Hapana; utafiti haukupata uhusiano wa monotoniki kati ya ugumu na utendaji. DLinear yenye takriban vigezo 1.000 ilikuwa ya tano kwa jumla, huku Autoformer yenye takriban vigezo 438.000 ikiwa ya nane. PatchTST yenye takriban vigezo 103.000 ilikuwa ya pili, na ModernTCN yenye takriban vigezo 230.000 ilikuwa ya kwanza.
Hakuna jaribio la Jonckheere–Terpstra kati ya yale yaliyotathmini makundi matatu ya ukubwa wa vigezo lililopata uhusiano wa monotoniki wenye umuhimu; katika michanganyiko yote sita ya mali-daraja × upeo iliripotiwa \(p>0{,}35\). Kwa hiyo, ujanibishaji rahisi wa “mtandao mkubwa zaidi = kosa dogo zaidi la utabiri” hauungwi mkono na utafiti.
Usahihi wa mwelekeo: matokeo hasi muhimu zaidi
| Kipimo | Matokeo |
|---|---|
| Mchanganyiko wa modeli × daraja × upeo | 54 |
| Wastani wa directional accuracy | %50,08 |
| Mchanganyiko uliotofautiana kwa umuhimu na %50 | Hakuna |
Ingawa modeli zilizofunzwa kwa MSE zilitoa utabiri ulio karibu na kiwango cha bei, hazikuweza kutabiri kwa kuaminika mwelekeo wa mabadiliko ya bei ya kila saa. Katika one-sample z-tests za mfano wa BTC/USDT, saa 24, baada ya marekebisho ya Holm hakuna modeli iliyotofautiana kwa umuhimu na kiwango cha %50.
Matokeo haya ni muhimu hasa kwa sababu modeli kufuata kwa karibu mkunjo halisi wa bei kwa kuona haimaanishi kwamba imetabiri kwa usahihi ishara ya mabadiliko. Ikiwa lengo la mkakati wa biashara ya kifedha ni utabiri wa mwelekeo, huenda ikahitajika objective tofauti ya mafunzo kuliko price regression inayotegemea MSE, directional surrogate loss au safu tofauti ya uamuzi wa probabilistic. Utafiti haukujaribu modeli ya aina hiyo; unapendekeza hili kama mwelekeo wa utafiti wa baadaye.
Tafsiri kwa kila modeli
ModernTCN: Ni modeli thabiti zaidi kwa kuwa ya kwanza katika 18 kati ya pointi 24 za tathmini. Konvolusheni za depthwise zenye kernel kubwa, downsampling ya hatua nyingi na RevIN zilionyesha mchanganyiko wenye ufanisi kwa kuiga muundo wa data ya kifedha katika mizani mbalimbali za muda. Hata hivyo, haiwezi kusemwa kwamba taratibu hizi peke yake “zinathibitisha” ubora wa kisababishi; matokeo yanahusu usanifu mzima.
PatchTST: Inaunganisha tokenization inayotegemea patch kwa ruwaza za muda za ndani na Transformer attention kwa utegemezi mpana zaidi. Ni ya pili kwa jumla na hutoa matokeo yaliyo karibu sana na ModernTCN. Kwa BTC/USDT, RMSE ya saa 4 ni 731,05, na kwa ModernTCN ni 731,63; tofauti ni takriban %0,08 tu.
iTransformer na TimeXer: Ziko katika sehemu ya juu ya kundi la kati kwa jumla. iTransformer huchukulia trajectories za muda za vigezo vya OHLCV kama token, huku TimeXer ikiiga wazi cross-attention kati ya lengo na vigezo vingine.
DLinear: Licha ya kuwa na bajeti ndogo sana ya vigezo, iko nafasi ya tano. Matokeo haya yanaonyesha kwamba kuwa na attention tata au miundo ya kurudia hakutoi faida ya moja kwa moja katika utabiri wa kifedha.
N-HiTS: Ingawa ni ya sita katika upangaji wa jumla, ilipata RMSE ya chini zaidi kwa ETH/USDT katika upeo wote miwili na kwa ADA/USDT katika upeo wa saa 4. Kwa hiyo, wastani wa nafasi wa jumla unaweza kuficha baadhi ya faida maalumu kwa mali.
TimesNet na Autoformer: Modeli zote mbili zinaweka msisitizo wazi kwenye periodicity au muundo wa frequency domain na zilibaki katika kundi la chini katika benchmark hii. Mwandishi anajadili kwamba uhaba wa miundo thabiti na yenye nguvu ya periodic katika mfululizo wa kifedha wa kila saa unaweza kueleza matokeo haya; tafsiri hii si utenganishaji wa moja kwa moja wa kimajaribio wa mechanism.
LSTM: Ni rejea ya kawaida ya recurrent katika utafiti. Makosa yake yalikuwa takriban mara 7–33 juu kuliko modeli bora kulingana na kategori na ilibaki ya mwisho katika upangaji wa jumla. Matokeo haya yanatumika tu kwa itifaki ya moja kwa moja ya multi-step, OHLCV-only na mafunzo ya pamoja iliyotumika hapa; hayathibitishi kwamba matumizi yote yanayowezekana ya LSTM hushindwa kwa ujumla.
Hitimisho zinazoungwa mkono na utafiti
- Utendaji wa usanifu tisa si sawa.
- ModernTCN na PatchTST ziliunda kundi la juu lililo wazi katika muundo huu wa majaribio.
- Ingawa kosa la absolute liliongezeka kutoka saa 4 hadi saa 24, upangaji wa kulinganisha wa modeli kwa kiasi kikubwa ulihifadhiwa.
- Tofauti ya mwanzo ya seed ni ndogo sana ikilinganishwa na athari za usanifu na muktadha wa mali.
- Hakukupatikana uhusiano wa monotoniki kati ya idadi ya vigezo vya modeli na mafanikio ya utabiri.
- Modeli zilizofunzwa kwa MSE hazikuweza kutofautiana kwa umuhimu na kiwango cha %50 katika utabiri wa mwelekeo wa kila saa.
- Katika baadhi ya mali, modeli tofauti na kiongozi wa jumla zinaweza kutoa RMSE ya chini zaidi.
Hitimisho ambazo utafiti hauungi mkono
- Haiwezi kuhitimishwa kwamba ModernTCN ni modeli bora kabisa katika masoko yote ya kifedha, frequencies na aina za data.
- Haijaonyeshwa kwamba RMSE ya chini huzalisha mkakati wa biashara wenye faida.
- Transaction cost, slippage, market impact, ukubwa wa position, Sharpe ratio au maximum drawdown hazikujaribiwa.
- Haijaonyeshwa kwamba upangaji uleule utahifadhiwa katika data ya kila siku, kila dakika, tick-level au H4.
- Hakujafanywa ujanibishaji kwa commodities, bonds, mali za masoko yanayoibukia au ulimwengu mpana wa altcoin.
- Haijaonyeshwa kwamba upangaji wa usanifu utabaki uleule ikiwa habari, sentiment, viashiria vya kiufundi na order-book zitaongezwa.
- Utafiti si jaribio la mfumo uliodeployiwa kwa wakati halisi katika mazingira hai ya forward-walk trading.
Mapungufu
| Kizuizi | Athari ya kisayansi |
|---|---|
| Trial 5 pekee kwa kila HPO | Inaweza kuzuia modeli zenye nafasi pana ya utafutaji kufikia configuration bora; hasa nafasi za kundi la kati zinaweza kubadilika. |
| Block 8 pekee katika majaribio ya jozi ndani ya kategori | Nguvu ya kitakwimu ni ndogo chini ya marekebisho ya Holm. |
| Ingizo la OHLCV pekee | Huenda lisioneshe uwezo wa modeli zinazotumia sentiment, order book au viashiria vya kiufundi. |
| Data ya kila saa pekee | Matokeo hayawezi kuhamishwa moja kwa moja kwa frequency za tick, dakika, H4 au kila siku. |
| Vyombo 12 vya kifedha | Commodities, fixed-income securities na masoko yanayoibukia yako nje ya wigo. |
| Upeo wa saa 4 na 24 pekee | Mkunjo kamili wa kuzorota kwa upeo haujulikani. |
| Cohen's d haijaripotiwa | Ulinganisho kati ya tafiti kwa standardized effect size ni mdogo. |
| Batch test set | Haionyeshi utendaji wa live rolling forward-walk deploy unaofanya retraining. |
Uzalishwaji upya
Source code ya utafiti, faili za configuration, data, rekodi za HPO, hyperparameter zilizofungiwa, checkpoint 648 za modeli zilizofunzwa, matokeo ya tathmini na matokeo ya majaribio ya kitakwimu zimeshirikiwa katika repository ya mradi. Usimamizi wa random seed ulitekelezwa katika tabaka za Python, NumPy, PyTorch CPU/CUDA na PYTHONHASHSEED; kwa cuDNN zilitumika deterministic=True na benchmark=False.
Hata hivyo, torch.use_deterministic_algorithms(True) haikuwashwa. Kwa hiyo, hata katika software configuration ileile, tofauti ndogo za floating-point kati ya usanifu tofauti wa GPU zinaweza kubaki kinadharia. Kutumia seed tatu huru husaidia kupima ukubwa wa kutokuwa na uhakika huu ndani ya matokeo ya majaribio.
Mapendekezo ya utafiti wa baadaye
Chanzo kinataja hasa bajeti kubwa zaidi za utafutaji wa hyperparameter, Cohen's d effect size, directional loss functions, upeo mpana zaidi wa utabiri, altcoin na madaraja zaidi ya mali, feature sets tajiri zaidi, heterogeneous ensembles zinazounganisha upendeleo tofauti wa kiinduktivu kama ModernTCN na PatchTST, frequencies mbadala za muda na tathmini ya rolling forward-walk kama maeneo ya kipaumbele ya utafiti wa baadaye.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: A Controlled Comparison of Deep Learning Architectures for Multi-Horizon Financial Forecasting: Evidence from 918 Experiments
Mwandishi: Nabeel Ahmad Saidd
Taasisi: Dr. A.P.J. Abdul Kalam Technical University (AKTU)
Aina ya chanzo: arXiv preprint / utafiti wa benchmark wa kimahesabu wa mfululizo wa muda wa kifedha.
arXiv: 2603.16886v1
Tarehe ya toleo la kwanza: 27 Februari 2026.
Kategoria ya arXiv: q-fin.ST.
DOI: DOI haijaainishwa katika PDF iliyotolewa wala katika rekodi ya arXiv iliyothibitishwa.
Jarida / juzuu / namba: Hakuna taarifa iliyothibitishwa ya jarida lililopitiwa na wenzao kwa toleo lililotolewa; kwa hiyo, utafiti haupaswi kuwasilishwa kama makala ya jarida lililopitiwa na wenzao.
Chanzo rasmi: https://arxiv.org/abs/2603.16886
Repository ya mradi: https://github.com/NabeelAhmad9/compare_forecasting_models
Leseni: Maelezo ya sasa ya leseni katika repository ya mradi yanaainisha Creative Commons Attribution 4.0 International (CC BY 4.0) kwa makala na vielelezo vinavyoandamana nayo, na MIT License kwa source code. Kwa kuwa lebo kamili ya leseni haionekani katika PDF iliyotolewa yenyewe, taarifa hii inategemea tamko la repository.
Ufadhili: Hakuna tamko tofauti la ufadhili lililogunduliwa katika PDF iliyotolewa.
Mgongano wa maslahi: Mwandishi anatangaza kwamba hakuna maslahi ya kifedha yanayoshindana au uhusiano binafsi unaojulikana ambao unaweza kuathiri utafiti, uchambuzi au matokeo.
Upatikanaji wa data na code: Utafiti unaeleza kwamba data ghafi na iliyochakatwa, configurations, rekodi za HPO, checkpoint na matokeo ya benchmark yanapatikana katika repository ya mradi.
Mpaka mkuu wa mbinu: Matokeo yanatumika kwa mali 12, data ya OHLCV ya kila saa, upeo wa utabiri wa saa 4 na 24, bajeti ndogo ya HPO na batch historical test set. Faida ya biashara ya wakati halisi au utendaji wa live market deploy haukujaribiwa.
Maelezo ya kutolingana kwa namba ndani ya chanzo: Kulingana na Jedwali 8, ModernTCN ilishinda pointi 15 kati ya 16 za jumla za tathmini za forex na fahirisi, na 8/8 za subset ya saa 24. Kauli “16/16 katika saa 24” katika mjadala hailingani na jedwali. Aidha, Jedwali 9 linaonyesha ModernTCN ikiwa ya kwanza katika forex RMSE kwa 0,1098, huku sehemu moja ya maandishi ikitaja thamani 0,1108 ya PatchTST kama “kiongozi wa kategori”. Katika uwasilishaji wa Verianla, majedwali ya kiasi yametumika kama msingi.
Hakimiliki na mbinu ya uwasilishaji: Maudhui haya hayazalishi upya muundo wa sentensi au aya wa utafiti asilia. Mbinu, matokeo ya namba, equation na mipaka ya tafsiri kutoka kwenye chanzo zimetolewa katika kiwango cha ukweli wa kisayansi na kupangwa upya ndani ya muundo huru wa kielimu kwa Verianla.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *