


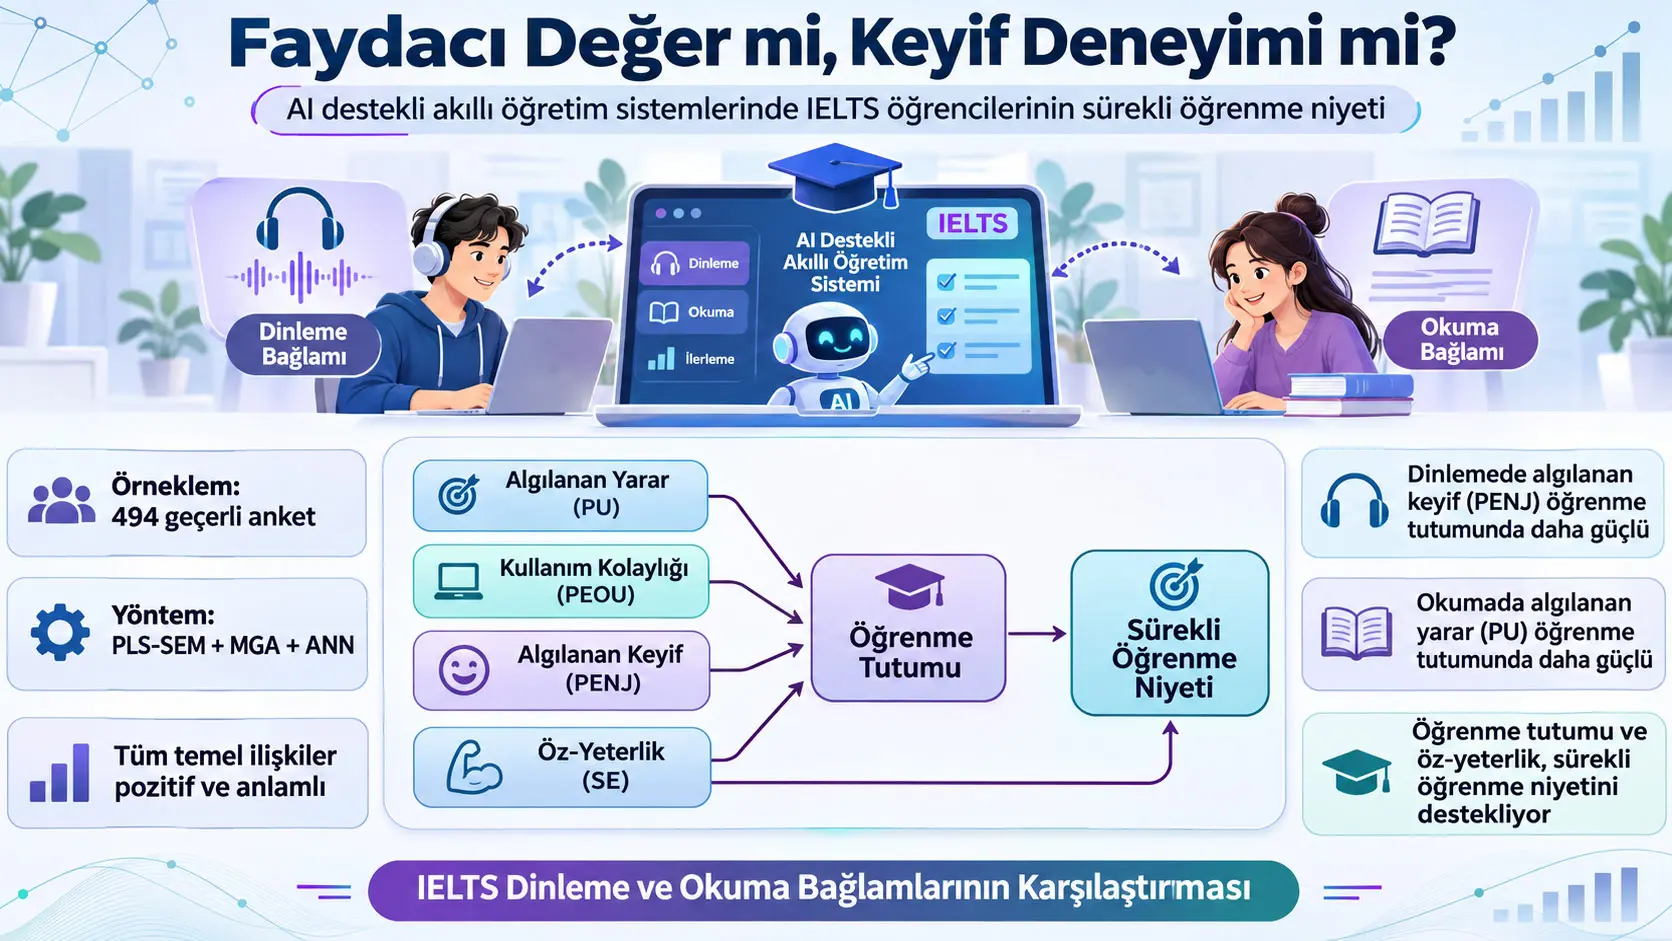
Yapay zekâ destekli akıllı öğretim sistemi (AI-driven Intelligent Tutoring System, ITS), öğrencinin performansına ve etkileşimlerine göre görev, geribildirim, tanılama ve öğrenme desteğini uyarlayabilen bilgisayar tabanlı bir eğitim ortamıdır. Bu çalışma, IELTS hazırlığında böyle bir sistemi kullanan öğrenenlerin sistemi kullanmaya devam etme niyetinin nasıl oluştuğunu incelemektedir. Araştırma 494 geçerli ankete dayanmakta ve genişletilmiş Teknoloji Kabul Modeli'ni (Technology Acceptance Model, TAM) kısmi en küçük kareler yapısal eşitlik modellemesi (PLS-SEM), çoklu grup analizi (MGA) ve yapay sinir ağı (ANN) ile değerlendirmektedir.
Genişletilmiş modelde algılanan yarar (PU), algılanan kullanım kolaylığı (PEOU), algılanan keyif (PENJ) ve öz-yeterlik (SE) öğrenme tutumunun (LA) öncülleri olarak incelenmiştir. Öğrenme tutumu ve öz-yeterlik ise sürekli öğrenme niyetinin (CLI) doğrudan öncülleridir. Bütün örneklemde altı temel yapısal yolun tamamı pozitif ve istatistiksel olarak anlamlı bulunmuştur. Öğrenme tutumuna giden en yüksek genel yol katsayısı algılanan yarara aittir (\(\beta=0.323\)); sürekli öğrenme niyetine giden iki doğrudan yol içinde öğrenme tutumu (\(\beta=0.361\)) ile öz-yeterlik (\(\beta=0.348\)) birbirine yakın büyüklüktedir.
Dinleme ve okuma bağlamları karşılaştırıldığında iki önemli bağlamsal fark ortaya çıkmıştır. Algılanan keyfin öğrenme tutumuna etkisi dinlemede \(\beta=0.340\), okumada \(\beta=0.178\) olarak bulunmuş ve grup farkı anlamlıdır (\(p=0.037\)). Algılanan yararın öğrenme tutumuna etkisi ise okumada \(\beta=0.424\), dinlemede \(\beta=0.226\)'dır; bu grup farkı da anlamlıdır (\(p=0.016\)). Kullanım kolaylığı, öz-yeterlik ve öğrenme tutumunun diğer yollarında dinleme ile okuma arasında istatistiksel olarak anlamlı yol farkı saptanmamıştır.
ANN sonuçları bağlama özgü bu sıralamayı desteklemiştir. Öğrenme tutumunu tahmin eden ANN'de dinleme grubunun en önemli girdisi algılanan keyiftir; ortalama önem 0,334 ve normalize önem %100'dür. Okuma grubunda en önemli girdi algılanan yarardır; ortalama önem 0,423 ve normalize önem %100'dür. Buradaki %100, değişkenin öğrenme tutumunun %100'ünü açıkladığı anlamına gelmez; yalnız aynı ANN içindeki en önemli öngörücünün diğer değişkenlerin göreli önemini ölçeklemek için %100'e sabitlendiğini gösterir.
Çalışmanın önemli yorum sınırı, ölçülen bağımlı değişkenin gerçek uzun dönem kullanım veya IELTS performansı değil, öğrencilerin gelecekte sistemi kullanmaya devam etme niyeti olmasıdır. Veri tek zaman noktasında toplanmış öz-bildirim anketidir. Bu nedenle sonuçlar değişkenler arasındaki ilişkileri ve tahmin örüntülerini gösterir; “keyif dinleme başarısını artırır” veya “yarar algısı okuma puanını yükseltir” gibi nedensel performans sonuçları çıkarılamaz.
Araştırmanın temel problemi
Akıllı öğretim sistemleri, kişiselleştirilmiş görev önerileri, adaptif alıştırmalar, anlık geribildirim, hata tanılama ve öğrenme analitiği sunabilmektedir. Ancak bir eğitim teknolojisinin kullanılabilmesi ile öğrencinin onu uzun süre kullanmak istemesi aynı problem değildir. Öğrenci sistemi teknik olarak kullanabilir ve hatta yararlı bulabilir; buna rağmen öğrenme deneyimi sıkıcı, zor veya kontrol edilemez gelirse devam etme niyeti zayıflayabilir.
Çalışma bu nedenle klasik Teknoloji Kabul Modeli'nin iki temel teknoloji algısını —algılanan yarar ve algılanan kullanım kolaylığı— tek başına yeterli görmemiştir. Modele öğrencinin kendi yapabilme kapasitesine ilişkin öz-yeterlik inancı ile öğrenme sürecinin kendisinden aldığı algılanan keyif eklenmiştir.
Araştırmanın ikinci problemi bağlam farklılığıdır. IELTS dinleme ve okuma, her ikisi de alıcı dil becerileri olmasına rağmen aynı bilişsel görev değildir. Dinlemede bilgi geçicidir; ses akışı devam ederken öğrenci bilgiyi işlemeli, tutmalı ve anlam kurmalıdır. Okumada ise metne geri dönmek, hızı değiştirmek ve stratejiyi uyarlamak daha mümkündür. Araştırmacılar bu nedenle aynı ITS içindeki farklı görevlerin öğrencinin yarar ve keyif değerlendirmelerine farklı ağırlıklar verip vermediğini test etmiştir.
PLS-SEM, MGA ve ANN Neden Birlikte Kullanıldı?
PLS-SEM kuramsal modeldeki yönlü ilişkileri ve hipotezleri test etmek, MGA dinleme ile okuma gruplarındaki yol katsayılarının gerçekten farklı olup olmadığını incelemek, ANN ise doğrusal modelin ötesinde olası doğrusal olmayan tahmin örüntülerini ve öngörücülerin göreli önemini değerlendirmek için kullanılmıştır; üç yöntem aynı sorunun farklı katmanlarını inceler ve birbirinin yerine geçmez.
Teknoloji Kabul Modeli ve genişletilmiş model
Teknoloji Kabul Modeli (Technology Acceptance Model, TAM), bir teknolojinin kabulünü açıklamak için özellikle algılanan yarar, algılanan kullanım kolaylığı, tutum ve davranışsal niyet arasındaki ilişkileri kullanan kuramsal bir çerçevedir. Bu çalışma klasik TAM'ı doğrudan tekrar etmek yerine iki değişkenle genişletmiştir: algılanan keyif ve görev-özgü öz-yeterlik.
| Kısaltma | İngilizce ad | Türkçe karşılık | Bu çalışmadaki anlamı | Madde sayısı |
|---|---|---|---|---|
| PU | Perceived Usefulness | Algılanan yarar | AI destekli sistemin IELTS okuma/dinleme öğrenimine yararlı olacağına ilişkin değerlendirme | 3 |
| PEOU | Perceived Ease of Use | Algılanan kullanım kolaylığı | Sistemi öğrenmenin ve kullanmanın ne kadar kolay algılandığı | 3 |
| PENJ | Perceived Enjoyment | Algılanan keyif | Sistemi kullanarak öğrenmenin ne kadar hoş, keyifli ve ilgi çekici bulunduğu | 3 |
| SE | Self-Efficacy | Öz-yeterlik | Öğrencinin AI destekli öğrenmede karşılaştığı sorunları çözebileceğine ve uygun stratejiler geliştirebileceğine ilişkin inancı | 3 |
| LA | Learning Attitude | Öğrenme tutumu | AI destekli okuma/dinleme öğrenimine yönelik olumlu değerlendirme ve memnuniyet | 3 |
| CLI | Continuous Learning Intention | Sürekli öğrenme niyeti | Gelecekte AI destekli öğrenme hizmetini kullanmaya devam etme niyeti | 3 |
Öz-yeterlik burada genel akademik öz-yeterlik değildir. Araştırma özellikle öğrencinin AI destekli IELTS öğrenme ortamındaki görevleri yönetme, sistem geribildirimini anlama, yeni sorunlara çözüm bulma ve uygun stratejiler geliştirme kapasitesine ilişkin inancını ölçmektedir.
Araştırma modelinin iki temel yapısal denklemi
Öğretici gösterim: Makale aşağıdaki iki denklemi numaralandırılmış formül olarak vermemektedir. Bunlar kaynak Şekil 1'deki yapısal ilişkilerin matematiksel olarak açık okunmasını sağlayan standart doğrusal gösterimdir.
\[ LA=\beta_1PU+\beta_2PEOU+\beta_3PENJ+\beta_4SE+\varepsilon_{LA} \]
Bu denklem öğrenme tutumunun dört öncülle açıklanan bölümünü gösterir. \(\beta_1,\ldots,\beta_4\) PLS-SEM yol katsayılarıdır. \(\varepsilon_{LA}\), modeldeki dört değişken tarafından açıklanmayan öğrenme tutumu varyasyonunu temsil eder.
\[ CLI=\beta_5SE+\beta_6LA+\varepsilon_{CLI} \]
İkinci denklem sürekli öğrenme niyetinin öz-yeterlik ve öğrenme tutumuyla açıklanan kısmını temsil eder. Araştırmada PU, PEOU ve PENJ'nin CLI'ye doğrudan yolları kurulmamış; bunların CLI üzerindeki dolaylı etkileri LA aracılığıyla incelenmiştir.
Hipotezler
| Hipotez | İlişki | Beklenti |
|---|---|---|
| H1 | PU → LA | Algılanan yarar arttıkça öğrenme tutumunun daha olumlu olması |
| H2 | PEOU → LA | Algılanan kullanım kolaylığı arttıkça öğrenme tutumunun daha olumlu olması |
| H3 | PENJ → LA | Algılanan keyif arttıkça öğrenme tutumunun daha olumlu olması |
| H4 | SE → LA | Öz-yeterlik arttıkça öğrenme tutumunun daha olumlu olması |
| H5 | SE → CLI | Öz-yeterliğin sürekli öğrenme niyetiyle pozitif ilişkili olması |
| H6 | LA → CLI | Olumlu öğrenme tutumunun sürekli öğrenme niyetini güçlendirmesi |
| H7a | PENJ → LA | Bu ilişkinin dinleme bağlamında okumadan daha güçlü olması |
| H7b | PU → LA | Bu ilişkinin okuma bağlamında dinlemeden daha güçlü olması |
İncelenen ITS nasıl çalışıyordu?
Çalışmada ticari marka genellemesi yapılmadan “AI tabanlı sınava hazırlık asistanı” olarak tanımlanan tek bir sistem kullanılmıştır. Öğrenci önce mevcut İngilizce düzeyi ve hedeflerine göre hedef IELTS puanı belirlemektedir. Sistem performansa ve hedefe göre okuma veya dinleme görevleri önermekte, içerik ve zorluk düzeyini dinamik biçimde ayarlayabilmektedir.
Her görev sonrasında öğrenciler anlık cevap geribildirimi ve AI tarafından üretilmiş öğrenme analizi raporları almıştır. Raporlarda performans, hata örüntüleri ve sonraki çalışma için öneriler bulunmuştur. Okuma modülü soru alıştırmaları, hata tanısı ve metin-anlama desteğine daha fazla odaklanırken; dinleme modülü ses girdisi üzerinde tekrarlı alıştırma ve etkileşimli geribildirime daha fazla yer vermiştir.
Dolayısıyla katılımcının sistemle ilişkisi yalnız içerik görüntülemekten ibaret değildir. Çalışmadaki etkileşim döngüsü kabaca hedef belirleme → görev tamamlama → geribildirim alma → öğrenme analizini inceleme → sonraki pratiği uyarlama biçimindedir.
Ölçüm aracı nasıl oluşturuldu?
Dinleme ve okuma için ayrı bağlamsallaştırılmış iki anket formu hazırlanmıştır. Her form 18 maddeden oluşmuştur. Altı gizil yapının her biri üç maddeyle ölçülmüş ve cevaplar 1 = kesinlikle katılmıyorum ile 5 = kesinlikle katılıyorum arasında beş noktalı Likert ölçeğinde alınmıştır.
PU, PEOU, PENJ, LA ve CLI maddeleri önceki TAM ve eğitim teknolojisi çalışmalarından uyarlanmıştır. SE maddeleri önceki dijital öz-yeterlik çalışmalarından uyarlanmış; birbirine anlamsal olarak çok benzeyen iki özgün madde arasından biri çıkarılarak üç maddelik dengeli yapı oluşturulmuştur.
İngilizce ölçeklerin Çincede kullanılabilmesi için çeviri ve geri çeviri yapılmıştır. İki iki dilli araştırmacı bağımsız biçimde İngilizceden Çinceye çeviri yapmış, araştırma ekibi bu sürümleri uzlaştırmış; özgün ölçekleri görmeyen iki başka iki dilli araştırmacı Çince sürümü tekrar İngilizceye çevirmiştir. Geri çevrilmiş İngilizce ile özgün maddeler karşılaştırılmış ve anlamsal farklılıklar revize edilmiştir. Daha sonra iki dilli eğitim ve eğitim teknolojisi geçmişine sahip üç profesör kültürel ve dilsel uygunluğu değerlendirmiştir.
PLS-SEM nedir?
Kısmi En Küçük Kareler Yapısal Eşitlik Modellemesi (Partial Least Squares Structural Equation Modeling, PLS-SEM), gözlenemeyen kuramsal yapıları birden fazla anket maddesiyle temsil edip bu yapılar arasındaki yönlü ilişkileri aynı model içinde tahmin etmeye yarayan varyans-temelli bir yapısal eşitlik modelleme yaklaşımıdır.
Bu çalışmada PLS-SEM tercihinin ana gerekçesi yalnız önceden kurulmuş TAM'ı doğrulamak değil; TAM'ı öz-yeterlik ve algılanan keyifle genişletmek, önemli öngörücüleri belirlemek ve modelin açıklayıcı/tahminsel kapasitesini birlikte değerlendirmektir. Analiz SmartPLS 4 ile yürütülmüştür.
Yol katsayısı \(\beta\) nasıl okunmalı?
PLS-SEM'deki \(\beta\), diğer ilgili öngörücüler modelde tutulduğunda bir gizil değişkendeki artışla sonuç değişkeni arasındaki yönü ve göreli ilişki büyüklüğünü gösteren yol katsayısıdır. Pozitif \(\beta\), değişkenlerin aynı yönde hareket ettiğini gösterir. Ancak kesitsel gözlemsel veri üzerinde pozitif ve anlamlı \(\beta\), tek başına deneysel nedensellik kanıtı değildir.
Etki büyüklüğü \(f^2\) neyi anlatıyor?
Öğretici standart formül:
\[ f^2= \frac{R^2_{\mathrm{dahil}}-R^2_{\mathrm{hariç}}} {1-R^2_{\mathrm{dahil}}} \]
Bu metrik belirli bir öngörücü modelden çıkarıldığında açıklanan varyansın ne kadar azaldığını gösterir. Çalışmada LA → CLI için \(f^2=0.173\) en yüksek değer olup yazarlar tarafından orta büyüklükte etki olarak yorumlanmıştır. SE → CLI için \(f^2=0.162\) de orta düzeydedir. PU → LA için \(f^2=0.149\) orta düzeye yaklaşmaktadır.
Dolaylı etki nasıl oluşuyor?
PU, PEOU ve PENJ modelde CLI'ye doğrudan bağlanmamaktadır. Bu değişkenler önce LA'yı, LA da CLI'yi etkileyen yapıda sınanmıştır. Basit bir aracılık zincirindeki dolaylı katsayı iki yolun çarpımıyla açıklanabilir:
\[ \beta_{\mathrm{dolaylı}} = \beta_{X\rightarrow LA} \times \beta_{LA\rightarrow CLI} \]
Örneğin PU → LA katsayısı 0,323 ve LA → CLI katsayısı 0,361 olduğundan çarpım yaklaşık \(0.323\times0.361\approx0.117\)'dir; çalışma bootstrap sonucunu 0,116 olarak raporlamaktadır. Bu küçük fark yuvarlamadan kaynaklanabilir.
R², Q² ve SRMR neyi ölçüyor?
\(R^2\), modelin bir içsel değişkendeki varyansın ne kadarını açıkladığını gösterir. Çalışmada LA için \(R^2=0.436\), CLI için \(R^2=0.338\)'dir. Başka bir ifadeyle model, örneklemde öğrenme tutumu varyasyonunun yaklaşık %43,6'sını ve sürekli öğrenme niyeti varyasyonunun yaklaşık %33,8'ini açıklamaktadır. Bu oranlar modelin bütün bireysel davranışı açıkladığı anlamına gelmez.
\(Q^2\), modelin tahminsel ilgisini değerlendiren ölçüdür. Çalışmada LA ve CLI için sırasıyla 0,305 ve 0,236 olarak raporlanmış ve iki değerin de sıfırdan büyük olması olumlu tahminsel ilgi olarak yorumlanmıştır.
SRMR (Standardized Root Mean Square Residual), modelin öngördüğü ve gözlenen ilişki yapıları arasındaki standartlaştırılmış artıkların genel büyüklüğünü özetler. Araştırmada SRMR=0,062 olup yazarların kullandığı 0,08 referans sınırının altındadır.
MICOM neden MGA'dan önce yapıldı?
Measurement Invariance of Composite Models (MICOM), dinleme ve okuma gruplarında aynı gizil yapıların yeterince karşılaştırılabilir biçimde ölçülüp ölçülmediğini kontrol etmek için uygulanmıştır. Eğer iki grupta “algılanan yarar” veya “öğrenme tutumu” aynı yapıyı temsil etmiyorsa yol katsayılarını doğrudan karşılaştırmak yanıltıcı olabilir.
MICOM üç aşamalıdır: yapılandırma değişmezliği, bileşimsel değişmezlik ve bileşik ortalama/varyans eşitliği. Çalışmada yapılandırma ve bileşimsel değişmezlik sağlanmış, böylece kısmi ölçüm değişmezliği elde edilmiştir. Tam ortalama/varyans eşitliği bütün yapılarda sağlanmamıştır. Bu nedenle MGA yapılabilmiştir fakat yazarlar iki grubun anket maddelerinin okuma ve dinleme bağlamına göre uyarlanmış olmasını ayrıca yorum sınırı olarak belirtmiştir.
ANN mimarisi
ANN analizi SPSS 27.0 içindeki çok katmanlı algılayıcı (Multilayer Perceptron, MLP) kullanılarak yapılmıştır. İki model kurulmuştur. Model 1'in girdileri PU, PEOU, PENJ ve SE; çıktısı LA'dır. Model 2'nin girdileri SE ve LA; çıktısı CLI'dir.
Her iki modelde tek gizli katman ve gizli katmanda beş nöron vardır. Gizli katman aktivasyonu sigmoid, çıktı katmanı aktivasyonu identity fonksiyonudur. Eğitim batch training yöntemiyle gerçekleştirilmiştir.
Min–max normalizasyonu
ANN'ye verilen bütün girdi ve çıktı değişkenleri 0–1 aralığına ölçeklenmiştir. Standart min–max dönüşümü:
\[ x'=\frac{x-x_{\min}}{x_{\max}-x_{\min}} \]
\(x\) özgün değer, \(x_{\min}\) değişkenin minimumu, \(x_{\max}\) maksimumu ve \(x'\) 0–1 ölçeğindeki dönüştürülmüş değerdir. Bu işlem değişkenleri ortak bir sayısal aralığa taşır. Dolayısıyla ANN'de raporlanan RMSE değerleri IELTS band puanı cinsinden değildir; normalize edilmiş model değişkenlerinin tahmin hatasıdır.
Sigmoid aktivasyon fonksiyonu
Gizli katmanda kullanılan sigmoid fonksiyonunun standart biçimi:
\[ \sigma(z)=\frac{1}{1+e^{-z}} \]
Fonksiyon herhangi bir gerçek sayı \(z\)'yi 0 ile 1 arasındaki doğrusal olmayan bir çıktıya dönüştürür. ANN'nin yalnız düz doğrusal ilişkiler yerine daha karmaşık örüntüleri modelleyebilmesine katkı sağlar.
RMSE neyi ölçüyor?
ANN'nin tahmin hatası Root Mean Square Error (RMSE) ile değerlendirilmiştir. Standart formül:
\[ RMSE= \sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2} \]
\(y_i\) gerçek gözlenen ölçek değeri, \(\hat{y}_i\) ANN tahmini ve \(n\) değerlendirmeye giren gözlem sayısıdır. Hatalar kareye alındığı için büyük hatalar daha fazla ağırlık kazanır. Daha küçük RMSE daha küçük tahmin hatasını gösterir.
ANN'deki %100 Normalize Önem Ne Anlama Geliyor?
Normalize önem %100, bir ANN modelinde en yüksek ortalama önem değerine sahip öngörücünün referans olarak 100'e ölçeklendiğini gösterir; değişkenin sonucun %100'ünü açıkladığını, %100 doğruluk sağladığını veya nedensel etkinin %100 olduğunu göstermez.
Standart öğretici gösterim:
\[ NI_j= \frac{I_j}{\max(I)} \times100 \]
\(I_j\), ilgili değişkenin ANN duyarlılık analizindeki ortalama önemidir; \(\max(I)\) aynı model içindeki en yüksek önem değeridir. En yüksek değişken böylece %100 olur ve diğer değişkenler ona göre göreli olarak ölçeklenir.
Çalışmanın Yöntemi ve Bulguları
Örnekleme ve veri toplama
Araştırmacılar amaçlı örnekleme kullanmıştır. Katılımcının çalışmaya alınması için IELTS hazırlık deneyimine, AI tabanlı sınava hazırlık asistanını kullanma deneyimine ve IELTS okuma veya dinleme görevlerini tamamlama kapasitesine sahip olması gerekmiştir.
Anket Şubat–Nisan 2026 arasında Credamo çevrim içi anket platformunda uygulanmıştır. Katılımcılar Pekin, Guangzhou, Chongqing, Wuhan, Nanjing ve Macao'dan toplanmış; 18 yaş ve üzerindeki lise öğrencileri ile lisans, yüksek lisans ve doktora öğrencileri örnekleme dahil edilmiştir.
G*Power 3.1.9.7 ile etki büyüklüğü 0,15, \(\alpha=0.05\) ve güç \(1-\beta=0.95\) kullanılarak minimum örneklem büyüklüğü 107 olarak hesaplanmıştır. Formal anket öncesinde AI destekli IELTS öğrenme deneyimine sahip 50 öğrenciyle pilot çalışma yapılmıştır.
Pilot çalışmanın kalite kontrolleri
| Gösterge | Sonuç | Kaynak yorumu |
|---|---|---|
| Cronbach α | 0,716–0,881 | Bütün gizil yapılar önerilen 0,70 düzeyini aşmıştır. |
| Composite Reliability | 0,789–0,925 | Ön güvenilirlik yeterli bulunmuştur. |
| KMO | 0,869 | Ölçüm uygunluğu açısından yeterli bulunmuştur. |
| Harman tek faktör, ilk faktör | %26,6 | %50 eşiğinin altında bulunmuştur. |
Pilot sonrasında araştırmacılar ölçüm maddelerinde yeni bir revizyon yapmamış ve aynı formu ana ankette kullanmıştır.
522 anketten 494 geçerli ankete geçiş
Toplam 522 anket toplanmıştır. Geçerlilik kontrol sorusunu geçmeyen, teorik olarak benzer olması beklenen maddelerde açık tutarsızlık gösteren veya eksik cevap içeren formlar çıkarılmıştır. Sonuçta 494 geçerli anket kalmış ve geçerli cevap oranı %94,64 olmuştur.
Dinleme ve okuma grupları tam dengeli biçimde 247'şer katılımcıdan oluşmuştur. Hiçbir katılımcı iki bağlamın anketini birden tamamlamamıştır.
Katılımcı profili
| Değişken | Kategori | n | % |
|---|---|---|---|
| Cinsiyet | Erkek | 211 | 42,7 |
| Cinsiyet | Kadın | 283 | 57,3 |
| Yaş | 18–20 | 129 | 26,1 |
| Yaş | 21–25 | 245 | 49,6 |
| Yaş | 26–30 | 72 | 14,6 |
| Yaş | 31 ve üzeri | 48 | 9,7 |
| Eğitim düzeyi | Lise öğrencisi, 18+ | 30 | 6,1 |
| Eğitim düzeyi | Lisans öğrencisi | 224 | 45,3 |
| Eğitim düzeyi | Yüksek lisans öğrencisi | 178 | 36,0 |
| Eğitim düzeyi | Doktora öğrencisi | 62 | 12,6 |
| Yer | Macao | 72 | 14,6 |
| Yer | Beijing | 78 | 15,8 |
| Yer | Chongqing | 88 | 17,8 |
| Yer | Guangzhou | 91 | 18,4 |
| Yer | Nanjing | 79 | 16,0 |
| Yer | Wuhan | 86 | 17,4 |
| AI eğitim hizmeti kullanımı | Nadiren | 8 | 1,6 |
| AI eğitim hizmeti kullanımı | Ara sıra | 117 | 23,7 |
| AI eğitim hizmeti kullanımı | Haftada birden çok | 154 | 31,2 |
| AI eğitim hizmeti kullanımı | Her gün | 215 | 43,5 |
Akademik disiplinler de mühendislik, beşerî bilimler, işletme ve ekonomi, sosyal bilimler, bilgi teknolojileri/bilgisayar bilimi, tıp bilimleri, sanat-tasarım ve doğa bilimleri arasında dağılmıştır. En yüksek oran sosyal bilimler (%15,8), en düşük oran sanat ve tasarımdır (%9,3).
Ortak yöntem yanlılığı nasıl kontrol edildi?
Bütün temel değişkenlerin aynı öz-bildirim anketinden gelmesi Common Method Bias (CMB) riskini doğurabilir. Araştırmacılar önce Harman tek faktör testini kullanmıştır. Ana veri setinde ilk faktör toplam varyansın %32,744'ünü açıklamış; kaynakta kullanılan %50 sınırının altında kalmıştır.
Harman testinin sınırlılığı nedeniyle ayrıca full-collinearity VIF kontrolü yapılmıştır. Yapı düzeyindeki VIF değerleri 1,155–1,770 arasında ve kullanılan 3,3 referans sınırının altındadır. Yazarlar bu iki kontrolü birlikte değerlendirerek ciddi bir ortak yöntem yanlılığının sonuçları baskın biçimde yönlendirdiğine ilişkin kanıt bulunmadığı sonucuna varmıştır. Bu testler CMB'nin mutlak olarak imkânsız olduğunu kanıtlamaz.
Ölçüm modelinin güvenilirlik ve yakınsak geçerliliği
| Yapı | Cronbach α | CR | AVE | İçsel yapıysa R² | Q² |
|---|---|---|---|---|---|
| PU | 0,787 | 0,875 | 0,701 | — | — |
| PEOU | 0,854 | 0,912 | 0,774 | — | — |
| PENJ | 0,803 | 0,883 | 0,716 | — | — |
| LA | 0,804 | 0,884 | 0,718 | 0,436 | 0,305 |
| SE | 0,806 | 0,885 | 0,720 | — | — |
| CLI | 0,799 | 0,882 | 0,713 | 0,338 | 0,236 |
Bütün madde yükleri 0,807–0,890 arasında raporlanmıştır. Madde düzeyi VIF değerleri 1,552–2,139 arasındadır. SRMR=0,062'dir. PLSpredict analizinde PLS-SEM çoğu gösterge için doğrusal modele göre daha düşük tahmin hatası üretmiştir.
Ayırt edici geçerlilik
Fornell–Larcker değerlendirmesinde her yapının AVE karekökünün kendi satırındaki diğer yapılarla korelasyonlardan büyük olması beklenir. Kaynak Tablo 3'te diyagonal AVE karekökleri 0,837–0,880 arasındadır.
HTMT değerlendirmesinde ise farklı gizil yapıların gösterge ilişkileri karşılaştırılır. Kaynak Tablo 4'te en yüksek görünen HTMT değeri PU ile LA arasında 0,651'dir ve kullanılan 0,85 sınırının altındadır; raporlanan güven aralıklarının hiçbiri 1'i içermemektedir.
Bütün örneklemde hipotez testi
| Hipotez | Yol | β | 95% CI | f² | T | p | Sonuç |
|---|---|---|---|---|---|---|---|
| H1 | PU → LA | 0,323 | [0,241; 0,404] | 0,149 | 7,687 | <0,001 | Desteklendi |
| H2 | PEOU → LA | 0,229 | [0,158; 0,297] | 0,085 | 6,486 | <0,001 | Desteklendi |
| H3 | PENJ → LA | 0,258 | [0,182; 0,335] | 0,095 | 6,524 | <0,001 | Desteklendi |
| H4 | SE → LA | 0,164 | [0,087; 0,241] | 0,043 | 4,203 | <0,001 | Desteklendi |
| H5 | SE → CLI | 0,348 | [0,274; 0,421] | 0,162 | 9,137 | <0,001 | Desteklendi |
| H6 | LA → CLI | 0,361 | [0,280; 0,437] | 0,173 | 8,912 | <0,001 | Desteklendi |
Öğrenme tutumuna ilişkin dört öncül arasında bütün örneklemde en yüksek yol katsayısı algılanan yarara aittir (\(\beta=0.323\)). Sürekli öğrenme niyetine giden doğrudan yollarda LA (\(\beta=0.361\)) ve SE (\(\beta=0.348\)) birbirine yakın sonuç vermiştir.
Öğrenme tutumunun aracılık rolü
| Dolaylı yol | β | T | 95% CI | Tablo 6 p değeri |
|---|---|---|---|---|
| PENJ → LA → CLI | 0,093 | 5,030 | [0,060; 0,131] | <0,001 |
| PEOU → LA → CLI | 0,082 | 4,890 | [0,051; 0,117] | <0,001 |
| PU → LA → CLI | 0,116 | 5,798 | [0,079; 0,158] | <0,001 |
| SE → LA → CLI | 0,059 | 3,897 | [0,031; 0,090] | <0,001 |
Bütün güven aralıkları sıfırın dışındadır. En yüksek dolaylı etki PU → LA → CLI yolunda 0,116'dır. SE'nin CLI üzerinde hem doğrudan yolu hem de LA üzerinden dolaylı yolu bulunmaktadır.
MICOM sonucu
1000 permütasyonlu MICOM değerlendirmesinde bütün yapılar için yapılandırma değişmezliği ve bileşimsel değişmezlik sağlanmıştır. Böylece kısmi ölçüm değişmezliği kurulmuştur. Bununla birlikte LA, PENJ, PU ve SE için grup ortalamaları; LA için ayrıca grup varyansı eşitliği sağlanmamıştır. Dolayısıyla dinleme–okuma MGA karşılaştırması yapılabilir kabul edilmiş, fakat tam ölçüm değişmezliği varmış gibi yorumlanmamıştır.
Dinleme ve okuma gruplarında yol katsayıları
| Yol | Dinleme β | Okuma β | Grup farkı | Fark p | Yorum |
|---|---|---|---|---|---|
| PU → LA | 0,226 | 0,424 | −0,198 | 0,016 | Okumada anlamlı biçimde daha güçlü |
| PEOU → LA | 0,222 | 0,241 | −0,019 | 0,783 | Anlamlı grup farkı yok |
| PENJ → LA | 0,340 | 0,178 | 0,162 | 0,037 | Dinlemede anlamlı biçimde daha güçlü |
| SE → LA | 0,149 | 0,168 | −0,020 | 0,801 | Anlamlı grup farkı yok |
| SE → CLI | 0,381 | 0,324 | 0,058 | 0,449 | Anlamlı grup farkı yok |
| LA → CLI | 0,375 | 0,351 | 0,024 | 0,771 | Anlamlı grup farkı yok |
Burada dikkat edilmesi gereken nokta, “dinlemede keyif önemli, okumada yarar önemli” ifadesinin diğer değişkenlerin önemsiz olduğu anlamına gelmemesidir. Altı temel yol iki grubun her birinde de pozitif ve anlamlıdır. Grup karşılaştırmasında yalnız PU → LA ve PENJ → LA yollarının büyüklüğü anlamlı biçimde farklılaşmıştır.
ANN eğitim ve test hataları
Her ANN modeli ve her bağlamda 10 bağımsız rastgele eğitim–test bölmesi yapılmıştır. Her çalıştırmada yaklaşık %90 eğitim ve %10 test kullanılmış; rastgele atama nedeniyle gerçek N değerleri çalıştırmalar arasında değişmiştir. Test kümeleri farklı tekrarlarda kısmen örtüşebilir.
| Bağlam | Model | Hedef | Eğitim RMSE ort. | Eğitim SD | Test RMSE ort. | Test SD |
|---|---|---|---|---|---|---|
| Dinleme | Model 1 | LA | 0,540 | 0,008 | 0,540 | 0,068 |
| Dinleme | Model 2 | CLI | 0,549 | 0,014 | 0,560 | 0,080 |
| Okuma | Model 1 | LA | 0,517 | 0,014 | 0,460 | 0,060 |
| Okuma | Model 2 | CLI | 0,600 | 0,017 | 0,566 | 0,045 |
Kaynak, eğitim ve test RMSE'leri arasındaki farkların genel olarak küçük olmasını held-out örneklerde geniş ölçüde tutarlı performans işareti olarak yorumlamaktadır. Bazı tekrarlar içinde test RMSE'sinin eğitim RMSE'sinden daha düşük olması, rastgele test alt kümesinin daha homojen veya daha kolay tahmin edilen gözlemler içermesiyle açıklanabilecek örnekleme değişkenliği olarak değerlendirilmiştir.
Bu RMSE büyüklüklerinin uygulamalı anlamı çıktı ölçeğine ve değişkenliğine bağlıdır. Değerler min–max normalizasyonundan sonraki model ölçeğindedir; IELTS sınav puanı hatası değildir.
ANN duyarlılık analizi
| Bağlam / model | Öngörücü | Ortalama önem | Normalize önem |
|---|---|---|---|
| Dinleme Model 1 → LA | PENJ | 0,334 | %100,00 |
| Dinleme Model 1 → LA | PU | 0,237 | %70,92 |
| Dinleme Model 1 → LA | SE | 0,214 | %64,14 |
| Dinleme Model 1 → LA | PEOU | 0,214 | %63,94 |
| Dinleme Model 2 → CLI | SE | 0,523 | %100,00 |
| Dinleme Model 2 → CLI | LA | 0,477 | %91,21 |
| Okuma Model 1 → LA | PU | 0,423 | %100,00 |
| Okuma Model 1 → LA | PEOU | 0,236 | %55,70 |
| Okuma Model 1 → LA | PENJ | 0,183 | %43,24 |
| Okuma Model 1 → LA | SE | 0,158 | %37,21 |
| Okuma Model 2 → CLI | LA | 0,542 | %100,00 |
| Okuma Model 2 → CLI | SE | 0,458 | %84,48 |
PLS-SEM ve ANN'nin sıralamaları genel olarak birbirini desteklemektedir. Dinlemede LA için PENJ ilk sıradadır; okumada LA için PU ilk sıradadır. Dinleme Model 1'de PEOU ile SE'nin alt sıralaması PLS-SEM ile ANN arasında küçük bir farklılık göstermektedir ancak ana bağlamsal desen değişmemektedir.
Sağlamlık kontrolü
Örneklemin %6,1'ini oluşturan 18 yaş ve üzeri lise öğrencilerinin ana sonuçları etkileyip etkilemediğini görmek için bu katılımcılar çıkarılarak PLS-SEM ve MGA yeniden tahmin edilmiştir.
Bu analizde altı ana hipotez yine desteklenmiştir. PU → LA için \(\beta=0.313\), PEOU → LA için \(\beta=0.225\), PENJ → LA için \(\beta=0.254\), SE → LA için \(\beta=0.176\), SE → CLI için \(\beta=0.346\) ve LA → CLI için \(\beta=0.356\) elde edilmiştir; bütün yollar \(p<0.001\)'dir.
Dinleme–okuma karşılaştırmasının iki temel farkı da korunmuştur: PU → LA okumada daha güçlü kalmış, PENJ → LA dinlemede daha güçlü kalmıştır. Lise öğrencileri çıkarıldığında PU grup farkı −0,186 ve PENJ grup farkı 0,181 olarak raporlanmış; ikisi de \(p<0.05\)'tir.
Bu Çalışma AI Destekli IELTS Sisteminin Öğrenme Başarısını Artırdığını Kanıtlıyor mu?
Hayır. Araştırma gerçek IELTS puanı artışını, uzun dönem kullanım davranışını veya deneysel öğrenme kazanımını ölçmemektedir; tek zaman noktasında toplanan öz-bildirimlerle öğrencilerin teknoloji algıları, öğrenme tutumu ve gelecekte kullanmaya devam etme niyeti arasındaki ilişkileri incelemektedir.
Dinleme ve okuma farkının anlamı
Yazarların kuramsal yorumuna göre dinleme, geçici ses girdisi, zaman baskısı ve gerçek zamanlı işlem gereksinimi nedeniyle öğrencinin dikkatini ve katılımını sürdürmesini zorlaştırabilir. Bu nedenle keyif ve olumlu deneyim dinleme bağlamında öğrenme tutumuyla daha güçlü ilişkili olabilir.
Okumada ise öğrenci metne geri dönebilir, hızını ayarlayabilir, strateji uygulayabilir ve sistemin hata tanısı veya metin-anlama desteğinin doğrudan görev başarısına ne kadar katkı verdiğini daha belirgin değerlendirebilir. Bu nedenle pratik yarar algısı okumada daha güçlü bir tutum belirleyicisi olarak ortaya çıkmış olabilir.
Ancak çalışma bu açıklamayı “dil becerilerinin değişmez doğası” olarak kanıtlamamaktadır. Kullanılan platformun dinleme modülü daha fazla tekrarlı pratik ve etkileşimli anlık geribildirim içerirken okuma modülü tanılama ve görev desteğine daha fazla odaklanmıştır. Dolayısıyla saptanan fark, görev özelliği ile platform tasarımının ortak sonucu olabilir.
Çalışmanın desteklediği sonuçlar
- Algılanan yarar, kullanım kolaylığı, keyif ve öz-yeterlik öğrenme tutumuyla pozitif ilişkilidir.
- Öğrenme tutumu ve öz-yeterlik sürekli öğrenme niyetiyle pozitif ilişkilidir.
- PU, PEOU, PENJ ve SE'nin CLI üzerinde LA aracılığıyla anlamlı dolaylı etkileri vardır.
- Dinleme bağlamında PENJ → LA yolu okumadan anlamlı biçimde daha güçlüdür.
- Okuma bağlamında PU → LA yolu dinlemeden anlamlı biçimde daha güçlüdür.
- PEOU → LA, SE → LA, SE → CLI ve LA → CLI yollarında iki bağlam arasında anlamlı yol farkı görülmemiştir.
- ANN'nin göreli önem sıralaması ana bağlamsal MGA desenini desteklemektedir.
- Lise öğrencilerinin çıkarıldığı sağlamlık analizinde temel sonuçlar büyük ölçüde korunmuştur.
Çalışmanın desteklemediği sonuçlar
Çalışma keyfin IELTS dinleme puanını artırdığını, algılanan yararın IELTS okuma performansını yükselttiğini, ANN'nin IELTS başarısını tahmin ettiğini, AI tabanlı ITS'nin insan öğretmenden üstün olduğunu, öğrencilerin gerçekten uzun süre sistemi kullanmaya devam ettiğini veya bulunan ilişkilerin kesin nedensel olduğunu göstermemektedir.
Temel sınırlılıklar
Kesitsel tasarım: Veriler tek zaman noktasında toplandığı için motivasyon, tutum ve kullanım niyetinin zaman içindeki değişimi izlenmemiştir. Katı nedensel sonuç çıkarılamaz.
Öz-bildirim: Temel değişkenler öğrencilerin kendi cevaplarıdır. İstatistiksel CMB kontrolleri yapılmasına rağmen öz-bildirim verisinin tüm sınırlılıkları ortadan kalkmaz.
Amaçlı ve çevrim içi örnekleme: Credamo kullanıcıları daha sık internet kullanan ve dijital teknolojiye daha aşina bireyleri fazla temsil edebilir. Gönüllü katılım da AI öğrenimine daha ilgili kişilerin seçilmesine yol açabilir. Örneklem bütün IELTS öğrenenlerinin rastgele temsili değildir.
Coğrafi/kültürel sınır: Örneklem esas olarak Çinli IELTS öğrenenlerine dayanır. Sonuçların farklı ülke, kültür ve eğitim sistemlerine doğrudan genellenmesi doğrulanmamıştır.
Tek platform: Yalnız bir AI tabanlı IELTS hazırlık sistemi kullanılmıştır. Platformun kendine özgü etkileşim, geribildirim ve tanılama tasarımı sonuçları etkileyebilir.
Bağlama uyarlanmış ölçüm: Dinleme ve okuma anketleri aynı kavramsal yapıları ölçmek üzere hazırlanmış olsa da maddeler ilgili görev bağlamına göre uyarlanmıştır. Kısmi ölçüm değişmezliği sağlanmış olsa bile grup farklarının tamamının yalnız görev türünden kaynaklandığı kesin değildir.
Model kapsamı: Teknoloji güveni, algılanan algoritmik adalet, öğretmen desteği, öğretimsel varlık, öğrenme analitiği geribildirimi ve eğitim teknolojisi yönetişimi gibi başka olası değişkenler modele dahil edilmemiştir.
Kaynak ve Yöntem Notu
Özgün başlık: Utilitarian Value or Enjoyment Experience? The Formation Mechanism of IELTS Learners’ Continuous Learning Intention in AI-Driven Intelligent Tutoring Systems: Evidence from PLS-SEM, MGA, and ANN
Yazarlar: Sunyu Tao, Hongfeng Zhang, Shenglin Liu.
Yazar sırası: Kaynaktaki sıra aynen korunmuştur.
Eş katkı: Kaynakta eş birinci yazarlık veya eş katkı işareti belirtilmemiştir.
Sorumlu yazar: Hongfeng Zhang.
Afiliasyon 1: Faculty of Humanities and Social Sciences, Macao Polytechnic University, Macao 999078, China.
Afiliasyon 2: School of Management, Universiti Sains Malaysia, Pulau 11800, Penang, Malaysia.
Dergi: Education Sciences.
Yayıncı: MDPI.
Yayın bilgisi: 2026, Volume 16, Article 1526.
DOI: 10.3390/educsci16091526.
Resmî yayın bağlantısı: DOI üzerinden MDPI Education Sciences makale kaydı.
Gönderim tarihi: 9 Temmuz 2026.
Revizyon tarihi: 11 Eylül 2026.
Kabul tarihi: 15 Eylül 2026.
PDF'deki yayın tarihi: 16 Eylül 2026.
Sürüm notu: MDPI'nin resmî Article Version Notes kaydı, 16 Eylül 2026 tarihli Version of Record sonrasında PDF/HTML dosyalarının 17 Eylül 2026'da güncellendiğini göstermektedir. Bu Verianla yazısı kullanıcı tarafından sağlanan PDF'nin bilimsel içeriğini esas alır.
Kaynak türü: Hakemli araştırma makalesi. Kesitsel, amaçlı örneklemli, öz-bildirim anketine dayalı gözlemsel/ilişkisel çalışma; PLS-SEM, MICOM, MGA ve ANN yöntemlerini birlikte kullanmaktadır.
Hakemlik durumu: Education Sciences içinde yayımlanmış hakemli makaledir.
Lisans: PDF, makalenin Creative Commons Attribution (CC BY) lisansı altında açık erişimli olduğunu belirtmektedir. PDF'deki metinsel kayıttan ayrıca bir CC sürüm numarası varsayılmamıştır.
Örneklem: 522 toplanan anketten 494 geçerli anket; dinleme n=247, okuma n=247.
Veri toplama dönemi: Şubat–Nisan 2026.
Veri toplama platformu: Credamo.
Analiz yazılımları: SmartPLS 4, SPSS 27.0 ve örneklem/güç analizlerinde G*Power 3.1.9.7.
Etik kurul: Macao Polytechnic University Research Committee; Approval No. RP/FCHS-01/2023/E01, 30 Kasım 2023.
Bilgilendirilmiş onam: Tüm katılımcılardan alınmıştır.
Finansman: Macao Polytechnic University tarafından RP/FCHS-01/2023 numarasıyla desteklenmiştir.
Veri erişilebilirliği: Çalışmanın verilerinin makul talep üzerine sorumlu yazardan sağlanabileceği belirtilmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir.
Yazar katkıları: Kavramsallaştırma Sunyu Tao; yöntem Sunyu Tao ve Hongfeng Zhang; yazılım Sunyu Tao ve Shenglin Liu; doğrulama Sunyu Tao ve Shenglin Liu; biçimsel analiz Sunyu Tao; araştırma Sunyu Tao; kaynaklar Hongfeng Zhang; veri kürasyonu Sunyu Tao ve Shenglin Liu; ilk taslak Sunyu Tao; gözden geçirme ve düzenleme Hongfeng Zhang; görselleştirme Sunyu Tao; danışmanlık Hongfeng Zhang; proje yönetimi Hongfeng Zhang; finansman edinimi Hongfeng Zhang.
Kaynak içi tutarsızlık 1 — Fornell–Larcker açıklaması: Ana metin en yüksek yapı korelasyonlarını 0,48 olarak tanımlarken Tablo 3'te PU–LA korelasyonu 0,518 olarak görünmektedir. Verianla tablo değerini değiştirmemiştir.
Kaynak içi tutarsızlık 2 — HTMT üst sınırı: Metin HTMT aralığını 0,159–0,596 olarak yazarken Tablo 4'te PU–LA HTMT değeri 0,651'dir. Verianla kesin değer olarak tabloda görülen 0,651'i esas almıştır.
Kaynak içi tutarsızlık 3 — Yapısal VIF aralığı: Yapısal model açıklamasında VIF aralığı 1,088–1,239 olarak yazılmıştır; Tablo 5'te PENJ → LA satırında VIF=1,247 bulunmaktadır. Verianla bu değeri sessizce değiştirmemektedir.
Kaynak içi tutarsızlık 4 — PEOU dolaylı etki p değeri: Tablo 6 öncesindeki metin PEOU → LA → CLI için p<0,01 ifadesini kullanırken Tablo 6 p<0,001 verir. Ana sonuç tablosunda Tablo 6'nın açık değeri korunmuş, farklılık burada belirtilmiştir.
ANN yorum sınırı: ANN çıktıları LA ve CLI ölçek değerlerini tahmin etmektedir; gerçek IELTS okuma/dinleme puanını tahmin etmez. RMSE sonuçları min–max normalizasyonundan sonraki ölçeğe aittir.
MGA yorum sınırı: Dinleme ve okuma bağlamları için kısmi ölçüm değişmezliği kurulmuştur; tam değişmezlik bütün yapılarda sağlanmamıştır. İki anket formu görev bağlamına göre uyarlanmıştır.
Nedensellik sınırı: Çalışma kesitseldir. “Etki” ve “yol” ifadeleri PLS-SEM modelindeki istatistiksel ilişki dilidir; deneysel nedensellik anlamına gelmez.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir