


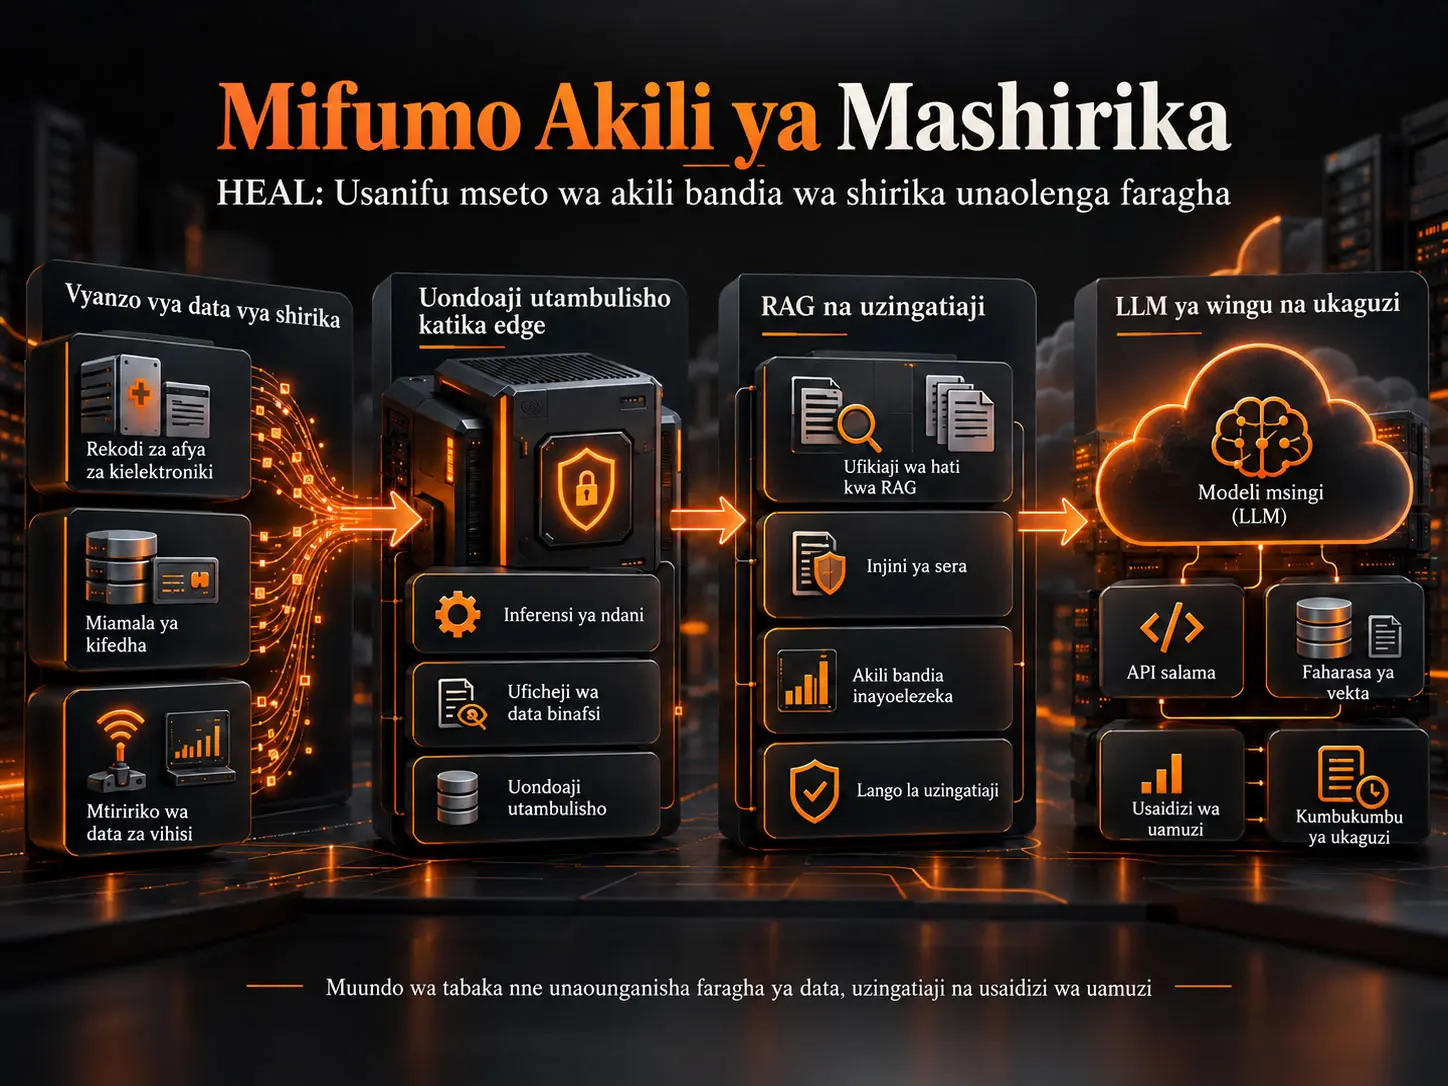
Hybrid Edge-Aware LLM (HEAL), ni mfumo uliopendekezwa wa akili bandia wa biashara unaounganisha katika usanifu mmoja mseto uondoaji utambulisho katika edge na, inapohitajika, inferensi ya ndani, federated learning, retrieval-augmented generation (RAG), ukaguzi wa uzingatiaji unaotegemea kanuni, explainable AI na inferensi ya LLM ya wingu, badala ya kutuma data nyeti ya shirika moja kwa moja kwa modeli kubwa ya lugha ya wingu. Utafiti wa Sakir Alim unalinganisha HEAL kwa uchanganuzi na usanifu mbadala minne: centralized cloud LLM, modeli ndogo ya lugha kwenye kifaa, federated fine-tuning na usanifu unaotumia RAG pekee. Chanzo kinaripoti kwa HEAL inference accuracy ya %91,6, wastani wa latency wa 148 ms na privacy score ya 0,94. Hata hivyo, tathmini hiyo haitokani na utekelezaji kamili wa HEAL katika kampuni, hospitali au taasisi ya fedha inayofanya kazi, bali na maswali 500 ya sintetiki ya usaidizi wa maamuzi yanayohusisha muktadha wa afya na fedha pamoja na baadhi ya thamani za utendaji zilizotokana kwa sehemu na usanifu.
Wazo kuu la muundo wa HEAL ni kutotuma maswali yote kwenye mkondo mmoja wa uchakataji. Kwanza, tabaka la edge lililo karibu na chanzo cha data huficha na kuondoa utambulisho wa taarifa zinazoweza kumtambulisha mtu. Maswali yenye ugumu mdogo yanaweza kutatuliwa kwa modeli nyepesi ya ndani iliyo quantized. Maswali yanayohitaji reasoning zaidi hupitishwa kwenye RAG yenye udhibiti wa ufikiaji, jurisdiction policy engine, explainability na compliance gate, kisha kutumwa kupitia API binafsi kwenda kwenye foundation model kubwa zaidi. Kwa njia hii, lengo ni kutumia uwezo mkubwa wa modeli ya wingu huku ikizuiwa data nyeti ghafi kuvuka moja kwa moja mpaka wa shirika.
Matokeo ya utafiti yanapendekeza kwamba HEAL hutoa uwiano wenye faida kati ya usanifu uliolinganishwa; hata hivyo, chanzo kina mipaka muhimu ya uthibitishaji. Hakijaeleza jinsi privacy score ilivyohesabiwa, jinsi maswali 500 ya sintetiki yalivyotengenezwa na kuwekewa lebo, utaratibu wa kina wa kutathmini kipimo cha accuracy, usanidi halisi wa LLM na edge model zilizotumiwa, wala hali za vifaa na mtandao. Aidha, kuna matatizo makubwa ya ulinganifu kati ya marejeo ndani ya makala na orodha ya marejeo, pamoja na kutokubaliana kwa kihesabu katika maelezo ya Jedwali II. Kwa hiyo, katika hatua hii HEAL inapaswa kusomwa zaidi kama pendekezo la usanifu mseto linalohitaji kupimwa kuliko kama utendaji wa mfumo wa uzalishaji uliothibitishwa.
Msuguano wa msingi katika akili bandia ya mashirika
Shirika linapotaka kupata uwezo wa juu zaidi wa reasoning kutoka kwa modeli kubwa ya lugha, njia rahisi zaidi ni kutuma data kwa modeli yenye nguvu ya wingu. Katika maeneo yanayodhibitiwa kisheria, hata hivyo, njia hii huibua moja kwa moja tatizo la governance. Rekodi za afya, miamala ya kifedha au taarifa nyingine nyeti za shirika zinapotumwa kwa watoa huduma wa nje, mahitaji ya eneo la kuhifadhi data, ulinzi wa taarifa binafsi, udhibiti wa ufikiaji na uwezo wa kukaguliwa huanza kutumika.
Upande mwingine ni kuendesha uchakataji wote ndani ya shirika au kwenye kifaa. Chaguo hili linaweza kuweka data ghafi ndani ya mazingira ya ndani; lakini katika mfumo wa tatizo uliowekwa na utafiti wa chanzo, modeli ndogo zinaweza zisiweze kutoa uwezo wa inferensi sawa na foundation model kubwa katika maswali changamano.
Badala ya kuona njia hizi mbili kama mbadala za kila mmoja, HEAL inapendekeza zitumike pamoja kulingana na aina ya swali. Taarifa nyeti hulindwa kwanza kwenye tabaka la edge; maswali rahisi hubaki ndani; na reasoning yenye nguvu zaidi inapohitajika, muktadha ulioondolewa utambulisho na kukaguliwa kwa kanuni huhamishwa kwenda wingu.
Usanifu wa HEAL Ni Nini?
Hybrid Edge-Aware LLM (HEAL) ni usanifu wa LLM mseto wenye tabaka nne unaochuja na kuondoa utambulisho wa data nyeti ya shirika kwenye edge; unaoweza kutatua maswali rahisi kwa modeli ya ndani; na unaoelekeza maswali changamano kwenye foundation model ya wingu baada ya kuyapitisha kupitia RAG, ukaguzi wa sera za udhibiti na tabaka la explainability.
Malengo manne ya muundo
Chanzo kinafafanua malengo manne ya wazi ya muundo wa HEAL:
- Taarifa zinazoweza kumtambulisha mtu zisivuke mpaka wa shirika bila kuondolewa utambulisho.
- Latency ya mwisho hadi mwisho ibaki chini ya 200 ms kwa usaidizi shirikishi wa maamuzi.
- Kila jibu liongezwe compliance attestation inayoweza kusomwa na mashine.
- Maelezo yaundwe ambayo mtaalamu wa eneo anaweza kukagua bila kufikia vigezo vya ndani vya modeli.
Haya ni malengo ya muundo wa usanifu kwanza, tofauti na matokeo yaliyoripotiwa. Hasa, lengo la 200 ms halipaswi kusomwa kama matokeo halisi ya Service Level Agreement ya mazingira ya uzalishaji, bali kama kigezo cha muundo wa HEAL.
Tabaka la kwanza: vyanzo vya data
Katika ingizo la HEAL kunaweza kuwa na aina tofauti za data za shirika. Chanzo kinatoa mifano mitatu: rekodi za afya za kielektroniki, rekodi za miamala ya kifedha na mikondo ya vihisi. Sifa yao ya pamoja ni kwamba zina thamani kwa usaidizi wa maamuzi ya kiutendaji, lakini zinaweza kuwa na taarifa binafsi, za shirika au zinazodhibitiwa.
Tabaka la pili: edge layer
Edge layer hufanya kazi karibu na mazingira ya shirika ambako data hutengenezwa au kuhifadhiwa. Chanzo kinatoa kazi mbili kuu kwa tabaka hili.
Kazi ya kwanza ni PII masking na anonymisation. Kwa kutumia pamoja ufichaji unaotegemea kanuni na classifier iliyofanyiwa fine-tune ndani ya mazingira ya ndani, lengo ni kulinda taarifa zinazoweza kumtambulisha mtu kabla ya inferensi ya mbali.
Kazi ya pili ni local inference. Maswali yenye ugumu mdogo yanaweza kutatuliwa moja kwa moja kwenye edge na modeli nyepesi iliyo quantized. Kwa swali kama hilo hakuna haja ya muunganisho wa wingu na network round-trip huondolewa.
Chanzo kinaripoti kwamba takriban %38 ya maswali katika seti ya tathmini yalitatuliwa kikamilifu kwenye edge. Hata hivyo, haijaonyeshwa kwamba uwiano huu unawakilisha mgawanyo wa maswali wa shirika halisi; thamani hiyo ni ya senario ya tathmini ya sintetiki.
Tabaka la tatu: orchestration
Maswali changamano zaidi hutumwa kwenye tabaka la orchestration la HEAL. Hili ndilo eneo kuu linalotofautisha mfumo na usanifu wa “kutuma prompt kwa LLM” pekee.
| Kipengele | Jukumu lake ndani ya HEAL |
|---|---|
| RAG Retriever | Hurejesha vipande vya nyaraka vinavyohusiana na swali kutoka kwenye msingi wa maarifa wenye udhibiti wa ufikiaji. |
| Policy Engine | Hulinganisha swali lililoondolewa utambulisho na kanuni zilizofafanuliwa kwa jurisdiction husika. |
| Compliance Gate | Hutoa uamuzi wa pass, rewrite au block kwa swali. |
| XAI Module | Huandaa muktadha wa maelezo ili uamuzi wa modeli uweze kuhusishwa na ushahidi. |
Compliance Gate Hufanyaje Kazi katika HEAL?
HEAL compliance gate hutathmini swali lililoondolewa utambulisho kwa mujibu wa kanuni zinazohifadhiwa kwa jurisdiction husika na kutoa mojawapo ya matokeo matatu: pass, rewrite au block. Uamuzi wa rewrite unalenga kuondoa au kubadilisha kategoria za data zinazodhibitiwa, huku uamuzi wa block ukilenga kusimamisha swali, kulirekodi kwa reason code na kulipeleka kwenye ukaguzi wa binadamu.
Kwa mujibu wa chanzo, compliance attestation inayoundwa pamoja na kila jibu ina toleo la rule set iliyotumiwa, decision code na thamani ya hash ya ingizo lililochakatwa. Kwa njia hii, lengo ni kufanya iwezekane kufuatilia si tu kile modeli ilichojibu, bali pia swali lilipitia ukaguzi gani wa compliance.
Kwa nini RAG ni sehemu ya usanifu?
Retrieval-Augmented Generation inalenga kuhakikisha kwamba jibu litakalotolewa halitegemei tu maarifa yaliyomo katika vigezo vya modeli, bali linaungwa mkono na ushahidi uliopatikana kutoka hazina ya nyaraka inayodhibitiwa. Katika muktadha wa HEAL, umuhimu wa ziada wa RAG ni explainability na auditability.
Context bundle inayotumwa kutoka tabaka la orchestration kwenda upande wa cloud hubeba pamoja swali lililoondolewa utambulisho, ushahidi uliorejeshwa na muhtasari wa compliance. Chanzo kinatarajia modeli ya wingu itoe katika jibu lililopangwa decision, confidence score na citation list inayounganisha kila dai na hati iliyorejeshwa.
Tabaka la nne: Cloud / LLM
Tabaka la wingu lina foundation model kubwa inayofikiwa kupitia private API deployment. Jukumu la tabaka la edge si kuondoa modeli kubwa, bali kuzuia ni data gani na chini ya masharti gani inaweza kuifikia.
Katika usanifu wa chanzo, upande wa cloud pia una vector index, audit ledger na decision API. Inapendekezwa kwamba jibu lililotolewa liandikwe kwenye immutable audit ledger kabla ya kurejeshwa kwenye programu. Muundo huu unalenga kuwezesha ukaguzi wa baadaye, hasa katika michakato ya maamuzi ya shirika yenye hatari kubwa.
Utaratibu wa federated update
HEAL si mkondo wa inference pekee. Chanzo kinaeleza kwamba edge node hushiriki katika raundi ya federated optimisation kila baada ya saa 24. Local gradient hupitia clipping kabla ya mkusanyiko wa kati na calibrated Gaussian noise huongezwa.
Chanzo kinaeleza kwamba utaratibu huu unatoa dhamana ya epsilon-delta differential privacy. Hata hivyo, \(\varepsilon\), \(\delta\), clipping norm, noise multiplier, idadi ya node, aggregation algorithm na convergence criteria zilizotumiwa hazijaripotiwa. Kwa hiyo, nguvu ya kiasi ya ulinzi wa differential privacy haiwezi kuhesabiwa upya kwa kujitegemea kutoka kwenye chanzo.
Kwa nini federated learning inatumika?
Jukumu la federated learning ndani ya HEAL ni kuwezesha edge classifier kujifunza kutokana na mgawanyo wa data wa ndani unaotokea katika mashirika huku ikizuia rekodi ghafi kuhamishwa kwenye hifadhi kuu ya mafunzo.
Njia hii inaweza kupunguza ucentrishaji wa data; hata hivyo, chanzo pia kinasisitiza katika sehemu yake ya mapitio ya maandiko kwamba mgawanyo wa data usiofanana unaweza kuleta communication overhead na matatizo ya convergence kwa federated optimisation. Bado haijajaribiwa ni kwa kiwango gani HEAL hutatua tatizo hili katika mazingira halisi ya mashirika mengi.
Maana ya kisayansi ya Kielelezo 1 cha chanzo
Kielelezo 1 katika ukurasa wa 3 wa utafiti wa chanzo kinafafanua maeneo manne tofauti ya uaminifu na uchakataji. Njia ya data husogea kutoka kushoto kwenda kulia:
- Data Sources: EHR, financial transaction na sensor stream.
- Edge Layer: local inference, PII masking, anonymisation na federated agent.
- Orchestration: RAG retriever, policy engine, XAI module na compliance gate.
- Cloud / LLM: foundation LLM, vector index, audit ledger na decision API.
Ujumbe wa kisayansi wa kielelezo ni kwamba data yote haitumwi moja kwa moja kwa foundation model. Ulinzi wa taarifa nyeti na ukaguzi wa kanuni umewekwa katika usanifu kabla ya model call.
Mbinu na Matokeo ya Utafiti
Muundo wa tathmini
HEAL imelinganishwa na baseline nne:
- Centralized Cloud LLM
- On-Device Small Language Model (SLM)
- Federated Fine-Tuning
- RAG-only Pipeline
Ulinganisho umefanywa katika vipimo vitano: latency, privacy preservation score, scalability, compliance efficiency na inference accuracy.
Kwa tathmini ya accuracy, inaelezwa kuwa maswali 500 yaliyopangwa kutoka kwenye senario ya sintetiki ya usaidizi wa maamuzi ya shirika inayohusisha muktadha wa huduma za afya na fedha yalitumika. Chanzo hakitoi mgawanyo wa kina wa maswali haya, lebo za madarasa, kazi yanazowakilisha au utaratibu wa kutengeneza ground-truth.
Sifa za ubora za usanifu
| Mfumo | Mbinu ya faragha | Usaidizi wa Edge | RAG / XAI | Uzingatiaji |
|---|---|---|---|---|
| Centralized Cloud LLM | Partial / TLS | Hakuna | Hakuna / Hakuna | Limited |
| On-Device SLM | Strong / local | Upo | Hakuna / Hakuna | Partial |
| Federated Fine-Tuning | Strong / FL | Partial | Hakuna / Partial | Partial |
| RAG-only | Moderate | Hakuna | Upo / Hakuna | Moderate |
| HEAL | Strong / FL + DP | Upo | Upo / Upo | Full |
Uainishaji huu wa ubora ni tathmini za muundo zilizotolewa katika chanzo. Kwa kuwa hakuna itifaki huru ya uthibitishaji iliyoripotiwa kwa ajili ya kutathmini kategoria za “Strong”, “Moderate”, “Partial” au “Full”, hazipaswi kufasiriwa kama vipimo vya kimwili vilivyopimwa.
Matokeo ya kiasi
| Mfumo | Latency (ms) | Privacy Score | Scalability | Compliance Efficiency | Inference Accuracy (%) |
|---|---|---|---|---|---|
| Centralized LLM | 420 | 0,51 | High | Low | 87,2 |
| On-Device SLM | 95 | 0,91 | Low | Partial | 79,4 |
| Federated FT | 310 | 0,83 | Moderate | Partial | 83,7 |
| RAG-only | 230 | 0,66 | Moderate | Moderate | 85,1 |
| HEAL | 148 | 0,94 | High | Full | 91,6 |
Ulinganisho na Centralized LLM
Centralized LLM baseline ina accuracy ya %87,2, thamani ya juu zaidi ya accuracy katika kundi la baseline. Wastani wa latency umeripotiwa kuwa 420 ms na privacy score kuwa 0,51.
Ikilinganishwa na HEAL, tofauti ya accuracy katika jedwali la chanzo ni 91,6 - 87,2 = pointi 4,4 za asilimia. Latency iliyoripotiwa ya HEAL pia ni ndogo kwa 272 ms. Hata hivyo, chanzo kinaeleza pia kwamba thamani hizi mbili za latency si benchmark zilizodhibitiwa zilizopimwa moja kwa moja end-to-end kwenye mfumo mmoja wa kimwili.
Ulinganisho na On-device SLM
On-device SLM ina latency ya chini zaidi katika jedwali, 95 ms, na privacy score ya 0,91; kwa upande mwingine inference accuracy yake ni %79,4.
Ulinganisho huu unaonyesha chaguo la msingi la muundo wa HEAL: HEAL hailengi latency ya chini kama modeli ya ndani kabisa; badala yake inajaribu kupata accuracy zaidi kwa kutumia uwezo wa cloud model kubwa huku ikitoa ulinzi wa edge kwa data nyeti.
Ulinganisho na Federated fine-tuning
Kwa federated fine-tuning baseline, accuracy ya %83,7, latency ya 310 ms na privacy score ya 0,83 zimeripotiwa. Inaonekana HEAL haitumii federated learning kama suluhisho la pekee, bali pamoja na RAG, edge filtering na compliance gating.
Ulinganisho na RAG-only
Mfumo wa RAG-only unatoa %85,1 inference accuracy, 230 ms latency na 0,66 privacy score. Kwa mujibu wa tafsiri ya chanzo, kwa kuwa hakuna edge enforcement, token nyeti zinaweza kujitokeza katika retrieval query, na hakuna compliance gate maalum ya kusimamisha swali lisilofaa kabla ya model call.
Tofauti ya accuracy kati ya HEAL na RAG-only iliyohesabiwa kutoka jedwali la chanzo ni pointi 6,5 za asilimia. Thamani ya pointi 8,4 za asilimia iliyoandikwa katika matini ya chanzo haiendani na jedwali hili.
Je, Matokeo ya HEAL Yanathibitisha Utendaji wa Uzalishaji katika Ulimwengu Halisi?
Hapana. Chanzo kinaeleza wazi kwamba tathmini si deployment kamili ya HEAL katika hospitali, benki au biashara nyingine halisi; maswali 500 ya sintetiki yalitumika, na hasa thamani za latency zilitokana si na instrumentation kamili ya mfumo bali na uchanganuzi wa usanifu na vipimo kutoka mifumo inayofanana iliyokuwa imepelekwa. Kwa hiyo, %91,6 accuracy, 148 ms latency na 0,94 privacy score zilizoripotiwa si dhamana za utendaji zilizothibitishwa katika mazingira ya uzalishaji.
Thamani ya 148 ms inapaswa kufasiriwaje?
Chanzo kinaripoti wastani wa edge-to-response latency wa 148 ms na kinaeleza kwamba takriban %38 ya maswali yalitatuliwa kwenye edge bila kwenda kwenye cloud. Muundo huu unaunga mkono utaratibu ambao maswali yasiyohitaji cloud round-trip yanaweza kupunguza latency ya jumla.
Hata hivyo, katika aya hiyo hiyo chanzo kinakubali kwamba thamani za latency hazikupimwa kwa end-to-end instrumentation halisi katika mkondo mzima wa HEAL. Kwa hiyo, 148 ms haipaswi kutumiwa kama kipimo halisi cha SLA ya uzalishaji.
Privacy score inaweza kurudiwa kwa kiwango gani?
Kwa HEAL privacy score ni 0,94, kwa on-device SLM ni 0,91, kwa federated fine-tuning ni 0,83, kwa RAG-only ni 0,66 na kwa centralized LLM ni 0,51.
Chanzo hakielezi ufafanuzi wa kihisabati wa privacy score, vipengele vyake, uzito wake au utaratibu wa majaribio. Kwa hiyo, mpangilio wa namba unaweza kuripotiwa kama matokeo ya chanzo; lakini hakuna maelezo ya kutosha ya mbinu ili mtafiti huru aweze kuzalisha privacy score zilezile kutoka kwa ingizo zilezile.
Inference accuracy inapaswa kufasiriwaje?
Chanzo kinaripoti %91,6 inference accuracy kwa HEAL. Hata hivyo, aina za kazi za maswali 500 ya sintetiki, uundaji wa majibu ya gold-standard, kigezo cha tathmini, exact-match au scoring method nyingine, watathmini na confidence interval hazijaelezwa.
Upungufu huu hauondoi hadhi ya %91,6 kama matokeo yaliyoripotiwa na chanzo; lakini unapunguza uwezekano wa kulirudia kwa kujitegemea na kulijumlisha kwa mifumo mingine.
Kikomo cha tathmini ya Compliance
HEAL ndiyo mfumo pekee katika jedwali uliopata kategoria ya “Full” compliance efficiency. Tofauti hii inatokana na kuwekwa kwa explicit policy engine na compliance gate ndani ya usanifu.
Hata hivyo, utafiti hauripoti formal compliance audit dhidi ya seti maalum ya vifungu vya GDPR, HIPAA au kanuni za kifedha. “Full” ni uainishaji wa usanifu wa chanzo; haimaanishi uthibitisho wa kisheria au idhini ya mamlaka ya udhibiti.
Kutokubaliana kwa kihesabu ndani ya chanzo
Jedwali II linaonyesha accuracy ya HEAL kuwa %91,6 na accuracy ya RAG-only kuwa %85,1. Tofauti kati ya thamani hizi mbili ni pointi 6,5 za asilimia. Hata hivyo, matini ya chanzo inaandika tofauti hiyo kuwa pointi 8,4 za asilimia.
Zaidi ya hayo, RAG-only baseline imeonyeshwa kwa usemi “best baseline”; ilhali baseline accuracy ya juu zaidi katika jedwali ni %87,2 kwa centralized LLM. Tofauti kati ya HEAL na baseline hii ni pointi 4,4 za asilimia. Kwa hiyo, simulizi la Verianla linahifadhi thamani ghafi zilizoonyeshwa wazi katika jedwali kama source-of-truth.
Kutolingana kwa orodha ya marejeo na nukuu ndani ya matini
Baadhi ya majina ya marejeo katika sehemu ya fasihi ya utafiti hayalingani na orodha ya marejeo yenye namba. Matini inaonyesha Brown et al. kama [1], Hard et al. kama [2], Lewis et al. kama [3], Chowdhery et al. kama [4] na Wornow et al. kama [5], wakati namba hizohizo katika orodha ya marejeo ya PDF zinahusu waandishi na kazi tofauti.
Hali hii inafanya iwe vigumu kufuatilia kwa kujitegemea msingi wa fasihi. Kwa hiyo, makala ya Verianla haisahihishi kwa hiari marejeo yasiyopo kwenye orodha ya marejeo wala kuyabadilisha na kazi nyingine; inaweka kutolingana huku wazi kama kikomo cha ubora wa chanzo.
Matokeo yanayoungwa mkono na utafiti
- HEAL ni muundo wa mfumo uliofafanuliwa wazi unaounganisha edge anonymisation, inferensi ya ndani, federated learning, RAG, XAI, compliance gating na cloud LLM katika usanifu mmoja.
- Katika tathmini ya sintetiki ya chanzo, HEAL imeripotiwa kuwa na %91,6 accuracy, 148 ms latency na 0,94 privacy score.
- Thamani ya accuracy iliyoripotiwa ya HEAL ni kubwa kuliko thamani zote nne za baseline katika jedwali.
- On-device SLM imeripotiwa kutoa latency ya chini kuliko HEAL lakini accuracy ya chini.
- Inaripotiwa kwamba takriban %38 ya maswali ya sintetiki yalikamilishwa kwenye edge.
- Kwa kuwa compliance gate imewekwa kabla ya inference katika usanifu, HEAL inatofautishwa na baseline nyingine katika tathmini ya chanzo kama mfumo wa compliance-aware.
Matokeo ambayo utafiti hauungi mkono
- Haijathibitishwa kwamba HEAL itatoa %91,6 accuracy katika hospitali, benki au shirika jingine linalodhibitiwa katika ulimwengu halisi.
- Thamani ya 148 ms si latency iliyohakikishwa iliyopimwa end-to-end katika mazingira halisi ya uzalishaji.
- Haijaonyeshwa kwamba 0,94 privacy score ni kipimo cha faragha cha ulimwengu wote au kilichosanifishwa.
- Usemi “Full compliance” si uthibitisho wa kisheria, cheti cha utiifu wa GDPR/HIPAA au idhini ya mamlaka ya udhibiti.
- Mafanikio ya convergence ya federated learning katika heterogeneity ya data halisi ya mashirika mengi hayajajaribiwa.
- Chanzo hakiripoti uthibitishaji wa mfumo kwa data halisi za wagonjwa au wateja halisi wa kifedha.
- Haijaonyeshwa kwamba HEAL ni bora kwa kiwango chenye umuhimu wa kitakwimu kuliko mifumo ya baseline; confidence interval, variance au significance test hazijaripotiwa.
Utafiti wa baadaye
Chanzo kinatoa mielekeo mitatu mikuu ya utafiti wa baadaye. Ya kwanza ni kuanzisha pilot hai ndani ya mtandao mshirika wa hospitali ili kupima tabia ya convergence ya utaratibu wa federated update chini ya heterogeneity ya data za kliniki za vituo vingi.
Mwelekeo wa pili unalenga tatizo la kuandaa compliance rule set kwa mikono. Chanzo kinapendekeza kutafiti baadaye uundaji wa kiotomatiki wa kanuni kutoka kwenye matini za udhibiti.
Mwelekeo wa tatu ni tabaka la XAI. Katika muundo wa sasa wa HEAL, maelezo yanahusishwa na citation na retrieved evidence; utafiti unapendekeza kwamba katika siku zijazo msaada wa counterfactual reasoning unaweza kuwa muhimu katika maamuzi ya hatari kubwa katika fedha na afya.
Maelezo ya Chanzo na Mbinu
Kichwa kamili cha asili: Intelligent Enterprise Systems: Integrating Artificial Intelligence, Data Analytics, and Information Management for Strategic Decision Making.
Mwandishi: Sakir Alim.
Ushirika wa PDF: Department of Information Systems, University of Lagos, Lagos, Nigeria.
Jukwaa: SSRN.
Namba ya SSRN abstract: 6894938.
DOI: 10.2139/ssrn.6894938.
Date Written: 11 Machi 2025.
Tarehe ya kuwasilisha/kuchapishwa kwenye SSRN: 29 Juni 2026.
Aina ya chanzo: Utafiti wa SSRN wenye hadhi ya Preprint / working paper.
Hali ya peer review: Katika uthibitishaji wa sasa, toleo la jarida lililopitiwa na wenzao halikupatikana; utafiti haupaswi kuwasilishwa kama makala iliyopitiwa na wenzao.
Hali ya leseni/haki: Rekodi ya SSRN inaeleza “All rights reserved” na sharti la kutotumia tena bila ruhusa. Kwa hiyo, kielelezo cha chanzo, muundo asili wa jedwali na matini iliyolindwa havikutumiwa tena.
Sehemu ya mawasiliano ndani ya PDF: Katika PDF, chini ya jina Sakir Alim kuna anwani ya barua pepe “o.adeyemi@unilag.edu.ng”. Kwa kuwa sehemu hii hailingani wazi na jina la mwandishi na uthibitishaji wa wazi wa barua pepe haukuweza kufanywa kwenye ukurasa wa SSRN, anwani hiyo haikukubaliwa kama taarifa iliyothibitishwa ya corresponding-author.
Modeli kuu: Hybrid Edge-Aware LLM (HEAL).
Tabaka za usanifu: Data Sources; Edge Layer; Orchestration; Cloud / LLM.
Mbinu kuu: PII masking, anonymisation, local quantised inference, federated optimisation, differential privacy, RAG, jurisdiction policy engine, compliance gate, XAI, private cloud foundation LLM na immutable audit ledger.
Marudio ya Federated update: Chanzo kinaeleza raundi moja kila baada ya saa 24 kwa kila edge node.
Sampuli ya tathmini: Maswali 500 ya sintetiki yaliyopangwa yanayohusisha senario za huduma za afya na fedha.
Baseline zilizolinganishwa: Centralized Cloud LLM, On-Device SLM, Federated Fine-Tuning na RAG-only Pipeline.
Vipimo vya tathmini: Inference latency, privacy preservation score, scalability, compliance efficiency na inference accuracy.
Matokeo yaliyoripotiwa kwa HEAL: 148 ms latency, 0,94 privacy score, High scalability, Full compliance efficiency na %91,6 inference accuracy.
Tatizo muhimu la kihesabu: Katika matini ya chanzo, tofauti ya accuracy kati ya HEAL na RAG-only imeandikwa kuwa pointi 8,4 za asilimia; thamani za Jedwali II zinaonyesha kwamba tofauti ni pointi 6,5 za asilimia. Baseline accuracy ya juu zaidi katika jedwali ni %87,2 kwa centralized LLM, na tofauti yake na HEAL ni pointi 4,4 za asilimia.
Tatizo muhimu la marejeo: Namba za marejeo ya Brown, Hard, Lewis, Chowdhery na Wornow katika sehemu ya fasihi hazilingani na rekodi za marejeo zenye namba mwishoni mwa PDF. Kwa hiyo, orodha ya marejeo inapaswa kushughulikiwa kwa tahadhari katika uthibitishaji wa fasihi.
Maelezo muhimu ambayo hayajaripotiwa kwa upande wa reproducibility: Utaratibu wa kutengeneza maswali ya sintetiki, mgawanyo wa madarasa ya maswali, njia ya kutengeneza gold-standard, accuracy scoring method, formula ya privacy score, compliance scoring protocol, jina na toleo la foundation model halisi, jina la edge model, quantisation method, hardware, network topology, maelezo ya vector database, embedding model, RAG retrieval parameters, federated aggregation algorithm, idadi ya node, learning rate, convergence criteria, thamani za differential privacy \(\varepsilon\) na \(\delta\), clipping norm na noise multiplier.
Kutokuwa na uhakika wa kitakwimu: Chanzo hakiripoti p-value, confidence interval, standard deviation au kipimo kingine cha kutokuwa na uhakika.
Uthibitishaji wa uwanjani: Hakuna. Chanzo kinaeleza kwamba pilot hai kwenye mtandao wa hospitali imepangwa kwa siku zijazo.
Ufadhili: Hakuna taarifa ya ufadhili iliyoripotiwa katika PDF.
Mgongano wa maslahi: Hakuna taarifa tofauti ya mgongano wa maslahi iliyoripotiwa katika PDF.
Upatikanaji wa data: Hakuna taarifa tofauti ya upatikanaji wa dataset au seti ya maswali ya sintetiki iliyoripotiwa katika PDF.
CRediT / michango ya mwandishi: Hakuna taarifa ya michango ya CRediT iliyoripotiwa katika PDF.
Jukumu la Kielelezo 1: Kinaonyesha mtiririko wa data wa HEAL wenye tabaka nne katika chanzo. Kwa matumizi ya Verianla, mpangilio huohuo wa picha haupaswi kunakiliwa; ni mahusiano ya chanzo cha data → edge privacy/local inference → RAG/policy/XAI/compliance → cloud LLM/audit pekee yanayopaswa kuchorwa upya kwa usanifu mpya wa kisemantiki.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *