


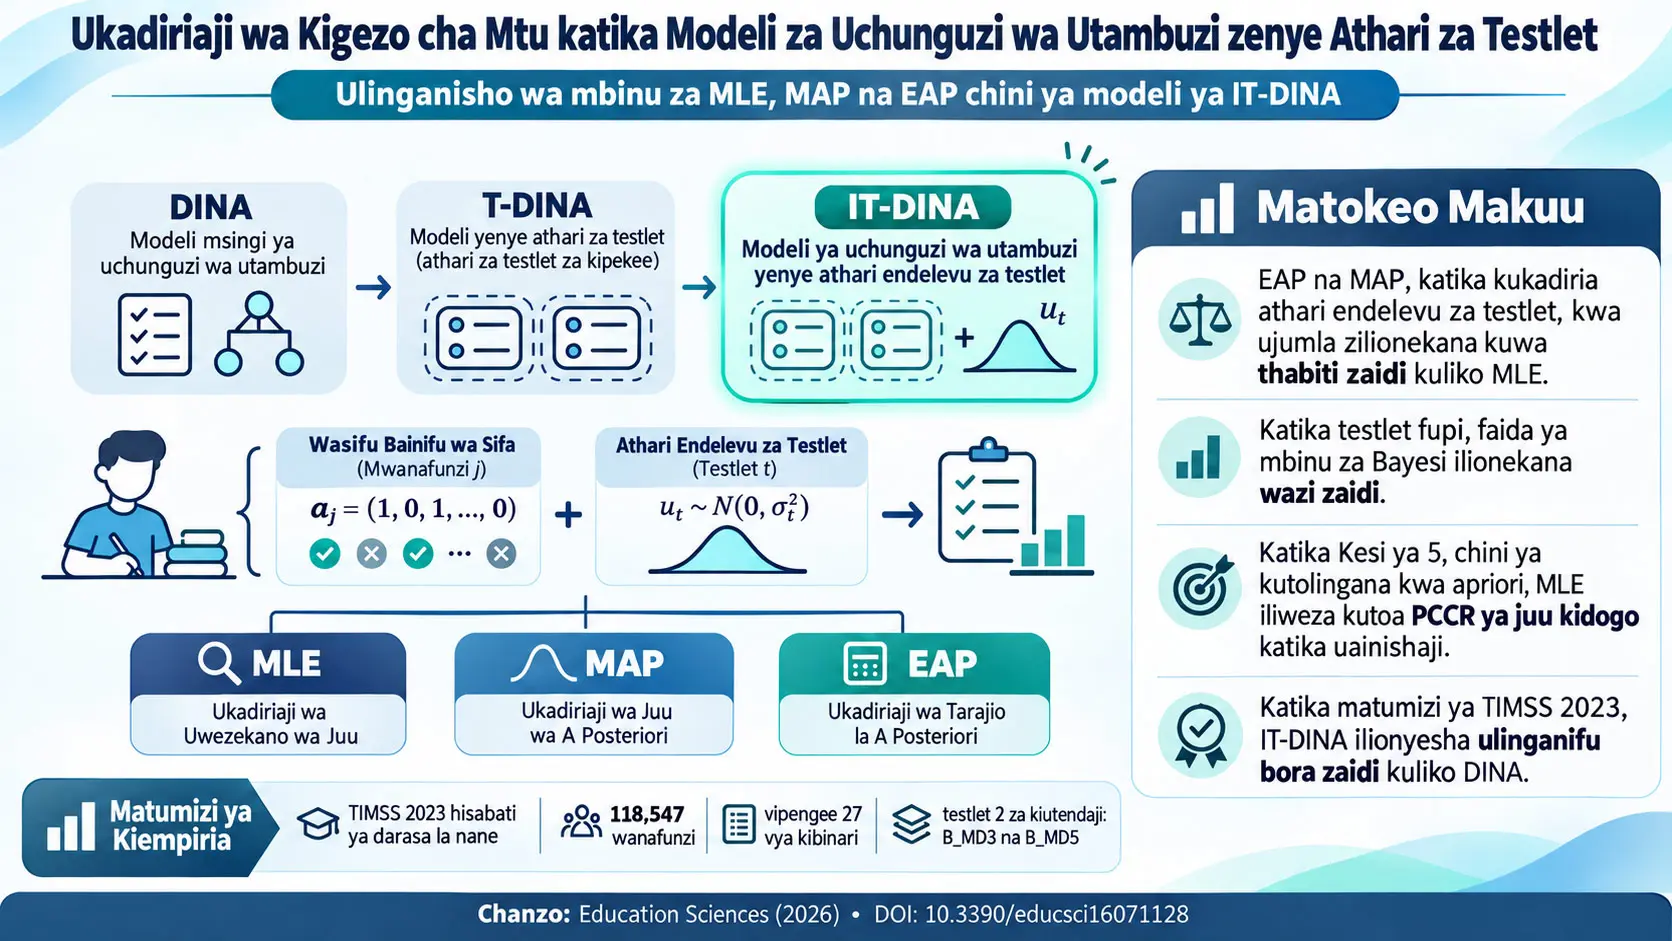
Modeli Shirikishi ya Testlet DINA (Interactive Testlet DINA, IT-DINA) ni modeli ya uchunguzi wa utambuzi inayowakilisha kwa pamoja wasifu bainifu wa sifa unaoonyesha ni sifa zipi za utambuzi mwanafunzi anazo na athari endelevu za testlet katika kiwango cha mtu ambazo zinaweza kutokea kutokana na muktadha wa pamoja wa vipengee vilivyo ndani ya testlet hiyo hiyo. Utafiti huu unachunguza jinsi vigezo vya mtu vinavyokadiriwa katika muundo fiche wa aina hii unaochanganya sehemu bainifu na endelevu, na unalinganisha mbinu za ukadiriaji wa uwezekano wa juu kabisa (Maximum Likelihood Estimation, MLE), ukadiriaji wa upeo wa aposteriori (Maximum A Posteriori, MAP) na ukadiriaji wa thamani tarajiwa ya aposteriori (Expected A Posteriori, EAP).
Sehemu ya kwanza ya utafiti inategemea uigaji. Ukubwa wa sampuli uliwekwa kuwa 10.000 katika kila hali; testlet tatu au nne, vipengee 10, 20, 30, 40 au 50 kwa kila testlet, na hali tofauti za usahihi wa ubainishaji wa modeli zilichunguzwa. Matukio matano ya uigaji yanajumuisha modeli ya IT-DINA iliyobainishwa kwa usahihi, matumizi ya IT-DINA ingawa hakuna athari halisi ya testlet, matumizi ya IT-DINA iliyo changamano zaidi wakati kuna athari kuu ya testlet pekee, ukadiriaji wa data halisi ya IT-DINA kwa modeli rahisi zaidi ya T-DINA, na hali ngumu zaidi yenye idadi kubwa zaidi ya sifa na usambazaji halisi wa sifa usio sare.
Katika uigaji, EAP na MAP zilitoa matokeo thabiti zaidi kuliko MLE katika urejeshaji wa athari endelevu za testlet, hasa katika testlet fupi na katika hali ambazo muundo wa modeli ulikuwa changamano kupita kiasi au haukubainishwa kikamilifu. Katika hali ya msingi ya IT-DINA iliyobainishwa kwa usahihi, mkengeuko wa kimfumo wa athari za testlet kwa EAP na MAP kwa thamani kamili mara nyingi ulibaki chini ya 0,005, ilhali katika testlet fupi zenye vipengee 10 baadhi ya mikengeuko ya MLE ilifikia takriban 0,02–0,04. Katika hali hiyo hiyo, kadiri urefu wa testlet ulivyoongezeka, RMSE ya mbinu za Bayes ilipungua kutoka takriban 0,35 hadi 0,20, huku MLE ikionyesha RMSE ya takriban 0,55–0,65 katika testlet fupi.
Hata hivyo, utafiti hauungi mkono hitimisho kwamba “mbinu za Bayes ni bora katika kila hali”. Katika hali ya tano ya uigaji, wasifu halisi wa sifa ulitolewa kutoka katika usambazaji usio sare, lakini katika hesabu za MAP na EAP usambazaji wa awali wa wasifu wa sifa uliendelea kuchukuliwa kuwa sare. Chini ya kutolingana huku kwa usambazaji wa awali, ingawa mbinu za Bayes zilibaki thabiti zaidi katika ukadiriaji wa athari endelevu za testlet, kwa kipimo cha PCCR kinachohitaji wasifu mzima wa sifa uainishwe kwa usahihi kwa wakati mmoja, MLE ilitoa matokeo ya takriban %90–93, huku MAP na EAP zikiwa katika takriban %87–91. Ugunduzi huu unaonyesha kwamba uchaguzi wa usambazaji wa awali ni muhimu kisayansi kwa lengo la uainishaji.
Sehemu ya pili ya utafiti ni onyesho la kimajaribio lililofanywa kwa data ya hisabati ya darasa la nane ya TIMSS 2023. Kutoka kwa wanafunzi 308.492 wa awali na vipengee 68 vya hisabati vilivyokuwa wagombea, baada ya usafishaji wa data wanafunzi 118.547 na vipengee 27 vya jozi vilichanganuliwa. Bloku B_MD3 na B_MD5 zilitumika kama testlet mbili za kiutendaji. Katika data hii, IT-DINA ilitoa thamani za AIC na BIC zilizo chini kuliko modeli ya jadi ya DINA na modeli hizo mbili ziliwagawanya wanafunzi katika wasifu wa sifa za utambuzi kwa namna iliyo tofauti wazi. Hata hivyo, matumizi haya ya TIMSS si ushahidi wa matokeo wakilishi katika kiwango cha idadi ya watu, bali ni mfano wa kimajaribio unaoonyesha tabia ya modeli katika data halisi ya tathmini.
Modeli ya uchunguzi wa utambuzi inajaribu kutatua nini?
Modeli nyingi za jadi za upimaji hujaribu kufupisha utendaji wa mwanafunzi kwa alama moja endelevu ya uwezo. Modeli za uchunguzi wa utambuzi (Cognitive-Diagnostic Models, CDMs) huuliza swali tofauti: Ni vipengele gani maalumu vya maarifa au ujuzi mwanafunzi anavyo, na ni vipi hana? Kwa hiyo, kigezo fiche cha modeli si lazima kiwe alama moja; kinaweza kuwa wasifu unaoundwa na sifa kadhaa za utambuzi za jozi.
Kwa mfano, ikiwa kuna sifa tatu za utambuzi, wasifu wa mwanafunzi unaweza kuwa \((1,0,1)\). Hapa 1 inaonyesha kwamba sifa husika imepatikana, na 0 inaonyesha kwamba haijapatikana. Ikiwa kuna sifa tatu za jozi, kuna jumla ya \(2^3=8\) wasifu unaowezekana; ikiwa kuna sifa tano, kuna \(2^5=32\) wasifu unaowezekana. Kwa hiyo, kadiri idadi ya sifa inavyoongezeka, tatizo la kubainisha mwanafunzi yuko katika darasa gani fiche pia huongezeka.
Athari ya Testlet na Utegemezi wa Ndani wa Vipengee ni Nini?
Athari ya testlet ni athari fiche ya ziada inayowakilisha uwezekano kwamba vipengee vinavyowasilishwa ndani ya maandishi, jedwali, tukio, bloku ya maswali au muktadha mwingine wa pamoja vinaweza kuonyesha tabia za majibu zinazohusiana hata baada ya sifa za utambuzi zinazolengwa kupimwa kuzingatiwa. Katika modeli za kawaida, sifa za utambuzi za mwanafunzi zikijulikana, vipengee vinatarajiwa kuwa huru kutoka kimoja hadi kingine; ikiwa hali hii haitimizwi, kuna utegemezi wa ndani wa vipengee (local item dependence, LID).
Tofauti hii ni muhimu. Katika maswali matano yanayotumia maandishi yale yale, mwanafunzi kuyachakata maandishi hayo vizuri au vibaya kwa kiwango kisicho cha kawaida kunaweza kuathiri majibu yote matano kwa pamoja. Ikiwa athari hiyo ya pamoja itaelekezwa tu kwenye ujuzi unaolengwa kupimwa, modeli inaweza kuonyesha uhakika wa upimaji kuwa mkubwa kuliko ulivyo au inaweza kumweka mwanafunzi katika wasifu usio sahihi wa sifa. Modeli za testlet hujaribu kuwakilisha kando ushirikiano huu uliobaki.
Uwakilishaji wa msingi: mwanafunzi, kipengee, testlet na sifa
| Alama | Maana | Aina |
|---|---|---|
| \(N\) | Idadi ya wanafunzi / watu wanaofanya mtihani | Hesabu |
| \(S\) | Idadi ya testlet | Hesabu |
| \(J_s\) | Idadi ya vipengee katika testlet \(s\) | Hesabu |
| \(J=\sum_{s=1}^{S}J_s\) | Jumla ya idadi ya vipengee | Hesabu |
| \(K\) | Idadi ya sifa za utambuzi za jozi | Hesabu |
| \(\boldsymbol{\alpha}_i\) | Wasifu wa sifa wa mwanafunzi \(i\) | Vekta ya jozi yenye vipimo \(K\) |
| \(\alpha_{ik}\) | Mwanafunzi \(i\) akiwa na sifa \(k\), 1; akiwa hana, 0 | Jozi |
| \(q_{jk}\) | Ikiwa kipengee \(j\) kinahitaji sifa \(k\), 1 | Kipengele cha matriksi ya Q |
| \(\eta_{ij}\) | Kiashiria cha jibu bora kinachoonyesha kama mwanafunzi \(i\) ana sifa zote zinazohitajika kwa kipengee \(j\) | Jozi |
| \(Y_{ij}\) | Jibu lililoonekana; likiwa sahihi 1, likiwa si sahihi 0 | Jozi |
| \(\boldsymbol{\xi}_i\) | Vigezo endelevu vya athari ya testlet vya mwanafunzi | Vekta fiche endelevu |
Matriksi ya Q hufanya nini?
Matriksi ya Q ni matriksi ya jozi yenye vipimo \(J\times K\) inayoonyesha ni kipengee gani kinachohitaji sifa gani ya utambuzi. Ikiwa \(q_{jk}=1\), ili kutatua kwa usahihi kipengee \(j\), sifa \(k\) inahitajika; ikiwa \(q_{jk}=0\), sifa hiyo haichukuliwi kuwa ya lazima kwa kipengee.
Kigezo kinachoonyesha kama mwanafunzi ana sifa zote zinazohitajika kwa ukamilifu kwa kipengee kinafafanuliwa katika chanzo kwa muundo unganishi ufuatao:
\[ \eta_{ij}=\prod_{k=1}^{K}(\alpha_{ik})^{q_{jk}} \]
Mantiki ya zao hili ni lango la “NA”. Ikiwa kipengee kinahitaji sifa mbili na mwanafunzi hana mojawapo, kizidishi husika huwa 0 na zao lote hutoa \(\eta_{ij}=0\). Mwanafunzi akiwa na sifa zote zinazohitajika, \(\eta_{ij}=1\).
Modeli ya DINA: sehemu ya msingi ya kuanzia
DINA (Deterministic Inputs, Noisy “AND” Gate) huchukulia kuwa kuwa na sifa zote zinazohitajika ni sharti unganishi la mafanikio. Hata hivyo, tabia halisi ya mtihani si ya kudeterminishwa kabisa: mwanafunzi mwenye sifa zote zinazohitajika anaweza kufanya kosa; mwanafunzi asiye na sifa zote zinazohitajika pia anaweza kujibu kwa usahihi kwa kubahatisha.
Mlinganyo (1) wa chanzo:
\[ P(Y_{ij}=1\mid\boldsymbol{\alpha}_i) =(1-s_j)^{\eta_{ij}}g_j^{\,1-\eta_{ij}} \tag{1} \]
\(s_j\) ni uwezekano wa slipping / kosa la kuteleza kwa kipengee \(j\). Unawakilisha uwezekano wa mwanafunzi kujibu vibaya ingawa ana sifa zote zinazohitajika. Kwa hiyo, wakati \(\eta_{ij}=1\), uwezekano wa jibu sahihi ni \(1-s_j\).
\(g_j\) ni uwezekano wa guessing / kubahatisha. Unawakilisha uwezekano wa mwanafunzi kujibu kwa usahihi akiwa hana sifa zote zinazohitajika. Wakati \(\eta_{ij}=0\), Mlinganyo (1) hupunguzwa moja kwa moja kuwa \(g_j\).
Muundo wa vipeo wa mlinganyo unaunganisha hali mbili katika fomula moja. Ikiwa \(\eta_{ij}=1\), basi \(g_j^{0}=1\) na kinachobaki ni \(1-s_j\). Ikiwa \(\eta_{ij}=0\), basi \((1-s_j)^0=1\) na kinachobaki ni \(g_j\). Kwa hiyo, lengo la fomula si ufupi wa kialjebra pekee, bali ni kueleza hali mbili fiche za DINA ndani ya fungsi moja ya jibu.
Kwa vekta nzima ya majibu ya mwanafunzi \(\mathbf{y}_i=(y_{i1},\ldots,y_{iJ})\), ikiwa inachukuliwa kwamba vipengee ni huru kwa masharti mara wasifu wa sifa unapojulikana, chanzo kinafafanua likelihood katika Mlinganyo (2) kama ifuatavyo:
\[ L(\mathbf{y}_i\mid\boldsymbol{\alpha}_i) =\prod_{j=1}^{J}P(Y_{ij}=y_{ij}\mid\boldsymbol{\alpha}_i) \tag{2} \]
Hapa, zao huhesabu jinsi majibu yote ya vipengee yaliyoonekana kwa mwanafunzi yanavyowezekana kwa pamoja. Dhana muhimu ya DINA ya kawaida iko hapa: \(\boldsymbol{\alpha}_i\) ikijulikana, inachukuliwa kwamba hakuna utegemezi mwingine wa kimfumo unaobaki kati ya vipengee. Tatizo la testlet linahusu hasa hali ambapo dhana hii inaweza kukiukwa.
T-DINA: athari ya ziada ya nasibu kwa testlet
Testlet Effect DINA (T-DINA) huongeza kwa mwanafunzi \(i\) na testlet \(s\) athari ya nasibu endelevu iliyo mahususi ya \(\xi_{is}\), ili kuwakilisha ushirikiano kati ya vipengee vya testlet moja ambao haujaelezwa na wasifu wa sifa.
Mlinganyo (3) wa chanzo:
\[ P(Y_{ij}=1\mid\boldsymbol{\alpha}_i,\xi_{is}) =h\!\left(\delta_{0j}+\delta_{1j}\eta_{ij}+\beta_{js}\xi_{is}\right) \tag{3} \]
\(h(\cdot)\) ni fungsi ya kiunganishi; chanzo kinaeleza kwamba kiunganishi cha logistic au probit kinaweza kutumika. \(\delta_{0j}\) ni kigezo cha mkato mahususi kwa kipengee, \(\delta_{1j}\) huonyesha athari ya hali bora ya jibu kwenye kipengee, na \(\beta_{js}\) huonyesha ukubwa wa mzigo wa athari ya testlet kwenye kipengee \(j\).
Ikiwa \(\xi_{is}\) iko karibu na sifuri, athari ya ziada ya testlet iliyo mahususi kwa mwanafunzi ni dhaifu. Kadiri thamani yake kamili inavyoongezeka, sehemu ya pamoja ya testlet hubadilisha zaidi kitabiri mstari; hata hivyo, uwezekano wa mwisho wa jibu sahihi si wa mstari moja kwa moja, bali hupitishwa katika fungi ya kiunganishi \(h(\cdot)\).
IT-DINA: athari ya testlet inaweza kuingiliana na hali ya sifa
Katika T-DINA, athari ya testlet huongezwa bila kutegemea hali bora ya jibu ya mwanafunzi. IT-DINA huruhusu athari hii kubadilika kulingana na \(\eta_{ij}\).
Mlinganyo (4) wa chanzo:
\[ P(Y_{ij}=1\mid\boldsymbol{\alpha}_i,\boldsymbol{\xi}_{is}) =h\!\left[ \delta_{0j} +\delta_{1j}\eta_{ij} +\beta_{js}\xi_{is1} +\gamma_{js}(2\eta_{ij}-1)\xi_{is2} \right] \tag{4} \]
Hapa \(\boldsymbol{\xi}_{is}=(\xi_{is1},\xi_{is2})^\prime\) ni vekta ya athari ya testlet yenye sehemu mbili. \(\beta_{js}\xi_{is1}\) inawakilisha athari kuu ya testlet, na \(\gamma_{js}(2\eta_{ij}-1)\xi_{is2}\) inawakilisha sehemu ya mwingiliano inayotegemea hali ya sifa.
Kipengele \((2\eta_{ij}-1)\) kina jukumu maalumu. Wakati \(\eta_{ij}=1\), kipengele hiki huwa \(+1\), na wakati \(\eta_{ij}=0\), huwa \(-1\). Hivyo, mwelekeo wa mchango wa \(\xi_{is2}\) kwenye kitabiri mstari unaweza kubadilika kulingana na hali bora ya jibu. Muundo huu huingiza katika modeli uwezekano kwamba utegemezi wa testlet si lazima utende kwa namna ile ile kwa wale walio na sifa zinazohitajika na wale wasio nazo.
| Modeli | Wasifu wa sifa | Athari kuu ya testlet | Mwingiliano wa sifa × testlet |
|---|---|---|---|
| DINA | Ipo | Haipo | Haipo |
| T-DINA | Ipo | Ipo: \(\beta_{js}\xi_{is}\) | Haipo |
| IT-DINA | Ipo | Ipo: \(\beta_{js}\xi_{is1}\) | Ipo: \(\gamma_{js}(2\eta_{ij}-1)\xi_{is2}\) |
Kwa nini kigezo cha mtu ni muundo mchanganyiko?
Katika utafiti, vigezo vyote vya mtu vya mwanafunzi mmoja hufikiriwa kuwa
\[ \boldsymbol{\lambda}_i=(\boldsymbol{\alpha}_i,\boldsymbol{\xi}_i) \]
. \(\boldsymbol{\alpha}_i\) ni wasifu bainifu wa sifa; kwa mfano \((1,0,1)\). \(\boldsymbol{\xi}_i\) huundwa na athari endelevu za testlet. Kwa hiyo, algoriti inapaswa kutatua kwa wakati mmoja maswali mawili: “mwanafunzi yuko katika darasa gani fiche?” na “thamani ya athari endelevu ya testlet kwa mwanafunzi huyu ni ipi?”. Hili ndilo changamoto kuu ya kihisabati inayofanya ulinganisho wa MLE, MAP na EAP katika utafiti kuwa muhimu.
MLE, MAP na EAP Zinatofautianaje Katika Utafiti Huu?
MLE huchagua vigezo vya mtu vinavyofanya likelihood ya majibu yaliyoonekana kuwa ya juu zaidi; MAP huongeza taarifa ya usambazaji wa awali kwenye likelihood hiyo na kuchagua kilele cha msongamano wa aposteriori; EAP, badala ya kuchagua kilele kimoja, huzingatia usambazaji mzima wa aposteriori na hutumia wastani wa aposteriori wa kigezo. Kwa hiyo, MAP na EAP zinaweza kutoa uratibishaji, lakini matokeo yake pia yanategemea ufaafu wa usambazaji wa awali unaotumiwa.
MLE: ongeza likelihood ya data pekee hadi kiwango cha juu
Mlinganyo (5) wa chanzo hutoa log-likelihood ya kiwango cha mtu kwa majibu ya jozi:
\[ \ell(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) = \sum_{j=1}^{J} \left[ y_{ij}\log P_{ij} + (1-y_{ij})\log(1-P_{ij}) \right] \tag{5} \]
Hapa \(P_{ij}=P(Y_{ij}=1\mid\boldsymbol{\lambda}_i)\). Ikiwa mwanafunzi amejibu kipengee kwa usahihi, \(y_{ij}=1\) na sehemu ya kwanza huamilishwa; ikiwa amejibu vibaya, \(y_{ij}=0\) na sehemu ya pili huamilishwa. Michango ya vipengee vyote hujumlishwa ili kupima jinsi vigezo fulani vya mtu vinavyolingana na majibu yaliyoonekana.
Ukadiriaji wa MLE:
\[ \widehat{\boldsymbol{\lambda}}_i^{MLE} = \operatorname*{arg\,max}_{\boldsymbol{\lambda}_i} \ell(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) \tag{6} \]
\(\operatorname{arg\,max}\) hapa hutafuta si thamani ya juu kabisa ya fungi, bali thamani ya kigezo inayozalisha thamani hiyo ya juu kabisa.
MAP: ongeza taarifa ya awali kwenye likelihood
Mlinganyo (7) wa chanzo:
\[ \widehat{\boldsymbol{\lambda}}_i^{MAP} = \operatorname*{arg\,max}_{\boldsymbol{\lambda}_i} \left\{ \ell(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) +\log\pi(\boldsymbol{\lambda}_i) \right\} \tag{7} \]
\(\pi(\boldsymbol{\lambda}_i)\) ni msongamano wa awali wa vigezo vya mtu. Katika utafiti huu, kwa \(\boldsymbol{\alpha}_i\) umetumiwa usambazaji wa awali sare juu ya wasifu \(2^K\) unaowezekana, na kwa athari endelevu za testlet umetumiwa usambazaji wa awali wa kawaida wa kawaida.
Chini ya usambazaji wa awali huru:
\[ \log\pi(\boldsymbol{\lambda}_i) = \log\pi(\boldsymbol{\alpha}_i) + \log\pi(\boldsymbol{\xi}_i), \qquad \log\pi(\boldsymbol{\xi}_i) \propto -\frac{1}{2}\boldsymbol{\xi}_i^\prime\boldsymbol{\xi}_i \]
Usambazaji wa awali wa kawaida wa kawaida huunda athari ya uratibishaji inayoadhibu athari za testlet zenye thamani kamili kubwa sana. Hata hivyo, sifa hii haimaanishi moja kwa moja “usahihi zaidi”; kutolingana kwa muundo wa awali na muundo halisi wa idadi ya watu kunaweza kuharibu hasa uainishaji wa sifa. Case 5 ni mfano wa moja kwa moja wa hili katika utafiti.
EAP: tumia wastani wa usambazaji wa aposteriori
Mlinganyo (8) wa chanzo:
\[ \widehat{\boldsymbol{\lambda}}_i^{EAP} = E[\boldsymbol{\lambda}_i\mid\mathbf{y}_i] = \int \boldsymbol{\lambda}_i p(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) \,d\boldsymbol{\lambda}_i \tag{8} \]
Hapa
\[ p(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) \propto L(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) \pi(\boldsymbol{\lambda}_i) \]
ni msongamano wa aposteriori. Tofauti kuu ya EAP ni kwamba hutumia si sehemu ya juu zaidi pekee ya usambazaji wa aposteriori, bali umbo lake lote. Kulingana na mjadala wa chanzo, tabia hii ya kuchukua wastani inaweza kutoa makadirio thabiti zaidi ya mtu, hasa katika testlet fupi ambako usambazaji wa aposteriori ni mpana, usio linganifu au usio laini.
Utekelezaji wa hatua mbili wa MLE ndani ya IT-DINA
Kwa kila wasifu wa sifa unaowezekana \(\boldsymbol{\alpha}_c\), \(c=1,\ldots,C\) na \(C=2^K\), kwanza athari endelevu ya testlet huboreshwa.
Mlinganyo (9) wa chanzo:
\[ \widehat{\boldsymbol{\xi}}_i^{(c)} = \operatorname*{arg\,max}_{\boldsymbol{\xi}_i} \ell(\boldsymbol{\xi}_i\mid\mathbf{y}_i,\boldsymbol{\alpha}_c) \tag{9} \]
Hii hutatua swali: “ikiwa kwa sasa wasifu wa sifa wa mwanafunzi unachukuliwa kuwa \(\boldsymbol{\alpha}_c\), ni katika thamani zipi athari za testlet zinaeleza majibu vizuri zaidi?”
Chanzo hutumia gradient ascent na utafutaji wa hatua kwa kurudi nyuma kwa MLE:
\[ \boldsymbol{\xi}_i^{(m+1)} = \boldsymbol{\xi}_i^{(m)} + \gamma^{(m)} \nabla_{\xi} \ell(\boldsymbol{\xi}_i^{(m)}\mid\mathbf{y}_i,\boldsymbol{\alpha}_c) \tag{10} \]
\(\nabla_{\xi}\ell\) ni gradient ya log-likelihood katika mwelekeo wa athari za testlet. Gradient huonyesha mwelekeo wa ongezeko la haraka zaidi la fungi. \(\gamma^{(m)}\) ni ukubwa wa hatua na hurekebishwa kwa utafutaji wa mstari wa kurudi nyuma ili kutoa ongezeko la kutosha la log-likelihood.
Baada ya kupata kadirio bora zaidi la endelevu kwa kila darasa la sifa, darasa lenye log-likelihood ya juu zaidi huchaguliwa:
\[ \widehat{\boldsymbol{\alpha}}_i^{MLE} = \operatorname*{arg\,max}_{\boldsymbol{\alpha}_c} \ell( \widehat{\boldsymbol{\xi}}_i^{(c)} \mid \mathbf{y}_i,\boldsymbol{\alpha}_c) \tag{11} \]
Mipangilio ya namba ya algoriti ya MLE
Algoriti ya chanzo hufanya uboreshaji kutoka kwa mianzo mitano tofauti kwa kila wasifu fiche wa sifa. Mwanzo wa kwanza ni \(\boldsymbol{\xi}=0\); mianzo inayofuata hutolewa kutoka usambazaji \(N(0,0.25I)\). Lengo ni kupunguza hatari ya mwanzo mmoja kukwama katika suluhisho duni la ndani kwenye uso changamano wa likelihood.
| Kigezo | Thamani | Jukumu |
|---|---|---|
| Kizidishi cha kurudi nyuma \(\rho\) | 0,8 | Mpangilio wa utaratibu wa kupunguza ukubwa wa hatua |
| Konstanti ya Armijo \(c_1\) | \(10^{-4}\) | Kizingiti cha sharti la ongezeko la kutosha la fungi |
| Idadi ya juu ya iteresheni \(M\) | 500 | Kikomo cha juu cha iteresheni za uboreshaji |
| Kizingiti cha muunganiko \(\epsilon\) | 0,001 | Kigezo cha kusimama wakati norm ya gradient imekuwa ndogo vya kutosha |
| Idadi ya mianzo \(J_{max}\) | 5 | Idadi ya kuanzisha upya ili kupunguza hatari ya optimum ya ndani |
Nini hubadilika katika algoriti ya MAP?
MAP hufanya uchunguzi ule ule wa madarasa; hata hivyo, athari endelevu ya testlet huongeza hadi kiwango cha juu lengo la aposteriori linalojumuisha si log-likelihood pekee, bali pia log-prior.
Mlinganyo (12) wa chanzo:
\[ \widehat{\boldsymbol{\xi}}_i^{(c)} = \operatorname*{arg\,max}_{\boldsymbol{\xi}_i} \left\{ \ell(\boldsymbol{\xi}_i\mid\mathbf{y}_i,\boldsymbol{\alpha}_c) + \log\pi(\boldsymbol{\xi}_i) \right\} \tag{12} \]
Katika usasishaji wa gradient kuna mchango wa data na wa usambazaji wa awali:
\[ \boldsymbol{\xi}_i^{(m+1)} = \boldsymbol{\xi}_i^{(m)} + \gamma^{(m)} \left[ \nabla_{\xi}\ell( \boldsymbol{\xi}_i^{(m)} \mid \mathbf{y}_i,\boldsymbol{\alpha}_c) + \nabla_{\xi}\log\pi( \boldsymbol{\xi}_i^{(m)}) \right] \tag{13} \]
Katika hatua ya mwisho, wasifu wa sifa huchaguliwa kwa kulinganisha thamani za lengo la aposteriori:
\[ \widehat{\boldsymbol{\alpha}}_i^{MAP} = \operatorname*{arg\,max}_{\boldsymbol{\alpha}_c} \left\{ \ell( \widehat{\boldsymbol{\xi}}_i^{(c)} \mid \mathbf{y}_i,\boldsymbol{\alpha}_c) + \log\pi( \widehat{\boldsymbol{\xi}}_i^{(c)}) + \log\pi(\boldsymbol{\alpha}_c) \right\} \tag{14} \]
Wakati usambazaji wa awali sare unatumiwa kwa wasifu wa sifa, \(\log\pi(\boldsymbol{\alpha}_c)\) ni konstanti ile ile katika madarasa yote, kwa hiyo haubadilishi ulinganisho kati ya madarasa. Lakini ikiwa wasifu halisi wa idadi ya watu si sare, dhana hii inaweza kuathiri matokeo ya uainishaji.
EAP: ujumuishaji badala ya uboreshaji
EAP, badala ya kutafuta kiwango cha juu kimoja kwa athari endelevu ya testlet, hujumuisha kigezo hiki juu ya usambazaji wa uwezekano.
Mlinganyo (15) wa chanzo:
\[ P(\mathbf{y}_i\mid\boldsymbol{\alpha}_c) = \int P(\mathbf{y}_i\mid\boldsymbol{\xi}_i,\boldsymbol{\alpha}_c) \pi(\boldsymbol{\xi}_i) \,d\boldsymbol{\xi}_i \tag{15} \]
Usemi huu ni likelihood ya pembezoni ya wasifu fulani wa sifa. Thamani zote zinazowezekana za athari endelevu ya testlet huzingatiwa pamoja na uzani wao wa awali.
Uwezekano wa aposteriori wa wasifu wa sifa:
\[ P(\boldsymbol{\alpha}_c\mid\mathbf{y}_i) = \frac{ P(\mathbf{y}_i\mid\boldsymbol{\alpha}_c)\pi(\boldsymbol{\alpha}_c) }{ \sum_{d=1}^{C} P(\mathbf{y}_i\mid\boldsymbol{\alpha}_d)\pi(\boldsymbol{\alpha}_d) } \tag{16} \]
Sehemu ya juu inawakilisha uzani wa darasa fulani pamoja na data na usambazaji wa awali, na sehemu ya chini inawakilisha jumla ya uzani wa madarasa yote yanayowezekana. Hivyo matokeo ni uwezekano halisi wa darasa wa aposteriori kati ya 0–1.
Uwezekano wa umilisi kwa kila sifa moja:
\[ \widehat{\alpha}_{ik}^{EAP} = P(\alpha_{ik}=1\mid\mathbf{y}_i) = \sum_{c=1}^{C} I(\alpha_{ck}=1) P(\boldsymbol{\alpha}_c\mid\mathbf{y}_i) \tag{17} \]
\(I(\cdot)\) ni fungi ya kiashiria. Ikiwa darasa \(c\) lina sifa \(k\), huwa 1; vinginevyo huwa 0. Hivyo, uwezekano wa aposteriori wa madarasa yote yenye sifa hiyo hujumlishwa.
Ukadiriaji wa EAP wa athari endelevu za testlet:
\[ \widehat{\boldsymbol{\xi}}_i^{EAP} = \int \boldsymbol{\xi}_i p(\boldsymbol{\xi}_i\mid\mathbf{y}_i) \,d\boldsymbol{\xi}_i \tag{18} \]
Chanzo huhesabu hili kama wastani wa matarajio yenye masharti ya darasa, yaliyowekewa uzani kwa uwezekano wa aposteriori wa madarasa ya sifa. Mbinu hii hubeba kutokuwa na uhakika kupitia usambazaji, badala ya kutoa uzani wote kwa darasa moja na nukta moja endelevu ya kiwango cha juu.
Kwa nini Gauss–Hermite quadrature inatumika?
Kwa kuwa integrali katika Mlinganyo (15) na (18) si rahisi kuhesabiwa kwa umbo funge, utafiti hutumia Gauss–Hermite quadrature (GHQ). Chanzo hutumia nodi 20 za Gauss–Hermite kwa kila kipimo endelevu katika algoriti ya EAP. Kwa athari ya testlet ya IT-DINA ya vipimo viwili, zao la tensor huzalisha jumla ya nukta \(20^2=400\) za quadrature.
Katika kila nukta ya quadrature, likelihood ya majibu huhesabiwa, huzidishwa kwa uzani wa Gauss–Hermite, na thamani hizi zenye uzani hujumlishwa ili kupata ukadiriaji wa namba wa integrali. Thamani 400 hapa si wanafunzi wapya wala data mpya; ni nukta za tathmini ya namba zinazotumiwa katika ukokotoaji wa kukadiria integrali endelevu.
Vigezo vya DINA vinahamishwaje hadi kipimo cha probit katika uigaji?
Mwanzoni mwa uigaji, thamani za slipping \(s_j\) na guessing \(g_j\) hutolewa kutoka usambazaji sare wa \(U(0.05,0.20)\). Kisha vigezo vya vipengee katika kipimo cha probit huundwa kama ifuatavyo:
\[ \delta_{0j}=\Phi^{-1}(g_j) \]
\[ \delta_{1j} = \Phi^{-1}(1-s_j) - \Phi^{-1}(g_j) \]
\(\Phi\) ni fungi ya usambazaji limbikizi wa usambazaji wa kawaida wa kawaida; \(\Phi^{-1}\) ni kinyume chake. Hivyo, thamani za guessing na slipping katika kipimo cha uwezekano huhamishwa kwenda kwenye kipimo cha kitabiri mstari cha probit.
Kwa nini uwezekano halisi wa vipengee hubadilika athari za testlet zinapoongezwa?
Athari za nasibu za testlet zinapoongezwa kwenye modeli ya probit, uwezekano wa pembezoni wa jibu sahihi haubaki sawa kabisa na thamani za \(g_j\) na \(1-s_j\) zilizochaguliwa mwanzoni. Chanzo hutoa uwezekano huu mpya unaotokana na modeli katika Mlinganyo (19) na (20).
Uwezekano wa pembezoni wa jibu sahihi kwa mwanafunzi mwenye sifa zinazohitajika:
\[ c_{js}^{*} = \Phi\left( \frac{ \delta_{0j}+\delta_{1j} }{ \sqrt{ 1+\sigma_{\xi}^{2} (\beta_{js}^{2}+\gamma_{js}^{2}) } } \right) \tag{19} \]
Uwezekano wa pembezoni wa jibu sahihi kwa mwanafunzi asiye na sifa zinazohitajika:
\[ g_{js}^{*} = \Phi\left( \frac{ \delta_{0j} }{ \sqrt{ 1+\sigma_{\xi}^{2} (\beta_{js}^{2}+\gamma_{js}^{2}) } } \right) \tag{20} \]
Katika utafiti \(\sigma_{\xi}^{2}=0.25\), yaani mkengeuko sanifu wa athari za testlet ni 0,5. Kwa kuwa miraba ya mizigo ya testlet huingia kwenye sehemu ya chini ya fomula, ukubwa kamili wa mizigo huathiri upimaji wa pembezoni. Katika Case 5, kuwa kwa alama chanya au hasi hakubadilishi masafa haya maalumu ya uwezekano wa pembezoni; kwa sababu katika Mlinganyo (19) na (20) hutumika \(\beta^2\) na \(\gamma^2\).
\(1-c_{js}^{*}\) ni uwezekano wa slipping unaodokezwa na modeli. Kwa hiyo, hata kama mwanzoni \(s_j\) na \(g_j\) zilichaguliwa kati ya 0,05–0,20, baada ya kuongeza athari za testlet uwezekano wa slipping na guessing unaotokana na modeli si lazima ubaki ndani ya mipaka hiyo hiyo.
Bias hupima nini?
Mlinganyo (21) wa chanzo:
\[ Bias(\widehat{\boldsymbol{\xi}}) = \frac{1}{N} \sum_{i=1}^{N} ( \widehat{\boldsymbol{\xi}}_i - \boldsymbol{\xi}_i ) \tag{21} \]
Bias huonyesha mwelekeo ambao makadirio yanakengeuka kwa utaratibu kutoka kwenye athari halisi za testlet. Thamani iliyo karibu na sifuri huonyesha kwamba kosa la kimfumo chanya na hasi ni dogo. Hata hivyo, Bias ndogo peke yake haitoshi; makosa makubwa chanya na hasi yanayofidia yanaweza kufanya wastani ukaribie sifuri.
RMSE hupima nini?
Mlinganyo (22) wa chanzo:
\[ RMSE(\widehat{\boldsymbol{\xi}}) = \sqrt{ \frac{1}{N} \sum_{i=1}^{N} \left\| \widehat{\boldsymbol{\xi}}_i - \boldsymbol{\xi}_i \right\|^2 } \tag{22} \]
RMSE hupima ukubwa wa kosa kati ya kadirio na thamani halisi na huadhibu makosa makubwa kwa nguvu zaidi kwa sababu ya kuyapandisha mraba. RMSE ya chini humaanisha urejeshaji sahihi zaidi wa athari endelevu ya testlet.
Kwa nini PCCR ni kipimo kigumu cha uainishaji?
Mlinganyo (23) wa chanzo:
\[ PCCR = \frac{1}{N} \sum_{i=1}^{N} I( \widehat{\boldsymbol{\alpha}}_i = \boldsymbol{\alpha}_i ) \tag{23} \]
Pattern-wise Correct Classification Rate (PCCR) haitaki tu kila ujuzi mmoja mmoja uainishwe kwa usahihi, bali inahitaji wasifu mzima wa sifa wa mwanafunzi uwe sahihi kikamilifu. Kwa mfano, ikiwa wasifu halisi ni \((1,1,0)\) lakini \((1,0,0)\) umekadiriwa, hata kama sifa mbili kati ya tatu ni sahihi, kwa PCCR wasifu mzima huhesabiwa kuwa si sahihi. Kwa hiyo, PCCR ni kipimo kikali.
EAP mwanzoni hutoa uwezekano wa aposteriori wa umilisi kati ya 0–1 kwa kila sifa badala ya wasifu wa jozi. Ili kuleta ulinganisho katika kipimo kile kile cha jozi, chanzo hutumia kizingiti cha 0,50:
\[ \widehat{\alpha}_{ik}^{binary} = I\left[ P(\alpha_{ik}=1\mid\mathbf{y}_i)\geq0.50 \right] \tag{24} \]
Kwa nini kosa sanifu la Monte Carlo lilihesabiwa?
Hali zote za uigaji zilirudiwa kwa kujitegemea mara \(R=500\). Ili kuonyesha kutofautiana kwa PCCR kati ya marudio haya, kosa sanifu la Monte Carlo lilihesabiwa:
\[ \widehat{MCSE}(PCCR) = \frac{ SD\left( PCCR^{(1)},\ldots,PCCR^{(R)} \right) }{ \sqrt{R} } \tag{25} \]
Hapa \(SD\) ni mkengeuko sanifu wa sampuli wa thamani za PCCR zilizopatikana katika marudio 500. PCCR inapoelezwa kwa asilimia, MCSE pia hufasiriwa kwa pointi za asilimia.
Mbinu na Matokeo ya Utafiti
Muundo wa uigaji
Utafiti ulilinganisha MLE, MAP na EAP katika matukio matano tofauti ya uzalishaji wa data/ukadiriaji. Katika hali zote za msingi, ukubwa wa sampuli ulikuwa watu 10.000. Idadi ya testlet ilibadilishwa kuwa 3 au 4, na idadi ya vipengee katika kila testlet kuwa 10, 20, 30, 40 au 50.
Kwa Case 1–4, ulitumiwa muundo wa idadi ya watu ulio sare wenye \(K=3\), ambapo wasifu nane wa sifa ulikuwa na uwezekano sawa. Katika Case 5, \(K=5\) na usambazaji halisi wa wasifu wa sifa haukuwa tena sare.
| Hali | Modeli halisi ya data | Modeli ya ukadiriaji | \(\beta\) | \(\gamma\) | Lengo kuu |
|---|---|---|---|---|---|
| Case 1 | IT-DINA | IT-DINA | 0,5 | 0,5 | Hali ya msingi ya IT-DINA iliyobainishwa kwa usahihi |
| Case 2 | DINA | IT-DINA | 0 | 0 | Matumizi ya modeli changamano kupita kiasi wakati hakuna athari halisi ya testlet |
| Case 3 | T-DINA | IT-DINA | 1 | 0 | Kuongeza sehemu ya mwingiliano isiyohitajika wakati kuna athari kuu ya testlet |
| Case 4 | IT-DINA | T-DINA | 0,5 | 1 | Kuondoa sehemu halisi ya mwingiliano kutoka kwenye modeli ya ukadiriaji |
| Case 5 | IT-DINA | IT-DINA | Thamani kamili 0,5; alama mchanganyiko | Thamani kamili 1; alama mchanganyiko | Ustahimilivu chini ya kipimo cha juu zaidi, idadi ya watu isiyo sare na mizigo yenye alama mchanganyiko |
Usambazaji halisi wa sifa katika Case 5 uliundwaje?
Kwa kuwa kuna sifa tano, kuna wasifu 32 unaowezekana. Katika idadi halisi ya watu, uwezekano wa darasa uliwekwa kuwa \(\pi_c=1/48\) kwa wasifu wenye sifa sifuri, moja au mbili zilizopatikana; na \(\pi_c=1/24\) kwa wasifu wenye sifa tatu au zaidi zilizopatikana. Hivyo, wasifu wenye umilisi wa juu ulikuwa na uwezekano wa darasa mara mbili ya ule wa wasifu wenye umilisi wa chini.
Hata hivyo, kwa MAP na EAP, usambazaji wa awali sare juu ya wasifu wa sifa uliendelea kutumika katika hali zote za Case 1–5. Umuhimu wa kisayansi wa Case 5 uko hasa hapa: muundo halisi wa idadi ya watu na usambazaji wa awali wa Bayes wa sifa haufanani kwa makusudi.
Uwezekano wa guessing na slipping unaotokana na modeli
| Hali | \(\beta\) | \(\gamma\) | Masafa ya \(g^*\) | Masafa ya \(1-c^*\) |
|---|---|---|---|---|
| Case 1 | 0,5 | 0,5 | 0,0605–0,2137 | 0,0605–0,2137 |
| Case 2 | 0 | 0 | 0,0500–0,2000 | 0,0500–0,2000 |
| Case 3 | 1 | 0 | 0,0706–0,2257 | 0,0706–0,2257 |
| Case 4 | 0,5 | 1 | 0,0755–0,2312 | 0,0755–0,2312 |
| Case 5 | ±0,5 | ±1 | 0,0755–0,2312 | 0,0755–0,2312 |
Case 1: IT-DINA iliyobainishwa kwa usahihi
Katika hali hii ya msingi, modeli ya uzalishaji wa data na modeli ya ukadiriaji zote ni IT-DINA. EAP na MAP kwa kawaida ziliweka Bias ya athari ya testlet kwa thamani kamili chini ya 0,005. Katika MLE, kwa baadhi ya athari za testlet katika testlet fupi zenye vipengee 10, Bias ya thamani kamili ilifikia takriban 0,02–0,04. Testlet ilipoongezwa hadi vipengee 50, Bias ya MLE ilipungua lakini ilibaki karibu na kiwango cha 0,01.
Kwa RMSE, EAP na MAP zilipungua takriban kutoka 0,35 hadi 0,20 kadiri urefu wa testlet ulivyoongezeka. MLE, katika testlet zenye vipengee 10, ilionyesha RMSE ya takriban 0,55–0,65; hata katika vipengee 50 ilibaki takriban katika kiwango cha 0,30–0,35.
Kwa PCCR, mbinu za Bayes kwa ujumla zilikuwa juu ya %97 na kuelekea vipengee 50 zilifikia takriban %98,5, huku MLE ikibaki takriban katika masafa ya %93–95.
Case 2: kwa kweli hakuna athari ya testlet, lakini IT-DINA inakadiriwa
Katika hali hii \(\beta=\gamma=0\). Kwa maneno mengine, katika mchakato wa uzalishaji wa data, athari za testlet hazibadilishi uwezekano wa majibu; hata hivyo, modeli kamili ya IT-DINA hutumiwa katika ukadiriaji. Hii hujaribu tabia ya mbinu wakati sehemu endelevu zisizohitajika zinaongezwa kwenye modeli.
Kwa EAP na MAP, Bias za athari ya testlet zilikuwa karibu sana na sifuri, na RMSE zilipatikana kuwa takriban 0,49–0,50. Thamani kamili ya Bias za MLE ilikuwa takriban 0,003–0,006 na RMSE yake ilikuwa takriban katika masafa ya 0,55–0,69.
RMSE ya 0,49–0,50 hapa inahitaji kusomwa kwa uangalifu. Katika chanzo, ingawa vigezo vya testlet vya mtu vilitolewa katika kipimo cha \(N(0,0.5^2)\), mizigo yake kwenye majibu ni sifuri. Kwa hiyo, data ya majibu haina taarifa ya moja kwa moja ya kubainisha athari za testlet za mtu mmoja mmoja. Uratibishaji wa Bayes huweka makadirio karibu na kitovu cha usambazaji wa awali; chanzo hutafsiri tabia hii kwa kuzingatia kuzuia sehemu zisizohitajika kuwa zisizo thabiti.
Case 3: modeli halisi ni T-DINA, ukadiriaji ni IT-DINA
Katika data halisi kuna athari kuu ya testlet, lakini hakuna sehemu ya mwingiliano. IT-DINA hujaribu kukadiria sehemu zote mbili.
Katika sehemu halisi za athari kuu, Bias ya EAP kwa thamani kamili ilibaki chini ya 0,001 na RMSE ilipungua kutoka takriban 0,43 hadi 0,34. Bias ya MAP ilikuwa takriban 0,001–0,006; RMSE yake ilikuwa katika masafa ya 0,40–0,50. Bias ya MLE ilikuwa takriban 0,004–0,02, na RMSE yake takriban 0,50–0,69.
Katika sehemu ya mwingiliano ambayo kwa kweli haipo, Bias ya EAP na MAP ilibaki tena karibu sana na sifuri, huku RMSE ikipatikana karibu 0,49–0,50. MLE ilionyesha Bias na RMSE kubwa zaidi katika sehemu isiyohitajika.
Case 4: IT-DINA halisi, lakini ukadiriaji ni T-DINA rahisi zaidi
Hali hii hujaribu kinyume cha modeli changamano kupita kiasi. Katika data halisi kuna athari kuu ya testlet na mwingiliano, lakini modeli ya ukadiriaji haijumuishi sehemu ya \(\xi_2\) inayohusiana na mwingiliano.
EAP kwa ujumla ilitoa Bias na RMSE ndogo zaidi katika hali za testlet tatu na nne. MAP ilibaki karibu na EAP katika hali nyingi. MLE ilibadilika zaidi hasa katika testlet fupi. Chanzo kinaripoti kwamba ikilinganishwa na Case 1 iliyobainishwa kwa usahihi, Bias ya MLE inaweza kuongezeka takriban mara 2–5 na RMSE katika testlet fupi inaweza kuzidi 0,80.
Katika uainishaji, kwa testlet fupi tofauti ya PCCR kati ya EAP na MLE ilifikia takriban pointi 6–7 za asilimia. Matokeo haya yanaonyesha kwamba katika modeli zilizobainishwa kwa upungufu, si uchaguzi wa modeli pekee bali pia mbinu ya ukadiriaji wa kigezo cha mtu inaweza kubadilisha matokeo ya uchunguzi.
Je, Mbinu za Bayes Zilikuwa Bora Katika Kila Hali?
Hapana. Ingawa EAP na MAP zilibaki thabiti zaidi kuliko MLE katika hali ya tano ya uigaji kwa upande wa Bias na RMSE ya athari endelevu za testlet, katika kipimo cha PCCR kinachotaka wasifu mzima wa sifa uainishwe kwa usahihi, MLE ilitoa matokeo ya juu kidogo. Chanzo kinahusisha hili na kutolingana kati ya usambazaji halisi wa wasifu wa sifa usio sare na matumizi ya usambazaji wa awali sare wa sifa katika MAP/EAP; kwa hiyo, faida ya Bayes haijitegemei usahihi wa usambazaji wa awali.
Case 5: nini kilitokea wakati usambazaji wa awali haukulingana?
Thamani za Bias za EAP na MAP katika athari endelevu za testlet zilibaki ndogo, huku MLE ikizalisha RMSE ya juu zaidi hasa katika testlet fupi. Kwa upande mwingine, katika PCCR EAP na MAP zilikuwa takriban katika masafa ya %87–91, na MLE takriban katika masafa ya %90–93.
Matokeo haya yanaonyesha kwamba malengo mawili tofauti ya ukadiriaji si kitu kimoja. Mbinu inaweza kurejesha athari endelevu ya testlet vizuri zaidi bila kulazimika pia kuainisha wasifu bainifu wa sifa vizuri zaidi kwa wakati mmoja. Hasa, uainishaji wa Bayes unaweza kuathiriwa na usambazaji wa awali wa wasifu usiolingana na usambazaji halisi wa idadi ya watu.
Kutofautiana kwa uigaji kwa PCCR
Thamani za MCSE zilizohesabiwa kutokana na marudio 500 huru ziko takriban katika masafa ya %0,08–%1,50 katika hali zote. Katika Case 1–3, thamani kwa ujumla zilibaki chini ya %1. Katika Case 4, kutofautiana kuliongezeka hasa kwa MLE; thamani za juu zaidi za MCSE zilionekana katika Case 5 yenye idadi kubwa zaidi ya sifa na usahihi mdogo zaidi wa uainishaji, takriban katika masafa ya %1,17–%1,50.
Urefu wa testlet au idadi ya testlet, kipi kilikuwa muhimu zaidi?
Kulingana na mjadala wa chanzo, katika hali hizi za uigaji kuongeza idadi ya vipengee kwa kila testlet kulitoa ongezeko kubwa zaidi la usahihi kuliko kuongeza idadi ya testlet. Kihisabati, hii ina maana kwamba majibu ya vipengee zaidi hutoa taarifa zaidi kuhusu athari ile ile endelevu ya testlet.
Hata hivyo, utafiti haufanyi matokeo haya kuwa kanuni ya jumla ya usanifu wa mitihani. Katika uigaji, idadi ya sifa, ubora wa vipengee na muundo wa modeli viko ndani ya mipaka maalumu; katika tathmini zenye idadi kubwa zaidi ya sifa, taarifa dhaifu zaidi ya vipengee au kelele zaidi, ongezeko la ukubwa huo huo halijahakikishwa.
Matumizi ya kimajaribio ya TIMSS 2023 yaliundwaje?
Katika onyesho la kimajaribio, hifadhidata ya kimataifa ya hisabati ya darasa la nane ya TIMSS 2023 ilitumika. Mwanzoni kulikuwa na wanafunzi 308.492 na vipengee 68 vya hisabati vilivyokuwa wagombea katika vijitabu vya tathmini. Majibu yasiyojibiwa au yasiyo halali yaliwekwa kama thamani pungufu; wanafunzi wenye majibu halali chini ya matano waliondolewa na sampuli ya mwisho ya watu ikawa 118.547.
Utafiti ulitumia bloku za vipengee katika muundo wa vijitabu vinavyozungushwa wa TIMSS kama vitengo vya testlet vya kiutendaji. B_MD3 na B_MD5 zilichaguliwa kwa sababu zilitolewa kwa kundi lile lile la wajibu ndani ya kijitabu kile kile kilichochaguliwa na ziliendelea kuwa na utofauti wa kutosha katika kiwango cha kipengee baada ya usafishaji wa data.
Hapa kuna mpaka muhimu wa istilahi: chanzo kinaeleza wazi kwamba bloku za TIMSS si lazima ziwe “testlet” za kawaida kwa maana finyu zinazoshiriki kichocheo kimoja cha pamoja. Zilitumiwa kama testlet za kiutendaji ili kuwakilisha utegemezi uliobaki ndani ya bloku hiyo hiyo.
Kwa nini vipengee vya polytomous vilibadilishwa kuwa vya jozi?
Alama za awali za TIMSS za vipengee vilivyochaguliwa vya constructed-response zinaweza kuwa na zaidi ya kategoria moja ya alama. Kwa kuwa aina za DINA, T-DINA na IT-DINA zilizotumiwa katika utafiti huu zinategemea majibu ya jozi, alama zote kubwa kuliko sifuri zilirudishwa kuwa sahihi = 1, na alama sifuri kuwa si sahihi = 0.
Mabadiliko haya hupoteza taarifa ya alama za sehemu. Kwa hiyo, kwa mfano, wanafunzi wawili waliopata alama 1 na alama 2 wanaweza wote kuingia katika kategoria ya “sahihi”. Chanzo kinakubali wazi hili kama mojawapo ya mapungufu muhimu ya utafiti.
| Hatua | Muundo uliotolewa katika chanzo |
|---|---|
| Idadi ya awali ya watu | 308.492 |
| Vipengee vya hisabati vilivyokuwa wagombea | 68 |
| Kigezo cha kuondoa mtu | Mwanafunzi mwenye majibu halali chini ya 5 aliondolewa |
| Idadi ya mwisho ya watu | 118.547 |
| Testlet za kiutendaji | B_MD3 na B_MD5 |
| Idadi ya mwisho ya vipengee | Vipengee 27 vya jozi |
| B_MD3 | Vipengee 15 |
| B_MD5 | Vipengee 12 |
| Sifa | Applying vipengee 11, Knowing 4, Reasoning vipengee 12 |
Matriksi ya Q ya TIMSS iliundwaje?
Uainishaji rasmi wa maeneo ya utambuzi ya vipengee vya hisabati vya TIMSS ulitumiwa katika utafiti kama sifa tatu za uchunguzi za jozi: Knowing (Kujua), Applying (Kutumia) na Reasoning (Kutoa Hoja). Kila kipengee cha uchanganuzi kilipewa eneo moja tu la utambuzi; kwa hiyo, kila mstari wa matriksi ya Q una 1 moja tu.
Kati ya vipengee 27, 11 vilikodishwa kama Applying, 4 kama Knowing na 12 kama Reasoning. Hii ina maana kwamba matriksi ya Q iliyotumiwa ina muundo rahisi sana ikilinganishwa na CDM za jumla zenye sifa nyingi. Katika mjadala wa utafiti, inasisitizwa hasa kwamba viwango vya juu vya uainishaji havipaswi kujumlishwa moja kwa moja kwa idadi kubwa zaidi ya sifa au matriksi za Q zilizo changamano zaidi.
Kutolingana kwa misimbo ya vipengee vya TIMSS ndani ya chanzo
Katika chanzo, Jedwali 7 linaonyesha misimbo miwili ya vipengee ndani ya B_MD3 kama MQ8N208A na MQ8N208B, ilhali katika Jedwali 8, ambalo ni jedwali la vigezo vya vipengee hivyo hivyo, misimbo imetolewa kama MQ82N08A na MQ82N08B. Kwa kuwa chanzo hakitoi maelezo ya marekebisho kuhusu tofauti hii, maandishi ya Verianla hayatangazi kimya kimya mojawapo ya tahajia hizo mbili kuwa “sahihi”.
Kipimo cha vigezo vya vipengee vya kimajaribio
Katika kulinganisha makadirio ya mtu ya MLE, MAP na EAP, vigezo vya vipengee vilikalibishwa mapema na kuwekwa thabiti. Kwa njia hii, ilijaribiwa kuzuia tofauti kati ya mbinu wakati wa ulinganisho isitokane na kukadiriwa upya kwa vigezo vya vipengee.
Katika Jedwali 8, chanzo kinatoa kwa vipengee 27 thamani za \(\delta_0\), \(\delta_1\), makosa sanifu na pass rate. Thamani za \(\delta_0\) zinabadilika takriban kutoka −4,06 hadi −0,86, thamani za \(\delta_1\) takriban kutoka −3,20 hadi 3,88, na pass rate takriban kutoka 0,03 hadi 0,24.
Chanzo kinaeleza hasa kwamba baadhi ya thamani za \(\delta_1\) ni hasi na zinapaswa kutafsiriwa kwa uangalifu. Kihisabati, \(\delta_1\) hasi ina maana kwamba katika Mlinganyo (3) au (4), sehemu nyingine zikiwa thabiti, kuhama kwa \(\eta\) kutoka 0 hadi 1 hupunguza kitabiri mstari badala ya kukiongeza. Kwa kuwa chanzo hakithibitishi sababu ya alama hizi zisizo za kawaida kama utaratibu mpya, Verianla pia haidhanishi sababu yake.
Mazingira ya ukokotoaji wa kimajaribio
Uchanganuzi wote ulifanywa katika mazingira ya R 4.2.0 na kwa kutumia ukokotoaji sambamba kwa sababu ya sampuli kubwa. Kigezo cha muunganiko wa modeli ni kwamba tofauti kamili ya mabadiliko ya kigezo kati ya iteresheni zinazofuatana iwe ndogo kuliko 0,001; idadi ya juu ya iteresheni iliwekwa kuwa 500.
Wasifu wa sifa wa MLE, MAP na EAP katika TIMSS
| Wasifu | EAP | MAP | MLE |
|---|---|---|---|
| (0,0,0) | 12.045 (%10,16) | 11.892 (%10,03) | 8.273 (%6,98) |
| (1,0,0) | 10.342 (%8,72) | 10.101 (%8,52) | 7.464 (%6,30) |
| (0,1,0) | 8.976 (%7,57) | 8.743 (%7,37) | 6.739 (%5,68) |
| (0,0,1) | 18.342 (%15,48) | 18.567 (%15,66) | 32.479 (%27,40) |
| (1,1,0) | 9.543 (%8,05) | 9.321 (%7,86) | 7.158 (%6,04) |
| (1,0,1) | 14.237 (%12,01) | 14.512 (%12,24) | 12.089 (%10,20) |
| (0,1,1) | 12.876 (%10,86) | 13.045 (%11,00) | 11.724 (%9,89) |
| (1,1,1) | 32.186 (%27,15) | 32.366 (%27,31) | 32.621 (%27,52) |
Asilimia za EAP na MAP kwa wasifu nane ziko karibu sana; tofauti kwa kila wasifu iko chini ya %0,5. Usambazaji wa MLE unatofautiana hasa katika wasifu wa \((0,0,1)\): MLE iliweka wanafunzi 32.479 katika darasa hili, EAP 18.342 na MAP 18.567.
Nini kilionekana katika usambazaji wa athari ya testlet?
Kielelezo 11 cha chanzo kinalinganisha usambazaji wa makadirio ya \(\xi_1\) na \(\xi_2\) kwa testlet mbili za kiutendaji kati ya EAP, MAP na MLE kwa kutumia box plots. Thamani za EAP zimejikusanya zaidi karibu na sifuri na zina masafa finyu zaidi kati ya kvartili. MAP ni pana kidogo lakini bado imejikusanya zaidi kuliko MLE. Katika MLE, visanduku, whisker na thamani za mwisho ni pana zaidi.
Kwa kuwa thamani ghafi za kiwango cha mtu za kielelezo au muhtasari wote wa box plot hazijatolewa kama jedwali katika chanzo, Verianla haijachora upya box plot ya namba iliyobuniwa. Ujumbe wa kisayansi umehifadhiwa kupitia maandishi na uwiano wa mpangilio ulio hapa chini.
Uwiano wa mpangilio wa Kendall
| Kigezo | EAP–MAP | EAP–MLE | MAP–MLE |
|---|---|---|---|
| \(\xi_1\), T1 | 0,976 | 0,634 | 0,616 |
| \(\xi_1\), T2 | 0,981 | 0,578 | 0,642 |
| \(\xi_2\), T1 | 0,969 | 0,561 | 0,655 |
| \(\xi_2\), T2 | 0,982 | 0,553 | 0,649 |
Uwiano wote wa EAP–MAP uko juu ya 0,96; mbinu hizi mbili zilikuwa na tabia inayofanana sana katika upangaji wa athari za testlet za wanafunzi. Uwiano kati ya MLE na mbinu za Bayes ulibaki takriban katika masafa ya 0,55–0,65 na ukaonyesha ulinganifu wa kiwango cha kati pekee.
Uainishaji wa EAP na MAP ulifanana kwa kiwango gani?
Katika matriksi ya mpito, chanzo kinaripoti kwamba uwiano wa diagonal wa uainishaji kutoka EAP hadi MAP uko juu ya %93 kwa wasifu wote nane wa sifa. Hii inaonyesha kwamba mbinu mbili za Bayes zilichagua kwa kiasi kikubwa madarasa yale yale si katika usambazaji wa jumla wa wasifu pekee, bali pia katika kiwango cha mtu.
Mabadiliko ya kimfumo kati ya EAP na MLE
Matriksi ya mpito ya EAP–MLE ilionyesha utengano ulio wazi zaidi. Kati ya wanafunzi walioainishwa na EAP kama \((1,1,0)\), wanafunzi 9.543, 1.571 kati yao, yaani takriban %16,5, walihamishwa na MLE hadi wasifu wa \((0,0,1)\).
Mabadiliko makubwa zaidi yalionekana katika wasifu wa \((0,0,0)\) na \((1,0,0)\). Kati ya waliokuwa katika kundi la \((0,0,0)\) la EAP, takriban %24,4, na kati ya kundi la \((1,0,0)\), takriban %25,2, waliwekwa na MLE katika \((0,0,1)\).
Ugunduzi huu haumaanishi kwamba EAP ndiyo wasifu halisi; katika matumizi ya kimajaribio ya TIMSS, wasifu halisi fiche wa sifa haujulikani. Matokeo yanaonyesha tu kwamba mbinu tofauti za ukadiriaji wa mtu zinaweza kutoa uainishaji tofauti wa uchunguzi chini ya modeli ile ile ya IT-DINA na data zile zile.
Je, Kupuuza Athari za Testlet Kunaweza Kubadilisha Uainishaji wa Uchunguzi?
Katika mfano huu wa kimajaribio wa TIMSS, ndiyo. IT-DINA, inayowakilisha athari za testlet na mwingiliano wake na hali ya sifa, ilionyesha ufaafu wa kulinganisha ulio bora kuliko DINA inayodhani uhuru wa ndani, na ilibadilisha kwa kiwango kikubwa usambazaji wa wasifu wa sifa za wanafunzi. Hata hivyo, matokeo haya hayamaanishi kwamba IT-DINA itakuwa bora kiotomatiki katika matumizi yote ya TIMSS au mitihani yote; chanzo kinayawasilisha kama onyesho la kimajaribio chini ya hali maalumu za uchakataji wa data na uundaji wa modeli.
Ufaafu wa modeli za DINA na IT-DINA
| Modeli | Log-likelihood | Idadi ya vigezo | AIC | BIC |
|---|---|---|---|---|
| DINA | −1.523.456,23 | 54 | 3.047.020,5 | 3.047.520,3 |
| IT-DINA | −1.517.221,78 | 58 | 3.034.559,6 | 3.035.019,8 |
Ingawa IT-DINA hutumia vigezo vinne vya ziada, thamani zake za AIC na BIC ni takriban 12.000 chini zaidi. Chanzo pia kinaripoti \(\Delta LL=6234,45\), \(\Delta df=4\) na \(p<0,001\). Matokeo haya yanaunga mkono kwamba ndani ya data hii ya kimajaribio na ulinganisho huu wa modeli, IT-DINA ilionyesha ufaafu wa kulinganisha ulio bora kuliko DINA.
DINA na IT-DINA ziliwaainishaje wanafunzi kwa tofauti?
| Wasifu | IT-DINA (EAP) | DINA | Tofauti ya idadi ya watu DINA − IT-DINA |
|---|---|---|---|
| (0,0,0) | 12.045 (%10,16) | 8.273 (%6,98) | −3.772 |
| (1,0,0) | 10.342 (%8,72) | 7.464 (%6,30) | −2.878 |
| (0,1,0) | 8.976 (%7,57) | 6.739 (%5,68) | −2.237 |
| (0,0,1) | 18.342 (%15,48) | 32.479 (%27,40) | +14.137 |
| (1,1,0) | 9.543 (%8,05) | 7.158 (%6,04) | −2.385 |
| (1,0,1) | 14.237 (%12,01) | 12.089 (%10,20) | −2.148 |
| (0,1,1) | 12.876 (%10,86) | 11.724 (%9,89) | −1.152 |
| (1,1,1) | 32.186 (%27,15) | 32.621 (%27,52) | +435 |
Tofauti kubwa zaidi iko katika wasifu wa \((0,0,1)\). DINA iliweka wanafunzi 32.479, na IT-DINA EAP wanafunzi 18.342, katika wasifu huu; tofauti ni wanafunzi 14.137. Chanzo kinaeleza kwamba mabadiliko haya ni muhimu kwa tafsiri ya uchunguzi kwa sababu vipengee vingi katika uchanganuzi vinahusishwa na sifa ya Reasoning.
DINA iliainisha wasifu wa umilisi wa chini wa \((0,0,0)\), \((1,0,0)\) na \((0,1,0)\) kwa jumla watu 8.887 wachache kuliko IT-DINA; na wasifu wenye sifa nyingi wa \((1,1,0)\), \((1,0,1)\) na \((0,1,1)\) kwa jumla takriban watu 5.685 wachache. Wasifu wa umilisi kamili wa \((1,1,1)\) ni karibu sana kati ya modeli hizo mbili.
Maelezo yanayotolewa na chanzo kwa EAP
Kulingana na mjadala wa utafiti, uthabiti wa EAP unaweza kuelezwa kwa taratibu tatu zinazohusiana. Kwanza, EAP hutumia wastani wa usambazaji wa aposteriori, si moda yake moja. Hali hii inaweza kuratibisha makadirio ya kiwango cha mtu kuelekea sifuri wakati taarifa kwa kila testlet ni ndogo.
Pili, kwa kuwa uso wa likelihood wa IT-DINA unajumuisha kwa pamoja madarasa bainifu ya sifa na vigezo endelevu vya testlet, katika testlet fupi unaweza kuwa tambarare, wenye moda nyingi au uliobainishwa kwa udhaifu. MLE isiyo na usambazaji wa awali inaweza kuwa wazi zaidi kwa mabadiliko ya sampuli katika hali hizi.
Tatu, ingawa MAP ina uratibishaji wa awali, hutumia moda pekee ya usambazaji wa aposteriori. Ikiwa usambazaji wa aposteriori ni mpana au usio linganifu, moda inaweza kubaki nyeti kwa kutokuwa laini kwa eneo. EAP inaweza kulainisha zaidi hali hizi kwa kuchukua wastani wa msongamano mzima wa aposteriori. Maelezo haya yanahusu hali za IT-DINA zilizochunguzwa katika utafiti na si ushahidi wa ubora wa jumla kwa modeli zote za saikometriki.
Hitimisho zinazoungwa mkono na utafiti
- Katika hali za uigaji zilizochunguzwa, MAP na hasa EAP kwa ujumla zilitoa matokeo thabiti zaidi kuliko MLE katika urejeshaji wa athari endelevu za testlet.
- Faida ya Bayes ilikuwa wazi zaidi katika testlet fupi na wakati muundo wa modeli ulikuwa changamano kupita kiasi au haukubainishwa kikamilifu.
- Katika hali zilizobainishwa kwa usahihi na zilizo na ubainishaji usio sahihi wa kiwango cha kati, EAP/MAP ziliweza kutoa PCCR ya juu kuliko MLE katika uainishaji wa wasifu wa sifa.
- Wakati usambazaji halisi wa sifa haulandani na usambazaji wa awali wa Bayes wa sifa uliotumika, faida ya uainishaji inaweza kutoweka au hata kugeuka kinyume.
- Katika mfano wa kimajaribio wa TIMSS, MLE, MAP na EAP zilitengeneza athari tofauti za testlet katika kiwango cha mtu na uainishaji tofauti wa uchunguzi chini ya modeli ile ile ya IT-DINA.
- Katika mfano wa kimajaribio wa TIMSS, IT-DINA ilionyesha ufaafu wa kulinganisha wa AIC/BIC ulio bora kuliko DINA na ilibadilisha usambazaji wa wasifu wa sifa.
Ujumlishaji ambao utafiti hauungi mkono
Utafiti hauungi mkono hitimisho kwamba “EAP daima ndiyo mbinu bora katika modeli zote za uchunguzi wa utambuzi”, “ukadiriaji wa Bayes huainisha kwa usahihi zaidi kuliko MLE katika kila hali”, “bloku zote za TIMSS ni testlet halisi zenye kichocheo kimoja cha pamoja”, “kutumia DINA huzalisha uainishaji usio sahihi katika kila tathmini”, au “IT-DINA lazima iwe modeli bora katika mifumo yote ya mitihani”.
Matokeo ya uigaji yalipatikana chini ya miundo iliyochaguliwa ya DINA/T-DINA/IT-DINA, idadi maalumu za sifa, ubora wa vipengee, usambazaji wa awali, mpangilio wa quadrature na algoriti ya uboreshaji. Katika matumizi ya kimajaribio, kwa kuwa wasifu halisi wa sifa haujulikani, tofauti ya uainishaji kati ya modeli na mbinu haithibitishi moja kwa moja ni wasifu upi ulio ukweli kamili.
Mapungufu ya msingi
Mpaka wa familia ya modeli: Utafiti umewekewa mipaka ya DINA, T-DINA na IT-DINA. Matokeo hayawezi kujumlishwa kiotomatiki kwa G-DINA iliyo nyumbufu zaidi au modeli nyingine za uchunguzi wa utambuzi zinazotegemea testlet.
Upotevu wa taarifa ya polytomous: Kubadilisha alama za constructed-response za TIMSS kuwa za jozi huondoa taarifa ya alama za sehemu. Kwa hiyo, matokeo ya uainishaji wa kimajaribio na ufaafu wa modeli ni mahususi kwa mfumo wa alama za jozi uliotumika.
Uwakilishi wa idadi ya watu: Matumizi ya TIMSS ni onyesho linalotegemea modeli. Uzani changamano wa sampuli haukujumuishwa wazi katika kalibresheni ya modeli au tathmini ya ufaafu. Kwa hiyo, matokeo hayapaswi kufasiriwa kama uwiano wakilishi wa idadi ya watu ya TIMSS.
Utegemezi kwa utekelezaji wa namba: Ulinganisho wa MLE, MAP na EAP unategemea algoriti ya uboreshaji iliyotumika, mkabala wa Gauss–Hermite na uchaguzi wa usambazaji wa awali. Utekelezaji mwingine wa namba unaweza kubadilisha kiasi matokeo ya namba.
Unyeti kwa usambazaji wa awali: Case 5 inaonyesha moja kwa moja kwamba usambazaji wa awali uliobainishwa vibaya, hasa kwa wasifu bainifu wa sifa, unaweza kuathiri uainishaji wa Bayes. Kwa hiyo, hitimisho rahisi la “usambazaji wa awali = uratibishaji = uboreshaji wa kiotomatiki” haliwezi kutolewa.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Evaluating Person-Parameter Estimation Methods in Cognitive-Diagnostic Models with Testlet Effects
Waandishi: Mei You, Jingjing Yang, Xin Xu.
Mpangilio wa waandishi: Mpangilio katika chanzo umehifadhiwa kama ulivyo.
Mchango sawa: Chanzo hakionyeshi alama ya uandishi wa kwanza wa pamoja au mchango sawa.
Mwandishi wa mawasiliano: Xin Xu.
Uhusiano wa kitaasisi: School of Science, Minzu University of China, Beijing 100081, China.
Jarida: Education Sciences.
Mchapishaji: MDPI.
Juzuu / toleo / namba ya makala: Volume 16, Issue 7, Article 1128.
DOI: 10.3390/educsci16071128.
Kiungo rasmi cha DOI: https://doi.org/10.3390/educsci16071128
Tarehe ya kuwasilishwa: 11 Mei 2026.
Tarehe ya marekebisho: 10 Julai 2026.
Tarehe ya kukubaliwa: 13 Julai 2026.
Tarehe ya kuchapishwa: 15 Julai 2026.
Aina ya chanzo: Article / makala ya utafiti. Utafiti si maandishi ya kinadharia ya mbinu pekee; unajumuisha kwa pamoja ulinganisho wa uigaji uliodhibitiwa na matumizi ya kimajaribio yanayotegemea modeli katika data ya TIMSS 2023.
Hali ya mapitio ya kitaalamu: Ni makala ya jarida iliyopitiwa na wataalamu na kuchapishwa katika Education Sciences.
Leseni: Creative Commons Attribution (CC BY). PDF inaeleza kwamba hakimiliki ya mwaka 2026 ni ya waandishi na kwamba MDPI, kama mwenye leseni/mchapishaji, ilichapisha utafiti chini ya masharti ya CC BY.
Ufadhili: Utafiti uliungwa mkono na Fundamental Research Funds for the Central Universities.
Bodi ya maadili ya taasisi: Chanzo kinaeleza “Not applicable”.
Ridhaa yenye taarifa: Chanzo kinaeleza “Not applicable”.
Upatikanaji wa data: Data ya umma ilitumika katika utafiti. Imeelezwa kwamba hifadhidata ya kimataifa ya TIMSS 2023 inapatikana kupitia TIMSS & PIRLS International Study Center; na kwamba matokeo ya uigaji yalizalishwa kwa mujibu wa modeli na hali za uigaji zilizoelezwa katika makala.
Mgongano wa maslahi: Waandishi hawakuripoti mgongano wa maslahi. Chanzo pia kinaeleza kwamba mfadhili hakuwa na jukumu katika usanifu wa utafiti, ukusanyaji/uchanganuzi/ufasiri wa data, uandishi wa makala au uamuzi wa kuchapisha.
Michango ya waandishi: Uundaji wa dhana Xin Xu; mbinu Xin Xu na Mei You; programu Mei You; uthibitishaji Mei You, Jingjing Yang na Xin Xu; uchanganuzi rasmi Mei You; uchunguzi Mei You; rasilimali Xin Xu; usimamizi wa data Mei You; uandishi wa rasimu ya kwanza Mei You; mapitio na uhariri Jingjing Yang na Xin Xu; uonyeshaji Mei You; usimamizi Xin Xu; usimamizi wa mradi Xin Xu; upatikanaji wa ufadhili Xin Xu.
Kutolingana ndani ya chanzo 1: Katika Jedwali 7 linalotoa matriksi ya Q ya TIMSS, misimbo miwili ya vipengee imeandikwa MQ8N208A na MQ8N208B; katika Jedwali 8 linalotoa vigezo vya vipengee, imeandikwa MQ82N08A na MQ82N08B. Kwa kuwa chanzo hakitoi maelezo ya marekebisho kuhusu hili, Verianla haijatoa dai jipya kuhusu ni tahajia ipi iliyo sahihi.
Kutolingana ndani ya chanzo 2: Katika maelezo ya mbinu ya PCCR, rejea ya msalaba kwa namba za milinganyo ya makadirio ya sifa za jozi ya MLE na MAP haionekani kulingana na milinganyo halisi ya uteuzi bainifu katika sehemu ya mbinu. Kwa hiyo, Verianla imeeleza fomula kupitia maudhui ya milinganyo na haijatoa namba mpya ya mlinganyo ambayo haipo katika chanzo.
Mpaka mkuu wa kimbinu: Utendaji wa uigaji umewekewa mipaka na idadi za testlet zilizochaguliwa, urefu wa testlet, idadi za sifa, mizigo, ubora wa vipengee, miundo ya usambazaji wa awali na utekelezaji wa namba. Matumizi ya TIMSS ni onyesho linalotegemea modeli linalotumia vipengee vya constructed-response vilivyobadilishwa kuwa vya jozi, bloku mbili za kiutendaji na uzani wa sampuli ambao haukuingizwa moja kwa moja katika modeli.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *