


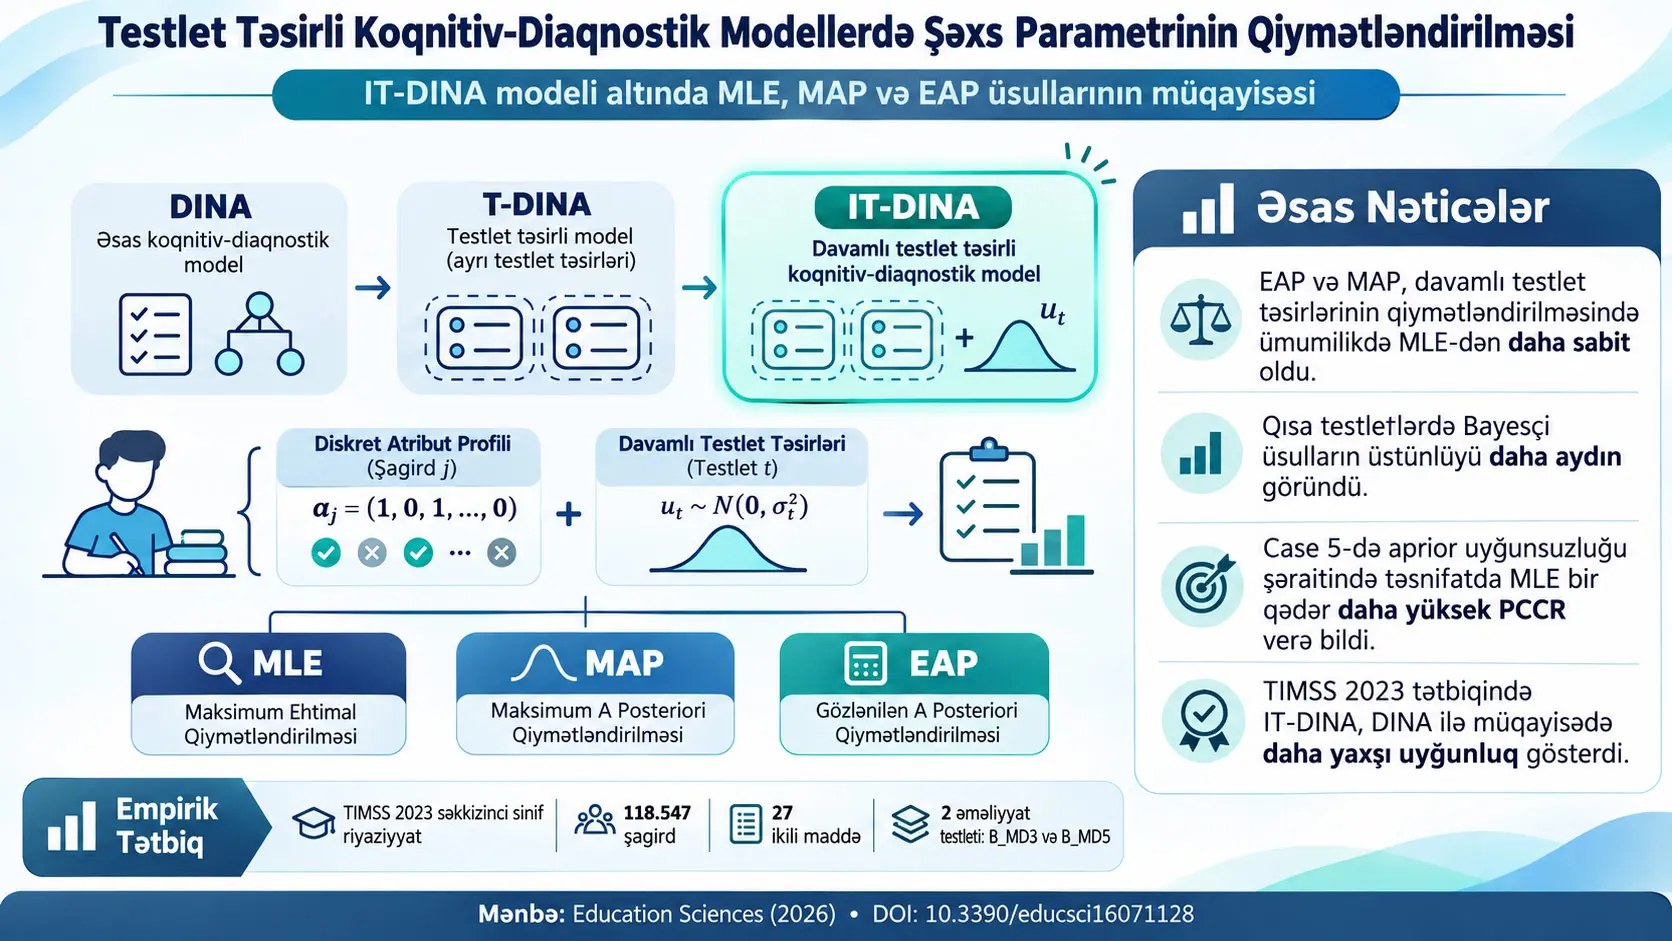
İnteraktiv Testlet DINA modeli (Interactive Testlet DINA, IT-DINA), şagirdin hansı koqnitiv atributlara malik olduğunu göstərən diskret atribut profili ilə eyni testlet daxilindəki maddələrin ortaq kontekstindən yarana bilən davamlı şəxs-səviyyəli testlet təsirlərini birlikdə modelləşdirən koqnitiv-diaqnostik modeldir. Bu tədqiqat belə qarışıq diskret-davamlı gizli quruluşda şəxs parametrlərinin necə qiymətləndiriləcəyini araşdıraraq maksimum oxşarlıq qiymətləndirilməsi (Maximum Likelihood Estimation, MLE), maksimum aposterior qiymətləndirmə (Maximum a Posteriori, MAP) və aposterior gözlənilən dəyər üzrə qiymətləndirmə (Expected A Posteriori, EAP) üsullarını müqayisə edir.
Tədqiqatın birinci hissəsi simulyasiyaya əsaslanır. Seçmə həcmi hər şərtdə 10.000 olaraq müəyyən edilmiş; üç və ya dörd testlet, hər testlet üçün 10, 20, 30, 40 və ya 50 maddə və müxtəlif model-düzgünlüyü şərtləri araşdırılmışdır. Beş simulyasiya ssenarisi; düzgün spesifikasiya olunmuş IT-DINA modelini, real testlet təsiri olmadığı halda IT-DINA-nın istifadəsini, yalnız əsas testlet təsirinin olduğu halda daha mürəkkəb IT-DINA-nın istifadəsini, real IT-DINA məlumatlarının daha sadə T-DINA modeli ilə qiymətləndirilməsini və daha yüksək atribut ölçüsü ilə qeyri-bərabər real atribut paylanmasının olduğu daha çətin şərti əhatə edir.
Simulyasiyalarda EAP və MAP, xüsusilə qısa testletlərdə və model quruluşunun lazım olduğundan daha mürəkkəb və ya natamam spesifikasiya edildiyi şərtlərdə davamlı testlet təsirlərinin bərpasında MLE ilə müqayisədə daha sabit nəticələr vermişdir. Düzgün spesifikasiya olunmuş əsas IT-DINA şərtində EAP və MAP-ın testlet-təsiri qərəzliliyi mütləq qiymətcə əsasən 0,005-dən aşağı qaldığı halda, 10 maddəlik qısa testletlərdə bəzi MLE qərəzlilikləri təxminən 0,02–0,04 səviyyəsinə çatmışdır. Eyni şərtdə Bayesçi üsulların RMSE dəyərləri testlet uzunluğu artdıqca təxminən 0,35-dən 0,20-yə enmiş, MLE isə qısa testletlərdə təxminən 0,55–0,65 RMSE göstərmişdir.
Bununla yanaşı, tədqiqat “Bayesçi üsullar hər şəraitdə üstündür” nəticəsini dəstəkləmir. Beşinci simulyasiya şərtində real atribut profilləri qeyri-bərabər paylanmadan yaradıldığı halda MAP və EAP hesablamalarında atribut profilləri üçün bərabər aprior paylanmadan istifadə olunmağa davam edilmişdir. Bu aprior uyğunsuzluğu şəraitində davamlı testlet təsirlərinin qiymətləndirilməsində Bayesçi üsullar daha sabit qalsa da, bütün atribut profilinin eyni anda düzgün təsnifatını ölçən PCCR baxımından MLE təxminən %90–93, MAP və EAP isə təxminən %87–91 aralığında nəticə vermişdir. Bu tapıntı aprior paylanma seçiminin təsnifat məqsədi baxımından elmi cəhətdən əhəmiyyətli olduğunu göstərir.
Tədqiqatın ikinci hissəsi TIMSS 2023 səkkizinci sinif riyaziyyat məlumatları ilə aparılmış empirik nümayişdir. İlkin 308.492 şagird və 68 namizəd riyaziyyat maddəsindən məlumatların təmizlənməsindən sonra 118.547 şagird və 27 ikili maddə təhlil edilmişdir. B_MD3 və B_MD5 blokları iki əməliyyat testleti kimi istifadə edilmişdir. IT-DINA bu məlumatlarda ənənəvi DINA modelindən daha aşağı AIC və BIC dəyərləri vermiş və iki model şagirdləri koqnitiv atribut profillərinə nəzərəçarpacaq dərəcədə fərqli paylamışdır. Lakin bu TIMSS tətbiqi əhali səviyyəsində təmsilçi nəticənin sübutu deyil, model davranışını real qiymətləndirmə məlumatlarında göstərən empirik nümunədir.
Koqnitiv-diaqnostik model hansı problemi həll etməyə çalışır?
Ənənəvi ölçmə modellərinin çoxu şagirdin performansını vahid davamlı qabiliyyət balı ilə xülasə etməyə çalışır. Koqnitiv-diaqnostik modellər (Cognitive-Diagnostic Models, CDMs) isə başqa sual verir: Şagird müəyyən bilik və ya bacarıq komponentlərindən hansına malikdir, hansına malik deyil? Buna görə modelin gizli dəyişəni mütləq tək bir bal olmalı deyil; bir neçə ikili koqnitiv atributdan ibarət profil ola bilər.
Məsələn, üç koqnitiv atribut olduqda şagirdin profili \((1,0,1)\) ola bilər. Buradakı 1 müvafiq atributun mənimsənildiyini, 0 isə mənimsənilmədiyini göstərir. Üç ikili atribut varsa ümumilikdə \(2^3=8\) mümkün profil; beş atribut varsa \(2^5=32\) mümkün profil vardır. Buna görə atributların sayı artdıqca şagirdin hansı gizli sinfə aid olduğunu müəyyənləşdirmə problemi də böyüyür.
Testlet Təsiri və Lokal Maddə Asılılığı Nədir?
Testlet təsiri, eyni ortaq mətn, cədvəl, ssenari, sual bloku və ya başqa kontekst daxilində təqdim olunan maddələrin, ölçülməsi nəzərdə tutulan koqnitiv atributlar nəzərə alındıqdan sonra belə bir-biri ilə əlaqəli cavab davranışı göstərə bilməsini təmsil edən əlavə gizli təsirdir. Standart modellərdə şagirdin koqnitiv atributları məlum olduqda maddələrin bir-birindən müstəqil olması gözlənilir; bu şərt ödənmirsə lokal maddə asılılığı (local item dependence, LID) mövcuddur.
Bu fərq vacibdir. Eyni mətndən istifadə edən beş sualda şagirdin həmin mətni qeyri-adi dərəcədə yaxşı və ya pis emal etməsi beş cavabın hamısına birlikdə təsir göstərə bilər. Belə ortaq təsir yalnız ölçülməsi nəzərdə tutulan bacarıqlara aid edilərsə, model ölçmə dəqiqliyini olduğundan yüksək göstərə və ya şagirdi yanlış atribut profilinə təsnif edə bilər. Testlet modelləri bu qalıq ortaq təsiri ayrıca modelləşdirməyə çalışır.
Əsas göstərim: şagird, maddə, testlet və atribut
| Simvol | Mənası | Növü |
|---|---|---|
| \(N\) | Şagird / imtahana girən şəxslərin sayı | Say |
| \(S\) | Testlet sayı | Say |
| \(J_s\) | \(s\) testletində maddələrin sayı | Say |
| \(J=\sum_{s=1}^{S}J_s\) | Ümumi maddə sayı | Say |
| \(K\) | İkili koqnitiv atributların sayı | Say |
| \(\boldsymbol{\alpha}_i\) | \(i\) şagirdinin atribut profili | \(K\)-ölçülü ikili vektor |
| \(\alpha_{ik}\) | Şagird \(i\), atribut \(k\)-ya malikdirsə 1; malik deyilsə 0 | İkili |
| \(q_{jk}\) | Maddə \(j\), atribut \(k\)-nı tələb edirsə 1 | Q-matrisinin elementi |
| \(\eta_{ij}\) | Şagird \(i\)-nin maddə \(j\) üçün tələb olunan bütün atributlara malik olub-olmadığını göstərən ideal cavab göstəricisi | İkili |
| \(Y_{ij}\) | Müşahidə olunan cavab; düzgündürsə 1, yanlışdırsa 0 | İkili |
| \(\boldsymbol{\xi}_i\) | Şagirdə aid davamlı testlet-təsiri parametrləri | Davamlı gizli vektor |
Q-matrisi nə edir?
Q-matrisi, hansı maddənin hansı koqnitiv atributu tələb etdiyini göstərən \(J\times K\) ölçülü ikili matrisdir. \(q_{jk}=1\) olduqda maddə \(j\)-nin düzgün həlli üçün atribut \(k\) tələb olunur; \(q_{jk}=0\) olduqda həmin atribut maddə üçün zəruri hesab edilmir.
Şagirdin maddə üçün ideal şəkildə tələb olunan bütün atributlara malik olub-olmadığını göstərən dəyişən mənbədə aşağıdakı birləşdirici quruluşla müəyyən edilir:
\[ \eta_{ij}=\prod_{k=1}^{K}(\alpha_{ik})^{q_{jk}} \]
Bu hasilin məntiqi bir “VƏ” qapısıdır. Maddə iki atribut tələb edirsə və şagirddə bunlardan biri yoxdursa, müvafiq vuruq 0 olur və bütün hasil \(\eta_{ij}=0\) nəticəsinə gedir. Şagird tələb olunan atributların hamısına malik olduqda \(\eta_{ij}=1\) olur.
DINA modeli: əsas başlanğıc nöqtəsi
DINA (Deterministic Inputs, Noisy “AND” Gate) modeli tələb olunan atributların hamısına malik olmağı uğur üçün birləşdirici şərt kimi qəbul edir. Bununla belə, real imtahan davranışı tam deterministik deyil: tələb olunan bütün atributlara malik şagird səhv edə bilər; tələb olunan atributlara malik olmayan şagird də təxmin yolu ilə düzgün cavab verə bilər.
Mənbə Tənlik (1):
\[ P(Y_{ij}=1\mid\boldsymbol{\alpha}_i) =(1-s_j)^{\eta_{ij}}g_j^{\,1-\eta_{ij}} \tag{1} \]
\(s_j\), maddə \(j\) üçün slipping / sürüşmə-səhv ehtimalıdır. Şagird tələb olunan bütün atributlara malik olduğu halda yanlış cavab vermə ehtimalını təmsil edir. Buna görə \(\eta_{ij}=1\) olduqda düzgün cavab ehtimalı \(1-s_j\)-dir.
\(g_j\), guessing / təxmin ehtimalıdır. Şagird tələb olunan bütün atributlara malik olmadığı halda düzgün cavab vermə ehtimalını təmsil edir. \(\eta_{ij}=0\) olduqda Tənlik (1) birbaşa \(g_j\)-yə sadələşir.
Tənliyin qüvvət quruluşu iki vəziyyəti bir formulda birləşdirir. \(\eta_{ij}=1\) olduqda \(g_j^{0}=1\) olur və yalnız \(1-s_j\) qalır. \(\eta_{ij}=0\) olduqda \((1-s_j)^0=1\) olur və yalnız \(g_j\) qalır. Buna görə formulun məqsədi yalnız cəbri yığcamlıq deyil, DINA-nın iki gizli vəziyyətini vahid cavab funksiyasında ifadə etməkdir.
Şagirdin bütün cavab vektoru \(\mathbf{y}_i=(y_{i1},\ldots,y_{iJ})\) üçün, atribut profili məlum olduqda maddələrin şərti müstəqil olduğu fərz edilirsə, mənbə Tənlik (2)-də oxşarlığı belə müəyyən edir:
\[ L(\mathbf{y}_i\mid\boldsymbol{\alpha}_i) =\prod_{j=1}^{J}P(Y_{ij}=y_{ij}\mid\boldsymbol{\alpha}_i) \tag{2} \]
Burada hasil şagirdin müşahidə olunan bütün maddə cavablarının birlikdə nə dərəcədə mümkün olduğunu hesablayır. Standart DINA-nın kritik fərziyyəsi məhz bu nöqtədədir: \(\boldsymbol{\alpha}_i\) məlum olduqda maddələr arasında başqa sistematik asılılığın qalmadığı qəbul edilir. Testlet problemi məhz bu fərziyyənin pozula bildiyi vəziyyətlə bağlıdır.
T-DINA: testlet üçün əlavə təsadüfi təsir
Testlet Effect DINA (T-DINA), eyni testlet daxilində maddələr arasında atribut profilinin izah etmədiyi ortaq təsiri təmsil etmək üçün şagird \(i\) və testlet \(s\)-ə xas davamlı \(\xi_{is}\) təsadüfi təsirini əlavə edir.
Mənbə Tənlik (3):
\[ P(Y_{ij}=1\mid\boldsymbol{\alpha}_i,\xi_{is}) =h\!\left(\delta_{0j}+\delta_{1j}\eta_{ij}+\beta_{js}\xi_{is}\right) \tag{3} \]
\(h(\cdot)\) əlaqə funksiyasıdır; mənbə logistik və ya probit əlaqədən istifadə oluna biləcəyini bildirir. \(\delta_{0j}\) maddəyə xas kəsim parametri, \(\delta_{1j}\) ideal cavab vəziyyətinin maddə üzərindəki təsirini, \(\beta_{js}\) isə testlet təsirinin maddə \(j\)-yə nə qədər güclü yükləndiyini göstərir.
\(\xi_{is}\) sıfıra yaxındırsa, testletin şagirdə xas əlavə təsiri zəifdir. Mütləq qiyməti böyüdükcə ortaq testlet komponenti xətti prediktoru daha çox dəyişir; lakin son düzgün cavab ehtimalı birbaşa xətti deyil, \(h(\cdot)\) əlaqə funksiyasından keçirilir.
IT-DINA: testlet təsiri atribut vəziyyəti ilə qarşılıqlı təsir göstərə bilir
T-DINA-da testlet təsiri şagirdin ideal cavab vəziyyətindən asılı olmayaraq əlavə olunur. IT-DINA isə bu təsirin \(\eta_{ij}\)-yə görə dəyişməsinə imkan verir.
Mənbə Tənlik (4):
\[ P(Y_{ij}=1\mid\boldsymbol{\alpha}_i,\boldsymbol{\xi}_{is}) =h\!\left[ \delta_{0j} +\delta_{1j}\eta_{ij} +\beta_{js}\xi_{is1} +\gamma_{js}(2\eta_{ij}-1)\xi_{is2} \right] \tag{4} \]
Burada \(\boldsymbol{\xi}_{is}=(\xi_{is1},\xi_{is2})^\prime\) iki komponentli testlet-təsiri vektorudur. \(\beta_{js}\xi_{is1}\) əsas testlet təsirini, \(\gamma_{js}(2\eta_{ij}-1)\xi_{is2}\) isə atribut vəziyyətindən asılı qarşılıqlı təsir komponentini təmsil edir.
\((2\eta_{ij}-1)\) terminini xüsusi funksiyası vardır. \(\eta_{ij}=1\) olduqda bu termin \(+1\), \(\eta_{ij}=0\) olduqda \(-1\) olur. Beləliklə, \(\xi_{is2}\)-nin xətti prediktora töhfəsinin istiqaməti ideal cavab vəziyyətinə görə dəyişə bilər. Bu quruluş testlet asılılığının tələb olunan atributlara malik olanlarla olmayanlarda eyni şəkildə davranmaq məcburiyyətində olmadığını modelə daxil edir.
| Model | Atribut profili | Testlet əsas təsiri | Atribut × testlet qarşılıqlı təsiri |
|---|---|---|---|
| DINA | Var | Yox | Yox |
| T-DINA | Var | Var: \(\beta_{js}\xi_{is}\) | Yox |
| IT-DINA | Var | Var: \(\beta_{js}\xi_{is1}\) | Var: \(\gamma_{js}(2\eta_{ij}-1)\xi_{is2}\) |
Şəxs parametri niyə qarışıq quruluşdur?
Tədqiqatda şagirdin bütün şəxs parametrləri
\[ \boldsymbol{\lambda}_i=(\boldsymbol{\alpha}_i,\boldsymbol{\xi}_i) \]
kimi nəzərdən keçirilir. \(\boldsymbol{\alpha}_i\) diskret atribut profilidir; məsələn, \((1,0,1)\). \(\boldsymbol{\xi}_i\) isə davamlı testlet təsirlərindən ibarətdir. Buna görə alqoritm eyni anda həm “şagird hansı gizli sinfə aiddir?”, həm də “bu şagird üçün davamlı testlet təsirinin qiyməti nədir?” suallarını həll etməlidir. Tədqiqatın MLE, MAP və EAP müqayisəsini əhəmiyyətli edən əsas riyazi çətinlik budur.
MLE, MAP və EAP Bu Tədqiqatda Necə Fərqlənir?
MLE yalnız müşahidə olunan cavabların oxşarlığını maksimum edən şəxs parametrlərini seçir; MAP həmin oxşarlığa aprior paylanma məlumatını əlavə edərək aposterior sıxlığın zirvə nöqtəsini seçir; EAP isə tək bir zirvə nöqtəsini seçmək əvəzinə bütün aposterior paylanmanı nəzərə alır və parametrin aposterior ortalamasından istifadə edir. Buna görə MAP və EAP regularizasiya təmin edə bilər, lakin onların nəticələri istifadə olunan aprior paylanmanın uyğunluğundan da asılıdır.
MLE: yalnız məlumatın oxşarlığını maksimum et
Mənbə Tənlik (5) ikili cavablar üçün şəxs səviyyəli log-oxşarlığı verir:
\[ \ell(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) = \sum_{j=1}^{J} \left[ y_{ij}\log P_{ij} + (1-y_{ij})\log(1-P_{ij}) \right] \tag{5} \]
Burada \(P_{ij}=P(Y_{ij}=1\mid\boldsymbol{\lambda}_i)\)-dir. Şagird maddəyə düzgün cavab veribsə \(y_{ij}=1\) olur və birinci termin aktivləşir; yanlış cavab veribsə \(y_{ij}=0\) olur və ikinci termin aktivləşir. Bütün maddələrin töhfələri toplanaraq müəyyən şəxs parametrlərinin müşahidə olunan cavablarla nə dərəcədə uyğun olduğu ölçülür.
MLE qiymətləndirilməsi:
\[ \widehat{\boldsymbol{\lambda}}_i^{MLE} = \operatorname*{arg\,max}_{\boldsymbol{\lambda}_i} \ell(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) \tag{6} \]
Buradakı \(\operatorname{arg\,max}\) funksiyanın ən böyük qiymətini deyil, həmin ən böyük qiyməti verən parametr qiymətini axtarır.
MAP: oxşarlığa aprior məlumat əlavə et
Mənbə Tənlik (7):
\[ \widehat{\boldsymbol{\lambda}}_i^{MAP} = \operatorname*{arg\,max}_{\boldsymbol{\lambda}_i} \left\{ \ell(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) +\log\pi(\boldsymbol{\lambda}_i) \right\} \tag{7} \]
\(\pi(\boldsymbol{\lambda}_i)\) şəxs parametrlərinin aprior sıxlığıdır. Bu tədqiqatda \(\boldsymbol{\alpha}_i\) üçün mümkün olan \(2^K\) profil üzərində bərabər aprior, davamlı testlet təsirləri üçün isə standart normal aprior istifadə edilmişdir.
Müstəqil apriorlar altında:
\[ \log\pi(\boldsymbol{\lambda}_i) = \log\pi(\boldsymbol{\alpha}_i) + \log\pi(\boldsymbol{\xi}_i), \qquad \log\pi(\boldsymbol{\xi}_i) \propto -\frac{1}{2}\boldsymbol{\xi}_i^\prime\boldsymbol{\xi}_i \]
Standart normal aprior mütləq qiyməti çox böyük olan testlet təsirlərinə cəza tətbiq edən regularizasiya təsiri yaradır. Lakin bu xüsusiyyət avtomatik olaraq “daha düzgün” demək deyil; aprior quruluşun real əhali quruluşu ilə uyğunsuzluğu xüsusilə atribut təsnifatını poza bilər. Case 5 bunun tədqiqatdakı birbaşa nümunəsidir.
EAP: aposterior paylanmanın ortalamasından istifadə et
Mənbə Tənlik (8):
\[ \widehat{\boldsymbol{\lambda}}_i^{EAP} = E[\boldsymbol{\lambda}_i\mid\mathbf{y}_i] = \int \boldsymbol{\lambda}_i p(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) \,d\boldsymbol{\lambda}_i \tag{8} \]
Burada
\[ p(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) \propto L(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) \pi(\boldsymbol{\lambda}_i) \]
aposterior sıxlıqdır. EAP-ın əsas fərqi aposterior paylanmanın yalnız ən yüksək nöqtəsindən deyil, bütün formasından istifadə etməsidir. Mənbənin müzakirəsinə görə bu ortalamaalma davranışı, xüsusilə qısa testletlərdə aposterior paylanma geniş, asimmetrik və ya qeyri-müntəzəm olduqda daha sabit şəxs qiymətləndirmələri yarada bilər.
MLE-nin IT-DINA daxilində iki mərhələli tətbiqi
Hər mümkün atribut profili \(\boldsymbol{\alpha}_c\), \(c=1,\ldots,C\) üçün və \(C=2^K\) olmaqla əvvəlcə davamlı testlet təsiri optimallaşdırılır.
Mənbə Tənlik (9):
\[ \widehat{\boldsymbol{\xi}}_i^{(c)} = \operatorname*{arg\,max}_{\boldsymbol{\xi}_i} \ell(\boldsymbol{\xi}_i\mid\mathbf{y}_i,\boldsymbol{\alpha}_c) \tag{9} \]
Bu, “şagirdin atribut profili hələlik \(\boldsymbol{\alpha}_c\) qəbul edilərsə, testlet təsirləri hansı qiymətlərdə cavabları ən yaxşı izah edir?” sualını həll edir.
Mənbə MLE üçün qradient yüksəlişindən və geri izləməli addım axtarışından istifadə edir:
\[ \boldsymbol{\xi}_i^{(m+1)} = \boldsymbol{\xi}_i^{(m)} + \gamma^{(m)} \nabla_{\xi} \ell(\boldsymbol{\xi}_i^{(m)}\mid\mathbf{y}_i,\boldsymbol{\alpha}_c) \tag{10} \]
\(\nabla_{\xi}\ell\) log-oxşarlığın testlet təsirləri istiqamətində qradientidir. Qradient funksiyanın ən sürətli artım istiqamətini göstərir. \(\gamma^{(m)}\) addım ölçüsüdür və geri izləməli xətt axtarışı ilə kifayət qədər log-oxşarlıq artımı təmin edəcək şəkildə tənzimlənir.
Hər atribut sinfi üçün ən yaxşı davamlı qiymətləndirmə tapıldıqdan sonra ən yüksək log-oxşarlığa malik sinif seçilir:
\[ \widehat{\boldsymbol{\alpha}}_i^{MLE} = \operatorname*{arg\,max}_{\boldsymbol{\alpha}_c} \ell( \widehat{\boldsymbol{\xi}}_i^{(c)} \mid \mathbf{y}_i,\boldsymbol{\alpha}_c) \tag{11} \]
MLE alqoritminin ədədi parametrləri
Mənbə alqoritmi hər gizli atribut profili üçün beş müxtəlif başlanğıcdan optimallaşdırma aparır. Birinci başlanğıc \(\boldsymbol{\xi}=0\)-dır; sonrakı başlanğıclar \(N(0,0.25I)\) paylanmasından götürülür. Məqsəd mürəkkəb oxşarlıq səthində tək başlanğıcın zəif lokal həllə ilişib qalması riskini azaltmaqdır.
| Parametr | Dəyər | Funksiyası |
|---|---|---|
| Geri izləmə əmsalı \(\rho\) | 0,8 | Addım ölçüsünü azaltma mexanizminin tənzimlənməsi |
| Armijo sabiti \(c_1\) | \(10^{-4}\) | Kifayət qədər funksiya artımı şərtinin həddi |
| Maksimum iterasiya \(M\) | 500 | Optimallaşdırmanın yuxarı iterasiya həddi |
| Yaxınlaşma həddi \(\epsilon\) | 0,001 | Qradient norması kifayət qədər kiçildikdə dayanma meyarı |
| Başlanğıcların sayı \(J_{max}\) | 5 | Lokal optimum riskini azaltmaq üçün yenidən başlatma sayı |
MAP alqoritmində nə dəyişir?
MAP eyni sinif taramasını aparır; lakin davamlı testlet təsiri yalnız log-oxşarlığı deyil, log-aprioru da daxil edən aposterior məqsədi maksimum edir.
Mənbə Tənlik (12):
\[ \widehat{\boldsymbol{\xi}}_i^{(c)} = \operatorname*{arg\,max}_{\boldsymbol{\xi}_i} \left\{ \ell(\boldsymbol{\xi}_i\mid\mathbf{y}_i,\boldsymbol{\alpha}_c) + \log\pi(\boldsymbol{\xi}_i) \right\} \tag{12} \]
Qradient yenilənməsində həm məlumatın, həm də apriorun töhfəsi mövcuddur:
\[ \boldsymbol{\xi}_i^{(m+1)} = \boldsymbol{\xi}_i^{(m)} + \gamma^{(m)} \left[ \nabla_{\xi}\ell( \boldsymbol{\xi}_i^{(m)} \mid \mathbf{y}_i,\boldsymbol{\alpha}_c) + \nabla_{\xi}\log\pi( \boldsymbol{\xi}_i^{(m)}) \right] \tag{13} \]
Son mərhələdə atribut profili aposterior məqsəd qiymətləri müqayisə edilərək seçilir:
\[ \widehat{\boldsymbol{\alpha}}_i^{MAP} = \operatorname*{arg\,max}_{\boldsymbol{\alpha}_c} \left\{ \ell( \widehat{\boldsymbol{\xi}}_i^{(c)} \mid \mathbf{y}_i,\boldsymbol{\alpha}_c) + \log\pi( \widehat{\boldsymbol{\xi}}_i^{(c)}) + \log\pi(\boldsymbol{\alpha}_c) \right\} \tag{14} \]
Atribut profilləri üçün bərabər aprior istifadə olunduqda \(\log\pi(\boldsymbol{\alpha}_c)\) bütün siniflərdə eyni sabit olduğuna görə siniflər arasındakı müqayisəni dəyişmir. Lakin real əhali profilləri bərabər paylanmırsa, bu fərziyyə təsnifat nəticələrinə təsir göstərə bilər.
EAP: optimallaşdırma əvəzinə inteqrasiya
EAP davamlı testlet təsiri üçün tək maksimum axtarmaq əvəzinə bu dəyişəni ehtimal paylanması üzərində inteqrasiya edir.
Mənbə Tənlik (15):
\[ P(\mathbf{y}_i\mid\boldsymbol{\alpha}_c) = \int P(\mathbf{y}_i\mid\boldsymbol{\xi}_i,\boldsymbol{\alpha}_c) \pi(\boldsymbol{\xi}_i) \,d\boldsymbol{\xi}_i \tag{15} \]
Bu ifadə müəyyən atribut profilinin marjinal oxşarlığıdır. Davamlı testlet təsirinin bütün mümkün qiymətləri aprior çəkiləri ilə birlikdə nəzərə alınır.
Atribut profilinin aposterior ehtimalı:
\[ P(\boldsymbol{\alpha}_c\mid\mathbf{y}_i) = \frac{ P(\mathbf{y}_i\mid\boldsymbol{\alpha}_c)\pi(\boldsymbol{\alpha}_c) }{ \sum_{d=1}^{C} P(\mathbf{y}_i\mid\boldsymbol{\alpha}_d)\pi(\boldsymbol{\alpha}_d) } \tag{16} \]
Surət müəyyən sinfin məlumat və apriorla birlikdə çəkisini, məxrəc isə bütün mümkün siniflərin çəkilərinin cəmini təmsil edir. Beləliklə nəticə 0–1 arasında həqiqi aposterior sinif ehtimalıdır.
Hər fərdi atribut üçün mənimsəmə ehtimalı:
\[ \widehat{\alpha}_{ik}^{EAP} = P(\alpha_{ik}=1\mid\mathbf{y}_i) = \sum_{c=1}^{C} I(\alpha_{ck}=1) P(\boldsymbol{\alpha}_c\mid\mathbf{y}_i) \tag{17} \]
\(I(\cdot)\) göstərici funksiyasıdır. Sinif \(c\) atribut \(k\)-ya malikdirsə 1, əks halda 0 olur. Beləliklə həmin atributa malik bütün siniflərin aposterior ehtimalları toplanır.
Davamlı testlet təsirlərinin EAP qiymətləndirilməsi:
\[ \widehat{\boldsymbol{\xi}}_i^{EAP} = \int \boldsymbol{\xi}_i p(\boldsymbol{\xi}_i\mid\mathbf{y}_i) \,d\boldsymbol{\xi}_i \tag{18} \]
Mənbə bunu sinif-şərti gözlənilən dəyərlərin atribut siniflərinin aposterior ehtimalları ilə çəkiləndirilmiş ortalaması kimi hesablayır. Bu yanaşma bütün çəkini bir sinfə və bir davamlı maksimum nöqtəsinə vermək əvəzinə qeyri-müəyyənliyi paylanma vasitəsilə daşıyır.
Gauss–Hermite kvadraturası niyə istifadə olunur?
Tənlik (15) və (18)-dəki inteqrallar qapalı formada asanlıqla hesablanmadığı üçün tədqiqat Gauss–Hermite quadrature (GHQ) istifadə edir. Mənbə EAP alqoritmində hər davamlı ölçü üçün 20 Gauss–Hermite düyünü istifadə edir. İkiölçülü IT-DINA testlet təsiri üçün tensor hasililə ümumilikdə \(20^2=400\) kvadratura nöqtəsi yaranır.
Hər kvadratura nöqtəsində cavab oxşarlığı hesablanır, Gauss–Hermite çəkisi ilə vurulur və bu çəkili qiymətlər toplanaraq inteqrala ədədi yaxınlaşma əldə edilir. Buradakı 400 dəyəri yeni şagird və ya yeni məlumat deyil; davamlı inteqralın təxmini hesabında istifadə olunan ədədi qiymətləndirmə nöqtələridir.
Simulyasiyada DINA parametrləri probit şkalasına necə keçirilir?
Simulyasiyanın başlanğıcında sürüşmə \(s_j\) və təxmin \(g_j\) dəyərləri \(U(0.05,0.20)\) bərabər paylanmasından yaradılır. Sonra probit şkalasındakı maddə parametrləri aşağıdakı kimi qurulur:
\[ \delta_{0j}=\Phi^{-1}(g_j) \]
\[ \delta_{1j} = \Phi^{-1}(1-s_j) - \Phi^{-1}(g_j) \]
\(\Phi\) standart normal paylanmanın kumulyativ paylanma funksiyası, \(\Phi^{-1}\) isə onun tərsidir. Beləliklə, ehtimal şkalasındakı təxmin və sürüşmə dəyərləri probit xətti prediktor şkalasına keçirilir.
Testlet təsirləri əlavə olunduqda real maddə ehtimalları niyə dəyişir?
Testlet təsadüfi təsirləri probit modelinə əlavə olunduqda marjinal düzgün cavab ehtimalları başlanğıcda seçilmiş \(g_j\) və \(1-s_j\) dəyərləri ilə tam eyni qalmır. Mənbə bu yeni model-törəmə ehtimalları Tənlik (19) və (20) ilə verir.
Tələb olunan atributlara malik şagird üçün marjinal düzgün cavab ehtimalı:
\[ c_{js}^{*} = \Phi\left( \frac{ \delta_{0j}+\delta_{1j} }{ \sqrt{ 1+\sigma_{\xi}^{2} (\beta_{js}^{2}+\gamma_{js}^{2}) } } \right) \tag{19} \]
Tələb olunan atributlara malik olmayan şagird üçün marjinal düzgün cavab ehtimalı:
\[ g_{js}^{*} = \Phi\left( \frac{ \delta_{0j} }{ \sqrt{ 1+\sigma_{\xi}^{2} (\beta_{js}^{2}+\gamma_{js}^{2}) } } \right) \tag{20} \]
Tədqiqatda \(\sigma_{\xi}^{2}=0.25\), yəni testlet təsirlərinin standart kənarlaşması 0,5-dir. Modeldə testlet yüklərinin kvadratları məxrəcə daxil olduğundan yüklərin mütləq böyüklüyü marjinal miqyaslamaya təsir edir. Case 5-də işarələrin müsbət və ya mənfi olması bu xüsusi marjinal ehtimal aralıqlarını dəyişmir; çünki Tənlik (19) və (20)-də \(\beta^2\) və \(\gamma^2\) istifadə olunur.
\(1-c_{js}^{*}\) modelin nəzərdə tutduğu sürüşmə ehtimalıdır. Buna görə başlanğıcda \(s_j\) və \(g_j\) 0,05–0,20 arasında seçilmiş olsa belə, testlet təsirləri əlavə edildikdən sonra model-törəmə sürüşmə və təxmin ehtimalları eyni sərhədlər daxilində qalmaq məcburiyyətində deyil.
Qərəzlilik nəyi ölçür?
Mənbə Tənlik (21):
\[ Bias(\widehat{\boldsymbol{\xi}}) = \frac{1}{N} \sum_{i=1}^{N} ( \widehat{\boldsymbol{\xi}}_i - \boldsymbol{\xi}_i ) \tag{21} \]
Qərəzlilik qiymətləndirmələrin real testlet təsirlərindən sistematik olaraq hansı istiqamətdə kənarlaşdığını göstərir. Sıfıra yaxın dəyər müsbət və mənfi sistematik xətanın aşağı olduğunu göstərir. Lakin təkcə aşağı Bias kifayət deyil; böyük, lakin bir-birini kompensasiya edən müsbət və mənfi xətalar orta hesabla sıfıra yaxınlaşa bilər.
RMSE nəyi ölçür?
Mənbə Tənlik (22):
\[ RMSE(\widehat{\boldsymbol{\xi}}) = \sqrt{ \frac{1}{N} \sum_{i=1}^{N} \left\| \widehat{\boldsymbol{\xi}}_i - \boldsymbol{\xi}_i \right\|^2 } \tag{22} \]
RMSE qiymətləndirmə ilə real dəyər arasındakı xətanın böyüklüyünü ölçür və böyük xətaları kvadrata yüksəltmə səbəbilə daha güclü cəzalandırır. Aşağı RMSE daha düzgün davamlı testlet-təsiri bərpası deməkdir.
PCCR niyə sərt təsnifat meyarıdır?
Mənbə Tənlik (23):
\[ PCCR = \frac{1}{N} \sum_{i=1}^{N} I( \widehat{\boldsymbol{\alpha}}_i = \boldsymbol{\alpha}_i ) \tag{23} \]
Pattern-wise Correct Classification Rate (PCCR) yalnız ayrı-ayrı bacarıqların düzgün təsnif edilməsini deyil, şagirdin bütün atribut profilinin tamamilə düzgün olmasını tələb edir. Məsələn, real profil \((1,1,0)\) olduğu halda \((1,0,0)\) qiymətləndirilibsə, üç atributdan ikisi düzgün olsa da, PCCR baxımından bütün profil yanlış sayılır. Buna görə PCCR sərt meyardır.
EAP başlanğıcda ikili profil əvəzinə hər atribut üçün 0–1 arasında aposterior mənimsəmə ehtimalı yaradır. Mənbə müqayisəni eyni ikili şkalaya gətirmək üçün 0,50 həddindən istifadə edir:
\[ \widehat{\alpha}_{ik}^{binary} = I\left[ P(\alpha_{ik}=1\mid\mathbf{y}_i)\geq0.50 \right] \tag{24} \]
Monte Carlo standart xətası niyə hesablandı?
Bütün simulyasiya şərtləri müstəqil olaraq \(R=500\) dəfə təkrar edilmişdir. PCCR-in bu təkrarlar arasındakı dəyişkənliyini göstərmək üçün Monte Carlo standart xətası hesablanmışdır:
\[ \widehat{MCSE}(PCCR) = \frac{ SD\left( PCCR^{(1)},\ldots,PCCR^{(R)} \right) }{ \sqrt{R} } \tag{25} \]
Burada \(SD\), 500 təkrar boyunca əldə olunan PCCR dəyərlərinin seçmə standart kənarlaşmasıdır. PCCR faizlə ifadə edildikdə MCSE də faiz bəndi ilə şərh olunur.
Tədqiqatın Metodu və Nəticələri
Simulyasiya dizaynı
Tədqiqat MLE, MAP və EAP-ı beş müxtəlif məlumat yaratma/qiymətləndirmə ssenarisində müqayisə etmişdir. Bütün əsas şərtlərdə seçmə həcmi 10.000 nəfərdir. Testlet sayı 3 və ya 4, hər testletdəki maddə sayı isə 10, 20, 30, 40 və ya 50 olaraq dəyişdirilmişdir.
Case 1–4 üçün \(K=3\) və səkkiz atribut profilinin bərabər ehtimallı olduğu bərabər əhali quruluşundan istifadə edilmişdir. Case 5-də \(K=5\)-ə qaldırılmış və real atribut profili paylanması bərabər olmaqdan çıxarılmışdır.
| Şərt | Real məlumat modeli | Qiymətləndirmə modeli | \(\beta\) | \(\gamma\) | Əsas məqsəd |
|---|---|---|---|---|---|
| Case 1 | IT-DINA | IT-DINA | 0,5 | 0,5 | Düzgün spesifikasiya olunmuş əsas IT-DINA şərti |
| Case 2 | DINA | IT-DINA | 0 | 0 | Reallıqda testlet təsiri olmadığı halda lazım olduğundan mürəkkəb modelin istifadəsi |
| Case 3 | T-DINA | IT-DINA | 1 | 0 | Əsas testlet təsiri olduğu halda lazımsız qarşılıqlı təsir komponentinin əlavə edilməsi |
| Case 4 | IT-DINA | T-DINA | 0,5 | 1 | Real qarşılıqlı təsir komponentinin qiymətləndirmə modelindən çıxarılması |
| Case 5 | IT-DINA | IT-DINA | Mütləq qiymət 0,5; qarışıq işarə | Mütləq qiymət 1; qarışıq işarə | Daha yüksək ölçü, qeyri-bərabər əhali və qarışıq işarəli yüklər altında dayanıqlıq |
Case 5-də real atribut paylanması necə yaradıldı?
Beş atribut olduğuna görə 32 mümkün profil vardır. Real əhalidə sıfır, bir və ya iki atribut mənimsənilmiş profillər üçün sinif ehtimalı \(\pi_c=1/48\); üç və ya daha çox atribut mənimsənilmiş profillər üçün isə \(\pi_c=1/24\) olaraq müəyyən edilmişdir. Beləliklə yüksək mənimsəmə profillərinin sinif ehtimalı aşağı mənimsəmə profillərininkindən iki dəfə çox olmuşdur.
Buna baxmayaraq, MAP və EAP üçün bütün Case 1–5 şərtlərində atribut profilləri üzərində bərabər aprior istifadə olunmağa davam edilmişdir. Case 5-in elmi əhəmiyyəti məhz bundadır: real əhali quruluşu ilə Bayesçi atribut aprioru qəsdən uyğunsuzdur.
Model-törəmə təxmin və sürüşmə ehtimalları
| Şərt | \(\beta\) | \(\gamma\) | \(g^*\) aralığı | \(1-c^*\) aralığı |
|---|---|---|---|---|
| Case 1 | 0,5 | 0,5 | 0,0605–0,2137 | 0,0605–0,2137 |
| Case 2 | 0 | 0 | 0,0500–0,2000 | 0,0500–0,2000 |
| Case 3 | 1 | 0 | 0,0706–0,2257 | 0,0706–0,2257 |
| Case 4 | 0,5 | 1 | 0,0755–0,2312 | 0,0755–0,2312 |
| Case 5 | ±0,5 | ±1 | 0,0755–0,2312 | 0,0755–0,2312 |
Case 1: düzgün spesifikasiya olunmuş IT-DINA
Bu əsas şərtdə həm məlumat yaratma, həm də qiymətləndirmə modeli IT-DINA-dır. EAP və MAP testlet-təsiri qərəzliliyini mütləq qiymətcə ümumiyyətlə 0,005-dən aşağı saxlamışdır. MLE-də 10 maddəlik testletlərdə bəzi testlet təsirləri üçün mütləq qərəzlilik təxminən 0,02–0,04-ə çatmışdır. Testlet 50 maddəyə uzandıqda MLE qərəzliliyi azalmış, lakin təxminən 0,01 səviyyəsində qalmışdır.
RMSE baxımından EAP və MAP testlet uzunluğu artdıqca təxminən 0,35-dən 0,20-yə enmişdir. MLE 10 maddəlik testletlərdə təxminən 0,55–0,65 RMSE göstərmiş; hətta 50 maddədə belə təxminən 0,30–0,35 səviyyəsində qalmışdır.
PCCR baxımından Bayesçi üsullar ümumilikdə %97-dən yuxarı olmuş, 50 maddəyə doğru təxminən %98,5-ə çatmış, MLE isə təxminən %93–95 aralığında qalmışdır.
Case 2: reallıqda testlet təsiri yoxdur, lakin IT-DINA qiymətləndirilir
Bu şərtdə \(\beta=\gamma=0\)-dır. Başqa sözlə, məlumat yaratma prosesində testlet təsirləri cavab ehtimallarını dəyişmir; buna baxmayaraq qiymətləndirmədə tam IT-DINA modeli istifadə olunur. Bu, lazımsız davamlı komponentlərin modelə əlavə olunmasına qarşı üsulların davranışını sınaqdan keçirir.
EAP və MAP üçün testlet-təsiri qərəzlilikləri sıfıra çox yaxın, RMSE dəyərləri isə təxminən 0,49–0,50 tapılmışdır. MLE qərəzliliklərinin mütləq qiyməti təxminən 0,003–0,006, RMSE-si isə təxminən 0,55–0,69 aralığındadır.
Buradakı 0,49–0,50 RMSE ehtiyatla oxunmalıdır. Mənbədə şəxs testlet dəyişənləri \(N(0,0.5^2)\) şkalasında yaradıldığı halda onların cavablar üzərindəki yükləri sıfırdır. Buna görə cavab məlumatı fərdi testlet təsirlərini müəyyənləşdirmək üçün birbaşa məlumat daşımır. Bayesçi regularizasiya qiymətləndirmələri aprior mərkəzinə yaxın saxlayır; mənbə bu davranışı lazımsız komponentlərin qeyri-sabitləşməsini məhdudlaşdırması baxımından şərh edir.
Case 3: real model T-DINA, qiymətləndirmə IT-DINA
Real məlumatlarda əsas testlet təsiri vardır, lakin qarşılıqlı təsir komponenti yoxdur. IT-DINA isə hər iki komponenti qiymətləndirməyə çalışır.
Real əsas təsir komponentlərində EAP qərəzliliyi mütləq qiymətcə 0,001-dən aşağı qalmış və RMSE təxminən 0,43-dən 0,34-ə enmişdir. MAP qərəzliliyi təxminən 0,001–0,006; RMSE-si 0,40–0,50 aralığındadır. MLE-nin qərəzliliyi təxminən 0,004–0,02, RMSE-si isə təxminən 0,50–0,69-dur.
Reallıqda mövcud olmayan qarşılıqlı təsir komponentində EAP və MAP-ın qərəzliliyi yenə sıfıra çox yaxın qaldığı halda RMSE təxminən 0,49–0,50 ətrafında olmuşdur. MLE lazımsız komponentdə daha yüksək qərəzlilik və RMSE göstərmişdir.
Case 4: real IT-DINA, lakin qiymətləndirmə daha sadə T-DINA
Bu şərt lazım olduğundan mürəkkəb modelin əksini sınaqdan keçirir. Real məlumatda həm əsas testlet təsiri, həm də qarşılıqlı təsir vardır, lakin qiymətləndirmə modeli qarşılıqlı təsirlə əlaqəli \(\xi_2\) komponentini ehtiva etmir.
EAP üç və dörd testlet şərtlərində ümumilikdə ən kiçik Bias və RMSE-ni vermişdir. MAP əksər şərtlərdə EAP-a yaxın qalmışdır. MLE xüsusilə qısa testletlərdə daha çox dəyişkənlik göstərmişdir. Mənbə düzgün spesifikasiya olunmuş Case 1 ilə müqayisədə MLE qərəzliliyinin təxminən 2–5 dəfə arta bildiyini və qısa testletlərdə RMSE-nin 0,80-i keçə bildiyini bildirir.
Təsnifatda qısa testletlər üçün EAP ilə MLE arasındakı PCCR fərqi təxminən 6–7 faiz bəndinə çatmışdır. Bu nəticə yalnız model seçiminin deyil, şəxs parametrinin qiymətləndirilməsi üsulunun da natamam spesifikasiya olunmuş modellərdə diaqnostik nəticəni dəyişə bildiyini göstərir.
Bayesçi Üsullar Hər Şəraitdə Daha Yaxşı İdimi?
Xeyr. EAP və MAP beşinci simulyasiya şərtində davamlı testlet təsirlərinin Bias və RMSE-si baxımından MLE-dən daha sabit qalsa da, bütün atribut profilini düzgün təsnif edən PCCR metrikasında MLE bir qədər yüksək nəticə vermişdir. Mənbə bunu real atribut profili paylanmasının bərabər olmaması ilə MAP/EAP-ın bərabər atribut apriorundan istifadə etməsi arasındakı uyğunsuzluqla əlaqələndirir; buna görə Bayesçi üstünlük apriorun düzgünlüyündən asılı deyil deyil.
Case 5: aprior paylanma uyğunsuz olduqda nə baş verdi?
EAP və MAP-ın davamlı testlet təsirlərindəki Bias dəyərləri kiçik qalmış, MLE isə xüsusilə qısa testletlərdə daha yüksək RMSE yaratmışdır. Bunun əksinə, PCCR-də EAP və MAP təxminən %87–91, MLE isə təxminən %90–93 aralığındadır.
Bu nəticə iki fərqli qiymətləndirmə məqsədinin eyni şey olmadığını göstərir. Bir üsul davamlı testlet təsirini daha yaxşı bərpa etdiyi halda, diskret atribut profilini eyni anda daha yaxşı təsnif etmək məcburiyyətində deyil. Xüsusilə Bayesçi təsnifat real əhali paylanması ilə uyğun gəlməyən profil apriorundan təsirlənə bilər.
PCCR üçün simulyasiya dəyişkənliyi
500 müstəqil təkrar əsasında hesablanan MCSE dəyərləri bütün şərtlərdə təxminən %0,08–%1,50 aralığındadır. Case 1–3-də dəyərlər ümumiyyətlə %1-dən aşağı qalmışdır. Case 4-də xüsusilə MLE üçün dəyişkənlik artmış; ən yüksək MCSE dəyərləri daha yüksək atribut ölçüsü və daha aşağı təsnifat dəqiqliyi olan Case 5-də təxminən %1,17–%1,50 aralığında görülmüşdür.
Testletin uzunluğu, yoxsa testlet sayı daha vacib idi?
Mənbənin müzakirəsinə görə bu simulyasiya şərtlərində hər testlet üzrə maddə sayını artırmaq, testlet sayını artırmaqdan daha böyük dəqiqlik qazancı yaratmışdır. Riyazi baxımdan bu, eyni davamlı testlet təsiri haqqında daha çox maddə cavabının məlumat verməsi deməkdir.
Lakin tədqiqat bu nəticəni universal imtahan dizaynı qaydasına çevirmir. Simulyasiyada atribut ölçüsü, maddə keyfiyyəti və model quruluşu müəyyən sərhədlər daxilindədir; daha yüksək ölçülü, daha zəif maddə məlumatına malik və ya daha səs-küylü qiymətləndirmələrdə eyni böyüklükdə qazanca zəmanət verilmir.
TIMSS 2023 empirik tətbiqi necə yaradıldı?
Empirik nümayişdə TIMSS 2023 səkkizinci sinif riyaziyyat beynəlxalq məlumat bazasından istifadə edilmişdir. Başlanğıcda 308.492 şagird və qiymətləndirmə kitabçaları üzrə 68 namizəd riyaziyyat maddəsi olmuşdur. Cavabsız və ya etibarsız cavablar itkin dəyər kimi işarələnmiş; beşdən az etibarlı cavabı olan şagirdlər çıxarılmış və yekun şəxs seçməsi 118.547 olmuşdur.
Tədqiqat TIMSS-in rotasiya olunan kitabça dizaynındakı maddə bloklarını əməliyyat testlet vahidi kimi istifadə etmişdir. B_MD3 və B_MD5, eyni seçilmiş kitabça daxilində eyni cavabdeh qrupuna tətbiq olunmaları və məlumatların təmizlənməsindən sonra kifayət qədər maddə-səviyyəli dəyişkənliyi saxlamaları səbəbilə seçilmişdir.
Burada mühüm terminoloji sərhəd vardır: mənbə TIMSS bloklarının dar mənada vahid ortaq stimulu paylaşan klassik “testlet” olmaq məcburiyyətində olmadığını açıq şəkildə bildirir. Bunlar eyni blok daxilində qalan qalıq asılılığı modelləşdirmək məqsədilə əməliyyat testletləri kimi istifadə edilmişdir.
Polytomous maddələr niyə ikili hala gətirildi?
Seçilmiş constructed-response maddələrinin orijinal TIMSS balları birdən çox bal kateqoriyasına malik ola bilər. DINA, T-DINA və IT-DINA-nın bu tədqiqatda istifadə olunan formaları ikili cavablara əsaslandığı üçün sıfırdan böyük bütün ballar düzgün = 1, sıfır bal yanlış = 0 kimi yenidən kodlanmışdır.
Bu çevrilmə qismən kredit məlumatını itirir. Buna görə, məsələn, 1 bal və 2 bal alan iki şagirdin hər ikisi “düzgün” kateqoriyasına daxil ola bilər. Mənbə bunu tədqiqatın mühüm məhdudiyyətlərindən biri kimi açıq şəkildə qəbul edir.
| Mərhələ | Mənbədə verilən quruluş |
|---|---|
| Başlanğıc şəxs sayı | 308.492 |
| Namizəd riyaziyyat maddəsi | 68 |
| Şəxs çıxarma meyarı | 5-dən az etibarlı cavabı olan şagird çıxarıldı |
| Yekun şəxs sayı | 118.547 |
| Əməliyyat testletləri | B_MD3 və B_MD5 |
| Yekun maddə sayı | 27 ikili maddə |
| B_MD3 | 15 maddə |
| B_MD5 | 12 maddə |
| Atributlar | Applying 11, Knowing 4, Reasoning 12 maddə |
TIMSS Q-matrisi necə quruldu?
TIMSS riyaziyyat maddələrinin rəsmi koqnitiv sahə təsnifatı tədqiqatda üç ikili diaqnostik atribut kimi istifadə edilmişdir: Knowing (Bilmə), Applying (Tətbiq) və Reasoning (Mühakimə). Hər analiz maddəsi yalnız bir koqnitiv sahəyə təyin edilmişdir; buna görə Q-matrisinin hər sətrində yalnız bir 1 vardır.
27 maddədən 11-i Applying, 4-ü Knowing və 12-si Reasoning kimi kodlanmışdır. Bu, istifadə olunan Q-matrisinin ümumi çox-atributlu CDM-lərlə müqayisədə kifayət qədər sadə quruluşa malik olduğunu göstərir. Tədqiqatın müzakirəsində yüksək təsnifat dərəcələrinin daha yüksək atribut ölçüsünə və ya daha mürəkkəb Q-matrislərinə birbaşa ümumiləşdirilməməli olduğu xüsusi vurğulanır.
Mənbə daxilində TIMSS maddə kodu uyğunsuzluğu
Mənbə Cədvəl 7-də B_MD3 daxilində iki maddə kodu MQ8N208A və MQ8N208B kimi göründüyü halda, eyni maddələrin parametr cədvəli olan Cədvəl 8-də kodlar MQ82N08A və MQ82N08B formasında verilmişdir. Mənbə bu fərq üçün düzəliş qeydi təqdim etmədiyinə görə Verianla mətni iki yazılışdan birini səssizcə “düzgün” elan etmir.
Empirik maddə parametrlərinin şkalası
MLE, MAP və EAP şəxs qiymətləndirmələrinin müqayisəsində maddə parametrləri əvvəlcədən kalibrlənmiş və sabit saxlanmışdır. Beləliklə, müqayisə zamanı üsullar arasındakı fərqin maddə parametrlərinin yenidən qiymətləndirilməsindən yaranmasının qarşısı alınmağa çalışılmışdır.
Mənbə Cədvəl 8-də 27 maddə üçün \(\delta_0\), \(\delta_1\), standart xətalar və pass rate dəyərləri verilir. \(\delta_0\) dəyərləri təxminən −4,06 ilə −0,86, \(\delta_1\) dəyərləri təxminən −3,20 ilə 3,88, pass rate isə təxminən 0,03 ilə 0,24 arasında dəyişir.
Mənbə xüsusilə bəzi \(\delta_1\) dəyərlərinin mənfi olduğunu və bunların ehtiyatla şərh edilməli olduğunu bildirir. Riyazi olaraq mənfi \(\delta_1\), Tənlik (3) və ya (4)-də digər komponentlər sabit olduğu halda \(\eta\)-nın 0-dan 1-ə keçməsinin xətti prediktoru artırmaq əvəzinə azaltması deməkdir. Mənbə bu qeyri-adi işarələrin səbəbini yeni mexanizm kimi sübut etmədiyinə görə Verianla da bunun səbəbini fərz etmir.
Empirik hesablama mühiti
Bütün analizlər R 4.2.0 mühitində və böyük seçmə səbəbilə paralel hesablama istifadə edilərək aparılmışdır. Modelin yaxınlaşma meyarı ardıcıl iterasiyalardakı parametr dəyişiminin mütləq fərqinin 0,001-dən kiçik olmasıdır; maksimum iterasiya sayı 500 olaraq müəyyən edilmişdir.
MLE, MAP və EAP-ın TIMSS üzərində atribut profilləri
| Profil | EAP | MAP | MLE |
|---|---|---|---|
| (0,0,0) | 12.045 (%10,16) | 11.892 (%10,03) | 8.273 (%6,98) |
| (1,0,0) | 10.342 (%8,72) | 10.101 (%8,52) | 7.464 (%6,30) |
| (0,1,0) | 8.976 (%7,57) | 8.743 (%7,37) | 6.739 (%5,68) |
| (0,0,1) | 18.342 (%15,48) | 18.567 (%15,66) | 32.479 (%27,40) |
| (1,1,0) | 9.543 (%8,05) | 9.321 (%7,86) | 7.158 (%6,04) |
| (1,0,1) | 14.237 (%12,01) | 14.512 (%12,24) | 12.089 (%10,20) |
| (0,1,1) | 12.876 (%10,86) | 13.045 (%11,00) | 11.724 (%9,89) |
| (1,1,1) | 32.186 (%27,15) | 32.366 (%27,31) | 32.621 (%27,52) |
EAP və MAP-ın səkkiz profil üzrə faizləri bir-birinə çox yaxındır; hər profil üçün fərq %0,5-dən aşağıdır. MLE-nin paylanması isə xüsusilə \((0,0,1)\) profilində fərqlənir: MLE bu sinfə 32.479 şagird, EAP 18.342 və MAP 18.567 şagird təyin etmişdir.
Testlet təsiri paylanmalarında nə müşahidə olundu?
Mənbə Şəkil 11 iki əməliyyat testleti üçün \(\xi_1\) və \(\xi_2\) qiymətləndirmələrinin EAP, MAP və MLE paylanmalarını qutu qrafikləri ilə müqayisə edir. EAP dəyərləri sıfır ətrafında ən sıx və ən dar kvartillərarası aralığa malikdir. MAP bir qədər daha genişdir, lakin MLE-dən daha sıx qalır. MLE-də qutular, whisker-lər və kənar dəyərlər daha genişdir.
Şəklin xam şəxs-səviyyəli dəyərləri və ya bütün qutu qrafiki xülasələri mənbədə cədvəl şəklində verilmədiyinə görə Verianla tərəfindən saxta ədədi qutu qrafiki yenidən çəkilməmişdir. Elmi mesaj mətn və aşağıdakı sıralama korrelyasiyaları vasitəsilə qorunmuşdur.
Kendall sıra korrelyasiyaları
| Parametr | EAP–MAP | EAP–MLE | MAP–MLE |
|---|---|---|---|
| \(\xi_1\), T1 | 0,976 | 0,634 | 0,616 |
| \(\xi_1\), T2 | 0,981 | 0,578 | 0,642 |
| \(\xi_2\), T1 | 0,969 | 0,561 | 0,655 |
| \(\xi_2\), T2 | 0,982 | 0,553 | 0,649 |
EAP–MAP korrelyasiyalarının hamısı 0,96-dan yuxarıdır; bu iki üsul şagirdlərin testlet-təsiri sıralamalarında çox oxşar davranmışdır. MLE ilə Bayesçi üsullar arasındakı korrelyasiyalar təxminən 0,55–0,65 aralığında qalmış və yalnız orta səviyyəli uyğunluğa işarə etmişdir.
EAP ilə MAP təsnifatları nə qədər oxşar idi?
Mənbə keçid matrisində EAP-dan MAP-a təsnifatların bütün səkkiz atribut profili üçün diaqonal nisbətlərinin %93-dən yuxarı olduğunu bildirir. Bu, iki Bayesçi üsulun yalnız ümumi profil paylanmalarında deyil, şəxs səviyyəsində də böyük ölçüdə eyni sinifləri seçdiyini göstərir.
EAP ilə MLE arasındakı sistematik sürüşmə
EAP–MLE keçid matrisi daha aydın ayrışma göstərmişdir. EAP tərəfindən \((1,1,0)\) kimi təsnif olunan 9.543 şagirdin 1.571-i, yəni təxminən %16,5-i MLE tərəfindən \((0,0,1)\) profilinə keçirilmişdir.
Daha güclü sürüşmələr \((0,0,0)\) və \((1,0,0)\) profillərində müşahidə edilmişdir. EAP-ın \((0,0,0)\) qrupundakıların təxminən %24,4-ü, \((1,0,0)\) qrupundakıların isə təxminən %25,2-si MLE tərəfindən \((0,0,1)\)-ə təyin edilmişdir.
Bu tapıntı real profilin EAP olduğu demək deyil; empirik TIMSS tətbiqində real gizli atribut profilləri məlum deyil. Nəticə yalnız müxtəlif şəxs-parametri qiymətləndirmə üsullarının eyni IT-DINA modeli və eyni məlumatlar altında fərqli diaqnostik təsnifatlar yarada bildiyini göstərir.
Testlet Təsirlərini Nəzərə Almamaq Diaqnostik Təsnifatı Dəyişə Bilərmi?
Bu TIMSS empirik nümunəsində bəli. Testlet təsirlərini və onların atribut vəziyyəti ilə qarşılıqlı təsirlərini modelləşdirən IT-DINA, lokal müstəqillik fərz edən DINA ilə müqayisədə daha yaxşı nisbi uyğunluq göstərmiş və şagirdlərin atribut profili paylanmasını nəzərəçarpacaq dərəcədə dəyişmişdir. Lakin bu nəticə bütün TIMSS tətbiqlərində və ya bütün imtahanlarda IT-DINA-nın avtomatik olaraq üstün olacağı demək deyil; mənbə bunu müəyyən məlumat emalı və modelləşdirmə şərtlərində empirik nümayiş kimi təqdim edir.
DINA ilə IT-DINA model uyğunluğu
| Model | Log-oxşarlıq | Parametr sayı | AIC | BIC |
|---|---|---|---|---|
| DINA | −1.523.456,23 | 54 | 3.047.020,5 | 3.047.520,3 |
| IT-DINA | −1.517.221,78 | 58 | 3.034.559,6 | 3.035.019,8 |
IT-DINA dörd əlavə parametr istifadə etməsinə baxmayaraq AIC və BIC dəyərləri təxminən 12.000 daha aşağıdır. Mənbə həmçinin \(\Delta LL=6234,45\), \(\Delta df=4\) və \(p<0,001\) bildirir. Bu nəticələr bu empirik məlumat və bu model müqayisəsi daxilində IT-DINA-nın DINA ilə müqayisədə daha yaxşı nisbi uyğunluq göstərdiyini dəstəkləyir.
DINA və IT-DINA şagirdləri necə fərqli təsnif etdi?
| Profil | IT-DINA (EAP) | DINA | DINA − IT-DINA şəxs fərqi |
|---|---|---|---|
| (0,0,0) | 12.045 (%10,16) | 8.273 (%6,98) | −3.772 |
| (1,0,0) | 10.342 (%8,72) | 7.464 (%6,30) | −2.878 |
| (0,1,0) | 8.976 (%7,57) | 6.739 (%5,68) | −2.237 |
| (0,0,1) | 18.342 (%15,48) | 32.479 (%27,40) | +14.137 |
| (1,1,0) | 9.543 (%8,05) | 7.158 (%6,04) | −2.385 |
| (1,0,1) | 14.237 (%12,01) | 12.089 (%10,20) | −2.148 |
| (0,1,1) | 12.876 (%10,86) | 11.724 (%9,89) | −1.152 |
| (1,1,1) | 32.186 (%27,15) | 32.621 (%27,52) | +435 |
Ən böyük fərq \((0,0,1)\) profilindədir. DINA 32.479 şagirdi, IT-DINA EAP isə 18.342 şagirdi bu profilə təyin etmişdir; fərq 14.137 şagirddir. Mənbə analizdəki bir çox maddənin Reasoning atributu ilə əlaqəli olması səbəbilə bu sürüşmənin diaqnostik şərh baxımından əhəmiyyətli olduğunu bildirir.
DINA; \((0,0,0)\), \((1,0,0)\) və \((0,1,0)\) aşağı-mənimsəmə profillərini IT-DINA ilə müqayisədə ümumilikdə 8.887 nəfər daha az; \((1,1,0)\), \((1,0,1)\) və \((0,1,1)\) çox-atributlu profilləri isə ümumilikdə təxminən 5.685 nəfər daha az təsnif etmişdir. Tam mənimsəmə profili \((1,1,1)\) isə iki modeldə bir-birinə kifayət qədər yaxındır.
Mənbənin EAP üçün verdiyi izah
Tədqiqatın müzakirəsinə görə EAP-ın sabitliyi üç əlaqəli mexanizmlə izah edilə bilər. Birincisi, EAP aposterior paylanmanın tək bir modundan deyil, ortalamasından istifadə edir. Bu vəziyyət hər testlet üzrə məlumat az olduqda şəxs-səviyyəli qiymətləndirmələri sıfıra doğru regularizasiya edə bilər.
İkincisi, IT-DINA-nın oxşarlıq səthi diskret atribut sinifləri ilə davamlı testlet dəyişənlərini birlikdə ehtiva etdiyindən qısa testletlərdə düz, çoxmodlu və ya zəif müəyyənləşmiş ola bilər. Aprior ehtiva etməyən MLE belə vəziyyətlərdə seçmə dalğalanmalarına daha açıq qala bilər.
Üçüncüsü, MAP aprior regularizasiyaya malik olsa da aposterior paylanmanın yalnız modundan istifadə edir. Aposterior paylanma geniş və ya asimmetrikdirsə, mod lokal qeyri-müntəzəmliklərə həssas qala bilər. EAP bütün aposterior sıxlığı ortalayaraq bu qeyri-müntəzəmlikləri daha çox yumşalda bilər. Bu izahlar tədqiqatda araşdırılan IT-DINA şərtlərinə aiddir və bütün psixometrik modellər üçün universal üstünlüyün sübutu deyil.
Tədqiqatın dəstəklədiyi nəticələr
- Araşdırılan simulyasiya şərtlərində MAP və xüsusilə EAP, davamlı testlet təsirlərinin bərpasında ümumiyyətlə MLE-dən daha sabit nəticələr vermişdir.
- Bayesçi üstünlük qısa testletlərdə və model quruluşu lazım olduğundan daha mürəkkəb və ya natamam spesifikasiya edildikdə daha aydın olmuşdur.
- Düzgün spesifikasiya olunmuş və orta səviyyədə yanlış spesifikasiya olunmuş şərtlərdə EAP/MAP atribut profili təsnifatında MLE-dən daha yüksək PCCR yarada bilmişdir.
- Real atribut paylanması ilə istifadə olunan Bayesçi atribut aprioru uyğun gəlmədikdə təsnifat üstünlüyü aradan qalxa və ya əksinə çevrilə bilər.
- TIMSS empirik nümunəsində MLE, MAP və EAP eyni IT-DINA modeli altında fərqli şəxs-səviyyəli testlet təsirləri və fərqli diaqnostik təsnifatlar yaratmışdır.
- TIMSS empirik nümunəsində IT-DINA, DINA ilə müqayisədə daha yaxşı nisbi AIC/BIC uyğunluğu göstərmiş və atribut profili paylanmasını dəyişmişdir.
Tədqiqatın dəstəkləmədiyi ümumiləşdirmələr
Tədqiqat “EAP bütün koqnitiv-diaqnostik modellərdə həmişə ən yaxşı üsuldur”, “Bayesçi qiymətləndirmə hər şərtdə MLE-dən daha düzgün təsnif edir”, “TIMSS bloklarının hamısı real ortaq-stimullu testletdir”, “DINA-dan istifadə hər qiymətləndirmədə yanlış təsnifat yaradır” və ya “IT-DINA bütün imtahan sistemlərində mütləq ən yaxşı modeldir” nəticələrini dəstəkləmir.
Simulyasiya nəticələri seçilmiş DINA/T-DINA/IT-DINA quruluşları, müəyyən atribut ölçüləri, maddə keyfiyyəti, aprior paylanmalar, quadrature quruluşu və optimallaşdırma alqoritmi altında əldə edilmişdir. Empirik tətbiqdə isə real atribut profilləri bilinmədiyinə görə model və üsullar arasındakı təsnifat fərqi hansı profilin mütləq həqiqət olduğunu birbaşa sübut etmir.
Əsas məhdudiyyətlər
Model ailəsi məhdudiyyəti: Tədqiqat DINA, T-DINA və IT-DINA ilə məhduddur. Tapıntılar daha çevik G-DINA və ya başqa testlet-əsaslı koqnitiv-diaqnostik modellərə avtomatik ümumiləşdirilə bilməz.
Polytomous məlumatın itirilməsi: TIMSS constructed-response ballarının ikili hala çevrilməsi qismən kredit məlumatını itirir. Buna görə empirik təsnifat və model uyğunluğu nəticələri istifadə olunan ikili bal sistemi üçün spesifikdir.
Əhali təmsilçiliyi: TIMSS tətbiqi model-əsaslı nümayişdir. Mürəkkəb seçmə çəkiləri model kalibrasiyasına və ya uyğunluq qiymətləndirilməsinə açıq şəkildə daxil edilməmişdir. Buna görə nəticələr TIMSS əhalisinin təmsilçi nisbətləri kimi şərh edilməməlidir.
Ədədi tətbiqdən asılılıq: MLE, MAP və EAP müqayisəsi istifadə olunan optimallaşdırma alqoritmindən, Gauss–Hermite yanaşmasından və aprior seçimlərindən asılıdır. Başqa ədədi tətbiqlər kəmiyyət nəticələrini müəyyən qədər dəyişə bilər.
Aprior həssaslığı: Case 5 xüsusilə diskret atribut profili üçün yanlış spesifikasiya olunmuş aprior paylanmanın Bayesçi təsnifata təsir göstərə bildiyini birbaşa göstərir. Buna görə “aprior = regularizasiya = avtomatik yaxşılaşma” şəklində sadə nəticə çıxarıla bilməz.
Mənbə və Metod Qeydi
Özgün tədqiqat: Evaluating Person-Parameter Estimation Methods in Cognitive-Diagnostic Models with Testlet Effects
Müəlliflər: Mei You, Jingjing Yang, Xin Xu.
Müəllif sırası: Mənbədəki sıra olduğu kimi qorunmuşdur.
Bərabər töhfə: Mənbədə bərabər birinci müəlliflik və ya bərabər töhfə işarəsi göstərilməmişdir.
Məsul müəllif: Xin Xu.
Affiliasiya: School of Science, Minzu University of China, Beijing 100081, China.
Jurnal: Education Sciences.
Nəşriyyat: MDPI.
Cild / nömrə / məqalə nömrəsi: Volume 16, Issue 7, Article 1128.
DOI: 10.3390/educsci16071128.
Rəsmi DOI keçidi: https://doi.org/10.3390/educsci16071128
Təqdimetmə tarixi: 11 may 2026.
Reviziya tarixi: 10 iyul 2026.
Qəbul tarixi: 13 iyul 2026.
Nəşr tarixi: 15 iyul 2026.
Mənbə növü: Article / tədqiqat məqaləsi. Tədqiqat yalnız nəzəri metod yazısı deyil; nəzarət olunan simulyasiya müqayisələrini və TIMSS 2023 məlumatları üzərində model-əsaslı empirik tətbiqi birlikdə ehtiva edir.
Resenziya vəziyyəti: Education Sciences jurnalında dərc olunmuş, resenziyadan keçmiş jurnal məqaləsidir.
Lisenziya: Creative Commons Attribution (CC BY). PDF müəllif hüququnun 2026-cı ildə müəlliflərə aid olduğunu və MDPI-nin lisenziya sahibi/nəşriyyat kimi işi CC BY şərtləri ilə yayımladığını bildirir.
Maliyyələşdirmə: Tədqiqat Fundamental Research Funds for the Central Universities tərəfindən dəstəklənmişdir.
İnstitusional etik şura: Mənbədə “Not applicable” kimi göstərilmişdir.
Məlumatlandırılmış razılıq: Mənbədə “Not applicable” kimi göstərilmişdir.
Məlumatların əlçatanlığı: Tədqiqatda ictimaiyyət üçün açıq məlumatlardan istifadə edilmişdir. TIMSS 2023 beynəlxalq məlumat bazasının TIMSS & PIRLS International Study Center vasitəsilə əlçatan olduğu; simulyasiya nəticələrinin məqalədə təsvir olunan model və simulyasiya şərtlərinə uyğun olaraq yaradıldığı bildirilir.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşması bildirməmişlər. Mənbə həmçinin maliyyələşdirənin tədqiqat dizaynında, məlumatların toplanması/təhlili/şərhində, məqalənin yazılmasında və ya nəşr qərarında rolunun olmadığını bildirir.
Müəllif töhfələri: Konseptuallaşdırma Xin Xu; metod Xin Xu və Mei You; proqram təminatı Mei You; doğrulama Mei You, Jingjing Yang və Xin Xu; formal analiz Mei You; tədqiqat Mei You; resurslar Xin Xu; məlumatların kurasiyası Mei You; ilkin layihənin yazılması Mei You; nəzərdən keçirmə və redaktə Jingjing Yang və Xin Xu; vizuallaşdırma Mei You; rəhbərlik Xin Xu; layihə idarəçiliyi Xin Xu; maliyyə əldə edilməsi Xin Xu.
Mənbədaxili uyğunsuzluq 1: TIMSS Q-matrisini verən Cədvəl 7-də iki maddə kodu MQ8N208A və MQ8N208B; maddə parametrlərini verən Cədvəl 8-də isə MQ82N08A və MQ82N08B kimi yazılmışdır. Mənbədə bunun üçün düzəliş izahı olmadığından Verianla hansı yazılışın düzgün olduğuna dair yeni iddia yaratmamışdır.
Mənbədaxili uyğunsuzluq 2: PCCR metod izahında MLE və MAP ikili atribut qiymətləndirmələrinin tənlik nömrələrinə edilən çarpaz istinad metod bölməsindəki real diskret seçim tənlikləri ilə uyğun görünmür. Buna görə Verianla formulları tənlik məzmunları üzərindən izah etmiş, mənbədə olmayan yeni tənlik nömrəsi təyin etməmişdir.
Əsas metodoloji sərhəd: Simulyasiya performansı seçilmiş testlet sayları, testlet uzunluqları, atribut ölçüləri, yüklər, maddə keyfiyyəti, aprior quruluşlar və ədədi tətbiqlə məhduddur. TIMSS tətbiqi isə ikiliyə çevrilmiş constructed-response maddələri, iki əməliyyat bloku və seçmə çəkilərini birbaşa modelə daxil etməyən model-əsaslı nümayişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib