


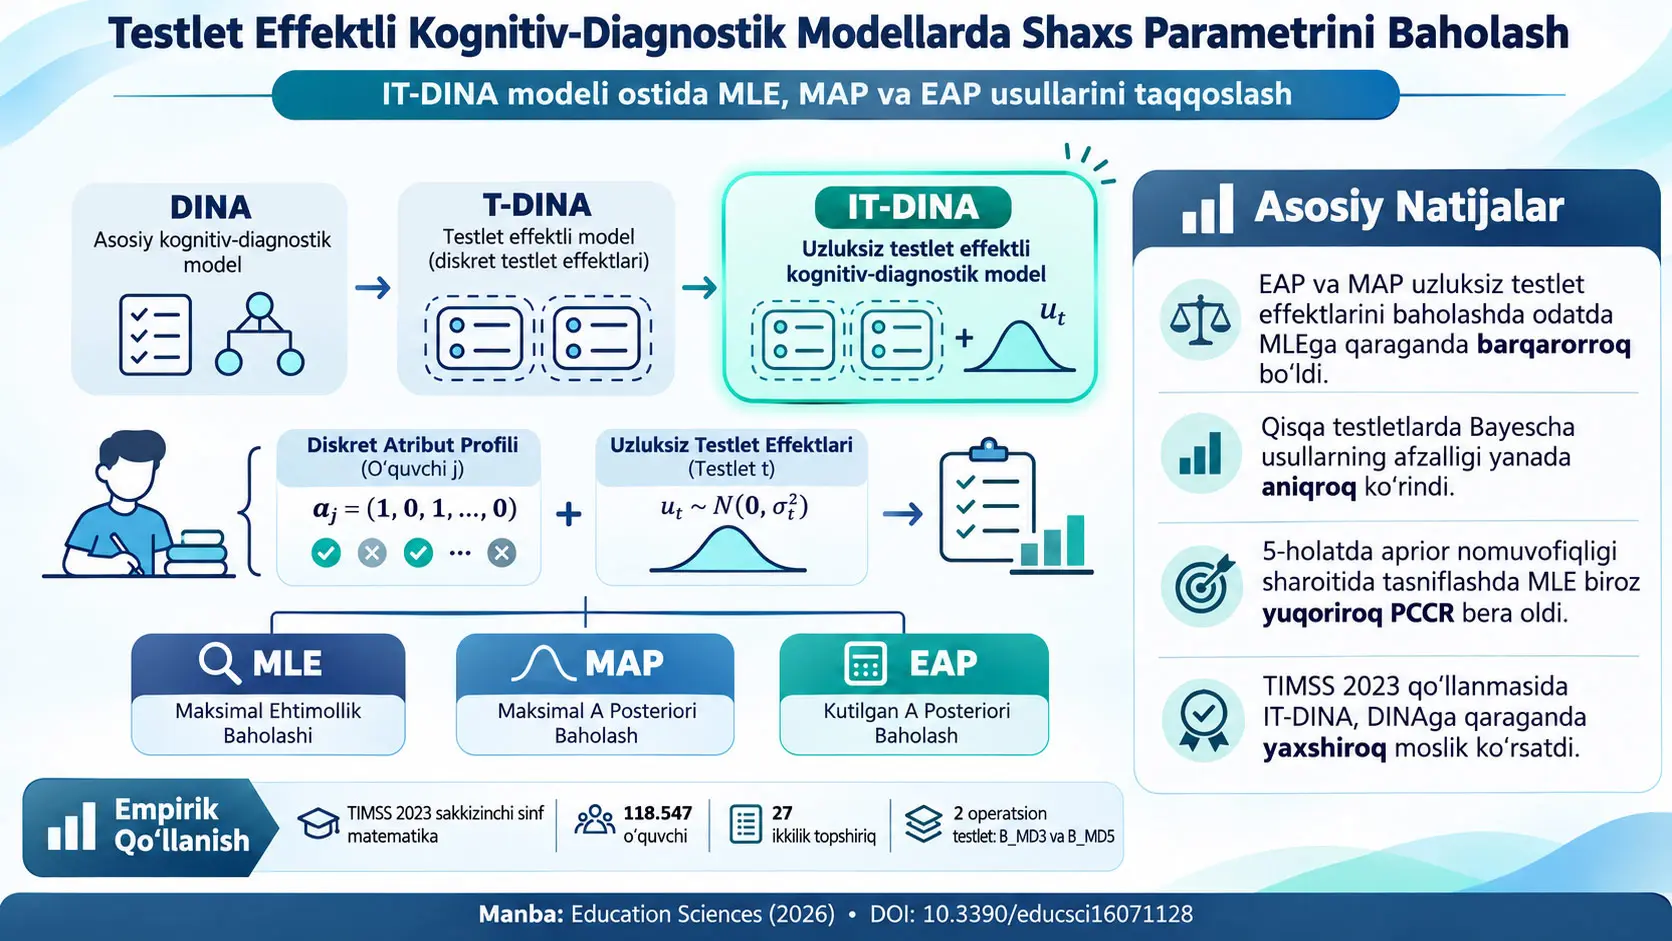
Interaktiv Testlet DINA modeli (Interactive Testlet DINA, IT-DINA) — o‘quvchining qaysi kognitiv atributlarga ega ekanini ko‘rsatuvchi diskret atribut profili bilan ayni testlet ichidagi topshiriqlarning umumiy kontekstidan kelib chiqishi mumkin bo‘lgan uzluksiz shaxs-darajasidagi testlet effektlarini birgalikda modellashtiradigan kognitiv-diagnostik modeldir. Ushbu tadqiqot ana shunday aralash diskret-uzluksiz yashirin tuzilmada shaxs parametrlarini qanday baholashni o‘rganib, maksimal ehtimollik baholashi (Maximum Likelihood Estimation, MLE), maksimal aposterior baholash (Maximum a Posteriori, MAP) va aposterior kutilgan qiymat baholashi (Expected A Posteriori, EAP) usullarini taqqoslaydi.
Tadqiqotning birinchi qismi simulyatsiyaga asoslanadi. Tanlanma hajmi har bir shartda 10.000 deb belgilangan; uch yoki to‘rtta testlet, har bir testlet uchun 10, 20, 30, 40 yoki 50 ta topshiriq hamda turli model-to‘g‘riligi shartlari tekshirilgan. Beshta simulyatsiya ssenariysi to‘g‘ri spetsifikatsiya qilingan IT-DINA modelini, haqiqiy testlet effekti bo‘lmagan holda IT-DINA dan foydalanishni, faqat asosiy testlet effekti mavjud bo‘lganda murakkabroq IT-DINA dan foydalanishni, haqiqiy IT-DINA ma’lumotlarini soddaroq T-DINA modeli bilan baholashni hamda yuqoriroq atribut o‘lchami va notekis haqiqiy atribut taqsimoti mavjud bo‘lgan murakkabroq shartni qamrab oladi.
Simulyatsiyalarda EAP va MAP, ayniqsa qisqa testletlarda hamda model tuzilishi zaruridan ortiq murakkab yoki to‘liq bo‘lmagan tarzda spetsifikatsiya qilingan shartlarda uzluksiz testlet effektlarini tiklashda MLE ga qaraganda barqarorroq natijalar bergan. To‘g‘ri spetsifikatsiya qilingan asosiy IT-DINA shartida EAP va MAP ning testlet-effekti bo‘yicha sistematik og‘ishlari mutlaq qiymatda ko‘pincha 0,005 dan past qolgan bo‘lsa, 10 ta topshiriqli qisqa testletlarda ayrim MLE og‘ishlari taxminan 0,02–0,04 darajasiga yetgan. Ayni shartda Bayes usullarining RMSE qiymatlari testlet uzunligi oshgani sari taxminan 0,35 dan 0,20 gacha pasaygan, MLE esa qisqa testletlarda taxminan 0,55–0,65 RMSE ko‘rsatgan.
Shu bilan birga, tadqiqot “Bayes usullari har qanday shartda ustun” degan xulosani qo‘llab-quvvatlamaydi. Beshinchi simulyatsiya shartida haqiqiy atribut profillari notekis taqsimotdan yaratilgan bo‘lsa-da, MAP va EAP hisoblarida atribut profillari uchun tekis aprior taqsimotdan foydalanish davom ettirilgan. Ushbu aprior nomuvofiqlik sharoitida uzluksiz testlet effektlarini baholashda Bayes usullari barqarorroq qolganiga qaramay, butun atribut profilini bir vaqtda to‘g‘ri tasniflash mezoni bo‘lgan PCCR bo‘yicha MLE taxminan %90–93, MAP va EAP esa taxminan %87–91 oralig‘ida natija bergan. Bu topilma aprior taqsimotni tanlash tasniflash maqsadi uchun ilmiy jihatdan muhim ekanini ko‘rsatadi.
Tadqiqotning ikkinchi qismi TIMSS 2023 sakkizinchi sinf matematika ma’lumotlari bilan o‘tkazilgan empirik namoyishdir. Dastlabki 308.492 o‘quvchi va 68 ta nomzod matematika topshirig‘idan ma’lumotlarni tozalashdan so‘ng 118.547 o‘quvchi va 27 ta ikkilik topshiriq tahlil qilingan. B_MD3 va B_MD5 bloklari ikkita operatsion testlet sifatida qo‘llangan. IT-DINA ushbu ma’lumotlarda an’anaviy DINA modeliga qaraganda pastroq AIC va BIC qiymatlarini bergan va ikki model o‘quvchilarni kognitiv atribut profillariga sezilarli darajada turlicha taqsimlagan. Biroq ushbu TIMSS qo‘llanilishi aholi darajasidagi reprezentativ natijaning dalili emas, balki model xatti-harakatini haqiqiy baholash ma’lumotlarida ko‘rsatuvchi empirik misoldir.
Kognitiv-diagnostik model nimani hal qilishga urinadi?
Ko‘plab an’anaviy o‘lchash modellari o‘quvchi natijasini bitta uzluksiz qobiliyat balli bilan umumlashtirishga urinadi. Kognitiv-diagnostik modellar (Cognitive-Diagnostic Models, CDMs) esa boshqa savolni beradi: o‘quvchi muayyan bilim yoki ko‘nikma komponentlarining qaysilariga ega, qaysilariga ega emas? Shu sababli modelning yashirin o‘zgaruvchisi bitta ball bo‘lishi shart emas; u bir nechta ikkilik kognitiv atributdan tashkil topgan profil bo‘lishi mumkin.
Masalan, uchta kognitiv atribut mavjud bo‘lsa, o‘quvchining profili \((1,0,1)\) bo‘lishi mumkin. Bu yerda 1 tegishli atribut o‘zlashtirilganini, 0 esa o‘zlashtirilmaganini ko‘rsatadi. Uchta ikkilik atribut bo‘lsa jami \(2^3=8\) mumkin bo‘lgan profil; beshta atribut bo‘lsa \(2^5=32\) mumkin bo‘lgan profil mavjud. Shu sababli atributlar soni oshgani sari o‘quvchining qaysi yashirin sinfga mansubligini aniqlash muammosi ham kattalashadi.
Testlet Effekti va Mahalliy Topshiriq Bog‘liqligi Nima?
Testlet effekti — ayni umumiy matn, jadval, ssenariy, savollar bloki yoki boshqa kontekst ichida taqdim etilgan topshiriqlar, o‘lchanishi ko‘zlangan kognitiv atributlar hisobga olinganidan keyin ham o‘zaro bog‘liq javob xatti-harakatini ko‘rsatishi mumkinligini ifodalovchi qo‘shimcha yashirin effektdir. Standart modellarda o‘quvchining kognitiv atributlari ma’lum bo‘lganda topshiriqlar bir-biridan mustaqil bo‘lishi kutiladi; bu shart bajarilmasa mahalliy topshiriq bog‘liqligi (local item dependence, LID) mavjud bo‘ladi.
Bu farq muhim. Ayni matndan foydalanadigan beshta savolda o‘quvchining o‘sha matnni noodatiy darajada yaxshi yoki yomon qayta ishlashi beshala javobga birgalikda ta’sir qilishi mumkin. Bunday umumiy effekt faqat o‘lchanishi ko‘zlangan ko‘nikmalarga yuklansa, model o‘lchash aniqligini haqiqatdagidan yuqori ko‘rsatishi yoki o‘quvchini noto‘g‘ri atribut profiliga tasniflashi mumkin. Testlet modellari ushbu qoldiq umumiylikni alohida modellashtirishga urinadi.
Asosiy belgilash: o‘quvchi, topshiriq, testlet va atribut
| Belgi | Ma’nosi | Turi |
|---|---|---|
| \(N\) | O‘quvchi / imtihon topshiruvchi shaxslar soni | Sanoq |
| \(S\) | Testletlar soni | Sanoq |
| \(J_s\) | \(s\) testletidagi topshiriqlar soni | Sanoq |
| \(J=\sum_{s=1}^{S}J_s\) | Jami topshiriqlar soni | Sanoq |
| \(K\) | Ikkilik kognitiv atributlar soni | Sanoq |
| \(\boldsymbol{\alpha}_i\) | \(i\) o‘quvchining atribut profili | \(K\) o‘lchamli ikkilik vektor |
| \(\alpha_{ik}\) | O‘quvchi \(i\), atribut \(k\) ga ega bo‘lsa 1; aks holda 0 | Ikkilik |
| \(q_{jk}\) | Topshiriq \(j\), atribut \(k\) ni talab qilsa 1 | Q-matritsa elementi |
| \(\eta_{ij}\) | O‘quvchi \(i\) topshiriq \(j\) uchun talab qilinadigan barcha atributlarga ega yoki yo‘qligini ko‘rsatuvchi ideal javob indikatori | Ikkilik |
| \(Y_{ij}\) | Kuzatilgan javob; to‘g‘ri bo‘lsa 1, noto‘g‘ri bo‘lsa 0 | Ikkilik |
| \(\boldsymbol{\xi}_i\) | O‘quvchiga tegishli uzluksiz testlet-effekti parametrlari | Uzluksiz yashirin vektor |
Q-matritsa nima qiladi?
Q-matritsa qaysi topshiriq qaysi kognitiv atributni talab qilishini ko‘rsatadigan \(J\times K\) o‘lchamli ikkilik matritsadir. \(q_{jk}=1\) bo‘lsa topshiriq \(j\) ni to‘g‘ri yechish uchun atribut \(k\) zarur; \(q_{jk}=0\) bo‘lsa mazkur atribut topshiriq uchun zarur deb hisoblanmaydi.
O‘quvchining topshiriq uchun ideal tarzda zarur barcha atributlarga ega yoki yo‘qligini ko‘rsatuvchi o‘zgaruvchi manbada quyidagi kon’yunktiv tuzilma orqali ta’riflanadi:
\[ \eta_{ij}=\prod_{k=1}^{K}(\alpha_{ik})^{q_{jk}} \]
Bu ko‘paytmaning mantiqi “VA” darvozasidir. Agar topshiriq ikki atributni talab qilsa va o‘quvchida ulardan biri bo‘lmasa, tegishli ko‘paytuvchi 0 bo‘ladi va butun ko‘paytma \(\eta_{ij}=0\) natijasiga olib keladi. O‘quvchi zarur atributlarning barchasiga ega bo‘lsa \(\eta_{ij}=1\) bo‘ladi.
DINA modeli: asosiy boshlang‘ich nuqta
DINA (Deterministic Inputs, Noisy “AND” Gate) modeli zarur atributlarning barchasiga ega bo‘lishni muvaffaqiyat uchun kon’yunktiv shart deb qabul qiladi. Biroq haqiqiy imtihon xatti-harakati to‘liq deterministik emas: barcha zarur atributlarga ega o‘quvchi xato qilishi mumkin; zarur atributlarga ega bo‘lmagan o‘quvchi esa taxmin orqali to‘g‘ri javob berishi mumkin.
Manba Tenglama (1):
\[ P(Y_{ij}=1\mid\boldsymbol{\alpha}_i) =(1-s_j)^{\eta_{ij}}g_j^{\,1-\eta_{ij}} \tag{1} \]
\(s_j\) topshiriq \(j\) uchun slipping / sirpanish-xato ehtimolligidir. U o‘quvchi zarur barcha atributlarga ega bo‘lsa ham noto‘g‘ri javob berish ehtimolini ifodalaydi. Shu sababli \(\eta_{ij}=1\) bo‘lganda to‘g‘ri javob ehtimoli \(1-s_j\) ga teng.
\(g_j\) guessing / taxmin ehtimolligidir. U o‘quvchi zarur barcha atributlarga ega bo‘lmagan holda to‘g‘ri javob berish ehtimolini ifodalaydi. \(\eta_{ij}=0\) bo‘lganda Tenglama (1) bevosita \(g_j\) ga qisqaradi.
Tenglamaning daraja tuzilishi ikki holatni bitta formulada birlashtiradi. \(\eta_{ij}=1\) bo‘lsa \(g_j^{0}=1\) bo‘ladi va \(1-s_j\) qoladi. \(\eta_{ij}=0\) bo‘lsa \((1-s_j)^0=1\) bo‘ladi va \(g_j\) qoladi. Shu sababli formulaning maqsadi faqat algebraik ixchamlik emas, balki DINA ning ikki yashirin holatini bitta javob funksiyasida ifodalashdir.
O‘quvchining barcha javoblari vektori \(\mathbf{y}_i=(y_{i1},\ldots,y_{iJ})\) uchun, atribut profili ma’lum bo‘lganda topshiriqlar shartli mustaqil deb faraz qilinsa, manba Tenglama (2) da ehtimollik funksiyasini quyidagicha ta’riflaydi:
\[ L(\mathbf{y}_i\mid\boldsymbol{\alpha}_i) =\prod_{j=1}^{J}P(Y_{ij}=y_{ij}\mid\boldsymbol{\alpha}_i) \tag{2} \]
Bu yerda ko‘paytma o‘quvchining kuzatilgan barcha topshiriq javoblari birgalikda qanchalik ehtimolli ekanini hisoblaydi. Standart DINA ning muhim farazi aynan shu nuqtada: \(\boldsymbol{\alpha}_i\) ma’lum bo‘lganda topshiriqlar orasida boshqa sistematik bog‘liqlik qolmaydi deb qabul qilinadi. Testlet muammosi aynan shu faraz buzilishi mumkin bo‘lgan holatga taalluqlidir.
T-DINA: testlet uchun qo‘shimcha tasodifiy effekt
Testlet Effect DINA (T-DINA) ayni testlet ichidagi topshiriqlar orasida atribut profili izohlamaydigan umumiylikni ifodalash uchun o‘quvchi \(i\) va testlet \(s\) ga xos uzluksiz \(\xi_{is}\) tasodifiy effektini qo‘shadi.
Manba Tenglama (3):
\[ P(Y_{ij}=1\mid\boldsymbol{\alpha}_i,\xi_{is}) =h\!\left(\delta_{0j}+\delta_{1j}\eta_{ij}+\beta_{js}\xi_{is}\right) \tag{3} \]
\(h(\cdot)\) bog‘lanish funksiyasidir; manba logistik yoki probit bog‘lanishdan foydalanish mumkinligini ko‘rsatadi. \(\delta_{0j}\) topshiriqqa xos kesishish parametri, \(\delta_{1j}\) ideal javob holatining topshiriqqa ta’sirini, \(\beta_{js}\) esa testlet effektining topshiriq \(j\) ga qanchalik kuchli yuklanishini ko‘rsatadi.
\(\xi_{is}\) nolga yaqin bo‘lsa testletning o‘quvchiga xos qo‘shimcha effekti zaif. Mutlaq qiymati oshgani sari umumiy testlet komponenti chiziqli prediktorni ko‘proq o‘zgartiradi; biroq yakuniy to‘g‘ri javob ehtimoli bevosita chiziqli emas, \(h(\cdot)\) bog‘lanish funksiyasidan o‘tkaziladi.
IT-DINA: testlet effekti atribut holati bilan o‘zaro ta’sirlashishi mumkin
T-DINA da testlet effekti o‘quvchining ideal javob holatidan mustaqil ravishda qo‘shiladi. IT-DINA esa ushbu effektning \(\eta_{ij}\) ga qarab o‘zgarishiga imkon beradi.
Manba Tenglama (4):
\[ P(Y_{ij}=1\mid\boldsymbol{\alpha}_i,\boldsymbol{\xi}_{is}) =h\!\left[ \delta_{0j} +\delta_{1j}\eta_{ij} +\beta_{js}\xi_{is1} +\gamma_{js}(2\eta_{ij}-1)\xi_{is2} \right] \tag{4} \]
Bu yerda \(\boldsymbol{\xi}_{is}=(\xi_{is1},\xi_{is2})^\prime\) ikki komponentli testlet-effekti vektoridir. \(\beta_{js}\xi_{is1}\) asosiy testlet effektini, \(\gamma_{js}(2\eta_{ij}-1)\xi_{is2}\) esa atribut holatiga bog‘liq o‘zaro ta’sir komponentini ifodalaydi.
\((2\eta_{ij}-1)\) hadining maxsus vazifasi bor. \(\eta_{ij}=1\) bo‘lganda bu had \(+1\), \(\eta_{ij}=0\) bo‘lganda \(-1\) bo‘ladi. Shunday qilib \(\xi_{is2}\) ning chiziqli prediktorga hissasi yo‘nalishi ideal javob holatiga qarab o‘zgarishi mumkin. Bu tuzilma testlet bog‘liqligi zarur atributlarga ega bo‘lganlar va ega bo‘lmaganlarda bir xil tarzda ishlashi shart emasligini modelga kiritadi.
| Model | Atribut profili | Testlet asosiy effekti | Atribut × testlet o‘zaro ta’siri |
|---|---|---|---|
| DINA | Bor | Yo‘q | Yo‘q |
| T-DINA | Bor | Bor: \(\beta_{js}\xi_{is}\) | Yo‘q |
| IT-DINA | Bor | Bor: \(\beta_{js}\xi_{is1}\) | Bor: \(\gamma_{js}(2\eta_{ij}-1)\xi_{is2}\) |
Nega shaxs parametri aralash tuzilma?
Tadqiqotda o‘quvchining barcha shaxs parametrlari
\[ \boldsymbol{\lambda}_i=(\boldsymbol{\alpha}_i,\boldsymbol{\xi}_i) \]
deb qaraladi. \(\boldsymbol{\alpha}_i\) diskret atribut profilidir; masalan, \((1,0,1)\). \(\boldsymbol{\xi}_i\) esa uzluksiz testlet effektlaridan iborat. Demak, algoritm bir vaqtning o‘zida ham “o‘quvchi qaysi yashirin sinfda?”, ham “bu o‘quvchi uchun uzluksiz testlet effektining qiymati qancha?” savollarini hal qilishi kerak. Tadqiqotda MLE, MAP va EAP taqqoslashini muhim qiladigan asosiy matematik qiyinchilik shudir.
MLE, MAP va EAP Ushbu Tadqiqotda Qanday Farqlanadi?
MLE faqat kuzatilgan javoblarning ehtimollik funksiyasini eng yuqori qiladigan shaxs parametrlarini tanlaydi; MAP ayni ehtimollikka aprior taqsimot ma’lumotini qo‘shib, aposterior zichlikning cho‘qqi nuqtasini tanlaydi; EAP esa bitta cho‘qqi nuqtasini tanlash o‘rniga butun aposterior taqsimotni hisobga oladi va parametrning aposterior o‘rtachasidan foydalanadi. Shu sababli MAP va EAP regularizatsiya ta’minlashi mumkin, biroq ularning natijalari qo‘llanilgan aprior taqsimotning mosligiga ham bog‘liq.
MLE: faqat ma’lumot ehtimolligini eng yuqori qil
Manba Tenglama (5) ikkilik javoblar uchun shaxs darajasidagi log-ehtimollikni beradi:
\[ \ell(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) = \sum_{j=1}^{J} \left[ y_{ij}\log P_{ij} + (1-y_{ij})\log(1-P_{ij}) \right] \tag{5} \]
Bu yerda \(P_{ij}=P(Y_{ij}=1\mid\boldsymbol{\lambda}_i)\). O‘quvchi topshiriqqa to‘g‘ri javob bergan bo‘lsa \(y_{ij}=1\) bo‘ladi va birinchi had faollashadi; noto‘g‘ri javob bergan bo‘lsa \(y_{ij}=0\) bo‘ladi va ikkinchi had faollashadi. Barcha topshiriqlarning hissalari yig‘ilib, muayyan shaxs parametrlari kuzatilgan javoblarga qanchalik mos kelishi o‘lchanadi.
MLE baholashi:
\[ \widehat{\boldsymbol{\lambda}}_i^{MLE} = \operatorname*{arg\,max}_{\boldsymbol{\lambda}_i} \ell(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) \tag{6} \]
Bu yerdagi \(\operatorname{arg\,max}\) funksiyaning eng katta qiymatini emas, balki shu eng katta qiymatni ta’minlaydigan parametr qiymatini qidiradi.
MAP: ehtimollikka aprior ma’lumot qo‘sh
Manba Tenglama (7):
\[ \widehat{\boldsymbol{\lambda}}_i^{MAP} = \operatorname*{arg\,max}_{\boldsymbol{\lambda}_i} \left\{ \ell(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) +\log\pi(\boldsymbol{\lambda}_i) \right\} \tag{7} \]
\(\pi(\boldsymbol{\lambda}_i)\) shaxs parametrlarining aprior zichligidir. Ushbu tadqiqotda \(\boldsymbol{\alpha}_i\) uchun mumkin bo‘lgan \(2^K\) profil bo‘yicha tekis aprior, uzluksiz testlet effektlari uchun esa standart normal aprior qo‘llangan.
Mustaqil apriorlar ostida:
\[ \log\pi(\boldsymbol{\lambda}_i) = \log\pi(\boldsymbol{\alpha}_i) + \log\pi(\boldsymbol{\xi}_i), \qquad \log\pi(\boldsymbol{\xi}_i) \propto -\frac{1}{2}\boldsymbol{\xi}_i^\prime\boldsymbol{\xi}_i \]
Standart normal aprior mutlaq qiymati juda katta testlet effektlariga jarima qo‘llaydigan regularizatsiya ta’sirini hosil qiladi. Biroq bu xususiyat avtomatik ravishda “aniqroq” degani emas; aprior tuzilma haqiqiy populyatsiya tuzilmasiga mos kelmasa, ayniqsa atribut tasnifini buzishi mumkin. Case 5 buning ushbu tadqiqotdagi bevosita misolidir.
EAP: aposterior taqsimotning o‘rtachasidan foydalan
Manba Tenglama (8):
\[ \widehat{\boldsymbol{\lambda}}_i^{EAP} = E[\boldsymbol{\lambda}_i\mid\mathbf{y}_i] = \int \boldsymbol{\lambda}_i p(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) \,d\boldsymbol{\lambda}_i \tag{8} \]
Bu yerda
\[ p(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) \propto L(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) \pi(\boldsymbol{\lambda}_i) \]
aposterior zichlikdir. EAP ning asosiy farqi aposterior taqsimotning faqat eng yuqori nuqtasidan emas, uning butun shaklidan foydalanishidir. Manba muhokamasiga ko‘ra, ayniqsa qisqa testletlarda aposterior taqsimot keng, assimetrik yoki notekis bo‘lganda bu o‘rtachalashtirish xatti-harakati barqarorroq shaxs baholarini hosil qilishi mumkin.
MLE ning IT-DINA ichida ikki bosqichli qo‘llanilishi
Har bir mumkin bo‘lgan atribut profili \(\boldsymbol{\alpha}_c\), \(c=1,\ldots,C\) uchun va \(C=2^K\) bo‘lganda, avval uzluksiz testlet effekti optimallashtiriladi.
Manba Tenglama (9):
\[ \widehat{\boldsymbol{\xi}}_i^{(c)} = \operatorname*{arg\,max}_{\boldsymbol{\xi}_i} \ell(\boldsymbol{\xi}_i\mid\mathbf{y}_i,\boldsymbol{\alpha}_c) \tag{9} \]
Bu “o‘quvchining atribut profili hozircha \(\boldsymbol{\alpha}_c\) deb qabul qilinsa, testlet effektlari qaysi qiymatlarda javoblarni eng yaxshi izohlaydi?” savolini hal qiladi.
Manba MLE uchun gradient ko‘tarilish va orqaga kuzatuvli qadam qidiruvidan foydalanadi:
\[ \boldsymbol{\xi}_i^{(m+1)} = \boldsymbol{\xi}_i^{(m)} + \gamma^{(m)} \nabla_{\xi} \ell(\boldsymbol{\xi}_i^{(m)}\mid\mathbf{y}_i,\boldsymbol{\alpha}_c) \tag{10} \]
\(\nabla_{\xi}\ell\) log-ehtimollikning testlet effektlari yo‘nalishidagi gradientidir. Gradient funksiyaning eng tez o‘sish yo‘nalishini ko‘rsatadi. \(\gamma^{(m)}\) qadam kattaligidir va orqaga kuzatuvli chiziq qidiruvi bilan yetarli log-ehtimollik o‘sishini ta’minlaydigan tarzda sozlanadi.
Har bir atribut sinfi uchun eng yaxshi uzluksiz baho topilgandan so‘ng eng yuqori log-ehtimollikka ega sinf tanlanadi:
\[ \widehat{\boldsymbol{\alpha}}_i^{MLE} = \operatorname*{arg\,max}_{\boldsymbol{\alpha}_c} \ell( \widehat{\boldsymbol{\xi}}_i^{(c)} \mid \mathbf{y}_i,\boldsymbol{\alpha}_c) \tag{11} \]
MLE algoritmining sonli sozlamalari
Manba algoritmi har bir yashirin atribut profili uchun beshta turli boshlang‘ich nuqtadan optimallashtiradi. Birinchi boshlang‘ich \(\boldsymbol{\xi}=0\); keyingi boshlang‘ichlar \(N(0,0.25I)\) taqsimotidan olinadi. Maqsad murakkab ehtimollik yuzasida bitta boshlang‘ich nuqtaning yomon mahalliy yechimda qolib ketish xavfini kamaytirishdir.
| Parametr | Qiymat | Vazifasi |
|---|---|---|
| Orqaga kuzatish koeffitsienti \(\rho\) | 0,8 | Qadam kattaligini kamaytirish mexanizmi sozlamasi |
| Armijo doimiysi \(c_1\) | \(10^{-4}\) | Yetarli funksiya o‘sishi shartining chegarasi |
| Maksimal iteratsiya \(M\) | 500 | Optimallashtirishning yuqori iteratsiya chegarasi |
| Yaqinlashish chegarasi \(\epsilon\) | 0,001 | Gradient normasi yetarlicha kichrayganda to‘xtash mezoni |
| Boshlang‘ichlar soni \(J_{max}\) | 5 | Mahalliy optimum xavfini kamaytirish uchun qayta ishga tushirishlar soni |
MAP algoritmida nima o‘zgaradi?
MAP ayni sinflarni ko‘rib chiqadi; biroq uzluksiz testlet effekti faqat log-ehtimollikni emas, log-apriorni ham o‘z ichiga olgan aposterior maqsad funksiyasini eng yuqori qiladi.
Manba Tenglama (12):
\[ \widehat{\boldsymbol{\xi}}_i^{(c)} = \operatorname*{arg\,max}_{\boldsymbol{\xi}_i} \left\{ \ell(\boldsymbol{\xi}_i\mid\mathbf{y}_i,\boldsymbol{\alpha}_c) + \log\pi(\boldsymbol{\xi}_i) \right\} \tag{12} \]
Gradient yangilanishida ham ma’lumot, ham aprior hissasi mavjud:
\[ \boldsymbol{\xi}_i^{(m+1)} = \boldsymbol{\xi}_i^{(m)} + \gamma^{(m)} \left[ \nabla_{\xi}\ell( \boldsymbol{\xi}_i^{(m)} \mid \mathbf{y}_i,\boldsymbol{\alpha}_c) + \nabla_{\xi}\log\pi( \boldsymbol{\xi}_i^{(m)}) \right] \tag{13} \]
Yakuniy bosqichda atribut profili aposterior maqsad qiymatlari taqqoslanib tanlanadi:
\[ \widehat{\boldsymbol{\alpha}}_i^{MAP} = \operatorname*{arg\,max}_{\boldsymbol{\alpha}_c} \left\{ \ell( \widehat{\boldsymbol{\xi}}_i^{(c)} \mid \mathbf{y}_i,\boldsymbol{\alpha}_c) + \log\pi( \widehat{\boldsymbol{\xi}}_i^{(c)}) + \log\pi(\boldsymbol{\alpha}_c) \right\} \tag{14} \]
Atribut profillari uchun tekis aprior ishlatilganda \(\log\pi(\boldsymbol{\alpha}_c)\) barcha sinflarda bir xil doimiy bo‘lgani sababli sinflar o‘rtasidagi taqqoslashni o‘zgartirmaydi. Biroq haqiqiy populyatsiya profillari tekis taqsimlanmagan bo‘lsa, ushbu faraz tasniflash natijalariga ta’sir qilishi mumkin.
EAP: optimallashtirish o‘rniga integrallash
EAP uzluksiz testlet effekti uchun bitta maksimumni qidirish o‘rniga bu o‘zgaruvchini ehtimollik taqsimoti bo‘yicha integrallaydi.
Manba Tenglama (15):
\[ P(\mathbf{y}_i\mid\boldsymbol{\alpha}_c) = \int P(\mathbf{y}_i\mid\boldsymbol{\xi}_i,\boldsymbol{\alpha}_c) \pi(\boldsymbol{\xi}_i) \,d\boldsymbol{\xi}_i \tag{15} \]
Bu ifoda muayyan atribut profilining marginal ehtimollik funksiyasidir. Uzluksiz testlet effektining barcha mumkin bo‘lgan qiymatlari aprior og‘irliklari bilan birgalikda hisobga olinadi.
Atribut profilining aposterior ehtimolligi:
\[ P(\boldsymbol{\alpha}_c\mid\mathbf{y}_i) = \frac{ P(\mathbf{y}_i\mid\boldsymbol{\alpha}_c)\pi(\boldsymbol{\alpha}_c) }{ \sum_{d=1}^{C} P(\mathbf{y}_i\mid\boldsymbol{\alpha}_d)\pi(\boldsymbol{\alpha}_d) } \tag{16} \]
Surat muayyan sinfning ma’lumot va aprior bilan birgalikdagi og‘irligini, maxraj esa barcha mumkin bo‘lgan sinflar og‘irliklari yig‘indisini ifodalaydi. Shu tariqa natija 0–1 oralig‘idagi haqiqiy aposterior sinf ehtimolligidir.
Har bir alohida atribut uchun o‘zlashtirish ehtimolligi:
\[ \widehat{\alpha}_{ik}^{EAP} = P(\alpha_{ik}=1\mid\mathbf{y}_i) = \sum_{c=1}^{C} I(\alpha_{ck}=1) P(\boldsymbol{\alpha}_c\mid\mathbf{y}_i) \tag{17} \]
\(I(\cdot)\) indikator funksiyasidir. Sinf \(c\) atribut \(k\) ga ega bo‘lsa 1, aks holda 0 bo‘ladi. Shunday qilib o‘sha atributga ega barcha sinflarning aposterior ehtimolliklari yig‘iladi.
Uzluksiz testlet effektlarining EAP bahosi:
\[ \widehat{\boldsymbol{\xi}}_i^{EAP} = \int \boldsymbol{\xi}_i p(\boldsymbol{\xi}_i\mid\mathbf{y}_i) \,d\boldsymbol{\xi}_i \tag{18} \]
Manba buni sinf-shartli kutilmalarni atribut sinflarining aposterior ehtimolliklari bilan og‘irlashtirilgan o‘rtachasi ko‘rinishida hisoblaydi. Bu yondashuv barcha og‘irlikni bitta sinf va bitta uzluksiz maksimum nuqtasiga berish o‘rniga noaniqlikni taqsimot orqali olib o‘tadi.
Nega Gauss–Hermite quadrature qo‘llanadi?
Tenglama (15) va (18) dagi integrallar yopiq shaklda oson hisoblanmagani sababli tadqiqot Gauss–Hermite quadrature (GHQ) dan foydalanadi. Manba EAP algoritmida har bir uzluksiz o‘lcham uchun 20 Gauss–Hermite tuguni dan foydalanadi. Ikki o‘lchamli IT-DINA testlet effekti uchun tenzor ko‘paytmasi orqali jami \(20^2=400\) quadrature nuqtasi hosil bo‘ladi.
Har bir quadrature nuqtasida javob ehtimolligi hisoblanadi, Gauss–Hermite og‘irligiga ko‘paytiriladi va bu og‘irlashtirilgan qiymatlar yig‘ilib integralga sonli yaqinlashuv olinadi. Bu yerdagi 400 qiymat yangi o‘quvchi yoki yangi ma’lumot emas; uzluksiz integralni taqribiy hisoblashda ishlatiladigan sonli baholash nuqtalaridir.
Simulyatsiyada DINA parametrlari probit shkalasiga qanday o‘tkaziladi?
Simulyatsiya boshida sirpanish \(s_j\) va taxmin \(g_j\) qiymatlari \(U(0.05,0.20)\) tekis taqsimotidan yaratiladi. Keyin probit shkalasidagi topshiriq parametrlari quyidagicha hosil qilinadi:
\[ \delta_{0j}=\Phi^{-1}(g_j) \]
\[ \delta_{1j} = \Phi^{-1}(1-s_j) - \Phi^{-1}(g_j) \]
\(\Phi\) standart normal taqsimotning kumulyativ taqsimot funksiyasi; \(\Phi^{-1}\) esa uning teskarisidir. Shu tariqa ehtimollik shkalasidagi taxmin va sirpanish qiymatlari probit chiziqli prediktor shkalasiga o‘tkaziladi.
Testlet effektlari qo‘shilganda haqiqiy topshiriq ehtimolliklari nega o‘zgaradi?
Testlet tasodifiy effektlari probit modeliga qo‘shilganda marginal to‘g‘ri javob ehtimolliklari dastlab tanlangan \(g_j\) va \(1-s_j\) qiymatlariga aynan teng bo‘lib qolmaydi. Manba ushbu yangi modeldan kelib chiqadigan ehtimolliklarni Tenglama (19) va (20) bilan beradi.
Zarur atributlarga ega o‘quvchi uchun marginal to‘g‘ri javob ehtimolligi:
\[ c_{js}^{*} = \Phi\left( \frac{ \delta_{0j}+\delta_{1j} }{ \sqrt{ 1+\sigma_{\xi}^{2} (\beta_{js}^{2}+\gamma_{js}^{2}) } } \right) \tag{19} \]
Zarur atributlarga ega bo‘lmagan o‘quvchi uchun marginal to‘g‘ri javob ehtimolligi:
\[ g_{js}^{*} = \Phi\left( \frac{ \delta_{0j} }{ \sqrt{ 1+\sigma_{\xi}^{2} (\beta_{js}^{2}+\gamma_{js}^{2}) } } \right) \tag{20} \]
Tadqiqotda \(\sigma_{\xi}^{2}=0.25\), ya’ni testlet effektlarining standart og‘ishi 0,5. Modelda testlet yuklamalarining kvadratlari maxrajga kirgani sababli yuklamalarning mutlaq kattaligi marginal masshtablashga ta’sir qiladi. Case 5 da ishoralar musbat yoki manfiy bo‘lishi ushbu maxsus marginal ehtimollik oraliqlarini o‘zgartirmaydi; chunki Tenglama (19) va (20) da \(\beta^2\) va \(\gamma^2\) ishlatiladi.
\(1-c_{js}^{*}\) model nazarda tutadigan sirpanish ehtimolligidir. Shu sababli boshida \(s_j\) va \(g_j\) 0,05–0,20 orasidan tanlangan bo‘lsa ham, testlet effektlari qo‘shilgandan keyin modeldan kelib chiqadigan sirpanish va taxmin ehtimolliklari ayni chegaralarda qolishi shart emas.
Sistematik og‘ish nimani o‘lchaydi?
Manba Tenglama (21):
\[ Bias(\widehat{\boldsymbol{\xi}}) = \frac{1}{N} \sum_{i=1}^{N} ( \widehat{\boldsymbol{\xi}}_i - \boldsymbol{\xi}_i ) \tag{21} \]
Sistematik og‘ish baholarning haqiqiy testlet effektlaridan qaysi yo‘nalishda muntazam chetlanishini ko‘rsatadi. Nolga yaqin qiymat musbat va manfiy sistematik xato past ekanini ko‘rsatadi. Biroq faqat past Bias yetarli emas; katta, ammo bir-birini qoplaydigan musbat va manfiy xatolar o‘rtachada nolga yaqinlashishi mumkin.
RMSE nimani o‘lchaydi?
Manba Tenglama (22):
\[ RMSE(\widehat{\boldsymbol{\xi}}) = \sqrt{ \frac{1}{N} \sum_{i=1}^{N} \left\| \widehat{\boldsymbol{\xi}}_i - \boldsymbol{\xi}_i \right\|^2 } \tag{22} \]
RMSE baho bilan haqiqiy qiymat orasidagi xatoning kattaligini o‘lchaydi va kvadratlash sababli katta xatolarni kuchliroq jazolaydi. Past RMSE uzluksiz testlet effektining aniqroq tiklanishini anglatadi.
Nega PCCR qattiq tasniflash mezoni?
Manba Tenglama (23):
\[ PCCR = \frac{1}{N} \sum_{i=1}^{N} I( \widehat{\boldsymbol{\alpha}}_i = \boldsymbol{\alpha}_i ) \tag{23} \]
Pattern-wise Correct Classification Rate (PCCR) faqat alohida ko‘nikmalar to‘g‘ri tasniflanishini emas, balki o‘quvchining butun atribut profili to‘liq to‘g‘ri bo‘lishini talab qiladi. Masalan, haqiqiy profil \((1,1,0)\) bo‘lsa-yu \((1,0,0)\) deb baholansa, uchta atributdan ikkitasi to‘g‘ri bo‘lishiga qaramay PCCR nuqtai nazaridan butun profil noto‘g‘ri hisoblanadi. Shu sababli PCCR qattiq mezondir.
EAP dastlab ikkilik profil o‘rniga har bir atribut uchun 0–1 oralig‘ida aposterior o‘zlashtirish ehtimolligini hosil qiladi. Manba taqqoslashni bir xil ikkilik shkalaga keltirish uchun 0,50 chegarasidan foydalanadi:
\[ \widehat{\alpha}_{ik}^{binary} = I\left[ P(\alpha_{ik}=1\mid\mathbf{y}_i)\geq0.50 \right] \tag{24} \]
Nega Monte Carlo standart xatosi hisoblandi?
Barcha simulyatsiya shartlari mustaqil ravishda \(R=500\) marta takrorlangan. PCCR ning takrorlar orasidagi o‘zgaruvchanligini ko‘rsatish uchun Monte Carlo standart xatosi hisoblangan:
\[ \widehat{MCSE}(PCCR) = \frac{ SD\left( PCCR^{(1)},\ldots,PCCR^{(R)} \right) }{ \sqrt{R} } \tag{25} \]
Bu yerda \(SD\) 500 ta takror davomida olingan PCCR qiymatlarining tanlanma standart og‘ishidir. PCCR foizda ifodalansa, MCSE ham foiz punkti sifatida talqin qilinadi.
Tadqiqot Usuli va Natijalari
Simulyatsiya dizayni
Tadqiqot MLE, MAP va EAP ni beshta turli ma’lumot yaratish/baholash ssenariysida taqqoslagan. Barcha asosiy shartlarda tanlanma hajmi 10.000 kishidan iborat. Testletlar soni 3 yoki 4, har bir testletdagi topshiriqlar soni esa 10, 20, 30, 40 yoki 50 qilib o‘zgartirilgan.
Case 1–4 uchun \(K=3\) va sakkizta atribut profilining ehtimolligi teng bo‘lgan tekis populyatsiya tuzilmasi qo‘llangan. Case 5 da \(K=5\) gacha oshirilgan va haqiqiy atribut profili taqsimoti tekis bo‘lmagan shaklga o‘tkazilgan.
| Shart | Haqiqiy ma’lumot modeli | Baholash modeli | \(\beta\) | \(\gamma\) | Asosiy maqsad |
|---|---|---|---|---|---|
| Case 1 | IT-DINA | IT-DINA | 0,5 | 0,5 | To‘g‘ri spetsifikatsiya qilingan asosiy IT-DINA sharti |
| Case 2 | DINA | IT-DINA | 0 | 0 | Haqiqatda testlet effekti bo‘lmagan holda zaruridan murakkab modeldan foydalanish |
| Case 3 | T-DINA | IT-DINA | 1 | 0 | Asosiy testlet effekti mavjud bo‘lganda keraksiz o‘zaro ta’sir komponentini qo‘shish |
| Case 4 | IT-DINA | T-DINA | 0,5 | 1 | Haqiqiy o‘zaro ta’sir komponentini baholash modelidan chiqarib tashlash |
| Case 5 | IT-DINA | IT-DINA | Mutlaq qiymat 0,5; aralash ishora | Mutlaq qiymat 1; aralash ishora | Yuqoriroq o‘lcham, notekis populyatsiya va aralash ishorali yuklamalar ostida barqarorlik |
Case 5 da haqiqiy atribut taqsimoti qanday yaratildi?
Beshta atribut bo‘lgani uchun 32 ta mumkin bo‘lgan profil mavjud. Haqiqiy populyatsiyada nol, bir yoki ikki atributni o‘zlashtirgan profillar uchun sinf ehtimolligi \(\pi_c=1/48\); uch yoki undan ko‘p atributni o‘zlashtirgan profillar uchun esa \(\pi_c=1/24\) deb belgilangan. Shu tariqa yuqori o‘zlashtirish profillari past o‘zlashtirish profillariga nisbatan ikki baravar sinf ehtimolligiga ega bo‘lgan.
Shunga qaramay, MAP va EAP uchun barcha Case 1–5 shartlarida atribut profillari bo‘yicha tekis aprior qo‘llash davom ettirilgan. Case 5 ning ilmiy ahamiyati aynan shunda: haqiqiy populyatsiya tuzilmasi bilan Bayes atribut apriori ataylab nomuvofiq qilingan.
Modeldan kelib chiqadigan taxmin va sirpanish ehtimolliklari
| Shart | \(\beta\) | \(\gamma\) | \(g^*\) oralig‘i | \(1-c^*\) oralig‘i |
|---|---|---|---|---|
| Case 1 | 0,5 | 0,5 | 0,0605–0,2137 | 0,0605–0,2137 |
| Case 2 | 0 | 0 | 0,0500–0,2000 | 0,0500–0,2000 |
| Case 3 | 1 | 0 | 0,0706–0,2257 | 0,0706–0,2257 |
| Case 4 | 0,5 | 1 | 0,0755–0,2312 | 0,0755–0,2312 |
| Case 5 | ±0,5 | ±1 | 0,0755–0,2312 | 0,0755–0,2312 |
Case 1: to‘g‘ri spetsifikatsiya qilingan IT-DINA
Ushbu asosiy shartda ham ma’lumot yaratish, ham baholash modeli IT-DINA. EAP va MAP testlet-effekti bo‘yicha sistematik og‘ishlarni mutlaq qiymatda odatda 0,005 dan past saqlagan. MLE da 10 ta topshiriqli testletlarda ayrim testlet effektlari uchun mutlaq og‘ish taxminan 0,02–0,04 gacha yetgan. Testlet 50 ta topshiriqqacha uzayganda MLE og‘ishi kamaygan, ammo taxminan 0,01 darajasida qolgan.
RMSE bo‘yicha EAP va MAP testlet uzunligi ortgani sari taxminan 0,35 dan 0,20 gacha pasaygan. MLE 10 ta topshiriqli testletlarda taxminan 0,55–0,65 RMSE ko‘rsatgan; 50 ta topshiriqda ham taxminan 0,30–0,35 darajasida qolgan.
PCCR bo‘yicha Bayes usullari umumiy holda %97 dan yuqori, 50 ta topshiriqqa yaqinlashganda taxminan %98,5 gacha yetgan, MLE esa taxminan %93–95 oralig‘ida qolgan.
Case 2: haqiqatda testlet effekti yo‘q, ammo IT-DINA baholanadi
Bu shartda \(\beta=\gamma=0\). Boshqacha aytganda, ma’lumot yaratish jarayonida testlet effektlari javob ehtimolliklarini o‘zgartirmaydi; shunga qaramay baholashda to‘liq IT-DINA modeli qo‘llanadi. Bu keraksiz uzluksiz komponentlarning modelga qo‘shilishiga nisbatan usullarning xatti-harakatini sinaydi.
EAP va MAP uchun testlet-effekti og‘ishlari nolga juda yaqin, RMSE qiymatlari taxminan 0,49–0,50 deb topilgan. MLE og‘ishlarining mutlaq qiymati taxminan 0,003–0,006 va RMSE si taxminan 0,55–0,69 oralig‘ida.
Bu yerdagi 0,49–0,50 RMSE ni ehtiyotkorlik bilan o‘qish kerak. Manbada shaxs testlet o‘zgaruvchilari \(N(0,0.5^2)\) shkalasida yaratilgan bo‘lsa-da, ularning javoblarga yuklamalari nol. Shu sababli javob ma’lumotlari individual testlet effektlarini aniqlash uchun bevosita axborot bermaydi. Bayes regularizatsiyasi baholarni aprior markaziga yaqin tutadi; manba bu xatti-harakatni keraksiz komponentlarning beqarorlashishini cheklashi nuqtai nazaridan talqin qiladi.
Case 3: haqiqiy model T-DINA, baholash IT-DINA
Haqiqiy ma’lumotlarda asosiy testlet effekti mavjud, ammo o‘zaro ta’sir komponenti yo‘q. IT-DINA esa ikkala komponentni ham baholashga urinadi.
Haqiqiy asosiy effekt komponentlarida EAP og‘ishi mutlaq qiymatda 0,001 dan past qolgan va RMSE taxminan 0,43 dan 0,34 gacha pasaygan. MAP og‘ishi taxminan 0,001–0,006; RMSE si 0,40–0,50 oralig‘ida. MLE ning og‘ishi taxminan 0,004–0,02, RMSE si esa taxminan 0,50–0,69.
Haqiqatda mavjud bo‘lmagan o‘zaro ta’sir komponentida EAP va MAP og‘ishlari yana nolga juda yaqin qolgan, RMSE esa taxminan 0,49–0,50 atrofida bo‘lgan. MLE keraksiz komponentda yuqoriroq og‘ish va RMSE ko‘rsatgan.
Case 4: haqiqiy IT-DINA, ammo baholash soddaroq T-DINA
Bu shart zaruridan ortiq murakkab modelning teskarisini sinaydi. Haqiqiy ma’lumotda ham asosiy testlet effekti, ham o‘zaro ta’sir mavjud, biroq baholash modeli o‘zaro ta’sir bilan bog‘liq \(\xi_2\) komponentini o‘z ichiga olmaydi.
EAP uch va to‘rt testletli shartlarda umuman eng kichik Bias va RMSE ni bergan. MAP ko‘p shartlarda EAP ga yaqin qolgan. MLE ayniqsa qisqa testletlarda ko‘proq tebrangan. Manba to‘g‘ri spetsifikatsiya qilingan Case 1 bilan taqqoslaganda MLE og‘ishi taxminan 2–5 baravar oshishi mumkinligini va qisqa testletlarda RMSE 0,80 dan oshishi mumkinligini bildiradi.
Tasniflashda qisqa testletlar uchun EAP bilan MLE o‘rtasidagi PCCR farqi taxminan 6–7 foiz punktiga yetgan. Bu natija faqat model tanlovi emas, shaxs parametrini baholash usuli ham to‘liq spetsifikatsiya qilinmagan modellarda diagnostik natijani o‘zgartirishi mumkinligini ko‘rsatadi.
Bayes Usullari Har Qanday Shartda Yaxshiroq Edimi?
Yo‘q. EAP va MAP beshinchi simulyatsiya shartida uzluksiz testlet effektlarining Bias va RMSE si bo‘yicha MLE dan barqarorroq qolganiga qaramay, butun atribut profilini to‘g‘ri tasniflaydigan PCCR metrikasida MLE biroz yuqoriroq natija bergan. Manba buni haqiqiy atribut profili taqsimoti tekis emasligi bilan MAP/EAP ning tekis atribut aprioridan foydalanishi o‘rtasidagi nomuvofiqlik bilan bog‘laydi; demak, Bayes ustunligi apriorning to‘g‘riligidan mustaqil emas.
Case 5: aprior taqsimot nomuvofiq bo‘lganda nima yuz berdi?
EAP va MAP ning uzluksiz testlet effektlaridagi Bias qiymatlari kichik qolgan, MLE ayniqsa qisqa testletlarda yuqoriroq RMSE hosil qilgan. Bunga qarshi ravishda PCCR da EAP va MAP taxminan %87–91, MLE esa taxminan %90–93 oralig‘ida.
Bu natija ikki xil baholash maqsadi bir xil narsa emasligini ko‘rsatadi. Bir usul uzluksiz testlet effektini yaxshiroq tiklashi bilan bir vaqtda diskret atribut profilini ham yaxshiroq tasniflashi shart emas. Ayniqsa Bayes tasnifi haqiqiy populyatsiya taqsimotiga mos kelmaydigan profil aprioridan ta’sirlanishi mumkin.
PCCR uchun simulyatsiya o‘zgaruvchanligi
500 ta mustaqil takror asosida hisoblangan MCSE qiymatlari barcha shartlarda taxminan %0,08–%1,50 oralig‘ida. Case 1–3 da qiymatlar odatda %1 dan past qolgan. Case 4 da ayniqsa MLE uchun o‘zgaruvchanlik oshgan; eng yuqori MCSE qiymatlari yuqoriroq atribut o‘lchami va pastroq tasniflash aniqligi bo‘lgan Case 5 da taxminan %1,17–%1,50 oralig‘ida kuzatilgan.
Testlet uzunligimi yoki testletlar sonimi muhimroq edi?
Manba muhokamasiga ko‘ra, ushbu simulyatsiya shartlarida har bir testletdagi topshiriqlar sonini oshirish testletlar sonini oshirishga qaraganda kattaroq aniqlik yutuqlarini bergan. Matematik jihatdan bu ayni uzluksiz testlet effekti haqida ko‘proq topshiriq javobi axborot berishini anglatadi.
Biroq tadqiqot bu natijani universal imtihon dizayni qoidasi sifatida bermaydi. Simulyatsiyada atribut o‘lchami, topshiriq sifati va model tuzilmasi muayyan chegaralarda; yuqoriroq o‘lchamli, topshiriq axboroti zaifroq yoki shovqini ko‘proq baholashlarda ayni miqdordagi yutuq kafolatlanmaydi.
TIMSS 2023 empirik qo‘llanilishi qanday tuzildi?
Empirik namoyishda TIMSS 2023 sakkizinchi sinf matematika xalqaro ma’lumotlar bazasidan foydalanilgan. Dastlab 308.492 o‘quvchi va baholash bukletlari bo‘yicha 68 ta nomzod matematika topshirig‘i mavjud bo‘lgan. Javobsiz yoki yaroqsiz javoblar yetishmayotgan qiymat sifatida belgilangan; beshtadan kam yaroqli javobi bo‘lgan o‘quvchilar chiqarilgan va yakuniy shaxs tanlanmasi 118.547 bo‘lgan.
Tadqiqot TIMSS ning rotatsion buklet dizaynidagi topshiriq bloklarini operatsion testlet birligi sifatida ishlatgan. B_MD3 va B_MD5 ayni tanlangan buklet ichida ayni respondent guruhiga qo‘llangani va ma’lumotlarni tozalashdan so‘ng yetarli topshiriq-darajali o‘zgaruvchanlikni saqlagani uchun tanlangan.
Bu yerda muhim terminologik chegara mavjud: manba TIMSS bloklari tor ma’noda yagona umumiy stimulni bo‘lishadigan klassik “testlet” bo‘lishi shart emasligini aniq qayd etadi. Ular ayni blok ichida qoluvchi qoldiq bog‘liqlikni modellashtirish maqsadida operatsion testletlar sifatida qo‘llangan.
Nega polytomous topshiriqlar ikkilik holga keltirildi?
Tanlangan constructed-response topshiriqlarining asl TIMSS ballari bir nechta ball kategoriyasiga ega bo‘lishi mumkin. DINA, T-DINA va IT-DINA ning ushbu tadqiqotda ishlatilgan shakllari ikkilik javoblarga tayangani sababli noldan katta barcha ballar to‘g‘ri = 1, nol ball noto‘g‘ri = 0 deb qayta kodlangan.
Bu o‘zgartirish qisman kredit haqidagi axborotni yo‘qotadi. Masalan, 1 ball va 2 ball olgan ikki o‘quvchi ham “to‘g‘ri” kategoriyasiga kirishi mumkin. Manba buni tadqiqotning muhim cheklovlaridan biri sifatida ochiq tan oladi.
| Bosqich | Manbada berilgan tuzilma |
|---|---|
| Dastlabki shaxslar soni | 308.492 |
| Nomzod matematika topshiriqlari | 68 |
| Shaxsni chiqarish mezoni | 5 tadan kam yaroqli javobi bo‘lgan o‘quvchi chiqarildi |
| Yakuniy shaxslar soni | 118.547 |
| Operatsion testletlar | B_MD3 va B_MD5 |
| Yakuniy topshiriqlar soni | 27 ta ikkilik topshiriq |
| B_MD3 | 15 ta topshiriq |
| B_MD5 | 12 ta topshiriq |
| Atributlar | Applying 11, Knowing 4, Reasoning 12 ta topshiriq |
TIMSS Q-matritsasi qanday tuzildi?
TIMSS matematika topshiriqlarining rasmiy kognitiv soha tasnifi tadqiqotda uchta ikkilik diagnostik atribut sifatida ishlatilgan: Knowing (Bilish), Applying (Qo‘llash) va Reasoning (Mulohaza yuritish). Har bir tahlil topshirig‘i faqat bitta kognitiv sohaga biriktirilgan; shu sababli Q-matritsaning har bir qatorida faqat bitta 1 mavjud.
27 ta topshiriqdan 11 tasi Applying, 4 tasi Knowing va 12 tasi Reasoning deb kodlangan. Bu ishlatilgan Q-matritsa umumiy ko‘p-atributli CDM larga qaraganda ancha sodda tuzilishga ega ekanini anglatadi. Tadqiqot muhokamasida yuqori tasniflash ko‘rsatkichlarini yuqoriroq atribut o‘lchamiga yoki murakkabroq Q-matritsalarga bevosita umumlashtirmaslik kerakligi alohida ta’kidlanadi.
Manbadagi TIMSS topshiriq kodi nomuvofiqligi
Manba Jadval 7 da B_MD3 ichidagi ikki topshiriq kodi MQ8N208A va MQ8N208B ko‘rinishida berilgan bo‘lsa, ayni topshiriqlarning parametr jadvali bo‘lgan Jadval 8 da kodlar MQ82N08A va MQ82N08B tarzida keltirilgan. Manba bu farq uchun tuzatish izohini bermagani sababli Verianla matni ikki yozilishdan birini jim tarzda “to‘g‘ri” deb e’lon qilmaydi.
Empirik topshiriq parametrlarining shkalasi
MLE, MAP va EAP shaxs baholarini taqqoslashda topshiriq parametrlari oldindan kalibrlangan va qat’iy saqlangan. Shu tariqa taqqoslash davomida usullar o‘rtasidagi farq topshiriq parametrlarini qayta baholashdan kelib chiqishining oldi olinishi ko‘zlangan.
Manba Jadval 8 da 27 ta topshiriq uchun \(\delta_0\), \(\delta_1\), standart xatolar va pass rate qiymatlari berilgan. \(\delta_0\) qiymatlari taxminan −4,06 dan −0,86 gacha, \(\delta_1\) qiymatlari taxminan −3,20 dan 3,88 gacha, pass rate esa taxminan 0,03 dan 0,24 gacha o‘zgaradi.
Manba ayrim \(\delta_1\) qiymatlari manfiy ekanini va ularni ehtiyotkorlik bilan talqin qilish zarurligini alohida qayd etadi. Matematik jihatdan manfiy \(\delta_1\), Tenglama (3) yoki (4) da boshqa komponentlar o‘zgarmaganida \(\eta\) ning 0 dan 1 ga o‘tishi chiziqli prediktorni oshirish o‘rniga kamaytirishini anglatadi. Manba bu noodatiy ishoralarning sababini yangi mexanizm sifatida isbotlamagani uchun Verianla ham buning sababini faraz qilmaydi.
Empirik hisoblash muhiti
Barcha tahlillar R 4.2.0 muhitida va katta tanlanma tufayli parallel hisoblashdan foydalanib bajarilgan. Model yaqinlashish mezoni ketma-ket iteratsiyalardagi parametr o‘zgarishining mutlaq farqi 0,001 dan kichik bo‘lishidir; maksimal iteratsiya soni 500 deb belgilangan.
MLE, MAP va EAP ning TIMSS dagi atribut profillari
| Profil | EAP | MAP | MLE |
|---|---|---|---|
| (0,0,0) | 12.045 (%10,16) | 11.892 (%10,03) | 8.273 (%6,98) |
| (1,0,0) | 10.342 (%8,72) | 10.101 (%8,52) | 7.464 (%6,30) |
| (0,1,0) | 8.976 (%7,57) | 8.743 (%7,37) | 6.739 (%5,68) |
| (0,0,1) | 18.342 (%15,48) | 18.567 (%15,66) | 32.479 (%27,40) |
| (1,1,0) | 9.543 (%8,05) | 9.321 (%7,86) | 7.158 (%6,04) |
| (1,0,1) | 14.237 (%12,01) | 14.512 (%12,24) | 12.089 (%10,20) |
| (0,1,1) | 12.876 (%10,86) | 13.045 (%11,00) | 11.724 (%9,89) |
| (1,1,1) | 32.186 (%27,15) | 32.366 (%27,31) | 32.621 (%27,52) |
EAP va MAP ning sakkiz profil uchun foizlari bir-biriga juda yaqin; har bir profil uchun farq %0,5 dan past. MLE taqsimoti esa ayniqsa \((0,0,1)\) profilida ajralib turadi: MLE bu sinfga 32.479 o‘quvchini, EAP 18.342 va MAP 18.567 o‘quvchini tayinlagan.
Testlet effekti taqsimotlarida nima ko‘rildi?
Manba 11-rasm ikkita operatsion testlet uchun \(\xi_1\) va \(\xi_2\) baholarining EAP, MAP va MLE taqsimotlarini boxplotlar orqali taqqoslaydi. EAP qiymatlari nol atrofida eng zich va eng tor kvartillararo oraliqqa ega. MAP biroz kengroq, ammo MLE dan zichroq qoladi. MLE da qutilar, whisker lar va chekka qiymatlar kengroq.
Rasmning xom shaxs-darajasidagi qiymatlari yoki barcha boxplot xulosalari manbada jadval shaklida berilmagani uchun Verianla tomonidan soxta sonli boxplot qayta chizilmagan. Ilmiy xabar matn va quyidagi tartib korrelyatsiyalari orqali saqlangan.
Kendall tartib korrelyatsiyalari
| Parametr | EAP–MAP | EAP–MLE | MAP–MLE |
|---|---|---|---|
| \(\xi_1\), T1 | 0,976 | 0,634 | 0,616 |
| \(\xi_1\), T2 | 0,981 | 0,578 | 0,642 |
| \(\xi_2\), T1 | 0,969 | 0,561 | 0,655 |
| \(\xi_2\), T2 | 0,982 | 0,553 | 0,649 |
EAP–MAP korrelyatsiyalarining barchasi 0,96 dan yuqori; bu ikki usul o‘quvchilarning testlet-effekti bo‘yicha tartiblarida juda o‘xshash ishlagan. MLE bilan Bayes usullari orasidagi korrelyatsiyalar taxminan 0,55–0,65 oralig‘ida qolgan va faqat o‘rtacha darajadagi moslikni ko‘rsatgan.
EAP va MAP tasniflari qanchalik o‘xshash edi?
Manba o‘tish matritsasida EAP dan MAP ga tasniflarning barcha sakkiz atribut profili uchun diagonal ulushlari %93 dan yuqori ekanini bildiradi. Bu ikki Bayes usuli faqat umumiy profil taqsimotlarida emas, shaxs darajasida ham katta darajada ayni sinflarni tanlaganini ko‘rsatadi.
EAP va MLE o‘rtasidagi sistematik siljish
EAP–MLE o‘tish matritsasi aniqroq ajralishni ko‘rsatgan. EAP tomonidan \((1,1,0)\) deb tasniflangan 9.543 o‘quvchining 1.571 tasi, ya’ni taxminan %16,5 i MLE tomonidan \((0,0,1)\) profiliga o‘tkazilgan.
Kuchliroq siljishlar \((0,0,0)\) va \((1,0,0)\) profillarida kuzatilgan. EAP ning \((0,0,0)\) guruhidagilarning taxminan %24,4 i, \((1,0,0)\) guruhidagilarning taxminan %25,2 i MLE tomonidan \((0,0,1)\) ga tayinlangan.
Bu topilma haqiqiy profil EAP ekanini anglatmaydi; empirik TIMSS qo‘llanilishida haqiqiy yashirin atribut profillari noma’lum. Natija faqat turli shaxs-parametrini baholash usullari ayni IT-DINA modeli va ayni ma’lumotlar ostida turli diagnostik tasniflar hosil qilishi mumkinligini ko‘rsatadi.
Testlet Effektlarini E’tiborsiz Qoldirish Diagnostik Tasnifni O‘zgartirishi Mumkinmi?
Ushbu TIMSS empirik misolida — ha. Testlet effektlari va ularning atribut holati bilan o‘zaro ta’sirlarini modellashtiradigan IT-DINA, mahalliy mustaqillikni faraz qiladigan DINA ga qaraganda yaxshiroq nisbiy moslik ko‘rsatgan va o‘quvchilarning atribut profili taqsimotini sezilarli darajada o‘zgartirgan. Biroq bu natija barcha TIMSS qo‘llanmalarida yoki barcha imtihonlarda IT-DINA avtomatik ravishda ustun bo‘ladi degani emas; manba uni muayyan ma’lumotlarni qayta ishlash va modellashtirish shartlaridagi empirik namoyish sifatida taqdim etadi.
DINA va IT-DINA model mosligi
| Model | Log-ehtimollik | Parametrlar soni | AIC | BIC |
|---|---|---|---|---|
| DINA | −1.523.456,23 | 54 | 3.047.020,5 | 3.047.520,3 |
| IT-DINA | −1.517.221,78 | 58 | 3.034.559,6 | 3.035.019,8 |
IT-DINA to‘rtta qo‘shimcha parametr ishlatishiga qaramay AIC va BIC qiymatlari taxminan 12.000 ga past. Manba shuningdek \(\Delta LL=6234,45\), \(\Delta df=4\) va \(p<0,001\) ni xabar qiladi. Ushbu natijalar ayni empirik ma’lumot va ayni model taqqoslashida IT-DINA DINA ga qaraganda yaxshiroq nisbiy moslik ko‘rsatganini qo‘llab-quvvatlaydi.
DINA va IT-DINA o‘quvchilarni qanday turlicha tasnifladi?
| Profil | IT-DINA (EAP) | DINA | DINA − IT-DINA shaxslar farqi |
|---|---|---|---|
| (0,0,0) | 12.045 (%10,16) | 8.273 (%6,98) | −3.772 |
| (1,0,0) | 10.342 (%8,72) | 7.464 (%6,30) | −2.878 |
| (0,1,0) | 8.976 (%7,57) | 6.739 (%5,68) | −2.237 |
| (0,0,1) | 18.342 (%15,48) | 32.479 (%27,40) | +14.137 |
| (1,1,0) | 9.543 (%8,05) | 7.158 (%6,04) | −2.385 |
| (1,0,1) | 14.237 (%12,01) | 12.089 (%10,20) | −2.148 |
| (0,1,1) | 12.876 (%10,86) | 11.724 (%9,89) | −1.152 |
| (1,1,1) | 32.186 (%27,15) | 32.621 (%27,52) | +435 |
Eng katta farq \((0,0,1)\) profilida. DINA 32.479 o‘quvchini, IT-DINA EAP esa 18.342 o‘quvchini ushbu profilga tayinlagan; farq 14.137 o‘quvchi. Manba tahlildagi ko‘plab topshiriqlar Reasoning atributi bilan bog‘liq bo‘lgani sababli ushbu siljish diagnostik talqin uchun muhimligini qayd etadi.
DINA \((0,0,0)\), \((1,0,0)\) va \((0,1,0)\) past-o‘zlashtirish profillarini IT-DINA ga nisbatan jami 8.887 kishi kam; \((1,1,0)\), \((1,0,1)\) va \((0,1,1)\) ko‘p-atributli profillarni esa jami taxminan 5.685 kishi kam tasniflagan. To‘liq o‘zlashtirish profili \((1,1,1)\) esa ikki modelda bir-biriga ancha yaqin.
Manbaning EAP uchun bergan izohi
Tadqiqot muhokamasiga ko‘ra EAP barqarorligini uchta o‘zaro bog‘liq mexanizm bilan tushuntirish mumkin. Birinchidan, EAP aposterior taqsimotning bitta modasidan emas, o‘rtachasidan foydalanadi. Bu holat har bir testlet bo‘yicha axborot kam bo‘lganda shaxs-darajasidagi baholarni nol tomonga regularizatsiya qilishi mumkin.
Ikkinchidan, IT-DINA ning ehtimollik yuzasi diskret atribut sinflari bilan uzluksiz testlet o‘zgaruvchilarini birgalikda o‘z ichiga olgani sababli qisqa testletlarda yassi, ko‘p modali yoki zaif aniqlangan bo‘lishi mumkin. Apriorsiz MLE bunday holatlarda tanlanma tebranishlariga ko‘proq ochiq qolishi mumkin.
Uchinchidan, MAP aprior regularizatsiyaga ega bo‘lsa ham aposterior taqsimotning faqat modasidan foydalanadi. Aposterior taqsimot keng yoki assimetrik bo‘lsa, moda mahalliy notekisliklarga sezgir qolishi mumkin. EAP butun aposterior zichlikni o‘rtachalab bu notekisliklarni ko‘proq yumshatishi mumkin. Ushbu izohlar tadqiqotda o‘rganilgan IT-DINA shartlariga tegishli va barcha psixometrik modellar uchun universal ustunlik dalili emas.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
- O‘rganilgan simulyatsiya shartlarida MAP va ayniqsa EAP uzluksiz testlet effektlarini tiklashda MLE ga qaraganda umuman barqarorroq natijalar bergan.
- Bayes ustunligi qisqa testletlarda va model tuzilmasi zaruridan ortiq murakkab yoki to‘liq bo‘lmagan tarzda spetsifikatsiya qilinganda yanada yaqqol bo‘lgan.
- To‘g‘ri spetsifikatsiya qilingan va o‘rtacha darajada noto‘g‘ri spetsifikatsiya qilingan shartlarda EAP/MAP atribut profili tasnifida MLE dan yuqoriroq PCCR hosil qila olgan.
- Haqiqiy atribut taqsimoti bilan qo‘llanilgan Bayes atribut apriori mos kelmaganda tasniflash ustunligi yo‘qolishi yoki teskari aylanishi mumkin.
- TIMSS empirik misolida MLE, MAP va EAP ayni IT-DINA modeli ostida turli shaxs-darajasidagi testlet effektlari va turli diagnostik tasniflar hosil qilgan.
- TIMSS empirik misolida IT-DINA DINA ga qaraganda yaxshiroq nisbiy AIC/BIC mosligini ko‘rsatgan va atribut profili taqsimotini o‘zgartirgan.
Tadqiqot qo‘llab-quvvatlamaydigan umumlashtirishlar
Tadqiqot “EAP barcha kognitiv-diagnostik modellarda doimo eng yaxshi usul”, “Bayes baholashi har qanday shartda MLE dan aniqroq tasniflaydi”, “TIMSS bloklarining barchasi haqiqiy umumiy-stimulli testlet”, “DINA ishlatish har bir baholashda noto‘g‘ri tasnif hosil qiladi” yoki “IT-DINA barcha imtihon tizimlarida albatta eng yaxshi model” degan xulosalarni qo‘llab-quvvatlamaydi.
Simulyatsiya natijalari tanlangan DINA/T-DINA/IT-DINA tuzilmalari, muayyan atribut o‘lchamlari, topshiriq sifati, aprior taqsimotlar, quadrature tartibi va optimallashtirish algoritmi ostida olingan. Empirik qo‘llanilishda esa haqiqiy atribut profillari noma’lum bo‘lgani sababli model va usullar orasidagi tasnif farqi qaysi profil mutlaq haqiqat ekanini bevosita isbotlamaydi.
Asosiy cheklovlar
Model oilasi chegarasi: Tadqiqot DINA, T-DINA va IT-DINA bilan cheklangan. Topilmalarni moslashuvchanroq G-DINA yoki boshqa testlet-asosli kognitiv-diagnostik modellarga avtomatik umumlashtirib bo‘lmaydi.
Polytomous axborot yo‘qotilishi: TIMSS constructed-response ballarini ikkilik holga keltirish qisman kredit axborotini tashlab yuboradi. Shu sababli empirik tasniflash va model mosligi natijalari qo‘llangan ikkilik ball tizimiga xos.
Populyatsiya reprezentativligi: TIMSS qo‘llanilishi model-asosli namoyishdir. Murakkab tanlanma og‘irliklari model kalibrlashiga yoki moslik baholashiga aniq kiritilmagan. Shu sababli natijalarni TIMSS populyatsiyasining reprezentativ ulushlari sifatida talqin qilmaslik kerak.
Sonli amalga oshirishga bog‘liqlik: MLE, MAP va EAP taqqoslashi qo‘llanilgan optimallashtirish algoritmi, Gauss–Hermite yondashuvi va aprior tanlovlariga bog‘liq. Boshqa sonli amalga oshirishlar miqdoriy natijalarni biroz o‘zgartirishi mumkin.
Aprior sezgirligi: Case 5 ayniqsa diskret atribut profili uchun noto‘g‘ri spetsifikatsiya qilingan aprior taqsimot Bayes tasnifiga ta’sir qilishi mumkinligini bevosita ko‘rsatadi. Shu sababli “aprior = regularizatsiya = avtomatik yaxshilanish” tarzidagi sodda xulosa chiqarib bo‘lmaydi.
Manba va Usul Haqida Izoh
Asl tadqiqot: Evaluating Person-Parameter Estimation Methods in Cognitive-Diagnostic Models with Testlet Effects
Mualliflar: Mei You, Jingjing Yang, Xin Xu.
Mualliflar tartibi: Manbadagi tartib aynan saqlangan.
Teng hissa: Manbada teng birinchi mualliflik yoki teng hissa belgisi ko‘rsatilmagan.
Mas’ul muallif: Xin Xu.
Affiliasiya: School of Science, Minzu University of China, Beijing 100081, China.
Jurnal: Education Sciences.
Nashriyot: MDPI.
Jild / son / maqola raqami: Volume 16, Issue 7, Article 1128.
DOI: 10.3390/educsci16071128.
Rasmiy DOI havolasi: https://doi.org/10.3390/educsci16071128
Yuborilgan sana: 11 may 2026.
Qayta ko‘rib chiqilgan sana: 10 iyul 2026.
Qabul qilingan sana: 13 iyul 2026.
Nashr sanasi: 15 iyul 2026.
Manba turi: Article / tadqiqot maqolasi. Tadqiqot faqat nazariy usul maqolasi emas; nazorat qilinadigan simulyatsiya taqqoslashlari va TIMSS 2023 ma’lumotlarida model-asosli empirik qo‘llanilishni birgalikda o‘z ichiga oladi.
Taqriz holati: Education Sciences jurnalida nashr etilgan, taqrizdan o‘tgan jurnal maqolasidir.
Litsenziya: Creative Commons Attribution (CC BY). PDF mualliflik huquqi 2026 yilda mualliflarga tegishli ekanini va MDPI litsenziya egasi/nashriyot sifatida ishni CC BY shartlari asosida nashr etganini bildiradi.
Moliyalashtirish: Tadqiqot Fundamental Research Funds for the Central Universities tomonidan qo‘llab-quvvatlangan.
Institutsional etika kengashi: Manbada “Not applicable” deb ko‘rsatilgan.
Axborotli rozilik: Manbada “Not applicable” deb ko‘rsatilgan.
Ma’lumotlardan foydalanish imkoniyati: Tadqiqotda ommaga ochiq ma’lumotlardan foydalanilgan. TIMSS 2023 xalqaro ma’lumotlar bazasiga TIMSS & PIRLS International Study Center orqali kirish mumkinligi; simulyatsiya natijalari maqolada tasvirlangan model va simulyatsiya shartlariga muvofiq yaratilgani qayd etiladi.
Manfaatlar to‘qnashuvi: Mualliflar manfaatlar to‘qnashuvini bildirmagan. Manba, shuningdek, moliyalashtiruvchining tadqiqot dizayni, ma’lumot to‘plash/tahlil/talqin qilish, maqola yozish yoki nashr qilish qarorida roli bo‘lmaganini bildiradi.
Muallif hissalari: Konseptuallashtirish Xin Xu; usul Xin Xu va Mei You; dasturiy ta’minot Mei You; tasdiqlash Mei You, Jingjing Yang va Xin Xu; formal tahlil Mei You; tadqiqot Mei You; resurslar Xin Xu; ma’lumotlar kuratsiyasi Mei You; dastlabki qoralamani yozish Mei You; ko‘rib chiqish va tahrirlash Jingjing Yang va Xin Xu; vizuallashtirish Mei You; rahbarlik Xin Xu; loyiha boshqaruvi Xin Xu; moliyalashtirishni jalb qilish Xin Xu.
Manba ichidagi nomuvofiqlik 1: TIMSS Q-matritsasini beruvchi Jadval 7 da ikki topshiriq kodi MQ8N208A va MQ8N208B; topshiriq parametrlarini beruvchi Jadval 8 da esa MQ82N08A va MQ82N08B deb yozilgan. Manbada bu farq uchun tuzatish izohi bo‘lmagani sababli Verianla qaysi yozilish to‘g‘ri ekaniga doir yangi da’vo yaratmagan.
Manba ichidagi nomuvofiqlik 2: PCCR usul izohida MLE va MAP ikkilik atribut baholarining tenglama raqamlariga qilingan o‘zaro havola usul bo‘limidagi haqiqiy diskret tanlash tenglamalari bilan mos kelmaydigandek ko‘rinadi. Shu sababli Verianla formulalarni tenglama mazmuni asosida tushuntirgan va manbada bo‘lmagan yangi tenglama raqamini tayinlamagan.
Asosiy metodologik chegara: Simulyatsiya natijasi tanlangan testlet sonlari, testlet uzunliklari, atribut o‘lchamlari, yuklamalar, topshiriq sifati, aprior tuzilmalar va sonli amalga oshirish bilan cheklangan. TIMSS qo‘llanilishi esa ikkilikka aylantirilgan constructed-response topshiriqlari, ikkita operatsion blok va tanlanma og‘irliklarini modelga bevosita kiritmaydigan model-asosli namoyishdir.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan