


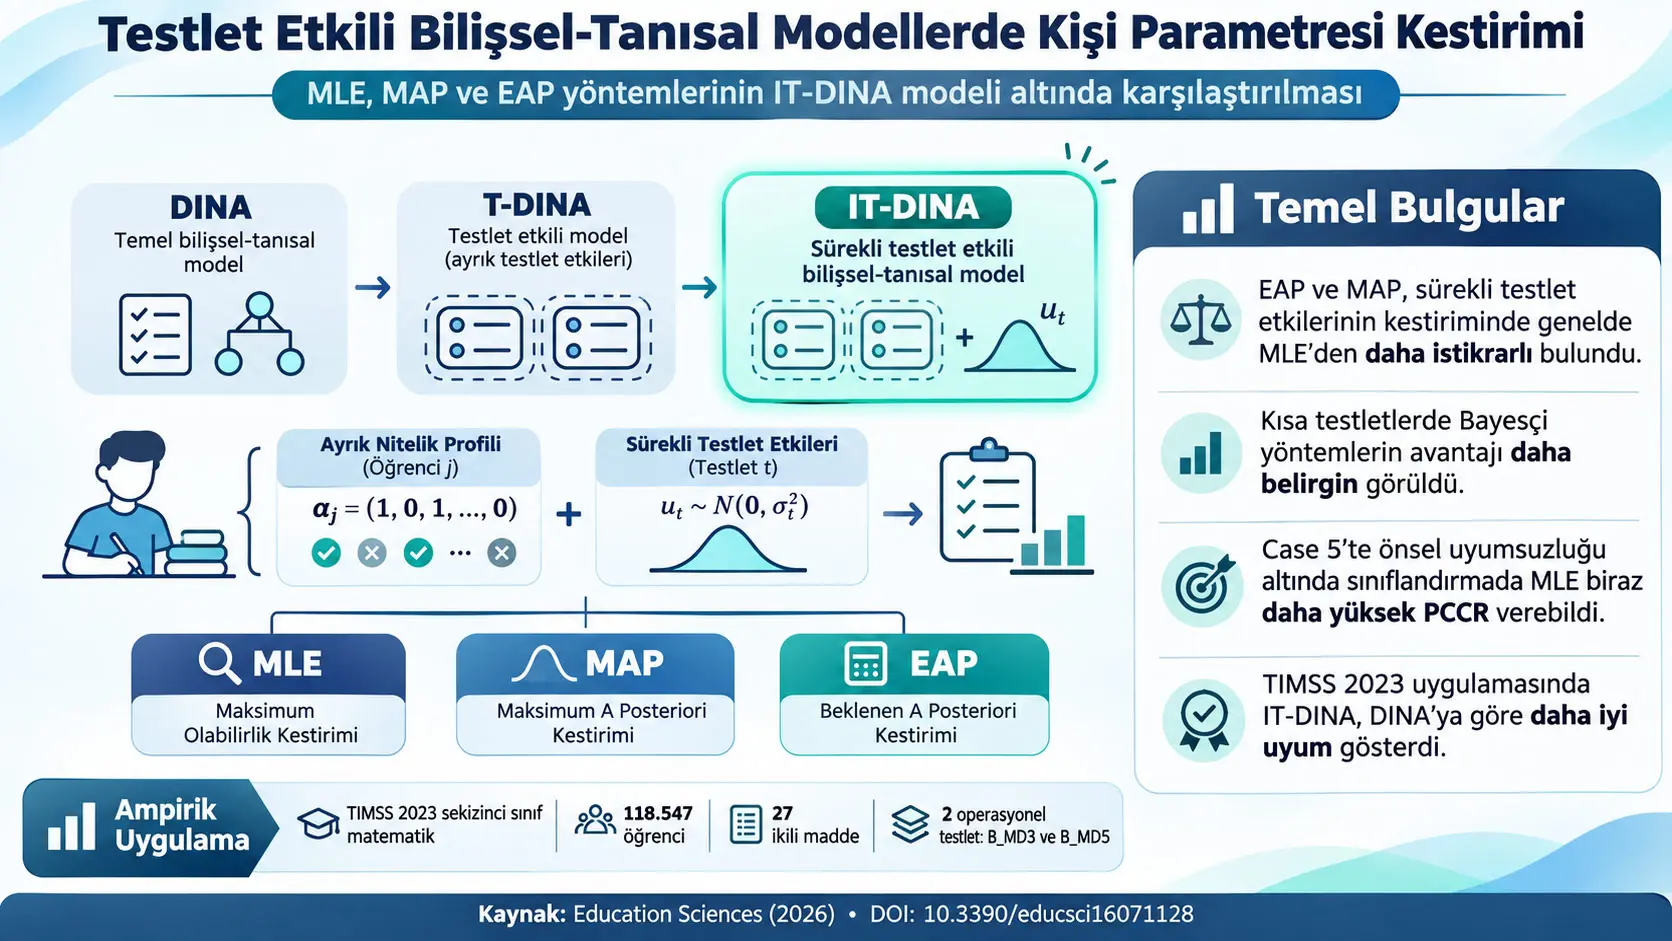
Etkileşimli Testlet DINA modeli (Interactive Testlet DINA, IT-DINA), bir öğrencinin hangi bilişsel niteliklere sahip olduğunu gösteren ayrık nitelik profili ile aynı testlet içindeki maddelerin ortak bağlamından kaynaklanabilen sürekli kişi-düzeyi testlet etkilerini birlikte modelleyen bir bilişsel-tanısal modeldir. Bu çalışma, böyle bir karma ayrık-sürekli gizil yapıda kişi parametrelerinin nasıl kestirileceğini inceleyerek maksimum olabilirlik kestirimi (Maximum Likelihood Estimation, MLE), maksimum sonsal kestirim (Maximum a Posteriori, MAP) ve sonsal beklenen değer kestirimi (Expected A Posteriori, EAP) yöntemlerini karşılaştırmaktadır.
Araştırmanın ilk bölümü simülasyona dayanır. Örneklem büyüklüğü her koşulda 10.000 olarak belirlenmiş; üç veya dört testlet, testlet başına 10, 20, 30, 40 veya 50 madde ve farklı model-doğruluğu koşulları incelenmiştir. Beş simülasyon senaryosu; doğru belirtilmiş IT-DINA modelini, gerçek testlet etkisi bulunmadığı halde IT-DINA kullanılmasını, yalnız ana testlet etkisinin bulunduğu durumda daha karmaşık IT-DINA kullanılmasını, gerçek IT-DINA verisinin daha basit T-DINA modeliyle kestirilmesini ve daha yüksek nitelik boyutu ile tekdüze olmayan gerçek nitelik dağılımının bulunduğu daha zor bir koşulu kapsamaktadır.
Simülasyonlarda EAP ve MAP, özellikle kısa testletlerde ve model yapısının gereğinden karmaşık veya eksik belirtildiği koşullarda sürekli testlet etkilerinin geri kazanımında MLE'ye göre daha istikrarlı sonuçlar vermiştir. Doğru belirtilmiş temel IT-DINA koşulunda EAP ve MAP'ın testlet-etkisi yanlılıkları mutlak değer olarak çoğunlukla 0,005'in altında kalırken, 10 maddelik kısa testletlerde bazı MLE yanlılıkları yaklaşık 0,02–0,04 düzeyine ulaşmıştır. Aynı koşulda Bayesçi yöntemlerin RMSE değerleri testlet uzunluğu arttıkça yaklaşık 0,35'ten 0,20'ye düşerken, MLE kısa testletlerde yaklaşık 0,55–0,65 RMSE göstermiştir.
Bununla birlikte çalışma “Bayesçi yöntemler her durumda üstündür” sonucunu desteklememektedir. Beşinci simülasyon koşulunda gerçek nitelik profilleri tekdüze olmayan bir dağılımdan üretilirken MAP ve EAP hesaplamasında tekdüze nitelik-profili önseli kullanılmaya devam edilmiştir. Bu önsel uyumsuzluğu altında sürekli testlet etkilerinin kestiriminde Bayesçi yöntemler daha istikrarlı kalmasına rağmen, tüm nitelik profilini aynı anda doğru sınıflandırma ölçütü olan PCCR açısından MLE yaklaşık %90–93, MAP ve EAP ise yaklaşık %87–91 aralığında sonuç vermiştir. Bu bulgu, önsel dağılım seçiminin sınıflandırma hedefi açısından bilimsel olarak önemli olduğunu göstermektedir.
Çalışmanın ikinci bölümü TIMSS 2023 sekizinci sınıf matematik verisiyle yapılan ampirik bir gösterimdir. Başlangıçtaki 308.492 öğrenci ve 68 aday matematik maddesinden veri temizleme sonrasında 118.547 öğrenci ve 27 ikili madde analiz edilmiştir. B_MD3 ve B_MD5 blokları iki operasyonel testlet olarak kullanılmıştır. IT-DINA, bu veri üzerinde geleneksel DINA modeline göre daha düşük AIC ve BIC değerleri vermiş ve iki model öğrencileri bilişsel nitelik profillerine belirgin biçimde farklı dağıtmıştır. Ancak bu TIMSS uygulaması nüfus düzeyinde temsilî bir sonuç kanıtı değil, model davranışını gerçek değerlendirme verisi üzerinde gösteren bir ampirik örnektir.
Bilişsel-tanısal model neyi çözmeye çalışıyor?
Geleneksel birçok ölçme modeli bir öğrencinin performansını tek bir sürekli yetenek puanı ile özetlemeye çalışır. Bilişsel-tanısal modeller (Cognitive-Diagnostic Models, CDMs) ise farklı bir soru sorar: Öğrenci belirli bilgi veya beceri bileşenlerinden hangilerine sahip, hangilerine sahip değil? Bu nedenle modelin gizil değişkeni tek bir puan olmak zorunda değildir; birden fazla ikili bilişsel niteliğin oluşturduğu bir profil olabilir.
Örneğin üç bilişsel nitelik bulunduğunda bir öğrencinin profili \((1,0,1)\) olabilir. Buradaki 1 ilgili niteliğin kazanıldığını, 0 ise kazanılmadığını gösterir. Üç ikili nitelik varsa toplam \(2^3=8\) olası profil; beş nitelik varsa \(2^5=32\) olası profil vardır. Bu nedenle nitelik sayısı arttıkça öğrencinin hangi gizil sınıfa ait olduğunu belirleme problemi de büyür.
Testlet Etkisi ve Yerel Madde Bağımlılığı Nedir?
Testlet etkisi, aynı ortak metin, tablo, senaryo, soru bloğu veya başka bir bağlam içinde sunulan maddelerin, ölçülmek istenen bilişsel nitelikler hesaba katıldıktan sonra bile birbirleriyle ilişkili yanıt davranışı gösterebilmesini temsil eden ek gizil etkidir. Standart modellerde öğrencinin bilişsel nitelikleri bilindiğinde maddelerin birbirinden bağımsız olması beklenir; bu koşul sağlanmıyorsa yerel madde bağımlılığı (local item dependence, LID) vardır.
Bu ayrım önemlidir. Aynı metni kullanan beş soruda öğrencinin o metni olağan dışı biçimde iyi veya kötü işlemesi, beş yanıtın tamamını birlikte etkileyebilir. Böyle bir ortak etki yalnız ölçülmek istenen becerilere yüklenirse model ölçme kesinliğini olduğundan fazla gösterebilir veya öğrenciyi yanlış nitelik profiline sınıflandırabilir. Testlet modelleri bu artık ortaklığı ayrıca modellemeye çalışır.
Temel gösterim: öğrenci, madde, testlet ve nitelik
| Sembol | Anlamı | Türü |
|---|---|---|
| \(N\) | Öğrenci / sınava giren kişi sayısı | Sayım |
| \(S\) | Testlet sayısı | Sayım |
| \(J_s\) | \(s\) testletindeki madde sayısı | Sayım |
| \(J=\sum_{s=1}^{S}J_s\) | Toplam madde sayısı | Sayım |
| \(K\) | İkili bilişsel nitelik sayısı | Sayım |
| \(\boldsymbol{\alpha}_i\) | \(i\) öğrencisinin nitelik profili | \(K\) boyutlu ikili vektör |
| \(\alpha_{ik}\) | Öğrenci \(i\), nitelik \(k\)'ya sahipse 1; değilse 0 | İkili |
| \(q_{jk}\) | Madde \(j\), nitelik \(k\)'yı gerektiriyorsa 1 | Q-matrisi elemanı |
| \(\eta_{ij}\) | Öğrenci \(i\)'nin madde \(j\) için gereken bütün niteliklere sahip olup olmadığını gösteren ideal yanıt göstergesi | İkili |
| \(Y_{ij}\) | Gözlenen yanıt; doğruysa 1, yanlışsa 0 | İkili |
| \(\boldsymbol{\xi}_i\) | Öğrenciye ait sürekli testlet-etkisi parametreleri | Sürekli gizil vektör |
Q-matrisi ne yapıyor?
Q-matrisi, hangi maddenin hangi bilişsel niteliği gerektirdiğini gösteren \(J\times K\) boyutlu ikili bir matristir. \(q_{jk}=1\) ise madde \(j\)'nin doğru çözümü için nitelik \(k\) gereklidir; \(q_{jk}=0\) ise o nitelik madde için gerekli kabul edilmez.
Öğrencinin madde için ideal olarak gerekli bütün niteliklere sahip olup olmadığını gösteren değişken kaynakta şu birleşimli yapı ile tanımlanır:
\[ \eta_{ij}=\prod_{k=1}^{K}(\alpha_{ik})^{q_{jk}} \]
Bu çarpımın mantığı bir “VE” kapısıdır. Bir madde iki niteliği gerektiriyorsa ve öğrencide bunlardan biri yoksa ilgili çarpan 0 olur ve bütün çarpım \(\eta_{ij}=0\) sonucuna gider. Öğrencinin gerekli niteliklerin tamamına sahip olması durumunda \(\eta_{ij}=1\) olur.
DINA modeli: temel başlangıç noktası
DINA (Deterministic Inputs, Noisy “AND” Gate) modeli, gerekli niteliklerin tümüne sahip olmayı başarı için birleşimli koşul olarak kabul eder. Bununla birlikte gerçek sınav davranışı tamamen deterministik değildir: gerekli niteliklerin tümüne sahip bir öğrenci hata yapabilir; gerekli nitelikleri olmayan bir öğrenci de tahmin yoluyla doğru yanıt verebilir.
Kaynak Denklem (1):
\[ P(Y_{ij}=1\mid\boldsymbol{\alpha}_i) =(1-s_j)^{\eta_{ij}}g_j^{\,1-\eta_{ij}} \tag{1} \]
\(s_j\), madde \(j\) için slipping / kayma-hata olasılığıdır. Öğrenci gerekli tüm niteliklere sahip olduğu halde yanlış yanıt verme ihtimalini temsil eder. Bu nedenle \(\eta_{ij}=1\) olduğunda doğru yanıt olasılığı \(1-s_j\)'dir.
\(g_j\), guessing / tahmin olasılığıdır. Öğrenci gerekli tüm niteliklere sahip değilken doğru yanıt verme ihtimalini temsil eder. \(\eta_{ij}=0\) olduğunda Denklem (1) doğrudan \(g_j\)'ye indirgenir.
Denklemin üs yapısı iki durumu tek formülde birleştirir. \(\eta_{ij}=1\) ise \(g_j^{0}=1\) olur ve geriye \(1-s_j\) kalır. \(\eta_{ij}=0\) ise \((1-s_j)^0=1\) olur ve geriye \(g_j\) kalır. Bu nedenle formülün amacı yalnız cebirsel kısalık değil, DINA'nın iki gizil durumunu tek yanıt fonksiyonunda ifade etmektir.
Öğrencinin bütün yanıt vektörü \(\mathbf{y}_i=(y_{i1},\ldots,y_{iJ})\) için, nitelik profili bilindiğinde maddelerin koşullu bağımsız olduğu varsayılırsa kaynak Denklem (2)'de olabilirliği şöyle tanımlar:
\[ L(\mathbf{y}_i\mid\boldsymbol{\alpha}_i) =\prod_{j=1}^{J}P(Y_{ij}=y_{ij}\mid\boldsymbol{\alpha}_i) \tag{2} \]
Burada çarpım, öğrencinin gözlenen bütün madde yanıtlarının birlikte ne kadar olası olduğunu hesaplar. Standart DINA'nın kritik varsayımı bu noktadadır: \(\boldsymbol{\alpha}_i\) bilindiğinde maddeler arasında başka sistematik bağımlılık kalmadığı kabul edilir. Testlet problemi tam olarak bu varsayımın ihlal edilebildiği durumla ilgilidir.
T-DINA: testlet için ek rastgele etki
Testlet Effect DINA (T-DINA), aynı testlet içindeki maddeler arasında nitelik profilinin açıklamadığı ortaklığı temsil etmek için öğrenci \(i\) ve testlet \(s\)'ye özgü sürekli bir \(\xi_{is}\) rastgele etkisi ekler.
Kaynak Denklem (3):
\[ P(Y_{ij}=1\mid\boldsymbol{\alpha}_i,\xi_{is}) =h\!\left(\delta_{0j}+\delta_{1j}\eta_{ij}+\beta_{js}\xi_{is}\right) \tag{3} \]
\(h(\cdot)\) bir bağlantı fonksiyonudur; kaynak lojistik veya probit bağlantının kullanılabileceğini belirtir. \(\delta_{0j}\) maddeye özgü kesme parametresi, \(\delta_{1j}\) ideal yanıt durumunun madde üzerindeki etkisini, \(\beta_{js}\) ise testlet etkisinin madde \(j\)'ye ne kadar güçlü yüklendiğini belirtir.
\(\xi_{is}\) sıfıra yakınsa testletin öğrenciye özgü ek etkisi zayıftır. Mutlak değeri büyüdükçe ortak testlet bileşeni doğrusal kestiriciyi daha fazla değiştirir; ancak son doğru yanıt olasılığı doğrudan doğrusal değildir, \(h(\cdot)\) bağlantı fonksiyonundan geçirilir.
IT-DINA: testlet etkisi nitelik durumuyla etkileşebiliyor
T-DINA'da testlet etkisi, öğrencinin ideal yanıt durumundan bağımsız eklenir. IT-DINA ise bu etkinin \(\eta_{ij}\)'ye göre değişebilmesine izin verir.
Kaynak Denklem (4):
\[ P(Y_{ij}=1\mid\boldsymbol{\alpha}_i,\boldsymbol{\xi}_{is}) =h\!\left[ \delta_{0j} +\delta_{1j}\eta_{ij} +\beta_{js}\xi_{is1} +\gamma_{js}(2\eta_{ij}-1)\xi_{is2} \right] \tag{4} \]
Burada \(\boldsymbol{\xi}_{is}=(\xi_{is1},\xi_{is2})^\prime\) iki bileşenli testlet-etkisi vektörüdür. \(\beta_{js}\xi_{is1}\) ana testlet etkisini, \(\gamma_{js}(2\eta_{ij}-1)\xi_{is2}\) ise nitelik durumuna bağlı etkileşim bileşenini temsil eder.
\((2\eta_{ij}-1)\) teriminin özel bir görevi vardır. \(\eta_{ij}=1\) olduğunda bu terim \(+1\), \(\eta_{ij}=0\) olduğunda \(-1\) olur. Böylece \(\xi_{is2}\)'nin doğrusal kestiriciye katkısının yönü ideal yanıt durumuna göre değişebilir. Bu yapı, testlet bağımlılığının gerekli niteliklere sahip olanlarla olmayanlarda aynı biçimde davranmak zorunda olmadığını modele dahil eder.
| Model | Nitelik profili | Testlet ana etkisi | Nitelik × testlet etkileşimi |
|---|---|---|---|
| DINA | Var | Yok | Yok |
| T-DINA | Var | Var: \(\beta_{js}\xi_{is}\) | Yok |
| IT-DINA | Var | Var: \(\beta_{js}\xi_{is1}\) | Var: \(\gamma_{js}(2\eta_{ij}-1)\xi_{is2}\) |
Kişi parametresi neden karma bir yapı?
Çalışmada bir öğrencinin tüm kişi parametreleri
\[ \boldsymbol{\lambda}_i=(\boldsymbol{\alpha}_i,\boldsymbol{\xi}_i) \]
olarak düşünülür. \(\boldsymbol{\alpha}_i\) ayrık bir nitelik profilidir; örneğin \((1,0,1)\). \(\boldsymbol{\xi}_i\) ise sürekli testlet etkilerinden oluşur. Dolayısıyla algoritma aynı anda hem “öğrenci hangi gizil sınıfta?” hem de “bu öğrenci için sürekli testlet etkisinin değeri nedir?” sorularını çözmek zorundadır. Araştırmanın MLE, MAP ve EAP karşılaştırmasını önemli hale getiren temel matematiksel zorluk budur.
MLE, MAP ve EAP Bu Çalışmada Nasıl Ayrılıyor?
MLE yalnız gözlenen yanıtların olabilirliğini en yüksek yapan kişi parametrelerini seçer; MAP aynı olabilirliğe önsel dağılım bilgisini ekleyerek sonsal yoğunluğun tepe noktasını seçer; EAP ise tek bir tepe noktasını seçmek yerine bütün sonsal dağılımı hesaba katar ve parametrenin sonsal ortalamasını kullanır. Bu nedenle MAP ve EAP düzenlileştirme sağlayabilir, ancak sonuçları kullanılan önsel dağılımın uygunluğuna da bağlıdır.
MLE: yalnız verinin olabilirliğini en yüksek yap
Kaynak Denklem (5), ikili yanıtlar için kişi düzeyi log-olabilirliğini verir:
\[ \ell(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) = \sum_{j=1}^{J} \left[ y_{ij}\log P_{ij} + (1-y_{ij})\log(1-P_{ij}) \right] \tag{5} \]
Burada \(P_{ij}=P(Y_{ij}=1\mid\boldsymbol{\lambda}_i)\)'dir. Öğrenci maddeyi doğru yanıtlamışsa \(y_{ij}=1\) olur ve ilk terim etkinleşir; yanlış yanıtlamışsa \(y_{ij}=0\) olur ve ikinci terim etkinleşir. Bütün maddelerin katkıları toplanarak belirli kişi parametrelerinin gözlenen yanıtlarla ne kadar uyumlu olduğu ölçülür.
MLE kestirimi:
\[ \widehat{\boldsymbol{\lambda}}_i^{MLE} = \operatorname*{arg\,max}_{\boldsymbol{\lambda}_i} \ell(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) \tag{6} \]
Buradaki \(\operatorname{arg\,max}\), fonksiyonun en büyük değerini değil, bu en büyük değeri sağlayan parametre değerini arar.
MAP: olabilirliğe önsel bilgi ekle
Kaynak Denklem (7):
\[ \widehat{\boldsymbol{\lambda}}_i^{MAP} = \operatorname*{arg\,max}_{\boldsymbol{\lambda}_i} \left\{ \ell(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) +\log\pi(\boldsymbol{\lambda}_i) \right\} \tag{7} \]
\(\pi(\boldsymbol{\lambda}_i)\), kişi parametrelerinin önsel yoğunluğudur. Bu çalışmada \(\boldsymbol{\alpha}_i\) için mümkün olan \(2^K\) profil üzerinde tekdüze önsel, sürekli testlet etkileri için ise standart normal önsel kullanılmıştır.
Bağımsız önseller altında:
\[ \log\pi(\boldsymbol{\lambda}_i) = \log\pi(\boldsymbol{\alpha}_i) + \log\pi(\boldsymbol{\xi}_i), \qquad \log\pi(\boldsymbol{\xi}_i) \propto -\frac{1}{2}\boldsymbol{\xi}_i^\prime\boldsymbol{\xi}_i \]
Standart normal önsel, mutlak değeri çok büyük testlet etkilerine ceza uygulayan bir düzenlileştirme etkisi oluşturur. Ancak bu özellik otomatik olarak “daha doğru” anlamına gelmez; önsel yapının gerçek nüfus yapısıyla uyumsuz olması özellikle nitelik sınıflandırmasını bozabilir. Case 5 bunun çalışmadaki doğrudan örneğidir.
EAP: sonsal dağılımın ortalamasını kullan
Kaynak Denklem (8):
\[ \widehat{\boldsymbol{\lambda}}_i^{EAP} = E[\boldsymbol{\lambda}_i\mid\mathbf{y}_i] = \int \boldsymbol{\lambda}_i p(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) \,d\boldsymbol{\lambda}_i \tag{8} \]
Burada
\[ p(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) \propto L(\boldsymbol{\lambda}_i\mid\mathbf{y}_i) \pi(\boldsymbol{\lambda}_i) \]
sonsal yoğunluktur. EAP'ın ana farkı, sonsal dağılımın yalnız en yüksek noktasını değil bütün şeklini kullanmasıdır. Kaynağın tartışmasına göre bu ortalama alma davranışı, özellikle kısa testletlerde sonsal dağılım geniş, asimetrik veya düzensiz olduğunda daha istikrarlı kişi kestirimleri oluşturabilir.
MLE'nin IT-DINA içinde iki aşamalı uygulanması
Her olası nitelik profili \(\boldsymbol{\alpha}_c\), \(c=1,\ldots,C\) için ve \(C=2^K\) olmak üzere önce sürekli testlet etkisi optimize edilir.
Kaynak Denklem (9):
\[ \widehat{\boldsymbol{\xi}}_i^{(c)} = \operatorname*{arg\,max}_{\boldsymbol{\xi}_i} \ell(\boldsymbol{\xi}_i\mid\mathbf{y}_i,\boldsymbol{\alpha}_c) \tag{9} \]
Bu, “öğrencinin nitelik profili şimdilik \(\boldsymbol{\alpha}_c\) kabul edilirse testlet etkileri hangi değerlerde yanıtları en iyi açıklar?” sorusunu çözer.
Kaynak MLE için gradyan yükselişi ve geri izlemeli adım araması kullanır:
\[ \boldsymbol{\xi}_i^{(m+1)} = \boldsymbol{\xi}_i^{(m)} + \gamma^{(m)} \nabla_{\xi} \ell(\boldsymbol{\xi}_i^{(m)}\mid\mathbf{y}_i,\boldsymbol{\alpha}_c) \tag{10} \]
\(\nabla_{\xi}\ell\), log-olabilirliğin testlet etkileri yönündeki gradyanıdır. Gradyan, fonksiyonun en hızlı artış yönünü gösterir. \(\gamma^{(m)}\) adım büyüklüğüdür ve geri izlemeli çizgi aramasıyla yeterli log-olabilirlik artışı sağlayacak biçimde ayarlanır.
Her nitelik sınıfı için en iyi sürekli kestirim bulunduktan sonra en yüksek log-olabilirliğe sahip sınıf seçilir:
\[ \widehat{\boldsymbol{\alpha}}_i^{MLE} = \operatorname*{arg\,max}_{\boldsymbol{\alpha}_c} \ell( \widehat{\boldsymbol{\xi}}_i^{(c)} \mid \mathbf{y}_i,\boldsymbol{\alpha}_c) \tag{11} \]
MLE algoritmasının sayısal ayarları
Kaynak algoritması her gizil nitelik profili için beş farklı başlangıçtan optimizasyon yapar. İlk başlangıç \(\boldsymbol{\xi}=0\)'dır; sonraki başlangıçlar \(N(0,0.25I)\) dağılımından alınır. Amaç, karmaşık olabilirlik yüzeyinde tek bir başlangıcın kötü bir yerel çözüme saplanması riskini azaltmaktır.
| Parametre | Değer | Görevi |
|---|---|---|
| Geri izleme katsayısı \(\rho\) | 0,8 | Adım büyüklüğünü azaltma mekanizmasının ayarı |
| Armijo sabiti \(c_1\) | \(10^{-4}\) | Yeterli fonksiyon artışı koşulunun eşiği |
| Azami iterasyon \(M\) | 500 | Optimizasyonun üst iterasyon sınırı |
| Yakınsama eşiği \(\epsilon\) | 0,001 | Gradyan normu yeterince küçüldüğünde durma ölçütü |
| Başlangıç sayısı \(J_{max}\) | 5 | Yerel optimum riskini azaltmak için yeniden başlatma sayısı |
MAP algoritmasında ne değişiyor?
MAP aynı sınıf taramasını yapar; ancak sürekli testlet etkisi yalnız log-olabilirliği değil, log-önseli de içeren sonsal amacı en yüksek yapar.
Kaynak Denklem (12):
\[ \widehat{\boldsymbol{\xi}}_i^{(c)} = \operatorname*{arg\,max}_{\boldsymbol{\xi}_i} \left\{ \ell(\boldsymbol{\xi}_i\mid\mathbf{y}_i,\boldsymbol{\alpha}_c) + \log\pi(\boldsymbol{\xi}_i) \right\} \tag{12} \]
Gradyan güncellemesinde hem veri hem de önsel katkısı bulunur:
\[ \boldsymbol{\xi}_i^{(m+1)} = \boldsymbol{\xi}_i^{(m)} + \gamma^{(m)} \left[ \nabla_{\xi}\ell( \boldsymbol{\xi}_i^{(m)} \mid \mathbf{y}_i,\boldsymbol{\alpha}_c) + \nabla_{\xi}\log\pi( \boldsymbol{\xi}_i^{(m)}) \right] \tag{13} \]
Son aşamada nitelik profili sonsal amaç değerleri karşılaştırılarak seçilir:
\[ \widehat{\boldsymbol{\alpha}}_i^{MAP} = \operatorname*{arg\,max}_{\boldsymbol{\alpha}_c} \left\{ \ell( \widehat{\boldsymbol{\xi}}_i^{(c)} \mid \mathbf{y}_i,\boldsymbol{\alpha}_c) + \log\pi( \widehat{\boldsymbol{\xi}}_i^{(c)}) + \log\pi(\boldsymbol{\alpha}_c) \right\} \tag{14} \]
Nitelik profilleri için tekdüze önsel kullanıldığında \(\log\pi(\boldsymbol{\alpha}_c)\) bütün sınıflarda aynı sabit olduğundan sınıflar arasındaki karşılaştırmayı değiştirmez. Fakat gerçek nüfus profilleri tekdüze değilse bu varsayımın sınıflandırma sonuçları üzerinde etkisi olabilir.
EAP: optimizasyon yerine integrasyon
EAP, sürekli testlet etkisi için tek bir maksimum aramak yerine bu değişkeni olasılık dağılımı üzerinde bütünleştirir.
Kaynak Denklem (15):
\[ P(\mathbf{y}_i\mid\boldsymbol{\alpha}_c) = \int P(\mathbf{y}_i\mid\boldsymbol{\xi}_i,\boldsymbol{\alpha}_c) \pi(\boldsymbol{\xi}_i) \,d\boldsymbol{\xi}_i \tag{15} \]
Bu ifade, belirli bir nitelik profilinin marjinal olabilirliğidir. Sürekli testlet etkisinin olası değerlerinin tamamı, önsel ağırlıklarıyla birlikte hesaba katılır.
Nitelik profilinin sonsal olasılığı:
\[ P(\boldsymbol{\alpha}_c\mid\mathbf{y}_i) = \frac{ P(\mathbf{y}_i\mid\boldsymbol{\alpha}_c)\pi(\boldsymbol{\alpha}_c) }{ \sum_{d=1}^{C} P(\mathbf{y}_i\mid\boldsymbol{\alpha}_d)\pi(\boldsymbol{\alpha}_d) } \tag{16} \]
Pay belirli sınıfın veriyle ve önselle birlikte ağırlığını, payda ise bütün olası sınıfların ağırlık toplamını temsil eder. Böylece sonuç 0–1 arasında gerçek bir sonsal sınıf olasılığıdır.
Her tekil nitelik için ustalık olasılığı:
\[ \widehat{\alpha}_{ik}^{EAP} = P(\alpha_{ik}=1\mid\mathbf{y}_i) = \sum_{c=1}^{C} I(\alpha_{ck}=1) P(\boldsymbol{\alpha}_c\mid\mathbf{y}_i) \tag{17} \]
\(I(\cdot)\) gösterge fonksiyonudur. Sınıf \(c\), nitelik \(k\)'ya sahipse 1, aksi halde 0 olur. Böylece o niteliğe sahip tüm sınıfların sonsal olasılıkları toplanır.
Sürekli testlet etkilerinin EAP kestirimi:
\[ \widehat{\boldsymbol{\xi}}_i^{EAP} = \int \boldsymbol{\xi}_i p(\boldsymbol{\xi}_i\mid\mathbf{y}_i) \,d\boldsymbol{\xi}_i \tag{18} \]
Kaynak bunu sınıf-koşullu beklentilerin, nitelik sınıflarının sonsal olasılıklarıyla ağırlıklandırılmış ortalaması biçiminde hesaplar. Bu yaklaşım, tek bir sınıf ve tek bir sürekli maksimum noktasına tüm ağırlığı vermek yerine belirsizliği dağılım üzerinden taşır.
Gauss–Hermite quadrature neden kullanılıyor?
Denklem (15) ve (18)'deki integraller kapalı biçimde kolayca hesaplanmadığından çalışma Gauss–Hermite quadrature (GHQ) kullanır. Kaynak EAP algoritmasında her sürekli boyut için 20 Gauss–Hermite düğümü kullanır. İki boyutlu IT-DINA testlet etkisi için tensör çarpımıyla toplam \(20^2=400\) quadrature noktası oluşur.
Her quadrature noktasında yanıt olabilirliği hesaplanır, Gauss–Hermite ağırlığıyla çarpılır ve bu ağırlıklı değerler toplanarak integrale sayısal yaklaşım elde edilir. Buradaki 400 değer yeni öğrenci veya yeni veri değildir; sürekli integralin yaklaşık hesabında kullanılan sayısal değerlendirme noktalarıdır.
Simülasyonda DINA parametreleri probit ölçeğine nasıl taşınıyor?
Simülasyonun başlangıcında kayma \(s_j\) ve tahmin \(g_j\) değerleri \(U(0.05,0.20)\) tekdüze dağılımından üretilir. Daha sonra probit ölçeğindeki madde parametreleri şu şekilde oluşturulur:
\[ \delta_{0j}=\Phi^{-1}(g_j) \]
\[ \delta_{1j} = \Phi^{-1}(1-s_j) - \Phi^{-1}(g_j) \]
\(\Phi\), standart normal dağılımın kümülatif dağılım fonksiyonu; \(\Phi^{-1}\) ise tersidir. Böylece olasılık ölçeğindeki tahmin ve kayma değerleri probit doğrusal kestirici ölçeğine taşınır.
Testlet etkileri eklendiğinde gerçek madde olasılıkları neden değişiyor?
Testlet rastgele etkileri probit modeline eklendiğinde marjinal doğru cevap olasılıkları başlangıçta seçilen \(g_j\) ve \(1-s_j\) değerleriyle birebir aynı kalmaz. Kaynak bu yeni model-türevli olasılıkları Denklem (19) ve (20) ile verir.
Gerekli niteliklere sahip öğrenci için marjinal doğru cevap olasılığı:
\[ c_{js}^{*} = \Phi\left( \frac{ \delta_{0j}+\delta_{1j} }{ \sqrt{ 1+\sigma_{\xi}^{2} (\beta_{js}^{2}+\gamma_{js}^{2}) } } \right) \tag{19} \]
Gerekli niteliklere sahip olmayan öğrenci için marjinal doğru cevap olasılığı:
\[ g_{js}^{*} = \Phi\left( \frac{ \delta_{0j} }{ \sqrt{ 1+\sigma_{\xi}^{2} (\beta_{js}^{2}+\gamma_{js}^{2}) } } \right) \tag{20} \]
Çalışmada \(\sigma_{\xi}^{2}=0.25\), yani testlet etkilerinin standart sapması 0,5'tir. Modelde testlet yüklerinin kareleri paydaya girdiğinden yüklerin mutlak büyüklüğü marjinal ölçeklemeyi etkiler. Case 5'te işaretlerin pozitif veya negatif olması bu özel marjinal olasılık aralıklarını değiştirmez; çünkü Denklem (19) ve (20)'de \(\beta^2\) ve \(\gamma^2\) kullanılır.
\(1-c_{js}^{*}\), modelin ima ettiği kayma olasılığıdır. Bu nedenle başlangıçta \(s_j\) ve \(g_j\) 0,05–0,20 arasında seçilmiş olsa bile testlet etkileri eklendikten sonra model-türevli kayma ve tahmin olasılıkları aynı sınırlar içinde kalmak zorunda değildir.
Yanlılık neyi ölçüyor?
Kaynak Denklem (21):
\[ Bias(\widehat{\boldsymbol{\xi}}) = \frac{1}{N} \sum_{i=1}^{N} ( \widehat{\boldsymbol{\xi}}_i - \boldsymbol{\xi}_i ) \tag{21} \]
Yanlılık, kestirimlerin gerçek testlet etkilerinden sistematik olarak hangi yönde saptığını gösterir. Sıfıra yakın değer, pozitif ve negatif sistematik hatanın düşük olduğunu gösterir. Ancak tek başına düşük Bias yeterli değildir; büyük fakat birbirini dengeleyen pozitif ve negatif hatalar ortalamada sıfıra yaklaşabilir.
RMSE neyi ölçüyor?
Kaynak Denklem (22):
\[ RMSE(\widehat{\boldsymbol{\xi}}) = \sqrt{ \frac{1}{N} \sum_{i=1}^{N} \left\| \widehat{\boldsymbol{\xi}}_i - \boldsymbol{\xi}_i \right\|^2 } \tag{22} \]
RMSE, kestirim ile gerçek değer arasındaki hatanın büyüklüğünü ölçer ve büyük hataları kare alma nedeniyle daha güçlü cezalandırır. Düşük RMSE daha doğru sürekli testlet-etkisi geri kazanımı anlamına gelir.
PCCR neden zor bir sınıflandırma ölçütü?
Kaynak Denklem (23):
\[ PCCR = \frac{1}{N} \sum_{i=1}^{N} I( \widehat{\boldsymbol{\alpha}}_i = \boldsymbol{\alpha}_i ) \tag{23} \]
Pattern-wise Correct Classification Rate (PCCR), yalnız tek tek becerilerin doğru sınıflandırılmasını değil, öğrencinin bütün nitelik profilinin eksiksiz doğru olmasını ister. Örneğin gerçek profil \((1,1,0)\) iken \((1,0,0)\) kestirilmişse üç niteliğin ikisi doğru olmasına rağmen PCCR açısından bütün profil yanlış sayılır. Bu nedenle PCCR katı bir ölçüttür.
EAP başlangıçta ikili profil yerine her nitelik için 0–1 arasında sonsal ustalık olasılığı üretir. Kaynak karşılaştırmayı aynı ikili ölçeğe getirmek için 0,50 eşiği kullanır:
\[ \widehat{\alpha}_{ik}^{binary} = I\left[ P(\alpha_{ik}=1\mid\mathbf{y}_i)\geq0.50 \right] \tag{24} \]
Monte Carlo standart hatası neden hesaplandı?
Bütün simülasyon koşulları bağımsız olarak \(R=500\) kez tekrarlanmıştır. PCCR'nin bu tekrarlar arasındaki değişkenliğini göstermek için Monte Carlo standart hatası hesaplanmıştır:
\[ \widehat{MCSE}(PCCR) = \frac{ SD\left( PCCR^{(1)},\ldots,PCCR^{(R)} \right) }{ \sqrt{R} } \tag{25} \]
Burada \(SD\), 500 tekrar boyunca elde edilen PCCR değerlerinin örneklem standart sapmasıdır. PCCR yüzde olarak ifade edildiğinde MCSE de yüzde puan cinsinden yorumlanır.
Çalışmanın Yöntemi ve Bulguları
Simülasyon tasarımı
Çalışma MLE, MAP ve EAP'ı beş farklı veri üretme/kestirim senaryosunda karşılaştırmıştır. Bütün temel koşullarda örneklem büyüklüğü 10.000 kişidir. Testlet sayısı 3 veya 4, her testletteki madde sayısı ise 10, 20, 30, 40 veya 50 olarak değiştirilmiştir.
Case 1–4 için \(K=3\) ve sekiz nitelik profilinin eşit olasılıklı olduğu tekdüze nüfus yapısı kullanılmıştır. Case 5'te \(K=5\)'e çıkılmış ve gerçek nitelik profili dağılımı tekdüze olmaktan çıkarılmıştır.
| Koşul | Gerçek veri modeli | Kestirim modeli | \(\beta\) | \(\gamma\) | Ana amaç |
|---|---|---|---|---|---|
| Case 1 | IT-DINA | IT-DINA | 0,5 | 0,5 | Doğru belirtilmiş temel IT-DINA koşulu |
| Case 2 | DINA | IT-DINA | 0 | 0 | Gerçekte testlet etkisi yokken gereğinden karmaşık model kullanımı |
| Case 3 | T-DINA | IT-DINA | 1 | 0 | Ana testlet etkisi varken gereksiz etkileşim bileşeni eklenmesi |
| Case 4 | IT-DINA | T-DINA | 0,5 | 1 | Gerçek etkileşim bileşeninin kestirim modelinden çıkarılması |
| Case 5 | IT-DINA | IT-DINA | Mutlak değer 0,5; karışık işaret | Mutlak değer 1; karışık işaret | Daha yüksek boyut, tekdüze olmayan nüfus ve karışık işaretli yükler altında sağlamlık |
Case 5'te gerçek nitelik dağılımı nasıl oluşturuldu?
Beş nitelik olduğundan 32 olası profil vardır. Gerçek nüfusta sıfır, bir veya iki nitelik kazanmış profiller için sınıf olasılığı \(\pi_c=1/48\); üç veya daha fazla nitelik kazanmış profiller için \(\pi_c=1/24\) olarak belirlenmiştir. Böylece yüksek ustalık profilleri düşük ustalık profillerinin iki katı sınıf olasılığına sahip olmuştur.
Buna rağmen MAP ve EAP için bütün Case 1–5 koşullarında nitelik profilleri üzerinde tekdüze önsel kullanılmaya devam edilmiştir. Case 5'in bilimsel önemi tam olarak buradadır: gerçek nüfus yapısı ile Bayesçi nitelik önseli kasıtlı olarak uyumsuzdur.
Model-türevli tahmin ve kayma olasılıkları
| Koşul | \(\beta\) | \(\gamma\) | \(g^*\) aralığı | \(1-c^*\) aralığı |
|---|---|---|---|---|
| Case 1 | 0,5 | 0,5 | 0,0605–0,2137 | 0,0605–0,2137 |
| Case 2 | 0 | 0 | 0,0500–0,2000 | 0,0500–0,2000 |
| Case 3 | 1 | 0 | 0,0706–0,2257 | 0,0706–0,2257 |
| Case 4 | 0,5 | 1 | 0,0755–0,2312 | 0,0755–0,2312 |
| Case 5 | ±0,5 | ±1 | 0,0755–0,2312 | 0,0755–0,2312 |
Case 1: doğru belirtilmiş IT-DINA
Bu temel koşulda hem veri üretme hem kestirim modeli IT-DINA'dır. EAP ve MAP testlet-etkisi yanlılıklarını mutlak olarak genellikle 0,005'in altında tutmuştur. MLE'de 10 maddelik testletlerde bazı testlet etkileri için mutlak yanlılık yaklaşık 0,02–0,04'e ulaşmıştır. Testlet 50 maddeye uzadığında MLE yanlılığı azalmış fakat yaklaşık 0,01 düzeyinde kalmıştır.
RMSE açısından EAP ve MAP, testlet uzunluğu arttıkça yaklaşık 0,35'ten 0,20'ye gerilemiştir. MLE, 10 maddelik testletlerde yaklaşık 0,55–0,65 RMSE göstermiş; 50 maddede dahi yaklaşık 0,30–0,35 düzeyinde kalmıştır.
PCCR bakımından Bayesçi yöntemler genel olarak %97'nin üzerinde, 50 maddeye doğru yaklaşık %98,5'e ulaşırken MLE yaklaşık %93–95 aralığında kalmıştır.
Case 2: gerçekte testlet etkisi yok, fakat IT-DINA kestiriliyor
Bu koşulda \(\beta=\gamma=0\)'dır. Başka bir deyişle veri üretme sürecinde testlet etkileri yanıt olasılıklarını değiştirmez; buna rağmen kestirimde tam IT-DINA modeli kullanılır. Bu, gereksiz sürekli bileşenlerin modele eklenmesine karşı yöntemlerin davranışını sınar.
EAP ve MAP için testlet-etkisi yanlılıkları sıfıra çok yakın, RMSE değerleri yaklaşık 0,49–0,50 bulunmuştur. MLE yanlılıklarının mutlak değeri yaklaşık 0,003–0,006 ve RMSE'si yaklaşık 0,55–0,69 aralığındadır.
Buradaki 0,49–0,50 RMSE'nin dikkatli okunması gerekir. Kaynakta kişi testlet değişkenleri \(N(0,0.5^2)\) ölçeğinde üretildiği halde bunların yanıtlar üzerindeki yükleri sıfırdır. Dolayısıyla yanıt verisi bireysel testlet etkilerini tanımlayacak doğrudan bilgi taşımaz. Bayesçi düzenlileştirme kestirimleri önsel merkezine yakın tutar; kaynak bu davranışı gereksiz bileşenlerin istikrarsızlaşmasını sınırlandırması açısından yorumlamaktadır.
Case 3: gerçek model T-DINA, kestirim IT-DINA
Gerçek veride ana testlet etkisi vardır ancak etkileşim bileşeni yoktur. IT-DINA ise her iki bileşeni de kestirmeye çalışır.
Gerçek ana etki bileşenlerinde EAP yanlılığı mutlak olarak 0,001'in altında kalmış ve RMSE yaklaşık 0,43'ten 0,34'e düşmüştür. MAP yanlılığı yaklaşık 0,001–0,006; RMSE'si 0,40–0,50 aralığındadır. MLE'nin yanlılığı yaklaşık 0,004–0,02, RMSE'si yaklaşık 0,50–0,69'dur.
Gerçekte bulunmayan etkileşim bileşeninde EAP ve MAP'ın yanlılığı yine sıfıra çok yakın kalırken RMSE yaklaşık 0,49–0,50 civarında bulunmuştur. MLE gereksiz bileşende daha yüksek yanlılık ve RMSE göstermiştir.
Case 4: gerçek IT-DINA, fakat kestirim daha basit T-DINA
Bu koşul gereğinden karmaşık modelin tersini sınar. Gerçek veride hem ana testlet etkisi hem de etkileşim vardır, ancak kestirim modeli etkileşimle ilişkili \(\xi_2\) bileşenini içermez.
EAP, üç ve dört testlet koşullarında genel olarak en küçük Bias ve RMSE'yi vermiştir. MAP çoğu koşulda EAP'a yakın kalmıştır. MLE özellikle kısa testletlerde daha fazla dalgalanmıştır. Kaynak, doğru belirtilmiş Case 1 ile karşılaştırıldığında MLE yanlılığının yaklaşık 2–5 kat büyüyebildiğini ve kısa testletlerde RMSE'nin 0,80'i aşabildiğini bildirir.
Sınıflandırmada kısa testletler için EAP ile MLE arasındaki PCCR farkı yaklaşık 6–7 yüzde puanına ulaşmıştır. Bu sonuç, yalnız model seçiminin değil kişi parametresi kestirim yönteminin de eksik belirtilmiş modellerde tanısal sonucu değiştirebildiğini göstermektedir.
Bayesçi Yöntemler Her Koşulda Daha İyi miydi?
Hayır. EAP ve MAP beşinci simülasyon koşulunda sürekli testlet etkilerinin Bias ve RMSE'si açısından MLE'den daha istikrarlı kalmasına rağmen, bütün nitelik profilini doğru sınıflandıran PCCR metriğinde MLE biraz daha yüksek sonuç vermiştir. Kaynak bunu gerçek nitelik profili dağılımının tekdüze olmaması ile MAP/EAP'ın tekdüze nitelik önseli kullanması arasındaki uyumsuzlukla ilişkilendirir; dolayısıyla Bayesçi avantaj önselin doğruluğundan bağımsız değildir.
Case 5: önsel dağılım uyumsuz olduğunda ne oldu?
EAP ve MAP'ın sürekli testlet etkilerindeki Bias değerleri küçük kalmış, MLE özellikle kısa testletlerde daha yüksek RMSE üretmiştir. Buna karşılık PCCR'de EAP ve MAP yaklaşık %87–91, MLE yaklaşık %90–93 aralığındadır.
Bu sonuç iki farklı kestirim hedefinin aynı şey olmadığını gösterir. Bir yöntem sürekli testlet etkisini daha iyi geri kazanırken ayrık nitelik profilini aynı anda daha iyi sınıflandırmak zorunda değildir. Özellikle Bayesçi sınıflandırma gerçek nüfus dağılımıyla uyuşmayan bir profil önselinden etkilenebilir.
PCCR için simülasyon değişkenliği
500 bağımsız tekrar üzerinden hesaplanan MCSE değerleri tüm koşullarda yaklaşık %0,08–%1,50 aralığındadır. Case 1–3'te değerler genel olarak %1'in altında kalmıştır. Case 4'te özellikle MLE için değişkenlik artmış; en yüksek MCSE değerleri daha yüksek nitelik boyutu ve daha düşük sınıflandırma doğruluğu bulunan Case 5'te yaklaşık %1,17–%1,50 aralığında görülmüştür.
Testletin uzunluğu mu, testlet sayısı mı daha önemliydi?
Kaynak tartışmasına göre bu simülasyon koşullarında testlet başına madde sayısını artırmak, testlet sayısını artırmaktan daha büyük doğruluk kazanımları üretmiştir. Matematiksel açıdan bu, aynı sürekli testlet etkisi hakkında daha fazla madde yanıtının bilgi sağlaması anlamına gelir.
Ancak çalışma bu sonucu evrensel sınav tasarım kuralı haline getirmez. Simülasyonda nitelik boyutu, madde kalitesi ve model yapısı belirli sınırlar içindedir; daha yüksek boyutlu, daha zayıf madde bilgisine sahip veya daha gürültülü değerlendirmelerde aynı büyüklükte bir kazanç garanti edilmemektedir.
TIMSS 2023 ampirik uygulaması nasıl oluşturuldu?
Ampirik gösterimde TIMSS 2023 sekizinci sınıf matematik uluslararası veritabanı kullanılmıştır. Başlangıçta 308.492 öğrenci ve değerlendirme kitapçıkları boyunca 68 aday matematik maddesi bulunmuştur. Yanıtsız veya geçersiz cevaplar eksik değer olarak işaretlenmiş; beşten az geçerli yanıtı olan öğrenciler çıkarılmış ve nihai kişi örneklemi 118.547 olmuştur.
Çalışma TIMSS'in döndürülmüş kitapçık tasarımındaki madde bloklarını operasyonel testlet birimi olarak kullanmıştır. B_MD3 ve B_MD5, aynı seçili kitapçık içinde aynı yanıtlayıcı grubuna uygulanmaları ve veri temizliği sonrasında yeterli madde düzeyi değişkenliği korumaları nedeniyle seçilmiştir.
Burada önemli bir terminolojik sınır vardır: Kaynak, TIMSS bloklarının dar anlamda tek bir ortak uyaranı paylaşan klasik “testlet” olmak zorunda olmadığını açıkça belirtmektedir. Bunlar aynı blok içinde kalan artık bağımlılığı modellemek amacıyla operasyonel testletler olarak kullanılmıştır.
Polytomous maddeler neden ikili hale getirildi?
Seçilen constructed-response maddelerinin özgün TIMSS puanları birden fazla puan kategorisine sahip olabilmektedir. DINA, T-DINA ve IT-DINA'nın bu çalışmada kullanılan biçimleri ikili yanıtlara dayandığı için sıfırdan büyük bütün puanlar doğru = 1, sıfır puan yanlış = 0 olarak yeniden kodlanmıştır.
Bu dönüşüm kısmi kredi bilgisini kaybeder. Dolayısıyla örneğin 1 puan ile 2 puan alan iki öğrenci ikisi de “doğru” kategorisine girebilir. Kaynak bunu çalışmanın önemli sınırlılıklarından biri olarak açıkça kabul etmektedir.
| Aşama | Kaynakta verilen yapı |
|---|---|
| Başlangıç kişi sayısı | 308.492 |
| Aday matematik maddesi | 68 |
| Kişi eleme ölçütü | 5'ten az geçerli yanıtı olan öğrenci çıkarıldı |
| Nihai kişi sayısı | 118.547 |
| Operasyonel testletler | B_MD3 ve B_MD5 |
| Nihai madde sayısı | 27 ikili madde |
| B_MD3 | 15 madde |
| B_MD5 | 12 madde |
| Nitelikler | Applying 11, Knowing 4, Reasoning 12 madde |
TIMSS Q-matrisi nasıl kuruldu?
TIMSS matematik maddelerinin resmî bilişsel alan sınıflandırması çalışmada üç ikili tanısal nitelik olarak kullanılmıştır: Knowing (Bilme), Applying (Uygulama) ve Reasoning (Akıl Yürütme). Her analiz maddesi yalnız bir bilişsel alana atanmıştır; dolayısıyla Q-matrisinin her satırında tek bir 1 vardır.
27 maddeden 11'i Applying, 4'ü Knowing ve 12'si Reasoning olarak kodlanmıştır. Bu, kullanılan Q-matrisinin genel çok-nitelikli CDM'lere kıyasla oldukça basit bir yapı taşıdığı anlamına gelir. Çalışmanın tartışmasında yüksek sınıflandırma oranlarının daha yüksek nitelik boyutuna veya daha karmaşık Q-matrislerine doğrudan genellenmemesi gerektiği özellikle vurgulanmaktadır.
Kaynak içindeki TIMSS madde kodu tutarsızlığı
Kaynak Tablo 7'de B_MD3 içindeki iki madde kodu MQ8N208A ve MQ8N208B olarak görünürken, aynı maddelerin parametre tablosu olan Tablo 8'de kodlar MQ82N08A ve MQ82N08B biçiminde verilmiştir. Kaynak bu fark için bir düzeltme notu sunmadığından Verianla metni iki yazımdan birini sessizce “doğru” ilan etmemektedir.
Ampirik madde parametrelerinin ölçeği
MLE, MAP ve EAP kişi kestirimlerinin karşılaştırılmasında madde parametreleri önceden kalibre edilmiş ve sabit tutulmuştur. Böylece karşılaştırma sırasında yöntemler arasındaki farkın madde parametrelerinin yeniden kestirilmesinden kaynaklanması önlenmeye çalışılmıştır.
Kaynak Tablo 8'de 27 madde için \(\delta_0\), \(\delta_1\), standart hatalar ve pass rate değerleri verilmektedir. \(\delta_0\) değerleri yaklaşık −4,06 ile −0,86, \(\delta_1\) değerleri yaklaşık −3,20 ile 3,88, pass rate ise yaklaşık 0,03 ile 0,24 arasında değişmektedir.
Kaynak özellikle bazı \(\delta_1\) değerlerinin negatif olduğunu ve bunların dikkatle yorumlanması gerektiğini belirtmektedir. Matematiksel olarak negatif \(\delta_1\), Denklem (3) veya (4)'te diğer bileşenler sabitken \(\eta\)'nın 0'dan 1'e geçmesinin doğrusal kestiriciyi artırmak yerine azaltması anlamına gelir. Kaynak bu sıra dışı işaretlerin nedenini yeni bir mekanizma olarak kanıtlamadığı için Verianla da bunun nedenini varsaymamaktadır.
Ampirik hesaplama ortamı
Bütün analizler R 4.2.0 ortamında ve büyük örneklem nedeniyle paralel hesaplama kullanılarak yürütülmüştür. Model yakınsama ölçütü, ardışık iterasyonlardaki parametre değişiminin mutlak farkının 0,001'den küçük olmasıdır; maksimum iterasyon sayısı 500 olarak belirlenmiştir.
MLE, MAP ve EAP'ın TIMSS üzerindeki nitelik profilleri
| Profil | EAP | MAP | MLE |
|---|---|---|---|
| (0,0,0) | 12.045 (%10,16) | 11.892 (%10,03) | 8.273 (%6,98) |
| (1,0,0) | 10.342 (%8,72) | 10.101 (%8,52) | 7.464 (%6,30) |
| (0,1,0) | 8.976 (%7,57) | 8.743 (%7,37) | 6.739 (%5,68) |
| (0,0,1) | 18.342 (%15,48) | 18.567 (%15,66) | 32.479 (%27,40) |
| (1,1,0) | 9.543 (%8,05) | 9.321 (%7,86) | 7.158 (%6,04) |
| (1,0,1) | 14.237 (%12,01) | 14.512 (%12,24) | 12.089 (%10,20) |
| (0,1,1) | 12.876 (%10,86) | 13.045 (%11,00) | 11.724 (%9,89) |
| (1,1,1) | 32.186 (%27,15) | 32.366 (%27,31) | 32.621 (%27,52) |
EAP ve MAP'ın sekiz profil için yüzdeleri birbirine çok yakındır; her profil için fark %0,5'in altındadır. MLE'nin dağılımı ise özellikle \((0,0,1)\) profilinde ayrışmaktadır: MLE bu sınıfa 32.479 öğrenci, EAP 18.342 ve MAP 18.567 öğrenci atamıştır.
Testlet etkisi dağılımlarında ne görüldü?
Kaynak Şekil 11, iki operasyonel testlet için \(\xi_1\) ve \(\xi_2\) kestirimlerinin EAP, MAP ve MLE dağılımlarını kutu grafikleriyle karşılaştırmaktadır. EAP değerleri sıfır çevresinde en yoğun ve en dar çeyrekler arası aralığa sahiptir. MAP biraz daha geniştir ancak MLE'den daha yoğun kalır. MLE'de kutular, whisker'lar ve uç değerler daha geniştir.
Şeklin ham kişi düzeyi değerleri veya bütün kutu grafiği özetleri kaynakta tablo halinde verilmediğinden Verianla tarafından sahte sayısal kutu grafiği yeniden çizilmemiştir. Bilimsel mesaj metin ve aşağıdaki sıralama korelasyonları üzerinden korunmuştur.
Kendall sıra korelasyonları
| Parametre | EAP–MAP | EAP–MLE | MAP–MLE |
|---|---|---|---|
| \(\xi_1\), T1 | 0,976 | 0,634 | 0,616 |
| \(\xi_1\), T2 | 0,981 | 0,578 | 0,642 |
| \(\xi_2\), T1 | 0,969 | 0,561 | 0,655 |
| \(\xi_2\), T2 | 0,982 | 0,553 | 0,649 |
EAP–MAP korelasyonlarının tamamı 0,96'nın üzerindedir; bu iki yöntem öğrencilerin testlet-etkisi sıralamalarında çok benzer davranmıştır. MLE ile Bayesçi yöntemler arasındaki korelasyonlar yaklaşık 0,55–0,65 aralığında kalmış ve yalnız orta düzeyde uyuma işaret etmiştir.
EAP ile MAP sınıflandırmaları ne kadar benzerdi?
Kaynak geçiş matrisinde EAP'tan MAP'a sınıflandırmaların bütün sekiz nitelik profili için diyagonal oranlarının %93'ün üzerinde olduğunu bildirir. Bu, iki Bayesçi yöntemin yalnız toplam profil dağılımlarında değil kişi düzeyinde de büyük ölçüde aynı sınıfları seçtiğini göstermektedir.
EAP ile MLE arasındaki sistematik kayma
EAP–MLE geçiş matrisi daha belirgin ayrışma göstermiştir. EAP tarafından \((1,1,0)\) olarak sınıflandırılan 9.543 öğrencinin 1.571'i, yani yaklaşık %16,5'i MLE tarafından \((0,0,1)\) profiline taşınmıştır.
Daha güçlü kaymalar \((0,0,0)\) ve \((1,0,0)\) profillerinde görülmüştür. EAP'ın \((0,0,0)\) grubundakilerin yaklaşık %24,4'ü, \((1,0,0)\) grubundakilerin yaklaşık %25,2'si MLE tarafından \((0,0,1)\)'e atanmıştır.
Bu bulgu gerçek profilin EAP olduğu anlamına gelmez; ampirik TIMSS uygulamasında gerçek gizil nitelik profilleri bilinmemektedir. Sonuç yalnız farklı kişi-kestirim yöntemlerinin aynı IT-DINA modeli ve aynı veriler altında farklı tanısal sınıflandırmalar üretebildiğini gösterir.
Testlet Etkilerini Yok Saymak Tanısal Sınıflandırmayı Değiştirebilir mi?
Bu TIMSS ampirik örneğinde evet. Testlet etkilerini ve nitelik durumuyla etkileşimlerini modelleyen IT-DINA, yerel bağımsızlık varsayan DINA'ya göre daha iyi göreli uyum göstermiş ve öğrencilerin nitelik profili dağılımını belirgin biçimde değiştirmiştir. Ancak bu sonuç, bütün TIMSS uygulamalarında veya bütün sınavlarda IT-DINA'nın otomatik olarak üstün olacağı anlamına gelmez; kaynak bunu belirli veri işleme ve modelleme koşullarındaki ampirik gösterim olarak sunmaktadır.
DINA ile IT-DINA model uyumu
| Model | Log-olabilirlik | Parametre sayısı | AIC | BIC |
|---|---|---|---|---|
| DINA | −1.523.456,23 | 54 | 3.047.020,5 | 3.047.520,3 |
| IT-DINA | −1.517.221,78 | 58 | 3.034.559,6 | 3.035.019,8 |
IT-DINA dört ek parametre kullanmasına rağmen AIC ve BIC değerleri yaklaşık 12.000 daha düşüktür. Kaynak ayrıca \(\Delta LL=6234,45\), \(\Delta df=4\) ve \(p<0,001\) rapor etmektedir. Bu sonuçlar bu ampirik veri ve bu model karşılaştırması içinde IT-DINA'nın DINA'ya göre daha iyi göreli uyum gösterdiğini desteklemektedir.
DINA ve IT-DINA öğrencileri nasıl farklı sınıflandırdı?
| Profil | IT-DINA (EAP) | DINA | DINA − IT-DINA kişi farkı |
|---|---|---|---|
| (0,0,0) | 12.045 (%10,16) | 8.273 (%6,98) | −3.772 |
| (1,0,0) | 10.342 (%8,72) | 7.464 (%6,30) | −2.878 |
| (0,1,0) | 8.976 (%7,57) | 6.739 (%5,68) | −2.237 |
| (0,0,1) | 18.342 (%15,48) | 32.479 (%27,40) | +14.137 |
| (1,1,0) | 9.543 (%8,05) | 7.158 (%6,04) | −2.385 |
| (1,0,1) | 14.237 (%12,01) | 12.089 (%10,20) | −2.148 |
| (0,1,1) | 12.876 (%10,86) | 11.724 (%9,89) | −1.152 |
| (1,1,1) | 32.186 (%27,15) | 32.621 (%27,52) | +435 |
En büyük fark \((0,0,1)\) profilindedir. DINA 32.479 öğrenciyi, IT-DINA EAP ise 18.342 öğrenciyi bu profile atamıştır; fark 14.137 öğrencidir. Kaynak, analizdeki birçok maddenin Reasoning niteliğiyle ilişkili olması nedeniyle bu kaymanın tanısal yorum açısından önemli olduğunu belirtmektedir.
DINA; \((0,0,0)\), \((1,0,0)\) ve \((0,1,0)\) düşük-ustalık profillerini IT-DINA'ya göre toplam 8.887 kişi daha az; \((1,1,0)\), \((1,0,1)\) ve \((0,1,1)\) çoklu-nitelik profillerini ise toplam yaklaşık 5.685 kişi daha az sınıflandırmıştır. Tam ustalık profili \((1,1,1)\) ise iki modelde birbirine oldukça yakındır.
Kaynağın EAP için verdiği açıklama
Çalışmanın tartışmasına göre EAP'ın istikrarı üç ilişkili mekanizmayla açıklanabilir. Birincisi, EAP sonsal dağılımın tek bir modunu değil ortalamasını kullanır. Bu durum, testlet başına bilgi az olduğunda kişi düzeyi kestirimleri sıfıra doğru düzenleyebilir.
İkincisi, IT-DINA'nın olabilirlik yüzeyi ayrık nitelik sınıfları ile sürekli testlet değişkenlerini birlikte içerdiğinden kısa testletlerde düz, çok modlu veya zayıf tanımlanmış olabilir. Önsel içermeyen MLE bu durumlarda örnekleme dalgalanmalarına daha açık kalabilir.
Üçüncüsü, MAP önsel düzenlileştirmesine sahip olsa da sonsal dağılımın yalnız modunu kullanır. Sonsal dağılım geniş veya asimetrikse mod yerel düzensizliklere duyarlı kalabilir. EAP bütün sonsal yoğunluğu ortalayarak bu düzensizlikleri daha fazla yumuşatabilir. Bu açıklamalar çalışmanın incelenen IT-DINA koşullarına aittir ve bütün psikometrik modeller için evrensel bir üstünlük kanıtı değildir.
Çalışmanın desteklediği sonuçlar
- İncelenen simülasyon koşullarında MAP ve özellikle EAP, sürekli testlet etkilerinin geri kazanımında MLE'den genel olarak daha istikrarlı sonuçlar vermiştir.
- Bayesçi avantaj kısa testletlerde ve model yapısı gereğinden karmaşık veya eksik belirtildiğinde daha belirgin hale gelmiştir.
- Doğru belirtilmiş ve orta düzeyde yanlış belirtilmiş koşullarda EAP/MAP nitelik profili sınıflandırmasında MLE'den daha yüksek PCCR üretebilmiştir.
- Gerçek nitelik dağılımı ile kullanılan Bayesçi nitelik önseli uyuşmadığında sınıflandırma avantajı ortadan kalkabilir veya tersine dönebilir.
- TIMSS ampirik örneğinde MLE, MAP ve EAP aynı IT-DINA modeli altında farklı kişi-düzeyi testlet etkileri ve farklı tanısal sınıflandırmalar üretmiştir.
- TIMSS ampirik örneğinde IT-DINA, DINA'ya göre daha iyi göreli AIC/BIC uyumu göstermiş ve nitelik profili dağılımını değiştirmiştir.
Çalışmanın desteklemediği genellemeler
Çalışma “EAP bütün bilişsel-tanısal modellerde daima en iyi yöntemdir”, “Bayesçi kestirim MLE'den her koşulda daha doğru sınıflandırır”, “TIMSS bloklarının tamamı gerçek ortak-uyaranlı testlettir”, “DINA kullanmak her değerlendirmede yanlış sınıflandırma üretir” veya “IT-DINA bütün sınav sistemlerinde zorunlu olarak en iyi modeldir” sonucunu desteklememektedir.
Simülasyon sonuçları seçilen DINA/T-DINA/IT-DINA yapıları, belirli nitelik boyutları, madde kalitesi, önsel dağılımlar, quadrature düzeni ve optimizasyon algoritması altında elde edilmiştir. Ampirik uygulamada ise gerçek nitelik profilleri bilinmediğinden model ve yöntemler arasındaki sınıflandırma farkı, hangi profilin mutlak gerçek olduğunu doğrudan kanıtlamaz.
Temel sınırlılıklar
Model ailesi sınırı: Araştırma DINA, T-DINA ve IT-DINA ile sınırlıdır. Bulgular daha esnek G-DINA veya başka testlet-tabanlı bilişsel-tanısal modellere otomatik olarak genellenemez.
Polytomous bilginin kaybı: TIMSS constructed-response puanlarının ikili hale dönüştürülmesi kısmi kredi bilgisini atmaktadır. Bu nedenle ampirik sınıflandırma ve model uyum sonuçları kullanılan ikili puanlama sistemine özgüdür.
Nüfus temsiliyeti: TIMSS uygulaması model-temelli bir gösterimdir. Karmaşık örnekleme ağırlıkları model kalibrasyonuna veya uyum değerlendirmesine açıkça dahil edilmemiştir. Bu nedenle sonuçlar TIMSS nüfusunun temsilî oranları gibi yorumlanmamalıdır.
Sayısal uygulamaya bağımlılık: MLE, MAP ve EAP karşılaştırması kullanılan optimizasyon algoritmasına, Gauss–Hermite yaklaşımına ve önsel tercihlerine bağlıdır. Başka sayısal uygulamalar nicel sonuçları bir miktar değiştirebilir.
Önsel duyarlılığı: Case 5, özellikle ayrık nitelik profili için yanlış belirtilmiş önsel dağılımın Bayesçi sınıflandırmayı etkileyebildiğini doğrudan göstermektedir. Bu nedenle “önsel = düzenlileştirme = otomatik iyileşme” biçiminde basit bir sonuç çıkarılamaz.
Kaynak ve Yöntem Notu
Özgün çalışma: Evaluating Person-Parameter Estimation Methods in Cognitive-Diagnostic Models with Testlet Effects
Yazarlar: Mei You, Jingjing Yang, Xin Xu.
Yazar sırası: Kaynaktaki sıra aynen korunmuştur.
Eş katkı: Kaynakta eş birinci yazarlık veya eş katkı işareti belirtilmemiştir.
Sorumlu yazar: Xin Xu.
Afiliasyon: School of Science, Minzu University of China, Beijing 100081, China.
Dergi: Education Sciences.
Yayıncı: MDPI.
Cilt / sayı / makale numarası: Volume 16, Issue 7, Article 1128.
DOI: 10.3390/educsci16071128.
Resmî DOI bağlantısı: https://doi.org/10.3390/educsci16071128
Gönderim tarihi: 11 Mayıs 2026.
Revizyon tarihi: 10 Temmuz 2026.
Kabul tarihi: 13 Temmuz 2026.
Yayın tarihi: 15 Temmuz 2026.
Kaynak türü: Article / araştırma makalesi. Çalışma yalnız teorik bir yöntem yazısı değildir; kontrollü simülasyon karşılaştırmalarını ve TIMSS 2023 verisi üzerinde model-temelli ampirik uygulamayı birlikte içermektedir.
Hakemlik durumu: Education Sciences içinde yayımlanmış hakemli dergi makalesidir.
Lisans: Creative Commons Attribution (CC BY). PDF, telifin 2026 yılında yazarlara ait olduğunu ve MDPI'nin lisans sahibi/yayıncı olarak çalışmayı CC BY şartlarıyla yayımladığını belirtmektedir.
Finansman: Araştırma Fundamental Research Funds for the Central Universities tarafından desteklenmiştir.
Kurumsal etik kurul: Kaynakta “Not applicable” olarak belirtilmiştir.
Bilgilendirilmiş onam: Kaynakta “Not applicable” olarak belirtilmiştir.
Veri erişilebilirliği: Çalışmada kamuya açık veri kullanılmıştır. TIMSS 2023 uluslararası veritabanının TIMSS & PIRLS International Study Center üzerinden erişilebilir olduğu; simülasyon sonuçlarının makalede açıklanan model ve simülasyon koşullarına göre üretildiği belirtilmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir. Kaynak ayrıca fon sağlayıcının çalışma tasarımı, veri toplama/analiz/yorumlama, makale yazımı veya yayın kararında rolü olmadığını belirtmektedir.
Yazar katkıları: Kavramsallaştırma Xin Xu; yöntem Xin Xu ve Mei You; yazılım Mei You; doğrulama Mei You, Jingjing Yang ve Xin Xu; biçimsel analiz Mei You; araştırma Mei You; kaynaklar Xin Xu; veri kürasyonu Mei You; ilk taslak yazımı Mei You; gözden geçirme ve düzenleme Jingjing Yang ve Xin Xu; görselleştirme Mei You; danışmanlık Xin Xu; proje yönetimi Xin Xu; finansman edinimi Xin Xu.
Kaynak içi tutarsızlık 1: TIMSS Q-matrisini veren Tablo 7'de iki madde kodu MQ8N208A ve MQ8N208B; madde parametrelerini veren Tablo 8'de ise MQ82N08A ve MQ82N08B olarak yazılmıştır. Kaynakta bunun için düzeltme açıklaması bulunmadığından Verianla hangi yazımın doğru olduğuna dair yeni iddia üretmemiştir.
Kaynak içi tutarsızlık 2: PCCR yöntem açıklamasında MLE ve MAP ikili nitelik kestirimlerinin denklem numaralarına yapılan çapraz referans, yöntem bölümündeki gerçek ayrık seçim denklemleriyle uyumlu görünmemektedir. Bu nedenle Verianla formülleri denklem içerikleri üzerinden açıklamış, kaynakta bulunmayan yeni denklem numarası ataması yapmamıştır.
Temel yöntemsel sınır: Simülasyon performansı seçilen testlet sayıları, testlet uzunlukları, nitelik boyutları, yükler, madde kalitesi, önsel yapıları ve sayısal uygulama ile sınırlıdır. TIMSS uygulaması ise ikiliye dönüştürülmüş constructed-response maddeleri, iki operasyonel blok ve örnekleme ağırlıklarını doğrudan modele katmayan model-temelli bir gösterimdir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir