


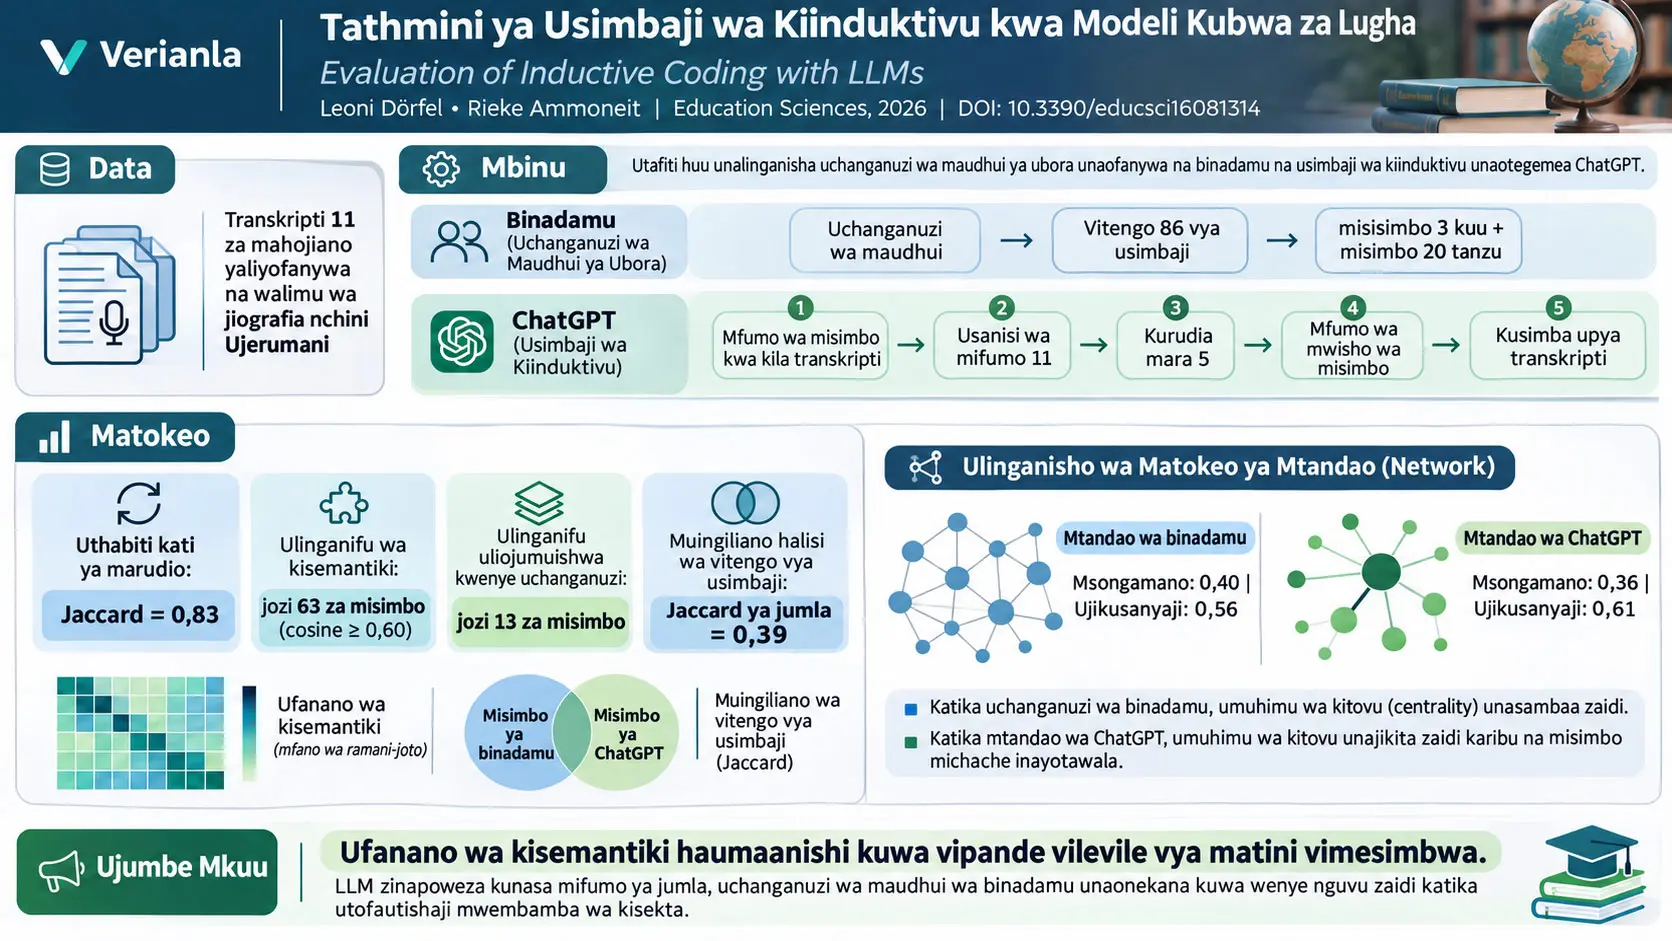
Usimbaji wa kiinduktivu unaosaidiwa na modeli kubwa ya lugha ni mkabala wa uchanganuzi wa data za ubora ambapo modeli kubwa ya lugha hutumiwa kuunda miundo ya misimbo na kategoria kutokana na mifumo inayojitokeza katika mahojiano au maandishi mengine ya ubora, badala ya kutumia tu kitabu cha misimbo kilichokamilishwa mapema. Utafiti huu unalinganisha mfumo wa misimbo uliotengenezwa na ChatGPT kutokana na mahojiano ya walimu 11 wa jiografia wa Ujerumani kwa kutumia uhandisi wa prompt wa hatua kwa hatua, na uchanganuzi wa maudhui wa ubora uliokuwa umefanywa hapo awali na watafiti binadamu kwenye mahojiano hayo hayo. Ulinganisho haukuishia katika kufanana kwa majina ya misimbo pekee; uliendelezwa hadi kwenye vipande gani vya maandishi vilivyowekewa misimbo, mahusiano ya kimuundo ya misimbo ndani ya mtandao, na kiwango ambacho muktadha mahususi wa taaluma ulihifadhiwa.
Katika utafiti, kwanza mfumo tofauti wa misimbo uliundwa kwa kila mahojiano kwa kutumia ChatGPT, kisha mifumo hiyo ikaunganishwa, mchakato wa usanisi ukarudiwa mara tano kwa kujitegemea, na mfumo wa mwisho wa misimbo ukaundwa kwa kutumia misimbo iliyokuwepo katika angalau usanisi tatu kati ya tano. Mfumo wa mwisho ulitumika baadaye kwa kila mahojiano katika utekelezaji tano huru wa usimbaji; kuwepo kwa msimbo uleule katika angalau utekelezaji tatu kati ya tano kulitumiwa kama kigezo cha kuuhifadhi katika tathmini ya mwisho. Katika mchakato huu wa kurudiwa, mfanano wa jumla wa Jaccard kati ya utekelezaji kwa kila mahojiano uliripotiwa kuwa 0,83.
Mfumo wa mwisho wa misimbo uliotengenezwa na ChatGPT ulikuwa na misimbo 3 kuu na misimbo midogo 14, ilhali uchanganuzi wa maudhui wa ubora unaotegemea binadamu ulikuwa na misimbo 3 kuu na misimbo midogo 20. Katika ulinganisho wa kisemantiki unaotegemea SBERT, jozi 63 za misimbo zilibainishwa kuwa na mfanano wa kosaini wa 0,60 au zaidi. Katika ulinganishaji wa mmoja-kwa-mmoja uliotengenezwa kwa Hungarian Algorithm, ni moja tu kati ya miunganiko 14 iliyotarajiwa iliyobaki chini ya kizingiti cha 0,60, na uchanganuzi uliofuata ulifanywa kwa jozi 13 za misimbo zilizolinganishwa.
Hata hivyo, kufanana kwa maana ya misimbo hakukumaanisha kwamba vipande vilevile vya mahojiano viliwekewa misimbo. Kwa jozi 13 za misimbo zilizolinganishwa, faharasa ya Jaccard ya jumla ilikuwa 0,39 tu. Katika baadhi ya jozi, mwingiliano wa vitengo vya usimbaji ulikuwa mkubwa, huku katika nyingine ukiwa sifuri. Kwa mfano, Jaccard kati ya “Material and textbook influence” na “Resources: Textbooks” ilikuwa 0,86, ilhali katika jozi za “Diagnostic assessment” na “Outside the classroom”, pamoja na “Knowledge deficits as breeding ground” na “Educational policy factors”, Jaccard ilikuwa 0.
Katika uchanganuzi wa mtandao, msongamano wa mtandao wa uchanganuzi wa maudhui wa binadamu ulikuwa 0,40 na mgawo wa jumla wa clustering ulikuwa 0,56; msongamano wa mtandao wa ChatGPT ulikuwa 0,36 na mgawo wa jumla wa clustering ulikuwa 0,61. Ingawa vipimo hivi vya jumla vilikuwa karibu, centrality za nodi zilionyesha muundo tofauti: katika uchanganuzi wa binadamu, centrality ilisambaa katika kundi pana zaidi la misimbo, huku katika mfumo wa ChatGPT misimbo michache ya jumla ikawa na uzito mkubwa zaidi. Tafsiri kuu ya utafiti ni kwamba prompt zilizo na muundo na zinazoboreshwa kwa kurudia zinaweza kuufanya usimbaji wa LLM kuwa thabiti zaidi; hata hivyo, katika seti hii ya data ChatGPT haikuwakilisha muktadha mahususi wa taaluma na tofauti ndogo za kimawazo kwa undani sawa na uchanganuzi wa maudhui wa binadamu.
Matokeo haya hayapaswi kutafsiriwa kama “ChatGPT hutoa matokeo sawa na binadamu katika uchanganuzi wa ubora” au “Jaccard 0,83 inamaanisha usahihi wa %83 ikilinganishwa na uchanganuzi wa binadamu”. Thamani ya 0,83 inapima uthabiti kati ya utekelezaji unaorudiwa wa ChatGPT yenyewe. Mwingiliano wa jumla wa vitengo vya usimbaji katika ulinganisho wa binadamu–ChatGPT ni 0,39. Aidha, watafiti hawauchukulii mfumo wa misimbo wa binadamu kama ukweli mmoja wa kiobjektivu, bali kama tafsiri nyingine halali ya uchanganuzi wa nyenzo hiyo hiyo.
Tatizo kuu la utafiti
Katika utafiti wa ubora, usimbaji huruhusu vipande virefu vya maandishi kubadilishwa kuwa kategoria zenye maana zinazohusiana na maswali ya utafiti. Katika mahojiano moja, yale yanayosemwa na walimu yanaweza kuwa na mamia ya sentensi au vifungu tofauti. Mtafiti huamua ni vifungu gani katika nyenzo hii vinavyohusiana na muundo uleule wa kimawazo, hutengeneza misimbo, huunganisha misimbo inayofanana, na inapohitajika huunda kategoria za kiwango cha juu zaidi.
Modeli kubwa za lugha zinaweza kutumia kitabu cha misimbo kilichopo kwenye maandishi au kubaini mada zinazorudiwa katika maandishi makubwa. Tatizo gumu zaidi linalolengwa na utafiti huu ni jinsi LLM inavyotengeneza mfumo wa misimbo wenyewe wakati misimbo haijatolewa kikamilifu mapema. Kwa maneno mengine, utafiti hauishii katika swali “Je, ChatGPT inachagua lebo sahihi?”; unaangalia ni kategoria gani modeli huzalisha kutoka kwenye nyenzo za ubora, jinsi kategoria hizo zinavyolingana na mfumo uliotengenezwa na binadamu, na kama zinategemea ushahidi uleule wa maandishi.
Kuna viwango viwili tofauti vya maswali ya utafiti katika utafiti huu
Katika chanzo, kuna viwango viwili vya maswali vinavyopaswa kutenganishwa. Kiwango cha kwanza ni maswali yanayochunguza maudhui ya seti ya awali ya data za mahojiano: kama stereotyping hutokea katika elimu ya jiografia, inatokeaje na kwa nini, na walimu hutumia mikakati gani kukabiliana nayo. Kiwango cha pili ni maswali ya tathmini ya kimetodolojia ya makala hii: je, mfumo wa misimbo wa ChatGPT unaweza kulinganishwa kisemantiki na mfumo wa uchanganuzi wa maudhui wa binadamu, je misimbo inayolingana kisemantiki huchagua vitengo vilevile vya usimbaji, na je kuna tofauti za kimfumo kati ya miundo ya mifumo miwili ya misimbo?
Tofauti hii ni muhimu. Mada ya mahojiano ni stereotyping; mada kuu ya kimetodolojia ya makala hii ni ulinganisho wa mfumo wa usimbaji wa kiinduktivu uliotengenezwa kwa ChatGPT na uchanganuzi wa maudhui unaotegemea binadamu.
Usimbaji wa Kiinduktivu ni Nini na ChatGPT Ilitumika Vipi Katika Utafiti Huu?
Usimbaji wa kiinduktivu ni mchakato wa kutengeneza kategoria na kategoria ndogo kutokana na mifumo yenye maana iliyo katika nyenzo za ubora zinazochanganuliwa, badala ya kuzifunga kikamilifu mapema; katika utafiti huu ChatGPT ilitengeneza mfumo wa misimbo unaotokana na data kwa kila mahojiano, ikaunganisha mifumo hiyo kupitia hatua za usanisi zinazorudiwa, na kisha ikatumia tena mfumo wa mwisho wa misimbo kwenye transcript za mahojiano.
Uchanganuzi wa maudhui unaotegemea binadamu ulifanywaje?
Uchanganuzi wa maudhui wa binadamu ulifuata mkabala wa hatua saba wa Kuckartz na Rädiker. Watafiti kwanza walisoma mahojiano kwa makini, wakaandaa maelezo na muhtasari wa kesi; kisha wakabaini jumla ya vitengo 86 vya usimbaji katika transcript 11.
Katika hatua ya kwanza, misimbo mitatu kuu ilitumika: mifano ya stereotyping, sababu za stereotyping, na mikakati ya kukabiliana na stereotyping. Chini ya muundo huu mkuu, misimbo midogo 20 ilitengenezwa kwa njia ya kiinduktivu kutoka kwenye nyenzo, muundo wa misimbo ukapitiwa upya, na nyenzo yote ikawekwa misimbo tena kwa mfumo wa mwisho wa misimbo. Mikakati ya uchanganuzi ilitumika kulingana na maswali ya utafiti, na uchanganuzi wa binadamu ulifanywa kwa MAXQDA Analytics Pro 24.4.0.
Hatua tano za mchakato wa usimbaji wa ChatGPT
Hatua I — Uundaji wa awali: Kila moja ya mahojiano 11 yalipewa ChatGPT kando, na mfumo tofauti wa usimbaji wa kiinduktivu ukatengenezwa kwa kila transcript. Prompt ilifafanua jukumu la modeli kama msaidizi wa utafiti, kazi, maswali ya utafiti, kanuni za usimbaji na muundo wa matokeo. Lengo lilikuwa kupunguza matatizo ya uchakataji yanayoweza kusababishwa na muktadha mrefu kwa kutumia transcript moja tu kwa wakati.
Katika majaribio ya awali, ChatGPT ilionyesha mwelekeo wa kuelekea kwenye misimbo ya maelezo ya kiwango cha juu kama “stereotype ni nini?”, ambayo ilikuwa ya jumla zaidi kuliko maswali ya utafiti, hivyo prompt iliboreshwa. Kwa njia hii, lengo lilikuwa kuunganisha uundaji wa misimbo kwa karibu zaidi na maswali ya utafiti katika mahojiano badala ya nadharia ya jumla ya stereotyping.
Hatua II — Usanisi wa mifumo kumi na moja: Mifumo 11 ya misimbo iliyopatikana kutoka kila transcript ililinganishwa pamoja. Misimbo iliyofanana kimaudhui iliunganishwa, misimbo ya kiwango cha juu iliyoweza kuhalalishwa kimada ikaundwa, mwingiliano ukatatuliwa, na ni misimbo iliyokuwa imetumika kweli katika hatua ya kwanza pekee iliyoruhusiwa kuingia kwenye mfumo mpya.
Hatua III — Kurudia usanisi: Kwa sababu matokeo ya LLM si ya deterministiki, mchakato wa usanisi ulirudiwa mara tano kwa kujitegemea. Kila usanisi ulifanywa katika kipindi tofauti cha mazungumzo na ilielezwa kwamba kipengele cha kumbukumbu kilikuwa kimezimwa katika hatua hii. Lengo lilikuwa kuangalia ni misimbo gani iliyokuwa thabiti katika uzalishaji unaorudiwa badala ya kutegemea matokeo moja ya bahati nasibu ya modeli.
Hatua IV — Usanisi wa mwisho: Mifumo mitano ya misimbo iliyosanisiwa iliunganishwa tena. Ili msimbo ujumuishwe katika mfumo wa mwisho, ilibidi uwepo katika angalau mifumo mitatu kati ya mitano. Kanuni hii ya “3/5” ilipunguza uwezekano wa matokeo adimu au ya mara moja ya modeli kuamua mfumo wa mwisho wa misimbo.
Hatua V — Kuweka transcript misimbo kwa mfumo wa mwisho: Mfumo wa mwisho wa misimbo ulitumika baadaye kwa transcript za awali za mahojiano. Kanuni zilitumika ili modeli itumie tu misimbo iliyofafanuliwa, isivuke mipaka ya ufafanuzi wa msimbo, isitengeneze msimbo mpya, itoe sababu ya mgawo wa msimbo, na iseme wazi ikiwa hakuna msimbo unaofaa.
Kila transcript iliwekewa misimbo katika utekelezaji tano huru. Katika uchanganuzi wa mwisho, ili mgawo wa msimbo uhifadhiwe ilibidi uwepo katika angalau tathmini tatu kati ya tano. Kanuni hii ya pili ya 3/5 ni tofauti na kanuni ya 3/5 katika hatua ya kutengeneza mfumo wa misimbo: ya kwanza huamua ni misimbo ipi itaingia katika kitabu cha mwisho cha misimbo, na ya pili huamua ni migawo ya misimbo ipi itaingizwa katika tathmini ya mwisho.
Kwa nini prompt zilizo kwenye viambatisho ni muhimu kisayansi?
Kiambatisho A cha utafiti hakitoi tu prompt ya mfano; kinaandika usanifu wa prompt uliotumiwa ili mchakato wa usimbaji unaosaidiwa na LLM uweze kufuatiliwa tena.
Kiambatisho A.1 ni prompt ya kwanza inayotengeneza mfumo wa misimbo kwa kila transcript. Modeli inaombwa kutenda kama mtafiti katika utafiti wa elimu wa ubora, kuunda kategoria kwa njia ya kiinduktivu kwa kutumia tu nyenzo husika katika transcript, kutofautisha kategoria, na kutoa jina la msimbo pamoja na maelezo yake katika jedwali.
Kiambatisho A.2 kinalenga kuunganisha mifumo 11 tofauti ya misimbo katika muundo mmoja uliounganishwa. Masharti ni pamoja na kulinganisha misimbo kwa maudhui, si kwa majina pekee; kuunganisha misimbo inayofanana; kuunda kategoria za juu tu pale zinapoweza kuhalalishwa kimada; na kutoruhusu msimbo ambao haujawahi kutumika katika mifumo ya awali kuongezwa kwenye usanisi.
Kiambatisho A.3 hubadilisha usanisi tano unaorudiwa kuwa mfumo mmoja wa mwisho wa misimbo. Kanuni kuu ya uteuzi hapa ni kwamba msimbo lazima uwepo katika angalau mifumo mitatu kati ya mitano.
Kiambatisho A.4 kinadhibiti matumizi ya kitabu cha mwisho cha misimbo kwenye transcript. Modeli inaombwa isivuke ufafanuzi wa misimbo, isitengeneze maana mpya kwa kuandika upya, isitengeneze misimbo mipya, iruhusu misimbo mingi katika kitengo kimoja cha usimbaji, iseme ikiwa hakuna msimbo unaofaa, na ihalalishe kila mgawo kwa kurejelea ufafanuzi wa msimbo.
Maelezo haya ni muhimu; kwa sababu matokeo ya utafiti si matokeo ya matumizi ya jumla kama “nini hutokea ukiambia ChatGPT iweke misimbo?”. Matokeo yanahusu itifaki maalum ya prompt iliyokuwa na muundo mkubwa na iliyojaribiwa kuimarishwa kwa marudio.
Kwa Nini Mfanano wa Kosaini na Faharasa ya Jaccard Havipimi Kitu Kilekile?
Mfanano wa kosaini hupima jinsi jina na maelezo ya misimbo miwili yalivyo karibu kisemantiki, ilhali faharasa ya Jaccard hupima kiwango ambacho vitengo halisi vya usimbaji vilivyogawiwa misimbo vinaingiliana; kwa hiyo misimbo miwili inaweza kuwa na maana inayofanana sana lakini ikatumika kwenye vipande tofauti vya maandishi katika mahojiano.
Uwakilishi wa kisemantiki wa misimbo kwa SBERT
Kwa kila msimbo, jina la msimbo na ufafanuzi wa msimbo viliunganishwa kuwa usemi mmoja wa maandishi. Maandishi haya yalibadilishwa kuwa vekta za nambari kwa kutumia mkabala wa Sentence-BERT (SBERT). Utafiti ulitumia modeli iliyofunzwa mapema ya paraphrase-multilingual-MiniLM-L12-v2.
Vekta hizi zinazoitwa embedding hutumiwa kuwakilisha si tu ulinganifu wa neno kwa neno, bali pia ukaribu wa maana ya maandishi katika nafasi ya nambari. Hivyo, kwa mfano, hata kama misimbo miwili inatumia maneno tofauti, inaweza kutengeneza vekta zilizo karibu ikiwa ina maana inayofanana.
Mantiki ya kihisabati ya mfanano wa kosaini
Dokezo la kufundishia: Makala haitoi mlinganyo wa mfanano wa kosaini kama mlinganyo uliochapishwa kivyake. Usemi ufuatao ni ufafanuzi wa kawaida wa kihisabati wa kipimo kilichotumiwa katika utafiti; si fomula mpya ya utafiti.
\[ \mathrm{cosine}(\mathbf{a},\mathbf{b}) = \frac{\mathbf{a}\cdot\mathbf{b}} {\|\mathbf{a}\|\,\|\mathbf{b}\|} \]
\(\mathbf{a}\) na \(\mathbf{b}\) ni vekta za embedding za misimbo miwili zilizopatikana kwa SBERT. Dot product katika sehemu ya juu huwakilisha mwelekeo wa pamoja wa vekta mbili, na bidhaa ya norma katika sehemu ya chini husawazisha ukubwa wa vekta. Kwa hivyo, ulinganisho hutegemea hasa mwelekeo wa vekta, yaani ukaribu wa kisemantiki.
Kipimo hiki hakina kitengo. Katika utafiti, kadiri thamani ilivyokaribia 1, ndivyo mwingiliano wa kimawazo ulivyochukuliwa kuwa wenye nguvu zaidi. Kizingiti cha 0,60 cha mfanano wa kosaini kilitumiwa kwa uchanganuzi uliofuata.
Kwa nini Hungarian Algorithm ilitumika?
Kulinganisha msimbo mmoja wa ChatGPT kwa kujitegemea tu na msimbo wa binadamu wenye alama ya juu zaidi ya mfanano kunaweza kusababisha msimbo uleule wa binadamu kugawiwa kwa misimbo mingi ya ChatGPT. Badala yake, utafiti ulitathmini miunganiko yote kwa pamoja na kutafuta mchanganyiko wa mgawo wa mmoja-kwa-mmoja unaoongeza jumla ya mfanano wa kisemantiki.
Uwakilishi wa kawaida wa kufundishia: Makala haichapishi mlinganyo ufuatao wa uboreshaji kwa namna hii; umetolewa kueleza matumizi ya tatizo la mgawo la Hungarian katika utafiti.
\[ \max \sum_i\sum_j s_{ij}x_{ij} \]
Hapa \(s_{ij}\) ni mfanano wa kosaini kati ya msimbo wa ChatGPT \(i\) na msimbo wa uchanganuzi wa maudhui wa binadamu \(j\). Ikiwa \(x_{ij}=1\), misimbo hiyo miwili imeunganishwa; ikiwa \(x_{ij}=0\), haijaunganishwa. Kwa sababu ya ulinganishaji wa mmoja-kwa-mmoja, kila msimbo unaweza kuunganishwa na msimbo mmoja tu wa upande mwingine.
Kwa kuwa mfumo wa ChatGPT una misimbo midogo 14 na mfumo wa binadamu una 20, Hungarian Algorithm inaweza kutengeneza hadi miunganiko 14 ya mmoja-kwa-mmoja. Katika utafiti, moja kati ya miunganiko 14 ilikuwa na mfanano wa kosaini wa 0,56 na ikabaki chini ya kizingiti cha 0,60; hivyo uchanganuzi uliofuata ulifanywa kwa jozi 13 zilizolinganishwa.
Faharasa ya Jaccard huhesabu nini?
Ufafanuzi wa kawaida wa kufundishia: Makala inafafanua faharasa ya Jaccard kwa maneno; mlinganyo ufuatao ni uwakilishi wa kawaida wa kihisabati wa ufafanuzi huo.
\[ J(A,B) = \frac{|A\cap B|} {|A\cup B|} \]
\(A\) ni seti ya vitengo vya usimbaji ambavyo msimbo mmoja umegawiwa na mkabala wa kwanza wa usimbaji; \(B\) ni seti ya vitengo vya usimbaji ambavyo msimbo unaolingana umegawiwa na mkabala wa pili. \(|A\cap B|\) ni idadi ya vitengo vya pamoja vilivyowekewa misimbo na mikabala yote miwili; \(|A\cup B|\) ni vitengo vyote vilivyowekewa msimbo na angalau mkabala mmoja.
\(J=1\) inamaanisha seti hizo mbili ni sawa kabisa; \(J=0\) inamaanisha hakuna kitengo chochote cha usimbaji cha pamoja.
Utafiti ulitumia faharasa ya Jaccard kwa madhumuni mawili tofauti. La kwanza ni kutathmini jinsi transcript ileile ilivyowekewa misimbo kwa uthabiti katika utekelezaji tano za ChatGPT. La pili ni kutathmini kama misimbo ya ChatGPT na binadamu iliyolinganishwa kisemantiki ilitumika kwenye vipande vilevile vya maandishi. Matokeo haya mawili ya Jaccard hayajibu swali lilelile la kisayansi.
Uchanganuzi wa mtandao unaongeza nini?
Wakati ulinganishaji wa kisemantiki unalinganisha jozi moja moja za misimbo, uchanganuzi wa mtandao huchunguza muundo wa mfumo mzima wa misimbo. Kila msimbo hufafanuliwa kama nodi, na uhusiano kati ya misimbo miwili inayoonekana pamoja katika kitengo kimoja cha usimbaji hufafanuliwa kama edge. Uzito wa edge hutegemea ni katika vitengo vingapi vya usimbaji misimbo hiyo miwili ilionekana pamoja.
Msongamano wa mtandao hupima ni sehemu gani ya mahusiano yanayowezekana ya msimbo-kwa-msimbo ambayo yameonekana. Kwa mtandao rahisi usio na mwelekeo, usemi wa kawaida wa kufundishia ni:
\[ D=\frac{2E}{V(V-1)} \]
\(V\) ni idadi ya nodi, yaani misimbo, na \(E\) ni idadi ya mahusiano yaliyoonekana. Kadiri thamani inavyoongezeka, ndivyo uwiano wa misimbo iliyounganishwa katika mtandao unavyoongezeka. Fomula hii si fomula mpya ya utafiti; ni maelezo ya kawaida ya dhana ya msongamano wa mtandao katika makala.
Mgawo wa jumla wa clustering hutathmini mwelekeo wa misimbo iliyounganishwa na msimbo mmoja kuunganishwa pia yenyewe na kuunda vikundi. Chanzo hakitoi mlinganyo maalum; kwa hiyo Verianla haitabuni fomula maalum ya utekelezaji ambayo haipo kwenye makala.
Eigenvector centrality (EV-centrality) haizingatii tu idadi ya mahusiano ya msimbo, bali pia jinsi misimbo mingine ambayo imeunganishwa nayo ilivyo ya kati. Uhusiano wa kawaida wa eigenvector unaweza kuonyeshwa kwa madhumuni ya kufundishia kama:
\[ x_i = \frac{1}{\lambda} \sum_j A_{ij}x_j \]
\(x_i\) ni centrality ya msimbo \(i\); \(A_{ij}\) ni matriki ya mahusiano ya mtandao; na \(\lambda\) ni eigenvalue husika. Nodi zinazounganishwa na misimbo yenye centrality kubwa hupata EV-centrality kubwa zaidi.
Mpangilio wa Fruchterman–Reingold si matokeo ya kitakwimu
Katika taswira za mtandao, nafasi za nodi kwenye skrini zilibainishwa na algoriti ya Fruchterman–Reingold. Algoriti huleta karibu kwa mwonekano nodi zenye uhusiano mkubwa ili mtandao usomeke kwa urahisi. Nodi kuwa kulia, kushoto, juu au chini kwenye picha si kipimo cha kisayansi chenyewe; vipimo vya kisayansi ni mahusiano, uzito wa edges na thamani za centrality.
Kwa nini modeli null ya Curveball inahitajika?
Ili kutathmini kama thamani za msongamano au clustering za mitandao miwili zilitokea tu kutokana na masafa ya misimbo yaliyopo, modeli null tofauti zilitengenezwa. Algoriti ya Curveball iliporandomisha matriki ya jozi ya kitengo cha usimbaji × msimbo, ilihifadhi sifa mbili muhimu: idadi ya jumla ya misimbo iliyogawiwa kwa kila kitengo cha usimbaji, na jumla ya mara ambazo kila msimbo ulionekana katika seti nzima ya data.
Kwa kila mfumo wa misimbo, matriki jozi 10.000 zilizorandomishwa zilitengenezwa; mitandao ya co-occurrence ya misimbo ikajengwa upya kutoka kwayo, na usambazaji null wa msongamano na clustering ya jumla ukapatikana.
Muundo wa kufundishia wa ulinganisho uliosanifishwa unaweza kufikiriwa kama:
\[ z = \frac{T_{\mathrm{obs}}-\mu_{\mathrm{null}}} {\sigma_{\mathrm{null}}} \]
\(T_{\mathrm{obs}}\) ni kipimo cha mtandao kilichoonekana, \(\mu_{\mathrm{null}}\) ni wastani wa usambazaji null wa bahati nasibu, na \(\sigma_{\mathrm{null}}\) ni mkengeuko sanifu wa usambazaji null. Chanzo pia kinaeleza kwamba p-values za Monte Carlo za pande mbili na vipindi null vya %95 vilihesabiwa. Kwa kuwa mipaka ya nambari ya vipindi null vya %95 haikutolewa katika maandishi makuu ya matokeo, Verianla haibuni mipaka hiyo.
Je, Mfanano Mkubwa wa Kisemantiki Unaonyesha Kwamba Vipande Vilevile vya Maandishi Viliwekewa Misimbo?
Hapana. Katika utafiti huu, baadhi ya jozi za misimbo zilikuwa na mfanano mkubwa wa kosaini lakini mwingiliano wa Jaccard ukabaki mdogo sana; kwa mfano, “Perspective shift and irritation” na “Teaching methods” zilionyesha mfanano wa kisemantiki wa takribani 0,78, lakini mwingiliano wa vitengo vya usimbaji ulikuwa 0,10 tu.
Tofauti hii ni mojawapo ya matokeo muhimu zaidi ya utafiti. Majina na ufafanuzi wa misimbo yanaweza kuwa na maana zinazofanana kimawazo; hata hivyo, mifumo miwili ya usimbaji inaweza kutumia dhana hiyo katika sehemu tofauti za mahojiano, kwa upana tofauti, au kwa vigezo tofauti vya muktadha.
Kulingana na tafsiri ya waandishi, mojawapo ya sababu muhimu ni granularity ya misimbo. ChatGPT ilikuwa na mwelekeo wa kuunganisha dhana pana chini ya msimbo mmoja, ilhali uchanganuzi wa maudhui wa binadamu ulitenganisha eneo lilelile la kimawazo katika misimbo midogo zaidi. Kwa hiyo, ni sehemu tu ya vipande vya maandishi vinavyoingia katika msimbo mpana wa ChatGPT inaweza kuingia katika msimbo mwembamba zaidi wa binadamu uliolinganishwa na Hungarian Algorithm.
Granularity ya misimbo inamaanisha nini?
Granularity inaeleza jinsi mfumo wa misimbo unavyoshikilia tofauti za kimawazo kwa undani au kwa upana. Kwa mfano, mfumo wa ChatGPT uliunda kategoria pana inayoitwa “Spatial and developmental stereotypes”, ilhali uchanganuzi wa maudhui wa binadamu uligawanya stereotyping za kijiografia katika misimbo tofauti kama “Continents”, “Countries” na “Country groups”.
Mikabala miwili inaweza kutambua jambo lilelile la jumla; lakini mmoja akiweka jambo hilo kwenye kisanduku kimoja kipana na mwingine kwenye visanduku vitatu tofauti, inaweza kuwa na mfanano mkubwa wa kisemantiki katika majina ya misimbo lakini kiwango cha vipande vinavyolingana moja kwa moja kikawa kidogo.
Mbinu na Matokeo ya Utafiti
Seti ya data na maandalizi ya data
| Sifa | Taarifa iliyotolewa katika chanzo |
|---|---|
| Idadi ya mahojiano | Mahojiano 11 ya mtandaoni, ya nusu-muundo na yasiyotambulisha washiriki |
| Washiriki | Walimu wa jiografia wa Ujerumani |
| Walimu walio kazini | n = 9 |
| Wanafunzi wa ualimu | n = 2 |
| Mada ya mahojiano | Stereotyping katika somo la jiografia |
| Unukuzi | noScribe 0.4.1 na kisha raundi mbili za marekebisho ya mikono |
| Kitengo cha usimbaji katika uchanganuzi wa binadamu | 86 |
| Programu ya uchanganuzi wa binadamu | MAXQDA Analytics Pro 24.4.0 |
| Mfumo wa ChatGPT | ChatGPT-5.2, 11 Desemba 2025 snapshot — jina lililotumiwa katika chanzo |
| Lugha ya usimbaji | Kijerumani |
| Tafsiri ya mfumo wa mwisho wa misimbo wa ChatGPT | Kwa DeepL kwenda Kiingereza, 8 Juni 2026 |
Misimb 20 midogo katika uchanganuzi wa maudhui wa binadamu
| Msimbo mkuu | Msimbo mdogo | n |
|---|---|---|
| Mifano ya stereotyping | Continents | 4 |
| Mifano ya stereotyping | Country groups | 3 |
| Mifano ya stereotyping | Students' background | 7 |
| Mifano ya stereotyping | Countries | 8 |
| Mifano ya stereotyping | Subject content | 13 |
| Sababu za stereotyping | Teachers (causes) | 2 |
| Sababu za stereotyping | Educational policy factors | 2 |
| Sababu za stereotyping | Geography-specific factors | 7 |
| Sababu za stereotyping | Students (causes) | 8 |
| Sababu za stereotyping | Sociocultural influences | 5 |
| Sababu za stereotyping | Resources: Textbooks | 6 |
| Mikakati ya kukabiliana na stereotyping | Perspective shift | 6 |
| Mikakati ya kukabiliana na stereotyping | Causal analysis | 3 |
| Mikakati ya kukabiliana na stereotyping | Student-oriented strategies | 4 |
| Mikakati ya kukabiliana na stereotyping | Teachers (strategies) | 3 |
| Mikakati ya kukabiliana na stereotyping | Teaching methods | 6 |
| Mikakati ya kukabiliana na stereotyping | Outside the classroom | 2 |
| Mikakati ya kukabiliana na stereotyping | Dialogue and reflection | 7 |
| Mikakati ya kukabiliana na stereotyping | Increasing complexity | 5 |
| Mikakati ya kukabiliana na stereotyping | Evidence-based working | 5 |
Katika Jedwali la Ziada A1 la chanzo, nambari za misimbo midogo ya mikakati zinatoka moja kwa moja 3.8 hadi 3.10; msimbo 3.9 hauonyeshwi. Hata hivyo, jedwali linaripoti jumla ya misimbo midogo 20. Verianla haikadirii msimbo ambao nambari iliyokosekana inapaswa kuhusiana nao.
Jumla ya matukio ya misimbo katika Jedwali la Ziada A1 ni 106. Idadi hii inaweza kuwa kubwa kuliko vitengo 86 vya usimbaji kwa sababu kitengo kimoja cha usimbaji kinaweza kugawiwa misimbo tofauti zaidi ya mmoja. Ili kufanya ulinganisho katika makala hii ufanane zaidi na usimbaji wa ChatGPT, marudio ya msimbo uleule ndani ya kitengo kilekile cha usimbaji yalihesabiwa kwa kiwango cha juu cha 1.
Mfumo wa mwisho wa misimbo uliotengenezwa na ChatGPT
| Msimbo mkuu | Msimbo mdogo | Wazo kuu linalofunikwa na msimbo |
|---|---|---|
| Manifestations | Spatial and developmental stereotypes | Kuwakilisha maeneo na jamii kwa picha za kuwa sawa, nyuma kimaendeleo, au zilizoendelea kwa mtazamo wa upande mmoja |
| Manifestations | Problem and deficit focus | Kuwasilisha maeneo hasa kupitia migogoro, umaskini, mizozo au upungufu |
| Manifestations | Social and origin stereotypes | Kutoa majumuisho kwa kuzingatia asili ya kikabila, utaifa, usuli wa kijamii au uwezo |
| Manifestations | Migration and religion | Kupunguza maeneo changamano kama uhamiaji na dini hadi sifa au sababu chache |
| Conditions of emergence | Didactic reduction and time pressure | Uwezekano kwamba muda wa somo na urahisishaji wa didaktiki vinaweza kuwezesha majumuisho kupita kiasi |
| Conditions of emergence | Material and textbook influence | Uwezekano kwamba uwakilishi katika vitabu vya kiada, picha, katuni au mtaala unaweza kuzalisha upya stereotyping |
| Conditions of emergence | Knowledge deficits as a breeding ground | Uwezekano kwamba upungufu wa maarifa ya taaluma unaweza kuelekeza kwenye mifumo rahisi ya maelezo badala ya mahusiano changamano |
| Conditions of emergence | Eurocentrism | Kutumia vigezo vinavyolenga Ulaya kama kiwango cha kutathmini maeneo mengine |
| Pedagogical strategies | Diagnostic assessment | Kubaini mawazo na taswira zilizopo za wanafunzi mwanzoni mwa somo |
| Pedagogical strategies | Dialogue-based reflection and intervention | Kuhoji, kujadili na kutoa mitazamo mbadala kuhusu kauli za kujumlisha |
| Pedagogical strategies | Perspective shift and irritation | Kuchochea mabadiliko ya mtazamo wa kifikra kwa kutumia uigizaji wa nafasi au mbinu zinazovunja mtazamo wa kawaida |
| Pedagogical strategies | Work with data and contextualization | Kupima madai kwa kutumia data na muktadha mpana zaidi |
| Pedagogical strategies | Making diversity and differentiation visible | Kufanya utofauti wa ndani wa nchi, maeneo na makundi uonekane |
| Pedagogical strategies | Professional self-reflection | Mwalimu kufikiri kwa ukosoaji kuhusu mifumo yake mwenyewe ya fikra na stereotyping zinazowezekana |
Idadi ya misimbo katika utekelezaji tano za usanisi
Usanisi tano tofauti haukutoa idadi sawa ya misimbo midogo. Trial 1 na Trial 5 zilitoa 16, Trial 2 ilitoa 18, Trial 3 ilitoa 24, na Trial 4 ilitoa misimbo midogo 20. Trial 4 pia ilitoa msimbo wa kiwango cha juu unaoitwa “Perception and Evaluation” ambao ulionekana katika utekelezaji huo tu. Kwa kuwa msimbo huo ulionekana katika usanisi mmoja pekee, haukupita kanuni ya mwisho ya uteuzi ya 3/5.
Uthabiti wa usimbaji wa mwisho kutoka utekelezaji mmoja hadi mwingine
| Transcript | Jaccard |
|---|---|
| 1 | 0,88 |
| 2 | 0,77 |
| 3 | 0,79 |
| 4 | 0,84 |
| 5 | 0,91 |
| 6 | 0,91 |
| 7 | 0,83 |
| 8 | 0,78 |
| 9 | 0,86 |
| 10 | 0,87 |
| 11 | 0,66 |
| Jumla | 0,83 |
Jaccard ya juu zaidi kati ya utekelezaji ilikuwa 0,91 katika transcript ya 5 na 6; thamani ya chini zaidi ilikuwa 0,66 katika transcript ya 11. Thamani ya jumla ilikuwa 0,83.
Maana ya jedwali hili lazima iwekwe wazi kwa ukomo wake: 0,83 haimaanishi kwamba ChatGPT inalingana na usimbaji wa binadamu kwa %83 au kwamba ina usahihi wa %83. Kipimo hiki kinahusu tu jinsi itifaki ileile ya ChatGPT ilivyotoa migawo ya misimbo inayofanana katika marudio huru.
Ujumbe mkuu wa ramani ya joto ya SBERT
Katika ramani ya joto ya chanzo, jumla ya jozi 63 za misimbo zilikuwa na mfanano wa kosaini wa 0,60 au zaidi. Misimbo ya ChatGPT kama “Professional self-reflection”, “Didactic reduction and time pressure”, “Working with data and contextualization” na “Perspective shift” ilionyesha mfanano wa zaidi ya 0,70 na misimbo ya binadamu.
Kinyume chake, misimbo kama “Migration and religion” na “Problem and deficit focus” ilikuwa na miunganiko ya karibu zaidi katika mfumo wa binadamu yenye mfanano wa kisemantiki dhaifu kwa kiasi.
Chanzo hakichapishi thamani sahihi za nambari za seli zote katika ramani ya joto kama jedwali. Kwa hiyo Verianla haitoi matriki mpya ya nambari kwa kukadiria thamani kutoka kwenye rangi.
Matokeo ya ulinganishaji wa mmoja-kwa-mmoja kwa Hungarian Algorithm
| No. | Msimbo wa ChatGPT | Msimbo wa uchanganuzi wa maudhui wa binadamu | Mfanano wa kosaini |
|---|---|---|---|
| 1 | Dialogue-based reflection and intervention | Dialogue and reflection | 0,81 |
| 2 | Perspective shift and irritation | Teaching methods | 0,78 |
| 3 | Making diversity and differentiation visible | Increasing complexity | 0,77 |
| 4 | Professional self-reflection | Teachers (strategies) | 0,77 |
| 5 | Diagnostic assessment | Outside the classroom | 0,73 |
| 6 | Work with data and contextualization | Evidence-based learning | 0,72 |
| 7 | Knowledge deficits as breeding ground | Educational policy factors | 0,71 |
| 8 | Spatial and developmental stereotypes | Continents | 0,69 |
| 9 | Social and origin stereotypes | Students' background | 0,66 |
| 10 | Didactic reduction and time pressure | Geography-specific factors | 0,65 |
| 11 | Material and textbook influence | Resources: Textbooks | 0,63 |
| 12 | Migration and religion | Sociocultural influences | 0,61 |
| 13 | Eurocentrism | Perspective shift | 0,60 |
| 14 | Problem and deficit focus | Country groups | 0,56 — chini ya kizingiti |
Kwa kuwa ulinganifu wa mwisho ulikuwa chini ya kizingiti cha 0,60, haukujumuishwa katika ulinganisho wa baadaye wa Jaccard wa vitengo vya usimbaji.
Kwa kuwa uchanganuzi wa maudhui wa binadamu una misimbo sita zaidi kuliko mfumo wa ChatGPT, misimbo sita ya binadamu ilibaki bila ulinganifu katika mgawo kamili wa mmoja-kwa-mmoja wa 14: Subject content, Countries, Teachers (causes), Students (causes), Causal analysis na Student-oriented strategies.
Tabia ya misimbo hii sita ni muhimu katika tafsiri ya utafiti. Sehemu kubwa yake inahusu maudhui mahususi ya jiografia, wahusika mahususi darasani, au tofauti ndogo zaidi za mikakati. Waandishi wanahusisha hili na matokeo kwamba mfumo wa ChatGPT ulibaini mifumo mipana inayoweza kujumlishwa, lakini ulitofautisha kwa undani mdogo vipengele mahususi vya taaluma na wahusika.
Mwingiliano halisi wa vitengo vya usimbaji baada ya ulinganishaji wa kisemantiki
| Msimbo wa ChatGPT | Msimbo wa binadamu | Jaccard |
|---|---|---|
| Dialogue-based reflection and intervention | Dialogue and reflection | 0,66 |
| Perspective shift and irritation | Teaching methods | 0,10 |
| Making diversity and differentiation visible | Increasing complexity | 0,66 |
| Professional self-reflection | Teachers (strategies) | 0,75 |
| Diagnostic assessment | Outside the classroom | 0 |
| Working with data and contextualization | Evidence-based working | 0,80 |
| Knowledge deficits as breeding ground | Educational policy factors | 0 |
| Spatial and developmental stereotypes | Continents | 0,33 |
| Social and origin stereotypes | Students' background | 0,38 |
| Complexity reduction and time pressure | Geography-specific factors | 0,33 |
| Material and textbook influence | Resources: Textbooks | 0,86 |
| Eurocentrism | Perspective shift | 0,14 |
| Migration and religion | Sociocultural influences | 0 |
| Jaccard ya jumla | Jumla ya jozi 13 zilizolinganishwa | 0,39 |
Katika jozi tano za misimbo, Jaccard ilikuwa zaidi ya 0,60. Thamani ya juu zaidi ilikuwa 0,86 kati ya “Material and textbook influence” na “Resources: Textbooks”. Kinyume chake, katika miunganiko mitatu Jaccard ilikuwa sifuri.
Maandishi ya matokeo ya chanzo yanaeleza kundi la chini-kati kama takribani 0,30–0,40. Chanzo pia kinatumia usemi “J<0,14” kwa jozi tano zilizobaki; hata hivyo, katika Jedwali 7 thamani ya Eurocentrism–Perspective shift ni 0,14 kamili. Verianla haibadilishi thamani ya jedwali.
Katika sehemu ya majadiliano, masafa ya makubaliano makubwa yameandikwa sehemu moja kuwa 0,66–0,89; lakini thamani ya juu zaidi iliyoonekana katika Jedwali 7 ni 0,86. Kwa hiyo Verianla hutumia 0,86 ya Jedwali 7 kwa thamani sahihi za kiasi.
Kwa nini mfanano wa kisemantiki wa 0,78 unaweza kuonekana pamoja na Jaccard ya 0,10?
Kwa kuwa ufafanuzi wa kimawazo wa “Perspective shift and irritation” na “Teaching methods” uko karibu kiasi, mfanano wa kosaini ni 0,78. Hata hivyo, mifumo ya binadamu na ChatGPT ilitumia dhana hizi kwa kiasi kidogo sana kwenye vifungu vilevile vya mahojiano na Jaccard ikawa 0,10 tu.
Kinyume chake, “Dialogue-based reflection and intervention” na “Dialogue and reflection” zina mfanano mkubwa wa kisemantiki wa 0,81 na pia mwingiliano wa Jaccard wa 0,66 katika vitengo vya usimbaji. Kwa hiyo, hakuna uhusiano wa lazima wa mmoja-kwa-mmoja kati ya ukaribu wa kisemantiki na mwingiliano wa matumizi ya maandishi katika utafiti huu.
Ikiwa Msongamano wa Mtandao Unafanana, Je, Mifumo Miwili ya Misimbo ni Sawa Kimuundo?
Hapana. Ingawa thamani za jumla za msongamano na clustering za mitandao ya binadamu na ChatGPT ziko karibu, usambazaji wa eigenvector centrality kati ya misimbo ni tofauti; katika mfumo wa binadamu umuhimu wa kimuundo unasambaa kwenye misimbo mingi zaidi, ilhali katika mfumo wa ChatGPT misimbo michache pana inajikusanya katikati.
| Kipimo | Uchanganuzi wa maudhui wa binadamu | ChatGPT |
|---|---|---|
| Msongamano wa mtandao | 0,40 | 0,36 |
| z kwa msongamano | −0,60 | −1,66 |
| p kwa msongamano | 0,611 | 0,154 |
| Mgawo wa jumla wa clustering | 0,56 | 0,61 |
| z kwa clustering | 0,34 | 1,19 |
| p kwa clustering | 0,683 | 0,239 |
Kulingana na tafsiri ya waandishi, thamani za msongamano na clustering ya jumla za mitandao yote miwili hazikutofautiana kwa kiasi kikubwa na modeli zao za null. Ingawa sehemu ya mbinu ya chanzo inaeleza pia kwamba vipindi null vya %95 vilihesabiwa, matokeo makuu hayatoi mipaka ya nambari ya chini na ya juu ya vipindi hivyo.
Chanzo hakitaji wazi kizingiti tofauti cha alpha kwa ulinganisho huu wa mtandao; kwa hiyo Verianla haiongezi kizingiti cha umuhimu ambacho hakipo kwenye chanzo. Tafsiri ya waandishi wenyewe, kwa kutegemea p-values zilizoripotiwa, ni kwamba msongamano na clustering ya jumla havikuzidi matarajio ya null.
Eigenvector centrality inaonyesha picha tofauti
Katika mtandao wa uchanganuzi wa maudhui wa binadamu, msimbo wenye centrality kubwa zaidi ni Subject content, EV = 1,00, na wa pili ni Continents, EV = 0,71. Chanzo pia kinaeleza kwamba Students (causes), Resources: Textbooks na Teaching methods zilionyesha centrality ya juu kiasi.
Katika mtandao wa ChatGPT, misimbo michache imejikusanya kwa uwazi katikati kwa thamani za Spatial and developmental stereotypes, EV = 1,00; Problem and deficit focus, EV = 0,91 na Material and textbook influence, EV = 0,90.
Matokeo ya null-model yana maana gani?
P-values kubwa za null-model kwa msongamano wa mtandao na clustering ya jumla zinaonyesha kwamba muunganisho na clustering ya jumla iliyoonekana haikutofautiana kwa uwazi na mitandao ya bahati nasibu iliyoundwa huku masafa ya misimbo na idadi ya misimbo kwa kila kitengo cha usimbaji vikihifadhiwa.
Hata hivyo, matokeo haya hayamaanishi “mitandao miwili ni sawa”. Hata kama namba mbili za jumla zinafanana, misimbo ipi iko katikati, dhana zipi zimeunganishwa, na umuhimu wa kimuundo unasambazwaje kati ya misimbo vinaweza kutofautiana. Matokeo ya EV-centrality ya utafiti yanaonyesha hasa tofauti hii ya kimuundo ya kiwango cha ndani zaidi.
Tathmini ya ubora: muundo wa kimuundo
Mfumo uliotengenezwa na ChatGPT ulihifadhi kwa kiwango kikubwa muundo wa jedwali uliotakiwa na maeneo matatu makuu ya kimawazo. Katika miunganiko 11 kati ya 13 ya kisemantiki, misimbo ilipata mwenzake katika kiwango kilekile cha mada kuu: mifano ya stereotyping ililingana na eneo la manifestations la ChatGPT, sababu na conditions of emergence, na mikakati na pedagogical strategies.
Miunganiko miwili ilivuka kiwango cha mada kuu: Migration and religion na Sociocultural influences; Eurocentrism na Perspective shift. Waandishi wanaeleza kwamba hili linaweza kuwa athari ya sharti la ulinganishaji wa mmoja-kwa-mmoja la Hungarian Algorithm. Kwa sababu algoriti huongeza mfanano wa jumla kimataifa huku ikiruhusu kila msimbo kupata ulinganifu mmoja tu; huenda washirika wa kawaida zaidi wa baadhi ya misimbo walikuwa tayari wamepewa miunganiko mingine.
Tathmini ya ubora: granularity na umahususi wa taaluma
Uchanganuzi wa maudhui wa binadamu ulitengeneza kategoria ndogo sita zaidi kuliko ChatGPT. Hasa, kutokuwepo kwa mwenzake wa msimbo Subject content wa mfumo wa binadamu katika mfumo wa ChatGPT kunavutia; kwa sababu Subject content ni mmoja wa misimbo inayotokea mara nyingi zaidi katika mtandao wa binadamu na pia ni nodi yenye centrality kubwa zaidi kwa EV = 1,00.
Mfumo wa binadamu ulitenganisha tofauti za kijiografia kwa undani zaidi kama Continents, Countries na Country groups, huku ChatGPT ikiziunganisha chini ya kategoria pana zaidi ya Spatial and developmental stereotypes.
Kulingana na tathmini ya waandishi, ChatGPT inaweza kubaini mifumo ya jumla inayojirudia kwa nguvu; hata hivyo, katika seti hii ya data, tofauti mahususi za elimu ya jiografia ziliwakilishwa kwa uwazi mdogo.
Tathmini ya ubora: wahusika katika kueleza sababu
Katika uchanganuzi wa maudhui wa binadamu, sababu za stereotyping zilitenganishwa katika viwango tofauti vya wahusika na miundo kama walimu, wanafunzi, usuli wa kijamii, muundo wa mada ya somo, vitabu vya kiada na sera ya elimu.
Katika mfumo wa ChatGPT, sababu zililenga zaidi masharti ya kimuundo; wahusika wakuu wa darasa kama walimu na wanafunzi hawakuwakilishwa kwa uwazi sawa kama kategoria tofauti za sababu kama ilivyo katika mfumo wa binadamu.
Hasa Students (causes) ni msimbo muhimu kimuundo katika mtandao wa binadamu; katika ChatGPT, kipengele cha wanafunzi kinaonekana kwa kiwango kidogo zaidi ndani ya Knowledge deficits as a breeding ground. Kwa hiyo utafiti unapendekeza kwamba uchanganuzi wa binadamu unatoa muundo uliotofautishwa zaidi wa wahusika kwa swali hili la utafiti.
Muundo wa kiwango cha juu unaoshirikiwa na mifumo yote miwili
Katika mitandao yote miwili, misimbo inayohusiana na mifano na sababu za stereotyping huwa na mwelekeo wa kuwa katika nafasi za kati zaidi. Misimbo ya mikakati ya ufundishaji kwa ujumla ina centrality ndogo na mahusiano machache.
Matokeo haya yanaashiria kwamba mikabala yote miwili ya uchanganuzi inawakilisha maswali “jambo ni nini na kwa nini hutokea?” kwa uzito mkubwa zaidi wa kimuundo kuliko swali “uingiliaji hufanywaje?” katika seti ya data. Hii ni tafsiri ya waandishi wa chanzo kutokana na muundo wa mtandao; si ushahidi wa utaratibu wa kisababishi.
Hitimisho zinazoungwa mkono na utafiti
- Chini ya prompt zilizo na muundo na zinazoboreshwa kwa kurudia, ChatGPT iliweza kutengeneza mfumo wa usimbaji wenye uthabiti kiasi kati ya marudio.
- Katika utekelezaji tano huru za usimbaji, run-to-run Jaccard ya jumla ilikuwa 0,83.
- Mifumo ya misimbo ya ChatGPT na binadamu ilikuwa na mifanano mingi ya kisemantiki ya kati hadi juu.
- Miunganiko 13 ya mmoja-kwa-mmoja juu ya kizingiti cha 0,60 iliingizwa katika ulinganisho uliofuata.
- Misimbo inayofanana kisemantiki si lazima iweke misimbo kwenye vipande vilevile vya maandishi; Jaccard ya jumla ilikuwa 0,39.
- Mfumo wa ChatGPT ulielekea kwenye kategoria pana za misimbo, huku uchanganuzi wa maudhui wa binadamu ukitoa tofauti ndogo na mahususi zaidi za taaluma.
- Ingawa msongamano na clustering ya jumla ya mitandao miwili zilionekana kufanana, usambazaji wa centrality ulikuwa tofauti.
- Katika seti hii ya data, umuhimu wa kimuundo katika mtandao wa ChatGPT ulijikusanya katika idadi ndogo ya misimbo inayotawala.
- Dhana mahususi za jiografia na wahusika zilionekana zaidi katika uchanganuzi wa maudhui wa binadamu.
- Utafiti unaona mapitio ya ukosoaji ya binadamu ya matokeo ya LLM kuwa ya lazima.
Hitimisho ambazo utafiti hauungi mkono
- Haiwezekani kuhitimisha kwamba ChatGPT ni sawa na usimbaji wa binadamu katika tafiti zote za ubora.
- Jaccard 0,83 haimaanishi usahihi wa %83 dhidi ya usimbaji wa binadamu.
- Mfanano mkubwa wa kosaini hauthibitishi kwamba vipande vilevile vya maandishi viliwekewa misimbo.
- Ukaribu wa msongamano wa jumla wa mtandao hauonyeshi kwamba muundo wa kimawazo wa mifumo miwili ya misimbo ni sawa.
- Uchanganuzi wa maudhui wa binadamu haukufafanuliwa katika utafiti huu kama “ground truth” ya kiobjektivu na pekee inayowezekana.
- Matokeo kutoka kwa mahojiano 11 hayawezi kujumlishwa kwa taaluma zote, LLM zote, au aina zote za data za ubora.
- Matokeo yanawakilisha itifaki ya prompt ya kina na ya kurudia ya utafiti, si matumizi ya jumla na yasiyo na muundo ya ChatGPT.
- Utafiti hauelezi ni kwa utaratibu gani wa kiakili au kialgorithimu LLM huunda kategoria za misimbo ndani yake.
Tatizo la “kisanduku cheusi” la LLM
Katika uchanganuzi wa ubora wa binadamu, mtafiti anaweza kuandika hatua kwa hatua ni vitengo gani vya usimbaji alivyolinganishia, kwa nini aligawanya msimbo mmoja, au kwa msingi gani wa kimawazo aliunganisha misimbo miwili. Katika uchakataji wa ndani wa LLM, haiwezi kuonekana moja kwa moja kama kategoria pana zinaundwa kwa uondoaji wa kimawazo wa kurudia kama katika uchanganuzi wa binadamu, au kwa utaratibu tofauti wa kitakwimu wa kutambua mifumo.
Kwa hiyo utafiti hauwezi kueleza kikamilifu kwa nini baadhi ya vitengo vya usimbaji vilichaguliwa tofauti sana licha ya kuwepo kwa ukaribu wa kisemantiki kati ya mifumo miwili. Granularity ya misimbo inaweza kueleza sehemu ya tofauti hii; lakini waandishi wanaeleza kwamba haiwezi kueleza tofauti yote.
Unyeti kwa prompt
Matokeo ya LLM ni nyeti kwa muundo wa prompt uliotumiwa. Katika utafiti huu, prompt ziliboreshwa kwa kurudia kwa vipengele kama ufafanuzi wa jukumu, maagizo, muktadha, marudio, usanisi na kuelekeza kwenye maswali ya utafiti.
Kwa hiyo si sahihi kutafsiri matokeo kama “tabia ya asili na isiyobadilika ya usimbaji wa ChatGPT”. Miundo tofauti ya prompt inaweza kutengeneza mifumo tofauti ya misimbo. Utafiti unaacha hili kama eneo wazi kwa tafiti zijazo.
Vikwazo vikuu
Seti ndogo ya data yenye mada maalum: Utafiti unategemea mahojiano 11 tu na mada moja nyeti kwa tafsiri, yaani stereotyping katika somo la jiografia. Haijulikani kama mifumo ileile itaonekana katika seti kubwa zaidi za data na taaluma tofauti.
Unyeti kwa prompt: Ingawa uhandisi wa prompt wa kina na unaorudiwa ulitumika, prompt mbadala zinaweza kutoa miundo tofauti ya kategoria.
Utegemezi wa njia ya ulinganishaji: Hungarian Algorithm hutoa ulinganishaji wa mmoja-kwa-mmoja unaoweza kurudiwa; hata hivyo, njia nyingine za ulinganishaji zinaweza kulinganisha jozi tofauti za misimbo na kubadilisha kwa kiasi fulani matokeo ya ulinganisho.
Asili ya kitafsiri ya uchanganuzi wa ubora: Zaidi ya mfumo mmoja wa misimbo unaoweza kutetewa kisayansi unaweza kutokea kutoka kwa nyenzo ileile. Kwa hiyo tofauti kati ya mfumo wa binadamu na mfumo wa ChatGPT haiwezi kusomwa yenyewe kama “kosa la ChatGPT”.
Kutoweza kuona mchakato wa ndani wa LLM: Utafiti hauwezi kufuatilia mchakato wa ndani wa usanisi wa kategoria wa modeli. Haiwezi kuelezwa kikamilifu kwa mlolongo gani wa maamuzi ya kati misimbo inakuwa mipana au myembamba.
Muktadha mahususi wa taaluma: Katika seti hii ya data, mfumo wa binadamu ulitengeneza misimbo yenye undani zaidi inayohusiana moja kwa moja na elimu ya jiografia. Utafiti haukujaribu kama hali hiyo hutokea kwa namna ileile katika taaluma zote.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Evaluation of Inductive Coding with LLMs
Waandishi: Leoni Dörfel, Rieke Ammoneit.
Mpangilio wa waandishi: Mpangilio katika chanzo umehifadhiwa bila kubadilishwa.
Mchango sawa: Chanzo hakina taarifa ya uandishi mwenza wa kwanza au mchango sawa.
Mwandishi wa mawasiliano: Leoni Dörfel.
Taasisi: Department for Mathematics and Science Education, Institute for Geography Education, University of Cologne, Gronewaldstraße 2, 50931 Cologne, Germany.
Jarida: Education Sciences.
Mchapishaji: MDPI.
Juzuu / toleo / nambari ya makala: 16(8), 1314.
DOI: 10.3390/educsci16081314.
Kiungo rasmi cha DOI: https://doi.org/10.3390/educsci16081314
Iliwasilishwa: 14 Julai 2026.
Marekebisho: 7 Agosti 2026.
Ilikubaliwa: 13 Agosti 2026.
Ilichapishwa: 17 Agosti 2026.
Aina ya chanzo: Makala ya utafiti iliyopitiwa na wenzao. Kimetodolojia ni tathmini ya mbinu mseto inayounganisha uchanganuzi wa maudhui wa ubora, usimbaji wa kiinduktivu unaosaidiwa na LLM, uchanganuzi wa kisemantiki unaotegemea NLP, uchanganuzi wa mwingiliano wa vitengo vya usimbaji, uchanganuzi wa mtandao na ulinganisho wa ubora.
Leseni: Creative Commons Attribution (CC BY).
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Taarifa ya maadili ya taasisi: Utafiti unachanganua upya transcript za mahojiano zilizokusanywa hapo awali na kuondolewa utambulisho kikamilifu. Chanzo kinaeleza kwamba uchanganuzi wa sasa hauna taarifa za kumtambulisha mtu na kwamba utambulisho upya hauwezekani.
Ridhaa yenye taarifa: Ridhaa yenye taarifa ilipatikana kutoka kwa washiriki wote wa mahojiano ya awali.
Upatikanaji wa data: Data, script za R na data ghafi za uchanganuzi zilichapishwa kwenye Zenodo. DOI ya data: 10.5281/zenodo.21108082.
Taarifa ya matumizi ya akili bandia: Waandishi walitumia toleo la ChatGPT lililotajwa katika chanzo kama “GPT-5.2, 11 December 2025 snapshot” kutengeneza matokeo ya usimbaji wa ubora wakati wa utafiti. Imeelezwa kwamba matokeo ya akili bandia yalipitiwa kwa ukosoaji, kuthibitishwa na kutafsiriwa na watafiti; wajibu wa maudhui ya uchapishaji unabaki kwa waandishi.
Mgongano wa maslahi: Waandishi hawakuripoti mgongano wa maslahi.
Michango ya waandishi: Uundaji wa dhana Leoni Dörfel na Rieke Ammoneit; mbinu Leoni Dörfel na Rieke Ammoneit; programu Leoni Dörfel; uthibitishaji Leoni Dörfel; uchanganuzi rasmi Leoni Dörfel; uratibu wa data Leoni Dörfel; rasimu ya kwanza Leoni Dörfel; uonyeshaji wa data Leoni Dörfel; usimamizi wa kitaaluma Rieke Ammoneit; usimamizi wa mradi Leoni Dörfel.
Zana kuu za kiufundi zilizotumiwa: noScribe 0.4.1, MAXQDA Analytics Pro 24.4.0, ChatGPT-5.2 yenye snapshot ya 11 Desemba 2025 kama ilivyotajwa katika chanzo, SBERT paraphrase-multilingual-MiniLM-L12-v2, Hungarian Algorithm, Jaccard Index, R, igraph, modeli null ya vegan Curveball na ggplot2.
Kutokulingana ndani ya chanzo 1: Katika Jedwali 7, thamani ya juu zaidi ya Jaccard ya jozi ya misimbo ni 0,86; katika sehemu ya majadiliano, kikomo cha juu cha masafa ya mwingiliano mkubwa kimeandikwa kuwa 0,89. Verianla huhifadhi jedwali kama thamani sahihi.
Kutokulingana ndani ya chanzo 2: Maandishi ya matokeo yanaeleza jozi tano zilizobaki zenye mwingiliano mdogo kama J<0,14, ilhali katika Jedwali 7 jozi ya Eurocentrism–Perspective shift ina thamani kamili ya 0,14.
Kutokulingana ndani ya chanzo 3: Jedwali la Ziada A1 linaruka kutoka msimbo wa mkakati 3.8 moja kwa moja hadi 3.10; msimbo 3.9 hauonyeshwi. Verianla haikadirii maudhui ya nambari iliyokosekana.
Tofauti ya majina ndani ya chanzo: Mmoja wa misimbo ya binadamu unaonekana kama “Evidence-based learning” katika Jedwali 6, na “Evidence-based working” katika Jedwali 7 na Jedwali la Ziada A1. Vivyo hivyo, msimbo wa ChatGPT “Didactic reduction and time pressure” umeandikwa kama “Complexity reduction and time pressure” katika Jedwali 7. Tofauti hizi hazikutafsiriwa kama misimbo mipya.
Kikomo cha chanzo kuhusu usemi wa swali la utafiti: Data ya awali ya mahojiano katika sehemu ya mbinu iliundwa kuzunguka maswali mawili ya utafiti wa maudhui. Baadhi ya sentensi za matokeo/hitimisho za chanzo zinaeleza kwamba misimbo mitatu kuu ya ChatGPT inahusiana na “RQ1–3”; hata hivyo, RQ tatu za kimetodolojia za makala zinauliza kuhusu ulinganisho wa mifumo miwili ya usimbaji, si maeneo ya maudhui ya misimbo. Verianla haipanui usemi huu kana kwamba kulikuwa na maswali matatu tofauti ya awali ya mahojiano.
Kikomo kikuu cha tafsiri: Matokeo ya utafiti yalipatikana chini ya seti maalum ya data za mahojiano, snapshot maalum ya ChatGPT, itifaki maalum ya prompt na mbinu maalum za ulinganisho. Matokeo si kipimo cha jumla cha utendaji wa LLM zote au miktadha yote ya utafiti wa ubora.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *