


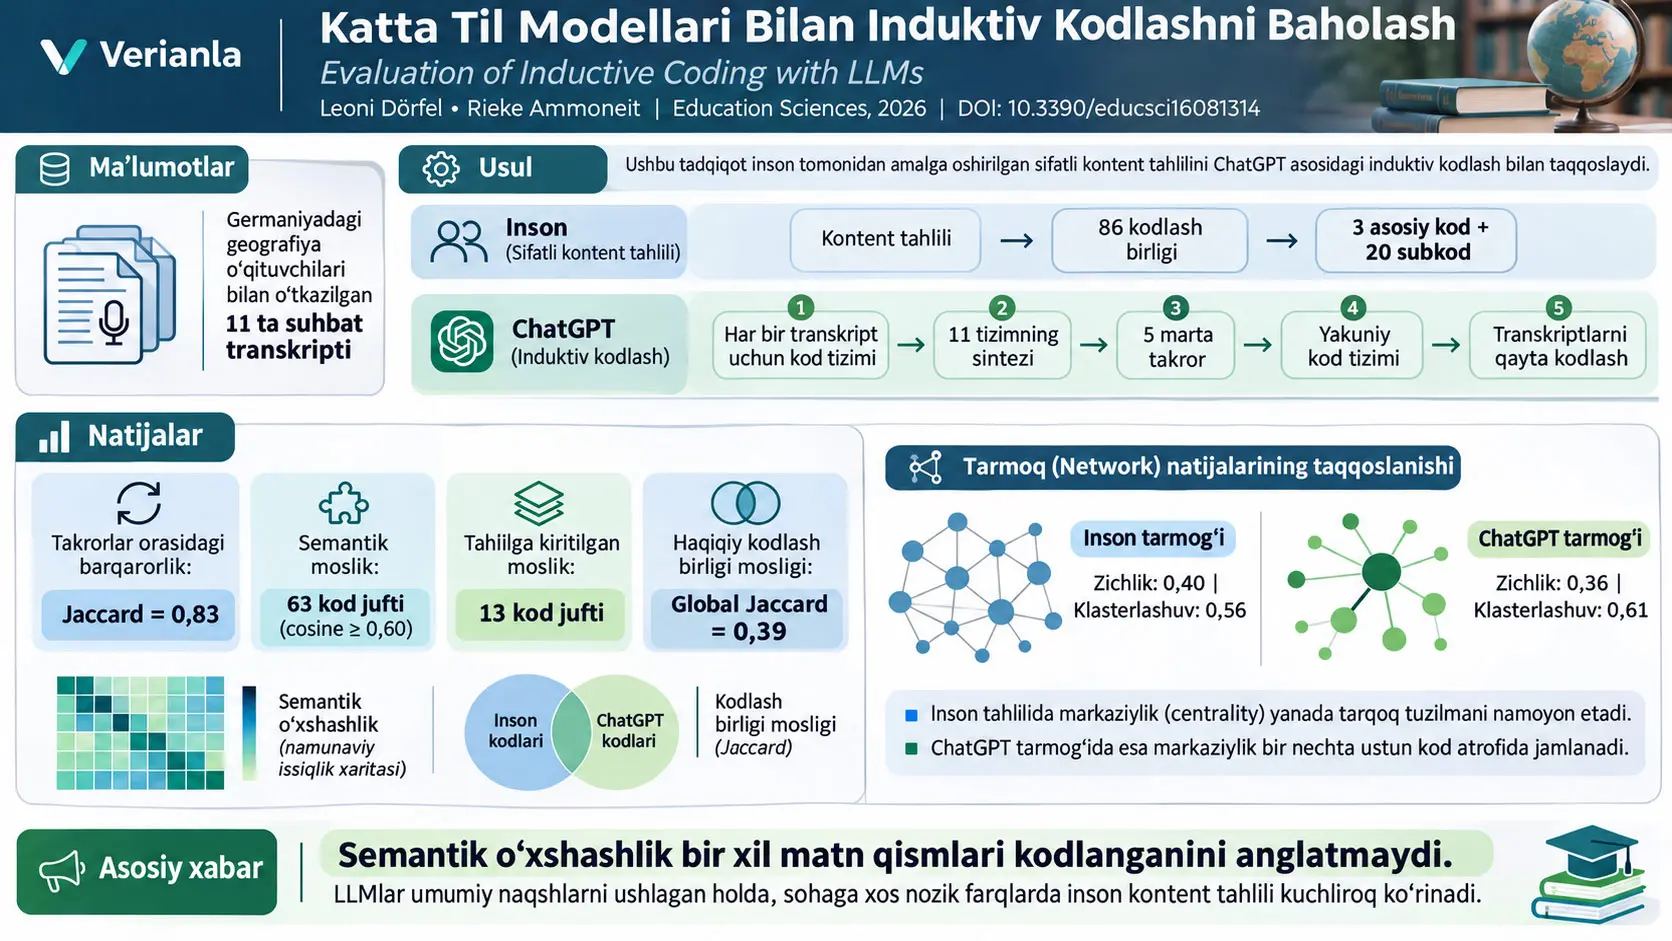
Katta til modeli yordamidagi induktiv kodlash — oldindan tayyorlangan kod kitobini shunchaki qo‘llash o‘rniga, suhbatlar yoki boshqa sifatli matnlardagi naqshlardan kod va kategoriya tuzilmalarini yaratishda katta til modelidan foydalaniladigan sifatli ma’lumotlarni tahlil qilish yondashuvidir. Ushbu tadqiqot ChatGPT 11 nafar nemis geografiya o‘qituvchisi bilan o‘tkazilgan suhbatlardan iterativ prompt muhandisligi orqali yaratgan kod tizimini ayni suhbatlar ustida avval inson tadqiqotchilar tomonidan amalga oshirilgan sifatli kontent tahlili bilan taqqoslaydi. Taqqoslash faqat kod nomlarining o‘xshashligi bilan cheklanmaydi; qaysi matn bo‘laklari kodlanganiga, kodlarning tarmoq ichidagi tarkibiy aloqalariga va sohaga xos kontekst qay darajada saqlanganigacha kengaytirilgan.
Tadqiqotda avval ChatGPT yordamida har bir suhbat uchun alohida kod tizimi yaratilgan, keyin bu tizimlar birlashtirilgan, sintez jarayoni besh marta mustaqil takrorlangan va besh sintezning kamida uchtasida uchragan kodlardan foydalanib yakuniy kod tizimi shakllantirilgan. Yakuniy tizim keyin har bir suhbatga beshta mustaqil kodlash ishga tushirishida qo‘llangan; ayni kodning besh ishga tushirishning kamida uchtasida uchrashi yakuniy baholashda saqlash mezoni sifatida ishlatilgan. Ushbu takroriy jarayonda suhbat bo‘yicha ishga tushirishlar orasidagi umumiy Jaccard o‘xshashligi 0,83 deb hisobot qilingan.
ChatGPT yaratgan yakuniy kod tizimi 3 ta asosiy kod va 14 ta quyi koddan iborat bo‘lgan bo‘lsa, insonga asoslangan sifatli kontent tahlili 3 ta asosiy kod va 20 ta quyi kodni o‘z ichiga oladi. SBERT asosidagi semantik taqqoslashda kosinus o‘xshashligi 0,60 yoki undan yuqori bo‘lgan 63 ta kod jufti aniqlangan. Hungarian Algorithm orqali tuzilgan bir-biriga moslashtirishda 14 ta nomzod moslikdan faqat bittasi 0,60 chegarasidan past qolgan va keyingi tahlillar 13 ta moslashtirilgan kod jufti bo‘yicha olib borilgan.
Biroq kodlarning ma’no jihatidan o‘xshashligi ayni suhbat bo‘laklari kodlanganini anglatmagan. Moslashtirilgan 13 ta kod jufti uchun global Jaccard indeksi atigi 0,39 bo‘lgan. Ayrim juftlarda kodlash birligi ustma-ust tushishi yuqori, ayrimlarida esa nol bo‘lgan. Masalan, “Material and textbook influence” bilan “Resources: Textbooks” orasida Jaccard 0,86 bo‘lgan bo‘lsa, “Diagnostic assessment” bilan “Outside the classroom” va “Knowledge deficits as breeding ground” bilan “Educational policy factors” juftlarida Jaccard 0 bo‘lgan.
Tarmoq tahlilida inson kontent tahlili tarmog‘ining zichligi 0,40 va global klasterlanish koeffitsiyenti 0,56; ChatGPT tarmog‘ining zichligi 0,36 va global klasterlanish koeffitsiyenti 0,61 deb topilgan. Bu global o‘lchovlar bir-biriga yaqin bo‘lsa ham, tugun markaziyliklari boshqacha tuzilmani ko‘rsatgan: inson tahlilida markaziylik kengroq kodlar to‘plamiga tarqalgan, ChatGPT tizimida esa bir nechta umumiy kodlar ustunroq bo‘lgan. Tadqiqotning asosiy talqini shuki, tuzilgan va iterativ promptlash LLM kodlashini barqarorlashtira oladi; biroq ushbu ma’lumotlar to‘plamida ChatGPT sohaga xos kontekst va nozik konseptual farqlarni inson kontent tahlilidek batafsil ifodalamagan.
Bu natijalar “ChatGPT sifatli tahlilda inson bilan bir xil natijani beradi” yoki “Jaccard 0,83 inson tahlili bilan %83 aniqlikni anglatadi” tarzida talqin qilinmasligi kerak. 0,83 qiymati ChatGPTning o‘z takroriy ishga tushirishlari orasidagi barqarorlikni o‘lchaydi. Inson–ChatGPT taqqoslashidagi global kodlash birligi ustma-ust tushishi esa 0,39. Bundan tashqari, tadqiqotchilar inson kod tizimini mutlaq obyektiv haqiqat sifatida emas, ayni materialning boshqa bir asosli analitik talqini sifatida ko‘radilar.
Tadqiqotning asosiy muammosi
Sifatli tadqiqotda kodlash uzun matn bo‘laklarini tadqiqot savollari bilan bog‘liq mazmunli kategoriyalarga aylantirish imkonini beradi. Bir suhbatda o‘qituvchilar aytganlari yuzlab alohida gap yoki parchalarni o‘z ichiga olishi mumkin. Tadqiqotchi ushbu materialda qaysi parchalar bir xil konseptual naqshga tegishli ekanini hal qiladi, kodlar yaratadi, o‘xshash kodlarni birlashtiradi va zarur bo‘lganda yuqoriroq kategoriyalar ishlab chiqadi.
Katta til modellari mavjud kod kitobini matnga qo‘llashi yoki katta matnlarda takrorlanadigan mavzularni aniqlashi mumkin. Ushbu tadqiqot e’tibor qaratgan murakkabroq muammo esa kodlar oldindan to‘liq berilmagan holatda LLM kod tizimining o‘zini qanday rivojlantirishidir. Boshqacha aytganda, tadqiqot faqat “ChatGPT to‘g‘ri yorliqni tanlayaptimi?” savoli bilan cheklanmaydi; model sifatli materialdan qaysi kategoriyalarni hosil qilishi, bu kategoriyalar inson yaratgan tizim bilan qanday mos kelishi va ayni matn dalillariga tayanib-tayanmasligi o‘rganiladi.
Tadqiqotda ikki xil tadqiqot savoli darajasi mavjud
Manbada bir-biridan ajratilishi kerak bo‘lgan ikki savol darajasi mavjud. Birinchi daraja asl suhbat ma’lumotlari to‘plamining mazmunini o‘rganuvchi savollardir: geografiya ta’limida stereotiplashtirish yuz beradimi, u qanday va nima uchun paydo bo‘ladi hamda o‘qituvchilar u bilan kurashish uchun qaysi strategiyalardan foydalanadi. Ikkinchi daraja esa ushbu maqolaning metodologik baholash savollaridir: ChatGPT kod tizimini inson kontent tahlili tizimiga semantik jihatdan moslashtirish mumkinmi, semantik jihatdan mos kodlar ayni kodlash birliklarini tanlaydimi va ikki kod tizimi tuzilmasi orasida tizimli farqlar bormi?
Bu farq muhim. Suhbatlar mavzusi stereotiplashtirishdir; ushbu maqolaning asl metodologik mavzusi esa ChatGPT yordamida yaratilgan induktiv kodlash tizimini insonga asoslangan kontent tahlili bilan taqqoslashdir.
Induktiv Kodlash Nima va Ushbu Tadqiqotda ChatGPT Qanday Ishlatilgan?
Induktiv kodlash — kategoriya va quyi kategoriyalarni oldindan to‘liq qat’iy belgilash o‘rniga, tahlil qilinayotgan sifatli materialdagi mazmunli naqshlardan rivojlantirish jarayonidir; ushbu tadqiqotda ChatGPT har bir suhbat uchun ma’lumotlarga asoslangan kod tizimini yaratgan, bu tizimlarni takroriy sintez bosqichlari orqali birlashtirgan va hosil bo‘lgan yakuniy kod tizimini suhbat transkriptlariga qayta qo‘llagan.
Insonga asoslangan kontent tahlili qanday bajarilgan?
Inson kontent tahlili Kuckartz va Rädikerning yetti bosqichli yondashuviga amal qilgan. Tadqiqotchilar avval suhbatlarni diqqat bilan o‘qigan, qaydlar va holat xulosalarini tayyorlagan; so‘ng 11 transkript bo‘yicha jami 86 ta kodlash birligini aniqlagan.
Birinchi bosqichda uchta asosiy kod ishlatilgan: stereotiplashtirish misollari, stereotiplashtirish sabablari va stereotiplashtirish bilan kurashish strategiyalari. Ushbu asosiy tuzilma ostida materialdan induktiv ravishda 20 ta quyi kod ishlab chiqilgan, kod tuzilmasi qayta ko‘rib chiqilgan va barcha material yakuniy kod tizimi bilan qayta kodlangan. Analitik strategiyalar tadqiqot savollariga muvofiq qo‘llangan va inson tahlili MAXQDA Analytics Pro 24.4.0 yordamida amalga oshirilgan.
ChatGPT kodlash jarayonining besh bosqichi
Bosqich I — Dastlabki ishlab chiqish: 11 ta suhbatning har biri alohida-alohida ChatGPTga berilgan va har bir transkript uchun alohida induktiv kod tizimi ishlab chiqilgan. Prompt modelning tadqiqotchi yordamchisi rolini, vazifani, tadqiqot savollarini, kodlash qoidalarini va chiqish formatini belgilagan. Bir vaqtning o‘zida faqat bitta transkriptdan foydalanish orqali uzun kontekst keltirib chiqarishi mumkin bo‘lgan qayta ishlash muammolarini kamaytirish maqsad qilingan.
Dastlabki sinovlarda ChatGPT tadqiqot savollaridan ko‘ra umumiyroq “stereotip nima?” turidagi yuqori darajali tavsiflovchi kodlarga yo‘nalishga moyillik ko‘rsatgani uchun prompt takomillashtirilgan. Shu tariqa kod ishlab chiqishni umumiy stereotip nazariyasidan ko‘ra suhbatlardagi tadqiqot savollariga yanada qattiq bog‘lash ko‘zlangan.
Bosqich II — O‘n bir tizimning sintezi: Har bir transkriptdan olingan 11 ta kod tizimi birgalikda taqqoslangan. Mazmun jihatidan o‘xshash kodlar birlashtirilgan, mavzuviy jihatdan asoslash mumkin bo‘lgan yuqori kodlar yaratilgan, ustma-ustliklar bartaraf etilgan va yangi tizimga faqat birinchi bosqichda haqiqatan ishlatilgan kodlarni kiritishga ruxsat berilgan.
Bosqich III — Sintezni takrorlash: LLM chiqishlari deterministik bo‘lmagani sababli sintez jarayoni besh marta mustaqil takrorlangan. Har bir sintez alohida suhbat sessiyasida bajarilgan va ushbu bosqichda xotira funksiyasi o‘chirilgani qayd etilgan. Maqsad bitta tasodifiy model chiqishiga bog‘lanib qolish o‘rniga qaysi kodlar takroriy hosil qilishda barqaror ekanini kuzatishdir.
Bosqich IV — Yakuniy sintez: Beshta sintez qilingan kod tizimi yana birlashtirilgan. Kodning yakuniy tizimga kiritilishi uchun u besh tizimning kamida uchtasida mavjud bo‘lishi talab qilingan. Ushbu “3/5” qoidasi kam uchraydigan va bir martalik model hosilalarining yakuniy kod tizimini belgilashini cheklagan.
Bosqich V — Transkriptlarni yakuniy kod tizimi bilan kodlash: Yakuniy kod tizimi keyin asl suhbat transkriptlariga qo‘llangan. Model faqat belgilangan kodlardan foydalanishi, kod ta’rifi chegarasidan chiqmasligi, yangi kod yaratmasligi, kod tayinlashini asoslab berishi va hech bir kod mos kelmasa buni ochiq ko‘rsatishi uchun qoidalar qo‘llanilgan.
Har bir transkript beshta mustaqil ishga tushirishda kodlangan. Yakuniy tahlilda kod tayinlanishini saqlash uchun u besh baholashning kamida uchtasida uchrashi talab qilingan. Ushbu ikkinchi 3/5 qoidasi kod tizimini yaratish bosqichidagi 3/5 qoidasidan farq qiladi: birinchisi qaysi kodlar yakuniy kod kitobiga kirishini, ikkinchisi esa qaysi kod tayinlashlar yakuniy baholashga olinishi kerakligini belgilaydi.
Ilovalardagi promptlar ilmiy jihatdan nega muhim?
Tadqiqotning A ilovasi faqat namunaviy prompt bermaydi; LLM yordamidagi kodlash jarayonini qayta kuzatish mumkin bo‘lishi uchun ishlatilgan prompt arxitekturasini hujjatlashtiradi.
A.1 ilova har bir transkript uchun kod tizimini ishlab chiquvchi dastlabki promptdir. Modeldan sifatli ta’lim tadqiqoti sohasida tadqiqotchi rolida harakat qilish, faqat transkriptdagi tegishli materialdan induktiv kategoriya yaratish, kategoriyalarni bir-biridan farqlash va kod nomi bilan izohini jadval shaklida berish so‘raladi.
A.2 ilova 11 ta alohida kod tizimini integratsiyalashgan tuzilmada birlashtirishga qaratilgan. Kodlarni faqat nomlariga ko‘ra emas, mazmuniga ko‘ra taqqoslash, o‘xshash kodlarni birlashtirish, yuqori kategoriyalarni faqat mavzuviy jihatdan asoslash mumkin bo‘lganda yaratish va asl tizimlarda hech ishlatilmagan kodni sintezga qo‘shmaslik shartlari mavjud.
A.3 ilova beshta takroriy sintezni yagona yakuniy kod tizimiga aylantiradi. Bu yerda asosiy tanlov qoidasi — kod besh tizimning kamida uchtasida mavjud bo‘lishi.
A.4 ilova yakuniy kod kitobini transkriptlarga qo‘llashni tartibga soladi. Model kod ta’riflaridan tashqariga chiqmasligi, qayta ifodalash orqali yangi ma’no yaratmasligi, yangi kod yaratmasligi, ayni kodlash birligida bir nechta kod bo‘lishiga ruxsat berishi, mos kod bo‘lmasa buni ko‘rsatishi va har bir tayinlashni kod ta’rifiga murojaat qilib asoslab berishi talab qilinadi.
Bu tafsilotlar muhim; chunki tadqiqot natijalari “ChatGPTga kodla deyilsa nima bo‘ladi?” kabi umumiy foydalanish natijasi emas. Natijalar ancha tuzilgan va takrorlar orqali barqarorlashtirishga urinilgan muayyan prompt protokoliga tegishli.
Kosinus O‘xshashligi va Jaccard Indeksi Nega Bir Xil Narsani O‘lchamaydi?
Kosinus o‘xshashligi ikki kod nomi va ta’rifining semantik jihatdan qanchalik yaqinligini o‘lchasa, Jaccard indeksi kodlar amalda qaysi kodlash birliklariga tayinlangani qay darajada ustma-ust tushishini o‘lchaydi; shuning uchun ikki kod ma’nosi juda o‘xshash bo‘lsa ham, suhbatlarda turli matn bo‘laklariga qo‘llanishi mumkin.
SBERT yordamida kodlarning semantik ifodasi
Har bir kod uchun kod nomi va kod ta’rifi bitta matnli ifoda sifatida birlashtirilgan. Ushbu matnlar Sentence-BERT (SBERT) yondashuvi bilan sonli vektorlarga aylantirilgan. Tadqiqotda oldindan o‘qitilgan paraphrase-multilingual-MiniLM-L12-v2 modeli ishlatilgan.
Embedding deb ataladigan bu vektorlar so‘zlarning faqat aynan mos kelishini emas, matn ma’nosining yaqinligini sonli fazoda ifodalash uchun ishlatiladi. Masalan, ikki kod turli so‘zlardan foydalansa ham o‘xshash ma’no bildirsa, bir-biriga yaqin vektorlarni hosil qilishi mumkin.
Kosinus o‘xshashligining matematik mantiqi
O‘quv izohi: Maqola kosinus o‘xshashligi tenglamasini alohida bosilgan tenglama sifatida bermaydi. Quyidagi ifoda tadqiqotda ishlatilgan metrikning standart matematik ta’rifidir; tadqiqotning yangi formulasi emas.
\[ \mathrm{cosine}(\mathbf{a},\mathbf{b}) = \frac{\mathbf{a}\cdot\mathbf{b}} {\|\mathbf{a}\|\,\|\mathbf{b}\|} \]
\(\mathbf{a}\) va \(\mathbf{b}\) — ikki kodning SBERT yordamida olingan embedding vektorlari. Suratdagi skalyar ko‘paytma ikki vektorning umumiy yo‘nalishini, maxrajdagi normalar ko‘paytmasi esa vektor kattaliklarini normallashtiradi. Shu tariqa taqqoslash asosan vektorlarning yo‘nalishiga, ya’ni semantik yaqinligiga tayanadi.
Bu metrik o‘lchovsiz. Tadqiqotda qiymat 1 ga yaqinlashgan sari konseptual ustma-ustlik kuchliroq deb qabul qilingan. Keyingi tahlil uchun 0,60 kosinus o‘xshashligi chegarasi ishlatilgan.
Hungarian Algorithm nega ishlatilgan?
Bitta ChatGPT kodini faqat o‘zining eng yuqori o‘xshashlik balliga ega inson kodi bilan mustaqil ravishda moslashtirish bir xil inson kodining bir nechta ChatGPT kodiga tayinlanishiga olib kelishi mumkin. Tadqiqot buning o‘rniga barcha mosliklarni birgalikda baholab, jami semantik o‘xshashlikni eng yuqori qiladigan bir-biriga tayinlash kombinatsiyasini izlagan.
O‘quv uchun standart ko‘rinish: Maqola quyidagi optimallashtirish tenglamasini aynan shu shaklda bermaydi; ifoda Hungarian tayinlash muammosining tadqiqotdagi qo‘llanishini tushuntirish uchun keltirilgan.
\[ \max \sum_i\sum_j s_{ij}x_{ij} \]
Bu yerda \(s_{ij}\) — ChatGPT kodi \(i\) bilan inson kontent tahlili kodi \(j\) orasidagi kosinus o‘xshashligi. \(x_{ij}=1\) bo‘lsa ikki kod moslashtirilgan, \(x_{ij}=0\) bo‘lsa moslashtirilmagan. Bir-birga moslashtirish sababli har bir kod ko‘pi bilan bitta qarshi kod bilan mos kelishi mumkin.
ChatGPT tizimida 14, inson tizimida 20 ta quyi kod bo‘lgani uchun Hungarian Algorithm ko‘pi bilan 14 ta bir-birga nomzod moslik yaratishi mumkin. Tadqiqotda 14 ta nomzod moslikdan bittasi 0,56 kosinus o‘xshashligi bilan 0,60 chegarasidan past qolgan, shu tariqa keyingi tahlillar 13 ta moslashtirilgan juft bo‘yicha o‘tkazilgan.
Jaccard indeksi nimani hisoblaydi?
O‘quv uchun standart ta’rif: Maqola Jaccard indeksini so‘z bilan ta’riflaydi; quyidagi tenglama ushbu ta’rifning standart matematik ifodasidir.
\[ J(A,B) = \frac{|A\cap B|} {|A\cup B|} \]
\(A\) — kod birinchi kodlash yondashuvi tomonidan tayinlangan kodlash birliklari; \(B\) — mos kod ikkinchi yondashuv tomonidan tayinlangan kodlash birliklari to‘plami. \(|A\cap B|\) har ikki yondashuv ham kodlagan umumiy birliklar sonini; \(|A\cup B|\) esa kamida bitta yondashuv kodlagan barcha birliklarni ko‘rsatadi.
\(J=1\) ikki to‘plam to‘liq bir xil ekanini; \(J=0\) esa umumiy hech bir kodlash birligi yo‘qligini anglatadi.
Tadqiqot Jaccard indeksidan ikki xil maqsadda foydalangan. Birinchisi — ayni transkript beshta ChatGPT ishga tushirishida qanchalik barqaror kodlanganini baholash. Ikkinchisi esa semantik jihatdan moslashtirilgan ChatGPT va inson kodlari ayni matn bo‘laklariga qo‘llanilganmi yoki yo‘qmi, shuni baholash. Ushbu ikki Jaccard natijasi bir xil ilmiy savolga javob bermaydi.
Tarmoq tahlili nimani qo‘shadi?
Semantik moslashtirish alohida kod juftlarini taqqoslasa, tarmoq tahlili butun kod tizimining tuzilmasini tekshiradi. Har bir kod tugun, ayni kodlash birligida birga uchragan ikki kod orasidagi bog‘lanish esa qirra sifatida belgilanadi. Qirra og‘irligi ikki kod nechta kodlash birligida birga uchrashiga bog‘liq.
Tarmoq zichligi kuzatilgan kod-kod bog‘lanishlari mumkin bo‘lgan bog‘lanishlarning qanchasini tashkil qilishini o‘lchaydi. Oddiy yo‘naltirilmagan tarmoq uchun standart o‘quv ifodasi quyidagicha:
\[ D=\frac{2E}{V(V-1)} \]
\(V\) — tugun, ya’ni kodlar soni; \(E\) — kuzatilgan bog‘lanishlar soni. Qiymat oshgani sari tarmoqdagi kodlarning o‘zaro bog‘langanlik ulushi ortadi. Bu formula tadqiqotning yangi formulasi emas; maqoladagi tarmoq zichligi tushunchasining standart izohidir.
Global klasterlanish koeffitsiyenti bir xil kodga bog‘langan kodlarning o‘zaro ham bog‘lanib klasterlar hosil qilish moyilligini baholaydi. Manba muayyan tenglama keltirmaydi; shu sababli Verianla bu yerda maqolada bo‘lmagan aniq qo‘llash formulasini faraz qilmaydi.
Xos vektor markaziyligi (eigenvector centrality, EV-centrality) faqat kodning nechta bog‘lanishi borligiga emas, balki u bog‘langan boshqa kodlarning qanchalik markaziy ekaniga ham ahamiyat beradi. Standart xos vektor munosabati o‘quv maqsadida:
\[ x_i = \frac{1}{\lambda} \sum_j A_{ij}x_j \]
shaklida ko‘rsatilishi mumkin. \(x_i\) — kod \(i\) ning markaziyligi; \(A_{ij}\) — tarmoq bog‘lanish matritsasi; \(\lambda\) esa tegishli xos qiymat. Markaziy kodlar bilan bog‘langan tugunlar yuqoriroq EV-markaziylik oladi.
Fruchterman–Reingold joylashuvi statistik natija emas
Tarmoq vizuallarida tugunlarning ekrandagi joylari Fruchterman–Reingold algoritmi bilan belgilanadi. Algoritm kuchli bog‘langan tugunlarni vizual ravishda bir-biriga yaqinlashtirib, tarmoqni o‘qishni osonlashtiradi. Tugunning rasmda o‘ngda, chapda, yuqorida yoki pastda joylashishi o‘z-o‘zicha ilmiy o‘lchov emas; ilmiy o‘lchovlar bog‘lanishlar, qirra og‘irliklari va markaziylik qiymatlaridir.
Curveball null modeli nega kerak?
Ikki tarmoqning zichlik yoki klasterlanish qiymatlari faqat mavjud kod chastotalari tufayli yuzaga kelgan-kelmaganini baholash uchun alohida null modellar yaratilgan. Curveball algoritmi kodlash birligi × kod ikkilik matritsasini tasodifiylashtirar ekan, ikki muhim xususiyatni saqlagan: har bir kodlash birligiga tayinlangan jami kodlar soni va har bir kodning butun ma’lumotlar to‘plamidagi umumiy uchrash chastotasi.
Har bir kod tizimi uchun 10.000 ta tasodifiylashtirilgan ikkilik matritsa yaratilgan, ulardan kod birga-uchrash tarmoqlari qayta qurilgan va zichlik hamda global klasterlanish uchun null taqsimotlari olingan.
Standartlashtirilgan taqqoslashning o‘quv shakli:
\[ z = \frac{T_{\mathrm{obs}}-\mu_{\mathrm{null}}} {\sigma_{\mathrm{null}}} \]
deb qaralishi mumkin. \(T_{\mathrm{obs}}\) — kuzatilgan tarmoq metrigi, \(\mu_{\mathrm{null}}\) — tasodifiy null taqsimotining o‘rtachasi va \(\sigma_{\mathrm{null}}\) — null taqsimotining standart og‘ishi. Manba shuningdek ikki tomonlama Monte Carlo p-qiymatlari va %95 null oraliqlari hisoblanganini bildiradi. Asosiy natijalar matnida %95 null oraliqlarining sonli chegaralari berilmagani uchun Verianla bu chegaralarni yaratmaydi.
Yuqori Semantik O‘xshashlik Ayni Matn Bo‘laklari Kodlanganini Ko‘rsatadimi?
Yo‘q. Ushbu tadqiqotda ayrim kod juftlarining kosinus o‘xshashligi yuqori bo‘lsa ham Jaccard ustma-ustligi juda past bo‘lib qolgan; masalan, “Perspective shift and irritation” bilan “Teaching methods” semantik jihatdan taxminan 0,78 o‘xshashlik ko‘rsatganiga qaramay, kodlash birligi ustma-ustligi atigi 0,10 bo‘lgan.
Bu farq tadqiqotning eng muhim topilmalaridan biridir. Kod nomlari va ta’riflari o‘xshash konseptual ma’noga ega bo‘lishi mumkin; biroq ikki kodlash tizimi ushbu tushunchani suhbatning turli qismlarida, turli kenglikda yoki turli kontekstual mezonlar bilan qo‘llashi mumkin.
Mualliflar talqiniga ko‘ra, buning muhim sabablaridan biri kod granulyarligidir. ChatGPT kengroq tushunchalarni bitta kod ostida birlashtirishga moyil bo‘lsa, inson kontent tahlili ayni konseptual sohani yanada nozik quyi kodlarga ajratgan. Shu tariqa ChatGPTning keng kodiga kirgan matn bo‘laklarining faqat bir qismi Hungarian Algorithm orqali moslashtirilgan torroq inson kodiga tushishi mumkin.
Kod granulyarligi nimani anglatadi?
Granulyarlik kod tizimi konseptual farqlarni qanchalik nozik yoki keng ushlashini anglatadi. Masalan, ChatGPT tizimi “Spatial and developmental stereotypes” nomi bilan keng kategoriya yaratgan bo‘lsa, inson kontent tahlili fazoviy stereotiplarni “Continents”, “Countries” va “Country groups” kabi alohida kodlarga ko‘proq ajratgan.
Ikki yondashuv ayni umumiy hodisani tanishi mumkin; biroq biri uni bitta keng qutiga, ikkinchisi uchta alohida qutiga joylasa, kod nomlari orasida yuqori semantik o‘xshashlik bo‘lishiga qaramay, qaysi parchalar birma-bir mos kelishi pastroq chiqishi mumkin.
Tadqiqot Usuli va Natijalari
Ma’lumotlar to‘plami va ma’lumotlarni tayyorlash
| Xususiyat | Manbada berilgan ma’lumot |
|---|---|
| Suhbatlar soni | 11 anonim yarim tuzilgan onlayn suhbat |
| Ishtirokchilar | Nemis geografiya o‘qituvchilari |
| Amaldagi o‘qituvchi | n = 9 |
| O‘qituvchi nomzodi | n = 2 |
| Suhbat mavzusi | Geografiya darsida stereotiplashtirish |
| Transkripsiya | noScribe 0.4.1 va undan keyin ikki bosqich qo‘lda tuzatish |
| Inson tahlilidagi kodlash birligi | 86 |
| Inson tahlili dasturi | MAXQDA Analytics Pro 24.4.0 |
| ChatGPT tizimi | ChatGPT-5.2, 11 dekabr 2025 snapshot — manbada ishlatilgan nomlanish |
| Kodlash tili | Nemis tili |
| Yakuniy ChatGPT kod tizimi tarjimasi | DeepL bilan ingliz tiliga, 8 iyun 2026 |
Inson kontent tahlilidagi 20 quyi kod
| Asosiy kod | Quyi kod | n |
|---|---|---|
| Stereotiplashtirish misollari | Continents | 4 |
| Stereotiplashtirish misollari | Country groups | 3 |
| Stereotiplashtirish misollari | Students' background | 7 |
| Stereotiplashtirish misollari | Countries | 8 |
| Stereotiplashtirish misollari | Subject content | 13 |
| Stereotiplashtirish sabablari | Teachers (causes) | 2 |
| Stereotiplashtirish sabablari | Educational policy factors | 2 |
| Stereotiplashtirish sabablari | Geography-specific factors | 7 |
| Stereotiplashtirish sabablari | Students (causes) | 8 |
| Stereotiplashtirish sabablari | Sociocultural influences | 5 |
| Stereotiplashtirish sabablari | Resources: Textbooks | 6 |
| Stereotiplashtirish bilan kurashish strategiyalari | Perspective shift | 6 |
| Stereotiplashtirish bilan kurashish strategiyalari | Causal analysis | 3 |
| Stereotiplashtirish bilan kurashish strategiyalari | Student-oriented strategies | 4 |
| Stereotiplashtirish bilan kurashish strategiyalari | Teachers (strategies) | 3 |
| Stereotiplashtirish bilan kurashish strategiyalari | Teaching methods | 6 |
| Stereotiplashtirish bilan kurashish strategiyalari | Outside the classroom | 2 |
| Stereotiplashtirish bilan kurashish strategiyalari | Dialogue and reflection | 7 |
| Stereotiplashtirish bilan kurashish strategiyalari | Increasing complexity | 5 |
| Stereotiplashtirish bilan kurashish strategiyalari | Evidence-based working | 5 |
Manbadagi A1 qo‘shimcha jadvalida strategiya quyi kodlarining raqamlanishi 3.8 dan bevosita 3.10 ga o‘tadi; 3.9 kodi ko‘rsatilmagan. Shunga qaramay, jadval jami 20 ta quyi kodni hisobot qiladi. Verianla yetishmayotgan raqam qaysi kodga tegishli ekanini taxmin qilmaydi.
A1 qo‘shimcha jadvalidagi jami kod uchrashlari soni 106. Bu son 86 ta kodlash birligidan katta bo‘lishi mumkin; chunki bitta kodlash birligiga bir nechta turli kod tayinlanishi mumkin. Ushbu maqoladagi taqqoslashni ChatGPT kodlashiga ko‘proq moslashtirish uchun bir xil kodning bir kodlash birligi ichidagi takrorlari ko‘pi bilan 1 deb hisoblangan.
ChatGPT yaratgan yakuniy kod tizimi
| Asosiy kod | Quyi kod | Kod qamrab olgan asosiy g‘oya |
|---|---|---|
| Manifestations | Spatial and developmental stereotypes | Hudud va jamiyatlarni bir xil, qoloq yoki bir yoqlama rivojlanganlik tasvirlari orqali ifodalash |
| Manifestations | Problem and deficit focus | Hududlarni asosan inqiroz, qashshoqlik, mojaro yoki yetishmovchilik orqali taqdim etish |
| Manifestations | Social and origin stereotypes | Etnik kelib chiqish, millat, ijtimoiy fon yoki qobiliyat bo‘yicha umumlashtiruvchi nisbatlar berish |
| Manifestations | Migration and religion | Migratsiya va din kabi murakkab sohalarni oz sonli xususiyat yoki sababga qisqartirish |
| Conditions of emergence | Didactic reduction and time pressure | Dars vaqti va didaktik soddalashtirish ortiqcha umumlashtirishlarni osonlashtirishi mumkinligi |
| Conditions of emergence | Material and textbook influence | Darslik, vizual, karikatura yoki o‘quv dasturidagi tasvirlar stereotiplarni qayta ishlab chiqarishi mumkinligi |
| Conditions of emergence | Knowledge deficits as a breeding ground | Yetarli soha bilimining yo‘qligi murakkab aloqalar o‘rniga sodda tushuntirish sxemalariga olib kelishi mumkinligi |
| Conditions of emergence | Eurocentrism | Yevropaga markazlangan mezonlarni boshqa hududlarni baholashda norma sifatida ishlatish |
| Pedagogical strategies | Diagnostic assessment | Dars boshida o‘quvchilarning mavjud fikr va tasavvurlarini aniqlash |
| Pedagogical strategies | Dialogue-based reflection and intervention | Umumlashtiruvchi ifodalarni savol ostiga qo‘yish, muhokama qilish va muqobil istiqbollarni taqdim etish |
| Pedagogical strategies | Perspective shift and irritation | Rol o‘ynash yoki odatiy qarashni buzuvchi usullar bilan fikriy istiqbol o‘zgarishini qo‘zg‘atish |
| Pedagogical strategies | Work with data and contextualization | Da’volarni ma’lumot va kengroq kontekstdan foydalanib sinash |
| Pedagogical strategies | Making diversity and differentiation visible | Mamlakat, hudud va guruhlarning ichki xilma-xilligini ko‘rinadigan qilish |
| Pedagogical strategies | Professional self-reflection | O‘qituvchining o‘z fikrlash qoliplari va ehtimoliy stereotiplari haqida tanqidiy mulohaza yuritishi |
Beshta sintez ishga tushirishidagi kodlar soni
Beshta alohida sintez bir xil miqdorda quyi kod yaratmagan. Trial 1 va Trial 5 da 16, Trial 2 da 18, Trial 3 da 24 va Trial 4 da 20 ta quyi kod hosil bo‘lgan. Trial 4 shuningdek faqat shu ishga tushirishda ko‘ringan “Perception and Evaluation” nomli yuqori darajali kodni yaratgan. Kod faqat bitta sintezda ko‘ringani uchun yakuniy 3/5 tanlov qoidasidan o‘ta olmagan.
Yakuniy kodlashning ishga tushirishdan ishga tushirishga barqarorligi
| Transkript | Jaccard |
|---|---|
| 1 | 0,88 |
| 2 | 0,77 |
| 3 | 0,79 |
| 4 | 0,84 |
| 5 | 0,91 |
| 6 | 0,91 |
| 7 | 0,83 |
| 8 | 0,78 |
| 9 | 0,86 |
| 10 | 0,87 |
| 11 | 0,66 |
| Umumiy | 0,83 |
Ishga tushirishlar orasidagi eng yuqori Jaccard 5- va 6-transkriptlarda 0,91; eng past qiymat 11-transkriptda 0,66. Umumiy qiymat 0,83.
Ushbu jadval ma’nosi alohida cheklanishi kerak: 0,83 ChatGPT inson kodlashiga %83 mos keladi yoki %83 to‘g‘ri degani emas. Bu o‘lchov faqat ayni ChatGPT protokoli mustaqil takrorlarda qanchalik o‘xshash kod tayinlashlarini bergani bilan bog‘liq.
SBERT issiqlik xaritasining asosiy xabari
Manba issiqlik xaritasida jami 63 ta kod juftining kosinus o‘xshashligi 0,60 yoki undan yuqori topilgan. “Professional self-reflection”, “Didactic reduction and time pressure”, “Working with data and contextualization” va “Perspective shift” kabi ChatGPT kodlari inson kodlari bilan 0,70 dan yuqori o‘xshashliklarni ko‘rsatgan.
Aksincha, “Migration and religion” hamda “Problem and deficit focus” kabi kodlarning inson tizimidagi eng yaqin muqobillari nisbatan zaifroq semantik o‘xshashlik ko‘rsatgan.
Manba issiqlik xaritasidagi barcha kataklarning aniq sonli qiymatlarini jadval ko‘rinishida e’lon qilmaydi. Shu sababli Verianla ranglardan taxminiy raqamlar chiqarib yangi sonli matritsa yaratmaydi.
Hungarian Algorithm bilan bir-birga moslashtirish natijalari
| No. | ChatGPT kodi | Inson kontent tahlili kodi | Kosinus o‘xshashligi |
|---|---|---|---|
| 1 | Dialogue-based reflection and intervention | Dialogue and reflection | 0,81 |
| 2 | Perspective shift and irritation | Teaching methods | 0,78 |
| 3 | Making diversity and differentiation visible | Increasing complexity | 0,77 |
| 4 | Professional self-reflection | Teachers (strategies) | 0,77 |
| 5 | Diagnostic assessment | Outside the classroom | 0,73 |
| 6 | Work with data and contextualization | Evidence-based learning | 0,72 |
| 7 | Knowledge deficits as breeding ground | Educational policy factors | 0,71 |
| 8 | Spatial and developmental stereotypes | Continents | 0,69 |
| 9 | Social and origin stereotypes | Students' background | 0,66 |
| 10 | Didactic reduction and time pressure | Geography-specific factors | 0,65 |
| 11 | Material and textbook influence | Resources: Textbooks | 0,63 |
| 12 | Migration and religion | Sociocultural influences | 0,61 |
| 13 | Eurocentrism | Perspective shift | 0,60 |
| 14 | Problem and deficit focus | Country groups | 0,56 — chegaradan past |
Oxirgi moslik 0,60 chegarasidan past bo‘lgani uchun keyingi kodlash-birligi Jaccard taqqoslashiga kiritilmagan.
Inson kontent tahlili ChatGPT tizimidan olti kod ko‘p bo‘lgani sababli to‘liq 14 talik bir-birga tayinlashda oltita inson kodi moslashtirilmay qolgan: Subject content, Countries, Teachers (causes), Students (causes), Causal analysis va Student-oriented strategies.
Ushbu olti kodning tabiati tadqiqot talqinida muhim. Ularning katta qismi geografiyaga xos mazmun, sinfdagi aniq ishtirokchilar yoki nozikroq strategiya farqlaridir. Mualliflar buni ChatGPT tizimi keng va umumlashtiriladigan naqshlarni ushlash bilan birga, sohaga xos va aktorga xos farqlarni kamroq tafsilot bilan ifodalagani haqidagi topilma bilan bog‘laydilar.
Semantik moslashtirishdan keyingi haqiqiy kodlash birligi ustma-ustligi
| ChatGPT kodi | Inson kodi | Jaccard |
|---|---|---|
| Dialogue-based reflection and intervention | Dialogue and reflection | 0,66 |
| Perspective shift and irritation | Teaching methods | 0,10 |
| Making diversity and differentiation visible | Increasing complexity | 0,66 |
| Professional self-reflection | Teachers (strategies) | 0,75 |
| Diagnostic assessment | Outside the classroom | 0 |
| Working with data and contextualization | Evidence-based working | 0,80 |
| Knowledge deficits as breeding ground | Educational policy factors | 0 |
| Spatial and developmental stereotypes | Continents | 0,33 |
| Social and origin stereotypes | Students' background | 0,38 |
| Complexity reduction and time pressure | Geography-specific factors | 0,33 |
| Material and textbook influence | Resources: Textbooks | 0,86 |
| Eurocentrism | Perspective shift | 0,14 |
| Migration and religion | Sociocultural influences | 0 |
| Global Jaccard | 13 ta moslashtirilgan juftning umumiy natijasi | 0,39 |
Beshta kod juftida Jaccard 0,60 dan yuqori. Eng yuqori qiymat “Material and textbook influence” bilan “Resources: Textbooks” orasida 0,86. Aksincha, uchta moslikda Jaccard nol.
Manbaning natijalar matni past-o‘rta guruhni taxminan 0,30–0,40 deb ta’riflaydi. Manba shuningdek qolgan besh juft uchun “J<0,14” ifodasini ishlatadi; biroq 7-jadvalda Eurocentrism–Perspective shift qiymati aynan 0,14. Verianla jadval qiymatini o‘zgartirmaydi.
Muhokama bo‘limida yuqori kelishuv oralig‘i bir joyda 0,66–0,89 deb yozilgan; holbuki 7-jadvalda kuzatilgan eng yuqori qiymat 0,86. Shu sababli Verianla aniq miqdoriy qiymatlar uchun 7-jadvaldagi 0,86 ni ishlatadi.
Nega 0,78 semantik o‘xshashlik 0,10 Jaccard bilan birga uchrashi mumkin?
“Perspective shift and irritation” bilan “Teaching methods” konseptual ta’riflari bir-biriga ancha yaqin bo‘lgani uchun kosinus o‘xshashligi 0,78. Biroq inson va ChatGPT tizimlari ushbu tushunchalarni ayni suhbat parchalariga juda kam qo‘llagan va Jaccard atigi 0,10 bo‘lgan.
Aksincha, “Dialogue-based reflection and intervention” bilan “Dialogue and reflection” semantik darajada 0,81 kabi yuqori o‘xshashlikka hamda kodlash birliklarida 0,66 Jaccard ustma-ustligiga ega. Demak, tadqiqotda semantik yaqinlik va matndagi qo‘llanish ustma-ustligi o‘rtasida majburiy bir-bir munosabat yo‘q.
Tarmoq Zichligi O‘xshash Bo‘lsa, Ikki Kod Tizimi Tuzilmaviy Jihatdan Bir Xilmi?
Yo‘q. Inson va ChatGPT tarmoqlarining umumiy zichlik hamda klasterlanish qiymatlari bir-biriga yaqin bo‘lsa ham, xos vektor markaziyligining kodlar orasidagi taqsimoti turlicha; inson tizimida tuzilmaviy ahamiyat ko‘proq kodlarga tarqaladi, ChatGPT tizimida esa bir nechta keng kod markazda jamlangan.
| Metrik | Inson kontent tahlili | ChatGPT |
|---|---|---|
| Tarmoq zichligi | 0,40 | 0,36 |
| Zichlik uchun z | −0,60 | −1,66 |
| Zichlik uchun p | 0,611 | 0,154 |
| Global klasterlanish koeffitsiyenti | 0,56 | 0,61 |
| Klasterlanish uchun z | 0,34 | 1,19 |
| Klasterlanish uchun p | 0,683 | 0,239 |
Mualliflar talqiniga ko‘ra, har ikki tarmoqning zichlik va global klasterlanish qiymatlari o‘z null modellaridan sezilarli darajada farq qilmagan. Manba metod bo‘limida %95 null oraliqlari ham hisoblanganini bildiradi, biroq asosiy natijalarda ushbu oraliqlarning sonli pastki va yuqori chegaralarini bermaydi.
Manba ushbu tarmoq taqqoslash uchun alohida alfa chegarasini ochiq yozmaydi; shu sababli Verianla manbada yo‘q ahamiyatlilik chegarasini qo‘shmaydi. Mualliflarning o‘z natija talqini hisobot qilingan p-qiymatlar asosida global zichlik va klasterlanish null kutilmadan oshmaganini bildiradi.
Xos vektor markaziyligi boshqa manzarani ko‘rsatadi
Inson kontent tahlili tarmog‘ida eng markaziy kod Subject content, EV = 1,00, ikkinchi eng markaziy kod Continents, EV = 0,71. Manba shuningdek Students (causes), Resources: Textbooks va Teaching methods kodlari ham nisbatan yuqori markaziylik ko‘rsatganini bildiradi.
ChatGPT tarmog‘ida esa Spatial and developmental stereotypes, EV = 1,00; Problem and deficit focus, EV = 0,91 va Material and textbook influence, EV = 0,90 qiymatlari bilan bir nechta kod aniq ravishda markazda jamlangan.
Null-model natijalari nimani anglatadi?
Global tarmoq zichligi va klasterlanish uchun null-model p-qiymatlarining yuqori bo‘lishi kuzatilgan global bog‘langanlik va klasterlanish faqat kod chastotalari va kodlash birligiga to‘g‘ri keladigan kod sonlari saqlangan holda yaratilgan tasodifiy tarmoqlardan aniq farq qilmasligini ko‘rsatadi.
Biroq bu natija “ikki tarmoq bir xil” degani emas. Global ikki raqam o‘xshash bo‘lsa ham, qaysi kodlar markazda ekani, qaysi tushunchalar o‘zaro bog‘lanishi va tuzilmaviy ahamiyat kodlar orasida qanday taqsimlanishi farq qilishi mumkin. Tadqiqotning EV-markaziylik topilmasi aynan shu lokalroq tuzilmaviy farqni ko‘rsatadi.
Sifatli baholash: tuzilmaviy tarkib
ChatGPT yaratgan tizim talab qilingan jadval formatini va uchta asosiy konseptual sohani katta darajada saqlagan. 13 ta semantik moslikning 11 tasida kodlar bir xil umumiy asosiy mavzu darajasida mos kelgan: stereotip misollari ChatGPTning manifestations sohasiga, sabablar conditions of emergence sohasiga va strategiyalar pedagogical strategies sohasiga mos kelgan.
Ikki moslik asosiy mavzu darajasidan oshib ketgan: Migration and religion bilan Sociocultural influences; Eurocentrism bilan Perspective shift. Mualliflar buni Hungarian Algorithmning bir-bir moslashtirish majburiyatining ehtimoliy yon ta’siri bo‘lishi mumkinligini ta’kidlaydilar. Chunki algoritm jami o‘xshashlikni global tarzda maksimal qilarkan, har bir kodga faqat bitta moslik berishga ruxsat beradi; ayrim kodlarning eng tabiiy sheriklari oldin boshqa mosliklarga ajratilgan bo‘lishi mumkin.
Sifatli baholash: granulyarlik va sohaga xoslik
Inson kontent tahlili ChatGPTdan oltita ko‘proq quyi kategoriya yaratgan. Ayniqsa inson tizimidagi Subject content kodining ChatGPT tizimida muqobili yo‘qligi e’tiborga loyiq; chunki Subject content inson tarmog‘ining eng tez-tez uchraydigan kodlaridan biri va EV = 1,00 bilan eng markaziy tugundir.
Inson tizimi Continents, Countries va Country groups kabi nozikroq fazoviy farqlarni ajratgan, ChatGPT esa ularni kengroq Spatial and developmental stereotypes kategoriyasi ostida birlashtirgan.
Mualliflar bahosiga ko‘ra, ChatGPT kuchli takrorlanuvchi umumiy naqshlarni aniqlay oladi; biroq ushbu ma’lumotlar to‘plamida geografiya ta’limiga xos farqlar kamroq aniq ifodalangan.
Sifatli baholash: sabablarni tushuntirishdagi aktorlar
Inson kontent tahlilida stereotiplashtirish sabablari o‘qituvchilar, o‘quvchilar, ijtimoiy fon, fan mavzusining tuzilishi, darsliklar va ta’lim siyosati kabi turli aktor va tuzilmaviy darajalarga ajratilgan.
ChatGPT tizimida esa sabablar ko‘proq tuzilmaviy shartlarga qaratilgan; o‘qituvchi va o‘quvchi kabi sinfning asosiy aktorlari alohida sabab kategoriyalari sifatida inson tizimidagidek aniq ifodalanmagan.
Xususan, Students (causes) inson tarmog‘ida tuzilmaviy jihatdan muhim kod; ChatGPTda o‘quvchi o‘lchami asosan Knowledge deficits as a breeding ground ichida cheklanganroq ko‘rinishda namoyon bo‘ladi. Shu sababli tadqiqot inson tahlili mazkur tadqiqot savoli nuqtai nazaridan ko‘proq differensiallashgan aktor tuzilmasini taklif qiladi, deb hisoblaydi.
Har ikki tizimda umumiy bo‘lgan yuqoriroq darajadagi naqsh
Har ikki tarmoqda ham stereotiplashtirish misollari va sabablari bilan bog‘liq kodlar ko‘proq markaziy o‘rinlarda bo‘lishga moyil. Pedagogik strategiya kodlari esa umuman olganda pastroq markaziylik va kamroq bog‘lanishni ko‘rsatadi.
Bu topilma har ikki tahlil yondashuvi ma’lumotlar to‘plamida “hodisa nima va nega yuz beradi?” savollarini “qanday aralashuv qilinadi?” savoliga qaraganda tuzilmaviy jihatdan markaziyroq ifodalashini ko‘rsatadi. Bu manba mualliflarining tarmoq tuzilmasidan chiqargan talqini; sababiy mexanizm dalili emas.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
- Tuzilgan, iterativ promptlash sharoitida ChatGPT takrorlar orasida nisbatan barqaror kodlash tizimini hosil qila olgan.
- Beshta mustaqil kodlash ishga tushirishida umumiy run-to-run Jaccard 0,83.
- ChatGPT va inson kod tizimlari o‘rtasida ko‘plab o‘rta-yuqori semantik o‘xshashliklar topilgan.
- 0,60 chegarasidan yuqori 13 ta bir-bir kod mosligi keyingi taqqoslashga kiritilgan.
- Semantik jihatdan o‘xshash kodlar ayni matn bo‘laklarini kodlashi kafolatlanmaydi; global Jaccard 0,39.
- ChatGPT tizimi kengroq kod kategoriyalariga yo‘nalgan, inson kontent tahlili esa nozikroq va sohaga xos farqlarni ishlab chiqqan.
- Ikki tarmoqning global zichligi va klasterlanishi o‘xshash ko‘rinsa-da, markaziylik taqsimotlari turlicha.
- Ushbu ma’lumotlar to‘plamida ChatGPT tarmog‘ining tuzilmaviy ahamiyati kamroq sonli ustun kodlarda jamlangan.
- Inson kontent tahlilida geografiyaga xos va aktorga xos tushunchalar ko‘proq ko‘rinadi.
- LLM chiqishlarini tanqidiy inson tekshiruvidan o‘tkazish tadqiqot tomonidan zarur deb hisoblanadi.
Tadqiqot qo‘llab-quvvatlamaydigan xulosalar
- ChatGPT barcha sifatli tadqiqotlarda inson kodlashiga teng degan xulosa chiqarib bo‘lmaydi.
- Jaccard 0,83 inson kodlashiga nisbatan %83 aniqlikni anglatmaydi.
- Kosinus o‘xshashligining yuqori bo‘lishi ayni matn parchalarining kodlanganini isbotlamaydi.
- Global tarmoq zichligining yaqin bo‘lishi ikki kod tizimining konseptual tuzilmasi bir xil ekanini ko‘rsatmaydi.
- Inson kontent tahlili ushbu tadqiqotda obyektiv va yagona mumkin bo‘lgan “ground truth” sifatida belgilanmagan.
- 11 suhbatdan olingan natijalarni barcha fanlar, barcha LLMlar yoki barcha sifatli ma’lumot turlariga umumlashtirib bo‘lmaydi.
- Natijalar umumiy va tuzilmagan ChatGPT foydalanishini emas, tadqiqotdagi batafsil va iterativ prompt protokolini ifodalaydi.
- Tadqiqot LLM kod kategoriyalarini ichkarida qaysi kognitiv yoki algoritmik mexanizm orqali yaratishini tushuntirmaydi.
LLMning “qora quti” muammosi
Inson sifatli tahlilida tadqiqotchi qaysi kodlash birliklarini taqqoslaganini, kodni nima uchun bo‘lganini yoki ikki kodni qaysi konseptual asos bilan birlashtirganini bosqichma-bosqich hujjatlashtira oladi. LLM ichki qayta ishlashida esa keng kategoriyalar inson tahlilidagidek iterativ konseptual abstraksiyalash orqali yoki boshqa statistik naqsh tanish mexanizmi orqali hosil bo‘ladimi, buni bevosita kuzatish mumkin emas.
Shu sababli tadqiqot ikki tizim orasida semantik yaqinlik mavjud bo‘lsa ham, ayrim kodlash birliklari nima uchun juda boshqacha tanlanganini to‘liq tushuntira olmaydi. Kod granulyarligi buning bir qismini tushuntirishi mumkin; biroq mualliflar bu butun farqni tushuntirmasligini qayd etadilar.
Prompt sezgirligi
LLM chiqishi ishlatilgan prompt tuzilmasiga sezgir. Ushbu tadqiqotda promptlar rol ta’rifi, ko‘rsatma, kontekst, takrorlash, sintez va tadqiqot savollariga yo‘naltirish kabi elementlar bilan iterativ ravishda takomillashtirilgan.
Shuning uchun natijalarni “ChatGPTning tabiiy va o‘zgarmas kodlash xatti-harakati” sifatida talqin qilish to‘g‘ri emas. Turli prompt tuzilmalari boshqa kod tizimlarini hosil qilishi mumkin. Tadqiqot buni kelajak tadqiqotlar uchun ochiq o‘rganish sohasi sifatida qoldiradi.
Asosiy cheklovlar
Kichik va mavzuga xos ma’lumotlar to‘plami: Tadqiqot faqat 11 ta suhbatga va geografiya darsida stereotiplashtirish kabi talqin jihatidan sezgir yagona mavzuga asoslangan. Kattaroq va turli fanlardagi ma’lumotlar to‘plamida ayni naqshlar yuzaga keladimi yoki yo‘qmi noma’lum.
Prompt sezgirligi: Batafsil va takroriy prompt muhandisligi ishlatilgan bo‘lsa ham, muqobil promptlar turli kategoriya tuzilmalarini hosil qilishi mumkin.
Moslashtirish usuliga bog‘liqlik: Hungarian Algorithm qayta ishlab chiqariladigan bir-bir moslashtirishni ta’minlaydi; biroq boshqa moslashtirish usullari boshqa kod juftlarini qarama-qarshi qo‘yishi va taqqoslash natijalarini ma’lum darajada o‘zgartirishi mumkin.
Sifatli tahlilning talqinli tabiati: Ayni materialdan bir nechta ilmiy jihatdan himoya qilinadigan kod tizimlari kelib chiqishi mumkin. Shu sababli inson tizimi bilan ChatGPT tizimi orasidagi farqning o‘zi “ChatGPT xatosi” deb talqin qilinmasligi kerak.
LLM ichki jarayonini kuzatib bo‘lmasligi: Tadqiqot modelning kategoriya sintezlash jarayonini ichkaridan kuzata olmaydi. Kodlar qaysi oraliq qarorlar zanjiri orqali keng yoki tor holga kelgani to‘liq tushuntirilmaydi.
Sohaga xos kontekst: Ushbu ma’lumotlar to‘plamida inson tizimi geografiya ta’limi bilan bevosita bog‘liq nozikroq kodlarni hosil qilgan. Bu barcha sohalarda aynan shunday yuz berishi tadqiqotda sinovdan o‘tkazilmagan.
Manba va Usul Haqida Izoh
Asl sarlavha: Evaluation of Inductive Coding with LLMs
Mualliflar: Leoni Dörfel, Rieke Ammoneit.
Mualliflar tartibi: Manbadagi tartib aynan saqlangan.
Teng hissa: Manbada teng birinchi mualliflik yoki teng hissa bayonoti yo‘q.
Mas’ul muallif: Leoni Dörfel.
Muassasa: Department for Mathematics and Science Education, Institute for Geography Education, University of Cologne, Gronewaldstraße 2, 50931 Cologne, Germany.
Jurnal: Education Sciences.
Nashriyot: MDPI.
Jild / son / maqola raqami: 16(8), 1314.
DOI: 10.3390/educsci16081314.
Rasmiy DOI havolasi: https://doi.org/10.3390/educsci16081314
Topshirilgan: 14 iyul 2026.
Qayta ko‘rib chiqilgan: 7 avgust 2026.
Qabul qilingan: 13 avgust 2026.
Nashr qilingan: 17 avgust 2026.
Manba turi: Taqrizdan o‘tgan tadqiqot maqolasi. Metodologik jihatdan sifatli kontent tahlili, LLM yordamidagi induktiv kodlash, NLP asosidagi semantik tahlil, kodlash-birligi ustma-ustlik tahlili, tarmoq tahlili va sifatli taqqoslashni birlashtiradigan aralash usulli metodologik baholashdir.
Litsenziya: Creative Commons Attribution (CC BY).
Moliyalashtirish: Tadqiqot tashqi moliyalashtirish olmagan.
Institutsional etika bayonoti: Tadqiqot avval to‘plangan, to‘liq anonimlashtirilgan suhbat transkriptlarini qayta tahlil qiladi. Manba joriy tahlilda shaxsni aniqlovchi ma’lumot yo‘qligi va qayta identifikatsiya qilish mumkin emasligini bildiradi.
Xabardor rozilik: Dastlabki suhbatlarda qatnashgan barcha ishtirokchilardan xabardor rozilik olingan.
Ma’lumotlar mavjudligi: Ma’lumotlar, R skriptlari va tahlillarning xom ma’lumotlari Zenododa e’lon qilingan. Ma’lumot DOI: 10.5281/zenodo.21108082.
Sun’iy intellektdan foydalanish bayonoti: Mualliflar tadqiqot davomida sifatli kodlash chiqishlarini yaratish uchun ChatGPTning manbada “GPT-5.2, 11 December 2025 snapshot” deb ko‘rsatilgan versiyasidan foydalangan. Sun’iy intellekt chiqishlari tadqiqotchilar tomonidan tanqidiy ko‘rib chiqilgani, tekshirilgani va talqin qilingani; nashr mazmuni uchun javobgarlik mualliflarga tegishli ekani ko‘rsatiladi.
Manfaatlar to‘qnashuvi: Mualliflar manfaatlar to‘qnashuvini bildirmagan.
Mualliflar hissasi: Konseptuallashtirish Leoni Dörfel va Rieke Ammoneit; usul Leoni Dörfel va Rieke Ammoneit; dasturiy ta’minot Leoni Dörfel; tekshirish Leoni Dörfel; formal tahlil Leoni Dörfel; ma’lumotlarni kuratsiya qilish Leoni Dörfel; dastlabki qoralama Leoni Dörfel; vizuallashtirish Leoni Dörfel; ilmiy rahbarlik Rieke Ammoneit; loyiha boshqaruvi Leoni Dörfel.
Ishlatilgan asosiy texnik vositalar: noScribe 0.4.1, MAXQDA Analytics Pro 24.4.0, manbada ko‘rsatilgan ChatGPT-5.2 11 dekabr 2025 snapshot, SBERT paraphrase-multilingual-MiniLM-L12-v2, Hungarian Algorithm, Jaccard Index, R, igraph, vegan Curveball null modeli va ggplot2.
Manba ichidagi nomuvofiqlik 1: 7-jadvalda eng yuqori kod-jufti Jaccard qiymati 0,86; muhokama bo‘limida esa yuqori ustma-ustlik oralig‘ining yuqori chegarasi 0,89 deb yozilgan. Verianla aniq qiymat sifatida jadvalni saqlaydi.
Manba ichidagi nomuvofiqlik 2: Natijalar matni qolgan beshta past ustma-ustlikli kod juftini J<0,14 deb ta’riflasa, 7-jadvalda Eurocentrism–Perspective shift jufti aynan 0,14.
Manba ichidagi nomuvofiqlik 3: A1 qo‘shimcha jadvali strategiya kodlarini 3.8 dan 3.10 ga o‘tkazadi; 3.9 kodi ko‘rsatilmagan. Verianla yetishmayotgan raqamning mazmunini taxmin qilmaydi.
Manba ichidagi nomlash farqi: Inson kodlaridan biri 6-jadvalda “Evidence-based learning”, 7-jadval va A1 qo‘shimcha jadvalida “Evidence-based working” sifatida ko‘rsatilgan. Xuddi shunday, ChatGPTning “Didactic reduction and time pressure” kodi 7-jadvalda “Complexity reduction and time pressure” shaklida yozilgan. Bu farqlar yangi kodlar sifatida talqin qilinmagan.
Tadqiqot savoli ifodasiga doir manba chegarasi: Metod bo‘limidagi asl suhbat ma’lumotlari ikki mazmuniy tadqiqot savoli atrofida tuzilgan. Manbaning ayrim natija/xulosa gaplari uchta asosiy ChatGPT kodi “RQ1–3” bilan bog‘liq ekanini bildiradi; biroq maqolaning uchta metodologik RQsi kodlarning mazmun sohalarini emas, ikki kodlash tizimini taqqoslashni so‘raydi. Verianla bu ifodani uchta alohida asl suhbat tadqiqot savoli bo‘lgandek kengaytirmaydi.
Asosiy talqin chegarasi: Tadqiqot topilmalari muayyan suhbat ma’lumotlari to‘plami, muayyan ChatGPT snapshoti, muayyan prompt protokoli va muayyan taqqoslash usullari sharoitida olingan. Natijalar barcha LLMlar yoki barcha sifatli tadqiqot kontekstlari uchun umumiy samaradorlik o‘lchovi emas.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan