


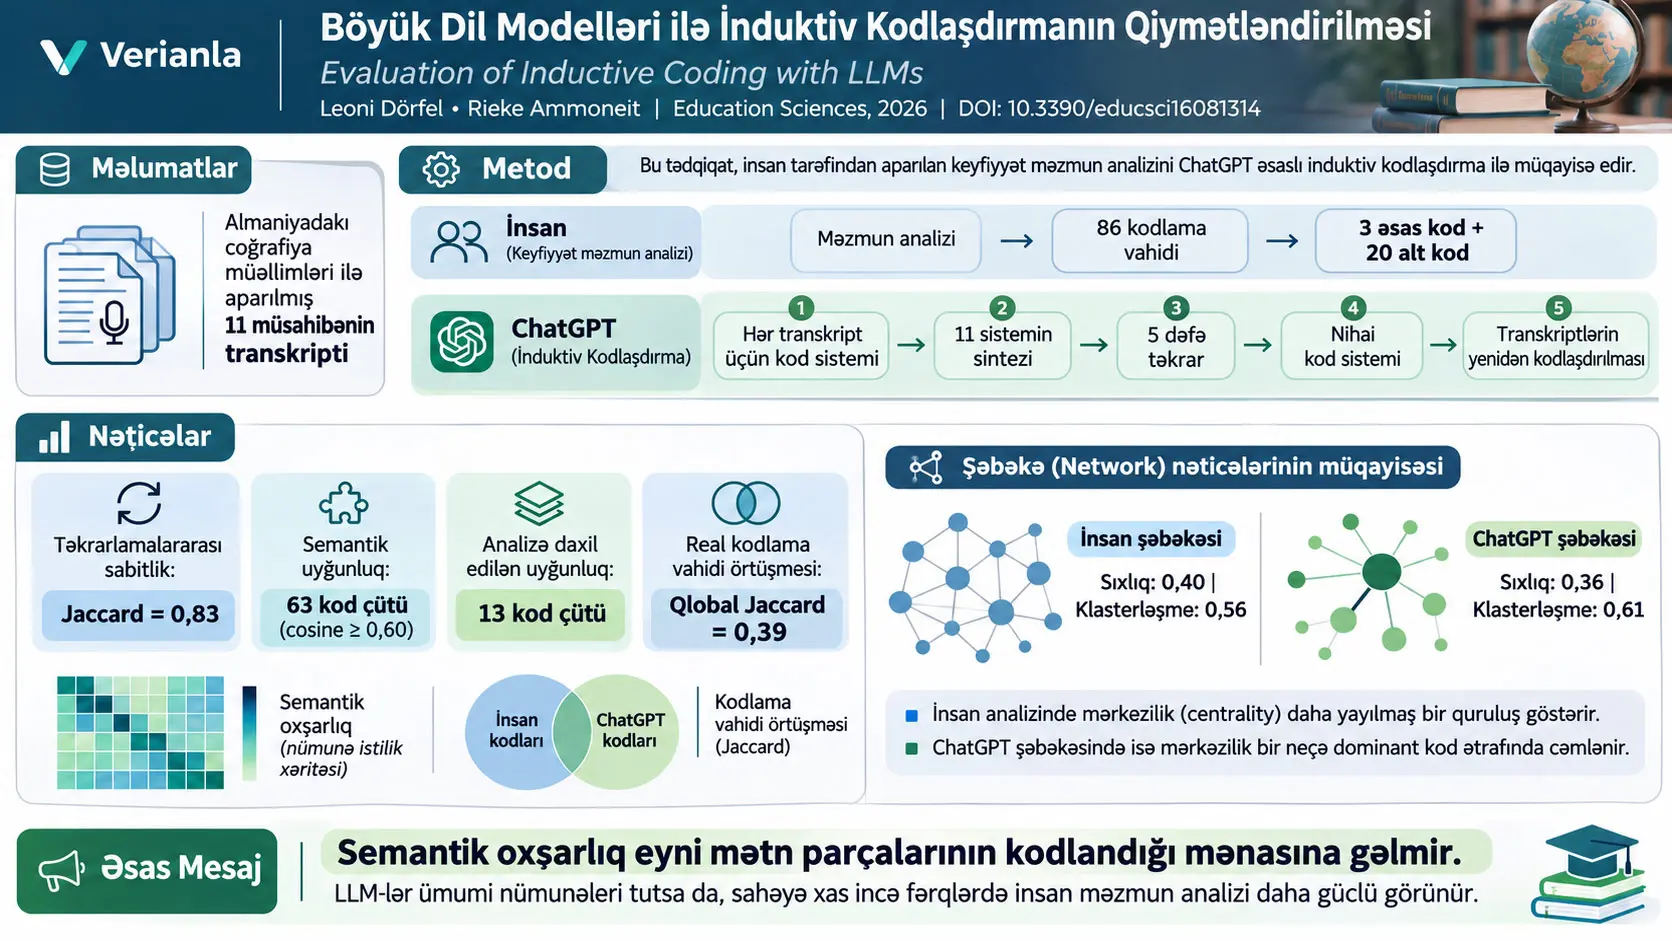
Böyük dil modeli dəstəkli induktiv kodlaşdırma, əvvəlcədən tamamlanmış kod kitabını sadəcə tətbiq etmək əvəzinə, müsahibələrdə və ya digər keyfiyyət mətnlərindəki nümunələrdən kod və kateqoriya strukturlarının yaradılmasında böyük dil modelindən istifadə edilən keyfiyyət məlumatlarının təhlili yanaşmasıdır. Bu tədqiqat ChatGPT-nin 11 alman coğrafiya müəllimi ilə aparılmış müsahibələrdən iterativ prompt mühəndisliyi vasitəsilə yaratdığı kod sistemini, eyni müsahibələr üzərində daha əvvəl insan tədqiqatçılar tərəfindən aparılmış keyfiyyət məzmun təhlili ilə müqayisə edir. Müqayisə yalnız kod adlarının oxşarlığı ilə məhdudlaşmır; hansı mətn hissələrinin kodlaşdırıldığına, kodların şəbəkə daxilindəki struktur əlaqələrinə və sahəyə xas kontekstin nə dərəcədə qorunduğuna qədər genişləndirilmişdir.
Tədqiqatda əvvəlcə ChatGPT ilə hər müsahibə üçün ayrıca kod sistemi yaradılmış, sonra bu sistemlər birləşdirilmiş, sintez prosesi beş müstəqil dəfə təkrarlanmış və beş sintezin ən azı üçündə mövcud olan kodlardan istifadə etməklə yekun kod sistemi qurulmuşdur. Yekun sistem daha sonra hər müsahibəyə beş müstəqil kodlaşdırma işə salınmasında tətbiq edilmiş; eyni kodun beş işə salınmanın ən azı üçündə mövcud olması yekun qiymətləndirmədə saxlanma meyarı kimi istifadə edilmişdir. Bu təkrarlanan prosesdə müsahibə üzrə işə salınmalar arasındakı ümumi Jaccard oxşarlığı 0,83 kimi bildirilmişdir.
ChatGPT tərəfindən yaradılan yekun kod sistemi 3 əsas kod və 14 alt koddan ibarət olduğu halda, insan əsaslı keyfiyyət məzmun təhlili 3 əsas kod və 20 alt kod ehtiva edir. SBERT əsaslı semantik müqayisədə 0,60 və ya daha yüksək kosinus oxşarlığına malik 63 kod cütü müəyyən edilmişdir. Hungarian Algorithm ilə yaradılan bir-bir uyğunlaşdırmada 14 namizəd uyğunluqdan yalnız biri 0,60 həddindən aşağı qalmış və sonrakı təhlillər 13 uyğunlaşdırılmış kod cütü üzərindən aparılmışdır.
Lakin kodların məna baxımından oxşar olması eyni müsahibə hissələrinin kodlaşdırıldığı demək olmamışdır. Uyğunlaşdırılmış 13 kod cütü üçün qlobal Jaccard indeksi yalnız 0,39-dur. Bəzi cütlərdə kodlaşdırma vahidi üst-üstə düşməsi yüksək olduğu halda, bəzi cütlərdə sıfırdır. Məsələn, “Material and textbook influence” ilə “Resources: Textbooks” arasında Jaccard 0,86 olduğu halda, “Diagnostic assessment” ilə “Outside the classroom” və “Knowledge deficits as breeding ground” ilə “Educational policy factors” cütlərində Jaccard 0-dır.
Şəbəkə təhlilində insan məzmun təhlili şəbəkəsinin sıxlığı 0,40 və qlobal klasterləşmə əmsalı 0,56; ChatGPT şəbəkəsinin sıxlığı 0,36 və qlobal klasterləşmə əmsalı 0,61 olaraq müəyyən edilmişdir. Bu qlobal ölçülər bir-birinə yaxın olsa da, düyün mərkəzilikləri fərqli struktur göstərmişdir: insan təhlilində mərkəzilik daha geniş kod toplusuna yayıldığı halda, ChatGPT sistemində bir neçə ümumi kod daha dominant olmuşdur. Tədqiqatın əsas şərhi ondan ibarətdir ki, strukturlaşdırılmış və iterativ promptlaşdırma LLM kodlaşdırmasını sabitləşdirə bilər; lakin bu məlumat dəstində ChatGPT sahəyə xas konteksti və incə konseptual fərqləri insan məzmun təhlili qədər təfərrüatlı təmsil etməmişdir.
Bu nəticələr “ChatGPT keyfiyyət təhlilində insanla eyni nəticəni verir” və ya “Jaccard 0,83 insan təhlili ilə %83 dəqiqlik deməkdir” formasında şərh edilməməlidir. 0,83 dəyəri ChatGPT-nin öz təkrarlanan işə salınmaları arasındakı sabitliyi ölçür. İnsan–ChatGPT müqayisəsində qlobal kodlaşdırma vahidi üst-üstə düşməsi isə 0,39-dur. Bundan əlavə, tədqiqatçılar insan kod sistemini mütləq obyektiv həqiqət kimi deyil, eyni materialın başqa bir etibarlı analitik şərhi kimi qəbul edirlər.
Tədqiqatın əsas problemi
Keyfiyyət tədqiqatında kodlaşdırma uzun mətn parçalarının tədqiqat sualları ilə əlaqəli mənalı kateqoriyalara çevrilməsini təmin edir. Bir müsahibədə müəllimlərin söylədikləri yüzlərlə ayrı cümlə və ya parça ehtiva edə bilər. Tədqiqatçı bu materialda hansı parçaların eyni konseptual nümunəyə aid olduğuna qərar verir, kodlar yaradır, oxşar kodları bir araya gətirir və lazım gəldikdə daha yuxarı kateqoriyalar formalaşdırır.
Böyük dil modelləri mövcud kod kitabını mətnə tətbiq edə və ya geniş mətnlərdə təkrarlanan mövzuları müəyyənləşdirə bilər. Bu tədqiqatın diqqət yetirdiyi daha çətin problem isə kodlar əvvəlcədən tam verilmədiyi halda LLM-nin kod sisteminin özünü necə inkişaf etdirməsidir. Başqa sözlə, araşdırma yalnız “ChatGPT düzgün etiketi seçirmi?” sualı ilə məhdudlaşmır; modelin keyfiyyət materialından hansı kateqoriyaları yaratdığı, bu kateqoriyaların insan tərəfindən yaradılmış sistemlə necə uyğunlaşdığı və eyni mətn sübutlarına əsaslanıb-əsaslanmadığı araşdırılır.
Tədqiqatda iki fərqli tədqiqat sualı səviyyəsi var
Mənbədə bir-birindən ayrılmalı olan iki sual səviyyəsi vardır. Birinci səviyyə ilkin müsahibə məlumat dəstinin məzmununu araşdıran suallardır: coğrafiya təhsilində stereotipləşdirmənin yaranıb-yaranmadığı, necə və niyə ortaya çıxdığı və müəllimlərin bunun öhdəsindən gəlmək üçün hansı strategiyalardan istifadə etdiyi. İkinci səviyyə isə bu məqalənin metodoloji qiymətləndirmə suallarıdır: ChatGPT kod sistemi insan məzmun təhlili sisteminə semantik baxımdan uyğunlaşdırıla bilərmi, semantik baxımdan uyğun gələn kodlar eyni kodlaşdırma vahidlərini seçirmi və iki kod sisteminin strukturu arasında sistematik fərqlər varmı?
Bu fərq vacibdir. Müsahibələrin mövzusu stereotipləşdirmədir; bu məqalənin əsas metodoloji mövzusu isə ChatGPT ilə yaradılmış induktiv kodlaşdırma sisteminin insan əsaslı məzmun təhlili ilə müqayisəsidir.
İnduktiv Kodlaşdırma Nədir və Bu Tədqiqatda ChatGPT Necə İstifadə Edilib?
İnduktiv kodlaşdırma kateqoriya və alt kateqoriyaların əvvəlcədən tam sabitləşdirilməsi əvəzinə təhlil edilən keyfiyyət materialındakı mənalı nümunələrdən inkişaf etdirilməsi prosesidir; bu tədqiqatda ChatGPT hər müsahibə üçün məlumat əsaslı kod sistemi yaratmış, bu sistemləri təkrarlanan sintez addımları ilə birləşdirmiş və ortaya çıxan yekun kod sistemini müsahibə transkriptlərinə yenidən tətbiq etmişdir.
İnsan əsaslı məzmun təhlili necə aparılıb?
İnsan məzmun təhlili Kuckartz və Rädiker-in yeddi mərhələli yanaşmasını izləmişdir. Tədqiqatçılar əvvəlcə müsahibələri diqqətlə oxumuş, qeydlər və hadisə xülasələri hazırlamış; daha sonra 11 transkript üzrə ümumilikdə 86 kodlaşdırma vahidi müəyyən etmişlər.
İlk mərhələdə üç əsas kod istifadə edilmişdir: stereotipləşdirmə nümunələri, stereotipləşdirmənin səbəbləri və stereotipləşdirmə ilə mübarizə strategiyaları. Bu əsas struktur altında materialdan induktiv olaraq 20 alt kod inkişaf etdirilmiş, kod strukturu nəzərdən keçirilmiş və bütün material son kod sistemi ilə yenidən kodlaşdırılmışdır. Analitik strategiyalar tədqiqat suallarına uyğun tətbiq edilmiş və insan təhlili MAXQDA Analytics Pro 24.4.0 istifadə edilməklə aparılmışdır.
ChatGPT kodlaşdırma prosesinin beş mərhələsi
Mərhələ I — İlkin inkişaf: 11 müsahibənin hər biri ayrı-ayrılıqda ChatGPT-yə verilmiş və hər transkript üçün ayrıca induktiv kod sistemi hazırlanmışdır. Prompt modelin tədqiqat köməkçisi rolunu, tapşırığı, tədqiqat suallarını, kodlaşdırma qaydalarını və çıxış formatını müəyyən etmişdir. Bir dəfədə yalnız bir transkriptdən istifadə etməklə uzun kontekstin yarada biləcəyi emal problemlərinin azaldılması hədəflənmişdir.
İlk sınaqlarda ChatGPT tədqiqat suallarından daha ümumi “stereotip nədir?” tipli yuxarı səviyyəli təsviri kodlara yönəlməyə meylli olduğu üçün prompt dəqiqləşdirilmişdir. Beləliklə, kod istehsalının ümumi stereotip nəzəriyyəsi əvəzinə müsahibələrdəki tədqiqat suallarına daha sıx bağlanması məqsəd qoyulmuşdur.
Mərhələ II — On bir sistemin sintezi: Hər transkriptdən əldə edilən 11 kod sistemi birlikdə müqayisə edilmişdir. Məzmun baxımından oxşar kodlar birləşdirilmiş, tematik baxımdan əsaslandırıla bilən üst kodlar yaradılmış, üst-üstə düşmələr aradan qaldırılmış və yalnız ilk mərhələdə həqiqətən istifadə olunmuş kodların yeni sistemdə olmasına icazə verilmişdir.
Mərhələ III — Sintezin təkrarlanması: LLM çıxışlarının deterministik olmaması səbəbilə sintez prosesi beş dəfə müstəqil şəkildə təkrarlanmışdır. Hər sintez ayrı söhbət sessiyasında həyata keçirilmiş və bu mərhələdə yaddaş funksiyasının söndürülü olduğu bildirilmişdir. Məqsəd tək təsadüfi model çıxışına bağlı qalmaq əvəzinə hansı kodların təkrarlanan istehsalda sabit olduğunu müşahidə etməkdir.
Mərhələ IV — Yekun sintez: Beş sintez edilmiş kod sistemi yenidən birləşdirilmişdir. Bir kodun yekun sistemə daxil edilməsi üçün beş sistemin ən azı üçündə mövcud olması tələb edilmişdir. Bu “3/5” qaydası seyrək və birdəfəlik model istehsallarının yekun kod sistemini müəyyən etməsini məhdudlaşdırmışdır.
Mərhələ V — Transkriptlərin yekun kod sistemi ilə kodlaşdırılması: Yekun kod sistemi daha sonra ilkin müsahibə transkriptlərinə tətbiq edilmişdir. Modelin yalnız müəyyənləşdirilmiş kodlardan istifadə etməsi, kod tərifinin hüdudlarından kənara çıxmaması, yeni kod yaratmaması, kod təyinatını əsaslandırması və heç bir kod uyğun gəlmirsə bunu açıq şəkildə bildirməsi üçün qaydalar tətbiq edilmişdir.
Hər transkript beş müstəqil işə salınmada kodlaşdırılmışdır. Yekun təhlildə bir kod təyinatının saxlanması üçün beş qiymətləndirmənin ən azı üçündə mövcud olması tələb edilmişdir. Bu ikinci 3/5 qaydası kod sisteminin yaradılması mərhələsindəki 3/5 qaydasından fərqlidir: birincisi hansı kodların yekun kod kitabına daxil olacağını, ikincisi isə hansı kod təyinatlarının yekun qiymətləndirməyə daxil ediləcəyini müəyyən edir.
Əlavələrdəki promptlar elmi baxımdan niyə vacibdir?
Tədqiqatın Əlavə A bölməsi yalnız nümunəvi bir prompt təqdim etmir; LLM dəstəkli kodlaşdırma prosesinin yenidən izlənilə bilməsi üçün istifadə olunan prompt arxitekturasını sənədləşdirir.
Əlavə A.1 hər transkript üçün kod sistemi inkişaf etdirən ilk promptdur. Modeldən keyfiyyət təhsil tədqiqatı sahəsində tədqiqatçı rolunda hərəkət etməsi, yalnız transkriptdəki müvafiq materialdan induktiv kateqoriya yaratması, kateqoriyaları bir-birindən fərqləndirməsi və kod adı ilə izahını cədvəl şəklində verməsi istənilir.
Əlavə A.2 11 ayrıca kod sistemini inteqrə edilmiş strukturda birləşdirməyə yönəlib. Kodların yalnız adlarına görə deyil, məzmunlarına görə müqayisə edilməsi, oxşar kodların birləşdirilməsi, üst kateqoriyaların yalnız tematik baxımdan əsaslandırıla bildikdə yaradılması və ilkin sistemlərdə heç istifadə olunmamış kodun sintezə əlavə edilməməsi şərtləri vardır.
Əlavə A.3 beş təkrarlanan sintezi vahid yekun kod sisteminə çevirir. Buradakı əsas seçim qaydası bir kodun beş sistemin ən azı üçündə mövcud olmasıdır.
Əlavə A.4 yekun kod kitabının transkriptlərə tətbiqini tənzimləyir. Modeldən kod təriflərinin hüdudlarından kənara çıxmaması, yenidən ifadə etməklə yeni məna yaratmaması, yeni kod yaratmaması, eyni kodlaşdırma vahidində bir neçə kodun olmasına icazə verməsi, uyğun kod yoxdursa bunu bildirməsi və hər təyinatı kod tərifinə istinadla əsaslandırması tələb olunur.
Bu təfərrüatlar vacibdir; çünki tədqiqatın nəticələri “ChatGPT-yə kodlaşdır deyildikdə nə baş verir?” kimi ümumi istifadənin nəticəsi deyil. Nəticələr kifayət qədər strukturlaşdırılmış və təkrarlarla sabitləşdirilməyə çalışılmış konkret prompt protokoluna aiddir.
Kosinus Oxşarlığı ilə Jaccard İndeksi Niyə Eyni Şeyi Ölçmür?
Kosinus oxşarlığı iki kodun ad və izahlarının semantik baxımdan nə qədər yaxın olduğunu ölçdüyü halda, Jaccard indeksi kodların həqiqətən hansı kodlaşdırma vahidlərinə təyin edildiyinin nə qədər üst-üstə düşdüyünü ölçür; buna görə də iki kodun mənası çox oxşar olsa belə, müsahibələrdə fərqli mətn hissələrinə tətbiq edilməsi mümkündür.
SBERT ilə kodların semantik təmsili
Hər kod üçün kod adı və kod tərifi vahid mətn ifadəsi kimi birləşdirilmişdir. Bu mətnlər Sentence-BERT (SBERT) yanaşması ilə ədədi vektorlara çevrilmişdir. Tədqiqatda əvvəlcədən öyrədilmiş paraphrase-multilingual-MiniLM-L12-v2 modeli istifadə edilmişdir.
Embedding adlandırılan bu vektorlar sözlərin yalnız birəbir uyğunluğunu deyil, mətn mənasının yaxınlığını ədədi fəzada təmsil etmək üçün istifadə olunur. Beləliklə, məsələn, iki kod fərqli sözlərdən istifadə etsə də oxşar məna ifadə edirsə, bir-birinə yaxın vektorlar yarada bilər.
Kosinus oxşarlığının riyazi məntiqi
Öyrədici qeyd: Məqalə kosinus oxşarlığı tənliyini ayrıca çap olunmuş tənlik kimi təqdim etmir. Aşağıdakı ifadə tədqiqatda istifadə edilən metrikənin standart riyazi tərifidir; araşdırmanın yeni formulu deyil.
\[ \mathrm{cosine}(\mathbf{a},\mathbf{b}) = \frac{\mathbf{a}\cdot\mathbf{b}} {\|\mathbf{a}\|\,\|\mathbf{b}\|} \]
\(\mathbf{a}\) və \(\mathbf{b}\) iki kodun SBERT ilə əldə edilən embedding vektorlarıdır. Surətdəki skalyar hasil iki vektorun ortaq istiqamətini, məxrəcdəki normların hasili isə vektor böyüklüklərini normallaşdırır. Beləliklə, müqayisə əsasən vektorların istiqamətinə, yəni semantik yaxınlığa əsaslanır.
Bu metrik ölçüsüzdür. Tədqiqatda dəyər 1-ə yaxınlaşdıqca konseptual üst-üstə düşmənin daha güclü olduğu qəbul edilmişdir. Sonrakı təhlil üçün 0,60 kosinus oxşarlığı həddi istifadə edilmişdir.
Hungarian Algorithm niyə istifadə olunub?
Bir ChatGPT kodunu yalnız özünün ən yüksək oxşarlıq balına malik insan kodu ilə müstəqil uyğunlaşdırmaq eyni insan kodunun birdən çox ChatGPT koduna təyin edilməsinə səbəb ola bilər. Tədqiqat bunun əvəzinə bütün uyğunluqları birlikdə qiymətləndirərək ümumi semantik oxşarlığı maksimum edən bir-bir təyinat kombinasiyasını axtarmışdır.
Öyrədici standart göstərim: Məqalə aşağıdakı optimallaşdırma tənliyini bu formada çap etmir; ifadə Hungarian təyinat probleminin tədqiqatdakı istifadəsini izah etmək üçündür.
\[ \max \sum_i\sum_j s_{ij}x_{ij} \]
Burada \(s_{ij}\), ChatGPT kodu \(i\) ilə insan məzmun təhlili kodu \(j\) arasındakı kosinus oxşarlığıdır. \(x_{ij}=1\) olduqda iki kod uyğunlaşdırılmış, \(x_{ij}=0\) olduqda isə uyğunlaşdırılmamışdır. Bir-bir uyğunlaşdırma səbəbilə hər kod ən çox bir qarşı kodla uyğunlaşa bilər.
ChatGPT sistemində 14, insan sistemində 20 alt kod olduğu üçün Hungarian Algorithm ən çox 14 bir-bir namizəd uyğunlaşdırma yarada bilər. Tədqiqatda 14 namizəd uyğunluqdan biri 0,56 kosinus oxşarlığı ilə 0,60 həddindən aşağı qalmış, beləliklə sonrakı təhlillər 13 uyğunlaşdırılmış cüt üzrə aparılmışdır.
Jaccard indeksi nəyi hesablayır?
Öyrədici standart tərif: Məqalə Jaccard indeksini sözlə müəyyən edir; aşağıdakı tənlik bu tərifin standart riyazi göstərimidir.
\[ J(A,B) = \frac{|A\cap B|} {|A\cup B|} \]
\(A\), bir kodun birinci kodlaşdırma yanaşması tərəfindən təyin edildiyi kodlaşdırma vahidləri; \(B\), uyğun gələn kodun ikinci yanaşma tərəfindən təyin edildiyi kodlaşdırma vahidləri çoxluğudur. \(|A\cap B|\) hər iki yanaşmanın kodlaşdırdığı ortaq vahidlərin sayını; \(|A\cup B|\) isə ən azı bir yanaşma tərəfindən kodlaşdırılan bütün vahidləri göstərir.
\(J=1\), iki çoxluğun tamamilə eyni olduğunu; \(J=0\), ortaq heç bir kodlaşdırma vahidinin olmadığını bildirir.
Tədqiqat Jaccard indeksindən iki fərqli məqsədlə istifadə etmişdir. Birincisi, eyni transkriptin beş ChatGPT işə salınması arasında nə qədər sabit kodlaşdırıldığını qiymətləndirməkdir. İkincisi isə semantik olaraq uyğunlaşdırılmış ChatGPT və insan kodlarının eyni mətn hissələrinə tətbiq edilib-edilmədiyini qiymətləndirməkdir. Bu iki Jaccard nəticəsi eyni elmi suala cavab vermir.
Şəbəkə təhlili nə əlavə edir?
Semantik uyğunlaşdırma ayrı-ayrı kod cütlərini müqayisə etdiyi halda, şəbəkə təhlili bütün kod sisteminin strukturunu araşdırır. Hər kod bir düyün, eyni kodlaşdırma vahidində birlikdə görünən iki kod arasındakı əlaqə isə kənar kimi müəyyən edilmişdir. Kənar çəkisi iki kodun neçə kodlaşdırma vahidində birlikdə olmasına bağlıdır.
Şəbəkə sıxlığı müşahidə edilən kod-kod əlaqələrinin mümkün əlaqələrin nə qədərini təşkil etdiyini ölçür. Sadə istiqamətsiz şəbəkə üçün standart öyrədici ifadə belədir:
\[ D=\frac{2E}{V(V-1)} \]
\(V\) düyün, yəni kod sayını, \(E\) isə müşahidə edilən əlaqələrin sayını göstərir. Dəyər artdıqca şəbəkədəki kodların bir-biri ilə əlaqəli olma nisbəti artır. Bu formula tədqiqatın yeni formulu deyil; məqalədəki şəbəkə sıxlığı anlayışının standart izahıdır.
Qlobal klasterləşmə əmsalı eyni koda bağlı kodların bir-biri ilə də əlaqə quraraq klasterlər yaratma meylini qiymətləndirir. Mənbə konkret tənlik yazmır; buna görə Verianla burada məqalədə olmayan dəqiq tətbiq formulunu fərz etmir.
Özvektor mərkəziliyi (eigenvector centrality, EV-centrality) yalnız bir kodun neçə əlaqəsi olduğuna deyil, həmin kodun əlaqə qurduğu digər kodların nə qədər mərkəzi olduğuna da önəm verir. Standart özvektor əlaqəsi öyrədici olaraq:
\[ x_i = \frac{1}{\lambda} \sum_j A_{ij}x_j \]
şəklində göstərilə bilər. \(x_i\), kod \(i\)-nin mərkəziliyini; \(A_{ij}\), şəbəkənin əlaqə matrisini; \(\lambda\) isə müvafiq özqiyməti göstərir. Mərkəzi kodlarla əlaqə quran düyünlər daha yüksək EV-mərkəzilik əldə edir.
Fruchterman–Reingold düzülüşü statistik nəticə deyil
Şəbəkə vizuallarında düyünlərin ekrandakı yerləri Fruchterman–Reingold alqoritmi ilə müəyyən edilmişdir. Alqoritm güclü əlaqəli düyünləri vizual olaraq bir-birinə yaxınlaşdıraraq şəbəkənin oxunaqlığını artırır. Bir düyünün şəkildə sağda, solda, yuxarıda və ya aşağıda olması özlüyündə elmi ölçmə deyil; elmi ölçülər əlaqələr, kənar çəkiləri və mərkəzilik dəyərləridir.
Curveball null modeli niyə lazımdır?
İki şəbəkənin sıxlıq və ya klasterləşmə dəyərlərinin yalnız mövcud kod tezliklərinə görə yaranıb-yaranmadığını qiymətləndirmək üçün ayrıca null modellər yaradılmışdır. Curveball alqoritmi kodlaşdırma vahidi × kod ikili matrisini təsadüfiləşdirərkən iki mühüm xüsusiyyəti qorumuşdur: hər kodlaşdırma vahidinə təyin edilmiş ümumi kod sayı və hər kodun bütün məlumat dəstində ümumi görünmə tezliyi.
Hər kod sistemi üçün 10.000 təsadüfiləşdirilmiş ikili matris yaradılmış, bunlardan kod birgə-görünmə şəbəkələri yenidən qurulmuş və sıxlıq ilə qlobal klasterləşmə üçün null paylanmaları əldə edilmişdir.
Standartlaşdırılmış müqayisənin öyrədici forması:
\[ z = \frac{T_{\mathrm{obs}}-\mu_{\mathrm{null}}} {\sigma_{\mathrm{null}}} \]
kimi düşünülə bilər. \(T_{\mathrm{obs}}\) müşahidə edilən şəbəkə metrikası, \(\mu_{\mathrm{null}}\) təsadüfi null paylanmasının ortası və \(\sigma_{\mathrm{null}}\) null paylanmasının standart sapmasıdır. Mənbə həmçinin ikitərəfli Monte Carlo p-dəyərlərinin və %95 null intervallarının hesablandığını bildirir. Əsas nəticə mətnində %95 null intervallarının ədədi sərhədləri verilmədiyi üçün Verianla bu sərhədləri yaratmır.
Yüksək Semantik Oxşarlıq Eyni Mətn Hissələrinin Kodlaşdırıldığını Göstərirmi?
Xeyr. Bu tədqiqatda bəzi kod cütlərinin kosinus oxşarlığı yüksək olsa da, Jaccard üst-üstə düşməsi çox aşağı qalmışdır; məsələn, “Perspective shift and irritation” ilə “Teaching methods” semantik olaraq təxminən 0,78 oxşarlıq göstərdiyi halda, kodlaşdırma vahidi üst-üstə düşməsi yalnız 0,10-dur.
Bu fərq tədqiqatın ən mühüm tapıntılarından biridir. Kod adları və tərifləri oxşar konseptual mənaya malik ola bilər; lakin iki kodlaşdırma sistemi bu anlayışı müsahibənin fərqli bölmələrində, fərqli genişlikdə və ya fərqli kontekstual meyarlarla tətbiq edə bilər.
Müəlliflərin şərhinə görə, bunun mühüm səbəblərindən biri kod qranulyarlığıdır. ChatGPT daha geniş anlayışları bir kod altında toplamağa meyl etdiyi halda, insan məzmun təhlili eyni konseptual sahəni daha incə alt kodlara ayırmışdır. Beləliklə, ChatGPT-nin geniş koduna daxil olan mətn parçalarının yalnız bir hissəsi Hungarian Algorithm tərəfindən uyğunlaşdırılmış daha dar insan koduna düşə bilər.
Kod qranulyarlığı nə deməkdir?
Qranulyarlıq kod sisteminin konseptual fərqləri nə qədər incə və ya geniş saxladığını ifadə edir. Məsələn, ChatGPT sistemi “Spatial and developmental stereotypes” adı ilə geniş kateqoriya yaratdığı halda, insan məzmun təhlili məkan stereotiplərini “Continents”, “Countries” və “Country groups” kimi ayrıca kodlara daha çox bölmüşdür.
İki yanaşma eyni ümumi fenomeni tanıya bilər; lakin biri onu bir geniş qutuya, digəri isə üç ayrı qutuya yerləşdirirsə, kod adları arasında yüksək semantik oxşarlıq olmasına baxmayaraq hansı parçaların ayrı-ayrılıqda uyğun gəldiyi daha aşağı çıxa bilər.
Tədqiqatın Metodu və Nəticələri
Məlumat dəsti və məlumatların hazırlanması
| Xüsusiyyət | Mənbədə verilən məlumat |
|---|---|
| Müsahibələrin sayı | 11 anonim yarı-strukturlaşdırılmış onlayn müsahibə |
| İştirakçılar | Alman coğrafiya müəllimləri |
| Xidmətdə olan müəllim | n = 9 |
| Müəllim namizədi | n = 2 |
| Müsahibə mövzusu | Coğrafiya dərsində stereotipləşdirmə |
| Transkripsiya | noScribe 0.4.1 və sonra iki mərhələ əl ilə düzəliş |
| İnsan təhlilində kodlaşdırma vahidi | 86 |
| İnsan təhlili proqramı | MAXQDA Analytics Pro 24.4.0 |
| ChatGPT sistemi | ChatGPT-5.2, 11 dekabr 2025 snapshot — mənbədə istifadə edilən adlandırma |
| Kodlaşdırma dili | Alman dili |
| Yekun ChatGPT kod sisteminin tərcüməsi | DeepL ilə ingilis dilinə, 8 iyun 2026 |
İnsan məzmun təhlilindəki 20 alt kod
| Əsas kod | Alt kod | n |
|---|---|---|
| Stereotipləşdirmə nümunələri | Continents | 4 |
| Stereotipləşdirmə nümunələri | Country groups | 3 |
| Stereotipləşdirmə nümunələri | Students' background | 7 |
| Stereotipləşdirmə nümunələri | Countries | 8 |
| Stereotipləşdirmə nümunələri | Subject content | 13 |
| Stereotipləşdirmənin səbəbləri | Teachers (causes) | 2 |
| Stereotipləşdirmənin səbəbləri | Educational policy factors | 2 |
| Stereotipləşdirmənin səbəbləri | Geography-specific factors | 7 |
| Stereotipləşdirmənin səbəbləri | Students (causes) | 8 |
| Stereotipləşdirmənin səbəbləri | Sociocultural influences | 5 |
| Stereotipləşdirmənin səbəbləri | Resources: Textbooks | 6 |
| Stereotipləşdirmə ilə mübarizə strategiyaları | Perspective shift | 6 |
| Stereotipləşdirmə ilə mübarizə strategiyaları | Causal analysis | 3 |
| Stereotipləşdirmə ilə mübarizə strategiyaları | Student-oriented strategies | 4 |
| Stereotipləşdirmə ilə mübarizə strategiyaları | Teachers (strategies) | 3 |
| Stereotipləşdirmə ilə mübarizə strategiyaları | Teaching methods | 6 |
| Stereotipləşdirmə ilə mübarizə strategiyaları | Outside the classroom | 2 |
| Stereotipləşdirmə ilə mübarizə strategiyaları | Dialogue and reflection | 7 |
| Stereotipləşdirmə ilə mübarizə strategiyaları | Increasing complexity | 5 |
| Stereotipləşdirmə ilə mübarizə strategiyaları | Evidence-based working | 5 |
Mənbə Əlavə Cədvəl A1-də strategiya alt kodlarının nömrələnməsi 3.8-dən birbaşa 3.10-a keçir; 3.9 kodu göstərilmir. Buna baxmayaraq, cədvəldə ümumilikdə 20 alt kod bildirilir. Verianla çatışmayan nömrənin hansı koda aid olduğunu təxmin etmir.
Əlavə Cədvəl A1-də kodların ümumi görünmə sayı 106-dır. Bu rəqəm 86 kodlaşdırma vahidindən böyük ola bilər; çünki bir kodlaşdırma vahidinə birdən çox fərqli kod təyin oluna bilər. Bu məqalədəki müqayisəni ChatGPT kodlaşdırmasına daha uyğun etmək üçün eyni kodun eyni kodlaşdırma vahidi daxilində təkrarları maksimum 1 kimi hesablanmışdır.
ChatGPT-nin yaratdığı yekun kod sistemi
| Əsas kod | Alt kod | Kodun əhatə etdiyi əsas fikir |
|---|---|---|
| Manifestations | Spatial and developmental stereotypes | Region və cəmiyyətlərin homogen, geridə qalmış və ya birtərəfli inkişaf etmişlik obrazları ilə təmsil edilməsi |
| Manifestations | Problem and deficit focus | Regionların əsasən böhran, yoxsulluq, münaqişə və ya çatışmazlıq üzərindən təqdim edilməsi |
| Manifestations | Social and origin stereotypes | Etnik mənşə, milliyyət, sosial fon və ya bacarıq üzərindən ümumiləşdirici aid etmələr |
| Manifestations | Migration and religion | Miqrasiya və din kimi mürəkkəb sahələrin az sayda xüsusiyyət və ya səbəbə endirilməsi |
| Conditions of emergence | Didactic reduction and time pressure | Dərs vaxtı və didaktik sadələşdirmənin həddindən artıq ümumiləşdirmələri asanlaşdıra bilməsi |
| Conditions of emergence | Material and textbook influence | Dərslik, vizual, karikatura və ya kurikulumdakı təsvirlərin stereotipləri yenidən istehsal edə bilməsi |
| Conditions of emergence | Knowledge deficits as a breeding ground | Natamam sahə biliyinin mürəkkəb əlaqələr əvəzinə sadə izah sxemlərinə yönəldə bilməsi |
| Conditions of emergence | Eurocentrism | Avropa mərkəzli meyarların digər regionları qiymətləndirməkdə norma kimi istifadə edilməsi |
| Pedagogical strategies | Diagnostic assessment | Dərsin əvvəlində şagirdlərin mövcud düşüncə və təsəvvürlərinin müəyyənləşdirilməsi |
| Pedagogical strategies | Dialogue-based reflection and intervention | Ümumiləşdirici ifadələrin sorğulanması, müzakirə edilməsi və alternativ perspektivlərin təqdim olunması |
| Pedagogical strategies | Perspective shift and irritation | Rol oynama və ya adət edilmiş baxışı pozan üsullarla düşüncə perspektivinin dəyişməsinin təşviq edilməsi |
| Pedagogical strategies | Work with data and contextualization | İddiaların məlumatlardan və daha geniş kontekstdən istifadə etməklə yoxlanılması |
| Pedagogical strategies | Making diversity and differentiation visible | Ölkə, region və qrupların daxili müxtəlifliyinin görünən edilməsi |
| Pedagogical strategies | Professional self-reflection | Müəllimin öz düşüncə qəlibləri və mümkün stereotipləri barədə tənqidi düşünməsi |
Beş sintez işə salınmasında kod sayları
Beş ayrı sintez eyni sayda alt kod yaratmamışdır. Trial 1 və Trial 5-də 16, Trial 2-də 18, Trial 3-də 24 və Trial 4-də 20 alt kod yaranmışdır. Trial 4 həmçinin yalnız həmin işə salınmada görünən “Perception and Evaluation” adlı yuxarı səviyyəli kod yaratmışdır. Kod yalnız bir sintezdə göründüyü üçün yekun 3/5 seçim qaydasını keçə bilməmişdir.
Yekun kodlaşdırmanın işə salınmadan işə salınmaya sabitliyi
| Transkript | Jaccard |
|---|---|
| 1 | 0,88 |
| 2 | 0,77 |
| 3 | 0,79 |
| 4 | 0,84 |
| 5 | 0,91 |
| 6 | 0,91 |
| 7 | 0,83 |
| 8 | 0,78 |
| 9 | 0,86 |
| 10 | 0,87 |
| 11 | 0,66 |
| Ümumi | 0,83 |
Ən yüksək işə salınmalararası Jaccard 5-ci və 6-cı transkriptlərdə 0,91; ən aşağı dəyər 11-ci transkriptdə 0,66-dır. Ümumi dəyər 0,83-dür.
Bu cədvəlin mənası xüsusilə məhdudlaşdırılmalıdır: 0,83, ChatGPT-nin insan kodlaşdırmasına %83 uyğun olduğu və ya %83 doğru olduğu demək deyil. Bu ölçmə yalnız eyni ChatGPT protokolunun müstəqil təkrarlarda nə qədər oxşar kod təyinatları etdiyinə aiddir.
SBERT istilik xəritəsinin əsas mesajı
Mənbə istilik xəritəsində ümumilikdə 63 kod cütünün kosinus oxşarlığı 0,60 və ya daha yüksək müəyyən edilmişdir. “Professional self-reflection”, “Didactic reduction and time pressure”, “Working with data and contextualization” və “Perspective shift” kimi ChatGPT kodları insan kodları ilə 0,70-dən yuxarı oxşarlıqlar göstərmişdir.
Bunun əksinə, “Migration and religion” ilə “Problem and deficit focus” kimi kodların insan sistemindəki ən yaxın qarşılıqları nisbətən daha zəif semantik oxşarlıq göstərmişdir.
Mənbə istilik xəritəsindəki bütün hüceyrələrin dəqiq ədədi dəyərlərini cədvəl şəklində dərc etmir. Buna görə Verianla rənglərdən təxmini rəqəmlər çıxarıb yeni ədədi matris yaratmır.
Hungarian Algorithm ilə bir-bir uyğunlaşdırma nəticələri
| No. | ChatGPT kodu | İnsan məzmun təhlili kodu | Kosinus oxşarlığı |
|---|---|---|---|
| 1 | Dialogue-based reflection and intervention | Dialogue and reflection | 0,81 |
| 2 | Perspective shift and irritation | Teaching methods | 0,78 |
| 3 | Making diversity and differentiation visible | Increasing complexity | 0,77 |
| 4 | Professional self-reflection | Teachers (strategies) | 0,77 |
| 5 | Diagnostic assessment | Outside the classroom | 0,73 |
| 6 | Work with data and contextualization | Evidence-based learning | 0,72 |
| 7 | Knowledge deficits as breeding ground | Educational policy factors | 0,71 |
| 8 | Spatial and developmental stereotypes | Continents | 0,69 |
| 9 | Social and origin stereotypes | Students' background | 0,66 |
| 10 | Didactic reduction and time pressure | Geography-specific factors | 0,65 |
| 11 | Material and textbook influence | Resources: Textbooks | 0,63 |
| 12 | Migration and religion | Sociocultural influences | 0,61 |
| 13 | Eurocentrism | Perspective shift | 0,60 |
| 14 | Problem and deficit focus | Country groups | 0,56 — həddən aşağı |
Son uyğunluq 0,60 həddindən aşağı olduğu üçün sonrakı kodlaşdırma-vahidi Jaccard müqayisəsinə daxil edilməmişdir.
İnsan məzmun təhlili ChatGPT sistemindən altı kod daha çox ehtiva etdiyinə görə tam 14-lük bir-bir təyinat daxilində altı insan kodu uyğunlaşdırılmadan qalmışdır: Subject content, Countries, Teachers (causes), Students (causes), Causal analysis və Student-oriented strategies.
Bu altı kodun xarakteri tədqiqatın şərhində vacibdir. Onların mühüm hissəsi coğrafiyaya xas məzmun, sinifdəki müəyyən aktorlar və ya daha incə strategiya fərqləridir. Müəlliflər bunu ChatGPT sisteminin geniş, ümumiləşdirilə bilən nümunələri tutarkən sahəyə xas və aktora xas fərqləri daha az təfərrüatlandırdığı tapıntısı ilə əlaqələndirirlər.
Semantik uyğunlaşdırmadan sonra real kodlaşdırma vahidi üst-üstə düşməsi
| ChatGPT kodu | İnsan kodu | Jaccard |
|---|---|---|
| Dialogue-based reflection and intervention | Dialogue and reflection | 0,66 |
| Perspective shift and irritation | Teaching methods | 0,10 |
| Making diversity and differentiation visible | Increasing complexity | 0,66 |
| Professional self-reflection | Teachers (strategies) | 0,75 |
| Diagnostic assessment | Outside the classroom | 0 |
| Working with data and contextualization | Evidence-based working | 0,80 |
| Knowledge deficits as breeding ground | Educational policy factors | 0 |
| Spatial and developmental stereotypes | Continents | 0,33 |
| Social and origin stereotypes | Students' background | 0,38 |
| Complexity reduction and time pressure | Geography-specific factors | 0,33 |
| Material and textbook influence | Resources: Textbooks | 0,86 |
| Eurocentrism | Perspective shift | 0,14 |
| Migration and religion | Sociocultural influences | 0 |
| Qlobal Jaccard | 13 uyğunlaşdırılmış cütün ümumisi | 0,39 |
Beş kod cütündə Jaccard 0,60-dan yuxarıdır. Ən yüksək dəyər “Material and textbook influence” ilə “Resources: Textbooks” arasında 0,86-dır. Bunun əksinə, üç uyğunluqda Jaccard sıfırdır.
Mənbənin nəticə mətni aşağı-orta qrupu təxminən 0,30–0,40 kimi təsvir edir. Mənbə həmçinin qalan beş cüt üçün “J<0,14” ifadəsindən istifadə edir; lakin Cədvəl 7-də Eurocentrism–Perspective shift dəyəri tam 0,14-dür. Verianla cədvəl dəyərini dəyişdirmir.
Müzakirə bölməsində yüksək razılaşma diapazonu bir yerdə 0,66–0,89 kimi yazılmışdır; bununla belə, Cədvəl 7-də müşahidə edilən ən yüksək dəyər 0,86-dır. Buna görə Verianla dəqiq kəmiyyət dəyərlərində Cədvəl 7-dəki 0,86-nı istifadə edir.
Niyə 0,78 semantik oxşarlıq 0,10 Jaccard ilə birlikdə görünə bilər?
“Perspective shift and irritation” ilə “Teaching methods” konseptual tərifləri bir-birinə kifayət qədər yaxın olduğu üçün kosinus oxşarlığı 0,78-dir. Lakin insan və ChatGPT sistemləri bu anlayışları eyni müsahibə parçalarına çox az tətbiq etmiş və Jaccard yalnız 0,10 olmuşdur.
Bunun əksinə, “Dialogue-based reflection and intervention” ilə “Dialogue and reflection” həm semantik səviyyədə 0,81 kimi yüksək oxşarlığa, həm də kodlaşdırma vahidlərində 0,66 Jaccard üst-üstə düşməsinə malikdir. Deməli, tədqiqatda semantik yaxınlıq ilə mətn tətbiqi üst-üstə düşməsi arasında məcburi bir-bir əlaqə yoxdur.
Şəbəkə Sıxlığı Oxşardırsa, İki Kod Sistemi Struktur Baxımından Eynidirmi?
Xeyr. İnsan və ChatGPT şəbəkələrinin ümumi sıxlıq və klasterləşmə dəyərləri bir-birinə yaxın olsa da, özvektor mərkəziliyinin kodlar arasında paylanması fərqlidir; insan sistemində struktur əhəmiyyət daha çox koda yayıldığı halda, ChatGPT sistemində bir neçə geniş kod mərkəzdə cəmlənmişdir.
| Metrik | İnsan məzmun təhlili | ChatGPT |
|---|---|---|
| Şəbəkə sıxlığı | 0,40 | 0,36 |
| Sıxlıq üçün z | −0,60 | −1,66 |
| Sıxlıq üçün p | 0,611 | 0,154 |
| Qlobal klasterləşmə əmsalı | 0,56 | 0,61 |
| Klasterləşmə üçün z | 0,34 | 1,19 |
| Klasterləşmə üçün p | 0,683 | 0,239 |
Müəlliflərin şərhinə görə, hər iki şəbəkənin sıxlıq və qlobal klasterləşmə dəyərləri öz null modellərindən statistik baxımdan əhəmiyyətli şəkildə fərqlənməmişdir. Mənbənin metod bölməsi həmçinin %95 null intervallarının hesablandığını bildirsə də, əsas nəticələrdə bu intervalların ədədi aşağı və yuxarı sərhədlərini vermir.
Mənbə bu şəbəkə müqayisəsi üçün ayrıca alfa həddini açıq şəkildə yazmır; Verianla buna görə mənbədə olmayan əhəmiyyətlilik həddi əlavə etmir. Müəlliflərin öz nəticə şərhi hesabatda verilmiş p-dəyərlərinə əsasən qlobal sıxlıq və klasterləşmənin null gözləntini aşmadığı istiqamətindədir.
Özvektor mərkəziliyi fərqli mənzərə göstərir
İnsan məzmun təhlili şəbəkəsində ən mərkəzi kod Subject content, EV = 1,00, ikinci ən mərkəzi kod Continents, EV = 0,71-dir. Mənbə həmçinin Students (causes), Resources: Textbooks və Teaching methods kodlarının da nisbətən yüksək mərkəzilik göstərdiyini bildirir.
ChatGPT şəbəkəsində isə Spatial and developmental stereotypes, EV = 1,00; Problem and deficit focus, EV = 0,91 və Material and textbook influence, EV = 0,90 dəyərləri ilə bir neçə kod aydın şəkildə mərkəzdə cəmlənmişdir.
Null-model nəticələri nə deməkdir?
Qlobal şəbəkə sıxlığı və klasterləşmə üçün null-model p-dəyərlərinin yüksək olması göstərir ki, müşahidə edilən qlobal əlaqəlilik və klasterləşmə yalnız kod tezlikləri və kodlaşdırma vahidi başına kod sayları qorunaraq yaradılan təsadüfi şəbəkələrdən aydın şəkildə fərqlənmir.
Lakin bu nəticə “iki şəbəkə eynidir” demək deyil. İki qlobal rəqəm oxşar olsa belə, hansı kodların mərkəzdə olduğu, hansı anlayışların bir-biri ilə əlaqə yaratdığı və struktur əhəmiyyətin kodlar arasında necə paylandığı fərqli ola bilər. Tədqiqatın EV-mərkəzilik tapıntısı məhz bu daha lokal struktur fərqini göstərir.
Keyfiyyət qiymətləndirməsi: struktur kompozisiya
ChatGPT-nin yaratdığı sistem tələb olunan cədvəl formatını və üç əsas konseptual sahəni böyük ölçüdə qorumuşdur. Semantik uyğunlaşdırmaların 13-dən 11-də kodlar eyni ümumi əsas tema səviyyəsində qarşılıq tapmışdır: stereotip nümunələri ChatGPT-nin manifestations sahəsinə, səbəblər conditions of emergence sahəsinə və strategiyalar pedagogical strategies sahəsinə uyğun gəlmişdir.
İki uyğunlaşdırma əsas tema səviyyəsini aşmışdır: Migration and religion ilə Sociocultural influences; Eurocentrism ilə Perspective shift. Müəlliflər bunun Hungarian Algorithm-in bir-bir uyğunlaşdırma məcburiyyətinin mümkün yan təsiri ola biləcəyini bildirirlər. Çünki alqoritm ümumi oxşarlığı qlobal olaraq maksimum edərkən hər kodun yalnız bir uyğunlaşma almasına icazə verir; bəzi kodların ən təbii tərəfdaşları artıq başqa uyğunlaşdırmalara ayrılmış ola bilər.
Keyfiyyət qiymətləndirməsi: qranulyarlıq və sahəyə xaslıq
İnsan məzmun təhlili ChatGPT-dən altı daha çox alt kateqoriya yaratmışdır. Xüsusilə insan sistemində olan Subject content kodunun ChatGPT sistemində qarşılığının olmaması diqqət çəkir; çünki Subject content insan şəbəkəsində həm ən çox istifadə edilən kodlardan biridir, həm də EV = 1,00 ilə ən mərkəzi düyündür.
İnsan sistemi Continents, Countries və Country groups kimi daha incə məkan fərqləri yaratdığı halda, ChatGPT bunları daha geniş Spatial and developmental stereotypes kateqoriyası altında birləşdirmişdir.
Müəlliflərin qiymətləndirməsinə görə, ChatGPT güclü şəkildə təkrarlanan ümumi nümunələri tuta bilir; lakin bu məlumat dəstində coğrafiya təhsilinə xas fərqlər daha az aydın şəkildə təmsil edilmişdir.
Keyfiyyət qiymətləndirməsi: səbəblərin izahında aktorlar
İnsan məzmun təhlilində stereotipləşdirmənin səbəbləri müəllimlər, şagirdlər, sosial fon, dərsin mövzu strukturu, dərsliklər və təhsil siyasəti kimi müxtəlif aktor və struktur səviyyələrinə ayrılmışdır.
ChatGPT sistemində isə səbəblər daha çox struktur şərtlərə yönəlmiş; müəllim və şagird kimi sinfin əsas aktorları ayrı səbəb kateqoriyaları kimi insan sistemindəki qədər aydın təmsil edilməmişdir.
Xüsusilə Students (causes) insan şəbəkəsində struktur baxımından mühüm koddur; ChatGPT-də şagird ölçüsü əsasən Knowledge deficits as a breeding ground daxilində daha məhdud şəkildə görünür. Tədqiqat buna görə insan təhlilinin sözügedən tədqiqat sualı baxımından daha diferensiallaşdırılmış aktor strukturu təqdim etdiyini irəli sürür.
Hər iki sistemdə ortaq olan daha yüksək səviyyəli nümunə
Hər iki şəbəkədə də stereotipləşdirmə nümunələri və səbəbləri ilə bağlı kodlar daha mərkəzi mövqelərdə yerləşməyə meyllidir. Pedaqoji strategiya kodları isə ümumilikdə daha aşağı mərkəzilik və daha az əlaqə göstərir.
Bu tapıntı hər iki təhlil yanaşmasının məlumat dəstində “fenomen nədir və niyə yaranır?” suallarını “necə müdaxilə edilir?” sualından struktur baxımdan daha mərkəzi şəkildə təmsil etdiyini düşündürür. Bu, mənbə müəlliflərinin şəbəkə strukturundan çıxardığı şərhdir; səbəb mexanizminin sübutu deyil.
Tədqiqatın dəstəklədiyi nəticələr
- Strukturlaşdırılmış, iterativ promptlaşdırma şəraitində ChatGPT təkrarlar arasında nisbətən sabit kodlaşdırma sistemi yarada bilmişdir.
- Beş müstəqil kodlaşdırma işə salınmasında ümumi run-to-run Jaccard 0,83-dür.
- ChatGPT və insan kod sistemləri arasında çoxlu orta-yüksək semantik oxşarlıq tapılmışdır.
- 0,60 həddindən yuxarı 13 bir-bir kod uyğunluğu sonrakı müqayisəyə daxil edilmişdir.
- Semantik baxımdan oxşar kodların eyni mətn hissələrini kodlaşdırması zəmanətli deyil; qlobal Jaccard 0,39-dur.
- ChatGPT sistemi daha geniş kod kateqoriyalarına yönəldiyi halda insan məzmun təhlili daha incə və sahəyə xas fərqlər yaratmışdır.
- İki şəbəkənin qlobal sıxlığı və klasterləşməsi oxşar görünsə də, mərkəzilik paylanmaları fərqlidir.
- Bu məlumat dəstində ChatGPT şəbəkəsinin struktur əhəmiyyəti daha az sayda dominant kodda cəmlənmişdir.
- İnsan məzmun təhlilində coğrafiyaya xas və aktora xas anlayışlar daha görünəndir.
- LLM çıxışlarının tənqidi insan baxışından keçirilməsi tədqiqat tərəfindən zəruri hesab edilir.
Tədqiqatın dəstəkləmədiyi nəticələr
- ChatGPT-nin bütün keyfiyyət tədqiqatlarında insan kodlaşdırması ilə ekvivalent olduğu nəticəsi çıxarıla bilməz.
- Jaccard 0,83, insan kodlaşdırmasına qarşı %83 dəqiqlik demək deyil.
- Kosinus oxşarlığının yüksək olması eyni mətn parçalarının kodlaşdırıldığını sübut etmir.
- Qlobal şəbəkə sıxlığının yaxın olması iki kod sisteminin konseptual strukturunun eyni olduğunu göstərmir.
- İnsan məzmun təhlili bu tədqiqatda obyektiv və yeganə mümkün “ground truth” kimi müəyyən edilməmişdir.
- 11 müsahibə ilə əldə edilən nəticələr bütün fənlərə, bütün LLM-lərə və ya bütün keyfiyyət məlumat növlərinə ümumiləşdirilə bilməz.
- Nəticələr ümumi və strukturlaşdırılmamış ChatGPT istifadəsini deyil, tədqiqatdakı təfərrüatlı və iterativ prompt protokolunu təmsil edir.
- Tədqiqat LLM-nin kod kateqoriyalarını daxildə hansı koqnitiv və ya alqoritmik mexanizmlə yaratdığını izah etmir.
LLM-nin “qara qutu” problemi
İnsan keyfiyyət təhlilində tədqiqatçı hansı kodlaşdırma vahidlərini müqayisə etdiyini, bir kodu niyə böldüyünü və ya iki kodu hansı konseptual əsasla birləşdirdiyini addım-addım sənədləşdirə bilər. LLM-nin daxili emalında isə geniş kateqoriyaların insan təhlilindəki kimi iterativ konseptual abstraksiya yolu ilə, yoxsa fərqli statistik nümunə tanıma mexanizmi ilə yarandığını birbaşa müşahidə etmək mümkün deyil.
Tədqiqat buna görə iki sistem arasında semantik yaxınlıq olmasına baxmayaraq bəzi kodlaşdırma vahidlərinin niyə çox fərqli seçildiyini tam izah edə bilmir. Kod qranulyarlığı bunun bir hissəsini izah edə bilər; lakin müəlliflər bunun bütün fərqi izah etmədiyini bildirirlər.
Prompt həssaslığı
LLM çıxışı istifadə olunan prompt strukturuna həssasdır. Bu tədqiqatda promptlar rol tərifi, təlimat, kontekst, təkrar, sintez və tədqiqat suallarına istiqamətləndirmə kimi elementlərlə iterativ şəkildə dəqiqləşdirilmişdir.
Deməli, nəticələrin “ChatGPT-nin təbii və dəyişməz kodlaşdırma davranışı” kimi şərh edilməsi düzgün deyil. Fərqli prompt strukturları başqa kod sistemləri yarada bilər. Tədqiqat bunu gələcək araşdırmalar üçün açıq tədqiqat sahəsi kimi saxlayır.
Əsas məhdudiyyətlər
Kiçik və mövzuya xas məlumat dəsti: Tədqiqat yalnız 11 müsahibəyə və coğrafiya dərsində stereotipləşdirmə kimi şərh baxımından həssas tək mövzuya əsaslanır. Daha böyük və fərqli fənlərdəki məlumat dəstlərində eyni nümunələrin ortaya çıxıb-çıxmayacağı məlum deyil.
Prompt həssaslığı: Təfərrüatlı və təkrarlanan prompt mühəndisliyi istifadə edilsə də, alternativ promptlar fərqli kateqoriya strukturları yarada bilər.
Uyğunlaşdırma üsulundan asılılıq: Hungarian Algorithm təkrar istehsal edilə bilən bir-bir uyğunlaşdırma təmin edir; lakin başqa uyğunlaşdırma üsulları fərqli kod cütlərini qarşı-qarşıya gətirə və müqayisə nəticələrini müəyyən qədər dəyişdirə bilər.
Keyfiyyət təhlilinin şərhedici təbiəti: Eyni materialdan elmi cəhətdən müdafiə oluna bilən birdən çox kod sistemi yarana bilər. Buna görə insan sistemi ilə ChatGPT sistemi arasındakı fərq təkbaşına “ChatGPT xətası” kimi oxuna bilməz.
LLM daxili prosesinin müşahidə edilə bilməməsi: Tədqiqat modelin kateqoriya sintezləmə prosesini daxildən izləyə bilmir. Kodların hansı aralıq qərar zənciri ilə geniş və ya dar hala gəldiyi tam izah edilə bilməz.
Sahəyə xas kontekst: Bu məlumat dəstində insan sistemi coğrafiya təhsili ilə birbaşa əlaqəli daha incə kodlar yaratmışdır. Bunun bütün sahələrdə eyni şəkildə baş verib-verməyəcəyi tədqiqatda yoxlanılmamışdır.
Mənbə və Metod Qeydi
Orijinal başlıq: Evaluation of Inductive Coding with LLMs
Müəlliflər: Leoni Dörfel, Rieke Ammoneit.
Müəllif sırası: Mənbədəki sıra eynilə qorunmuşdur.
Bərabər töhfə: Mənbədə bərabər birinci müəlliflik və ya bərabər töhfə bəyanı yoxdur.
Məsul müəllif: Leoni Dörfel.
Qurum: Department for Mathematics and Science Education, Institute for Geography Education, University of Cologne, Gronewaldstraße 2, 50931 Cologne, Germany.
Jurnal: Education Sciences.
Nəşriyyatçı: MDPI.
Cild / nömrə / məqalə nömrəsi: 16(8), 1314.
DOI: 10.3390/educsci16081314.
Rəsmi DOI keçidi: https://doi.org/10.3390/educsci16081314
Təqdim: 14 iyul 2026.
Reviziya: 7 avqust 2026.
Qəbul: 13 avqust 2026.
Nəşr: 17 avqust 2026.
Mənbə növü: Rəyçi qiymətləndirməsindən keçmiş tədqiqat məqaləsi. Metodoloji baxımdan keyfiyyət məzmun təhlili, LLM dəstəkli induktiv kodlaşdırma, NLP əsaslı semantik təhlil, kodlaşdırma-vahidi üst-üstə düşmə təhlili, şəbəkə təhlili və keyfiyyət müqayisəsini birləşdirən qarışıq metodlu metodoloji qiymətləndirmədir.
Lisenziya: Creative Commons Attribution (CC BY).
Maliyyələşdirmə: Tədqiqat xarici maliyyələşdirmə almamışdır.
İnstitusional etika açıqlaması: Tədqiqat əvvəllər toplanmış, tam anonimləşdirilmiş müsahibə transkriptlərini yenidən təhlil edir. Mənbə mövcud təhlildə şəxsləri müəyyənləşdirən məlumat olmadığını və yenidən identifikasiyanın mümkün olmadığını bildirir.
Məlumatlandırılmış razılıq: İlkin müsahibələrdə iştirak edən bütün iştirakçılardan məlumatlandırılmış razılıq alınmışdır.
Məlumatların əlçatanlığı: Məlumatlar, R skriptləri və təhlillərin xam məlumatları Zenodo-da yayımlanmışdır. Məlumat DOI-si: 10.5281/zenodo.21108082.
Süni intellekt istifadəsi bəyanatı: Müəlliflər tədqiqat zamanı keyfiyyət kodlaşdırma çıxışları yaratmaq üçün ChatGPT-nin mənbədə “GPT-5.2, 11 December 2025 snapshot” kimi göstərilən versiyasından istifadə etmişlər. Süni intellekt çıxışlarının tədqiqatçılar tərəfindən tənqidi şəkildə nəzərdən keçirildiyi, doğrulandığı və şərh edildiyi; nəşr məzmununa görə məsuliyyətin müəlliflərə aid olduğu bildirilir.
Maraqların toqquşması: Müəlliflər maraqların toqquşması bildirməmişlər.
Müəllif töhfələri: Konseptuallaşdırma Leoni Dörfel və Rieke Ammoneit; metod Leoni Dörfel və Rieke Ammoneit; proqram təminatı Leoni Dörfel; doğrulama Leoni Dörfel; formal təhlil Leoni Dörfel; məlumat kurasiyası Leoni Dörfel; ilkin qaralama Leoni Dörfel; vizuallaşdırma Leoni Dörfel; məsləhətçilik Rieke Ammoneit; layihənin idarə edilməsi Leoni Dörfel.
İstifadə edilən əsas texniki alətlər: noScribe 0.4.1, MAXQDA Analytics Pro 24.4.0, ChatGPT-5.2 mənbədə göstərilən 11 dekabr 2025 snapshot, SBERT paraphrase-multilingual-MiniLM-L12-v2, Hungarian Algorithm, Jaccard Index, R, igraph, vegan Curveball null modeli və ggplot2.
Mənbədaxili uyğunsuzluq 1: Cədvəl 7-də ən yüksək kod-cütü Jaccard dəyəri 0,86-dır; müzakirə bölməsində isə yüksək üst-üstə düşmə diapazonunun yuxarı sərhədi 0,89 kimi yazılmışdır. Verianla dəqiq dəyər kimi cədvəli qoruyur.
Mənbədaxili uyğunsuzluq 2: Nəticə mətni qalan beş aşağı üst-üstə düşməli kod cütünü J<0,14 kimi təsvir etdiyi halda, Cədvəl 7-də Eurocentrism–Perspective shift cütü dəqiq 0,14-dür.
Mənbədaxili uyğunsuzluq 3: Əlavə Cədvəl A1 strategiya kodlarını 3.8-dən 3.10-a keçirir; 3.9 kodu göstərilmir. Verianla çatışmayan nömrənin məzmununu təxmin etmir.
Mənbədaxili adlandırma fərqi: İnsan kodlarından biri Cədvəl 6-da “Evidence-based learning”, Cədvəl 7 və Əlavə Cədvəl A1-də “Evidence-based working” kimi görünür. Eynilə, ChatGPT-nin “Didactic reduction and time pressure” kodu Cədvəl 7-də “Complexity reduction and time pressure” formasında yazılmışdır. Bu fərqlər yeni kodlar kimi şərh edilməmişdir.
Tədqiqat sualının ifadəsinə dair mənbə sərhədi: Metod bölməsindəki ilkin müsahibə məlumatı iki məzmun tədqiqat sualı ətrafında qurulmuşdur. Mənbənin bəzi nəticə/yekun cümlələri üç əsas ChatGPT kodunun “RQ1–3” ilə əlaqəli olduğunu bildirir; lakin məqalənin üç metodoloji RQ-su kodların məzmun sahələrini deyil, iki kodlaşdırma sisteminin müqayisəsini sorğulayır. Verianla bu ifadəni üç ayrı ilkin müsahibə tədqiqat sualı varmış kimi genişləndirmir.
Əsas şərh sərhədi: Tədqiqatın nəticələri müəyyən müsahibə məlumat dəsti, müəyyən ChatGPT snapshot-ı, müəyyən prompt protokolu və müəyyən müqayisə üsulları altında əldə edilmişdir. Nəticələr bütün LLM-lərin və ya bütün keyfiyyət tədqiqat kontekstlərinin ümumi performans ölçüsü deyil.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib