


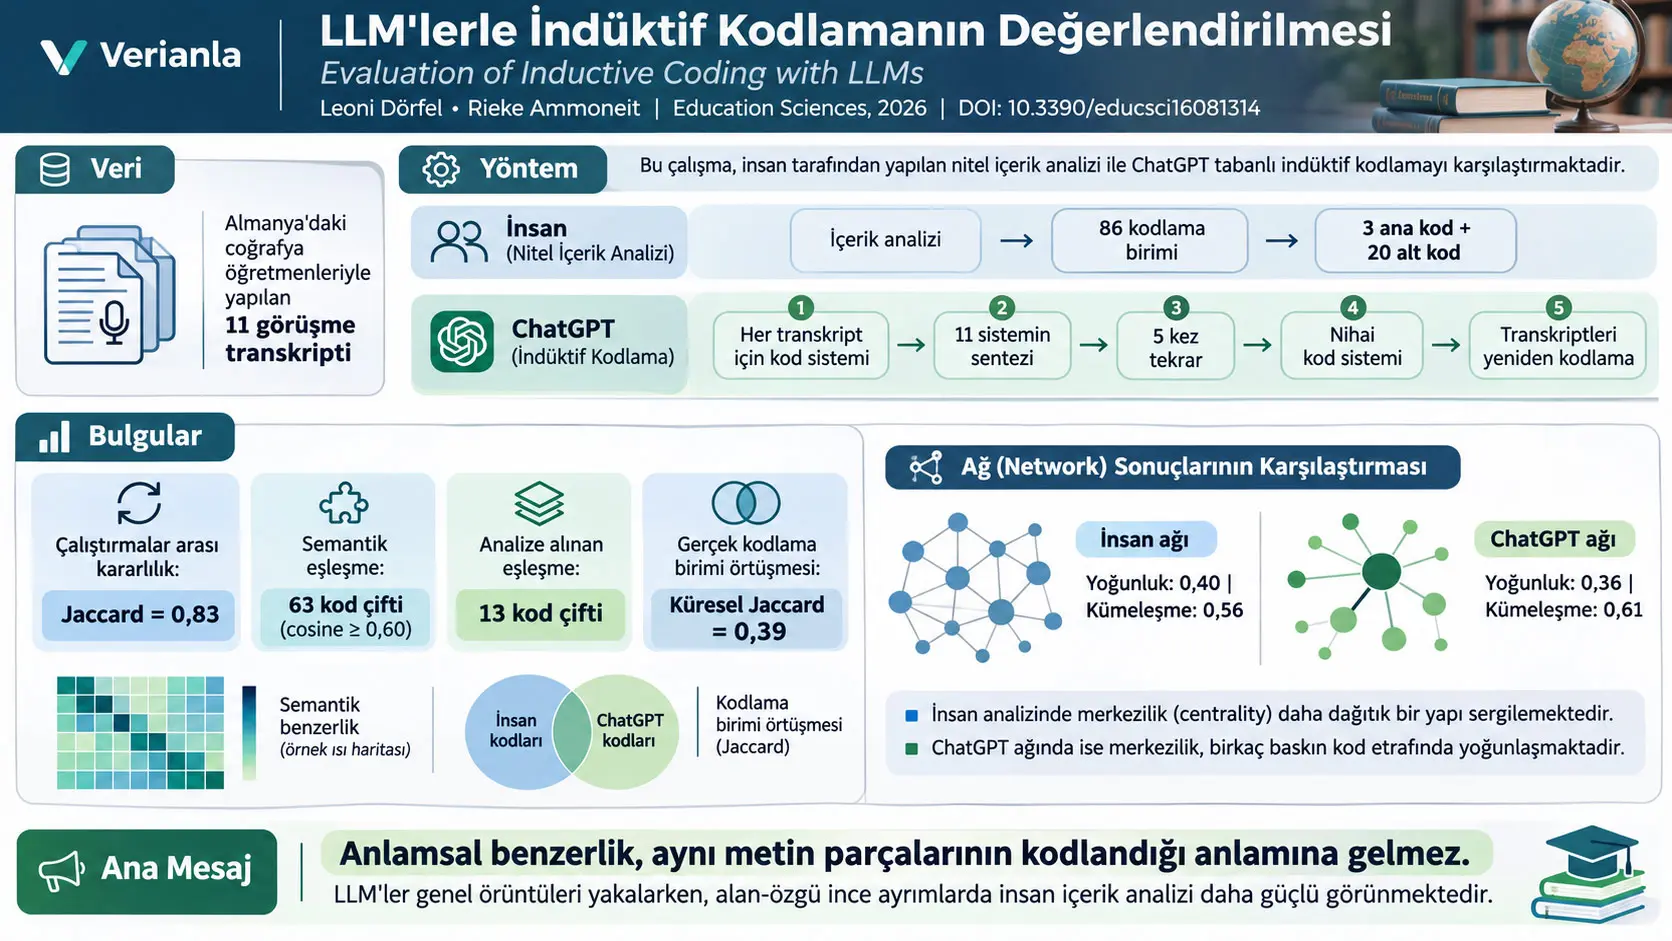
Büyük dil modeli destekli indüktif kodlama, önceden tamamlanmış bir kod kitabını yalnız uygulamak yerine görüşme veya başka nitel metinlerdeki örüntülerden kod ve kategori yapılarının oluşturulmasında büyük dil modelinin kullanıldığı bir nitel veri analizi yaklaşımıdır. Bu çalışma, ChatGPT'nin 11 Alman coğrafya öğretmeniyle yapılan görüşmelerden iteratif prompt mühendisliği yoluyla oluşturduğu kod sistemini, aynı görüşmeler üzerinde daha önce insan araştırmacılar tarafından gerçekleştirilen nitel içerik analiziyle karşılaştırmaktadır. Karşılaştırma yalnız kod adlarının benzerliğine değil; hangi metin parçalarının kodlandığına, kodların ağ içindeki yapısal ilişkilerine ve alan-özgü bağlamın ne ölçüde korunduğuna kadar genişletilmiştir.
Çalışmada ChatGPT ile önce her görüşme için ayrı bir kod sistemi oluşturulmuş, daha sonra bu sistemler birleştirilmiş, sentez işlemi beş bağımsız kez tekrarlanmış ve beş sentezin en az üçünde bulunan kodlar kullanılarak nihai kod sistemi oluşturulmuştur. Nihai sistem daha sonra her görüşmeye beş bağımsız kodlama çalıştırmasında uygulanmış; aynı kodun beş çalıştırmanın en az üçünde bulunması nihai değerlendirmede korunma ölçütü olarak kullanılmıştır. Bu tekrarlı süreçte görüşme başına çalıştırmalar arasındaki genel Jaccard benzerliği 0,83 olarak raporlanmıştır.
ChatGPT tarafından oluşturulan nihai kod sistemi 3 ana kod ve 14 alt koddan oluşurken insan temelli nitel içerik analizi 3 ana kod ve 20 alt kod içermektedir. SBERT tabanlı semantik karşılaştırmada 0,60 veya daha yüksek kosinüs benzerliğine sahip 63 kod çifti bulunmuştur. Hungarian Algorithm ile oluşturulan bire bir eşleştirmede 14 aday eşleşmenin yalnız biri 0,60 eşiğinin altında kalmış ve sonraki analizler 13 eşleştirilmiş kod çifti üzerinden yürütülmüştür.
Ancak kodların anlam bakımından benzer olması, aynı görüşme parçalarının kodlandığı anlamına gelmemiştir. Eşleştirilmiş 13 kod çifti için küresel Jaccard indeksi yalnız 0,39'dur. Bazı çiftlerde kodlama birimi örtüşmesi yüksekken bazı çiftlerde sıfırdır. Örneğin “Material and textbook influence” ile “Resources: Textbooks” arasında Jaccard 0,86 iken, “Diagnostic assessment” ile “Outside the classroom” ve “Knowledge deficits as breeding ground” ile “Educational policy factors” çiftlerinde Jaccard 0'dır.
Ağ analizinde insan içerik analizi ağının yoğunluğu 0,40 ve küresel kümeleşme katsayısı 0,56; ChatGPT ağının yoğunluğu 0,36 ve küresel kümeleşme katsayısı 0,61 olarak bulunmuştur. Bu global ölçüler birbirine yakın olsa da düğüm merkezilikleri farklı bir yapı göstermiştir: insan analizinde merkezilik daha geniş bir kod kümesine dağılırken ChatGPT sisteminde birkaç genel kod daha baskın hale gelmiştir. Çalışmanın temel yorumu, yapılandırılmış ve iteratif promptlamanın LLM kodlamasını kararlı hale getirebildiği; fakat bu veri setinde ChatGPT'nin alan-özgü bağlamı ve ince kavramsal ayrımları insan içerik analizi kadar ayrıntılı temsil etmediğidir.
Bu sonuçlar “ChatGPT nitel analizde insanla aynı sonucu üretir” veya “Jaccard 0,83 insan analiziyle %83 doğruluk anlamına gelir” biçiminde yorumlanmamalıdır. 0,83 değeri ChatGPT'nin kendi tekrarlı çalıştırmaları arasındaki kararlılığı ölçmektedir. İnsan–ChatGPT karşılaştırmasındaki küresel kodlama birimi örtüşmesi ise 0,39'dur. Ayrıca araştırmacılar insan kod sistemini mutlak bir nesnel doğru olarak değil, aynı materyalin başka bir geçerli analitik yorumu olarak ele almaktadır.
Araştırmanın temel problemi
Nitel araştırmada kodlama, uzun metin parçalarının araştırma sorularıyla ilişkili anlamlı kategorilere dönüştürülmesini sağlar. Bir görüşmede öğretmenlerin söyledikleri yüzlerce ayrı cümle veya pasaj içerebilir. Araştırmacı bu materyalde hangi pasajların aynı kavramsal örüntüye ait olduğuna karar verir, kodlar oluşturur, benzer kodları bir araya getirir ve gerektiğinde daha üst kategoriler geliştirir.
Büyük dil modelleri mevcut bir kod kitabını metne uygulayabilir veya geniş metinlerde tekrar eden temaları belirleyebilir. Bu çalışmanın odaklandığı daha zor problem ise kodların önceden tamamen verilmediği durumda LLM'nin kod sisteminin kendisini nasıl geliştirdiğidir. Başka bir ifadeyle araştırma yalnız “ChatGPT doğru etiketi seçiyor mu?” sorusuyla sınırlı değildir; modelin nitel materyalden hangi kategorileri ürettiği, bu kategorilerin insan tarafından oluşturulan sistemle nasıl eşleştiği ve aynı metin kanıtlarına dayanıp dayanmadığı araştırılmaktadır.
Çalışmada iki farklı araştırma sorusu düzeyi bulunuyor
Kaynakta birbirinden ayrılması gereken iki soru düzeyi vardır. İlk düzey, özgün görüşme veri setinin içeriğini araştıran sorulardır: coğrafya eğitiminde stereotipleştirmenin oluşup oluşmadığı, nasıl ve neden ortaya çıktığı ve öğretmenlerin bununla başa çıkmak için hangi stratejileri kullandığı. İkinci düzey ise bu makalenin metodolojik değerlendirme sorularıdır: ChatGPT kod sistemi insan içerik analizi sistemine semantik olarak eşlenebilir mi, semantik olarak karşılık gelen kodlar aynı kodlama birimlerini mi seçiyor ve iki kod sisteminin yapısı arasında sistematik farklar var mı?
Bu ayrım önemlidir. Görüşmelerin konusu stereotipleştirmedir; bu makalenin asıl metodolojik konusu ise ChatGPT ile oluşturulan indüktif kodlama sisteminin insan temelli içerik analiziyle karşılaştırılmasıdır.
İndüktif Kodlama Nedir ve Bu Çalışmada ChatGPT Nasıl Kullanıldı?
İndüktif kodlama, kategori ve alt kategorilerin önceden tamamen sabitlenmesi yerine analiz edilen nitel materyaldeki anlamlı örüntülerden geliştirilmesi sürecidir; bu çalışmada ChatGPT her görüşme için veri temelli kod sistemi üretmiş, bu sistemleri tekrarlı sentez adımlarıyla birleştirmiş ve ortaya çıkan nihai kod sistemini görüşme transkriptlerine yeniden uygulamıştır.
İnsan temelli içerik analizi nasıl yapılmış?
İnsan içerik analizi Kuckartz ve Rädiker'in yedi aşamalı yaklaşımını izlemiştir. Araştırmacılar önce görüşmeleri dikkatle okumuş, notlar ve vaka özetleri hazırlamış; ardından 11 transkript boyunca toplam 86 kodlama birimi belirlemiştir.
İlk aşamada üç ana kod kullanılmıştır: stereotipleştirme örnekleri, stereotipleştirmenin nedenleri ve stereotipleştirmeyle başa çıkma stratejileri. Bu ana yapı altında materyalden indüktif olarak 20 alt kod geliştirilmiş, kod yapısı gözden geçirilmiş ve bütün materyal son kod sistemiyle yeniden kodlanmıştır. Analitik stratejiler araştırma sorularına göre uygulanmış ve insan analizi MAXQDA Analytics Pro 24.4.0 kullanılarak yürütülmüştür.
ChatGPT kodlama sürecinin beş aşaması
Aşama I — İlk geliştirme: 11 görüşmenin her biri ayrı ayrı ChatGPT'ye verilmiş ve her transkript için ayrı bir indüktif kod sistemi geliştirilmiştir. Prompt; modelin araştırma asistanı rolünü, görevi, araştırma sorularını, kodlama kurallarını ve çıktı biçimini belirlemiştir. Bir defada yalnız bir transkript kullanılmasıyla uzun bağlamın yaratabileceği işlem sorunlarının azaltılması hedeflenmiştir.
İlk denemelerde ChatGPT araştırma sorularından daha genel “stereotip nedir?” türündeki üst düzey tanımlayıcı kodlara yönelme eğilimi gösterdiği için prompt rafine edilmiştir. Böylece kod üretiminin genel stereotip teorisi yerine görüşmelerdeki araştırma sorularına daha sıkı bağlanması amaçlanmıştır.
Aşama II — On bir sistemin sentezi: Her transkriptten elde edilen 11 kod sistemi birlikte karşılaştırılmıştır. İçerik bakımından benzer kodlar birleştirilmiş, tematik olarak gerekçelendirilebilen üst kodlar oluşturulmuş, örtüşmeler çözülmüş ve yalnız ilk aşamada gerçekten kullanılmış kodların yeni sistemde bulunmasına izin verilmiştir.
Aşama III — Sentezin tekrarlanması: LLM çıktılarının deterministik olmaması nedeniyle sentez işlemi beş kez bağımsız olarak tekrarlanmıştır. Her sentez ayrı sohbet oturumunda gerçekleştirilmiş ve bu aşamada bellek işlevinin kapalı olduğu belirtilmiştir. Amaç tek bir rastlantısal model çıktısına bağlı kalmak yerine hangi kodların tekrarlı üretimde kararlı olduğunu gözlemlemektir.
Aşama IV — Nihai sentez: Beş sentezlenmiş kod sistemi tekrar birleştirilmiştir. Bir kodun nihai sisteme alınması için beş sistemin en az üçünde bulunması gerekmiştir. Bu “3/5” kuralı seyrek ve tek seferlik model üretimlerinin nihai kod sistemini belirlemesini sınırlandırmıştır.
Aşama V — Transkriptlerin nihai kod sistemiyle kodlanması: Nihai kod sistemi daha sonra özgün görüşme transkriptlerine uygulanmıştır. Modelin yalnız tanımlanmış kodları kullanmasına, kod tanımının dışına taşmamasına, yeni kod oluşturmamasına, kod atamasını gerekçelendirmesine ve hiçbir kod uymuyorsa bunu açıkça belirtmesine yönelik kurallar kullanılmıştır.
Her transkript beş bağımsız çalıştırmada kodlanmıştır. Nihai analizde bir kod atamasının korunması için beş değerlendirmeden en az üçünde bulunması gerekmiştir. Bu ikinci 3/5 kuralı kod sistemini oluşturma aşamasındaki 3/5 kuralından farklıdır: birincisi hangi kodların nihai kod kitabına gireceğini, ikincisi ise hangi kod atamalarının nihai değerlendirmeye alınacağını belirler.
Eklerdeki promptlar neden bilimsel açıdan önemli?
Çalışmanın Ek A bölümü yalnız örnek bir istem vermekle kalmaz; LLM destekli kodlama sürecinin yeniden izlenebilmesi için kullanılan prompt mimarisini belgelemektedir.
Ek A.1 her transkript için kod sistemi geliştiren ilk prompttur. Modelin nitel eğitim araştırması alanında araştırmacı rolünde hareket etmesi, yalnız transkriptteki ilgili materyalden indüktif kategori oluşturması, kategorileri birbirinden ayrıştırması ve kod adı ile açıklamasını tablo halinde vermesi istenir.
Ek A.2 11 ayrı kod sistemini bütünleşik bir yapıda birleştirmeye yöneliktir. Kodların yalnız adlarına göre değil içeriklerine göre karşılaştırılması, benzer kodların birleştirilmesi, üst kategorilerin yalnız tematik olarak gerekçelendirilebiliyorsa oluşturulması ve özgün sistemlerde hiç kullanılmamış bir kodun senteze eklenmemesi şartları bulunur.
Ek A.3 beş tekrarlı sentezi tek nihai kod sistemine dönüştürür. Buradaki ana seçim kuralı, bir kodun beş sistemin en az üçünde bulunmasıdır.
Ek A.4 nihai kod kitabının transkriptlere uygulanmasını düzenler. Modelin kod tanımlarının ötesine geçmemesi, yeniden ifade ederek yeni anlam üretmemesi, yeni kod oluşturmaması, aynı kodlama biriminde birden fazla kodun bulunabilmesine izin vermesi, uygun kod yoksa bunu belirtmesi ve her atamayı kod tanımına referansla gerekçelendirmesi istenir.
Bu ayrıntılar önemlidir; çünkü çalışmanın bulguları “ChatGPT'ye kodla denildiğinde ne olur?” gibi genel bir kullanımın sonucu değildir. Sonuçlar, oldukça yapılandırılmış ve tekrarlarla kararlı hale getirilmeye çalışılmış belirli bir prompt protokolüne aittir.
Kosinüs Benzerliği ile Jaccard İndeksi Neden Aynı Şeyi Ölçmüyor?
Kosinüs benzerliği iki kodun ad ve açıklamalarının anlamsal olarak ne kadar yakın olduğunu ölçerken Jaccard indeksi kodların hangi kodlama birimlerine gerçekten atandığının ne kadar örtüştüğünü ölçer; bu nedenle iki kodun anlamı çok benzer olduğu halde görüşmelerde farklı metin parçalarına uygulanması mümkündür.
SBERT ile kodların anlamsal temsili
Her kod için kod adı ve kod tanımı tek bir metinsel ifade olarak birleştirilmiştir. Bu metinler Sentence-BERT (SBERT) yaklaşımıyla sayısal vektörlere dönüştürülmüştür. Çalışmada önceden eğitilmiş paraphrase-multilingual-MiniLM-L12-v2 modeli kullanılmıştır.
Embedding olarak adlandırılan bu vektörler, kelimelerin yalnız birebir eşleşmesini değil metinsel anlam yakınlığını sayısal bir uzayda temsil etmek için kullanılır. Böylece örneğin iki kod farklı kelimeler kullansa bile benzer anlam ifade ediyorsa birbirine yakın vektörler oluşturabilir.
Kosinüs benzerliğinin matematiksel mantığı
Öğretici not: Makale kosinüs benzerliği denklemini ayrıca basılı bir denklem olarak vermemektedir. Aşağıdaki ifade çalışmada kullanılan metriğin standart matematiksel tanımıdır; araştırmanın yeni bir formülü değildir.
\[ \mathrm{cosine}(\mathbf{a},\mathbf{b}) = \frac{\mathbf{a}\cdot\mathbf{b}} {\|\mathbf{a}\|\,\|\mathbf{b}\|} \]
\(\mathbf{a}\) ve \(\mathbf{b}\), iki kodun SBERT ile elde edilen embedding vektörleridir. Paydaki noktasal çarpım iki vektörün ortak yönelimini, paydadaki normların çarpımı ise vektör büyüklüklerini normalize eder. Böylece karşılaştırma esas olarak vektörlerin yönüne, yani anlamsal yakınlığına dayanır.
Bu metrik boyutsuzdur. Çalışmada değer 1'e yaklaştıkça kavramsal örtüşmenin daha güçlü olduğu kabul edilmiştir. Sonraki analiz için 0,60 kosinüs benzerliği eşiği kullanılmıştır.
Hungarian Algorithm neden kullanılmış?
Bir ChatGPT kodunu yalnız kendi en yüksek benzerlik puanına sahip insan koduyla bağımsız olarak eşleştirmek aynı insan kodunun birden fazla ChatGPT koduna atanmasına neden olabilir. Çalışma bunun yerine bütün eşleşmeleri birlikte değerlendirerek toplam semantik benzerliği en yüksek yapan bire bir atama kombinasyonunu aramıştır.
Öğretici standart gösterim: Makale aşağıdaki optimizasyon denklemini bu biçimde basmamaktadır; ifade Hungarian atama probleminin çalışmadaki kullanımını açıklamak içindir.
\[ \max \sum_i\sum_j s_{ij}x_{ij} \]
Burada \(s_{ij}\), ChatGPT kodu \(i\) ile insan içerik analizi kodu \(j\) arasındaki kosinüs benzerliğidir. \(x_{ij}=1\) ise iki kod eşleştirilmiş, \(x_{ij}=0\) ise eşleştirilmemiştir. Bire bir eşleştirme nedeniyle her kod en fazla bir karşı kodla eşleşebilir.
ChatGPT sisteminde 14, insan sisteminde 20 alt kod olduğu için Hungarian Algorithm en fazla 14 bire bir aday eşleştirme oluşturabilir. Çalışmada 14 aday eşleşmenin bir tanesi 0,56 kosinüs benzerliğiyle 0,60 eşiğinin altında kalmış, böylece sonraki analizler 13 eşleştirilmiş çift üzerinden yapılmıştır.
Jaccard indeksi neyi hesaplıyor?
Öğretici standart tanım: Makale Jaccard indeksini sözel olarak tanımlamaktadır; aşağıdaki denklem bu tanımın standart matematiksel gösterimidir.
\[ J(A,B) = \frac{|A\cap B|} {|A\cup B|} \]
\(A\), bir kodun birinci kodlama yaklaşımı tarafından atandığı kodlama birimleri; \(B\), karşılık gelen kodun ikinci yaklaşım tarafından atandığı kodlama birimleri kümesidir. \(|A\cap B|\), iki yaklaşımın da kodladığı ortak birimlerin sayısını; \(|A\cup B|\), en az bir yaklaşım tarafından kodlanan bütün birimleri gösterir.
\(J=1\), iki kümenin tamamen aynı olduğu; \(J=0\), ortak hiçbir kodlama birimi olmadığı anlamına gelir.
Çalışma Jaccard indeksini iki farklı amaçla kullanmıştır. Birincisi aynı transkriptin beş ChatGPT çalıştırması arasında ne kadar kararlı kodlandığını değerlendirmektir. İkincisi ise semantik olarak eşleştirilmiş ChatGPT ve insan kodlarının aynı metin parçalarına uygulanıp uygulanmadığını değerlendirmektir. Bu iki Jaccard sonucu aynı bilimsel soruyu cevaplamaz.
Ağ analizi neyi ekliyor?
Semantik eşleşme tek tek kod çiftlerini karşılaştırırken ağ analizi bütün kod sisteminin yapısını inceler. Her kod bir düğüm, aynı kodlama biriminde birlikte görülen iki kod arasındaki ilişki bir kenar olarak tanımlanmıştır. Kenar ağırlığı iki kodun kaç kodlama biriminde birlikte bulunduğuna bağlıdır.
Ağ yoğunluğu, gözlenen kod-kod bağlantılarının mümkün olan bağlantıların ne kadarını oluşturduğunu ölçer. Basit yönsüz ağ için standart öğretici ifade şöyledir:
\[ D=\frac{2E}{V(V-1)} \]
\(V\) düğüm yani kod sayısı, \(E\) gözlenen bağlantı sayısıdır. Değer arttıkça ağdaki kodların birbirleriyle bağlantılı olma oranı artar. Bu formül çalışmanın yeni formülü değildir; makaledeki ağ yoğunluğu kavramının standart açıklamasıdır.
Küresel kümeleşme katsayısı, aynı koda bağlı kodların birbirleriyle de bağlantılı olarak kümeler oluşturma eğilimini değerlendirir. Kaynak belirli bir denklem yazmamaktadır; bu nedenle Verianla burada makalede bulunmayan kesin uygulama formülünü varsaymamaktadır.
Özvektör merkeziliği (eigenvector centrality, EV-centrality), yalnız bir kodun kaç bağlantısı olduğuna değil, o kodun bağlantı kurduğu diğer kodların ne kadar merkezi olduğuna da önem verir. Standart özvektör ilişkisi öğretici olarak:
\[ x_i = \frac{1}{\lambda} \sum_j A_{ij}x_j \]
biçiminde gösterilebilir. \(x_i\), kod \(i\)'nin merkeziliği; \(A_{ij}\), ağın bağlantı matrisi; \(\lambda\) ise ilgili özdeğerdir. Merkezî kodlarla bağlantı kuran düğümler daha yüksek EV-merkezilik elde eder.
Fruchterman–Reingold düzeni istatistiksel sonuç değildir
Ağ görsellerinde düğümlerin ekrandaki yerleri Fruchterman–Reingold algoritmasıyla belirlenmiştir. Algoritma güçlü biçimde ilişkili düğümleri görsel olarak birbirine yaklaştırarak ağın okunmasını kolaylaştırır. Bir düğümün resimde sağda, solda, yukarıda veya aşağıda bulunması başlı başına bilimsel ölçüm değildir; bilimsel ölçüler bağlantılar, kenar ağırlıkları ve merkezilik değerleridir.
Curveball null modeli neden gerekli?
İki ağın yoğunluk veya kümeleşme değerlerinin yalnız mevcut kod sıklıkları nedeniyle ortaya çıkıp çıkmadığını değerlendirmek için ayrı null modeller oluşturulmuştur. Curveball algoritması kodlama birimi × kod ikili matrisini rastgeleleştirirken iki önemli özelliği korumuştur: her kodlama birimine atanmış toplam kod sayısı ve her kodun bütün veri setindeki toplam görülme sıklığı.
Her kod sistemi için 10.000 rastgeleleştirilmiş ikili matris oluşturulmuş, bunlardan kod birlikte-görülme ağları yeniden kurulmuş ve yoğunluk ile küresel kümeleşme için null dağılımları elde edilmiştir.
Standartlaştırılmış karşılaştırmanın öğretici biçimi:
\[ z = \frac{T_{\mathrm{obs}}-\mu_{\mathrm{null}}} {\sigma_{\mathrm{null}}} \]
olarak düşünülebilir. \(T_{\mathrm{obs}}\) gözlenen ağ metriği, \(\mu_{\mathrm{null}}\) rastgele null dağılımının ortalaması ve \(\sigma_{\mathrm{null}}\) null dağılımının standart sapmasıdır. Kaynak ayrıca iki taraflı Monte Carlo p-değerleri ve %95 null aralıkları hesaplandığını belirtmektedir. Ana sonuç metninde %95 null aralıklarının sayısal sınırları verilmediği için Verianla bu sınırları üretmemektedir.
Yüksek Semantik Benzerlik Aynı Metin Parçalarının Kodlandığını Gösterir mi?
Hayır. Bu çalışmada bazı kod çiftlerinin kosinüs benzerliği yüksek olmasına rağmen Jaccard örtüşmesi çok düşük kalmıştır; örneğin “Perspective shift and irritation” ile “Teaching methods” semantik olarak yaklaşık 0,78 benzerlik göstermesine karşın kodlama birimi örtüşmesi yalnız 0,10'dur.
Bu fark çalışmanın en önemli bulgularından biridir. Kod adları ve tanımları benzer kavramsal anlama sahip olabilir; fakat iki kodlama sistemi bu kavramı görüşmenin farklı bölümlerinde, farklı genişlikte veya farklı bağlamsal ölçütlerle uygulayabilir.
Yazarların yorumuna göre bunun önemli nedenlerinden biri kod granülerliğidir. ChatGPT daha geniş kavramları tek kod altında toplama eğilimi gösterirken insan içerik analizi aynı kavramsal alanı daha ince alt kodlara ayırmıştır. Böylece ChatGPT'nin geniş bir koduna giren metin parçalarının yalnız bir kısmı Hungarian Algorithm tarafından eşleştirilmiş daha dar insan koduna düşebilir.
Kod granülerliği ne demek?
Granülerlik, bir kod sisteminin kavramsal ayrımları ne kadar ince veya geniş tuttuğunu anlatır. Örneğin ChatGPT sistemi “Spatial and developmental stereotypes” adıyla geniş bir kategori oluştururken insan içerik analizi mekânsal stereotipleri “Continents”, “Countries” ve “Country groups” gibi ayrı kodlarla daha fazla parçalamıştır.
İki yaklaşım aynı genel fenomeni tanıyor olabilir; ancak biri onu tek geniş kutuya, diğeri üç ayrı kutuya yerleştirirse kod adları arasında yüksek anlamsal benzerlik bulunmasına rağmen hangi pasajların tek tek eşleştiği daha düşük çıkabilir.
Çalışmanın Yöntemi ve Bulguları
Veri seti ve veri hazırlama
| Özellik | Kaynakta verilen bilgi |
|---|---|
| Görüşme sayısı | 11 anonim yarı yapılandırılmış çevrim içi görüşme |
| Katılımcılar | Alman coğrafya öğretmenleri |
| Hizmet içi öğretmen | n = 9 |
| Öğretmen adayı | n = 2 |
| Görüşme konusu | Coğrafya dersinde stereotipleştirme |
| Transkripsiyon | noScribe 0.4.1 ve ardından iki tur manuel düzeltme |
| İnsan analizindeki kodlama birimi | 86 |
| İnsan analiz yazılımı | MAXQDA Analytics Pro 24.4.0 |
| ChatGPT sistemi | ChatGPT-5.2, 11 Aralık 2025 snapshot — kaynakta kullanılan adlandırma |
| Kodlama dili | Almanca |
| Final ChatGPT kod sistemi çevirisi | DeepL ile İngilizce, 8 Haziran 2026 |
İnsan içerik analizindeki 20 alt kod
| Ana kod | Alt kod | n |
|---|---|---|
| Stereotipleştirme örnekleri | Continents | 4 |
| Stereotipleştirme örnekleri | Country groups | 3 |
| Stereotipleştirme örnekleri | Students' background | 7 |
| Stereotipleştirme örnekleri | Countries | 8 |
| Stereotipleştirme örnekleri | Subject content | 13 |
| Stereotipleştirmenin nedenleri | Teachers (causes) | 2 |
| Stereotipleştirmenin nedenleri | Educational policy factors | 2 |
| Stereotipleştirmenin nedenleri | Geography-specific factors | 7 |
| Stereotipleştirmenin nedenleri | Students (causes) | 8 |
| Stereotipleştirmenin nedenleri | Sociocultural influences | 5 |
| Stereotipleştirmenin nedenleri | Resources: Textbooks | 6 |
| Stereotipleştirmeyle başa çıkma stratejileri | Perspective shift | 6 |
| Stereotipleştirmeyle başa çıkma stratejileri | Causal analysis | 3 |
| Stereotipleştirmeyle başa çıkma stratejileri | Student-oriented strategies | 4 |
| Stereotipleştirmeyle başa çıkma stratejileri | Teachers (strategies) | 3 |
| Stereotipleştirmeyle başa çıkma stratejileri | Teaching methods | 6 |
| Stereotipleştirmeyle başa çıkma stratejileri | Outside the classroom | 2 |
| Stereotipleştirmeyle başa çıkma stratejileri | Dialogue and reflection | 7 |
| Stereotipleştirmeyle başa çıkma stratejileri | Increasing complexity | 5 |
| Stereotipleştirmeyle başa çıkma stratejileri | Evidence-based working | 5 |
Kaynak Ek Tablo A1'de strateji alt kodlarının numaralandırılması 3.8'den doğrudan 3.10'a geçmektedir; 3.9 kodu gösterilmemiştir. Buna rağmen tablo toplam 20 alt kod raporlamaktadır. Verianla eksik numaranın hangi koda ait olduğunu tahmin etmemektedir.
Ek Tablo A1'deki toplam kod görülme sayısı 106'dır. Bu sayı 86 kodlama biriminden büyük olabilir; çünkü bir kodlama birimine birden fazla farklı kod atanabilir. Bu makaledeki karşılaştırmayı ChatGPT kodlamasına daha uyumlu hale getirmek için aynı kodun aynı kodlama birimi içindeki tekrarları en fazla 1 olarak sayılmıştır.
ChatGPT'nin oluşturduğu nihai kod sistemi
| Ana kod | Alt kod | Kodun kapsadığı temel fikir |
|---|---|---|
| Manifestations | Spatial and developmental stereotypes | Bölge ve toplumların homojen, geri veya tek boyutlu gelişmişlik imgeleriyle temsil edilmesi |
| Manifestations | Problem and deficit focus | Bölgelerin ağırlıklı olarak kriz, yoksulluk, çatışma veya eksiklik üzerinden sunulması |
| Manifestations | Social and origin stereotypes | Etnik köken, milliyet, sosyal arka plan veya yetenek üzerinden genelleyici atıflar |
| Manifestations | Migration and religion | Göç ve din gibi karmaşık alanların az sayıda özellik veya nedene indirgenmesi |
| Conditions of emergence | Didactic reduction and time pressure | Ders süresi ve öğretimsel sadeleştirmenin aşırı genellemeleri kolaylaştırabilmesi |
| Conditions of emergence | Material and textbook influence | Ders kitabı, görsel, karikatür veya müfredattaki temsillerin stereotipleri yeniden üretebilmesi |
| Conditions of emergence | Knowledge deficits as a breeding ground | Eksik alan bilgisinin karmaşık ilişkiler yerine basit açıklama şemalarına yöneltebilmesi |
| Conditions of emergence | Eurocentrism | Avrupa merkezli ölçütlerin başka bölgeleri değerlendirmede norm olarak kullanılması |
| Pedagogical strategies | Diagnostic assessment | Ders başında öğrencilerin mevcut düşünce ve imgelerinin belirlenmesi |
| Pedagogical strategies | Dialogue-based reflection and intervention | Genelleyici ifadelerin sorgulanması, tartışılması ve alternatif perspektiflerin sunulması |
| Pedagogical strategies | Perspective shift and irritation | Rol oynama veya alışılmış bakışı bozan yöntemlerle düşünsel perspektif değişiminin tetiklenmesi |
| Pedagogical strategies | Work with data and contextualization | İddiaların veri ve daha geniş bağlam kullanılarak sınanması |
| Pedagogical strategies | Making diversity and differentiation visible | Ülke, bölge ve grupların iç çeşitliliğinin görünür hale getirilmesi |
| Pedagogical strategies | Professional self-reflection | Öğretmenin kendi düşünsel kalıpları ve olası stereotipleri üzerine eleştirel düşünmesi |
Beş sentez çalıştırmasında kod sayıları
Beş ayrı sentez aynı sayıda alt kod üretmemiştir. Trial 1 ve Trial 5'te 16, Trial 2'de 18, Trial 3'te 24 ve Trial 4'te 20 alt kod oluşmuştur. Trial 4 ayrıca yalnız o çalıştırmada görülen “Perception and Evaluation” adlı üst düzey bir kod üretmiştir. Kod tek bir sentezde göründüğü için nihai 3/5 seçim kuralını geçememiştir.
Nihai kodlamanın çalıştırmadan çalıştırmaya kararlılığı
| Transkript | Jaccard |
|---|---|
| 1 | 0,88 |
| 2 | 0,77 |
| 3 | 0,79 |
| 4 | 0,84 |
| 5 | 0,91 |
| 6 | 0,91 |
| 7 | 0,83 |
| 8 | 0,78 |
| 9 | 0,86 |
| 10 | 0,87 |
| 11 | 0,66 |
| Genel | 0,83 |
En yüksek çalıştırmalar-arası Jaccard 5. ve 6. transkriptlerde 0,91; en düşük değer 11. transkriptte 0,66'dır. Genel değer 0,83'tür.
Bu tablonun anlamı özellikle sınırlandırılmalıdır: 0,83, ChatGPT'nin insan kodlamasına %83 uyduğu veya %83 doğru olduğu anlamına gelmez. Bu ölçüm yalnız aynı ChatGPT protokolünün bağımsız tekrarlarda ne kadar benzer kod atamaları yaptığıyla ilgilidir.
SBERT ısı haritasının ana mesajı
Kaynak ısı haritasında toplam 63 kod çiftinin kosinüs benzerliği 0,60 veya daha yüksek bulunmuştur. “Professional self-reflection”, “Didactic reduction and time pressure”, “Working with data and contextualization” ve “Perspective shift” gibi ChatGPT kodları insan kodlarıyla 0,70'in üzerinde benzerlikler göstermiştir.
Buna karşılık “Migration and religion” ile “Problem and deficit focus” gibi kodların insan sistemindeki en yakın karşılıkları görece daha zayıf semantik benzerlik göstermiştir.
Kaynak ısı haritasındaki bütün hücrelerin kesin sayısal değerlerini tablo halinde yayımlamamaktadır. Bu nedenle Verianla renklerden yaklaşık rakam türetip yeni bir sayısal matris oluşturmamaktadır.
Hungarian Algorithm ile bire bir eşleştirme sonuçları
| No. | ChatGPT kodu | İnsan içerik analizi kodu | Kosinüs benzerliği |
|---|---|---|---|
| 1 | Dialogue-based reflection and intervention | Dialogue and reflection | 0,81 |
| 2 | Perspective shift and irritation | Teaching methods | 0,78 |
| 3 | Making diversity and differentiation visible | Increasing complexity | 0,77 |
| 4 | Professional self-reflection | Teachers (strategies) | 0,77 |
| 5 | Diagnostic assessment | Outside the classroom | 0,73 |
| 6 | Work with data and contextualization | Evidence-based learning | 0,72 |
| 7 | Knowledge deficits as breeding ground | Educational policy factors | 0,71 |
| 8 | Spatial and developmental stereotypes | Continents | 0,69 |
| 9 | Social and origin stereotypes | Students' background | 0,66 |
| 10 | Didactic reduction and time pressure | Geography-specific factors | 0,65 |
| 11 | Material and textbook influence | Resources: Textbooks | 0,63 |
| 12 | Migration and religion | Sociocultural influences | 0,61 |
| 13 | Eurocentrism | Perspective shift | 0,60 |
| 14 | Problem and deficit focus | Country groups | 0,56 — eşik altında |
Son eşleşme 0,60 eşiğinin altında olduğu için sonraki kodlama-birimi Jaccard karşılaştırmasına dahil edilmemiştir.
İnsan içerik analizi ChatGPT sisteminden altı kod daha fazla içerdiğinden tam 14'lü bire bir atama içinde altı insan kodu eşleşmeden kalmıştır: Subject content, Countries, Teachers (causes), Students (causes), Causal analysis ve Student-oriented strategies.
Bu altı kodun niteliği çalışmanın yorumunda önemlidir. Bunların önemli bölümü coğrafyaya özgü içerik, sınıftaki belirli aktörler veya daha ince strateji ayrımlarıdır. Yazarlar bunu ChatGPT sisteminin geniş, genellenebilir örüntüleri yakalarken alan-özgü ve aktör-özgü ayrımları daha az ayrıntılandırdığı yönündeki bulguyla ilişkilendirmektedir.
Semantik eşleşme sonrası gerçek kodlama birimi örtüşmesi
| ChatGPT kodu | İnsan kodu | Jaccard |
|---|---|---|
| Dialogue-based reflection and intervention | Dialogue and reflection | 0,66 |
| Perspective shift and irritation | Teaching methods | 0,10 |
| Making diversity and differentiation visible | Increasing complexity | 0,66 |
| Professional self-reflection | Teachers (strategies) | 0,75 |
| Diagnostic assessment | Outside the classroom | 0 |
| Working with data and contextualization | Evidence-based working | 0,80 |
| Knowledge deficits as breeding ground | Educational policy factors | 0 |
| Spatial and developmental stereotypes | Continents | 0,33 |
| Social and origin stereotypes | Students' background | 0,38 |
| Complexity reduction and time pressure | Geography-specific factors | 0,33 |
| Material and textbook influence | Resources: Textbooks | 0,86 |
| Eurocentrism | Perspective shift | 0,14 |
| Migration and religion | Sociocultural influences | 0 |
| Küresel Jaccard | 13 eşleştirilmiş çiftin geneli | 0,39 |
Beş kod çiftinde Jaccard 0,60'ın üzerindedir. En yüksek değer “Material and textbook influence” ile “Resources: Textbooks” arasında 0,86'dır. Buna karşılık üç eşleşmede Jaccard sıfırdır.
Kaynağın sonuç metni düşük-orta grubu yaklaşık 0,30–0,40 olarak tanımlar. Kaynak ayrıca kalan beş çift için “J<0,14” ifadesini kullanmaktadır; ancak Tablo 7'de Eurocentrism–Perspective shift değeri tam 0,14'tür. Verianla tablo değerini değiştirmemektedir.
Tartışma bölümünde yüksek anlaşma aralığı bir yerde 0,66–0,89 olarak yazılmıştır; buna karşın Tablo 7'de gözlenen en yüksek değer 0,86'dır. Bu nedenle Verianla kesin nicel değerlerde Tablo 7'deki 0,86'yı kullanmaktadır.
Neden 0,78 semantik benzerlik 0,10 Jaccard ile birlikte görülebiliyor?
“Perspective shift and irritation” ile “Teaching methods” kavramsal tanımları birbirine oldukça yakın olduğundan kosinüs benzerliği 0,78'dir. Ancak insan ve ChatGPT sistemleri bu kavramları aynı görüşme pasajlarına çok az uygulamış ve Jaccard yalnız 0,10 olmuştur.
Buna karşılık “Dialogue-based reflection and intervention” ile “Dialogue and reflection” hem semantik düzeyde 0,81 gibi yüksek bir benzerliğe hem de kodlama birimlerinde 0,66 Jaccard örtüşmesine sahiptir. Dolayısıyla çalışmada semantik yakınlık ile metinsel uygulama örtüşmesi arasında zorunlu bire bir ilişki yoktur.
Ağ Yoğunluğu Benzerse İki Kod Sistemi Yapısal Olarak Aynı mıdır?
Hayır. İnsan ve ChatGPT ağlarının toplam yoğunluk ve kümeleşme değerleri birbirine yakın olsa da özvektör merkeziliğinin kodlar arasındaki dağılımı farklıdır; insan sisteminde yapısal önem daha fazla koda dağılırken ChatGPT sisteminde birkaç geniş kod merkezde yoğunlaşmıştır.
| Metrik | İnsan içerik analizi | ChatGPT |
|---|---|---|
| Ağ yoğunluğu | 0,40 | 0,36 |
| Yoğunluk için z | −0,60 | −1,66 |
| Yoğunluk için p | 0,611 | 0,154 |
| Küresel kümeleşme katsayısı | 0,56 | 0,61 |
| Kümeleşme için z | 0,34 | 1,19 |
| Kümeleşme için p | 0,683 | 0,239 |
Yazarların yorumuna göre her iki ağın yoğunluk ve küresel kümeleşme değerleri kendi null modellerinden anlamlı biçimde ayrılmamıştır. Kaynak yöntem bölümünde ayrıca %95 null aralıklarının hesaplandığını belirtmesine rağmen ana sonuçlarda bu aralıkların sayısal alt ve üst sınırlarını raporlamamaktadır.
Kaynak bu ağ karşılaştırması için ayrı bir alfa eşiğini açıkça yazmamaktadır; Verianla dolayısıyla kaynakta olmayan bir anlamlılık eşiği eklememektedir. Yazarların kendi sonuç yorumu, raporlanan p-değerleri üzerinden global yoğunluk ve kümeleşmenin null beklentiyi aşmadığı yönündedir.
Özvektör merkeziliği farklı resmi gösteriyor
İnsan içerik analizi ağında en merkezi kod Subject content, EV = 1,00, ikinci en merkezi kod Continents, EV = 0,71'dir. Kaynak ayrıca Students (causes), Resources: Textbooks ve Teaching methods kodlarının da görece yüksek merkezilik gösterdiğini belirtmektedir.
ChatGPT ağında ise Spatial and developmental stereotypes, EV = 1,00; Problem and deficit focus, EV = 0,91 ve Material and textbook influence, EV = 0,90 değerleriyle birkaç kod belirgin biçimde merkezde yoğunlaşmıştır.
Null-model sonuçları ne anlama geliyor?
Global ağ yoğunluğu ve kümeleşme için null-model p-değerlerinin yüksek olması, gözlenen global bağlantılılık ve kümeleşmenin yalnız kodların frekansları ile kodlama birimi başına kod sayıları korunarak oluşturulan rastgele ağlardan açık biçimde ayrılmadığını göstermektedir.
Ancak bu sonuç “iki ağ aynı” anlamına gelmez. Global iki sayı benzer olsa bile hangi kodların merkezde olduğu, hangi kavramların birbiriyle bağlantı kurduğu ve yapısal önemin kodlar arasında nasıl dağıldığı farklı olabilir. Çalışmanın EV-merkezilik bulgusu tam olarak bu daha yerel yapısal farkı göstermektedir.
Nitel değerlendirme: yapısal bileşim
ChatGPT'nin oluşturduğu sistem istenen tablo biçimini ve üç ana kavramsal alanı büyük ölçüde korumuştur. Semantik eşleştirmelerin 13'ünün 11'inde kodlar aynı genel ana tema düzeyinde karşılık bulmuştur: stereotip örnekleri ChatGPT'nin manifestations alanına, nedenler conditions of emergence alanına ve stratejiler pedagogical strategies alanına karşılık gelmiştir.
İki eşleşme ana tema düzeyini aşmıştır: Migration and religion ile Sociocultural influences; Eurocentrism ile Perspective shift. Yazarlar bunun Hungarian Algorithm'in bire bir eşleştirme zorunluluğunun olası bir yan etkisi olabileceğini belirtmektedir. Çünkü algoritma toplam benzerliği global olarak en yüksek yaparken her kodun yalnız bir eşleşme almasına izin verir; bazı kodların en doğal partnerleri daha önce başka eşleşmelere ayrılmış olabilir.
Nitel değerlendirme: granülerlik ve alan-özgüllük
İnsan içerik analizi ChatGPT'den altı fazla alt kategori üretmiştir. Özellikle insan sisteminde bulunan Subject content kodunun ChatGPT sisteminde karşılığı olmaması dikkat çekicidir; çünkü Subject content insan ağının hem en sık kodlarından biri hem de EV = 1,00 ile en merkezi düğümüdür.
İnsan sistemi Continents, Countries ve Country groups gibi daha ince mekânsal ayrımlar yaparken ChatGPT bunları daha geniş Spatial and developmental stereotypes kategorisi altında birleştirmiştir.
Yazarların değerlendirmesine göre ChatGPT güçlü biçimde tekrar eden genel örüntüleri yakalayabilmektedir; fakat bu veri setinde coğrafya eğitimine özgü ayrımlar daha az belirgin temsil edilmiştir.
Nitel değerlendirme: nedenleri açıklamada aktörler
İnsan içerik analizinde stereotipleştirmenin nedenleri öğretmenler, öğrenciler, sosyal arka plan, dersin konu yapısı, ders kitapları ve eğitim politikası gibi farklı aktör ve yapısal düzeylere ayrılmıştır.
ChatGPT sisteminde ise nedenler daha fazla yapısal koşullara yoğunlaşmış; öğretmen ve öğrenci gibi sınıfın temel aktörleri ayrı neden kategorileri olarak insan sistemindeki kadar belirgin temsil edilmemiştir.
Özellikle Students (causes) insan ağında yapısal olarak önemli bir koddur; ChatGPT'de öğrenci boyutu büyük ölçüde Knowledge deficits as a breeding ground içinde daha sınırlı biçimde görünmektedir. Çalışma bu nedenle insan analizinin söz konusu araştırma sorusu açısından daha farklılaşmış bir aktör yapısı sunduğunu ileri sürmektedir.
Her iki sistemde ortak olan daha üst düzey desen
Her iki ağda da stereotipleştirmenin örnekleri ve nedenleriyle ilgili kodlar daha merkezi konumlarda bulunma eğilimindedir. Pedagojik strateji kodları ise genel olarak daha düşük merkezilik ve daha az bağlantı göstermektedir.
Bu bulgu her iki analiz yaklaşımının da veri setinde “fenomen nedir ve neden ortaya çıkıyor?” sorularını “nasıl müdahale ediliyor?” sorusundan yapısal olarak daha merkezî biçimde temsil ettiğini düşündürmektedir. Bu, kaynak yazarlarının ağ yapısından yaptığı yorumdur; nedensel bir mekanizma kanıtı değildir.
Çalışmanın desteklediği sonuçlar
- Yapılandırılmış, iteratif promptlama altında ChatGPT tekrarlar arasında görece kararlı bir kodlama sistemi üretebilmiştir.
- Beş bağımsız kodlama çalıştırmasında genel run-to-run Jaccard 0,83'tür.
- ChatGPT ve insan kod sistemleri arasında birçok orta-yüksek semantik benzerlik bulunmuştur.
- 0,60 eşik üzerinde 13 bire bir kod eşleşmesi sonraki karşılaştırmaya alınmıştır.
- Semantik olarak benzer kodların aynı metin parçalarını kodlaması garanti değildir; global Jaccard 0,39'dur.
- ChatGPT sistemi daha geniş kod kategorilerine yönelirken insan içerik analizi daha ince ve alan-özgü ayrımlar üretmiştir.
- İki ağın global yoğunluğu ve kümeleşmesi benzer görünürken merkezilik dağılımları farklıdır.
- Bu veri setinde ChatGPT ağının yapısal önemi daha az sayıda baskın kodda yoğunlaşmıştır.
- İnsan içerik analizinde coğrafyaya özgü ve aktör-özgü kavramlar daha görünürdür.
- LLM çıktılarının eleştirel insan incelemesi çalışma tarafından gerekli görülmektedir.
Çalışmanın desteklemediği sonuçlar
- ChatGPT'nin bütün nitel araştırmalarda insan kodlamasıyla eşdeğer olduğu sonucu çıkarılamaz.
- Jaccard 0,83, insan kodlamasına karşı %83 doğruluk anlamına gelmez.
- Kosinüs benzerliğinin yüksek olması aynı metin pasajlarının kodlandığını kanıtlamaz.
- Global ağ yoğunluğunun yakın olması iki kod sisteminin kavramsal yapısının aynı olduğunu göstermez.
- İnsan içerik analizi bu çalışmada nesnel ve tek mümkün “ground truth” olarak tanımlanmamıştır.
- 11 görüşmeyle elde edilen sonuçlar bütün disiplinlere, bütün LLM'lere veya bütün nitel veri türlerine genellenemez.
- Sonuçlar genel ve yapılandırılmamış ChatGPT kullanımını değil, araştırmadaki ayrıntılı ve iteratif prompt protokolünü temsil eder.
- Çalışma LLM'nin kod kategorilerini içeride hangi bilişsel veya algoritmik mekanizmayla oluşturduğunu açıklamaz.
LLM'nin “kara kutu” problemi
İnsan nitel analizinde araştırmacı hangi kodlama birimlerini karşılaştırdığını, bir kodu neden böldüğünü veya iki kodu hangi kavramsal gerekçeyle birleştirdiğini adım adım belgeleyebilir. LLM'nin iç işleminde ise geniş kategorilerin insan analizindeki gibi iteratif kavramsal soyutlama yoluyla mı, yoksa farklı bir istatistiksel örüntü tanıma mekanizmasıyla mı oluştuğu doğrudan gözlenemez.
Çalışma bu nedenle iki sistem arasında semantik yakınlık bulunmasına rağmen neden bazı kodlama birimlerinin çok farklı seçildiğini bütünüyle açıklayamamaktadır. Kod granülerliği bunun bir bölümünü açıklayabilir; ancak yazarlar bunun tüm farkı açıklamadığını belirtmektedir.
Prompt duyarlılığı
LLM çıktısı kullanılan istem yapısına duyarlıdır. Bu araştırmada promptlar rol tanımı, talimat, bağlam, tekrar, sentez ve araştırma sorularına yönlendirme gibi öğelerle iteratif biçimde rafine edilmiştir.
Dolayısıyla sonuçların “ChatGPT'nin doğal ve değişmez kodlama davranışı” biçiminde yorumlanması doğru değildir. Farklı prompt yapıları başka kod sistemleri oluşturabilir. Çalışma bunu gelecek araştırmalar için açık bir inceleme alanı olarak bırakmaktadır.
Temel sınırlılıklar
Küçük ve konuya özgü veri seti: Çalışma yalnız 11 görüşmeye ve coğrafya dersinde stereotipleştirme gibi yorum bakımından hassas tek bir konuya dayanmaktadır. Daha büyük ve farklı disiplinlerdeki veri setlerinde aynı örüntülerin ortaya çıkıp çıkmayacağı bilinmemektedir.
Prompt duyarlılığı: Ayrıntılı ve tekrarlı prompt mühendisliği kullanılmış olmasına rağmen alternatif promptlar farklı kategori yapıları üretebilir.
Eşleştirme yöntemine bağımlılık: Hungarian Algorithm tekrar üretilebilir bir bire bir eşleme sağlamaktadır; ancak başka eşleştirme yöntemleri farklı kod çiftlerini karşı karşıya getirebilir ve karşılaştırma sonuçlarını bir miktar değiştirebilir.
Nitel analizin yorumlayıcı doğası: Aynı materyalden birden fazla bilimsel olarak savunulabilir kod sistemi ortaya çıkabilir. Bu nedenle insan sistemi ile ChatGPT sistemi arasındaki fark tek başına “ChatGPT hatası” olarak okunamaz.
LLM iç sürecinin gözlenememesi: Çalışma modelin kategori sentezleme sürecini içsel olarak izleyememektedir. Kodların hangi ara karar zinciriyle geniş veya dar hale geldiği tam olarak açıklanamaz.
Alan-özgü bağlam: Bu veri setinde insan sistemi coğrafya eğitimiyle doğrudan ilişkili daha ince kodlar üretmiştir. Bunun bütün alanlarda aynı biçimde gerçekleşeceği çalışmada test edilmemiştir.
Kaynak ve Yöntem Notu
Özgün başlık: Evaluation of Inductive Coding with LLMs
Yazarlar: Leoni Dörfel, Rieke Ammoneit.
Yazar sırası: Kaynaktaki sıra aynen korunmuştur.
Eş katkı: Kaynakta eş birinci yazarlık veya eş katkı bildirimi bulunmamaktadır.
Sorumlu yazar: Leoni Dörfel.
Kurum: Department for Mathematics and Science Education, Institute for Geography Education, University of Cologne, Gronewaldstraße 2, 50931 Cologne, Germany.
Dergi: Education Sciences.
Yayıncı: MDPI.
Cilt / sayı / makale numarası: 16(8), 1314.
DOI: 10.3390/educsci16081314.
Resmî DOI bağlantısı: https://doi.org/10.3390/educsci16081314
Gönderim: 14 Temmuz 2026.
Revizyon: 7 Ağustos 2026.
Kabul: 13 Ağustos 2026.
Yayın: 17 Ağustos 2026.
Kaynak türü: Hakemli araştırma makalesi. Yöntemsel olarak nitel içerik analizi, LLM destekli indüktif kodlama, NLP tabanlı semantik analiz, kodlama-birimi örtüşme analizi, ağ analizi ve nitel karşılaştırmayı birleştiren karma yöntemli metodolojik değerlendirmedir.
Lisans: Creative Commons Attribution (CC BY).
Finansman: Araştırma dış finansman almamıştır.
Kurumsal etik açıklaması: Çalışma daha önce toplanmış, tamamen anonimleştirilmiş görüşme transkriptlerini yeniden analiz etmektedir. Kaynak, mevcut analizde kişileri tanımlayıcı bilgi bulunmadığını ve yeniden kimliklendirme yapılamadığını belirtmektedir.
Bilgilendirilmiş onam: İlk görüşmelere katılan bütün katılımcılardan bilgilendirilmiş onam alınmıştır.
Veri erişilebilirliği: Veri, R betikleri ve analizlerin ham verileri Zenodo üzerinde yayımlanmıştır. Veri DOI'si: 10.5281/zenodo.21108082.
Yapay zekâ kullanım beyanı: Yazarlar çalışma sırasında nitel kodlama çıktıları üretmek için ChatGPT'nin kaynakta “GPT-5.2, 11 December 2025 snapshot” olarak belirtilen sürümünü kullanmıştır. Yapay zekâ çıktılarının araştırmacılar tarafından eleştirel biçimde incelendiği, doğrulandığı ve yorumlandığı; yayın içeriğinin sorumluluğunun yazarlara ait olduğu belirtilmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir.
Yazar katkıları: Kavramsallaştırma Leoni Dörfel ve Rieke Ammoneit; yöntem Leoni Dörfel ve Rieke Ammoneit; yazılım Leoni Dörfel; doğrulama Leoni Dörfel; biçimsel analiz Leoni Dörfel; veri kürasyonu Leoni Dörfel; ilk taslak Leoni Dörfel; görselleştirme Leoni Dörfel; danışmanlık Rieke Ammoneit; proje yönetimi Leoni Dörfel.
Kullanılan başlıca teknik araçlar: noScribe 0.4.1, MAXQDA Analytics Pro 24.4.0, ChatGPT-5.2 kaynakta belirtilen 11 Aralık 2025 snapshot, SBERT paraphrase-multilingual-MiniLM-L12-v2, Hungarian Algorithm, Jaccard Index, R, igraph, vegan Curveball null modeli ve ggplot2.
Kaynak içi tutarsızlık 1: Tablo 7'de en yüksek kod-çifti Jaccard değeri 0,86'dır; tartışma bölümünde ise yüksek örtüşme aralığının üst sınırı 0,89 olarak yazılmıştır. Verianla kesin değer olarak tabloyu korur.
Kaynak içi tutarsızlık 2: Sonuç metni kalan beş düşük örtüşmeli kod çiftini J<0,14 olarak tanımlarken Tablo 7'de Eurocentrism–Perspective shift çifti tam 0,14'tür.
Kaynak içi tutarsızlık 3: Ek Tablo A1 strateji kodlarını 3.8'den 3.10'a geçirir; 3.9 kodu gösterilmez. Verianla eksik numaranın içeriğini tahmin etmez.
Kaynak içi adlandırma farkı: İnsan kodlarından biri Tablo 6'da “Evidence-based learning”, Tablo 7 ve Ek Tablo A1'de “Evidence-based working” olarak görünmektedir. Benzer biçimde ChatGPT'nin “Didactic reduction and time pressure” kodu Tablo 7'de “Complexity reduction and time pressure” biçiminde yazılmıştır. Bu farklılıklar yeni kodlar olarak yorumlanmamıştır.
Araştırma sorusu ifadesine ilişkin kaynak sınırı: Yöntem bölümündeki özgün görüşme verisi iki içerik araştırma sorusu etrafında toplanmıştır. Kaynağın bazı sonuç/sonuç cümleleri üç ana ChatGPT kodunun “RQ1–3” ile ilişkili olduğunu ifade etmektedir; ancak makalenin üç metodolojik RQ'su kodların içerik alanlarını değil iki kodlama sisteminin karşılaştırılmasını sorgulamaktadır. Verianla bu ifadeyi üç ayrı özgün görüşme araştırma sorusu varmış gibi genişletmez.
Ana yorum sınırı: Çalışmanın bulguları belirli bir görüşme veri seti, belirli bir ChatGPT snapshot'ı, belirli prompt protokolü ve belirli karşılaştırma yöntemleri altında elde edilmiştir. Sonuçlar bütün LLM'lerin veya bütün nitel araştırma bağlamlarının genel performans ölçüsü değildir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir