


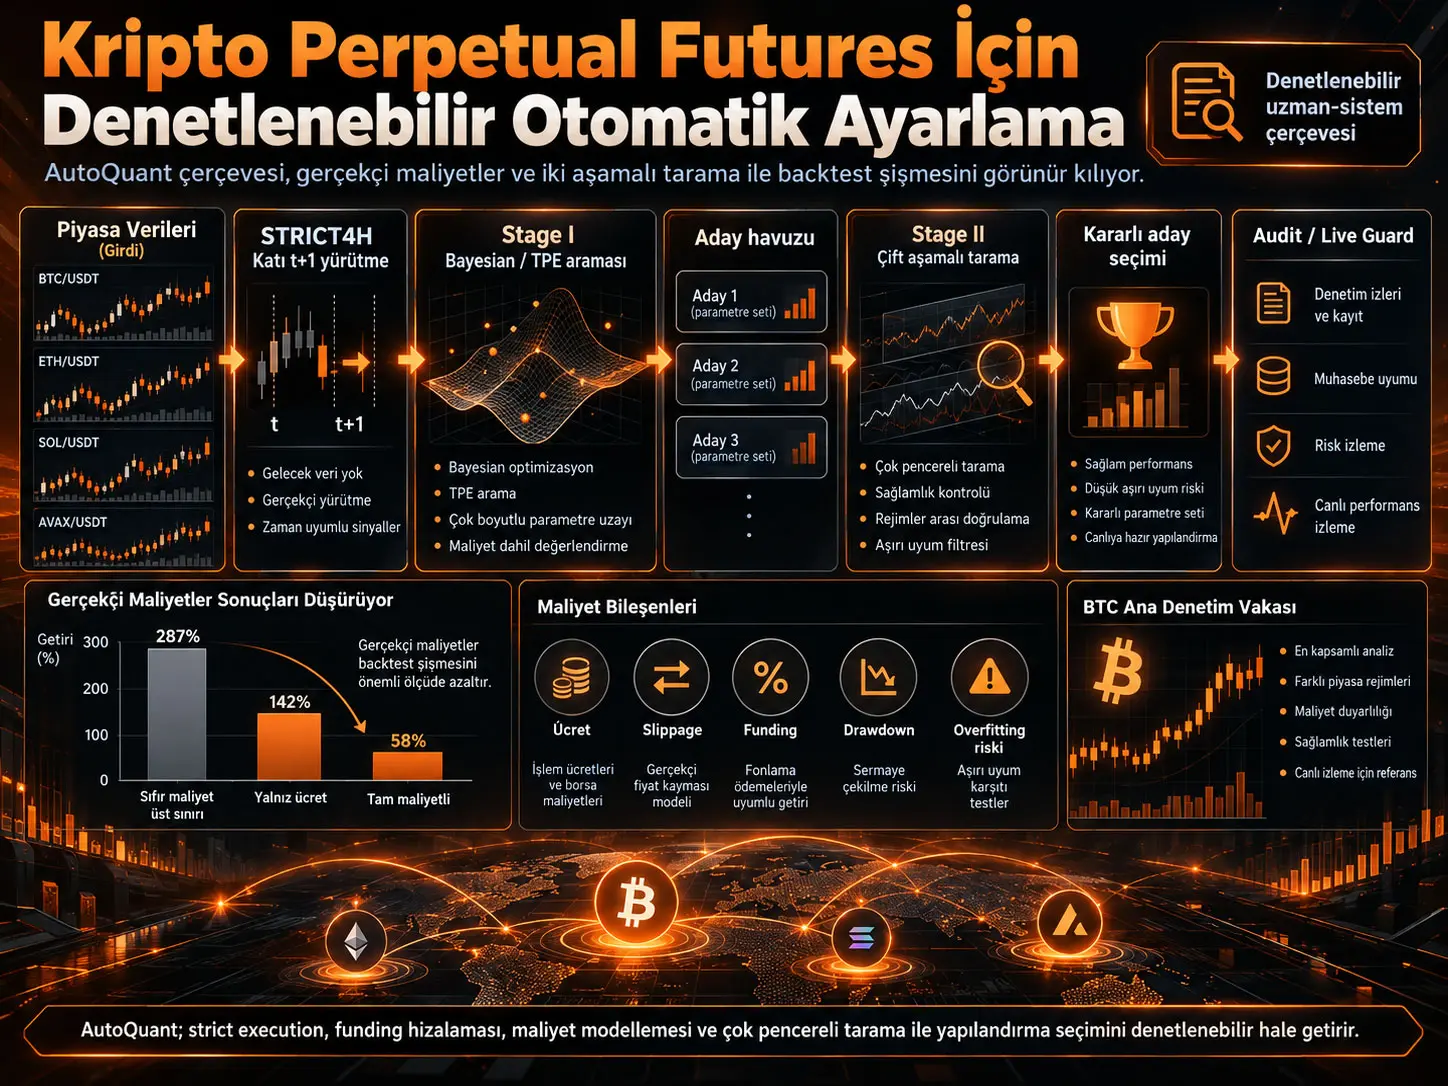
AutoQuant, kripto para perpetual futures stratejilerinde yeni bir alım-satım sinyali üretmek yerine, önceden belirlenmiş bir sinyal ailesinin parametrelerini gerçekçi yürütme ve maliyet kuralları altında seçen, yeniden değerlendiren ve denetlenebilir biçimde kaydeden bir karar-destek çerçevesidir. Sistem, STRICT4H adı verilen katı 4 saatlik yürütme semantiğini, gelecekteki funding bilgisinin kullanılmasını engelleyen zaman hizalamasını, ücret ve slippage maliyetlerini, kaldıraç ve notional sınırlarını, Bayesian/TPE parametre aramasını ve iki aşamalı robustness screening sürecini aynı pipeline içinde birleştirir.
Çalışma BTC/USDT, ETH/USDT, SOL/USDT ve AVAX/USDT perpetual futures sözleşmelerini inceler. BTC ana denetim vakasıdır; diğer üç varlık aynı pipeline'ın farklı piyasalara uygulanabilirliğini sınamak için kullanılır. Stage I yalnız training penceresinde parametre adayları üretir. Stage II aynı adayları validation pencereleri ve maliyet senaryolarında tekrar değerlendirir. Long-horizon ve blind hold-out pencereleri ise parametre seçimi için kullanılmayan ek stress testleridir.
En belirgin sonuç, backtest maliyetlerinin çıkarılmasının görünür performansı ciddi biçimde büyütebilmesidir. BTC stress-test yapılandırmasında tam maliyetli koşulda yıllıklandırılmış CAGR 2,726 iken yalnız işlem ücretinin hesaba katıldığı koşulda 4,308'e, bütün fees/slippage/funding maliyetlerinin kaldırıldığı iyimser üst sınırda 5,225'e yükselmektedir. Bu değerler gerçek ölçeklenebilir yatırım getirisi olarak değil, backtest'in maliyet varsayımlarına ne kadar duyarlı olabileceğini gösteren tanısal sonuçlardır.
İki aşamalı seçim de otomatik olarak daha yüksek getiri üretmemektedir. BTC örneğinde one-stage top-1 yapılandırması çoğu pencerede daha yüksek getiri gösterirken, two-stage seçim daha düşük drawdown ve daha sınırlı ekstrem performans üretmektedir. Benzer risk kontrolü davranışı bazı ETH, SOL ve AVAX deneylerinde de görülür. Buna karşılık sonuçlar bütün varlıklarda ve bütün dönemlerde aynı değildir.
Önemli bir sınırlılık, pipeline'ın aşırı uyum riskini tamamen ortadan kaldırmamasıdır. BTC aday havuzunda CSCV/PBO tahmini 0,586'dır. Uzun pencere DSR-style kontrolü de Sharpe açısından güçlü bir kalıcı alpha kanıtı sunmamaktadır. Bu nedenle AutoQuant'ın ana katkısı “kârlı strateji bulmak” değil, hangi varsayımlarla hangi yapılandırmanın seçildiğini izlenebilir ve denetlenebilir hale getirmektir.
AutoQuant Nedir ve Ne Yapmaz?
AutoQuant, bir trading strategy generator veya piyasa yönünü tahmin eden yeni bir alpha modeli değildir; sabit bir sinyal ailesinin parametrelerini strict execution, funding visibility, transaction cost ve risk kısıtları altında tarayan, robustness kontrollerinden geçiren ve her seçimin yeniden üretilebilir denetim izini oluşturan execution-aware configuration-selection sistemidir.
Kripto perpetual futures backtest'i neden özellikle kırılgandır?
Perpetual futures sözleşmelerinde yalnız fiyat yönünü doğru tahmin etmek yeterli değildir. Stratejinin gerçek sonucu; işlem ücreti, slippage, funding payment, kaldıraç, notional cap, pozisyon değişim sıklığı ve işlemin hangi bar üzerinde yürütüldüğü gibi mikro-yapısal ayrıntılardan etkilenir.
Örneğin bir sinyal 4 saatlik barın kapanışında hesaplanmışsa aynı barın fiyat hareketinden faydalanmasına izin vermek gelecekteki bilgiyi geçmiş kararın içine sokabilir. Benzer biçimde, funding rate henüz piyasada yayımlanmamışken geçmiş bir bara geriye doğru uygulanırsa backtest gerçek zamanda mevcut olmayan bilgiyi kullanmış olur.
AutoQuant'ın temel yaklaşımı bu ayrıntıları kullanıcının dikkatine bırakmak yerine sistem davranışının açık kurallarına dönüştürmektir.
Çalışmanın üç ana ampirik sorusu
| Soru | İncelenen problem |
|---|---|
| 1 | Maliyetler ve kısıtlar kaldırıldığında backtest performansı ne kadar şişebilir? |
| 2 | Stage I aramasından ayrı tutulup Stage II seçiminde yeniden kullanılan validation penceresine karşı parametreler ne kadar kırılgandır? |
| 3 | Ücret, funding ve slippage varsayımlarındaki değişiklikler apparent profitability ve robustness yorumlarını nasıl etkiler? |
Expert-system benzeri yapı
| Katman | AutoQuant içindeki karşılığı | Görev |
|---|---|---|
| Knowledge base | STRICT4H execution semantics, funding alignment, maliyet ve kısıt profilleri, screening politikaları | Look-ahead ve fizibilite hatalarını açık kurallarla sınırlar. |
| Inference engine | Stage I TPE Bayesian search + Stage II double screening | Aday yapılandırmaları üretir ve robustness kriterlerine göre seçer. |
| Explanation interface | Makine-okunur artifact'lar, ledger'lar, accounting invariants | Seçim ve performans hesaplarının yeniden oluşturulmasını sağlar. |
| Governance overlay | Live Guard ve invariant monitoring | Dağıtım sonrası drift ve risk durumlarını gözetir. |
Şekil 1'in bilimsel mesajı
Kaynağın 10. sayfasındaki yöntem akışı, verinin ve cost model'in Stage I Bayesian Search'e girdiğini, buradan candidate pool üretildiğini ve adayların Stage II STRICT4H double screening'e taşındığını gösterir. Screening sonrası yalnız stable candidates kalır. Bunlar post-deployment guard tarafından izlenirken accounting invariants bağımsız denetim yolunu oluşturur.
Bu şeklin önemli noktası, optimizasyon ve denetimin aynı şey olmamasıdır. Stage I en yüksek objective değerini ararken Stage II bu sonucu zaman ve maliyet perturbasyonlarına karşı sınar.
STRICT4H Neden AutoQuant'ın Merkezindedir?
STRICT4H, sinyalin 4 saatlik bar kapanışında hesaplandığı fakat pozisyonun ancak sonraki bar olan \(t+1\)'den itibaren uygulanabildiği; funding bilgisinin de yalnız o anda gerçekten bilinen zaman damgalarından ileri taşındığı katı yürütme protokolüdür.
Signal-modular yapı
Çerçeve, temel sinyal üreticisini matematiksel olarak:
\[ f:I_t\times\Theta\rightarrow S_t \]
biçiminde ele alır. Burada \(I_t\), \(t\) zamanında gerçekten erişilebilir bilgi kümesi; \(\Theta\), hiperparametre uzayı; \(S_t\in\{-1,0,1\}\) ise short, flat veya long hedef sinyaldir.
AutoQuant bu \(f\) fonksiyonunu kendiliğinden icat etmez. Araştırmadaki özgün deneyler STRICT4H momentum, mean-reversion ve breakout/gating mantığına sahip sabit bir sinyal ailesini kullanır.
Momentum skoru
Kaynakta EMA farkından türetilen momentum skoru:
\[ m_t(\theta_{\mathrm{momentum}}) = \frac{1}{2} \left[ 1+ \tanh \left( \frac{ EMA_{\mathrm{fast},t}-EMA_{\mathrm{slow},t} }{ \sigma(\theta_{\mathrm{momentum}}) EMA_{\mathrm{slow},t} } \right) \right] \]
şeklindedir. Hızlı ve yavaş EMA arasındaki normalize fark tanh dönüşümüyle \([0,1]\) aralığına sıkıştırılır. \(\theta_{\mathrm{momentum}}\) volatilite ölçekleme davranışını kontrol eder.
Birleşik skor
\[ C_t= w_{\mathrm{mom}}m_t+ (1-w_{\mathrm{mom}})a_t \]
Burada \(a_t\), etkin mean-reversion/anomaly alt skorlarının birleşimi; \(w_{\mathrm{mom}}\) momentum kanalının ağırlığıdır.
Kaynak uygulamasında anomaly score, etkin alt skorların maksimumu olarak kullanılır. Böylece sistem trend-momentum bilgisi ile Bollinger-band veya tail-exceedance benzeri tersine dönüş sinyallerini ortak eşik mekanizmasına taşır.
Sinyal kararı
Birleşik skor belirlenen long ve short eşiklerine göre:
\[ Signal_t= \begin{cases} +1, & C_t\geq\tau_t^{long}\\ -1, & C_t\leq1-\tau_t^{short}\\ 0, & \text{diğer durumlarda} \end{cases} \]
biçiminde pozisyon yönüne dönüştürülür.
Funding yalnız maliyet değil, karar girdisi de olabilir
Long tarafta adverse funding koşullarında giriş eşiği artırılabilir:
\[ \tau_{\mathrm{long}}(t) = \tau_{\mathrm{base}} + \kappa \max \left( |fr_t|-\frac{\vartheta_{\mathrm{bias}}}{10000}, 0 \right) \]
Burada \(fr_t\), 8 saatlik funding rate; \(\vartheta_{\mathrm{bias}}\) funding-bias aktivasyon eşiği; \(\kappa\) ise funding kötüleştikçe giriş eşiğinin ne hızla yükseleceğini belirler.
Funding rate 4 saatlik grid'e carry-forward yöntemiyle hizalanır. Gelecekte açıklanacak funding değerlerinin eski barlara backfill edilmesine izin verilmez.
Çalışmanın Yöntemi ve Bulguları
Stage I: Bayesian/TPE parametre araması
Stage I, training penceresinde Tree-structured Parzen Estimator (TPE) kullanarak aday parametre setleri üretir. Amaç fonksiyonu cost-adjusted yıllıklandırılmış net getiridir:
\[ \max_{\theta\in\Theta}J(\theta), \qquad J(\theta)=r_{\mathrm{ann}}(\theta) \]
4 saatlik barlardan yıllıklandırılmış getiri:
\[ r_{\mathrm{ann}} = (1+R_{\mathrm{tot}})^{AF/N}-1 \]
olarak hesaplanır. Kaynakta yıllıklaştırma faktörü:
\[ AF=6\times365=2190 \]
olarak alınmıştır; çünkü günde altı adet 4 saatlik dönem vardır.
BTC temel çalışmasında hesaplama-kısıtlı örnek için 40 TPE trial kullanılmış; doğrudan karşılaştırma tablolarında aramanın yetersiz kalmasını azaltmak amacıyla 120 trial'a kadar genişletilmiştir. Best-so-far objective 10 trial'da 0,0174, 40 trial'da 0,1172 ve 100–120 trial civarında 0,1590'a ulaşmıştır. Kaynak bu nedenle 40 trial'ı global optimuma yakınsamış bir arama olarak değil, compute-limited örnek olarak yorumlar.
Stage II: Double screening
Stage I sonrası yeni bir optimizasyon yapılmaz. Sabit aday havuzu farklı dönemler ve cost scenarios altında tekrar çalıştırılır.
BTC örneğinde rolling değerlendirmeler 2000 barlık pencerelerle ve 500 bar adımla yapılmıştır. Cost-grid ise:
Taker fee: 3, 4 ve 6 bps
Funding multiplier: 0,5; 1,0 ve 1,5
olmak üzere dokuz kombinasyon içerir.
Stable candidate seçim kriterleri
| Metrik | Eşik | Amaç |
|---|---|---|
| mean_monthly_true | ≥ 0,005 | Minimum performans |
| min_monthly_true | ≥ 0,0 | Kötü senaryo tabanı |
| maxDD_mean | ≤ 0,30 | Drawdown sınırı |
| switch_density_mean | ≤ 0,12 | Turnover ve kırılganlık sınırı |
Filtreyi geçen adaylardan ilk beş yapılandırma, ortalama aylık geometrik getiri azalan ve MaxDD artan sıralamayla seçilir.
Training, validation ve blind hold-out birbirinden farklıdır
| Pencere | BTC tarih aralığı | Rol |
|---|---|---|
| Training | 2019-09-08 – 2021-01-01 | Stage I parametre üretimi |
| Validation | 2021-01-01 – 2023-01-01 | Stage II screening ve seçim |
| Long-horizon | 2019-09-08 – 2025-10-14 | DSR ve uzun dönem stress testleri |
| Blind Post-ETF | 2024-01-01 – 2025-10-14 | Seçimde hiç kullanılmayan post-hoc robustness testi |
Validation penceresinin Stage I için out-of-sample olması, onu bütün pipeline açısından tamamen dokunulmamış final test seti yapmaz. Çünkü Stage II aday seçiminde bu pencere yeniden kullanılmaktadır. Çalışmanın metodolojik olarak özellikle görünür kıldığı noktalardan biri budur.
Veri kaynakları ve frekans
Bütün temel deneyler 4 saatlik OHLCV serileri üzerinde yürütülmüştür. BTC/USDT için ana veri kaynakları Binance, Bybit ve OKX gibi merkezi borsalardır. Funding rate serileri 8 saatlik frekanstadır ve 4 saatlik zaman eksenine carry-forward yöntemiyle hizalanmıştır.
BTC core sample 2019-09-08–2021-12-31 döneminde 5.069 non-overlapping 4 saatlik getiri içerir. Extended BTC long sample ise 2019-09-08–2025-10-14 döneminde 13.368 getiri içerir.
ETH verisi 2021-12-31–2025-11-24; SOL ve AVAX serileri 2021-01-01–2025-12-16 dönemlerini kapsar.
OHLCV verisine boşluk doldurma yapılmıyor
Eksik OHLCV barlarına interpolation veya forward-fill uygulanmaz. Temel veri setinde continuity tolerance tipik olarak sıfırdır; eksik bar bulunursa pipeline veri kaynağını reddedebilir.
Funding ayrı bir external series olarak ele alınır. Gerçek funding değerinin bulunmadığı kısımlarda sıfırla doldurma yapılmaz; conservative fallback funding assumption kullanılır ve duyarlılık Stage II funding-multiplier senaryolarıyla incelenir.
Net getiri nasıl hesaplanıyor?
Executed exposure \(\pi_t\), önceki barın sinyalinden türetilir. Raw return:
\[ r_t^{raw}=\pi_t r_t^{mkt} \]
olarak tanımlanır.
Net getiri:
\[ r_t^{net} = r_t^{raw} - C_{\mathrm{fee},t} - C_{\mathrm{slip},t} - C_{\mathrm{fund},t} \]
şeklindedir.
Bu ayrıştırma auditability için önemlidir; çünkü net performansın hangi bölümünün fiyat hareketinden, hangisinin fee, slippage veya funding'den geldiği bar bazında yeniden oluşturulabilir.
BTC temel maliyet profili
| Parametre | Değer |
|---|---|
| Başlangıç özsermayesi | 10.000 USDT |
| Maksimum kaldıraç | 5× |
| Notional cap | 50.000 USDT |
| Taker fee | 4 bps |
| Base slippage | 2 bps |
| Fallback funding | 1 bps / 8 saat |
Gerçek funding verisi mevcut olduğunda fallback oran yerine gerçek 8 saatlik funding serisi kullanılır.
Gerçekçi İşlem Maliyetleri Backtest Sonucunu Ne Kadar Değiştirdi?
BTC/USDT core stress-test'inde aynı temel parametreler altında fees, slippage ve funding birlikte hesaba katıldığında yıllıklandırılmış CAGR 2,726 iken fee-only koşulda 4,308'e, bütün işlem maliyetleri kaldırılan zero-cost üst sınırda 5,225'e çıkmıştır; kaynak bu farkı gerçek ölçeklenebilir getiri değil, backtest maliyet duyarlılığı olarak yorumlamaktadır.
| Koşul | Yıllık CAGR | Sharpe | MaxDD | İşlem |
|---|---|---|---|---|
| Tam maliyetli: fees + slippage + funding | 2,726 | 2,049 | 0,265 | 636 |
| Standard: fee-only | 4,308 | 2,506 | 0,262 | 636 |
| Naive: zero-cost üst sınır | 5,225 | 2,711 | 0,260 | 535 |
Naive yapılandırmada işlem sayısının değişebilmesi önemlidir. Funding-aware gating gibi karar kanalları maliyet/funding girdilerinden etkilendiği için maliyet bileşenlerinin kaldırılması yalnız son PnL hesabını değil, bazı durumlarda trade sequence'i de değiştirebilir.
Two-Stage Screening Daha Fazla Kâr mı Üretiyor?
Hayır; çalışmanın ana iddiası daha yüksek getiri garantisi değildir. BTC örneğinde two-stage seçim training, validation ve blind Post-ETF dönemlerinde one-stage top-1'den daha düşük aylık geometrik getiri üretirken üç dönemde de daha düşük maksimum drawdown göstermiştir.
| Yöntem | Pencere | Aylık geometrik ortalama | Sharpe | MaxDD | İşlem |
|---|---|---|---|---|---|
| One-stage | Training | 0,222 | 3,164 | 0,283 | 548 |
| Two-stage | Training | 0,145 | 2,388 | 0,265 | 485 |
| One-stage | Validation | 0,051 | 1,238 | 0,318 | 423 |
| Two-stage | Validation | 0,038 | 1,070 | 0,231 | 348 |
| One-stage | Post-ETF | 0,023 | 0,845 | 0,220 | 259 |
| Two-stage | Post-ETF | 0,016 | 0,664 | 0,196 | 223 |
Kaynak Şekil 3, training + validation dönemindeki equity curves'ü logaritmik y ekseninde gösterir. One-stage eğrisi daha yüksek bileşik büyümeye ulaşırken two-stage eğrisi daha sınırlı büyüme ve daha düşük drawdown profili göstermektedir. Şeklin amacı “two-stage daha kârlıdır” demek değil, training winner'ın ekstrem compounding davranışı ile daha muhafazakâr seçimin farkını görünür kılmaktır.
Bootstrap güven aralığı
BTC validation döneminde two-stage eksi one-stage aylık geometrik ortalama farkı:
\[ \Delta=-0.016 \]
ve hareketli blok bootstrap %95 güven aralığı:
\[ [-0.040,\;0.008] \]
olarak raporlanmıştır. Güven aralığının sıfırı içermesi, two-stage seçim için getiri bakımından belirgin bir üstünlük sonucu çıkarılmaması gerektiğini gösterir.
Threshold seçimi de sonuçları değiştiriyor
Stable-candidate filter'daki eşikler evrensel sabitler değildir. Kaynak 27 farklı threshold kombinasyonunda seçilen yapılandırmanın trial 52, 87 ve 108 arasında değiştiğini göstermektedir. Validation CAGR 0,332–1,058, Sharpe 0,844–1,667 ve MaxDD 0,209–0,386 aralığında değişmektedir.
Bu nedenle screening policy kendisi de görünür bir governance choice olarak tutulmaktadır; gizli bir meta-optimizer gibi davranması amaçlanmamıştır.
AutoQuant Aşırı Uyumu Ortadan Kaldırıyor mu?
Hayır. Strict execution, cost realism ve multi-window screening önemli korumalar sağlasa da BTC Stage I aday havuzundaki CSCV/PBO tahmini 0,586'dır ve kaynak bunu önemli düzeyde kalan backtest-overfitting riski olarak yorumlamaktadır.
DSR-style kontrol de benzer biçimde muhafazakâr sonuç verir. Uzun pencere Sharpe değeri sıfıra yakındır ve çoklu trial sayısı hesaba katıldığında sıfır gerçek Sharpe hipotezine karşı güçlü kanıt bulunmamaktadır.
Bu nedenle AutoQuant'ın bilimsel iddiası “kalıcı alpha bulduk” değildir. Çerçevenin iddiası, alpha iddiası yapılacaksa bunun hangi maliyetler, hangi zaman pencereleri ve hangi selection rules altında ortaya çıktığının denetlenebilir olması gerektiğidir.
ETH sonucu
| Yöntem | Pencere | Aylık geom. | Sharpe | MaxDD | İşlem |
|---|---|---|---|---|---|
| One-stage | Training | 0,233 | 3,009 | 0,317 | 2112 |
| Two-stage | Training | 0,173 | 2,607 | 0,276 | 346 |
| One-stage | Validation | 0,085 | 2,157 | 0,186 | 2012 |
| Two-stage | Validation | 0,046 | 1,368 | 0,201 | 457 |
| One-stage | Post-2024 | 0,151 | 2,590 | 0,381 | 3880 |
| Two-stage | Post-2024 | 0,096 | 2,009 | 0,368 | 852 |
ETH'de two-stage model her pencerede getiri açısından daha düşük kalmıştır. Drawdown eğitim ve Post-2024 dönemlerinde daha düşük, validation döneminde ise 0,201 ile one-stage'in 0,186 değerinden biraz yüksektir. Dolayısıyla “two-stage her durumda drawdown'ı azaltır” şeklinde mutlak bir iddia da doğru değildir.
SOL ve AVAX sonuçları
| Varlık | Pencere | One-stage aylık geom. | Two-stage aylık geom. | One-stage MaxDD | Two-stage MaxDD |
|---|---|---|---|---|---|
| SOL | Training | 0,141 | 0,124 | 0,319 | 0,152 |
| SOL | Validation | 0,227 | 0,362 | 0,239 | 0,242 |
| SOL | Post-2024 | 0,066 | 0,068 | 0,243 | 0,195 |
| AVAX | Training | 0,479 | 0,091 | 0,795 | 0,055 |
| AVAX | Validation | 0,572 | 0,087 | 0,621 | 0,096 |
| AVAX | Post-2024 | 0,797 | 0,094 | 0,607 | 0,142 |
AVAX örneği çalışmanın “extreme compounding yerine daha muhafazakâr yapılandırma” temasını özellikle görünür kılar. One-stage çok yüksek görünür getiriler üretirken drawdown da 0,607–0,795 gibi yüksek seviyelerdedir. Two-stage yapılandırma daha düşük görünen getirilerle birlikte çok daha düşük drawdown üretmektedir.
Cross-asset transfer
ETH üzerinde eğitilen aggressive yapılandırma aynı dönemde ETH üzerinde yıllık +0,44%, BTC'de −0,17% üretmiştir. Bu sonuç AutoQuant pipeline'ının başka varlıklara uygulanabilmesi ile belirli bir parametre setinin başka bir varlıkta çalışmasının aynı şey olmadığını gösterir.
Drawdown-aware risk budgeting
| Varyant | Yıllık getiri | MaxDD | Sharpe | Getiri farkı | MaxDD farkı |
|---|---|---|---|---|---|
| v1 (0–20–35) | 4,06% | 0,760 | 0,247 | +28,15 puan | −19,36 puan |
| v2 (0–18–33) | 0,37% | 0,810 | 0,194 | +24,46 puan | −14,32 puan |
| v3 (0–22–38) | 8,46% | 0,695 | 0,329 | +32,55 puan | −25,83 puan |
Bu varyantlar baseline'a göre derin drawdown durumlarında exposure'ı azaltmaktadır. Sonuçlar çalışmanın tek vaka bağlamında state-dependent exposure scaling'in risk/getiri profilini değiştirebildiğini gösterir; genel portföy yönetimi yasası olarak yorumlanmamalıdır.
Full-chain audit
AutoQuant her bar için signal, executed exposure, raw market return, raw strategy return, fee, slippage, funding ve net return bileşenlerini kaydeder.
Temsilî BTC ve ETH denetimlerinde offline backtest ile live-style replay arasında:
\[ \max|\Delta S|=0 \]
ve:
\[ \max|\Delta\pi|=0 \]
raporlanmıştır. Fees, slippage ve funding reconciliation farkları da bu snapshot'ta sıfırdır.
Bunun anlamı “canlı performans backtest ile aynıdır” değildir. Sonuç yalnız aynı kod/semantik yolunun muhasebe ve sinyal üretimi bakımından tutarlı replay üretebildiğini gösterir.
Live Guard
Post-deployment guard, rolling 30/90 günlük performans, drawdown, günlük kayıp ve trade frequency gibi göstergeleri izleyerek ok, watch veya kill kararı verebilir. Kill durumunda pozisyon sıfırlanabilir ve yeniden manuel onay verilene kadar işlem durdurulabilir.
Ancak Live Guard'ın uzun yıllara yayılan geniş canlı track record'u çalışmada yoktur. Kaynak yalnız sınırlı paper-trading/live-style replay ve historical guard simulation kanıtı sunmaktadır.
Çalışmanın desteklediği sonuçlar
- Funding, fee ve slippage'ın eksik modellenmesi belirli BTC deneyinde backtest performansını ciddi biçimde büyütebilir.
- Validation penceresinin seçim sürecinde kullanılması final kör test ile aynı değildir.
- Two-stage screening, bazı örneklerde daha düşük drawdown ve daha az ekstrem parametre setleri seçmektedir.
- STRICT4H t+1 ve no-look-ahead funding semantics açık ve yeniden oynatılabilir bir yürütme protokolü sağlar.
- Deterministik artifact ve accounting invariants backtest ile live-style replay arasındaki uygulama tutarlılığını denetlemeye yardımcı olur.
- PBO sonucu, güçlü korumalara rağmen residual overfitting riskinin devam ettiğini gösterir.
- Pipeline aynı metodolojik yapı altında BTC, ETH, SOL ve AVAX'a uygulanabilmiştir.
Çalışmanın desteklemediği sonuçlar
- AutoQuant'ın kalıcı veya garanti edilmiş alpha ürettiği gösterilmemiştir.
- Two-stage screening'in bütün dönemlerde daha yüksek getiri veya daha düşük drawdown sağlayacağı gösterilmemiştir.
- Backtest CAGR değerlerinin kurumsal sermaye ölçeğinde elde edilebileceği gösterilmemiştir.
- Non-linear market impact ve order-book capacity modellenmemiştir.
- Düşük likiditeli, yeni listelenmiş veya delist edilmiş perpetual sözleşmelere genelleme yapılmamıştır.
- Live Guard için uzun dönem production track record gösterilmemiştir.
- TPE'nin bütün optimizasyon yöntemlerinden üstün olduğu gösterilmemiştir.
- Deep neural network veya başka non-parametric alpha modellerinin eğitim ve tuning döngüsü bu çalışmada AutoQuant tarafından yönetilmemektedir.
Başlıca sınırlılıklar
Sınırlı varlık kapsamı: Dört likit perpetual ve tek STRICT4H sinyal ailesi incelenmiştir.
Survivorship ve lifecycle: Delisting, symbol migration ve exchange-specific contract re-specification sistematik biçimde analiz edilmemiştir.
Market impact yok: İşlem maliyetleri turnover ile doğrusal modellenir. Büyük AUM altında ortaya çıkabilecek non-linear price impact ve likidite kapasitesi değerlendirilmez.
Dış framework benchmarkı sınırlı: Backtrader ile minimal semantics replay yapılmış olsa da bütün third-party AutoML/backtest sistemleri STRICT4H'in bütün invariants ve funding kuralları altında uçtan uca karşılaştırılmamıştır.
Optimizer karşılaştırması sınırlı: TPE ile random sampling karşılaştırılmıştır; evolutionary optimization veya başka Bayesian samplers kapsamlı biçimde benchmark edilmemiştir.
Structural break: Live Guard performans bozulmasını dolaylı olarak algılar; gerçek zamanlı yapısal kırılma testi uygulamaz.
Veri bağımlılığı: Continuity ve sanity checks kaynak hatalarını azaltabilir fakat borsadan gelen latent historical-data hatalarını düzeltemez.
Multiple testing: PBO=0,586 sonucu pipeline'ın data-snooping riskini tamamen ortadan kaldırmadığını göstermektedir.
Kaynak ve Yöntem Notu
Özgün başlık: AutoQuant: An Auditable Expert-System Framework for Execution-Constrained Auto-Tuning in Cryptocurrency Perpetual Futures
Yazar: Kaihong Deng
Kurum: School of Modern Information Industry, Artificial Intelligence Program, Guangzhou College of Commerce, Guangzhou, China.
Yüklenen kaynak: arXiv:2512.22476v1 [q-fin.TR].
Yüklenen preprint tarihi: 27 Aralık 2025.
Yüklenen dosyadaki gönderim bilgisi: Preprint submitted to Expert Systems with Applications, 30 Aralık 2025.
Güncel yayın: Expert Systems with Applications.
Yayınevi: Elsevier.
Güncel yayın durumu: Available online 5 August 2026; In Press, Journal Pre-proof.
Makale numarası: 133924.
DOI: 10.1016/j.eswa.2026.133924
Çalışma türü: Hesaplamalı finans / backtest metodolojisi / uzman-sistem benzeri karar-destek ve yapılandırma seçimi.
Ana varlıklar: BTC/USDT, ETH/USDT, SOL/USDT, AVAX/USDT perpetual futures.
Ana veri frekansı: 4 saatlik OHLCV; funding girdisi 8 saatlik.
Temel optimizer: Tree-structured Parzen Estimator (TPE), Optuna.
Temel execution protokolü: STRICT4H, strict \(t+1\) execution ve no-look-ahead funding alignment.
Temel maliyet modeli: Trading fee + slippage + funding; leverage ve notional cap.
BTC baseline hesap koşulları: 10.000 USDT equity, 5× maximum leverage, 50.000 USDT notional cap, 4 bps taker fee, 2 bps base slippage.
Overfitting diagnostic: DSR-style multiple-testing sanity check ve CSCV/PBO; BTC snapshot PBO=0,586.
Reproducibility: Configuration JSON, per-bar ledger CSV, robustness summaries ve invariant-audit çıktıları üretilmektedir. Ham tick-level veri exchange licensing/storage kısıtları nedeniyle doğrudan yeniden dağıtılmamaktadır; yeniden indirme ve 4 saatlik veri oluşturma scriptleri sağlanmaktadır.
Finansman: Kaynak, kamu, ticari veya kâr amacı gütmeyen fon kuruluşlarından özel bir araştırma hibesi alınmadığını bildirmektedir.
Çıkar çatışması: Bilinen competing financial interest veya çalışmayı etkileyebilecek kişisel ilişki olmadığı beyan edilmiştir.
Generative AI bildirimi: Kaynak, OpenAI Codex CLI'nin GPT-5.2 modeliyle yalnız sınırlı İngilizce copy-editing ve reproducibility/table-figure traceability checklist desteğinde kullanıldığını; deneysel sonuçlar, konfigürasyon seçimi ve metrik hesaplarının yazarın codebase ve artifact'larından üretildiğini belirtmektedir.
Lisans: Güncel bibliyografik doğrulamada bu çalışma için açık bir Creative Commons yeniden kullanım lisansı güvenilir biçimde doğrulanamadığından görsel/telif işlemlerinde fail-closed yaklaşımı uygulanmalıdır.
En önemli yorum sınırı: AutoQuant'ın sonuçları küçük hesap ve doğrusal işlem maliyeti varsayımları altındaki backtest/simulation sonuçlarıdır. Market impact ve institutional capacity modellenmemiştir; elde edilen CAGR veya Sharpe değerleri canlı, ölçeklenebilir kârlılık garantisi değildir.
Sürüm notu: Bu Verianla bilimsel metnindeki yöntem ve sayısal bulgular yüklenen arXiv v1 kaynağından alınmıştır. 2026 tarihli Expert Systems with Applications Journal Pre-proof kaydı bibliyografik statüyü güncellemek için doğrulanmış, daha yeni sürümdeki olası bilimsel revizyonlar yüklenen v1'in sonuçlarına sessizce eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir