


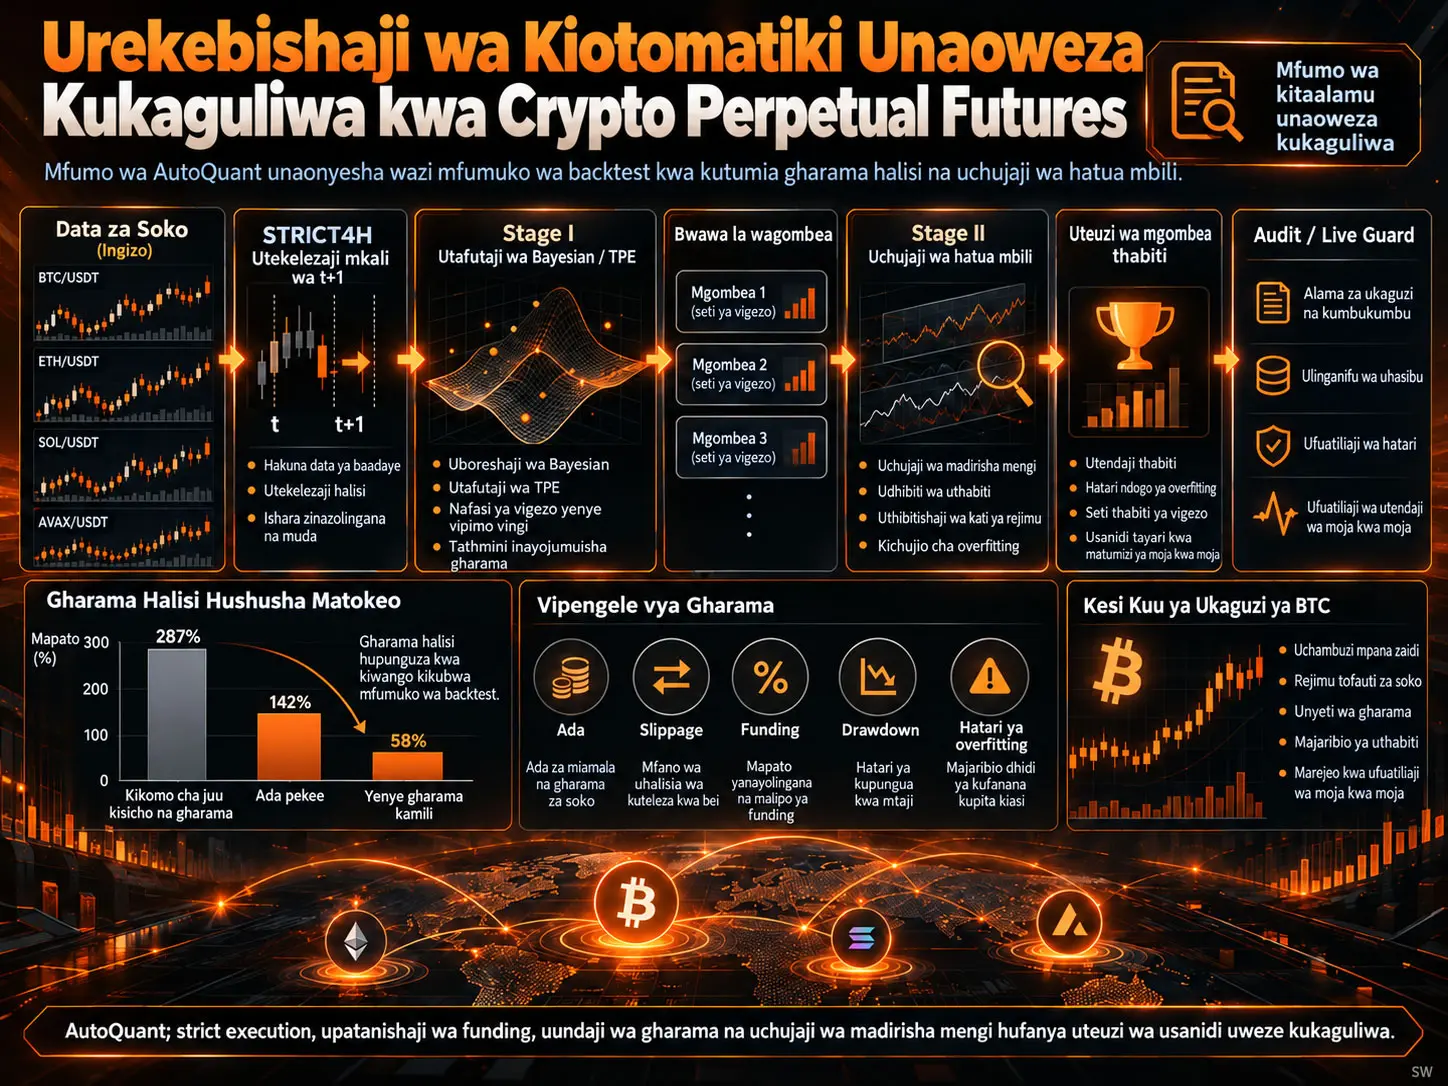
AutoQuant ni mfumo wa usaidizi wa maamuzi ambao, badala ya kuzalisha ishara mpya ya biashara katika mikakati ya cryptocurrency perpetual futures, huchagua, hutathmini upya na kurekodi kwa namna inayoweza kukaguliwa vigezo vya familia ya ishara iliyowekwa mapema chini ya kanuni halisi za utekelezaji na gharama. Mfumo unaunganisha katika pipeline moja semantics kali za utekelezaji wa saa 4 zinazoitwa STRICT4H, ulinganishaji wa muda unaozuia matumizi ya taarifa za funding za siku zijazo, gharama za fee na slippage, mipaka ya leverage na notional, utafutaji wa parameter wa Bayesian/TPE na mchakato wa hatua mbili wa robustness screening.
Utafiti unachunguza mikataba ya BTC/USDT, ETH/USDT, SOL/USDT na AVAX/USDT perpetual futures. BTC ndiyo kesi kuu ya ukaguzi; mali nyingine tatu hutumika kujaribu kama pipeline hiyo hiyo inaweza kutumika katika masoko tofauti. Stage I huzalisha parameter candidates katika training window pekee. Stage II hutathmini tena candidates hao hao katika validation windows na cost scenarios. Long-horizon na blind hold-out windows ni stress tests za ziada ambazo hazitumiki katika uteuzi wa parameter.
Matokeo yanayoonekana zaidi ni kwamba kuondoa gharama za backtest kunaweza kuongeza sana performance inayoonekana. Katika BTC stress-test configuration, annualized CAGR ni 2,726 chini ya full-cost condition, huongezeka hadi 4,308 wakati trading fee pekee ndiyo inayohesabiwa, na hadi 5,225 katika optimistic upper bound ambapo fees/slippage/funding zote zimeondolewa. Values hizi hazipaswi kutafsiriwa kama real scalable investment return, bali kama diagnostic results zinazoonyesha jinsi backtest inaweza kuwa nyeti kwa cost assumptions.
Uteuzi wa hatua mbili pia hauzalishi return kubwa kiotomatiki. Katika mfano wa BTC, one-stage top-1 configuration huonyesha return kubwa zaidi katika windows nyingi, huku two-stage selection ikizalisha drawdown ya chini na performance isiyo kali sana. Tabia inayofanana ya risk control inaonekana pia katika baadhi ya majaribio ya ETH, SOL na AVAX. Hata hivyo, matokeo si sawa katika assets zote na periods zote.
Kizuizi muhimu ni kwamba pipeline haiondoi kabisa hatari ya overfitting. Katika BTC candidate pool, makadirio ya CSCV/PBO ni 0,586. Long-window DSR-style check pia haitoi ushahidi wenye nguvu wa persistent alpha kwa mtazamo wa Sharpe. Kwa hiyo mchango mkuu wa AutoQuant si “kupata profitable strategy”, bali kufanya iwezekane kufuatilia na kukagua ni configuration ipi iliyochaguliwa chini ya assumptions zipi.
AutoQuant ni Nini na Haifanyi Nini?
AutoQuant si trading strategy generator wala alpha model mpya ya kutabiri mwelekeo wa soko; ni execution-aware configuration-selection system inayochunguza parameters za fixed signal family chini ya strict execution, funding visibility, transaction cost na risk constraints, kuzipitisha kwenye robustness checks na kuunda reproducible audit trail kwa kila uteuzi.
Kwa nini crypto perpetual futures backtest ni dhaifu hasa?
Katika perpetual futures contracts haitoshi kutabiri kwa usahihi mwelekeo wa bei pekee. Matokeo halisi ya strategy huathiriwa na microstructural details kama trading fee, slippage, funding payment, leverage, notional cap, frequency ya kubadilisha position na ni bar gani biashara inatekelezwa.
Kwa mfano, ikiwa signal inahesabiwa wakati wa kufungwa kwa bar ya saa 4, kuiruhusu kufaidika na movement ya bei ya bar hiyo hiyo kunaweza kuingiza taarifa ya baadaye katika decision ya zamani. Vivyo hivyo, ikiwa funding rate inatumika kurudi nyuma kwenye bar ya zamani kabla haijachapishwa sokoni, backtest itakuwa imetumia taarifa ambayo haikupatikana katika real time.
Mbinu kuu ya AutoQuant ni kubadilisha details hizi kuwa kanuni wazi za tabia ya mfumo badala ya kuziacha kwa tahadhari ya mtumiaji.
Maswali matatu makuu ya empiria ya utafiti
| Swali | Tatizo lililochunguzwa |
|---|---|
| 1 | Performance ya backtest inaweza kuongezeka kwa kiasi gani gharama na constraints zikiondolewa? |
| 2 | Parameters ni dhaifu kwa kiwango gani dhidi ya validation window iliyotengwa na Stage I search lakini ikatumika tena katika Stage II selection? |
| 3 | Mabadiliko katika assumptions za fee, funding na slippage yanaathiri vipi apparent profitability na tafsiri za robustness? |
Muundo unaofanana na expert-system
| Tabaka | Kinacholingana ndani ya AutoQuant | Kazi |
|---|---|---|
| Knowledge base | STRICT4H execution semantics, funding alignment, profiles za gharama na constraints, screening policies | Huzuia look-ahead na feasibility errors kwa kanuni wazi. |
| Inference engine | Stage I TPE Bayesian search + Stage II double screening | Huzalisha candidate configurations na kuzichagua kulingana na robustness criteria. |
| Explanation interface | Machine-readable artifacts, ledgers, accounting invariants | Huwezesha selection na performance calculations kujengwa upya. |
| Governance overlay | Live Guard na invariant monitoring | Hufuatilia drift na risk states baada ya deployment. |
Ujumbe wa kisayansi wa Kielelezo 1
Method flow katika ukurasa wa 10 wa chanzo inaonyesha data na cost model zikiingia Stage I Bayesian Search, candidate pool ikitengenezwa hapo, na candidates kuhamishwa kwenda Stage II STRICT4H double screening. Baada ya screening ni stable candidates pekee wanaobaki. Wakati hao wakifuatiliwa na post-deployment guard, accounting invariants huunda independent audit path.
Jambo muhimu la figure hii ni kwamba optimization na audit si kitu kimoja. Stage I hutafuta highest objective value, huku Stage II ikijaribu matokeo hayo dhidi ya time na cost perturbations.
Kwa Nini STRICT4H Iko Katikati ya AutoQuant?
STRICT4H ni strict execution protocol ambapo signal huhesabiwa wakati wa kufungwa kwa bar ya saa 4 lakini position inaweza kutumika kuanzia bar inayofuata pekee, yaani \(t+1\); funding information pia hubebwa mbele tu kutoka timestamps ambazo zilijulikana kweli wakati huo.
Muundo wa Signal-modular
Framework huchukulia base signal generator kihisabati kama:
\[ f:I_t\times\Theta\rightarrow S_t \]
Hapa \(I_t\) ni information set inayopatikana kweli wakati \(t\); \(\Theta\) ni hyperparameter space; na \(S_t\in\{-1,0,1\}\) ni target signal ya short, flat au long.
AutoQuant haibuni function hii ya \(f\) yenyewe. Original experiments katika utafiti hutumia fixed signal family yenye mantiki ya STRICT4H momentum, mean-reversion na breakout/gating.
Momentum score
Katika chanzo, momentum score inayotokana na tofauti ya EMA ni:
\[ m_t(\theta_{\mathrm{momentum}}) = \frac{1}{2} \left[ 1+ \tanh \left( \frac{ EMA_{\mathrm{fast},t}-EMA_{\mathrm{slow},t} }{ \sigma(\theta_{\mathrm{momentum}}) EMA_{\mathrm{slow},t} } \right) \right] \]
Tofauti iliyowekwa normalized kati ya fast na slow EMA hubanwa hadi interval ya \([0,1]\) kwa tanh transformation. \(\theta_{\mathrm{momentum}}\) hudhibiti volatility scaling behavior.
Combined score
\[ C_t= w_{\mathrm{mom}}m_t+ (1-w_{\mathrm{mom}})a_t \]
Hapa \(a_t\) ni mchanganyiko wa active mean-reversion/anomaly subscores; \(w_{\mathrm{mom}}\) ni uzito wa momentum channel.
Katika implementation ya chanzo, anomaly score hutumika kama maximum ya active subscores. Hivyo mfumo huleta trend-momentum information pamoja na reversal signals kama Bollinger-band au tail-exceedance kwenye common threshold mechanism.
Uamuzi wa signal
Combined score hubadilishwa kuwa mwelekeo wa position kulingana na long na short thresholds zilizowekwa:
\[ Signal_t= \begin{cases} +1, & C_t\geq\tau_t^{long}\\ -1, & C_t\leq1-\tau_t^{short}\\ 0, & \text{diğer durumlarda} \end{cases} \]
.
Funding si gharama pekee, inaweza pia kuwa input ya uamuzi
Kwa upande wa Long, entry threshold inaweza kuongezwa katika adverse funding conditions:
\[ \tau_{\mathrm{long}}(t) = \tau_{\mathrm{base}} + \kappa \max \left( |fr_t|-\frac{\vartheta_{\mathrm{bias}}}{10000}, 0 \right) \]
Hapa \(fr_t\) ni funding rate ya saa 8; \(\vartheta_{\mathrm{bias}}\) ni funding-bias activation threshold; na \(\kappa\) huamua jinsi entry threshold inavyoongezeka haraka funding inapozorota.
Funding rate huwekwa sawia na grid ya saa 4 kwa carry-forward method. Hairuhusiwi backfill ya funding values ambazo zitatangazwa baadaye kwenye bars za zamani.
Mbinu na Matokeo ya Utafiti
Stage I: Utafutaji wa parameter wa Bayesian/TPE
Stage I huzalisha candidate parameter sets katika training window kwa kutumia Tree-structured Parzen Estimator (TPE). Objective function ni cost-adjusted annualized net return:
\[ \max_{\theta\in\Theta}J(\theta), \qquad J(\theta)=r_{\mathrm{ann}}(\theta) \]
Annualized return kutoka bars za saa 4 huhesabiwa kama:
\[ r_{\mathrm{ann}} = (1+R_{\mathrm{tot}})^{AF/N}-1 \]
Katika chanzo, annualization factor imechukuliwa kuwa:
\[ AF=6\times365=2190 \]
kwa sababu kuna vipindi sita vya saa 4 kwa siku.
Katika BTC core study, 40 TPE trial zilitumika kwa compute-limited example; katika direct comparison tables zikaongezwa hadi 120 trial ili kupunguza uwezekano wa search kutotosha. Best-so-far objective ilifikia 0,0174 katika 10 trial, 0,1172 katika 40 trial na 0,1590 karibu na 100–120 trial. Kwa hiyo chanzo hakitafsiri 40 trial kama search iliyokaribia global optimum, bali kama compute-limited example.
Stage II: Double screening
Hakuna optimization mpya inayofanywa baada ya Stage I. Fixed candidate pool huendeshwa tena katika vipindi tofauti na chini ya cost scenarios tofauti.
Katika mfano wa BTC, rolling evaluations zilifanywa kwa windows za 2000 bar na hatua za 500 bar. Cost-grid ina:
Taker fee: 3, 4 na 6 bps
Funding multiplier: 0,5; 1,0 na 1,5
na hivyo ina combinations tisa.
Vigezo vya uchaguzi wa Stable candidate
| Metriki | Kizingiti | Lengo |
|---|---|---|
| mean_monthly_true | ≥ 0,005 | Performance ya chini kabisa |
| min_monthly_true | ≥ 0,0 | Msingi wa worst-case scenario |
| maxDD_mean | ≤ 0,30 | Drawdown limit |
| switch_density_mean | ≤ 0,12 | Turnover na fragility limit |
Kati ya candidates wanaopita filter, configurations tano za kwanza huchaguliwa kwa mpangilio wa kupungua kwa mean monthly geometric return na kuongezeka kwa MaxDD.
Training, validation na blind hold-out ni tofauti
| Window | Kipindi cha tarehe cha BTC | Jukumu |
|---|---|---|
| Training | 2019-09-08 – 2021-01-01 | Stage I parameter generation |
| Validation | 2021-01-01 – 2023-01-01 | Stage II screening na selection |
| Long-horizon | 2019-09-08 – 2025-10-14 | DSR na long-term stress tests |
| Blind Post-ETF | 2024-01-01 – 2025-10-14 | Post-hoc robustness test ambayo haikutumika kamwe katika selection |
Kuwa out-of-sample kwa validation window kwa Stage I hakufanyi window hiyo kuwa final test set ambayo haijaguswa kabisa kwa pipeline nzima. Hii ni kwa sababu window hiyo hutumika tena katika Stage II candidate selection. Hili ni moja ya mambo ambayo utafiti unaweka wazi hasa katika kiwango cha methodology.
Vyanzo vya data na frequency
Majaribio yote ya msingi yalifanywa kwenye 4-hour OHLCV series. Kwa BTC/USDT, vyanzo vikuu vya data ni centralized exchanges kama Binance, Bybit na OKX. Funding rate series zina frequency ya saa 8 na zinalinganishwa na time axis ya saa 4 kwa carry-forward method.
BTC core sample ina 5.069 non-overlapping 4-hour returns katika kipindi cha 2019-09-08–2021-12-31. Extended BTC long sample ina 13.368 returns katika kipindi cha 2019-09-08–2025-10-14.
Data ya ETH inashughulikia 2021-12-31–2025-11-24; series za SOL na AVAX zinashughulikia vipindi vya 2021-01-01–2025-12-16.
Mapengo katika data ya OHLCV hayajazwi
Interpolation au forward-fill haitumiki kwa OHLCV bars zinazokosekana. Katika msingi wa data set, continuity tolerance kwa kawaida ni sifuri; ikiwa bar inayokosekana itapatikana, pipeline inaweza kukataa data source.
Funding hushughulikiwa kama external series tofauti. Katika sehemu ambazo actual funding value haipo, hakuna kujaza kwa sifuri; conservative fallback funding assumption hutumika na sensitivity huchunguzwa kwa Stage II funding-multiplier scenarios.
Net return inahesabiwaje?
Executed exposure \(\pi_t\) hutokana na signal ya bar iliyotangulia. Raw return:
\[ r_t^{raw}=\pi_t r_t^{mkt} \]
hufafanuliwa hivyo.
Net return:
\[ r_t^{net} = r_t^{raw} - C_{\mathrm{fee},t} - C_{\mathrm{slip},t} - C_{\mathrm{fund},t} \]
ni hivyo.
Mgawanyo huu ni muhimu kwa auditability; kwa sababu inaweza kujengwa upya kwa kiwango cha bar ni sehemu gani ya net performance iliyotokana na price movement na ni sehemu gani imetokana na fee, slippage au funding.
BTC base cost profile
| Parameter | Thamani |
|---|---|
| Equity ya mwanzo | 10.000 USDT |
| Maximum leverage | 5× |
| Notional cap | 50.000 USDT |
| Taker fee | 4 bps |
| Base slippage | 2 bps |
| Fallback funding | 1 bps / 8 saa |
Actual funding data inapopatikana, actual 8-hour funding series hutumika badala ya fallback rate.
Gharama Halisi za Biashara Zilibadilisha Backtest Result kwa Kiasi Gani?
Katika BTC/USDT core stress-test, chini ya base parameters zilezile, annualized CAGR ilikuwa 2,726 wakati fees, slippage na funding zilihesabiwa pamoja; ikaongezeka hadi 4,308 katika fee-only condition, na hadi 5,225 katika zero-cost upper bound ambapo trading costs zote ziliondolewa. Chanzo kinatafsiri tofauti hii si kama real scalable return bali kama backtest cost sensitivity.
| Hali | Annual CAGR | Sharpe | MaxDD | Biashara |
|---|---|---|---|---|
| Full-cost: fees + slippage + funding | 2,726 | 2,049 | 0,265 | 636 |
| Standard: fee-only | 4,308 | 2,506 | 0,262 | 636 |
| Naive: zero-cost upper bound | 5,225 | 2,711 | 0,260 | 535 |
Ni muhimu kwamba idadi ya biashara inaweza kubadilika katika Naive configuration. Kwa sababu decision channels kama funding-aware gating zinaathiriwa na cost/funding inputs, kuondoa cost components kunaweza kubadilisha si final PnL calculation pekee bali pia trade sequence katika baadhi ya hali.
Je, Two-Stage Screening Inazalisha Faida Zaidi?
Hapana; dai kuu la utafiti si guarantee ya return ya juu. Katika mfano wa BTC, two-stage selection huzalisha monthly geometric return ya chini kuliko one-stage top-1 katika training, validation na blind Post-ETF periods, huku ikionyesha maximum drawdown ya chini katika periods zote tatu.
| Mbinu | Window | Monthly geometric mean | Sharpe | MaxDD | Biashara |
|---|---|---|---|---|---|
| One-stage | Training | 0,222 | 3,164 | 0,283 | 548 |
| Two-stage | Training | 0,145 | 2,388 | 0,265 | 485 |
| One-stage | Validation | 0,051 | 1,238 | 0,318 | 423 |
| Two-stage | Validation | 0,038 | 1,070 | 0,231 | 348 |
| One-stage | Post-ETF | 0,023 | 0,845 | 0,220 | 259 |
| Two-stage | Post-ETF | 0,016 | 0,664 | 0,196 | 223 |
Kielelezo 3 cha chanzo kinaonyesha equity curves katika training + validation period kwenye logarithmic y-axis. One-stage curve hufikia compound growth ya juu zaidi, huku two-stage curve ikionyesha growth iliyo na mipaka zaidi na lower drawdown profile. Lengo la figure si kusema “two-stage ina faida zaidi”, bali kuonyesha tofauti kati ya extreme compounding behavior ya training winner na conservative selection zaidi.
Bootstrap confidence interval
Katika BTC validation period, two-stage minus one-stage monthly geometric mean difference ni:
\[ \Delta=-0.016 \]
na moving block bootstrap %95 confidence interval ni:
\[ [-0.040,\;0.008] \]
kama ilivyoripotiwa. Kwa kuwa confidence interval inajumuisha sifuri, haipaswi kutoa conclusion ya wazi ya superiority ya return kwa two-stage selection.
Threshold selection pia hubadilisha matokeo
Thresholds katika stable-candidate filter si universal constants. Chanzo kinaonyesha kuwa katika 27 threshold combinations tofauti, configuration iliyochaguliwa inabadilika kati ya trial 52, 87 na 108. Validation CAGR inabadilika katika range ya 0,332–1,058, Sharpe 0,844–1,667 na MaxDD 0,209–0,386.
Kwa hiyo screening policy yenyewe hudumishwa kama visible governance choice; haikulengi kufanya kazi kama hidden meta-optimizer.
Je, AutoQuant Inaondoa Overfitting?
Hapana. Ingawa strict execution, cost realism na multi-window screening hutoa protections muhimu, CSCV/PBO estimate katika BTC Stage I candidate pool ni 0,586, na chanzo kinatafsiri hii kama meaningful residual backtest-overfitting risk.
DSR-style check pia hutoa conservative result. Long-window Sharpe value iko karibu na sifuri na, baada ya kuzingatia multiple trial count, hakuna ushahidi wenye nguvu dhidi ya hypothesis ya zero true Sharpe.
Kwa hiyo scientific claim ya AutoQuant si “tumepata persistent alpha”. Dai la framework ni kwamba ikiwa alpha claim itatolewa, lazima iwe possible kukagua ilionekana chini ya costs zipi, time windows zipi na selection rules zipi.
Matokeo ya ETH
| Mbinu | Window | Monthly geom. | Sharpe | MaxDD | Biashara |
|---|---|---|---|---|---|
| One-stage | Training | 0,233 | 3,009 | 0,317 | 2112 |
| Two-stage | Training | 0,173 | 2,607 | 0,276 | 346 |
| One-stage | Validation | 0,085 | 2,157 | 0,186 | 2012 |
| Two-stage | Validation | 0,046 | 1,368 | 0,201 | 457 |
| One-stage | Post-2024 | 0,151 | 2,590 | 0,381 | 3880 |
| Two-stage | Post-2024 | 0,096 | 2,009 | 0,368 | 852 |
Katika ETH, two-stage model imebaki chini kwa return katika kila window. Drawdown ni ya chini katika training na Post-2024 periods, lakini katika validation period ni 0,201, kidogo juu ya one-stage value ya 0,186. Kwa hiyo absolute claim kwamba “two-stage hupunguza drawdown katika kila hali” si sahihi pia.
Matokeo ya SOL na AVAX
| Mali | Window | One-stage monthly geom. | Two-stage monthly geom. | One-stage MaxDD | Two-stage MaxDD |
|---|---|---|---|---|---|
| SOL | Training | 0,141 | 0,124 | 0,319 | 0,152 |
| SOL | Validation | 0,227 | 0,362 | 0,239 | 0,242 |
| SOL | Post-2024 | 0,066 | 0,068 | 0,243 | 0,195 |
| AVAX | Training | 0,479 | 0,091 | 0,795 | 0,055 |
| AVAX | Validation | 0,572 | 0,087 | 0,621 | 0,096 |
| AVAX | Post-2024 | 0,797 | 0,094 | 0,607 | 0,142 |
Mfano wa AVAX unaonyesha kwa uwazi mada ya utafiti ya “configuration ya kihafidhina zaidi badala ya extreme compounding”. One-stage huzalisha returns zinazoonekana kuwa za juu sana, lakini drawdown pia iko katika viwango vya juu vya 0,607–0,795. Two-stage configuration huzalisha drawdown ya chini sana pamoja na returns zinazoonekana chini zaidi.
Cross-asset transfer
Aggressive configuration iliyofunzwa kwenye ETH ilizalisha annual +0,44% kwenye ETH na −0,17% kwenye BTC katika kipindi kilekile. Matokeo haya yanaonyesha kuwa AutoQuant pipeline inaweza kutumiwa kwa asset nyingine na parameter set fulani kufanya kazi katika asset nyingine si kitu kimoja.
Drawdown-aware risk budgeting
| Variant | Annual return | MaxDD | Sharpe | Tofauti ya return | Tofauti ya MaxDD |
|---|---|---|---|---|---|
| v1 (0–20–35) | 4,06% | 0,760 | 0,247 | +28,15 point | −19,36 point |
| v2 (0–18–33) | 0,37% | 0,810 | 0,194 | +24,46 point | −14,32 point |
| v3 (0–22–38) | 8,46% | 0,695 | 0,329 | +32,55 point | −25,83 point |
Variants hizi hupunguza exposure katika hali za deep drawdown ikilinganishwa na baseline. Matokeo yanaonyesha kuwa katika single-case context ya utafiti, state-dependent exposure scaling inaweza kubadilisha risk/return profile; hayapaswi kutafsiriwa kama sheria ya jumla ya portfolio management.
Full-chain audit
AutoQuant hurekodi kwa kila bar components za signal, executed exposure, raw market return, raw strategy return, fee, slippage, funding na net return.
Katika representative BTC na ETH audits, kati ya offline backtest na live-style replay:
\[ \max|\Delta S|=0 \]
na:
\[ \max|\Delta\pi|=0 \]
ziliripotiwa. Fees, slippage na funding reconciliation differences pia ni sifuri katika snapshot hii.
Hii haimaanishi kwamba “live performance ni sawa na backtest”. Matokeo yanaonyesha tu kwamba code/semantic path ileile inaweza kutoa replay iliyo consistent katika accounting na signal generation.
Live Guard
Post-deployment guard inaweza kufuatilia indicators kama rolling 30/90-day performance, drawdown, daily loss na trade frequency na kutoa decision ya ok, watch au kill. Katika hali ya Kill, position inaweza kuwekwa sifuri na trading kusimamishwa hadi manual approval itolewe tena.
Hata hivyo, hakuna broad live track record ya Live Guard inayochukua miaka mingi katika utafiti. Chanzo kinatoa limited paper-trading/live-style replay na historical guard simulation evidence pekee.
Hitimisho zinazoungwa mkono na utafiti
- Incomplete modeling ya funding, fee na slippage inaweza kuongeza sana backtest performance katika BTC experiment fulani.
- Kutumia validation window katika selection process si sawa na final blind test.
- Two-stage screening huchagua parameter sets zenye lower drawdown na less extreme values katika baadhi ya examples.
- STRICT4H t+1 na no-look-ahead funding semantics hutoa execution protocol iliyo wazi na replayable.
- Deterministic artifact na accounting invariants husaidia kukagua implementation consistency kati ya backtest na live-style replay.
- PBO result inaonyesha residual overfitting risk inaendelea licha ya protections zenye nguvu.
- Pipeline iliweza kutumika kwa BTC, ETH, SOL na AVAX chini ya methodological structure ileile.
Hitimisho ambazo utafiti hauungi mkono
- Haijaonyeshwa kwamba AutoQuant huzalisha persistent au guaranteed alpha.
- Haijaonyeshwa kwamba two-stage screening hutoa higher return au lower drawdown katika periods zote.
- Haijaonyeshwa kwamba backtest CAGR values zinaweza kupatikana kwa institutional-capital scale.
- Non-linear market impact na order-book capacity hazijamodeliwa.
- Hakuna generalization iliyofanywa kwa low-liquidity, newly listed au delisted perpetual contracts.
- Hakuna long-term production track record iliyoonyeshwa kwa Live Guard.
- Haijaonyeshwa kwamba TPE ni bora kuliko optimization methods zote.
- Training na tuning cycle ya deep neural network au other non-parametric alpha models haisimamiwi na AutoQuant katika utafiti huu.
Mapungufu makuu
Limited asset scope: Perpetual contracts nne zenye liquidity na single STRICT4H signal family zimechunguzwa.
Survivorship na lifecycle: Delisting, symbol migration na exchange-specific contract re-specification hazijachambuliwa kwa utaratibu.
Hakuna Market impact: Trading costs zimemodeliwa kwa mstari dhidi ya turnover. Non-linear price impact na liquidity capacity zinazoweza kutokea chini ya large AUM hazitathminiwi.
External framework benchmark ni limited: Ingawa minimal semantics replay imefanywa kwa Backtrader, third-party AutoML/backtest systems zote hazijalinganishwa end-to-end chini ya invariants na funding rules zote za STRICT4H.
Optimizer comparison ni limited: TPE imelinganishwa na random sampling; evolutionary optimization au other Bayesian samplers hazijafanyiwa comprehensive benchmark.
Structural break: Live Guard hugundua performance deterioration kwa njia isiyo ya moja kwa moja; haitumii real-time structural break test.
Data dependency: Continuity na sanity checks zinaweza kupunguza source errors lakini haziwezi kusahihisha latent historical-data errors kutoka exchange.
Multiple testing: Result ya PBO=0,586 inaonyesha pipeline haiondoi kabisa data-snooping risk.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: AutoQuant: An Auditable Expert-System Framework for Execution-Constrained Auto-Tuning in Cryptocurrency Perpetual Futures
Mwandishi: Kaihong Deng
Taasisi: School of Modern Information Industry, Artificial Intelligence Program, Guangzhou College of Commerce, Guangzhou, China.
Chanzo kilichopakiwa: arXiv:2512.22476v1 [q-fin.TR].
Tarehe ya preprint iliyopakiwa: 27 Desemba 2025.
Taarifa ya submission katika faili iliyopakiwa: Preprint submitted to Expert Systems with Applications, 30 Desemba 2025.
Publication ya sasa: Expert Systems with Applications.
Mchapishaji: Elsevier.
Hali ya sasa ya publication: Available online 5 August 2026; In Press, Journal Pre-proof.
Nambari ya makala: 133924.
DOI: 10.1016/j.eswa.2026.133924
Aina ya utafiti: Computational finance / backtest methodology / expert-system-like decision support na configuration selection.
Mali kuu: BTC/USDT, ETH/USDT, SOL/USDT, AVAX/USDT perpetual futures.
Frequency kuu ya data: 4-hour OHLCV; funding input ya 8-hour.
Optimizer kuu: Tree-structured Parzen Estimator (TPE), Optuna.
Execution protocol kuu: STRICT4H, strict \(t+1\) execution na no-look-ahead funding alignment.
Cost model kuu: Trading fee + slippage + funding; leverage na notional cap.
BTC baseline account conditions: 10.000 USDT equity, 5× maximum leverage, 50.000 USDT notional cap, 4 bps taker fee, 2 bps base slippage.
Overfitting diagnostic: DSR-style multiple-testing sanity check na CSCV/PBO; BTC snapshot PBO=0,586.
Reproducibility: Configuration JSON, per-bar ledger CSV, robustness summaries na invariant-audit outputs huzalishwa. Raw tick-level data haisambazwi tena moja kwa moja kutokana na exchange licensing/storage constraints; scripts za ku-download upya na kutengeneza data ya saa 4 hutolewa.
Ufadhili: Chanzo kinaripoti kwamba hakuna specific research grant iliyopokelewa kutoka public, commercial au not-for-profit funding organizations.
Mgongano wa maslahi: Imetangazwa kwamba hakuna competing financial interest inayojulikana au personal relationship ambayo inaweza kuathiri utafiti.
Taarifa ya Generative AI: Chanzo kinaeleza kuwa OpenAI Codex CLI na modeli ya GPT-5.2 ilitumika tu kwa limited English copy-editing na reproducibility/table-figure traceability checklist support; experimental results, configuration selection na metric calculations zilitengenezwa kutoka codebase na artifacts za mwandishi.
Leseni: Kwa kuwa open Creative Commons reuse license kwa utafiti huu haikuweza kuthibitishwa kwa kuaminika katika current bibliographic verification, fail-closed approach inapaswa kutumika katika visual/copyright operations.
Mpaka muhimu zaidi wa tafsiri: Matokeo ya AutoQuant ni backtest/simulation results chini ya assumptions za small account na linear transaction costs. Market impact na institutional capacity hazijamodeliwa; CAGR au Sharpe values zilizopatikana si guarantee ya live, scalable profitability.
Maelezo ya toleo: Mbinu na numerical findings katika maandishi haya ya kisayansi ya Verianla zimetolewa kutoka uploaded arXiv v1 source. Rekodi ya Expert Systems with Applications Journal Pre-proof ya 2026 imethibitishwa ili kusasisha bibliographic status, na possible scientific revisions katika newer version hazijaongezwa kimya kimya kwenye matokeo ya uploaded v1.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *