


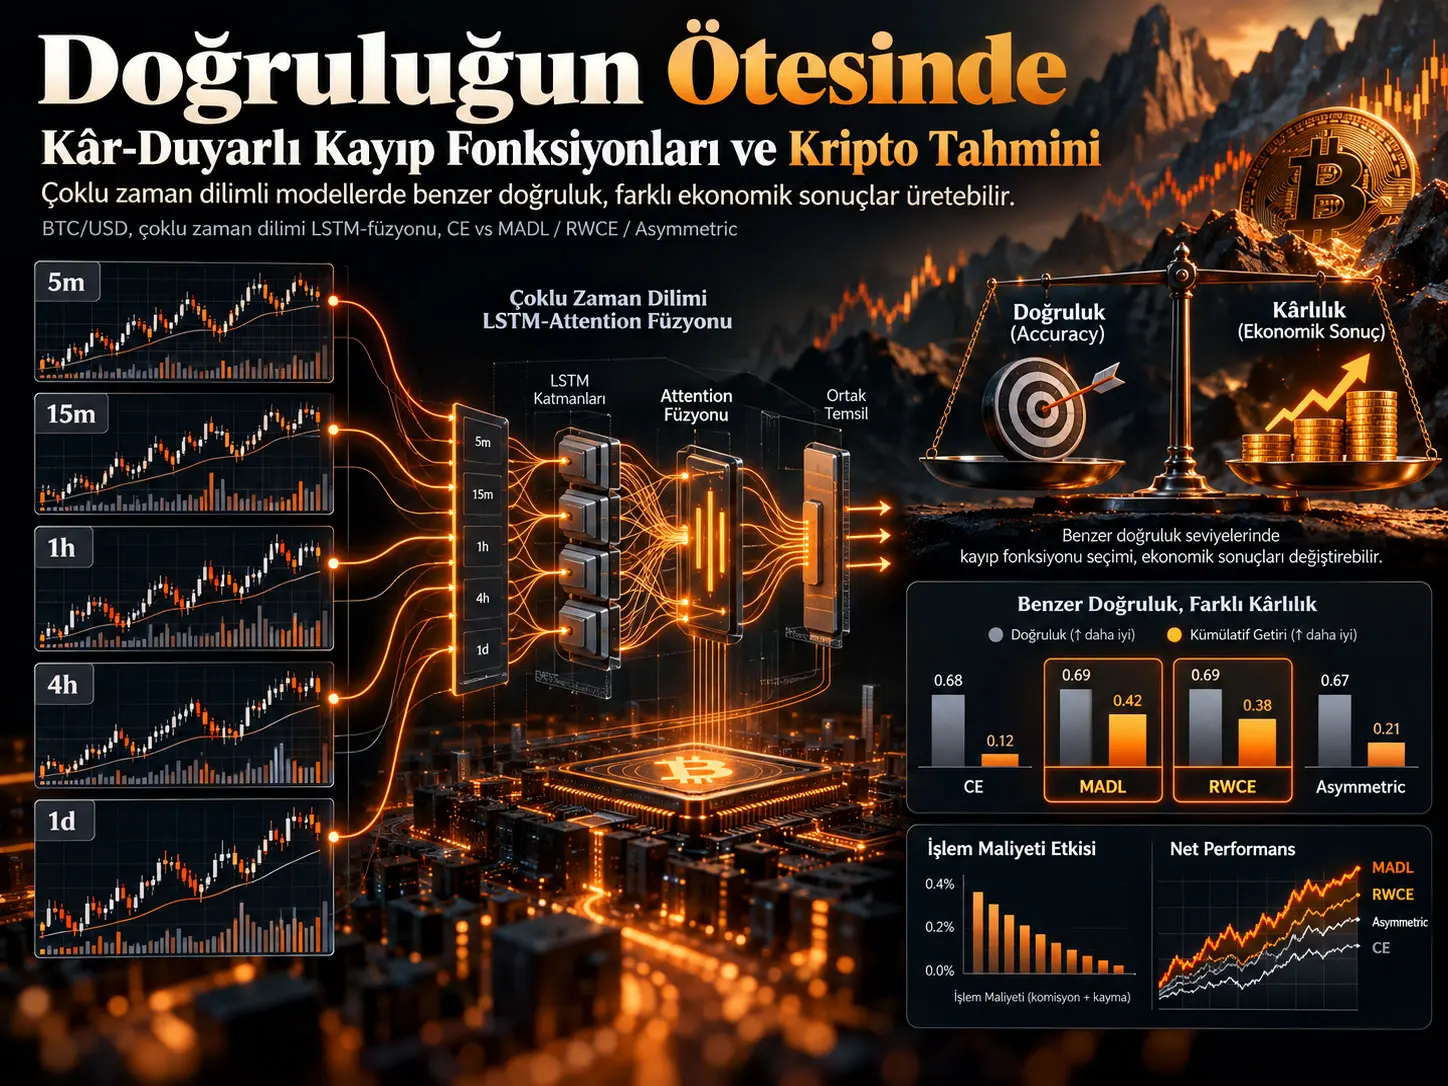
Kâr-duyarlı kayıp fonksiyonu, sınıflandırma hatalarını yalnız doğru/yanlış olmalarına göre değil, hatanın ilişkili olduğu finansal fiyat hareketinin büyüklüğü veya risk-düzeltilmiş getiri etkisine göre de ağırlıklandıran bir model eğitim amacıdır. Haruki Tanabe, 2019–2024 arasındaki yaklaşık 5,3 yıllık BTC/USD Bybit perpetual verisinde beş zaman dilimini birleştiren LSTM-attention modelini kullanarak standart Cross-Entropy (CE) ile beş kâr-duyarlı loss’u karşılaştırmaktadır: MADL, Return-Weighted CE (RWCE), Profit-Guided Loss, Sharpe Loss ve Asymmetric Directional Loss. Ana sonuç, CE ile yaklaşık aynı %72 yön doğruluğunu koruyan return-magnitude-weighted yöntemlerin net bar başı getiriyi 14,83 bp’den 15,55–15,57 bp’ye, yani yaklaşık %4,9–%5,0 artırmasıdır. Ancak çalışma tarihsel veri üzerinde backtesttir; canlı işlem performansı veya gerçek portföy kârlılığı kanıtı değildir.
Çalışmanın önemli yapısal bulgusu, MADL ve RWCE’nin kullanılan implementasyonda iki ayrı loss ailesi olmamasıdır. İkisi de aynı return-weighted cross-entropy çekirdeğini kullanmakta ve yalnız büyük getiri örneklerine uygulanacak üst clipping sınırı \(\tau\) bakımından ayrılmaktadır. MADL için varsayılan \(\tau=5\), RWCE için \(\tau=3\)’tür. Ana deneyde \(\tau=3\)–5 bölgesi güçlü görünürken üç walk-forward rejimde \(\tau\in[2,15]\) değerleri fold içinde istatistiksel olarak ayırt edilememiştir.
Saatlik getirilerden \(\sqrt{8760}\) ile yıllıklandırılan Sharpe değerleri return-weighted trio için yaklaşık %5,4–%5,5 artış göstermektedir; fakat mutlak Sharpe seviyeleri 25–29 gibi olağanüstü büyüktür ve i.i.d. ölçekleme varsayımına bağlıdır. Günlük toplulaştırmada avantaj +%0,4–%3,1’e iner; Newey–West HAC düzeltmesinde sıralama korunurken MADL için çoklu karşılaştırma sonrası anlamlılık sınırda kalır. Bu nedenle çalışmanın en sağlam ekonomik sonucu, yıllıklandırılmış mutlak Sharpe değil, işlem maliyetleri sonrası bar başına net baz puan getirisidir.
Araştırma problemi: Accuracy neden tek başına yeterli değil?
Finansal yön tahmininde klasik sınıflandırma problemi, gelecekte fiyatın yukarı mı aşağı mı hareket edeceğini tahmin etmektir. Standart Cross-Entropy, yanlış sınıflandırılan her örneğe olasılık hatasına göre ceza verir; fakat yanlış tahmin edilen fiyat hareketinin ekonomik büyüklüğünü doğrudan dikkate almaz.
Bu durum finansal uygulamada önemli bir uyuşmazlık yaratabilir. %5’lik fiyat hareketinin yönünü yanlış tahmin etmek ile %0,01’lik hareketi yanlış tahmin etmek classification loss açısından benzer olabilir; fakat trading PnL üzerindeki etkileri aynı değildir.
Çalışma bu farkı accuracy–profitability gap olarak ele almaktadır. Araştırmanın ana sorusu, yön doğruluğunu büyük ölçüde korurken eğitim loss’unu fiyat hareketinin finansal önemine daha iyi hizalamanın backtest performansını artırıp artırmadığıdır.
Kâr-Duyarlı Kayıp Fonksiyonu Nedir ve Accuracy’den Neden Farklıdır?
Kâr-duyarlı kayıp fonksiyonu, eğitim sırasında örneklerin finansal önemini loss’a dâhil eder; bu çalışmada özellikle büyük fiyat hareketlerine daha fazla ağırlık veren loss’lar, CE ile yaklaşık aynı yön doğruluğunu korurken daha yüksek net bar başı getiri üretmiştir. Bu sonuç accuracy’nin gereksiz olduğu anlamına gelmez; ekonomik olarak farklı büyüklükteki doğru ve yanlış tahminlerin aynı classification metriği altında görünmez kalabileceğini gösterir.
Karşılaştırılan altı loss
| Loss | Kategori | Temel mekanizma | Ana varsayılan |
|---|---|---|---|
| Cross-Entropy (CE) | Standart sınıflandırma | Bütün hataları finansal büyüklükten bağımsız cezalandırır. | Yok |
| MADL | Return-weighted | Cross-entropy’yi \(|r|\) büyüklüğüne göre ağırlıklandırır. | \(\tau=5\) |
| Return-Weighted CE (RWCE) | Return-weighted | MADL ile aynı çekirdek; farklı clipping sınırı. | \(\tau=3\) |
| Profit-Guided | Profit-direct | CE’ye differentiable PnL terimi ekler. | \(\alpha=0.5\), warmup=5 |
| Sharpe Loss | Risk-adjusted | CE ve differentiable Sharpe benzeri amacı birleştirir. | \(\beta\) floor=0.5, warmup=5 |
| Asymmetric Directional | Asimetrik | Yukarı/aşağı hata maliyetlerini ayrı katsayılarla değiştirebilir. | \(\lambda_{up}=\lambda_{down}=1.5\), \(\tau=3\) |
Ortak değişkenler
Bütün loss’lar \(L(z,y,r)\) arabirimini kullanır. \(z\), iki sınıflı model logits’idir; \(y\in\{0,1\}\) yön etiketidir; \(r\) ilgili gelecek getiridir. Yukarı yön olasılığı:
\[ p_i=\operatorname{softmax}(z_i)_1 \]
olarak tanımlanır. Soft trading position:
\[ pos_i=2p_i-1 \]
şeklindedir. \(pos_i\) eğitimde differentiable financial objectives için kullanılır; gerçek backtest kararında ise \(p_i>0.5\) durumunda long, aksi durumda short hard decision uygulanır.
Cross-Entropy
\[ L_{CE} = -\frac{1}{N} \sum_{i=1}^{N} \left[ y_i\log p_i+(1-y_i)\log(1-p_i) \right] \]
Cross-Entropy yön sınıflandırmasının olasılık hatasını ölçer. Getirinin yüzde veya baz puan büyüklüğü bu denkleme doğrudan girmez.
Return-weighted loss ailesi
Çalışmanın birleşik formülasyonu:
\[ L_{RW}(\tau) = \frac{1}{N} \sum_{i=1}^{N} \tilde{w}_i(\tau)\,CE(z_i,y_i) \]
ve:
\[ w_i(\tau) = \operatorname{clip} \left( \frac{|r_i|}{|r|_B}, 0.1, \tau \right), \qquad \tilde{w}_i=\frac{w_i}{\bar{w}} \]
şeklindedir.
\(|r_i|\), örnek \(i\)’nin mutlak getirisidir. \(|r|_B\), batch ortalama mutlak getiridir. \(\tau\), aşırı büyük return ağırlıklarının gradient’i domine etmesini önleyen üst clipping sınırıdır. Son ağırlıkların batch ortalaması tekrar 1 olacak biçimde normalize edilir.
Böylece büyük hareketler CE içinde daha önemli hale gelirken tek bir uç fiyat hareketinin bütün batch loss’unu kontrol etmesi sınırlanır.
MADL ve RWCE Bu Çalışmada Gerçekten Farklı Kayıp Fonksiyonları mı?
Bu implementasyonda hayır: MADL ve RWCE aynı \(L_{RW}(\tau)\) çekirdeğini kullanmakta, operasyonel olarak yalnız üst clipping sınırı \(\tau\) bakımından ayrılmaktadır; MADL varsayılan olarak \(\tau=5\), RWCE ise \(\tau=3\) kullanır. Dolayısıyla çalışmanın kendi sonuçlarına göre pratik sorun iki ayrı loss ailesi seçmekten çok tek bir return-weighting ailesinde \(\tau\) değerini seçmektir.
Kaynak ayrıca özgün MADL yayınının clipping ve renormalization kullanmadığını açıkça belirtmektedir. Bu nedenle burada “MADL” adı altında raporlanan \(\tau=5\) sürümü, MADL ilkesinin bu çalışmada stability amacıyla değiştirilmiş uygulamasıdır.
Profit-Guided Loss
\[ L_{PGL} = L_{CE} - \alpha \frac{1}{N} \sum_{i=1}^{N}pos_i r_i \]
\(\alpha\), PnL teriminin ağırlığıdır. Çalışma warmup kullanarak \(\alpha\)’yı ilk epoch’larda sıfırdan hedef değere yükseltmektedir.
Ancak erken stopping ile warmup arasında beklenmeyen etkileşim görülür. Varsayılan warmup=5 konfigürasyonunda en iyi epoch 6 seçildiği için efektif \(\alpha\) çok düşük/CE-dominant kalmaktadır. Warmup kaldırıldığında bile iyileşme MADL/RWCE seviyesine ulaşmamıştır.
Sharpe Loss
\[ L_{Sharpe} = \beta L_{CE} + (1-\beta) \left( -\frac{E[pos\cdot\tilde r]} {\operatorname{std}(pos\cdot\tilde r)+\epsilon} \right) \]
burada:
\[ \tilde r = \frac{r}{|r|_B+\epsilon}, \qquad \epsilon=10^{-6} \]
kullanılır.
Varsayılan konfigürasyonda Sharpe optimization classification gradient’i ile çatışarak accuracy’yi yaklaşık 1,4 yüzde puanı düşürmüştür. Ancak Appendix C’de iki boyutlu \((\beta,warmup)\) aramasıyla Sharpe Loss’un yaklaşık 28,00 düzeyine geri döndüğü gösterilir. Dolayısıyla kaynak Sharpe Loss’u temelde işe yaramaz olarak değil, yüksek tuning maliyetli ve varsayılan hiperparametrelere hassas olarak yorumlamaktadır.
Asymmetric Directional Loss
Asimetrik loss:
\[ L_{Asym} = \frac{1}{N} \sum_i a_i w_i CE(z_i,y_i) \]
ve yön katsayısı:
\[ a_i = 1 + y_i(\lambda_{up}-1)(1-p_i) + (1-y_i)(\lambda_{down}-1)p_i \]
şeklindedir.
\(\lambda_{up}\) ve \(\lambda_{down}\), yukarı ve aşağı yönlü hata maliyetlerinin farklılaştırılmasını sağlar. Ancak ana deneyde iki katsayı da 1,5 olduğundan tam anlamıyla yön-asimetrik bir preferans kullanılmamaktadır. Kaynak, gerçek non-LRW davranışın \(\lambda_{up}\neq\lambda_{down}\) olduğunda ortaya çıktığını belirtmektedir.
Kripto getirilerinin dağılımı neden önemli?
Kaynak BTC’nin 15 dakikalık basit getirilerinde çok yüksek leptokurtosis raporlamakta ve equity intraday getirilerine göre daha ağır kuyruklu bir dağılım ortamı olduğunu savunmaktadır. Return weighting’in mantığı özellikle büyük hareketlerin nadir fakat ekonomik olarak önemli olduğu bu tür dağılımlarda daha anlamlıdır.
Bununla birlikte “kripto ağır kuyrukludur, dolayısıyla \(\tau=5\) evrensel optimumdur” sonucu çıkarılamaz. Walk-forward analizinde farklı excess-kurtosis rejimleri için \(\tau\) argmax’ları değişmiş, fakat geniş bir \([2,15]\) aralığı fold içinde istatistiksel olarak ayırt edilememiştir.
\(\kappa-\lambda\) coupling yorumu
Kaynak, \(\kappa\)’yı tail heaviness/excess kurtosis; \(\lambda\)’yı ise loss kaynaklı gradient/noise varyansı için kuramsal bir bileşen olarak ele alır. Gerçek piyasa deneyinde \(\lambda\) doğrudan gözlenmediği için cross-seed Sharpe standard deviation proxy olarak kullanılmaktadır.
Üç walk-forward fold ve altı loss’tan oluşan 18 hücrede:
\[ r_{\text{Pearson}} = +0.633, \qquad p=0.005 \]
bulunmuştur. Accuracy tabanlı hata oranı ile kurtosis arasında ise belirgin ilişki yoktur. Yazar bu sonucu, ağır kuyruk ve training noise birlikte yükseldiğinde optimum clipping ihtiyacının kısmen dengelenebileceği hipotezine destek olarak yorumlar.
Bu mekanizma deneysel olarak kesinleştirilmiş fiziksel yasa değildir. Kullanılan \(\lambda\) doğrudan noise ölçümü değil bir proxy, fold-mean yeniden toplamada ise bağımsız örnek sayısı yalnız üçtür.
Çoklu zaman dilimli LSTM-fusion mimarisi
Model beş zaman dilimini paralel işler:
| Zaman dilimi | Model içindeki rol |
|---|---|
| 5 dakika | En kısa dönem piyasa hareketleri |
| 15 dakika | Ana hedef zaman ekseni |
| 1 saat | Orta-kısa dönem bağlam |
| 4 saat | Daha geniş trend bağlamı |
| 1 gün | Uzun dönem piyasa bağlamı |
Her timeframe için bağımsız iki katmanlı LSTM kullanılır:
\[ h^{(k)}=LSTM_k(X^{(k)}) \]
Her girdi dizisinin uzunluğu \(T=48\), her zaman dilimindeki özellik boyutu \(d_k=19\)’dur.
Beş encoder çıktısı:
\[ H\in\mathbb{R}^{5\times128} \]
şeklinde stack edilir ve scaled dot-product attention uygulanır:
\[ Attn(Q,K,V) = softmax \left( \frac{QK^\top}{\sqrt{H}} \right)V \]
Sonrasında timeframe attention ağırlıklarıyla fused representation üretilir ve 128→64→2 classifier yön olasılığı üretir.
19 özellik
| Özellik grubu | Kaynakta kullanılan örnekler |
|---|---|
| Fiyat | Return, log-return |
| Hareketli ortalamalar | SMA-7/25/50/99 oranları, EMA-12/26 oranları |
| Osilatörler | RSI(14), normalize RSI, MACD histogram, normalize MACD |
| Volatilite | Bollinger Band position, ATR(14), ATR ratio, rolling volatility 10/20 |
| Hacim | Volume SMA(10), volume ratio |
Tahmin hedefi
Ana binary target:
\[ y_t=\mathbf{1}[p_{t+4}>p_t] \]
şeklindedir ve 15 dakikalık zaman diliminde dört bar sonrasını, yani yaklaşık 1 saat sonraki fiyat yönünü tahmin eder.
Etiket dağılımı %50,7 yukarı ve %49,3 aşağıdır; dolayısıyla ciddi class imbalance yoktur.
Look-ahead bias önleme
Modelde bütün rolling teknik göstergeler causal operators ile hesaplanır. Tahmin indeksi \(t\) için \(t-1\) özellik satırı kullanılır. Daha yüksek timeframe verileri yalnız tahmin anından önce tamamen kapanmış barlardan gelir. StandardScaler yalnız training set üzerinde fit edilir. Train/validation/test split kronolojiktir.
Daily timeframe için son kullanılabilir bar bazı durumlarda yaklaşık 23 saat 59 dakika eski olabilir; kaynak bunu leakage’dan kaçınmanın bedeli olan stale-context durumu olarak kabul etmektedir.
Leakage diagnostikleri
Shuffled-label eğitiminde test accuracy:
%50,79 ± yaklaşık 0
düzeyine iner ve model tek sınıfa çöker. Normal etiketlerde accuracy yaklaşık %72’dir.
Target horizon deneyi 1 saat, 4 saat, 16 saat, 25 saat, 64 saat ve 250 saat ufuklarında sinyalin giderek bozulduğunu gösterir. 1 saatte yaklaşık %72,3 olan accuracy, 250 saat civarında yaklaşık %42,4’e iner.
Bu sonuç horizon-invariant bilgi sızıntısıyla uyumlu değildir. Ancak kaynak yalnız bir seed kullandığı bu testin bütün olası horizon-specific leakage yollarını dışlamadığını belirtir.
Çoklu Zaman Dilimi Füzyonu Sonuçlar İçin Ne Kadar Önemli?
Çoklu zaman dilimi füzyonu çalışmanın sonuçları için kritik görünmektedir: yalnız 15 dakikalık timeframe kullanıldığında accuracy yaklaşık %50–%53 sınıf-önceliği düzeyine düşmüş ve altı loss’un tamamı negatif trading sonucu üretmiştir. Dolayısıyla kâr-duyarlı loss avantajı, güçlü çoklu-timeframe representation’ın yerine geçen bir mekanizma değil; bu representation üzerine eklenen loss-design iyileştirmesidir.
Çalışmanın Yöntemi ve Bulguları
Veri seti
| Özellik | Kaynak değeri |
|---|---|
| Ana varlık | BTC/USD, Bybit perpetual futures |
| Dönem | 2019-10-01 – 2024-12-31 |
| 5 dakikalık bar | 552.672 |
| Takvimsel kapsama oranı | Yaklaşık %99,2 |
| Zaman dilimleri | 5m, 15m, 1h, 4h, 1d |
| 15m bar | 184.224 |
| 1h bar | 46.056 |
| Train/validation/test | %70 / %15 / %15 kronolojik |
| Ana test bar sayısı | 23.040 |
Model eğitim yapılandırması
| Parametre | Değer |
|---|---|
| LSTM katman sayısı | 2 / timeframe |
| Hidden size | 128 |
| Dropout | 0,2 |
| Toplam parametre | Yaklaşık 1,1 milyon |
| Optimizer | Adam |
| Learning rate | 0,001 |
| Batch size | 64 |
| Early stopping patience | 10 |
| Maksimum epoch | 100 |
| Ana seed’ler | 42–51 |
| Ana tekrar sayısı | 10 seed/loss |
Trading simulation koşulları
| Koşul | Değer |
|---|---|
| Başlangıç notional | 10.000 USD |
| Transaction cost | %0,1 / trade |
| Round-trip maliyet | %0,2 |
| Slippage | %0,05 |
| Pozisyon kararı | \(p>0.5\Rightarrow+1\), aksi \(-1\) |
| Pozisyon büyüklüğü | Her sinyalde full-size |
| Getiri toplama | Basit, non-compound |
| Funding | Ana backtest maliyetine dâhil değil |
Ana sınıflandırma performansı
| Loss | Accuracy | F1 | MCC |
|---|---|---|---|
| CE | 0,7228 ± 0,0032 | 0,7226 ± 0,0032 | 0,4471 ± 0,0064 |
| MADL | 0,7218 ± 0,0033 | 0,7215 ± 0,0036 | 0,4451 ± 0,0061 |
| Profit-Guided | 0,7198 ± 0,0033 | 0,7193 ± 0,0037 | 0,4425 ± 0,0048 |
| Sharpe Loss | 0,7084 ± 0,0036 | 0,7078 ± 0,0040 | 0,4197 ± 0,0066 |
| RWCE | 0,7231 ± 0,0027 | 0,7226 ± 0,0031 | 0,4489 ± 0,0044 |
| Asymmetric | 0,7224 ± 0,0024 | 0,7220 ± 0,0025 | 0,4472 ± 0,0054 |
CE, MADL, RWCE ve Asymmetric accuracy bakımından istatistiksel olarak birbirinden ayırt edilememektedir. Profit-Guided modest bir accuracy kaybı, varsayılan Sharpe Loss ise daha belirgin accuracy kaybı göstermektedir.
Ana ekonomik performans
| Loss | Yıllıklandırılmış Sharpe | Net avg/bar | Max drawdown | Sharpe farkı vs CE |
|---|---|---|---|---|
| CE | 27,07 ± 0,72 | 14,83 bp | -2,61 ± 0,47% | — |
| MADL | 28,53 ± 0,30 | 15,55 bp | -2,34 ± 0,22% | +%5,4 |
| Profit-Guided | 26,73 ± 0,63 | 14,66 bp | -2,65 ± 0,44% | -%1,3 |
| Sharpe Loss, default | 25,73 ± 1,17 | 14,14 bp | -2,65 ± 0,58% | -%5,0 |
| Sharpe Loss, best tuned | 28,00, n=3 | 15,36 bp | Raporlanmamış | +%3,4 vs 10-seed CE baseline |
| RWCE | 28,52 ± 0,38 | 15,55 bp | -2,51 ± 0,26% | +%5,4 |
| Asymmetric | 28,56 ± 0,69 | 15,57 bp | -2,51 ± 0,35% | +%5,5 |
Ana ekonomik iddia yıllıklandırılmış Sharpe’dan ziyade net bar başı getiridir. Return-weighted trio CE’ye göre yaklaşık 0,72–0,74 bp/bar ek getiri üretmektedir.
Bar başı getiri nasıl hesaplanıyor?
Kaynak Table 7’de:
\[ Avg/bar\;(bp) = \frac{ROI(\%)\times10000} {100\times n_{bar}} \]
ve \(n_{bar}=23{,}040\) kullanmaktadır.
Bu dönüşüm cumulative simple ROI’yi test bar sayısına bölerek karşılaştırılabilir ortalama bar başı getiriyi verir.
Çalışmadaki Sharpe 25–29 Değerleri Gerçek Portföy Performansı Olarak Okunabilir mi?
Hayır. Kaynağın 25–29 aralığındaki yıllıklandırılmış Sharpe değerleri saatlik Sharpe’ın \(\sqrt{8760}\) ile ölçeklenmesine ve i.i.d. getiri varsayımına bağlıdır; yazar günlük toplulaştırma ve Newey–West HAC kontrollerinde mutlak değerlerin önemli ölçüde düştüğünü gösterir ve ana ekonomik kanıt olarak net bp/bar metriğini öne çıkarır. Benzer biçimde binlerce yüzdeye ulaşan cumulative non-compound ROI eğrileri gerçekçi bileşik portföy getirisi değildir.
Günlük Sharpe sağlamlık kontrolü
| Loss | Günlük yıllık Sharpe | CE’ye göre fark |
|---|---|---|
| CE | 23,89 ± 1,10 | — |
| MADL | 23,99 ± 0,14 | +%0,4 |
| Profit-Guided | 24,15 ± 1,04 | +%1,1 |
| Sharpe | 24,31 ± 0,87 | +%1,8 |
| RWCE | 24,63 ± 0,30 | +%3,1 |
| Asymmetric | 23,49 ± 1,29 | -%1,7 |
Özellikle Asymmetric’in saatlik +%5,5 sonucunun günlük ölçekte -%1,7’ye dönmesi, kullanılan annualization sıklığının yorum için ne kadar önemli olduğunu göstermektedir.
Newey–West HAC sonucu
| Loss | IID Sharpe | Newey–West Sharpe | NW/IID SE inflator | p vs CE, NW |
|---|---|---|---|---|
| CE | 27,07 ± 0,72 | 16,37 ± 0,38 | 1,65 | — |
| MADL | 28,39 ± 0,43 | 16,73 ± 0,28 | 1,70 | 0,054 |
| RWCE | 28,02 ± 0,54 | 16,64 ± 0,35 | 1,68 | 0,222 |
Bonferroni m=2 uygulandığında MADL sonucu p=0,108’e yükselmektedir. Sıralama korunur, fakat Sharpe farkının istatistiksel kesinliği per-bar return sonucu kadar güçlü değildir.
Çoklu karşılaştırma düzeltmeleri
Önceden belirlenen MADL, RWCE ve Asymmetric vs CE Sharpe karşılaştırmalarında paired t-test, Bonferroni, Holm ve Wilcoxon sonuçları return-weighted trio’nun CE’den yüksek olduğunu desteklemektedir.
| Loss | ∆Sharpe | p raw | p Bonferroni | p Holm |
|---|---|---|---|---|
| MADL | +1,46 | <0,001 | <0,001 | <0,001 |
| RWCE | +1,45 | <0,001 | <0,001 | <0,001 |
| Asymmetric | +1,48 | <0,001 | 0,0025 | 0,0015 |
| Profit-Guided | -0,34 | 0,1699 | 0,8495 | 0,1699 |
| Sharpe default | -1,34 | 0,0061 | 0,0306 | 0,0123 |
Cohen’s d nasıl yorumlanmalı?
MADL için paired Cohen’s d=2,63, RWCE için 2,51, Asymmetric için 2,09’dur. Kaynak özellikle bu büyük effect-size değerlerinin piyasa düzeyinde evrensel sağlamlık anlamına gelmediğini belirtmektedir. Paydadaki varyans yalnız farklı random seed eğitimlerinden kaynaklanan training stochasticity’dir.
Bu nedenle d>2, “dünya piyasalarında çok büyük etki” anlamına değil, aynı veri ve model koşullarında loss farkının seed-noise’a kıyasla büyük olduğuna işaret eder.
Market regime sonuçları
| Loss | Up Sharpe | Down Sharpe | Flat Sharpe |
|---|---|---|---|
| CE | 29,6 | 29,6 | 25,4 |
| MADL | 30,8 | 31,3 | 26,9 |
| RWCE | 31,0 | 31,3 | 26,8 |
| Asymmetric | 30,7 | 31,2 | 27,0 |
| Profit-Guided | 29,0 | 29,1 | 25,1 |
| Sharpe Loss | 27,9 | 26,8 | 24,6 |
Return-weighted loss’ların CE üzerindeki en büyük göreli avantajı down-period’da görülür. MADL 31,3, CE 29,6 Sharpe üretir; yaklaşık %5,7 farktır.
Transaction-cost sensitivity
| Tek yön maliyet | CE Sharpe | MADL Sharpe | RWCE Sharpe |
|---|---|---|---|
| %0,05 | 35,1 | 36,5 | 36,4 |
| Bybit taker ≈ %0,055 | 33,9 | 35,4 | 35,3 |
| %0,1 baseline | 26,4 | 28,4 | 28,2 |
| %0,2 | 10,6 | 13,4 | 13,0 |
| %0,5 | -19,0 | -15,4 | -16,0 |
İşlem Maliyetleri Artınca Return-Weighted Loss Avantajı Korunuyor mu?
Kaynakta test edilen %0,05–%0,5 tek-yön işlem maliyeti aralığında MADL≈RWCE>CE sıralaması korunmaktadır; ancak %0,5 maliyette üç stratejinin de performansı negatife döner. Bu nedenle çalışma return-weighted loss’un maliyetleri ortadan kaldırdığını değil, test edilen maliyet seviyelerinde CE’ye göre daha dayanıklı olduğunu göstermektedir.
Baseline %0,1 maliyette kaynak, MADL’ın CE’ye göre yaklaşık %8,4; RWCE’nin %6,9 daha düşük toplam işlem maliyeti ürettiğini hesaplamaktadır. Yazar bunu düşük-sinyalli barlarda gereksiz pozisyon değişikliklerinin azalmasıyla ilişkilendirmektedir.
Tek zaman dilimi ablasyonu
| Loss | 15m-only accuracy | Sharpe | ROI diagnostic |
|---|---|---|---|
| CE | 52,33% | -5,77 | -767,1% |
| MADL | 50,26% | -3,35 | -445,4% |
| RWCE | 50,64% | -3,13 | -416,9% |
| Asymmetric | 50,83% | -5,69 | -755,8% |
| Profit-Guided | 52,75% | -5,68 | -756,4% |
| Sharpe Loss | 51,53% | -3,83 | -506,3% |
Bu ablation, multi-timeframe temsilin model sinyalinin temel kaynağı olduğunu gösterir.
\(\tau\) clipping duyarlılığı
| \(\tau\) | Accuracy | Sharpe | Max DD |
|---|---|---|---|
| 1 | 72,05% | 27,6 | -2,68% |
| 2 | 72,51% | 28,0 | -2,54% |
| 3, RWCE | 72,33% | 28,2 | -2,43% |
| 5, MADL | 72,12% | 28,4 | -2,38% |
| 10 | 71,65% | 27,3 | -2,57% |
Ana splitte ters-U biçimli pattern görünmektedir. Ancak walk-forward fold’larda genişletilmiş \(\tau=\{1,2,3,5,7,10,15\}\) taraması, \(\tau\ge2\) seçeneklerinin fold içinde birbirinden güvenilir biçimde ayırt edilemediğini göstermiştir. Dolayısıyla \(\tau=5\)’i evrensel optimum olarak yorumlamak doğru değildir.
Binance spot replikasyonu
| Loss | Accuracy | Sharpe |
|---|---|---|
| CE | 70,56 ± 0,53% | 27,86 ± 0,38 |
| MADL | 69,13 ± 0,80% | 28,47 ± 1,16 |
| RWCE | 70,18 ± 0,15% | 29,56 ± 0,91 |
| Asymmetric | 69,74 ± 0,43% | 28,57 ± 1,10 |
| Profit-Guided | 70,43 ± 0,60% | 27,77 ± 0,58 |
| Sharpe Loss | 68,96 ± 1,13% | 27,82 ± 0,53 |
Binance spot döneminde return-weighted aile üstünlüğünün yönü korunur; ancak MADL–CE Sharpe farkı Bybit BTC perpetual’daki yaklaşık +%5,4’ten yaklaşık +%2,2’ye iner. Etki büyüklüğü piyasa rejimine bağlıdır.
ETH/USDT cross-asset doğrulaması
| Loss | Accuracy | Sharpe | Max DD |
|---|---|---|---|
| MADL | 0,7204 ± 0,0019 | 31,22 ± 0,78 | -5,05 ± 0,79% |
| Asymmetric | 0,7219 ± 0,0025 | 31,13 ± 0,70 | -4,86 ± 0,58% |
| RWCE | 0,7223 ± 0,0017 | 31,08 ± 0,60 | -5,05 ± 0,80% |
| CE | 0,7232 ± 0,0013 | 30,45 ± 0,63 | -5,05 ± 0,46% |
| Profit-Guided | 0,7222 ± 0,0021 | 30,36 ± 0,71 | -5,12 ± 0,46% |
| Sharpe Loss | 0,7152 ± 0,0018 | 29,27 ± 0,57 | -6,30 ± 1,71% |
MADL, Asymmetric ve RWCE’nin CE’ye Sharpe üstünlüğü ETH’de de anlamlıdır; ancak effect size yaklaşık \(d\approx1\) düzeyine iner. Kaynağa göre BTC’deki \(d>2\) değerine kıyasla bu sıkışma hem daha küçük ortalama gap hem de daha yüksek cross-seed varyanstan kaynaklanır.
Walk-forward doğrulama
| Loss | Bear Sharpe | Recovery Sharpe | Bull Sharpe | Ortalama |
|---|---|---|---|---|
| CE | 22,9 | 17,0 | 27,7 | 22,5 |
| MADL | 24,0 | 20,9 | 28,2 | 24,3 |
| RWCE | 24,0 | 20,4 | 28,2 | 24,2 |
| Asymmetric | 23,7 | 20,6 | 28,4 | 24,2 |
| Profit-Guided | 23,1 | 19,1 | 27,4 | 23,2 |
| Sharpe Loss | 23,8 | 18,2 | 27,1 | 23,0 |
Return-weighted trio her fold’da CE’nin üzerinde görünür. Fakat yalnız üç fold olduğu için paired t-test fold means anlamlı değildir. Page trend testinin p=5,6×10⁻⁴ sonucu sıralamanın rastlantısal olmadığına ek destek verir.
PGL hyperparameter araması
\(\alpha\in\{0.1,0.3,0.5,1.0,2.0\}\) ve warmup \(\in\{0,3,5,10\}\) olmak üzere 20 konfigürasyon × 3 seed taranmıştır. En iyi PGL:
\(\alpha=1.0\), warmup=0, Sharpe≈27,0
olmuştur. Aynı üç seed’de CE baseline 26,42’dir. Bu iyileşme MADL/RWCE 28,5 seviyesine ulaşmamaktadır.
Sharpe Loss hyperparameter araması
\(\beta\in\{0.1,0.3,0.5,0.7,0.9\}\) ve warmup \(\in\{0,3,5,10\}\) taranmıştır. En iyi konfigürasyon:
\(\beta=0.3\), warmup=0, Sharpe=28,00±0,60
olmuştur. Bu sonuç Sharpe Loss’un doğru tuning ile recover edilebildiğini, fakat return-weighted loss’ların tek \(\tau\) parametresine kıyasla daha pahalı iki boyutlu arama gerektirdiğini gösterir.
Alternatif weighting pilotları
Appendix G’de Confidence-Weighted LRW ve GMADL pilot olarak denenmiştir. Confidence-Weighted LRW, MADL’dan -0,66 Sharpe daha düşük görünür; GMADL varsayılan \(a=10,b=2\) ile accuracy yaklaşık %61,7’ye ve Sharpe 22,14’e çöker.
Kaynak özellikle GMADL sonucunu fair head-to-head üstünlük kanıtı saymaz. Parametrelerin daha düşük frekanslı equity verisine göre kalibre edildiğini, ayrı \((a,b)\) grid search yapılmadığını ve sonucun “default-hyperparameter transfer failure” olduğunu belirtir.
Algorithm 1: loss seçimi
| Trading amacı | Önerilen loss | Kaynak mantığı |
|---|---|---|
| General-purpose | RWCE, \(\tau=3\) | Yüksek accuracy + top-tier Sharpe + düşük seed varyansı |
| Max Sharpe, aggressive | MADL, \(\tau=5\) | Top-tier Sharpe, en düşük top-tier std, en sığ drawdown |
| Max Sharpe, conservative | RWCE, \(\tau=3\) | Top-tier Sharpe ve daha yüksek accuracy |
| Asymmetric preference | Asymmetric Directional | \(\lambda_{up}\) ve \(\lambda_{down}\) ile yönsel risk tercihi |
| Maximum accuracy only | Cross-Entropy | Finansal HP gerekmez |
Algorithm 1 ayrıca işlem maliyeti \(c>0.005\) olduğunda, Table 12’ye dayalı olarak test edilen pipeline’ın bu maliyet seviyesinde kârlı olmadığını belirten uyarı üretir.
RWCE neden varsayılan öneridir?
Kaynak RWCE’yi genel amaçlı varsayılan olarak seçmektedir çünkü ana BTC deneyinde en yüksek accuracy’yi (%72,31) verirken MADL ve Asymmetric ile istatistiksel olarak aynı top-tier Sharpe grubunda kalır ve cross-seed Sharpe varyansı Asymmetric’den düşüktür. MADL daha agresif maksimum-Sharpe seçeneği olarak tutulur; farkların kendisi küçük ve rejime bağımlıdır.
Çalışmanın desteklediği sonuçlar
- Multi-timeframe LSTM-fusion üzerinde return-magnitude weighting, CE’ye benzer accuracy ile daha yüksek net bp/bar üretebilir.
- MADL ve RWCE bu implementasyonda aynı \(L_{RW}(\tau)\) ailesinin farklı \(\tau\) değerleridir.
- Ana BTC splitinde MADL/RWCE/Asymmetric net bar başına getiride CE’den yaklaşık %4,9–%5,0 daha yüksektir.
- Return-weighted trio’nun ana per-bar sonucu çoklu test düzeltmelerinde korunur.
- Cross-seed varyans MADL’da CE’ye göre belirgin biçimde düşmektedir.
- Return-weighted yöntemler up, down ve flat market rejimlerinde CE’den daha yüksek Sharpe üretmiştir.
- Binance BTC spot ve ETH/USDT doğrulamaları yönsel sıralamayı desteklemektedir.
- Üç walk-forward fold’da return-weighted trio CE’nin üzerinde kalmaktadır.
- Tek-timeframe ablation, güçlü performansın çoklu-timeframe representation’a önemli ölçüde bağlı olduğunu göstermektedir.
- Sharpe Loss’un varsayılan başarısızlığı tuning sonrası kısmen geri kazanılabilmektedir.
Çalışmanın desteklemediği sonuçlar
- Return-weighted loss’ların canlı trading’de mutlaka kârlı olacağı gösterilmemiştir.
- Binlerce yüzde cumulative ROI gerçek, bileşik ve uygulanabilir yatırım getirisi değildir.
- Sharpe 25–29 değerleri i.i.d. varsayımından bağımsız gerçek portföy Sharpe’ı değildir.
- MADL’ın bütün kripto varlıklarda veya bütün piyasalarda RWCE’den üstün olduğu gösterilmemiştir.
- \(\tau=5\)’in evrensel optimum olduğu gösterilmemiştir.
- Return-weighting’in SOL, XRP veya düşük-kurtosis geleneksel varlıklarda aynı büyüklükte avantaj sağlayacağı test edilmemiştir.
- Full-size position sizing gerçekçi risk bütçelemesini temsil etmemektedir.
- Funding, market impact ve gerçek emir defteri execution’ın tamamı ana backtest modeline dâhil değildir.
- Tek mimari üzerinde bulunan loss sıralamasının Transformer veya başka backbone’larda aynı kalacağı gösterilmemiştir.
- Cross-seed Cohen’s d, market-level external validity ölçüsü değildir.
Temel sınırlılıklar
- Cross-asset kapsamı BTC ve ETH ile sınırlıdır.
- Düşük-\(\kappa\) bir geleneksel piyasa kontrolü yoktur.
- Model backbone’u sabit LSTM-attention’dır.
- Feature normalization global StandardScaler ile yapılır; rolling normalization test edilmemiştir.
- Slippage ana deneyde sabit %0,05’tir.
- Funding ana backtest performansına dâhil edilmemiştir; kaynak ayrı kontrolde ranking’in korunduğunu söyler.
- PGL için early-stopping patience >10 test edilmemiştir.
- Walk-forward yalnız 3 fold × 3 seed’dir.
- Signal-decay leakage diagnostic tek seed üzerinde yapılmıştır.
- ETH doğrulaması farklı dönem ve rejimi içerir.
- Position sizing her sinyalde full-size’dır.
- Kelly sizing veya volatility targeting uygulanmamıştır.
- Daha geniş differentiable-Sharpe, distributional-regression ve focal-loss karşılaştırması yoktur.
Gelecek çalışma alanları
Kaynak; data-driven \(\tau\) seçimi, SOL/XRP gibi ek varlıklar, düşük-kurtosis kontroller, Kelly veya volatility-targeting deployment, gerçek live trading, Transformer/gated-fusion backbone’ları ve daha geniş loss aileleriyle doğrudan karşılaştırmaları gelecek araştırma alanları olarak önermektedir.
Kaynak ve Yöntem Notu
Tam özgün başlık: Beyond Accuracy: A Systematic Comparison of Profit-Aware Loss Functions for Multi-Timeframe Cryptocurrency Price Prediction.
Yazar: Haruki Tanabe.
Corresponding author: Haruki Tanabe.
ORCID: 0009-0000-9423-5609.
PDF afiliyasyonu: School of Computer Science, Tokyo University of Technology, 1404-1 Katakuracho, Hachioji, Tokyo, Japan.
Platform: SSRN.
SSRN Abstract ID: 6928679.
DOI: 10.2139/ssrn.6928679.
Posting tarihi: 12 Haziran 2026.
Sayfa sayısı: 61.
Kaynak türü: Preprint research paper.
Hakemlik: Kaynak çalışma hakem değerlendirmesinden geçmediğini açıkça belirtmektedir.
Hakemli sürüm: Güncel bibliyografik doğrulamada ayrı bir version of record doğrulanmamıştır.
Lisans: SSRN — All rights reserved; permission olmadan yeniden kullanım yok.
Anahtar kelimeler: Loss function design; Cryptocurrency prediction; Multi-timeframe analysis; Deep learning; Trading profitability.
Ana veri: BTC/USD Bybit perpetual, 1 Ekim 2019–31 Aralık 2024.
Ana gözlem: 552.672 adet 5 dakikalık OHLCV bar.
Zaman dilimleri: 5m, 15m, 1h, 4h, 1d.
Ana hedef: 1 saatlik yön tahmini, \(y_t=\mathbf{1}[p_{t+4}>p_t]\).
Özellik sayısı: Her timeframe için 19.
Model: Beş bağımsız iki katmanlı LSTM encoder + scaled dot-product attention fusion + binary classifier.
Hidden size: 128.
Dropout: 0,2.
Toplam parametre: Yaklaşık 1,1 milyon.
Optimizer: Adam.
Learning rate: 0,001.
Batch size: 64.
Early stopping: patience 10, maksimum 100 epoch.
Seed’ler: Ana deneylerde 42–51.
Ana loss’lar: CE, MADL, Profit-Guided, Sharpe Loss, RWCE, Asymmetric Directional.
MADL varsayılanı: \(\tau=5\).
RWCE varsayılanı: \(\tau=3\).
Profit-Guided varsayılanı: \(\alpha=0.5\), warmup 5.
Sharpe Loss varsayılanı: \(\epsilon=10^{-6}\), warmup 5, CE floor 0,5.
Asymmetric varsayılanı: \(\lambda_{up}=1.5\), \(\lambda_{down}=1.5\), \(\tau_{mag}=3\).
Ana ekonomik sonuç: CE 14,83 bp/bar; return-weighted trio 15,55–15,57 bp/bar.
Göreli ana kazanç: Yaklaşık +%4,9–%5,0.
Ana multiple-comparison sonucu: MADL/RWCE/Asymmetric vs CE için önceden belirlenmiş Sharpe karşılaştırmalarında Bonferroni sonrası anlamlılık korunmaktadır.
IID yıllık Sharpe: CE 27,07; MADL 28,53; RWCE 28,52; Asymmetric 28,56.
Yorum sınırı: Bu mutlak Sharpe değerleri saatlik i.i.d. \(\sqrt{8760}\) yıllıklandırmasına bağlıdır.
Günlük Sharpe farkları: Return-weighted trio’da CE’ye göre yaklaşık +%0,4 ile +%3,1 arasında; Asymmetric günlük hesapta -%1,7’ye dönmektedir.
Newey–West HAC: Ranking korunur; MADL vs CE için raw p=0,054, Bonferroni sonrası yaklaşık 0,108.
Cross-seed variance sonucu: MADL net bp/bar varyansı CE’ye göre yaklaşık %58 düşüktür.
Trading maliyeti baseline: %0,1 / işlem + %0,05 slippage.
Cost sensitivity: %0,5 / işlem seviyesinde test edilen bütün ana stratejiler negatiftir.
Cross-exchange validation: Binance BTC/USDT spot, 2023-07–2024-12.
Cross-asset validation: ETH/USDT Bybit perpetual, yaklaşık 2021-03-15–2024-12-31.
Walk-forward: Bear, Recovery ve Bull olmak üzere üç expanding-window fold.
Leakage kontrolü: Shuffled labels test accuracy %50,79; normal labels yaklaşık %72.
Reproducibility donanımı: NVIDIA RTX 5070 Ti, 16 GB VRAM; CUDA 12.8; PyTorch 2.7.
Ana deney hesaplama bütçesi: 6 loss × 10 seed = 60 run, yaklaşık 2,5 saat.
Veri erişilebilirliği: BTC/ETH OHLCV Bybit v5 ve Binance Spot API’lerinden temin edilebilir. Trained artefacts, numerical CSV ve kod yazardan makul talep üzerine sağlanabilir.
Finansman: Kamu, ticari veya kâr amacı gütmeyen fon kuruluşlarından özel grant alınmamıştır.
Çıkar çatışması: Yazar bilinen competing financial interest veya çalışmayı etkileyebilecek kişisel ilişki bildirmemektedir.
CRediT: Haruki Tanabe — Conceptualization, Methodology, Software, Validation, Formal analysis, Investigation, Data Curation, Writing – Original Draft, Writing – Review & Editing, Visualization.
Generative AI bildirimi: Anthropic Claude Opus 4; manuscript editing, reviewer-response anticipation, statistical sanity-checking ve LaTeX formatting amacıyla kullanılmıştır. Nihai içerik sorumluluğu yazara aittir.
Temel dış geçerlilik sınırı: Kaynak sonuçlar esas olarak BTC/ETH kripto piyasaları ve kullanılan LSTM-attention backbone’u için doğrulanmıştır; daha düşük kurtosis varlıklara veya başka model ailelerine genellenmesi ayrıca test edilmelidir.
Backtest sınırı: Çalışma canlı trading çalışması değildir; full-size hard position, basitleştirilmiş cost/slippage modeli ve non-compound diagnostic equity kullanılmaktadır.
Telif sınırı: Kaynak SSRN sürümü All rights reserved olduğu için özgün figür düzeni veya ekran görüntüleri yeniden kullanılmamalıdır; yalnız olgusal sayılar ve yöntem ilişkileri yeni Verianla grafikleriyle yeniden ifade edilmelidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir