


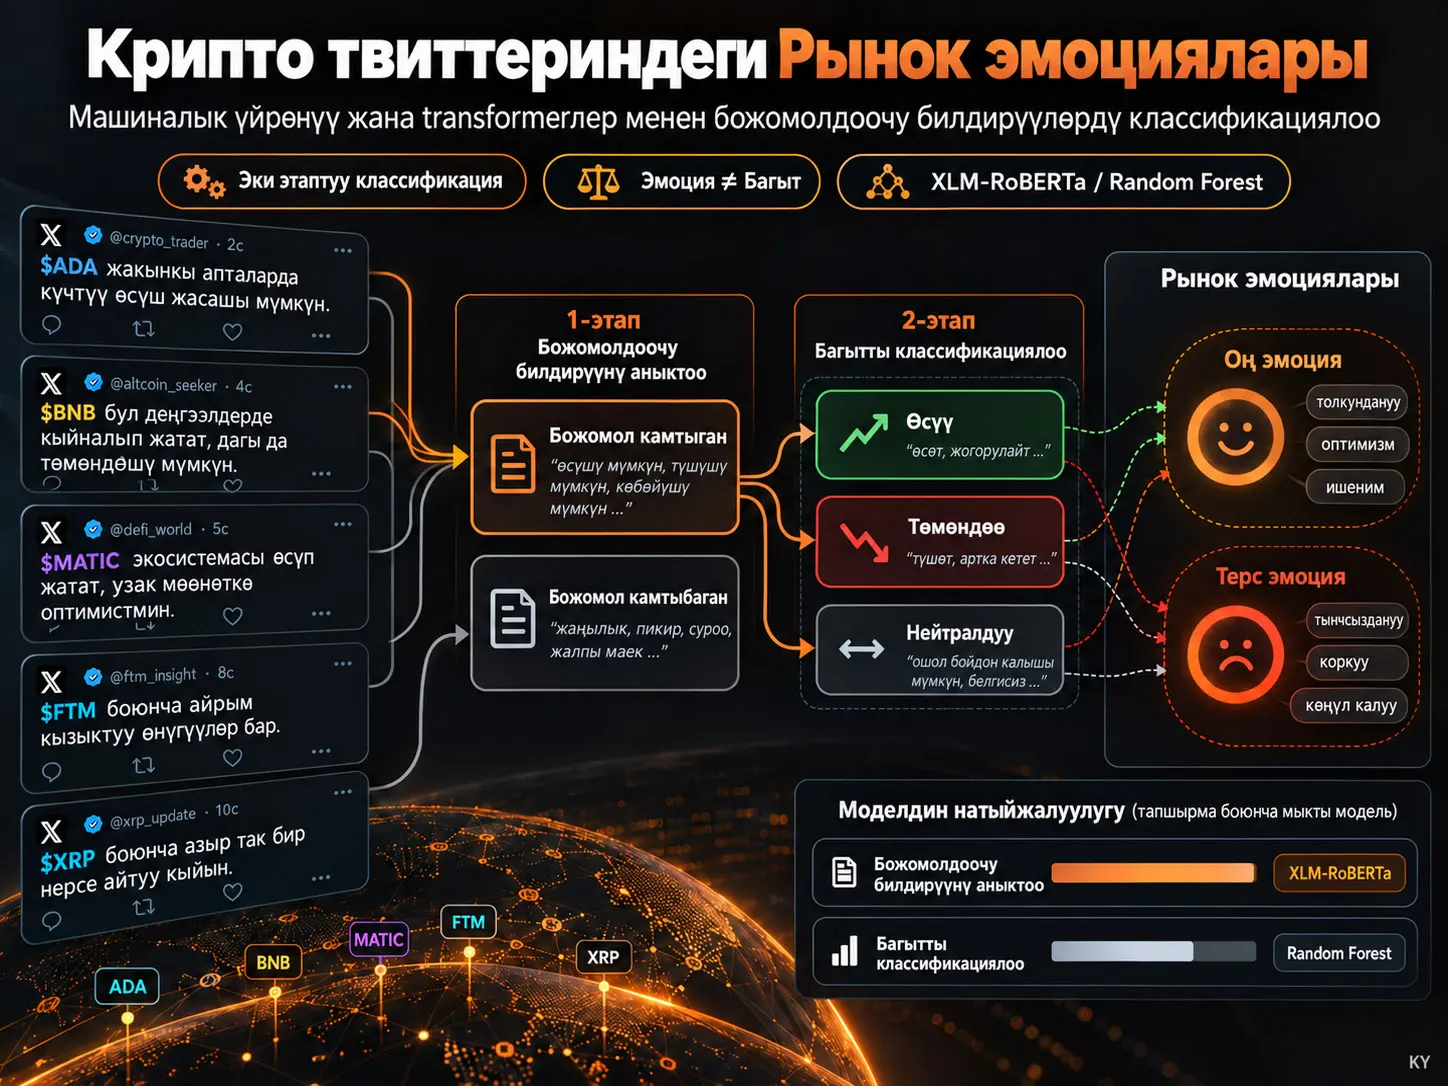
Болжолдоочу билдирүүлөрдү классификациялоо (predictive statement classification) — социалдык медиадагы тексттин жөн гана оң же терс эмоцияны камтый турган-камтыбай турганын эмес, келечекке байланыштуу багытталган күтүүнү камтый турган-камтыбай турганын жана камтыса, бул күтүүнүн өсүү, төмөндөө же өзгөрбөө багытында экенин аныктоочу текст классификациялоо ыкмасы. Бул изилдөө Cardano, Binance, Fantom, Matic жана Ripple жөнүндө англис тилиндеги X/Twitter билдирүүлөрүнөн тандалган 3.116 твитти эки этапта классификациялайт. Task 1 Predictive жана Non-Predictive билдирүүлөрдү ажыратат; Task 2 болсо Predictive деп табылган билдирүүлөрдү гана Incremental, Decremental жана Neutral класстарына бөлөт. Эки адам-annotator менен GPT негизиндеги annotation, SenticNet эмоция чыгаруу, GPT-4o paraphrase augmentation, салттуу машиналык үйрөнүү, CNN/BiLSTM жана transformer моделдери чогуу бааланган.
Булакта класс тең салмаксыздыгы жоюлганда бардык модель үй-бүлөлөрүндө көрсөткүчтөр кыйла жогорулаганы көрүнөт. Тең салмакталган Task 1де эң жогорку macro F1 XLM-RoBERTa менен 0,7011. Тең салмакталган Task 2де болсо эң жогорку macro F1 transformer эмес, Random Forest менен 0,6488; эң мыкты терең үйрөнүү натыйжасы CNN + FastText менен 0,6153, эң мыкты transformer натыйжасы DistilRoBERTa менен 0,5936. Демек, бир эле модель үй-бүлөсү эки тапшырманын тең ичинде үстөм эмес.
Изилдөөнүн негизги илимий салымы бааны болжолдоо эмес, эмоциянын багыты менен рыноктук күтүүнүн багытын бири-биринен ажыратуу. Колдонуучу баанын төмөндөшүн күтүп, жоготуу коркунучунан улам муну терс маанайда билдириши мүмкүн; башка колдонуучу ошол эле төмөндөөнү сатып алуу мүмкүнчүлүгү деп көргөндүктөн оң эмоция көрсөтүшү мүмкүн. Ошондуктан жалгыз классикалык sentiment анализи инвестордун чыныгы багыт күтүүсүн туура эмес чечмелеши мүмкүн. Изилдөө азырынча бул классификацияланган билдирүүлөрдү ошол эле учурдагы реалдуу баа кыймылдары менен текшерген эмес; демек жыйынтыктарды түздөн-түз криптовалюта баасын ийгиликтүү болжолдоо катары окууга болбойт.
Изилдөө маселеси
Криптовалюта талкууларында “эмоция” жана “күтүү” бир эле түшүнүк эмес. Оң маанайдагы твит сөзсүз баанын өсүшүн болжолдобошу мүмкүн; терс твит да сөзсүз төмөндөө күтүүсүнө туура келбеши мүмкүн. Айрыкча жогорку волатилдүүлүккө ээ рыноктордо бир эле баа кыймылы ар башка инвесторлор тарабынан карама-каршы бааланышы мүмкүн.
Мисалы, баа төмөндөйт деп ойлогон инвестор учурдагы позициясында жоготуу күтүүсүнөн улам коркуу же көңүл калуу билдириши мүмкүн. Башка инвестор болсо ошол эле төмөндөөнү арзаныраак баада сатып алуу мүмкүнчүлүгү деп көрүп, оң эмоция билдириши мүмкүн. Булак сунуштаган эки этаптуу түзүм ошондуктан адегенде келечекке багытталган болжол бар-жогун, андан соң ошол болжолдун багытын аныктоону максат кылат.
Болжолдоочу билдирүүлөрдү классификациялоо классикалык эмоция анализинен эмнеси менен айырмаланат?
Болжолдоочу билдирүүлөрдү классификациялоо твиттин эмоционалдык өңүн эмес, адегенде ал келечекке байланыштуу рыноктук күтүүнү камтыйбы-жокпу, андан соң күтүүнүн өсүү, төмөндөө же өзгөрбөө багытын классификациялайт; муну менен “оң эмоция = өсүү күтүүсү” же “терс эмоция = төмөндөө күтүүсү” сыяктуу дайыма эле туура боло бербеген дал келтирүүлөрдөн качууну көздөйт.
Төрт негизги класс
| Класс | Аныктама | Багыт |
|---|---|---|
| Incremental | Келечекте өсүү, жакшыруу же жогору багытталган кыймылды күткөн билдирүү | Оң багыттагы болжол |
| Decremental | Келечекте азайуу, начарлоо же төмөн багытталган кыймылды күткөн билдирүү | Терс багыттагы болжол |
| Neutral | Жакынкы келечекте байкаларлык өзгөрүү күтпөгөн билдирүү | Туурасынан / өзгөрүүсүз күтүү |
| Non-Predictive | Келечекке байланыштуу ачык болжол же проекция камтыбаган билдирүү | Багыттык болжол жок |
Эки этаптуу классификация архитектурасы
Task 1 бинардык классификация:
Tweet → Predictive же Non-Predictive.
Predictive деп аныкталган твиттер гана Task 2ге өтөт:
Predictive tweet → Incremental, Decremental же Neutral.
Бул түзүмдүн илимий артыкчылыгы адегенде “болжол барбы?” деген суроону, андан соң “болжолдун багыты кандай?” деген суроону чечишинде. Ошентип багыттык классификация өткөн окуяларды баяндаган, жөн гана пикир билдирген же учурдагы абалды сүрөттөгөн твиттер менен аралашпайт.
Маалымат булагы жана тандалма
Баштапкы маалымат топтому 2021-жылдын сентябрынан 2023-жылдын мартына чейин X/Twitter платформасынан чогултулган болжол менен 30.000 англис тилиндеги твиттен турган. Изилдөөчүлөр бул жыйнактан Cardano, Binance, Fantom, Matic жана Ripple менен байланышкан 3.116 твитти кокус тандап, annotation ишине киргизишкен.
| Тапшырма | Класс | Үлгүлөрдүн саны |
|---|---|---|
| Task 1 | Non-Predictive | 2.000 |
| Task 1 | Predictive | 1.116 |
| Task 2 | Incremental | 570 |
| Task 2 | Decremental | 434 |
| Task 2 | Neutral | 112 |
Айрыкча Neutral классынын болгону 112 үлгүдөн турушу Task 2 үчүн олуттуу класс тең салмаксыздыгын жаратат. Macro F1 сыяктуу ар бир класска бирдей салмак берген метриканын төмөн болушунун маанилүү себептеринин бири — ушул аз көрсөтүлгөн класстар.
Annotation процесси
Эки эркек annotator англис тилин жакшы билген жана компьютердик илимдер боюнча магистр даражасына ээ болгон; алардын жашы 28–30 аралыгында эле. Адегенде 100 үлгүдөн турган калибрлөө топтому менен иштешип, каталар каралып, кайтарым байланыш берилген. Толук annotation процесси болжол менен бир айга созулган.
GPT моделдери үчүнчү annotator катары колдонулган. GPT-4o белгилери кол менен берилген белгилер менен салыштырылганда Predictive Statement Detection үчүн Cohen's Kappa 0,7493 деп билдирилген. Булак бул маанини адам жана GPT annotation-ынын ортосундагы күчтүү шайкештиктин көрсөткүчү катары чечмелейт.
Annotation эрежелери
Annotatorлордон келечекке байланыштуу натыйжаны ачык билдирген сүйлөмдөрдү гана predictive деп белгилөө талап кылынган. Твит бир нече болжолду камтыса, үстөмдүк кылган болжол тандалган. Ирониялуу же бүдөмүк болжолдордо ачык келечек багыты болбосо, алар киргизилген эмес. “Bitcoin өсөбү?” сыяктуу жөн гана суроо берген билдирүүлөр, автор жоопту ачык түрдө кыйытып айтпаса, predictive деп эсептелген эмес.
Текстти алдын ала иштетүү
Булакта көрсөтүлгөн алдын ала иштетүү кадамдары URL даректерди регулярдык туюнтмалар менен алып салуу, тыныш белгилери жана атайын символдорду тазалоо, узундугу эки же андан аз белгиден турган сөздөрдү чыгаруу, tokenization жана normalization процесстеринен турат.
Салттуу машиналык үйрөнүү моделдеринде текст TF-IDF аркылуу сандык белгилерге айландырылган. Терең үйрөнүүдө GloVe жана FastText алдын ала үйрөтүлгөн сөз embeddingдери, transformer моделдеринде болсо түздөн-түз алдын ала үйрөтүлгөн контексттик өкүлчүлүктөр колдонулган.
GPT менен класстарды тең салмактоо
Изилдөөчүлөр аз көрсөтүлгөн класстардан үлгүлөрдү тандап, GPT-4oго баштапкы маанини сактап, сөздөрдүн иретин өзгөрткөн paraphrase-тарды жасатышкан. Бул синтетикалык үлгүлөр маалымат топтомуна кошулуп, класстардын саны теңдештирилген.
| Тапшырма | Класс | Тең салмакталган үлгүлөрдүн саны |
|---|---|---|
| Task 1 | Predictive | 2.000 |
| Task 1 | Non-Predictive | 2.000 |
| Task 2 | Incremental | 570 |
| Task 2 | Decremental | 570 |
| Task 2 | Neutral | 570 |
GPT негизиндеги маалымат тең салмактоо моделдин натыйжалуулугуна кандай таасир этти?
Булакта GPT-4o менен түзүлгөн paraphrase үлгүлөрү аз көрсөтүлгөн класстарды теңдегенден кийин салттуу машиналык үйрөнүү, терең үйрөнүү жана transformer моделдеринин macro F1 маанилери кыйла жогорулаганы көрсөтүлгөн; бирок изилдөө көз карандысыз тышкы тест топтомун билдирбегендиктен жана paraphrase үлгүлөрү cross-validation fold-дорунун арасында кантип топтолгону түшүндүрүлбөгөндүктөн, бул өсүш жаңы жана көз карандысыз реалдуу дүйнөдөгү твиттерге канчалык өтөрү өзүнчө текшерилиши керек.
Баалоо метрикалары
Булак Accuracy, Precision, Recall жана F1-score метрикаларын колдонот:
\[ Accuracy=\frac{TP+TN}{TP+TN+FP+FN} \]
\[ Precision=\frac{TP}{TP+FP} \]
\[ Recall=\frac{TP}{TP+FN} \]
\[ F1=2\times\frac{Precision\times Recall}{Precision+Recall} \]
Бул жерде \(TP\) — туура оң, \(TN\) — туура терс, \(FP\) — жалган оң жана \(FN\) — жалган терс учурлар.
Macro F1 ар бир класстын F1 маанисине бирдей салмак берет:
\[ MacroF1=\frac{1}{N}\sum_{i=1}^{N}F1_i \]
Weighted F1 болсо ар бир класстын колдоосун, башкача айтканда үлгүлөрдүн санын салмак катары колдонот:
\[ WeightedF1= \sum_{i=1}^{N} \frac{support_i}{total\ instances} F1_i \]
Изилдөө ар бир класска бирдей маанилүүлүк бергендиктен негизги салыштыруу метрикасы катары macro F1ди тандайт. Баалоо 5-fold cross-validation аркылуу жүргүзүлгөн.
Каралган модель үй-бүлөлөрү
| Модель үй-бүлөсү | Моделдер / өкүлчүлүк |
|---|---|
| Салттуу машиналык үйрөнүү | Logistic Regression, Random Forest, XGBoost, SVM Linear, SVM RBF; TF-IDF белгилери |
| Терең үйрөнүү | CNN жана BiLSTM; GloVe жана FastText embeddingдери |
| Transformer | DistilRoBERTa, RoBERTa-base, RoBERTuito, BERT-base, XLM-RoBERTa |
SenticNet менен эмоция анализи
SenticNet ар бир predictive твит үчүн бир нече эмоция сигналын бере алат. Булак окшош эмоцияларды алты топко бөлүп караган: Delight and Joy, Enthusiasm and Eagerness, Delight and Pleasantness, Grief and Sadness, Fear and Anxiety жана Rage and Anger.
Пайыздардын бир сапта 100гө кошулбашы ката эмес; бир эле твит бир нече эмоция категориясын камтышы мүмкүн.
| Криптовалюта | Delight and Joy | Enthusiasm and Eagerness |
|---|---|---|
| FTM | %81,82 | %41,82 |
| MATIC | %72,41 | %49,66 |
| ADA | %61,29 | %44,09 |
Incremental болжолдордо оң эмоциялар басым; Decremental твиттерде Grief and Sadness, Fear and Anxiety жана Rage and Anger көбүрөөк кездешет. Ошол эле учурда айрым төмөндөө болжолдору да жогорку деңгээлдеги оң эмоцияны камтыйт. Булак муну айрым катышуучулар күтүлгөн баа төмөндөшүн сатып алуу мүмкүнчүлүгү катары көрүшү менен байланыштырат.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Баштапкы тең салмаксыз маалыматтагы салттуу моделдер
| Тапшырма | Эң жогорку модель | Macro F1 |
|---|---|---|
| Task 1 | XGBoost | 0,5068 |
| Task 2 | XGBoost | 0,3631 |
Task 2де macro F1 маанилеринин кыйла төмөн болушу үч багыт классынын семантикалык жактан бири-бирине жакын болушуна жана Neutral классынын өтө кичине болушуна шайкеш келет.
GPT менен тең салмакталган маалыматтагы салттуу моделдер
| Модель | Task 1 Macro F1 | Task 2 Macro F1 |
|---|---|---|
| Logistic Regression | 0,6672 | 0,6396 |
| Random Forest | 0,6380 | 0,6488 |
| XGBoost | 0,6389 | 0,6059 |
| SVM Linear | 0,6583 | 0,6463 |
| SVM RBF | 0,6825 | 0,6478 |
Булак текстинде Task 2 үчүн SVM-RBF “эң жакшы” деп аталганы менен, ошол эле таблицадагы 0,6488 Random Forest мааниси 0,6478ден чоң. Жыйынтык бөлүмү да Random Forestту Task 2нин эң мыкты салттуу модели катары көрсөтөт. Ошондуктан сандык таблицага негизделген салыштырууда Random Forest негиз катары алынган.
Терең үйрөнүү натыйжалары
| Модель | Task 1 | Task 2 |
|---|---|---|
| CNN + GloVe | 0,6277 | 0,6149 |
| BiLSTM + GloVe | 0,6349 | 0,5737 |
| CNN + FastText | 0,6231 | 0,6153 |
| BiLSTM + FastText | 0,6222 | 0,6014 |
Булак баянында Task 2нин эң мыкты терең үйрөнүү модели катары CNN + GloVe жана 0,6149 мааниси көрсөтүлгөнү менен, Таблица 12 CNN + FastText үчүн 0,6153 берет. Жыйынтык бөлүмүндө да CNN + FastText 0,6153 менен туура түрдө лидер катары көрсөтүлгөн.
Transformer натыйжалары
| Модель | Task 1 | Task 2 |
|---|---|---|
| DistilRoBERTa | 0,6593 | 0,5936 |
| RoBERTa-base | 0,6625 | 0,5901 |
| RoBERTuito | 0,6444 | 0,5505 |
| BERT-base | 0,6378 | 0,5439 |
| XLM-RoBERTa | 0,7011 | 0,5367 |
Task 1де XLM-RoBERTa бүткүл изилдөөдөгү эң жогорку macro F1 маанисине жеткен. Task 2де болсо ошол эле модель үй-бүлөсүнүн үстөмдүгү уланбайт; DistilRoBERTa transformerлердин арасында эң жакшы болгону менен Random Forest жана CNN + FastTextтен артта калат.
Үч модель үй-бүлөсүн түз салыштыруу
| Тапшырма | Салттуу ML | Терең үйрөнүү | Transformer | Жалпы лидер |
|---|---|---|---|---|
| Task 1 | SVM-RBF — 0,6825 | BiLSTM + GloVe — 0,6349 | XLM-RoBERTa — 0,7011 | XLM-RoBERTa |
| Task 2 | Random Forest — 0,6488 | CNN + FastText — 0,6153 | DistilRoBERTa — 0,5936 | Random Forest |
Бул таблица булактагы “transformerлер тең салмакталган маалыматта эки тапшырмада тең ачык түрдө жакшыраак” деген билдирүү менен дал келбейт. Task 1 үчүн бул билдирүү туура; Task 2 үчүн туура эмес. Булактын abstract бөлүмү жана жыйынтык бөлүмү таблицаларга шайкеш түрдө transformerлер Task 1де, ал эми салттуу моделдер Task 2де эң жогорку натыйжа бергенин билдирет.
Эмне үчүн эң жакшы модель эки тапшырмада бирдей эмес?
Task 1 predictive жана non-predictive тексттерди гана ажыратса, Task 2 семантикалык жактан бири-бирине жакыныраак Incremental, Decremental жана Neutral күтүүлөрдү ажыратат; булак натыйжаларында контексттик transformer өкүлчүлүгү Task 1де эң жогорку macro F1ди бергенине карабастан, татаалыраак Task 2 айырмалоосунда Random Forestтун TF-IDF негизиндеги салттуу ыкмасы жогору macro F1 берген.
Тең салмаксыз жана тең салмакталган маалыматтын ортосундагы көрсөткүч өзгөрүүсү
| Модель үй-бүлөсү / тапшырма | Тең салмаксыздагы эң жакшы | Тең салмакталганда эң жакшы |
|---|---|---|
| Салттуу ML — Task 1 | 0,5068 | 0,6825 |
| Салттуу ML — Task 2 | 0,3631 | 0,6488 |
| Терең үйрөнүү — Task 1 | 0,5070 | 0,6349 |
| Терең үйрөнүү — Task 2 | 0,3656 | 0,6153 |
| Transformer — Task 1 | 0,5578 | 0,7011 |
| Transformer — Task 2 | 0,4051 | 0,5936 |
Булак бул жыйынтыктарды GPT негизиндеги тең салмактоо өзгөчө minority класстарын үйрөнүүнү жеңилдеткени катары чечмелейт. Бирок баалоо бир эле маалымат булагынын ичиндеги cross-validationга гана таянгандыктан, реалдуу дүйнөгө жалпылоо өзүнчө сыналышы керек.
Ката анализи
| Тапшырма / класс | Precision | Recall | F1 |
|---|---|---|---|
| Task 1 — Non-Predictive | 0,7334 | 0,8000 | 0,7524 |
| Task 1 — Predictive | 0,7178 | 0,6255 | 0,6498 |
| Task 2 — Decremental | 0,5702 | 0,4851 | 0,5242 |
| Task 2 — Incremental | 0,5581 | 0,6316 | 0,5926 |
| Task 2 — Neutral | 0,8224 | 0,8368 | 0,8296 |
Neutral классынын башка эки багыт классынан кыйла оңой таанылышы “өсүү” жана “төмөндөө” болжолдору тилдик жактан көбүрөөк жалпы белгилерди бөлүшүшү мүмкүн экенин көрсөтөт. Булак муну өзгөчө Incremental жана Decremental класстарындагы төмөнүрөөк precision/recall маанилери менен талкуулайт.
9-беттеги confusion matrixтердин илимий билдирүүсү
Булактагы Сүрөт 1 Task 1де Non-Predictive үлгүлөр Predictive үлгүлөргө караганда жогорураак туура классификация көрсөткүчүнө ээ экенин көрсөтөт. Сүрөт 2 болсо Random Forest Task 2де Neutral классын кыйла жакшыраак ажыратканын, Incremental жана Decremental үлгүлөр бири-бири менен көбүрөөк чаташканын көрсөтөт. Бул визуалдар жалгыз жалпы accuracyге карап коюу жетишсиз экенин; класс боюнча ката профили да өзүнчө каралышы керек экенин көрсөтөт.
Бул изилдөө чындап эле криптовалюта бааларын болжолдойбу?
Жок. Изилдөө криптовалюта бааларынын келечектеги сандык маанисин же багытын рыноктук маалыматка салыштырып болжолдобойт; твиттерде адамдардын келечекке байланыштуу багытталган күтүүлөрүн классификациялайт жана авторлор бул класстарды реалдуу баа кыймылдары менен дал келтирүүнү ачык түрдө келечекте жасала турган текшерүү катары калтырышат.
Изилдөө колдогон жыйынтыктар
- Predictive statement менен жалпы sentiment айырмасы крипто социалдык медиа тексттеринде колдонууга мүмкүн болгон эки этаптуу классификация түзүмүн камсыз кылат.
- GPT негизиндеги paraphrase augmentationдан кийин бардык модель үй-бүлөлөрүндө macro F1 жогорулаган.
- Task 1де XLM-RoBERTa эң жогорку macro F1 маанисин берген.
- Task 2де Random Forest transformer жана терең үйрөнүү моделдеринен жогору macro F1 берген.
- Incremental билдирүүлөр көбүнчө оң эмоциялар менен, Decremental билдирүүлөр болсо көбүрөөк терс эмоциялар менен байланышкан.
- Эмоция менен рынок багытынын күтүүсү бирдей эмес; айрым төмөндөө болжолдору оң эмоция менен коштолушу мүмкүн.
- Neutral классы тандалган ката анализинде Incremental жана Decremental класстарынан жогору precision, recall жана F1 көрсөткөн.
Изилдөө колдобогон жыйынтыктар
Изилдөө твит класстары реалдуу криптовалюта баа кыймылдарын болжолдой турганын, моделдер кирешелүү trading системасын түзөрүн, жыйынтыктар башка тилдерге же социалдык медиа платформаларына автоматтык түрдө жалпыланарын, реалдуу убакыттагы рынокто ошол эле ийгиликти сактарын же GPT менен көбөйтүлгөн маалыматтагы cross-validation көрсөткүчү көз карандысыз тышкы маалыматтагы көрсөткүчкө барабар экенин көрсөтпөйт.
Негизги чектөөлөр
Бир платформа: Маалымат X/Twitterдан гана алынган.
Бир тил: Англис тилиндеги твиттер гана колдонулган; маданий жана тилдик жалпылоо текшерилген эмес.
Реалдуу рынок маалыматы жок: Predictive statement класстары азырынча ошол эле учурдагы же келечектеги реалдуу баа кыймылдары менен текшерилген эмес.
Тышкы тест топтому билдирилген эмес: Баалоо 5-fold cross-validationга негизделген.
Augmentation-fold деталдары жетишсиз: GPT paraphrase-тары fold-дордун арасында баштапкы үлгүлөрү менен чогуу топтолгон-топтолбогону түшүндүрүлгөн эмес. Ошондуктан синтетикалык үлгүлөрдүн баалоо көз карандысыздыгына тийгизген таасирин толук көзөмөлдөө мүмкүн эмес.
Гиперпараметр деталдары чектелүү: Булак модель үй-бүлөлөрүн тизмелегени менен ар бир модель үчүн деталдуу окутуу гиперпараметрлерин, optimizer жөндөөлөрүн, epoch санын жана random seed сыяктуу кайра өндүрүлүүчү деталдарды кеңири бербейт.
Булактын ичиндеги натыйжа баяндоосундагы шайкешсиздиктер: Айрым бөлүмчөлөрдүн тексти ошол эле беттеги сандык таблицалардын модель рейтингине туура келбейт; ошондуктан Verianla макаласында сандык таблицаларга жана жыйынтык бөлүмүнө артыкчылык берилген.
Келечектеги изилдөө багыттары
Авторлор predictive statement класстарын жана SenticNet эмоция сигналдарын реалдуу баа кыймылдары менен бирдей убакыт аралыктарында дал келтирип, болжол потенциалын текшерүүнү пландашат. Ошондой эле көп тилдүү маалыматтар, реалдуу убакыттагы колдонмолор жана PBC4cip сыяктуу альтернативдүү класс тең салмактоо ыкмалары келечектеги изилдөө багыттары катары көрсөтүлгөн.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталышы: Decoding Market Emotions in Cryptocurrency Tweets via Predictive Statement Classification with Machine Learning and Transformers
Авторлор: Moein Shahiki Tash; Zahra Ahani; Mohim Tash; Mostafa Keikhay Farzaneh; Ari Y. Barrera-Animas; Olga Kolesnikova.
Аффилиациялар: Centro de Investigación en Computación, Instituto Politécnico Nacional, Ciudad de México; Management and Economics Faculty, University of Sistan and Baluchestan, Zahedan; Universidad Panamericana, Ciudad de México.
Жүктөлгөн булак версиясы: 25 март 2026 датасындагы preprint; PDFде “Preprint submitted to Results in Physics” деген жазуу бар.
Архив жазуусу: arXiv:2603.24933. ArXiv объекти үчүн DOI: 10.48550/arXiv.2603.24933.
Учурдагы жарыялоо абалы: Ошол эле изилдөө жана ошол эле алты автор 2026-жылы Computación y Sistemas, Vol. 30 No. 3, s. 1943–1953 ичинде жарыялангандай көрүнөт. Журнал жазуусунда аталыш “Predictive-Statement Classification” түрүндө дефис менен жазылган.
Журнал: Computación y Sistemas.
Жарыялаган мекеме: Instituto Politécnico Nacional, Centro de Investigación en Computación.
Рецензиялоо: Computación y Sistemas рецензиялануучу илимий журнал; жүктөлгөн документ болсо журналга чейинки preprint версиясы.
Лицензия: Computación y Sistemas жарыялары Creative Commons Attribution 4.0 International (CC BY 4.0) лицензиясы боюнча жарыяланат.
Журналдагы финалдык DOI: Жеткиликтүү расмий журнал индексинде бул макалага тиешелүү финалдык DOI ырасталбагандыктан ойлоп табылган эмес. 10.48550/arXiv.2603.24933 — arXiv версиясынын DOIси.
Маалымат: 2021-жылдын сентябры–2023-жылдын марты аралыгында X/Twitterдан чогултулган болжол менен 30.000 англис тилиндеги твиттик баштапкы жыйнактан кокус тандалган 3.116 твит.
Криптовалюталар: Cardano, Binance, Fantom, Matic жана Ripple.
Annotation: Эки адам annotator + GPT моделдери; GPT-4o менен адам annotation-ынын ортосундагы Predictive Statement Detection Cohen's κ = 0,7493.
Маалыматты тең салмактоо: GPT-4o менен маанини сактаган paraphrase augmentation.
Алдын ала иштетүү: URL алып салуу, атайын символдорду тазалоо, кыска tokenдерди чыгаруу, tokenization жана normalization.
Салттуу моделдер: Logistic Regression, Random Forest, XGBoost, SVM Linear, SVM RBF; TF-IDF өкүлчүлүгү.
Терең үйрөнүү: CNN жана BiLSTM; GloVe жана FastText embeddingдери.
Transformer моделдери: DistilRoBERTa, RoBERTa-base, RoBERTuito, BERT-base, XLM-RoBERTa.
Эмоция чыгаруу: SenticNet.
Баалоо: 5-fold cross-validation; Accuracy, Precision, Recall, F1, Macro F1 жана Weighted F1.
Каржылоо жана колдоо: Mexican Government CONACYT A1-S-47854; Instituto Politécnico Nacional Secretaría de Investigación y Posgrado 20241816, 20241819 жана 20240951 гранттары; INAOE суперкомпьютер ресурстары; Microsoft Latin America PhD Award.
Corresponding author: Жүктөлгөн preprintте ачык көрсөтүлгөн эмес.
Data Availability Statement: Жүктөлгөн preprintте өзүнчө маалымат жеткиликтүүлүгү тууралуу билдирүү жок.
CRediT / автордук салымдар: Жүктөлгөн preprintте өзүнчө CRediT салым бөлүмү жок.
Кызыкчылыктардын кагылышы: Жүктөлгөн preprintте өзүнчө conflict-of-interest билдирүүсү жок.
Негизги илимий чек: Бул изилдөө социалдык медиадагы текстте келечекке багытталган рыноктук күтүүнү классификациялоону баалайт; реалдуу криптовалюта баасын же инвестиция кирешесин forecasting кылуу ийгилигин азырынча сынабайт.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген