


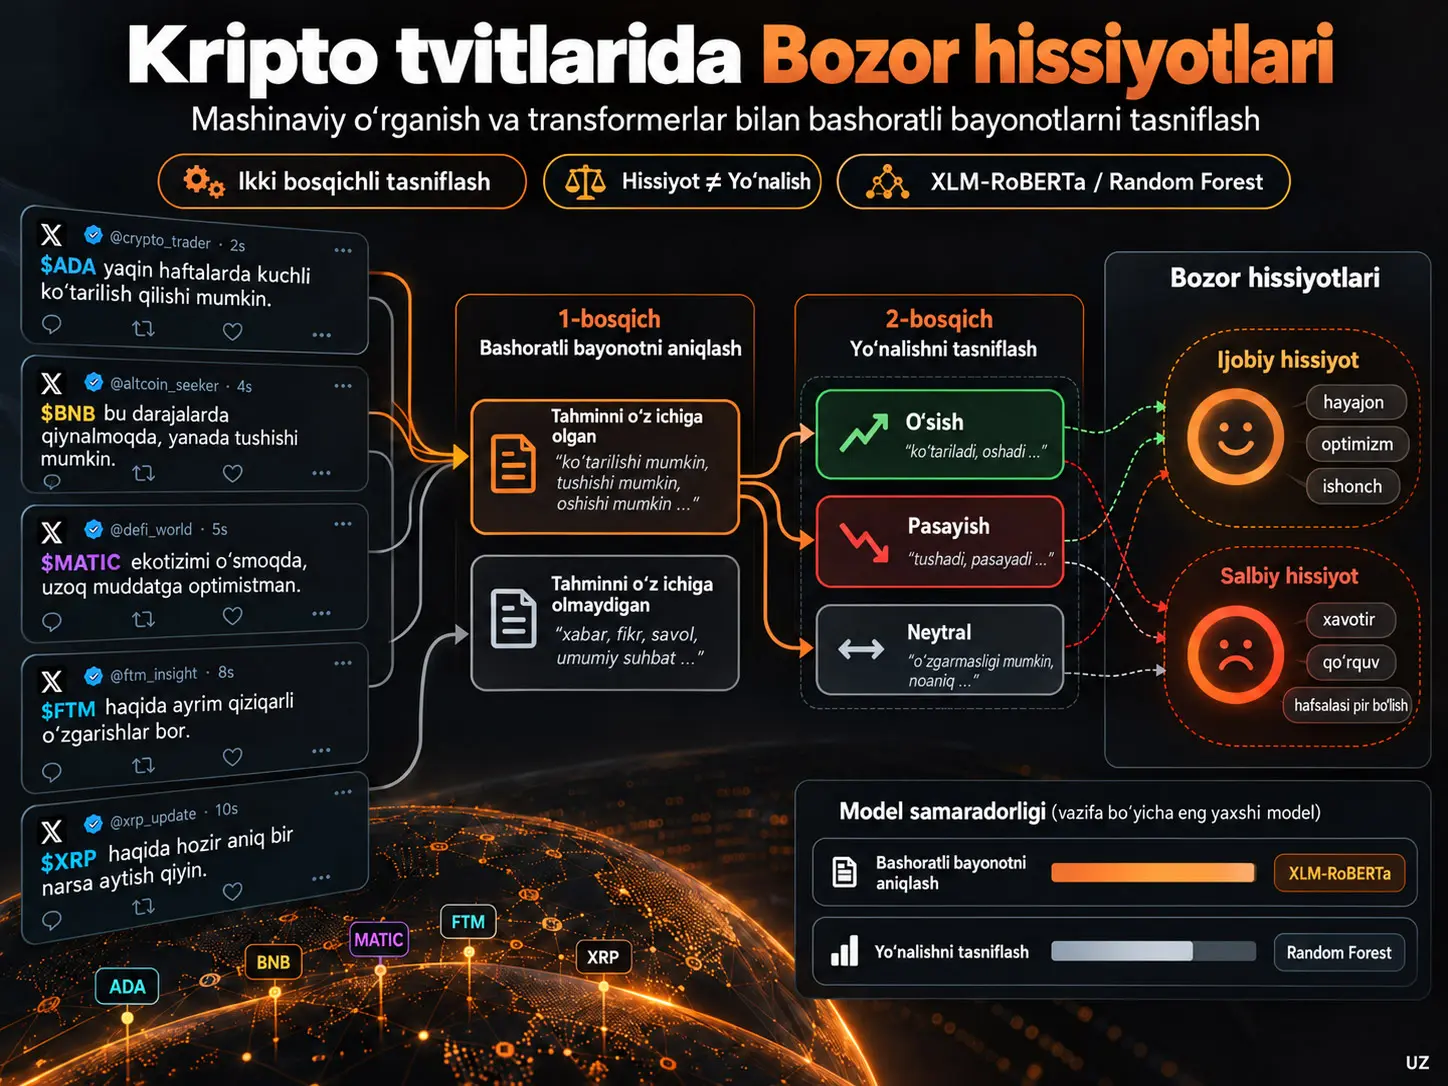
Bashoratli bayonotlarni tasniflash (predictive statement classification) — ijtimoiy tarmoq matnida faqat ijobiy yoki salbiy hissiyot bor-yo‘qligini emas, balki kelajakka oid yo‘nalishli kutish mavjud yoki yo‘qligini va mavjud bo‘lsa, bu kutish o‘sish, pasayish yoki o‘zgarishsiz qolish yo‘nalishida ekanini aniqlaydigan matn tasnifi yondashuvidir. Ushbu tadqiqot Cardano, Binance, Fantom, Matic va Ripple haqidagi ingliz tilidagi X/Twitter postlaridan tanlangan 3.116 ta tvitni ikki bosqichda tasniflaydi. Task 1 Predictive va Non-Predictive bayonotlarni ajratadi; Task 2 esa faqat Predictive bayonotlarni Incremental, Decremental va Neutral sinflariga bo‘ladi. Ikki nafar inson annotator bilan GPT asosidagi annotation, SenticNet orqali hissiyotlarni ajratib olish, GPT-4o paraphrase augmentation, an’anaviy mashinaviy o‘rganish, CNN/BiLSTM va transformer modellari birgalikda baholangan.
Manbada sinf nomutanosibligi bartaraf etilganda barcha model oilalarida natija sezilarli darajada oshgani ko‘rsatiladi. Muvozanatlangan Task 1da eng yuqori macro F1 XLM-RoBERTa bilan 0,7011. Muvozanatlangan Task 2da esa eng yuqori macro F1 transformer emas, Random Forest bilan 0,6488; eng yaxshi chuqur o‘rganish natijasi CNN + FastText bilan 0,6153, eng yaxshi transformer natijasi DistilRoBERTa bilan 0,5936. Shuning uchun bitta model oilasi ikkala vazifada ham ustun emas.
Tadqiqotning asosiy ilmiy hissasi narxni bashorat qilish emas, hissiyot yo‘nalishi bilan bozor kutishi yo‘nalishini bir-biridan ajratishdir. Foydalanuvchi narx pasayishini kutib, yo‘qotishdan qo‘rqishi sababli buni salbiy tarzda ifodalashi mumkin; boshqa foydalanuvchi esa ayni pasayishni xarid qilish imkoniyati deb ko‘rgani uchun ijobiy hissiyot ko‘rsatishi mumkin. Shu sababli faqat klassik sentiment tahlili investorning haqiqiy yo‘nalishli kutishini noto‘g‘ri talqin qilishi mumkin. Tadqiqot hali bu tasniflangan bayonotlarni bir vaqtdagi real narx harakatlari bilan tasdiqlamagan; shuning uchun natijalarni to‘g‘ridan-to‘g‘ri kriptovalyuta narxini muvaffaqiyatli bashorat qilish deb o‘qish kerak emas.
Tadqiqot muammosi
Kriptovalyuta muhokamalarida “hissiyot” va “kutish” bir xil tushuncha emas. Ijobiy tvit albatta narx ko‘tarilishini bashorat qilmasligi mumkin; salbiy tvit ham albatta pasayish kutilishini anglatmasligi mumkin. Ayniqsa yuqori volatillikka ega bozorlarda ayni narx harakati turli investorlar tomonidan qarama-qarshi tarzda baholanishi mumkin.
Masalan, narx tushadi deb o‘ylagan investor mavjud pozitsiyasida zarar kutishi tufayli qo‘rquv yoki hafsalasi pir bo‘lishini ifodalashi mumkin. Boshqa investor esa ayni pasayishni pastroq narxda xarid qilish imkoniyati deb ko‘rgani uchun ijobiy hissiyot ifodalashi mumkin. Manba taklif qilgan ikki bosqichli tuzilma shu sabab avval kelajakka qaratilgan bashorat bor-yo‘qligini, keyin esa ushbu bashoratning yo‘nalishini aniqlashga qaratilgan.
Bashoratli bayonotlarni tasniflash klassik hissiyot tahlilidan qanday farq qiladi?
Bashoratli bayonotlarni tasniflash tvitning hissiy ohangini emas, avval u kelajakka oid bozor kutishini o‘z ichiga oladimi-yo‘qmi, so‘ng esa kutish o‘sish, pasayish yoki o‘zgarishsiz qolish yo‘nalishida ekanini tasniflaydi; shu tariqa “ijobiy hissiyot = ko‘tarilish kutishi” yoki “salbiy hissiyot = pasayish kutishi” kabi har doim ham to‘g‘ri bo‘lmaydigan moslashtirishlardan qochishga intiladi.
To‘rtta asosiy sinf
| Sinf | Ta’rif | Yo‘nalish |
|---|---|---|
| Incremental | Kelajakda o‘sish, yaxshilanish yoki yuqoriga yo‘nalgan harakatni kutuvchi bayonot | Ijobiy yo‘nalishli bashorat |
| Decremental | Kelajakda kamayish, yomonlashish yoki pastga yo‘nalgan harakatni kutuvchi bayonot | Salbiy yo‘nalishli bashorat |
| Neutral | Yaqin kelajakda sezilarli o‘zgarish kutmaydigan bayonot | Yonlama / o‘zgarishsiz kutish |
| Non-Predictive | Kelajakka oid ochiq bashorat yoki proyeksiya bo‘lmagan bayonot | Yo‘nalishli bashorat yo‘q |
Ikki bosqichli tasnif arxitekturasi
Task 1 ikkilik tasnifdir:
Tweet → Predictive yoki Non-Predictive.
Faqat Predictive deb aniqlangan tvitlar Task 2ga o‘tadi:
Predictive tweet → Incremental, Decremental yoki Neutral.
Ushbu dizaynning ilmiy afzalligi avval “bashorat bormi?” degan savolni, keyin “bashoratning yo‘nalishi qanday?” degan savolni hal qilishidir. Shu tariqa yo‘nalishli tasnif o‘tgan voqealarni tasvirlovchi, faqat fikr bildiruvchi yoki hozirgi holatni bayon qiluvchi tvitlar bilan aralashmaydi.
Ma’lumot manbai va tanlanma
Manba ma’lumotlar to‘plami 2021 yil sentabrdan 2023 yil martgacha X/Twitter platformasidan yig‘ilgan taxminan 30.000 ta ingliz tilidagi tvitni o‘z ichiga olgan. Tadqiqotchilar ushbu to‘plamdan Cardano, Binance, Fantom, Matic va Ripple bilan bog‘liq 3.116 ta tvitni tasodifiy tanlab, annotation jarayoniga kiritgan.
| Vazifa | Sinf | Namuna soni |
|---|---|---|
| Task 1 | Non-Predictive | 2.000 |
| Task 1 | Predictive | 1.116 |
| Task 2 | Incremental | 570 |
| Task 2 | Decremental | 434 |
| Task 2 | Neutral | 112 |
Ayniqsa Neutral sinfining atigi 112 ta namunadan iborat bo‘lishi Task 2 uchun jiddiy sinf nomutanosibligini yuzaga keltiradi. Macro F1 kabi har bir sinfga teng og‘irlik beradigan metrikada past natija chiqishining muhim sabablaridan biri aynan shu kam namoyon bo‘lgan sinflardir.
Annotation jarayoni
Ikki erkak annotator ingliz tilini yetarli darajada bilgan va kompyuter fanlari bo‘yicha magistr darajasiga ega bo‘lgan; ularning yoshi 28–30 oralig‘ida edi. Avval 100 ta namunadan iborat kalibrlash to‘plamida ishlashgan, xatolar ko‘rib chiqilgan va fikr-mulohaza berilgan. To‘liq annotation jarayoni taxminan bir oy davom etgan.
GPT modellari uchinchi annotator sifatida ishlatilgan. GPT-4o yorliqlari qo‘lda berilgan yorliqlar bilan taqqoslanganda Predictive Statement Detection uchun Cohen's Kappa qiymati 0,7493 deb xabar qilingan. Bu qiymat manbada inson va GPT annotation’i o‘rtasidagi kuchli moslik ko‘rsatkichi sifatida talqin qilingan.
Annotation qoidalari
Annotatorlardan faqat kelajakdagi natijani aniq nazarda tutuvchi bayonotlarni predictive deb belgilash so‘ralgan. Agar tvit bir nechta bashoratni o‘z ichiga olsa, ustun bashorat tanlangan. Kinoyali yoki noaniq bashoratlarda aniq kelajak yo‘nalishi bo‘lmasa, ular kiritilmagan. “Bitcoin ko‘tariladimi?” kabi faqat savol beruvchi bayonotlar, muallif javobni aniq nazarda tutmasa, predictive deb hisoblanmagan.
Matnni oldindan qayta ishlash
Manbada keltirilgan oldindan qayta ishlash bosqichlari URLlarni muntazam ifodalar yordamida olib tashlash, tinish belgilari va maxsus belgilarni tozalash, uzunligi ikki yoki undan kam belgidan iborat so‘zlarni chiqarib tashlash, tokenization va normalization amallaridir.
An’anaviy mashinaviy o‘rganish modellarida matn TF-IDF orqali raqamli xususiyatlarga aylantirilgan. Chuqur o‘rganishda GloVe va FastText oldindan o‘qitilgan so‘z embeddinglari, transformer modellarida esa bevosita oldindan o‘qitilgan kontekstual tasvirlardan foydalanilgan.
GPT bilan sinflarni muvozanatlash
Tadqiqotchilar kam namoyon bo‘lgan sinflardan namunalar tanlab, GPT-4o ga asl ma’noni saqlagan holda so‘z tartibini o‘zgartiruvchi paraphrase’lar yaratishni topshirgan. Ushbu sintetik namunalar ma’lumotlar to‘plamiga qo‘shilib, sinf sonlari tenglashtirilgan.
| Vazifa | Sinf | Muvozanatlangan namuna soni |
|---|---|---|
| Task 1 | Predictive | 2.000 |
| Task 1 | Non-Predictive | 2.000 |
| Task 2 | Incremental | 570 |
| Task 2 | Decremental | 570 |
| Task 2 | Neutral | 570 |
GPT asosidagi ma’lumotlarni muvozanatlash model natijasiga qanday ta’sir ko‘rsatdi?
Manbada GPT-4o yordamida yaratilgan paraphrase namunalar kam namoyon bo‘lgan sinflarni tenglashtirgandan so‘ng an’anaviy mashinaviy o‘rganish, chuqur o‘rganish va transformer modellarining macro F1 qiymatlari sezilarli darajada oshgani ko‘rsatilgan; biroq tadqiqot mustaqil tashqi test to‘plamini taqdim etmagan va paraphrase namunalarning cross-validation foldlari orasida qanday guruhlanganini tushuntirmaganligi sababli, bu o‘sish yangi va mustaqil real dunyo tvitlariga qay darajada ko‘chishi alohida tekshirilishi kerak.
Baholash metrikalari
Manba Accuracy, Precision, Recall va F1-score metrikalaridan foydalanadi:
\[ Accuracy=\frac{TP+TN}{TP+TN+FP+FN} \]
\[ Precision=\frac{TP}{TP+FP} \]
\[ Recall=\frac{TP}{TP+FN} \]
\[ F1=2\times\frac{Precision\times Recall}{Precision+Recall} \]
Bu yerda \(TP\) to‘g‘ri ijobiy, \(TN\) to‘g‘ri salbiy, \(FP\) noto‘g‘ri ijobiy va \(FN\) noto‘g‘ri salbiy holatlarni bildiradi.
Macro F1 har bir sinfning F1 qiymatiga bir xil og‘irlik beradi:
\[ MacroF1=\frac{1}{N}\sum_{i=1}^{N}F1_i \]
Weighted F1 esa har bir sinfning tayanchini, ya’ni namuna sonini og‘irlik sifatida ishlatadi:
\[ WeightedF1= \sum_{i=1}^{N} \frac{support_i}{total\ instances} F1_i \]
Tadqiqot har bir sinfga teng ahamiyat bergani uchun asosiy taqqoslash o‘lchovi sifatida macro F1ni afzal ko‘radi. Baholash 5-fold cross-validation yordamida amalga oshirilgan.
Ko‘rib chiqilgan model oilalari
| Model oilasi | Modellar / tasvir |
|---|---|
| An’anaviy mashinaviy o‘rganish | Logistic Regression, Random Forest, XGBoost, SVM Linear, SVM RBF; TF-IDF xususiyatlari |
| Chuqur o‘rganish | CNN va BiLSTM; GloVe va FastText embeddinglari |
| Transformer | DistilRoBERTa, RoBERTa-base, RoBERTuito, BERT-base, XLM-RoBERTa |
SenticNet bilan hissiyot tahlili
SenticNet har bir predictive tvit uchun bir nechta hissiyot signalini berishi mumkin. Manba o‘xshash hissiyotlarni oltita guruhda ko‘rib chiqqan: Delight and Joy, Enthusiasm and Eagerness, Delight and Pleasantness, Grief and Sadness, Fear and Anxiety va Rage and Anger.
Foizlarning bitta qatorda 100 ga yig‘ilmasligi xato emas; bir tvit bir nechta hissiyot toifasini o‘z ichiga olishi mumkin.
| Kriptovalyuta | Delight and Joy | Enthusiasm and Eagerness |
|---|---|---|
| FTM | %81,82 | %41,82 |
| MATIC | %72,41 | %49,66 |
| ADA | %61,29 | %44,09 |
Incremental bashoratlarda ijobiy hissiyotlar ustun; Decremental tvitlarda Grief and Sadness, Fear and Anxiety va Rage and Anger ko‘proq uchraydi. Shu bilan birga ayrim pasayish bashoratlari ham yuqori ijobiy hissiyotlarni o‘z ichiga oladi. Manba buni ayrim qatnashchilar kutilayotgan narx pasayishini xarid imkoniyati sifatida baholashi mumkinligi bilan bog‘laydi.
Tadqiqot Usuli va Natijalari
Asl nomuvozanatli ma’lumotdagi an’anaviy modellar
| Vazifa | Eng yuqori model | Macro F1 |
|---|---|---|
| Task 1 | XGBoost | 0,5068 |
| Task 2 | XGBoost | 0,3631 |
Task 2da macro F1 qiymatlarining sezilarli darajada past bo‘lishi uchta yo‘nalish sinfi semantik jihatdan bir-biriga yaqinligi va Neutral sinfi juda kichikligi bilan mos keladi.
GPT bilan muvozanatlangan ma’lumotdagi an’anaviy modellar
| Model | Task 1 Macro F1 | Task 2 Macro F1 |
|---|---|---|
| Logistic Regression | 0,6672 | 0,6396 |
| Random Forest | 0,6380 | 0,6488 |
| XGBoost | 0,6389 | 0,6059 |
| SVM Linear | 0,6583 | 0,6463 |
| SVM RBF | 0,6825 | 0,6478 |
Manba matnida Task 2 uchun SVM-RBF “eng yaxshi” deb atalgan bo‘lsa-da, shu jadvaldagi 0,6488 Random Forest qiymati 0,6478 dan kattaroq. Natija bo‘limida ham Random Forest Task 2ning eng yaxshi an’anaviy modeli sifatida berilgan. Shu sabab sonli jadvalga asoslangan taqqoslashda Random Forest asos qilib olingan.
Chuqur o‘rganish natijalari
| Model | Task 1 | Task 2 |
|---|---|---|
| CNN + GloVe | 0,6277 | 0,6149 |
| BiLSTM + GloVe | 0,6349 | 0,5737 |
| CNN + FastText | 0,6231 | 0,6153 |
| BiLSTM + FastText | 0,6222 | 0,6014 |
Manba bayonida Task 2ning eng yaxshi chuqur o‘rganish modeli sifatida CNN + GloVe va 0,6149 qiymati keltirilgan bo‘lsa-da, 12-jadval CNN + FastText uchun 0,6153 ni beradi. Natija bo‘limida ham CNN + FastText 0,6153 bilan to‘g‘ri ravishda yetakchi deb ko‘rsatilgan.
Transformer natijalari
| Model | Task 1 | Task 2 |
|---|---|---|
| DistilRoBERTa | 0,6593 | 0,5936 |
| RoBERTa-base | 0,6625 | 0,5901 |
| RoBERTuito | 0,6444 | 0,5505 |
| BERT-base | 0,6378 | 0,5439 |
| XLM-RoBERTa | 0,7011 | 0,5367 |
Task 1da XLM-RoBERTa butun tadqiqotdagi eng yuqori macro F1 qiymatiga erishgan. Task 2da esa shu model oilasining ustunligi davom etmaydi; DistilRoBERTa transformerlar ichida eng yaxshi bo‘lsa-da, Random Forest va CNN + FastText dan ortda qoladi.
Uch model oilasini bevosita taqqoslash
| Vazifa | An’anaviy ML | Chuqur o‘rganish | Transformer | Umumiy yetakchi |
|---|---|---|---|---|
| Task 1 | SVM-RBF — 0,6825 | BiLSTM + GloVe — 0,6349 | XLM-RoBERTa — 0,7011 | XLM-RoBERTa |
| Task 2 | Random Forest — 0,6488 | CNN + FastText — 0,6153 | DistilRoBERTa — 0,5936 | Random Forest |
Ushbu jadval manbadagi “transformerlar muvozanatlangan ma’lumotda ikkala vazifada ham aniq yaxshiroq” degan bayonot bilan mos kelmaydi. Task 1 uchun bu bayonot to‘g‘ri; Task 2 uchun esa to‘g‘ri emas. Manbaning abstracti va natija bo‘limi jadvallarga mos ravishda transformerlar Task 1da, an’anaviy modellar esa Task 2da eng yuqori natijani berganini bildiradi.
Nega eng yaxshi model ikkala vazifada bir xil emas?
Task 1 faqat predictive va non-predictive matnlarni ajratsa, Task 2 semantik jihatdan bir-biriga yaqinroq Incremental, Decremental va Neutral kutishlarni ajratadi; manba natijalarida kontekstual transformer tasviri Task 1da eng yuqori macro F1ni bergan bo‘lsa, nozikroq Task 2 farqlashida Random Forestning TF-IDF asosidagi an’anaviy yondashuvi yuqoriroq macro F1 bergan.
Nomuvozanatli va muvozanatlangan ma’lumotlar orasidagi natija o‘zgarishi
| Model oilasi / vazifa | Nomuvozanatdagi eng yaxshi | Muvozanatlangandagi eng yaxshi |
|---|---|---|
| An’anaviy ML — Task 1 | 0,5068 | 0,6825 |
| An’anaviy ML — Task 2 | 0,3631 | 0,6488 |
| Chuqur o‘rganish — Task 1 | 0,5070 | 0,6349 |
| Chuqur o‘rganish — Task 2 | 0,3656 | 0,6153 |
| Transformer — Task 1 | 0,5578 | 0,7011 |
| Transformer — Task 2 | 0,4051 | 0,5936 |
Manba bu natijalarni GPT asosidagi muvozanatlash, ayniqsa minority sinflarni o‘rganishni osonlashtirgani sifatida talqin qiladi. Biroq baholash faqat bir xil ma’lumot manbasi ichidagi cross-validationga tayangani uchun real dunyoga umumlashtirish alohida sinovdan o‘tkazilishi kerak.
Xatolar tahlili
| Vazifa / sinf | Precision | Recall | F1 |
|---|---|---|---|
| Task 1 — Non-Predictive | 0,7334 | 0,8000 | 0,7524 |
| Task 1 — Predictive | 0,7178 | 0,6255 | 0,6498 |
| Task 2 — Decremental | 0,5702 | 0,4851 | 0,5242 |
| Task 2 — Incremental | 0,5581 | 0,6316 | 0,5926 |
| Task 2 — Neutral | 0,8224 | 0,8368 | 0,8296 |
Neutral sinfining boshqa ikki yo‘nalish sinfiga qaraganda ancha oson tanilishi “o‘sish” va “pasayish” bashoratlari til jihatdan ko‘proq umumiy xususiyatlarga ega bo‘lishi mumkinligini ko‘rsatadi. Manba buni ayniqsa Incremental va Decremental sinflaridagi pastroq precision/recall qiymatlari bilan muhokama qiladi.
9-sahifadagi confusion matrixlarning ilmiy xabari
Manbadagi 1-rasm Task 1da Non-Predictive namunalar Predictive namunalarga qaraganda yuqoriroq to‘g‘ri tasniflash ulushiga ega ekanini ko‘rsatadi. 2-rasm esa Random Forest Task 2da Neutral sinfini ancha yaxshiroq ajratishini, Incremental va Decremental namunalar esa bir-biri bilan ko‘proq chalkashishini ko‘rsatadi. Ushbu vizuallar faqat umumiy accuracyga qarash yetarli emasligini; sinf bo‘yicha xato profilini ham alohida ko‘rib chiqish kerakligini ko‘rsatadi.
Ushbu tadqiqot haqiqatan ham kriptovalyuta narxlarini bashorat qiladimi?
Yo‘q. Tadqiqot kriptovalyuta narxlarining kelajakdagi raqamli qiymatini yoki yo‘nalishini bozor ma’lumotlariga nisbatan bashorat qilmaydi; tvitlarda odamlarning kelajakka oid yo‘nalishli kutishlarini tasniflaydi va mualliflar ushbu sinflarni real narx harakatlari bilan moslashtirishni kelajakda bajarilishi kerak bo‘lgan tekshiruv sifatida ochiq qoldiradi.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
- Predictive statement va umumiy sentiment o‘rtasidagi farq kripto ijtimoiy media matnlarida qo‘llash mumkin bo‘lgan ikki bosqichli tasnif tuzilmasini beradi.
- GPT asosidagi paraphrase augmentationdan so‘ng barcha model oilalarida macro F1 oshgan.
- Task 1da XLM-RoBERTa eng yuqori macro F1 qiymatini bergan.
- Task 2da Random Forest transformer va chuqur o‘rganish modellariga qaraganda yuqoriroq macro F1 bergan.
- Incremental bayonotlar asosan ijobiy hissiyotlar bilan, Decremental bayonotlar esa ko‘proq salbiy hissiyotlar bilan bog‘liq.
- Hissiyot va bozor yo‘nalishi kutishi aynan bir narsa emas; ayrim pasayish bashoratlari ijobiy hissiyot bilan birga bo‘lishi mumkin.
- Neutral sinfi tanlangan xato tahlilida Incremental va Decremental sinflarga qaraganda yuqoriroq precision, recall va F1 ko‘rsatgan.
Tadqiqot qo‘llab-quvvatlamaydigan xulosalar
Tadqiqot tvit sinflari real kriptovalyuta narx harakatlarini bashorat qilishini, modellar foydali trading tizimini yaratishini, natijalar boshqa tillarga yoki ijtimoiy media platformalariga avtomatik umumlashtirilishini, real vaqt bozorida xuddi shu natijani saqlashini yoki GPT bilan kengaytirilgan ma’lumotdagi cross-validation natijasi mustaqil tashqi ma’lumot natijasi bilan bir xil ekanini ko‘rsatmaydi.
Asosiy cheklovlar
Bitta platforma: Ma’lumot faqat X/Twitterdan olingan.
Bitta til: Faqat ingliz tilidagi tvitlardan foydalanilgan; madaniy va tilga oid umumlashtirish sinovdan o‘tkazilmagan.
Real bozor ma’lumotlari yo‘q: Predictive statement sinflari hali bir vaqtdagi yoki kelajakdagi real narx harakatlari bilan tasdiqlanmagan.
Tashqi test to‘plami berilmagan: Baholash 5-fold cross-validationga asoslangan.
Augmentation-fold tafsiloti yetishmaydi: GPT paraphrase’lari foldlar orasida asl namunalar bilan birga guruhlangan-guruhlanmagani tushuntirilmagan. Shu sabab sintetik namunalar baholash mustaqilligiga qanday ta’sir qilgani to‘liq nazorat qilinmaydi.
Giperparametr tafsilotlari cheklangan: Manba model oilalarini sanab o‘tsa-da, har bir model uchun batafsil trening giperparametrlari, optimizer sozlamalari, epoch sonlari va random seed kabi qayta ishlab chiqarish tafsilotlarini keng qamrovda bermaydi.
Manba ichidagi natija bayonidagi nomuvofiqliklar: Ba’zi kichik bo‘lim matnlari shu sahifadagi sonli jadvallarning model reytingi bilan mos kelmaydi; shu sabab Verianla maqolasida sonli jadvallar va natija bo‘limiga ustuvorlik berilgan.
Kelajakdagi tadqiqot yo‘nalishlari
Mualliflar predictive statement sinflari va SenticNet hissiyot signallarini real narx harakatlari bilan bir xil vaqt oralig‘ida moslashtirib, bashorat salohiyatini sinashni rejalashtiradi. Shuningdek, ko‘p tilli ma’lumotlar, real vaqt ilovalari va PBC4cip kabi muqobil sinf muvozanatlash usullari kelajakdagi tadqiqot yo‘nalishlari sifatida ko‘rsatilgan.
Manba va Usul Haqida Izoh
Asl sarlavha: Decoding Market Emotions in Cryptocurrency Tweets via Predictive Statement Classification with Machine Learning and Transformers
Mualliflar: Moein Shahiki Tash; Zahra Ahani; Mohim Tash; Mostafa Keikhay Farzaneh; Ari Y. Barrera-Animas; Olga Kolesnikova.
Affiliatsiyalar: Centro de Investigación en Computación, Instituto Politécnico Nacional, Ciudad de México; Management and Economics Faculty, University of Sistan and Baluchestan, Zahedan; Universidad Panamericana, Ciudad de México.
Yuklangan manba versiyasi: 25 mart 2026 sanasidagi preprint; PDFda “Preprint submitted to Results in Physics” yozuvi mavjud.
Arxiv yozuvi: arXiv:2603.24933. ArXiv obyekti uchun DOI: 10.48550/arXiv.2603.24933.
Joriy nashr holati: Ayni tadqiqot va ayni olti muallif 2026 yilda Computación y Sistemas, Vol. 30 No. 3, s. 1943–1953 ichida nashr qilingan ko‘rinadi. Jurnal yozuvida sarlavha “Predictive-Statement Classification” shaklida tire bilan yozilgan.
Jurnal: Computación y Sistemas.
Nashr etuvchi muassasa: Instituto Politécnico Nacional, Centro de Investigación en Computación.
Taqriz: Computación y Sistemas taqrizdan o‘tadigan ilmiy jurnal; yuklangan hujjat esa jurnaldan oldingi preprint versiyasidir.
Litsenziya: Computación y Sistemas nashrlari Creative Commons Attribution 4.0 International (CC BY 4.0) litsenziyasi ostida nashr etiladi.
Yakuniy jurnal DOI: Mavjud rasmiy jurnal indeksida ushbu maqolaga tegishli yakuniy DOI tasdiqlanmagani sababli uydirib yozilmagan. 10.48550/arXiv.2603.24933 arXiv versiyasining DOI hisoblanadi.
Ma’lumot: 2021 yil sentabr–2023 yil mart davrida X/Twitterdan yig‘ilgan taxminan 30.000 ta ingliz tilidagi tvitdan iborat manba to‘plamidan tasodifiy tanlangan 3.116 ta tvit.
Kriptovalyutalar: Cardano, Binance, Fantom, Matic va Ripple.
Annotation: Ikki inson annotator + GPT modellari; GPT-4o va inson annotation’i o‘rtasidagi Predictive Statement Detection Cohen's κ = 0,7493.
Ma’lumotlarni muvozanatlash: GPT-4o bilan ma’noni saqlovchi paraphrase augmentation.
Oldindan qayta ishlash: URLlarni olib tashlash, maxsus belgilarni tozalash, qisqa tokenlarni chiqarib tashlash, tokenization va normalization.
An’anaviy modellar: Logistic Regression, Random Forest, XGBoost, SVM Linear, SVM RBF; TF-IDF tasviri.
Chuqur o‘rganish: CNN va BiLSTM; GloVe va FastText embeddinglari.
Transformer modellari: DistilRoBERTa, RoBERTa-base, RoBERTuito, BERT-base, XLM-RoBERTa.
Hissiyotlarni ajratish: SenticNet.
Baholash: 5-fold cross-validation; Accuracy, Precision, Recall, F1, Macro F1 va Weighted F1.
Moliyalashtirish va qo‘llab-quvvatlash: Mexican Government CONACYT A1-S-47854; Instituto Politécnico Nacional Secretaría de Investigación y Posgrado 20241816, 20241819 va 20240951 grantlari; INAOE superkompyuter resurslari; Microsoft Latin America PhD Award.
Corresponding author: Yuklangan preprintda aniq ko‘rsatilmagan.
Data Availability Statement: Yuklangan preprintda alohida ma’lumotlar mavjudligi bayonoti yo‘q.
CRediT / muallif hissalari: Yuklangan preprintda alohida CRediT hissa bo‘limi yo‘q.
Manfaatlar to‘qnashuvi: Yuklangan preprintda alohida conflict-of-interest bayonoti yo‘q.
Asosiy ilmiy chegara: Ushbu tadqiqot ijtimoiy media matnida kelajakka yo‘naltirilgan bozor kutishini tasniflashni baholaydi; real kriptovalyuta narxi yoki investitsiya daromadi forecasting muvaffaqiyatini hali sinamaydi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan