


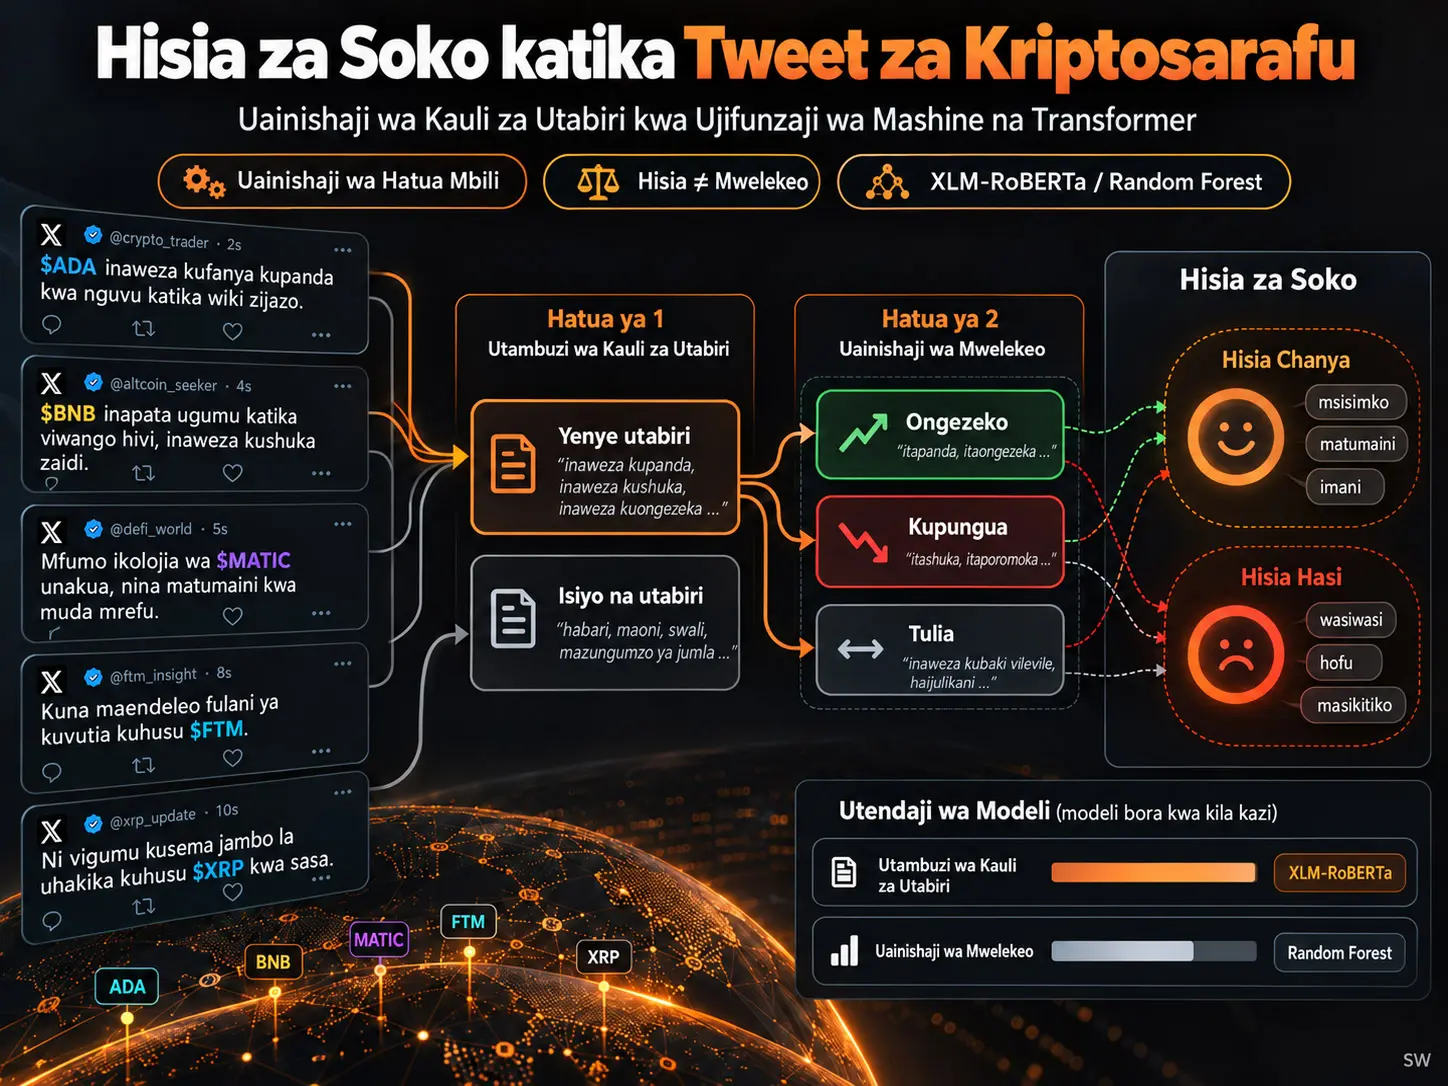
Uainishaji wa kauli za utabiri (predictive statement classification) ni mbinu ya uainishaji wa maandishi inayobainisha si tu kama maandishi ya mitandao ya kijamii yana hisia chanya au hasi, bali pia kama yana matarajio yenye mwelekeo kuhusu siku zijazo na, ikiwa yapo, kama matarajio hayo yanaelekea kwenye ongezeko, kupungua au kutobadilika. Utafiti huu unaainisha katika hatua mbili tweet 3.116 zilizochaguliwa kutoka machapisho ya Kiingereza ya X/Twitter kuhusu Cardano, Binance, Fantom, Matic na Ripple. Task 1 hutenganisha kauli Predictive na Non-Predictive; Task 2 hugawa kauli Predictive pekee katika madarasa ya Incremental, Decremental na Neutral. Annotation ya waannotator wawili wa binadamu pamoja na GPT, uchimbaji wa hisia kwa SenticNet, GPT-4o paraphrase augmentation, ujifunzaji wa mashine wa jadi, CNN/BiLSTM na modeli za transformer zilitathminiwa kwa pamoja.
Chanzo kinaonyesha kuwa utendaji huongezeka kwa kiasi kikubwa katika familia zote za modeli baada ya usawa wa madarasa kurekebishwa. Katika Task 1 iliyosawazishwa, macro F1 ya juu zaidi ni 0,7011 kwa XLM-RoBERTa. Katika Task 2 iliyosawazishwa, macro F1 ya juu zaidi si ya transformer bali ni 0,6488 kwa Random Forest; matokeo bora zaidi ya ujifunzaji wa kina ni 0,6153 kwa CNN + FastText, na matokeo bora zaidi ya transformer ni 0,5936 kwa DistilRoBERTa. Kwa hiyo, hakuna familia moja ya modeli inayotawala katika kazi zote mbili.
Mchango mkuu wa kisayansi wa utafiti si kutabiri bei, bali ni kutenganisha mwelekeo wa hisia na mwelekeo wa matarajio ya soko. Mtumiaji anaweza kutarajia bei ishuke na kuieleza kwa hisia hasi kwa sababu ya hofu ya hasara; mtumiaji mwingine anaweza kuona kushuka huko huko kama fursa ya kununua na hivyo kuonyesha hisia chanya. Kwa hiyo, uchanganuzi wa kawaida wa sentiment pekee unaweza kutafsiri vibaya matarajio halisi ya mwekezaji kuhusu mwelekeo. Utafiti bado haujathibitisha kauli hizi zilizoainishwa kwa kulinganisha na mienendo halisi ya bei ya wakati huo; hivyo matokeo hayapaswi kusomwa kama mafanikio ya moja kwa moja ya kutabiri bei za kriptosarafu.
Tatizo la utafiti
Katika mijadala ya kriptosarafu, “hisia” na “matarajio” si dhana moja. Tweet chanya si lazima itabiri kupanda kwa bei; tweet hasi pia si lazima ilingane na matarajio ya kushuka. Hasa katika masoko yenye teteko kubwa, mabadiliko yale yale ya bei yanaweza kutathminiwa kwa namna zinazokinzana na wawekezaji tofauti.
Kwa mfano, mwekezaji anayefikiri bei itashuka anaweza kuonyesha hofu au kukatishwa tamaa kwa sababu anatarajia hasara katika nafasi yake ya sasa. Mwekezaji mwingine anaweza kuona kushuka huko huko kama fursa ya kununua kwa bei ya chini na kwa hiyo kuonyesha hisia chanya. Muundo wa hatua mbili unaopendekezwa na chanzo, kwa sababu hii, unalenga kwanza kubaini kama kuna utabiri unaoelekea siku zijazo, kisha kubaini mwelekeo wa utabiri huo.
Uainishaji wa kauli za utabiri unatofautianaje na uchanganuzi wa kawaida wa hisia?
Uainishaji wa kauli za utabiri hauainishi toni ya kihisia ya tweet; kwanza huainisha kama ina matarajio ya soko kuhusu siku zijazo, kisha huainisha kama matarajio hayo yana mwelekeo wa kuongezeka, kupungua au kutobadilika; hivyo hulenga kuepuka ulinganishaji ambao si sahihi kila wakati kama “hisia chanya = matarajio ya kupanda” au “hisia hasi = matarajio ya kushuka”.
Madarasa manne ya msingi
| Darasa | Ufafanuzi | Mwelekeo |
|---|---|---|
| Incremental | Kauli inayotarajia ongezeko, uboreshaji au mwendo wa juu katika siku zijazo | Utabiri wenye mwelekeo chanya |
| Decremental | Kauli inayotarajia kupungua, kuzorota au mwendo wa chini katika siku zijazo | Utabiri wenye mwelekeo hasi |
| Neutral | Kauli isiyotarajia mabadiliko dhahiri katika siku za karibu | Matarajio ya upande / kutobadilika |
| Non-Predictive | Kauli isiyo na utabiri au makadirio ya wazi kuhusu siku zijazo | Hakuna utabiri wa mwelekeo |
Usanifu wa uainishaji wa hatua mbili
Task 1 ni uainishaji wa aina mbili:
Tweet → Predictive au Non-Predictive.
Ni tweet zilizobainishwa kuwa Predictive pekee zinazopita kwenda Task 2:
Predictive tweet → Incremental, Decremental au Neutral.
Faida ya kisayansi ya muundo huu ni kutatua kwanza swali “je, kuna utabiri?”, kisha swali “mwelekeo wa utabiri ni upi?”. Kwa njia hii, uainishaji wa mwelekeo hauchanganywi na tweet zinazosimulia matukio yaliyopita, zinazotoa maoni tu au zinazoeleza hali ya sasa.
Chanzo cha data na sampuli
Seti ya data ya chanzo ilikuwa na takriban tweet 30.000 za Kiingereza zilizokusanywa kutoka jukwaa la X/Twitter kati ya Septemba 2021 na Machi 2023. Watafiti walichagua kwa nasibu tweet 3.116 zinazohusiana na Cardano, Binance, Fantom, Matic na Ripple kutoka mkusanyiko huu na kuzijumuisha katika kazi ya annotation.
| Kazi | Darasa | Idadi ya mifano |
|---|---|---|
| Task 1 | Non-Predictive | 2.000 |
| Task 1 | Predictive | 1.116 |
| Task 2 | Incremental | 570 |
| Task 2 | Decremental | 434 |
| Task 2 | Neutral | 112 |
Hasa kuwa darasa la Neutral lina mifano 112 pekee kunasababisha kutokuwa na usawa mkubwa wa madarasa katika Task 2. Moja ya sababu muhimu za kuwa chini kwa metriki kama Macro F1, inayopa kila darasa uzito sawa, ni madarasa haya yenye uwakilishi mdogo.
Mchakato wa annotation
Waannotator wawili wa kiume walikuwa na ujuzi wa Kiingereza na shahada ya uzamili katika sayansi ya kompyuta; umri wao ulikuwa kati ya 28–30. Kwanza walifanya kazi kwenye seti ya kalibresheni yenye mifano 100, makosa yakapitiwa na mrejesho ukatolewa. Mchakato kamili wa annotation ulidumu takriban mwezi mmoja.
Modeli za GPT zilitumika kama annotator wa tatu. Lebo za GPT-4o zilipolinganishwa na lebo za mikono, thamani ya Cohen's Kappa kwa Predictive Statement Detection iliripotiwa kuwa 0,7493. Chanzo kiliitafsiri thamani hii kama kiashirio cha makubaliano makubwa kati ya annotation ya binadamu na GPT.
Kanuni za annotation
Waannotator waliombwa kuweka alama ya predictive kwa kauli zinazoashiria wazi matokeo ya siku zijazo pekee. Ikiwa tweet ilikuwa na utabiri zaidi ya mmoja, utabiri mkuu ulichaguliwa. Utabiri wa kejeli au usio wazi haukujumuishwa ikiwa haukuwa na mwelekeo wa wazi wa siku zijazo. Kauli zinazouliza swali tu kama “Bitcoin itapanda?” hazikuhesabiwa kuwa predictive ikiwa mwandishi hakuashiria wazi jibu.
Uchakataji wa awali wa maandishi
Hatua za uchakataji wa awali zilizoripotiwa katika chanzo ni kuondoa URL kwa regular expressions, kusafisha alama za uakifishaji na herufi maalum, kuondoa maneno yenye urefu wa herufi mbili au chini, pamoja na tokenization na normalization.
Katika modeli za jadi za ujifunzaji wa mashine, maandishi yalibadilishwa kuwa vipengele vya namba kwa TF-IDF. Katika ujifunzaji wa kina, embedding za maneno zilizofunzwa awali za GloVe na FastText zilitumika, na katika modeli za transformer uwakilishi wa muktadha uliofunzwa awali ulitumika moja kwa moja.
Usawazishaji wa madarasa kwa GPT
Watafiti walichagua mifano kutoka madarasa yenye uwakilishi mdogo na wakaomba GPT-4o itengeneze paraphrase zinazobadilisha mpangilio wa maneno huku zikihifadhi maana ya asili. Mifano hii sintetiki iliongezwa kwenye seti ya data ili kusawazisha idadi ya madarasa.
| Kazi | Darasa | Idadi ya mifano iliyosawazishwa |
|---|---|---|
| Task 1 | Predictive | 2.000 |
| Task 1 | Non-Predictive | 2.000 |
| Task 2 | Incremental | 570 |
| Task 2 | Decremental | 570 |
| Task 2 | Neutral | 570 |
Usawazishaji wa data kwa kutumia GPT uliathirije utendaji wa modeli?
Katika chanzo, baada ya mifano ya paraphrase iliyoundwa kwa GPT-4o kusawazisha madarasa yenye uwakilishi mdogo, thamani za macro F1 za modeli za jadi za ujifunzaji wa mashine, ujifunzaji wa kina na transformer ziliongezeka kwa kiasi kikubwa; hata hivyo, kwa kuwa utafiti haukuripoti seti huru ya majaribio ya nje na haukueleza jinsi mifano ya paraphrase ilivyowekwa katika fold za cross-validation, inahitaji kuthibitishwa tofauti ni kwa kiwango gani ongezeko hili litahamia kwenye tweet mpya na huru za ulimwengu halisi.
Metriki za tathmini
Chanzo kinatumia metriki za Accuracy, Precision, Recall na F1-score:
\[ Accuracy=\frac{TP+TN}{TP+TN+FP+FN} \]
\[ Precision=\frac{TP}{TP+FP} \]
\[ Recall=\frac{TP}{TP+FN} \]
\[ F1=2\times\frac{Precision\times Recall}{Precision+Recall} \]
Hapa \(TP\) ni chanya sahihi, \(TN\) ni hasi sahihi, \(FP\) ni chanya zisizo sahihi na \(FN\) ni hasi zisizo sahihi.
Macro F1 hupa thamani ya F1 ya kila darasa uzito sawa:
\[ MacroF1=\frac{1}{N}\sum_{i=1}^{N}F1_i \]
Weighted F1 hutumia support ya kila darasa, yaani idadi ya mifano, kama uzito:
\[ WeightedF1= \sum_{i=1}^{N} \frac{support_i}{total\ instances} F1_i \]
Kwa kuwa utafiti unapa kila darasa umuhimu sawa, unapendelea macro F1 kama kipimo kikuu cha kulinganisha. Tathmini ilifanywa kwa 5-fold cross-validation.
Familia za modeli zilizochunguzwa
| Familia ya modeli | Modeli / uwakilishi |
|---|---|
| Ujifunzaji wa mashine wa jadi | Logistic Regression, Random Forest, XGBoost, SVM Linear, SVM RBF; vipengele vya TF-IDF |
| Ujifunzaji wa kina | CNN na BiLSTM; embedding za GloVe na FastText |
| Transformer | DistilRoBERTa, RoBERTa-base, RoBERTuito, BERT-base, XLM-RoBERTa |
Uchanganuzi wa hisia kwa SenticNet
SenticNet inaweza kutoa ishara zaidi ya moja ya hisia kwa kila tweet predictive. Chanzo kilichunguza hisia zinazofanana katika makundi sita: Delight and Joy, Enthusiasm and Eagerness, Delight and Pleasantness, Grief and Sadness, Fear and Anxiety na Rage and Anger.
Kutofikia 100 kwa jumla ya asilimia katika mstari mmoja si kosa; tweet moja inaweza kuwa na zaidi ya kundi moja la hisia.
| Kriptosarafu | Delight and Joy | Enthusiasm and Eagerness |
|---|---|---|
| FTM | %81,82 | %41,82 |
| MATIC | %72,41 | %49,66 |
| ADA | %61,29 | %44,09 |
Katika utabiri wa Incremental, hisia chanya ndizo nyingi; katika tweet za Decremental, Grief and Sadness, Fear and Anxiety na Rage and Anger huonekana mara nyingi zaidi. Hata hivyo, baadhi ya utabiri wa kushuka pia una hisia chanya kwa kiwango cha juu. Chanzo kinaunganisha hali hii na uwezekano kwamba baadhi ya washiriki wanaona kushuka kwa bei kunakotarajiwa kama fursa ya kununua.
Mbinu na Matokeo ya Utafiti
Modeli za jadi katika data ya awali isiyo na usawa
| Kazi | Modeli ya juu zaidi | Macro F1 |
|---|---|---|
| Task 1 | XGBoost | 0,5068 |
| Task 2 | XGBoost | 0,3631 |
Kuwa chini kwa thamani za macro F1 katika Task 2 kunaendana na ukweli kwamba madarasa matatu ya mwelekeo yako karibu kisemantiki na darasa la Neutral ni dogo sana.
Modeli za jadi katika data iliyosawazishwa kwa GPT
| Modeli | Task 1 Macro F1 | Task 2 Macro F1 |
|---|---|---|
| Logistic Regression | 0,6672 | 0,6396 |
| Random Forest | 0,6380 | 0,6488 |
| XGBoost | 0,6389 | 0,6059 |
| SVM Linear | 0,6583 | 0,6463 |
| SVM RBF | 0,6825 | 0,6478 |
Ingawa maandishi ya chanzo yanataja SVM-RBF kuwa “bora zaidi” kwa Task 2, thamani ya 0,6488 ya Random Forest katika jedwali hilo hilo ni kubwa kuliko 0,6478. Sehemu ya matokeo pia inatoa Random Forest kama modeli bora ya jadi ya Task 2. Kwa hiyo, katika ulinganishaji unaotegemea jedwali la namba, Random Forest imechukuliwa kuwa msingi.
Matokeo ya ujifunzaji wa kina
| Modeli | Task 1 | Task 2 |
|---|---|---|
| CNN + GloVe | 0,6277 | 0,6149 |
| BiLSTM + GloVe | 0,6349 | 0,5737 |
| CNN + FastText | 0,6231 | 0,6153 |
| BiLSTM + FastText | 0,6222 | 0,6014 |
Ingawa simulizi ya chanzo inataja CNN + GloVe na thamani ya 0,6149 kama modeli bora ya ujifunzaji wa kina kwa Task 2, Jedwali 12 linatoa 0,6153 kwa CNN + FastText. Katika sehemu ya matokeo pia CNN + FastText 0,6153 imetajwa kwa usahihi kuwa kinara.
Matokeo ya Transformer
| Modeli | Task 1 | Task 2 |
|---|---|---|
| DistilRoBERTa | 0,6593 | 0,5936 |
| RoBERTa-base | 0,6625 | 0,5901 |
| RoBERTuito | 0,6444 | 0,5505 |
| BERT-base | 0,6378 | 0,5439 |
| XLM-RoBERTa | 0,7011 | 0,5367 |
Katika Task 1, XLM-RoBERTa imefikia thamani ya juu zaidi ya macro F1 katika utafiti mzima. Katika Task 2, ubora wa familia hiyo ya modeli hauendelei; ingawa DistilRoBERTa ndiyo bora zaidi kati ya transformer, iko nyuma ya Random Forest na CNN + FastText.
Ulinganishaji wa moja kwa moja wa familia tatu za modeli
| Kazi | ML ya jadi | Ujifunzaji wa kina | Transformer | Kinara kwa jumla |
|---|---|---|---|---|
| Task 1 | SVM-RBF — 0,6825 | BiLSTM + GloVe — 0,6349 | XLM-RoBERTa — 0,7011 | XLM-RoBERTa |
| Task 2 | Random Forest — 0,6488 | CNN + FastText — 0,6153 | DistilRoBERTa — 0,5936 | Random Forest |
Jedwali hili halilingani na kauli ya chanzo kwamba “transformer ni bora zaidi kwa uwazi katika kazi zote mbili kwenye data iliyosawazishwa”. Kauli hiyo ni sahihi kwa Task 1; si sahihi kwa Task 2. Abstract na sehemu ya matokeo ya chanzo, kwa namna inayolingana na majedwali, zinasema transformer zilitoa matokeo ya juu zaidi katika Task 1, huku modeli za jadi zikitoa matokeo ya juu zaidi katika Task 2.
Kwa nini modeli bora si ile ile katika kazi zote mbili?
Task 1 hutenganisha tu maandishi predictive na non-predictive, ilhali Task 2 hutenganisha matarajio ya Incremental, Decremental na Neutral ambayo yako karibu zaidi kisemantiki; katika matokeo ya chanzo, uwakilishi wa muktadha wa transformer ulitoa macro F1 ya juu zaidi katika Task 1, lakini katika utofautishaji wa kina zaidi wa Task 2, mbinu ya jadi ya Random Forest inayotumia TF-IDF ilitoa macro F1 ya juu zaidi.
Mabadiliko ya utendaji kati ya data isiyo na usawa na iliyosawazishwa
| Familia ya modeli / kazi | Bora zaidi isiyo na usawa | Bora zaidi iliyosawazishwa |
|---|---|---|
| ML ya jadi — Task 1 | 0,5068 | 0,6825 |
| ML ya jadi — Task 2 | 0,3631 | 0,6488 |
| Ujifunzaji wa kina — Task 1 | 0,5070 | 0,6349 |
| Ujifunzaji wa kina — Task 2 | 0,3656 | 0,6153 |
| Transformer — Task 1 | 0,5578 | 0,7011 |
| Transformer — Task 2 | 0,4051 | 0,5936 |
Chanzo kinatafsiri matokeo haya kuwa usawazishaji unaotumia GPT ulifanya ujifunzaji wa madarasa ya minority kuwa rahisi zaidi. Hata hivyo, kwa kuwa tathmini inategemea cross-validation ndani ya chanzo hicho hicho cha data, ujanibishaji wa matokeo katika ulimwengu halisi unapaswa kupimwa kando.
Uchanganuzi wa makosa
| Kazi / darasa | Precision | Recall | F1 |
|---|---|---|---|
| Task 1 — Non-Predictive | 0,7334 | 0,8000 | 0,7524 |
| Task 1 — Predictive | 0,7178 | 0,6255 | 0,6498 |
| Task 2 — Decremental | 0,5702 | 0,4851 | 0,5242 |
| Task 2 — Incremental | 0,5581 | 0,6316 | 0,5926 |
| Task 2 — Neutral | 0,8224 | 0,8368 | 0,8296 |
Urahisi mkubwa zaidi wa kulitambua darasa la Neutral kuliko madarasa mengine mawili ya mwelekeo unaashiria kwamba utabiri wa “ongezeko” na “kupungua” unaweza kuwa na vipengele vingi vya lugha vinavyofanana. Chanzo kinajadili jambo hili hasa kupitia thamani za chini zaidi za precision/recall katika madarasa ya Incremental na Decremental.
Ujumbe wa kisayansi wa confusion matrix katika ukurasa wa 9
Kielelezo 1 cha chanzo kinaonyesha kuwa katika Task 1, mifano ya Non-Predictive ina kiwango cha juu zaidi cha uainishaji sahihi kuliko mifano ya Predictive. Kielelezo 2 kinaonyesha kuwa Random Forest katika Task 2 hutenganisha darasa la Neutral kwa ubora mkubwa zaidi, huku mifano ya Incremental na Decremental ikichanganyika mara nyingi zaidi. Vielelezo hivi vinaonyesha kuwa kuangalia accuracy ya jumla pekee haitoshi; wasifu wa makosa kwa kila darasa unapaswa kuchunguzwa pia.
Je, utafiti huu kweli unatabiri bei za kriptosarafu?
Hapana. Utafiti hautabiri thamani ya namba au mwelekeo wa baadaye wa bei za kriptosarafu kwa kulinganisha na data ya soko; unaainisha matarajio yenye mwelekeo ya watu kuhusu siku zijazo katika tweet, na waandishi wameacha wazi ulinganishaji wa madarasa haya na mienendo halisi ya bei kuwa uthibitishaji unaopaswa kufanywa baadaye.
Hitimisho zinazoungwa mkono na utafiti
- Tofauti kati ya predictive statement na sentiment ya jumla hutoa muundo wa uainishaji wa hatua mbili unaoweza kutumika katika maandishi ya mitandao ya kijamii kuhusu kripto.
- Baada ya GPT-based paraphrase augmentation, macro F1 iliongezeka katika familia zote za modeli.
- Katika Task 1, XLM-RoBERTa ilitoa thamani ya juu zaidi ya macro F1.
- Katika Task 2, Random Forest ilitoa macro F1 ya juu zaidi kuliko transformer na modeli za ujifunzaji wa kina.
- Kauli za Incremental kwa ujumla zinahusishwa na hisia chanya, huku kauli za Decremental zikihusishwa zaidi na hisia hasi.
- Hisia na matarajio ya mwelekeo wa soko si kitu kile kile; baadhi ya utabiri wa kushuka unaweza kuwepo pamoja na hisia chanya.
- Katika uchanganuzi wa makosa uliochaguliwa, darasa la Neutral lina precision, recall na F1 za juu zaidi kuliko madarasa ya Incremental na Decremental.
Hitimisho ambazo utafiti hauungi mkono
Utafiti hauonyeshi kwamba madarasa ya tweet yanatabiri mienendo halisi ya bei za kriptosarafu, kwamba modeli zinaunda mfumo wa trading wenye faida, kwamba matokeo yanaweza kuhamishwa moja kwa moja kwenda lugha nyingine au majukwaa mengine ya mitandao ya kijamii, kwamba yataendelea na kiwango kile kile cha mafanikio katika soko la wakati halisi, au kwamba utendaji wa cross-validation kwenye data iliyoongezwa kwa GPT ni sawa na utendaji kwenye data huru ya nje.
Vikwazo vikuu
Jukwaa moja: Data imetoka X/Twitter pekee.
Lugha moja: Tweet za Kiingereza pekee zilitumika; ujanibishaji wa kitamaduni na kilugha haujapimwa.
Hakuna data halisi ya soko: Madarasa ya Predictive statement bado hayajathibitishwa kwa kulinganisha na mienendo halisi ya bei ya wakati huo au ya baadaye.
Seti ya majaribio ya nje haijaripotiwa: Tathmini inategemea 5-fold cross-validation.
Maelezo ya augmentation-fold hayatoshi: Haijaelezwa kama GPT paraphrase ziliwekwa pamoja na mifano yake ya asili katika fold tofauti. Kwa hiyo athari za mifano sintetiki kwa uhuru wa tathmini haziwezi kudhibitiwa kikamilifu.
Maelezo ya hyperparameter ni machache: Ingawa chanzo kinaorodhesha familia za modeli, hakitoi kwa kina hyperparameter za mafunzo, mipangilio ya optimizer, idadi ya epoch na maelezo kama random seed kwa kila modeli.
Kutokulingana katika maelezo ya matokeo ndani ya chanzo: Baadhi ya maandishi ya sehemu ndogo hayalingani na mpangilio wa modeli katika majedwali ya namba ya ukurasa huo huo; kwa hiyo katika makala ya Verianla, majedwali ya namba na sehemu ya matokeo zimepewa kipaumbele.
Mielekeo ya utafiti wa baadaye
Waandishi wanapanga kuoanisha madarasa ya predictive statement na ishara za hisia za SenticNet na mienendo halisi ya bei katika vipindi sawa vya muda ili kupima uwezo wa utabiri. Data ya lugha nyingi, matumizi ya wakati halisi na mbinu mbadala za kusawazisha madarasa kama PBC4cip pia zimetajwa kama maeneo ya utafiti wa baadaye.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Decoding Market Emotions in Cryptocurrency Tweets via Predictive Statement Classification with Machine Learning and Transformers
Waandishi: Moein Shahiki Tash; Zahra Ahani; Mohim Tash; Mostafa Keikhay Farzaneh; Ari Y. Barrera-Animas; Olga Kolesnikova.
Uhusiano wa taasisi: Centro de Investigación en Computación, Instituto Politécnico Nacional, Ciudad de México; Management and Economics Faculty, University of Sistan and Baluchestan, Zahedan; Universidad Panamericana, Ciudad de México.
Toleo la chanzo lililopakiwa: preprint ya 25 Machi 2026; PDF ina kauli “Preprint submitted to Results in Physics”.
Rekodi ya hifadhi: arXiv:2603.24933. DOI ya kitu cha ArXiv: 10.48550/arXiv.2603.24933.
Hali ya sasa ya uchapishaji: Utafiti huo huo na waandishi wale wale sita unaonekana kuwa ulichapishwa mwaka 2026 katika Computación y Sistemas, Vol. 30 No. 3, s. 1943–1953. Katika rekodi ya jarida, kichwa kimeandikwa kwa namna yenye kistari “Predictive-Statement Classification”.
Jarida: Computación y Sistemas.
Taasisi inayochapisha: Instituto Politécnico Nacional, Centro de Investigación en Computación.
Mapitio ya kitaalamu: Computación y Sistemas ni jarida la kisayansi linalopitiwa na wataalamu; hati iliyopakiwa ni toleo la preprint la kabla ya jarida.
Leseni: Machapisho ya Computación y Sistemas hutolewa chini ya leseni ya Creative Commons Attribution 4.0 International (CC BY 4.0).
DOI ya mwisho ya jarida: Kwa kuwa DOI ya mwisho ya makala hii haikuweza kuthibitishwa katika faharasa rasmi ya jarida inayopatikana, haikubuniwa. 10.48550/arXiv.2603.24933 ni DOI ya toleo la arXiv.
Data: Tweet 3.116 zilizochaguliwa kwa nasibu kutoka mkusanyiko wa chanzo wenye takriban tweet 30.000 za Kiingereza zilizokusanywa kutoka X/Twitter katika kipindi cha Septemba 2021–Machi 2023.
Kriptosarafu: Cardano, Binance, Fantom, Matic na Ripple.
Annotation: Waannotator wawili wa binadamu + modeli za GPT; Predictive Statement Detection Cohen's κ = 0,7493 kati ya GPT-4o na annotation ya binadamu.
Usawazishaji wa data: paraphrase augmentation inayohifadhi maana kwa GPT-4o.
Uchakataji wa awali: kuondoa URL, kusafisha herufi maalum, kuondoa token fupi, tokenization na normalization.
Modeli za jadi: Logistic Regression, Random Forest, XGBoost, SVM Linear, SVM RBF; uwakilishi wa TF-IDF.
Ujifunzaji wa kina: CNN na BiLSTM; embedding za GloVe na FastText.
Modeli za Transformer: DistilRoBERTa, RoBERTa-base, RoBERTuito, BERT-base, XLM-RoBERTa.
Uchimbaji wa hisia: SenticNet.
Tathmini: 5-fold cross-validation; Accuracy, Precision, Recall, F1, Macro F1 na Weighted F1.
Ufadhili na usaidizi: Mexican Government CONACYT A1-S-47854; ruzuku za Instituto Politécnico Nacional Secretaría de Investigación y Posgrado 20241816, 20241819 na 20240951; rasilimali za kompyuta kuu za INAOE; Microsoft Latin America PhD Award.
Corresponding author: Haijaelezwa wazi katika preprint iliyopakiwa.
Data Availability Statement: Hakuna taarifa tofauti ya upatikanaji wa data katika preprint iliyopakiwa.
CRediT / michango ya waandishi: Hakuna sehemu tofauti ya michango ya CRediT katika preprint iliyopakiwa.
Mgongano wa maslahi: Hakuna tamko tofauti la conflict-of-interest katika preprint iliyopakiwa.
Kikomo kikuu cha kisayansi: Utafiti huu unatathmini uainishaji wa matarajio ya soko ya siku zijazo katika maandishi ya mitandao ya kijamii; bado haujapima mafanikio ya forecasting ya bei halisi ya kriptosarafu au mapato ya uwekezaji.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *