


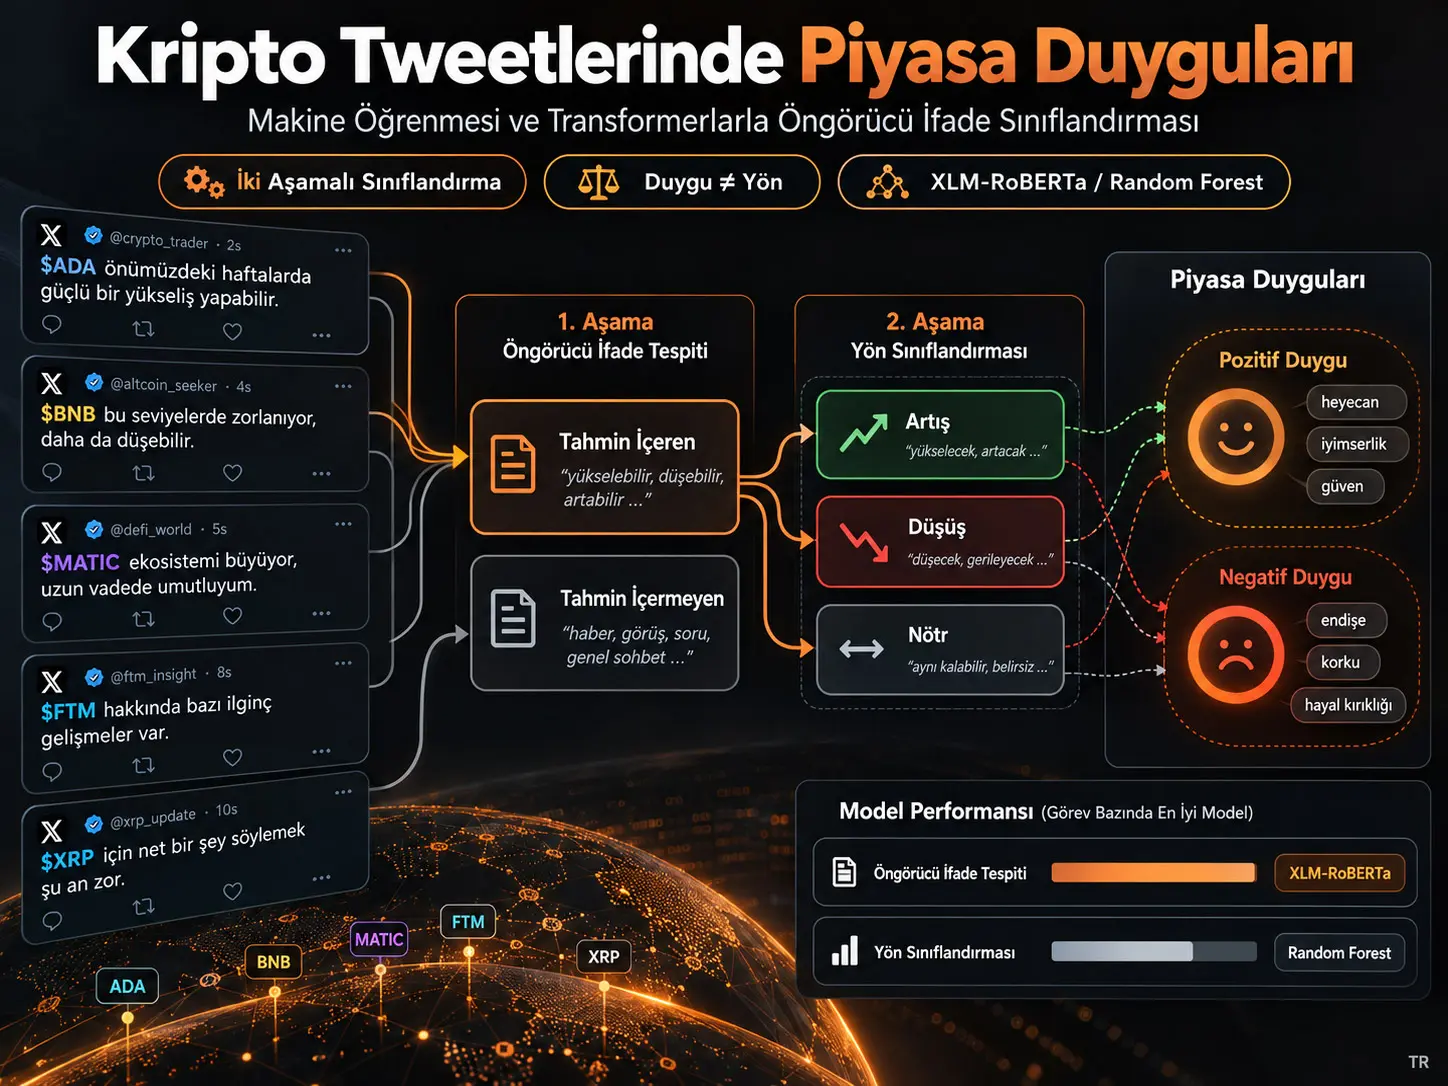
Öngörücü ifade sınıflandırması (predictive statement classification), sosyal medya metninin yalnız olumlu veya olumsuz duygu taşıyıp taşımadığını değil, geleceğe ilişkin yönlü bir beklenti içerip içermediğini ve içeriyorsa bu beklentinin artış, düşüş veya değişmeme yönünde olup olmadığını belirleyen bir metin sınıflandırma yaklaşımıdır. Bu çalışma, Cardano, Binance, Fantom, Matic ve Ripple hakkındaki İngilizce X/Twitter gönderilerinden seçilen 3.116 tweeti iki aşamada sınıflandırmaktadır. Task 1, Predictive ile Non-Predictive ifadeleri ayırır; Task 2 yalnız Predictive ifadeleri Incremental, Decremental ve Neutral sınıflarına böler. İki insan annotator ile GPT tabanlı annotation, SenticNet duygu çıkarımı, GPT-4o paraphrase augmentation, geleneksel makine öğrenmesi, CNN/BiLSTM ve transformer modelleri birlikte değerlendirilmiştir.
Kaynakta sınıf dengesizliği giderildiğinde performansın bütün model ailelerinde belirgin biçimde yükseldiği görülmektedir. Dengelenmiş Task 1'de en yüksek macro F1, XLM-RoBERTa ile 0,7011'dir. Dengelenmiş Task 2'de ise en yüksek macro F1, transformer yerine Random Forest ile 0,6488'dir; en iyi derin öğrenme sonucu CNN + FastText ile 0,6153, en iyi transformer sonucu DistilRoBERTa ile 0,5936'dır. Bu nedenle tek bir model ailesi her iki görevde de üstün değildir.
Çalışmanın asıl bilimsel katkısı fiyat tahmini yapmak değil, duygu yönü ile piyasa beklentisi yönünü birbirinden ayırmaktır. Bir kullanıcı fiyat düşüşü beklerken bunu kayıp korkusuyla olumsuz ifade edebilir; başka bir kullanıcı aynı düşüşü alış fırsatı olarak gördüğü için olumlu duygu gösterebilir. Bu nedenle yalnız klasik sentiment analizi, yatırımcının gerçek yön beklentisini yanlış yorumlayabilir. Çalışma henüz bu sınıflandırılmış ifadeleri eşzamanlı gerçek fiyat hareketleriyle doğrulamamıştır; dolayısıyla sonuçlar doğrudan kripto fiyat tahmin başarısı olarak okunmamalıdır.
Araştırma problemi
Kripto para tartışmalarında “duygu” ile “beklenti” aynı kavram değildir. Olumlu bir tweet mutlaka fiyat artışı tahmin etmeyebilir; olumsuz bir tweet de mutlaka düşüş beklentisine karşılık gelmeyebilir. Özellikle yüksek volatiliteye sahip piyasalarda aynı fiyat hareketi farklı yatırımcılar tarafından zıt biçimde değerlendirilebilir.
Örneğin fiyatın düşeceğini düşünen bir yatırımcı mevcut pozisyonunda zarar beklentisi nedeniyle korku veya hayal kırıklığı ifade edebilir. Başka bir yatırımcı aynı düşüşü daha düşük fiyattan alım fırsatı olarak gördüğü için olumlu bir duygu ifade edebilir. Kaynağın önerdiği iki aşamalı yapı, bu nedenle önce geleceğe dönük bir tahmin bulunup bulunmadığını, sonra bu tahminin yönünü belirlemeyi amaçlamaktadır.
Öngörücü ifade sınıflandırması klasik duygu analizinden nasıl farklıdır?
Öngörücü ifade sınıflandırması, bir tweetin duygusal tonunu değil önce geleceğe ilişkin bir piyasa beklentisi içerip içermediğini, ardından beklentinin artış, düşüş veya değişmeme yönünü sınıflandırır; böylece “olumlu duygu = yükseliş beklentisi” veya “olumsuz duygu = düşüş beklentisi” gibi her zaman doğru olmayan eşleştirmelerden kaçınmayı amaçlar.
Dört temel sınıf
| Sınıf | Tanım | Yön |
|---|---|---|
| Incremental | Gelecekte artış, iyileşme veya yukarı yönlü hareket bekleyen ifade | Pozitif yönlü tahmin |
| Decremental | Gelecekte azalış, bozulma veya aşağı yönlü hareket bekleyen ifade | Negatif yönlü tahmin |
| Neutral | Yakın gelecekte belirgin değişim beklemeyen ifade | Yatay / değişimsiz beklenti |
| Non-Predictive | Geleceğe ilişkin açık tahmin veya projeksiyon içermeyen ifade | Yön tahmini yok |
İki aşamalı sınıflandırma mimarisi
Task 1 ikili sınıflandırmadır:
Tweet → Predictive veya Non-Predictive.
Yalnız Predictive olarak belirlenen tweetler Task 2'ye geçer:
Predictive tweet → Incremental, Decremental veya Neutral.
Bu tasarımın bilimsel avantajı, önce “tahmin var mı?” sorusunu, ardından “tahminin yönü ne?” sorusunu çözmesidir. Böylece yön sınıflandırması geçmiş olayları anlatan, yalnız fikir bildiren veya mevcut durumu betimleyen tweetlerle karışmaz.
Veri kaynağı ve örneklem
Kaynak veri seti, Eylül 2021 ile Mart 2023 arasında X/Twitter platformundan toplanmış yaklaşık 30.000 İngilizce tweet içeriyordu. Araştırmacılar bu koleksiyondan Cardano, Binance, Fantom, Matic ve Ripple ile ilişkili 3.116 tweeti rastgele seçerek annotation çalışmasına dahil etti.
| Görev | Sınıf | Örnek sayısı |
|---|---|---|
| Task 1 | Non-Predictive | 2.000 |
| Task 1 | Predictive | 1.116 |
| Task 2 | Incremental | 570 |
| Task 2 | Decremental | 434 |
| Task 2 | Neutral | 112 |
Özellikle Neutral sınıfının yalnız 112 örnek içermesi Task 2 için ciddi sınıf dengesizliği oluşturmaktadır. Macro F1 gibi her sınıfa eşit ağırlık veren bir metriğin düşük çıkmasının önemli nedenlerinden biri bu az temsil edilen sınıflardır.
Annotation süreci
İki erkek annotator İngilizce yeterliliğine ve bilgisayar bilimi alanında yüksek lisans derecesine sahipti; yaşları 28–30 arasındaydı. İlk olarak 100 örneklik bir kalibrasyon seti üzerinde çalıştılar, hatalar gözden geçirildi ve geri bildirim verildi. Tam annotation süreci yaklaşık bir ay sürdü.
GPT modelleri üçüncü annotator olarak kullanıldı. GPT-4o etiketleri manuel etiketlerle karşılaştırıldığında Predictive Statement Detection için Cohen's Kappa değeri 0,7493 olarak raporlandı. Bu değer kaynak tarafından insan ve GPT annotation'ı arasında güçlü uyum göstergesi olarak yorumlanmıştır.
Annotation kuralları
Annotatorlardan yalnız açık biçimde geleceğe ilişkin sonuç ima eden ifadeleri predictive olarak işaretlemeleri istendi. Bir tweet birden fazla tahmin içeriyorsa baskın tahmin seçildi. Alaycı veya belirsiz tahminler açık gelecek yönü yoksa dahil edilmedi. “Bitcoin yükselecek mi?” gibi yalnız soru soran ifadeler, yazar açık biçimde bir cevap ima etmiyorsa predictive sayılmadı.
Metin ön işleme
Kaynakta raporlanan ön işleme adımları URL'lerin düzenli ifadelerle kaldırılması, noktalama ve özel karakterlerin temizlenmesi, uzunluğu iki veya daha az karakter olan sözcüklerin çıkarılması, tokenization ve normalization işlemleridir.
Geleneksel makine öğrenmesi modellerinde metin TF-IDF ile sayısal özelliklere dönüştürüldü. Derin öğrenmede GloVe ve FastText önceden eğitilmiş kelime gömmeleri, transformer modellerinde ise doğrudan önceden eğitilmiş bağlamsal temsil kullanıldı.
GPT ile sınıf dengeleme
Araştırmacılar az temsil edilen sınıflardan örnekler seçip GPT-4o'ya özgün anlamı korurken sözcük dizilimini değiştiren paraphrase'lar ürettirdi. Bu sentetik örnekler veri setine eklenerek sınıf sayıları eşitlendi.
| Görev | Sınıf | Dengeli örnek sayısı |
|---|---|---|
| Task 1 | Predictive | 2.000 |
| Task 1 | Non-Predictive | 2.000 |
| Task 2 | Incremental | 570 |
| Task 2 | Decremental | 570 |
| Task 2 | Neutral | 570 |
GPT tabanlı veri dengeleme model performansını nasıl etkiledi?
Kaynakta GPT-4o ile oluşturulan paraphrase örnekleri az temsil edilen sınıfları eşitledikten sonra geleneksel makine öğrenmesi, derin öğrenme ve transformer modellerinin macro F1 değerleri belirgin biçimde yükselmiştir; ancak çalışma bağımsız bir dış test seti raporlamadığı ve paraphrase örneklerinin cross-validation fold'ları arasında nasıl gruplandığını açıklamadığı için bu artışın yeni ve bağımsız gerçek dünya tweetlerine ne ölçüde taşınacağı ayrıca doğrulanmalıdır.
Değerlendirme metrikleri
Kaynak Accuracy, Precision, Recall ve F1-score metriklerini kullanmaktadır:
\[ Accuracy=\frac{TP+TN}{TP+TN+FP+FN} \]
\[ Precision=\frac{TP}{TP+FP} \]
\[ Recall=\frac{TP}{TP+FN} \]
\[ F1=2\times\frac{Precision\times Recall}{Precision+Recall} \]
Burada \(TP\) doğru pozitifleri, \(TN\) doğru negatifleri, \(FP\) yanlış pozitifleri ve \(FN\) yanlış negatifleri ifade eder.
Macro F1 her sınıfın F1 değerine aynı ağırlığı verir:
\[ MacroF1=\frac{1}{N}\sum_{i=1}^{N}F1_i \]
Weighted F1 ise her sınıfın desteğini, yani örnek sayısını ağırlık olarak kullanır:
\[ WeightedF1= \sum_{i=1}^{N} \frac{support_i}{total\ instances} F1_i \]
Çalışma, sınıfların her birine eşit önem verdiği için ana karşılaştırma ölçüsü olarak macro F1'i tercih etmektedir. Değerlendirme 5-fold cross-validation ile gerçekleştirilmiştir.
İncelenen model aileleri
| Model ailesi | Modeller / temsil |
|---|---|
| Geleneksel makine öğrenmesi | Logistic Regression, Random Forest, XGBoost, SVM Linear, SVM RBF; TF-IDF özellikleri |
| Derin öğrenme | CNN ve BiLSTM; GloVe ve FastText embeddingleri |
| Transformer | DistilRoBERTa, RoBERTa-base, RoBERTuito, BERT-base, XLM-RoBERTa |
SenticNet ile duygu analizi
SenticNet her predictive tweet için birden fazla duygu sinyali sağlayabilmektedir. Kaynak benzer duyguları altı grupta incelemiştir: Delight and Joy, Enthusiasm and Eagerness, Delight and Pleasantness, Grief and Sadness, Fear and Anxiety ve Rage and Anger.
Yüzdelerin bir satırda 100'e toplamaması bir hata değildir; aynı tweet birden fazla duygu kategorisi taşıyabilir.
| Kripto para | Delight and Joy | Enthusiasm and Eagerness |
|---|---|---|
| FTM | %81,82 | %41,82 |
| MATIC | %72,41 | %49,66 |
| ADA | %61,29 | %44,09 |
Incremental tahminlerde olumlu duygular baskındır; Decremental tweetlerde Grief and Sadness, Fear and Anxiety ve Rage and Anger daha sık görülmektedir. Bununla birlikte bazı düşüş tahminleri de yüksek olumlu duygu içermektedir. Kaynak bunu, bazı katılımcıların beklenen fiyat düşüşünü bir alım fırsatı olarak değerlendirebilmesiyle ilişkilendirir.
Çalışmanın Yöntemi ve Bulguları
Orijinal dengesiz veride geleneksel modeller
| Görev | En yüksek model | Macro F1 |
|---|---|---|
| Task 1 | XGBoost | 0,5068 |
| Task 2 | XGBoost | 0,3631 |
Task 2'de macro F1 değerlerinin belirgin biçimde daha düşük olması üç yön sınıfının anlamsal olarak birbirine yakın olması ve Neutral sınıfının çok küçük olmasıyla uyumludur.
GPT ile dengelenmiş veride geleneksel modeller
| Model | Task 1 Macro F1 | Task 2 Macro F1 |
|---|---|---|
| Logistic Regression | 0,6672 | 0,6396 |
| Random Forest | 0,6380 | 0,6488 |
| XGBoost | 0,6389 | 0,6059 |
| SVM Linear | 0,6583 | 0,6463 |
| SVM RBF | 0,6825 | 0,6478 |
Kaynak metninde Task 2 için SVM-RBF “en iyi” olarak adlandırılmış olsa da aynı tablodaki 0,6488 Random Forest değeri 0,6478'den büyüktür. Sonuç bölümü de Random Forest'ı Task 2'nin en iyi geleneksel modeli olarak verir. Bu nedenle sayısal tabloya dayalı karşılaştırmada Random Forest esas alınmıştır.
Derin öğrenme sonuçları
| Model | Task 1 | Task 2 |
|---|---|---|
| CNN + GloVe | 0,6277 | 0,6149 |
| BiLSTM + GloVe | 0,6349 | 0,5737 |
| CNN + FastText | 0,6231 | 0,6153 |
| BiLSTM + FastText | 0,6222 | 0,6014 |
Kaynak anlatısında Task 2'nin en iyi derin öğrenme modeli olarak CNN + GloVe ve 0,6149 değeri belirtilse de Tablo 12, CNN + FastText için 0,6153 vermektedir. Sonuç bölümünde de CNN + FastText 0,6153 doğru biçimde lider olarak belirtilmiştir.
Transformer sonuçları
| Model | Task 1 | Task 2 |
|---|---|---|
| DistilRoBERTa | 0,6593 | 0,5936 |
| RoBERTa-base | 0,6625 | 0,5901 |
| RoBERTuito | 0,6444 | 0,5505 |
| BERT-base | 0,6378 | 0,5439 |
| XLM-RoBERTa | 0,7011 | 0,5367 |
Task 1'de XLM-RoBERTa bütün çalışmadaki en yüksek macro F1 değerine ulaşmıştır. Task 2'de ise aynı model ailesinin üstünlüğü sürmemektedir; DistilRoBERTa transformerlar arasında en iyi olsa da Random Forest ve CNN + FastText'in gerisindedir.
Üç model ailesinin doğrudan karşılaştırması
| Görev | Geleneksel ML | Derin öğrenme | Transformer | Genel lider |
|---|---|---|---|---|
| Task 1 | SVM-RBF — 0,6825 | BiLSTM + GloVe — 0,6349 | XLM-RoBERTa — 0,7011 | XLM-RoBERTa |
| Task 2 | Random Forest — 0,6488 | CNN + FastText — 0,6153 | DistilRoBERTa — 0,5936 | Random Forest |
Bu tablo kaynak içindeki “transformerlar dengeli veride iki görevde de açıkça daha iyi” ifadesiyle uyuşmamaktadır. Task 1 için ifade doğrudur; Task 2 için değildir. Kaynağın abstract'ı ve sonuç bölümü, tablolarla uyumlu biçimde transformerların Task 1'de, geleneksel modellerin ise Task 2'de en yüksek sonucu verdiğini belirtmektedir.
En iyi model neden iki görevde aynı değildir?
Task 1 yalnız predictive ve non-predictive metinleri ayırırken Task 2 anlamsal olarak birbirine daha yakın Incremental, Decremental ve Neutral beklentileri ayırır; kaynak sonuçlarında bağlamsal transformer temsilinin Task 1'de en yüksek macro F1'i üretmesine karşılık, daha ince Task 2 ayrımında Random Forest'ın TF-IDF tabanlı geleneksel yaklaşımı daha yüksek macro F1 vermiştir.
Dengesiz ve dengeli veri arasındaki performans değişimi
| Model ailesi / görev | Dengesiz en iyi | Dengeli en iyi |
|---|---|---|
| Geleneksel ML — Task 1 | 0,5068 | 0,6825 |
| Geleneksel ML — Task 2 | 0,3631 | 0,6488 |
| Derin öğrenme — Task 1 | 0,5070 | 0,6349 |
| Derin öğrenme — Task 2 | 0,3656 | 0,6153 |
| Transformer — Task 1 | 0,5578 | 0,7011 |
| Transformer — Task 2 | 0,4051 | 0,5936 |
Kaynak bu sonuçları GPT tabanlı dengelemenin özellikle minority sınıflarının öğrenilmesini kolaylaştırdığı şeklinde yorumlamaktadır. Bununla birlikte değerlendirme yalnız aynı veri kaynağı içindeki cross-validation'a dayandığı için gerçek dünya genellemesi ayrıca test edilmelidir.
Hata analizi
| Görev / sınıf | Precision | Recall | F1 |
|---|---|---|---|
| Task 1 — Non-Predictive | 0,7334 | 0,8000 | 0,7524 |
| Task 1 — Predictive | 0,7178 | 0,6255 | 0,6498 |
| Task 2 — Decremental | 0,5702 | 0,4851 | 0,5242 |
| Task 2 — Incremental | 0,5581 | 0,6316 | 0,5926 |
| Task 2 — Neutral | 0,8224 | 0,8368 | 0,8296 |
Neutral sınıfının diğer iki yön sınıfından belirgin biçimde daha kolay tanınması, “artış” ve “düşüş” tahminlerinin dilsel olarak daha fazla ortak özellik paylaşabileceğini düşündürmektedir. Kaynak bunu özellikle Incremental ve Decremental sınıflarındaki daha düşük precision/recall değerleriyle tartışmaktadır.
Sayfa 9'daki confusion matrix'lerin bilimsel mesajı
Kaynak Şekil 1, Task 1'de Non-Predictive örneklerin Predictive örneklerden daha yüksek doğru sınıflandırma oranına sahip olduğunu gösterir. Şekil 2 ise Random Forest'ın Task 2'de Neutral sınıfını belirgin biçimde daha iyi ayırdığını, Incremental ve Decremental örneklerin birbirine daha sık karıştığını gösterir. Bu görseller yalnız toplam accuracy'ye bakmanın yeterli olmadığını; sınıf bazlı hata profilinin ayrıca incelenmesi gerektiğini ortaya koymaktadır.
Bu çalışma kripto para fiyatlarını gerçekten tahmin ediyor mu?
Hayır. Çalışma kripto para fiyatlarının gelecekteki sayısal değerini veya yönünü piyasa verisine karşı tahmin etmiyor; tweetlerde insanların geleceğe ilişkin yön beklentilerini sınıflandırıyor ve yazarlar bu sınıfların gerçek fiyat hareketleriyle eşleştirilmesini açıkça gelecekte yapılması gereken doğrulama olarak bırakıyor.
Çalışmanın desteklediği sonuçlar
- Predictive statement ile genel sentiment ayrımı kripto sosyal medya metinlerinde uygulanabilir bir iki-aşamalı sınıflandırma yapısı sağlamaktadır.
- GPT tabanlı paraphrase augmentation sonrası bütün model ailelerinde macro F1 yükselmiştir.
- Task 1'de XLM-RoBERTa en yüksek macro F1 değerini üretmiştir.
- Task 2'de Random Forest transformer ve derin öğrenme modellerinden daha yüksek macro F1 üretmiştir.
- Incremental ifadeler çoğunlukla olumlu duygularla, Decremental ifadeler ise daha fazla olumsuz duyguyla ilişkilidir.
- Duygu ile piyasa yön beklentisi birebir aynı değildir; bazı düşüş tahminleri olumlu duyguyla birlikte bulunabilir.
- Neutral sınıfı seçilen hata analizinde Incremental ve Decremental sınıflardan daha yüksek precision, recall ve F1 göstermektedir.
Çalışmanın desteklemediği sonuçlar
Çalışma tweet sınıflarının gerçek kripto fiyat hareketlerini öngördüğünü, modellerin kârlı bir trading sistemi oluşturduğunu, sonuçların başka dillere veya sosyal medya platformlarına otomatik olarak genellenebileceğini, gerçek zamanlı piyasada aynı başarıyı koruyacağını veya GPT ile artırılmış veri üzerindeki cross-validation performansının bağımsız dış veri performansıyla aynı olduğunu göstermemektedir.
Başlıca sınırlılıklar
Tek platform: Veri yalnız X/Twitter'dan gelmektedir.
Tek dil: Yalnız İngilizce tweetler kullanılmıştır; kültürel ve dilsel genelleme test edilmemiştir.
Gerçek piyasa verisi yok: Predictive statement sınıfları henüz eşzamanlı veya gelecekteki gerçek fiyat hareketleriyle doğrulanmamıştır.
Harici test seti raporlanmıyor: Değerlendirme 5-fold cross-validation'a dayanmaktadır.
Augmentation-fold ayrıntısı eksik: GPT paraphrase'ların fold'lar arasında özgün örnekleriyle birlikte gruplanıp gruplanmadığı açıklanmamaktadır. Bu nedenle sentetik örneklerin değerlendirme bağımsızlığı üzerindeki etkisi tam olarak denetlenemez.
Hiperparametre ayrıntıları sınırlı: Kaynak model ailelerini listelese de her model için ayrıntılı eğitim hiperparametreleri, optimizer ayarları, epoch sayıları ve random seed gibi yeniden üretilebilirlik ayrıntılarını kapsamlı biçimde vermemektedir.
Kaynak içi sonuç anlatımı tutarsızlıkları: Bazı alt bölüm metinleri, aynı sayfadaki sayısal tabloların model sıralamasıyla uyuşmamaktadır; bu nedenle Verianla makalesinde sayısal tablolara ve sonuç bölümüne öncelik verilmiştir.
Gelecek çalışma yönleri
Yazarlar predictive statement sınıflarını ve SenticNet duygu sinyallerini gerçek fiyat hareketleriyle aynı zaman aralıklarında eşleştirerek tahmin potansiyelini test etmeyi planlamaktadır. Ayrıca çok dilli veri, gerçek zamanlı uygulamalar ve PBC4cip gibi alternatif sınıf dengeleme yöntemleri gelecekteki araştırma alanları olarak belirtilmiştir.
Kaynak ve Yöntem Notu
Özgün başlık: Decoding Market Emotions in Cryptocurrency Tweets via Predictive Statement Classification with Machine Learning and Transformers
Yazarlar: Moein Shahiki Tash; Zahra Ahani; Mohim Tash; Mostafa Keikhay Farzaneh; Ari Y. Barrera-Animas; Olga Kolesnikova.
Afiliyasyonlar: Centro de Investigación en Computación, Instituto Politécnico Nacional, Ciudad de México; Management and Economics Faculty, University of Sistan and Baluchestan, Zahedan; Universidad Panamericana, Ciudad de México.
Yüklenen kaynak sürümü: 25 Mart 2026 tarihli preprint; PDF üzerinde “Preprint submitted to Results in Physics” ibaresi bulunmaktadır.
Arşiv kaydı: arXiv:2603.24933. ArXiv nesnesi için DOI: 10.48550/arXiv.2603.24933.
Güncel yayın durumu: Aynı çalışma ve aynı altı yazar 2026 yılında Computación y Sistemas, Vol. 30 No. 3, s. 1943–1953 içinde yayımlanmış görünmektedir. Dergi kaydında başlık “Predictive-Statement Classification” biçiminde tireli yazılmaktadır.
Dergi: Computación y Sistemas.
Yayımlayan kurum: Instituto Politécnico Nacional, Centro de Investigación en Computación.
Hakemlik: Computación y Sistemas hakemli bilimsel dergidir; yüklenen belge ise dergi öncesi preprint sürümüdür.
Lisans: Computación y Sistemas yayınları Creative Commons Attribution 4.0 International (CC BY 4.0) lisansı altında yayımlanmaktadır.
Final dergi DOI'si: Erişilebilir resmî dergi indeksinde bu makaleye ait final DOI doğrulanamadığından uydurulmamıştır. 10.48550/arXiv.2603.24933 arXiv sürümünün DOI'sidir.
Veri: Eylül 2021–Mart 2023 döneminde X/Twitter'dan toplanan yaklaşık 30.000 İngilizce tweetlik kaynak koleksiyondan rastgele seçilen 3.116 tweet.
Kripto paralar: Cardano, Binance, Fantom, Matic ve Ripple.
Annotation: İki insan annotator + GPT modelleri; GPT-4o ile insan annotation'ı arasındaki Predictive Statement Detection Cohen's κ = 0,7493.
Veri dengeleme: GPT-4o ile anlam-koruyucu paraphrase augmentation.
Ön işleme: URL kaldırma, özel karakter temizleme, kısa tokenların çıkarılması, tokenization ve normalization.
Geleneksel modeller: Logistic Regression, Random Forest, XGBoost, SVM Linear, SVM RBF; TF-IDF temsili.
Derin öğrenme: CNN ve BiLSTM; GloVe ve FastText embeddingleri.
Transformer modelleri: DistilRoBERTa, RoBERTa-base, RoBERTuito, BERT-base, XLM-RoBERTa.
Duygu çıkarımı: SenticNet.
Değerlendirme: 5-fold cross-validation; Accuracy, Precision, Recall, F1, Macro F1 ve Weighted F1.
Finansman ve destek: Mexican Government CONACYT A1-S-47854; Instituto Politécnico Nacional Secretaría de Investigación y Posgrado 20241816, 20241819 ve 20240951 hibeleri; INAOE süperbilgisayar kaynakları; Microsoft Latin America PhD Award.
Corresponding author: Yüklenen preprintte açık biçimde belirtilmemektedir.
Data Availability Statement: Yüklenen preprintte ayrı bir veri erişilebilirliği beyanı bulunmamaktadır.
CRediT / yazar katkıları: Yüklenen preprintte ayrı bir CRediT katkı bölümü bulunmamaktadır.
Çıkar çatışması: Yüklenen preprintte ayrı bir conflict-of-interest beyanı bulunmamaktadır.
Temel bilimsel sınır: Bu çalışma sosyal medya metninde geleceğe yönelik piyasa beklentisinin sınıflandırılmasını değerlendirir; gerçek kripto para fiyatı veya yatırım getirisi forecasting başarısını henüz test etmez.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir