


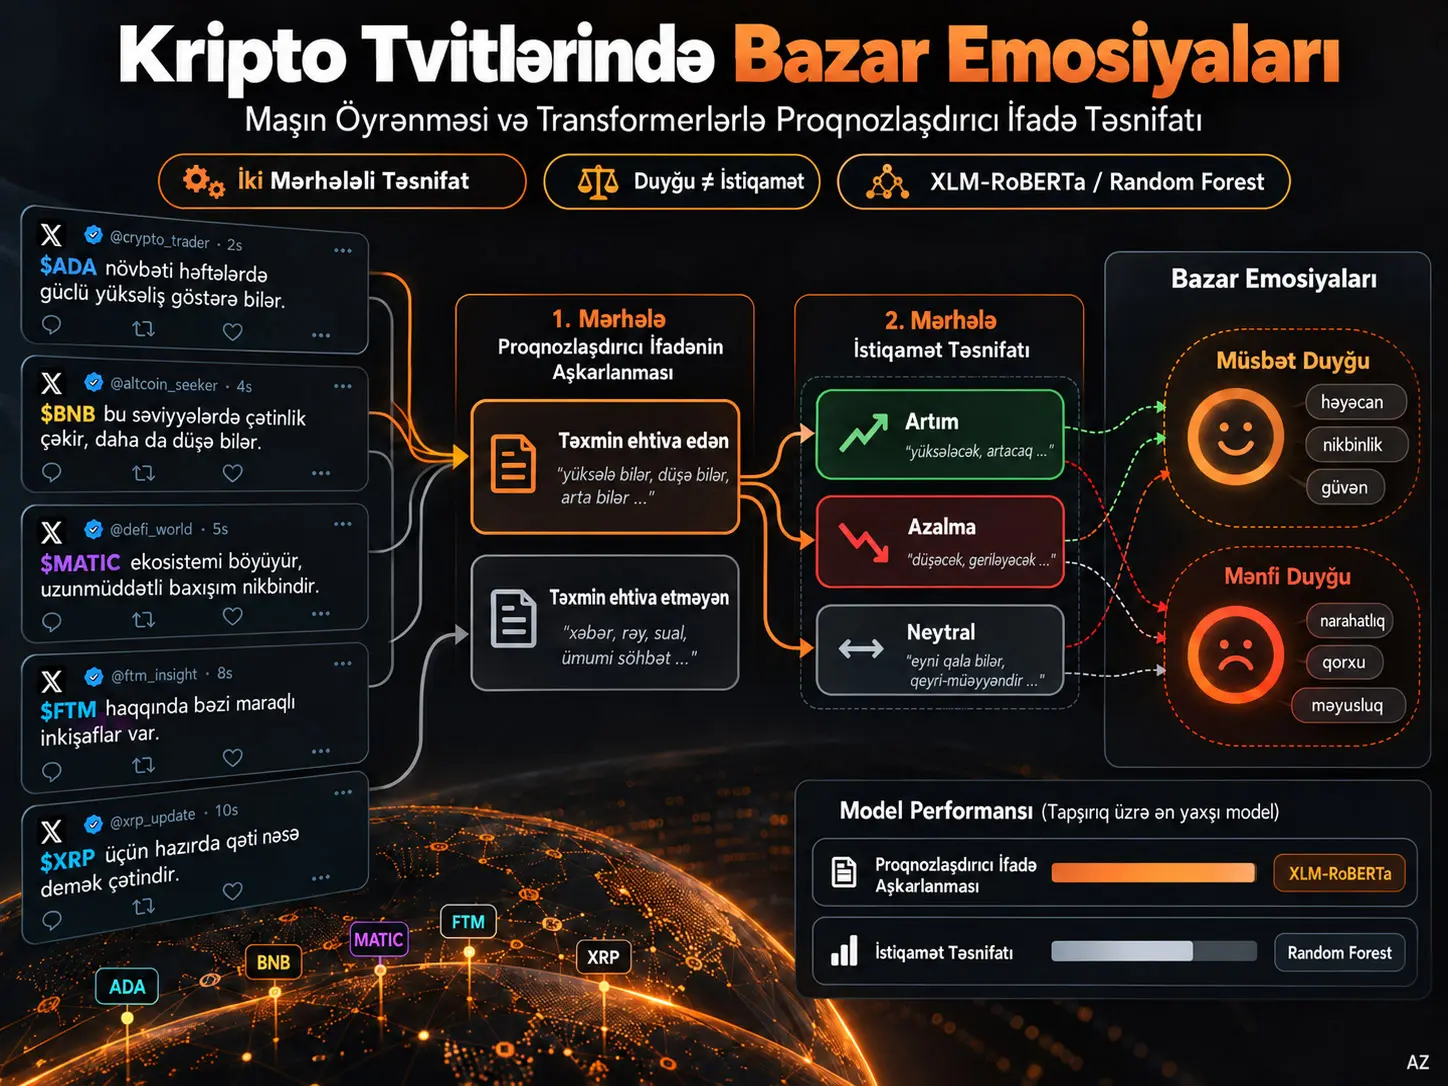
Proqnozlaşdırıcı ifadə təsnifatı (predictive statement classification), sosial media mətninin yalnız müsbət və ya mənfi emosional məzmun daşıyıb-daşımadığını deyil, gələcəyə dair istiqamətli gözlənti ehtiva edib-etmədiyini və ehtiva edirsə, bu gözləntinin artım, azalma və ya dəyişməzlik istiqamətində olub-olmadığını müəyyən edən mətn təsnifatı yanaşmasıdır. Bu tədqiqat Cardano, Binance, Fantom, Matic və Ripple haqqında ingiliscə X/Twitter paylaşımlarından seçilmiş 3.116 tviti iki mərhələdə təsnif edir. Task 1 Predictive və Non-Predictive ifadələri ayırır; Task 2 isə yalnız Predictive ifadələri Incremental, Decremental və Neutral siniflərinə bölür. İki insan annotatoru ilə GPT əsaslı annotation, SenticNet emosiya çıxarımı, GPT-4o paraphrase augmentation, ənənəvi maşın öyrənməsi, CNN/BiLSTM və transformer modelləri birlikdə qiymətləndirilmişdir.
Mənbədə sinif balanssızlığı aradan qaldırıldıqda performansın bütün model ailələrində nəzərəçarpacaq dərəcədə yüksəldiyi görünür. Balanslaşdırılmış Task 1-də ən yüksək macro F1 XLM-RoBERTa ilə 0,7011-dir. Balanslaşdırılmış Task 2-də isə ən yüksək macro F1 transformer deyil, Random Forest ilə 0,6488-dir; ən yaxşı dərin öyrənmə nəticəsi CNN + FastText ilə 0,6153, ən yaxşı transformer nəticəsi DistilRoBERTa ilə 0,5936-dır. Buna görə də tək bir model ailəsi hər iki tapşırıqda üstün deyil.
Tədqiqatın əsas elmi töhfəsi qiymət proqnozu vermək deyil, emosiyanın istiqaməti ilə bazar gözləntisinin istiqamətini bir-birindən ayırmaqdır. İstifadəçi qiymətin düşəcəyini gözləyərkən bunu itki qorxısı ilə mənfi ifadə edə bilər; başqa istifadəçi isə eyni enişi alış fürsəti kimi gördüyü üçün müsbət emosiya göstərə bilər. Buna görə yalnız klassik sentiment analizi investorun real istiqamət gözləntisini yanlış şərh edə bilər. Tədqiqat hələ bu təsnif edilmiş ifadələri eyni vaxtlı real qiymət hərəkətləri ilə doğrulamayıb; buna görə nəticələr birbaşa kriptovalyuta qiymət proqnozunun uğuru kimi oxunmamalıdır.
Tədqiqat problemi
Kriptovalyuta müzakirələrində “emosiya” ilə “gözlənti” eyni anlayış deyil. Müsbət tvit mütləq qiymət artımı proqnozlaşdırmaya bilər; mənfi tvit də mütləq eniş gözləntisinə uyğun gəlməyə bilər. Xüsusilə yüksək volatilliyə malik bazarlarda eyni qiymət hərəkəti müxtəlif investorlar tərəfindən əks şəkildə qiymətləndirilə bilər.
Məsələn, qiymətin düşəcəyini düşünən investor mövcud mövqeyində zərər gözləntisinə görə qorxu və ya məyusluq ifadə edə bilər. Başqa investor isə eyni enişi daha aşağı qiymətdən alış fürsəti kimi gördüyü üçün müsbət emosiya ifadə edə bilər. Mənbənin təklif etdiyi iki mərhələli quruluş buna görə əvvəlcə gələcəyə yönəlik proqnozun olub-olmadığını, sonra isə bu proqnozun istiqamətini müəyyən etməyi hədəfləyir.
Proqnozlaşdırıcı ifadə təsnifatı klassik emosiya analizindən necə fərqlənir?
Proqnozlaşdırıcı ifadə təsnifatı tvitin emosional tonunu deyil, əvvəlcə gələcəyə dair bazar gözləntisi ehtiva edib-etmədiyini, daha sonra isə gözləntinin artım, eniş və ya dəyişməzlik istiqamətini təsnif edir; beləliklə “müsbət emosiya = yüksəliş gözləntisi” və ya “mənfi emosiya = eniş gözləntisi” kimi hər zaman doğru olmayan uyğunlaşdırmalardan yayınmağı hədəfləyir.
Dörd əsas sinif
| Sinif | Tərif | İstiqamət |
|---|---|---|
| Incremental | Gələcəkdə artım, yaxşılaşma və ya yuxarı istiqamətli hərəkət gözləyən ifadə | Müsbət istiqamətli proqnoz |
| Decremental | Gələcəkdə azalma, pisləşmə və ya aşağı istiqamətli hərəkət gözləyən ifadə | Mənfi istiqamətli proqnoz |
| Neutral | Yaxın gələcəkdə nəzərəçarpacaq dəyişiklik gözləməyən ifadə | Üfüqi / dəyişməz gözlənti |
| Non-Predictive | Gələcəyə dair açıq proqnoz və ya proyeksiya ehtiva etməyən ifadə | İstiqamət proqnozu yoxdur |
İki mərhələli təsnifat arxitekturası
Task 1 ikili təsnifatdır:
Tweet → Predictive və ya Non-Predictive.
Yalnız Predictive kimi müəyyən edilən tvitlər Task 2-yə keçir:
Predictive tweet → Incremental, Decremental və ya Neutral.
Bu dizaynın elmi üstünlüyü əvvəlcə “proqnoz varmı?” sualını, ardınca “proqnozun istiqaməti nədir?” sualını həll etməsidir. Beləliklə istiqamət təsnifatı keçmiş hadisələri izah edən, yalnız fikir bildirən və ya mövcud vəziyyəti təsvir edən tvitlərlə qarışmır.
Məlumat mənbəyi və seçmə
Mənbə məlumat dəsti 2021-ci ilin sentyabrından 2023-cü ilin martına qədər X/Twitter platformasından toplanmış təxminən 30.000 ingiliscə tvitdən ibarət idi. Tədqiqatçılar bu kolleksiyadan Cardano, Binance, Fantom, Matic və Ripple ilə əlaqəli 3.116 tviti təsadüfi seçərək annotation işinə daxil etdilər.
| Tapşırıq | Sinif | Nümunə sayı |
|---|---|---|
| Task 1 | Non-Predictive | 2.000 |
| Task 1 | Predictive | 1.116 |
| Task 2 | Incremental | 570 |
| Task 2 | Decremental | 434 |
| Task 2 | Neutral | 112 |
Xüsusilə Neutral sinfinin yalnız 112 nümunədən ibarət olması Task 2 üçün ciddi sinif balanssızlığı yaradır. Macro F1 kimi hər sinfə bərabər çəki verən metrikin aşağı çıxmasının mühüm səbəblərindən biri bu az təmsil olunan siniflərdir.
Annotation prosesi
İki kişi annotator ingilis dili səriştəsinə və kompüter elmləri sahəsində magistr dərəcəsinə malik idi; yaşları 28–30 arasında idi. İlk olaraq 100 nümunəlik kalibrasiya dəsti üzərində işlədilər, səhvlər nəzərdən keçirildi və geribildirim verildi. Tam annotation prosesi təxminən bir ay davam etdi.
GPT modelləri üçüncü annotator kimi istifadə olundu. GPT-4o etiketləri manual etiketlərlə müqayisə edildikdə Predictive Statement Detection üçün Cohen's Kappa dəyəri 0,7493 olaraq bildirildi. Bu dəyər mənbə tərəfindən insan və GPT annotation-ı arasında güclü uyğunluq göstəricisi kimi şərh edilmişdir.
Annotation qaydaları
Annotatorlardan yalnız açıq şəkildə gələcəyə dair nəticə nəzərdə tutan ifadələri predictive kimi işarələmələri istənildi. Tvit birdən çox proqnoz ehtiva edirsə, dominant proqnoz seçildi. Sarkastik və ya qeyri-müəyyən proqnozlar açıq gələcək istiqaməti yoxdursa daxil edilmədi. “Bitcoin yüksələcəkmi?” kimi yalnız sual verən ifadələr, müəllif açıq şəkildə cavab nəzərdə tutmursa predictive sayılmadı.
Mətnin ilkin emalı
Mənbədə bildirilən ilkin emal addımları URL-lərin müntəzəm ifadələrlə silinməsi, durğu işarələri və xüsusi simvolların təmizlənməsi, uzunluğu iki və ya daha az simvol olan sözlərin çıxarılması, tokenization və normalization əməliyyatlarıdır.
Ənənəvi maşın öyrənməsi modellərində mətn TF-IDF ilə ədədi xüsusiyyətlərə çevrildi. Dərin öyrənmədə GloVe və FastText əvvəlcədən öyrədilmiş söz embeddingləri, transformer modellərində isə birbaşa əvvəlcədən öyrədilmiş kontekstual təmsillər istifadə olundu.
GPT ilə sinif balanslaşdırması
Tədqiqatçılar az təmsil olunan siniflərdən nümunələr seçərək GPT-4o-ya ilkin mənanı qorumaqla söz düzümünü dəyişən paraphrase-lar yaratdırdılar. Bu sintetik nümunələr məlumat dəstinə əlavə edilərək sinif sayları bərabərləşdirildi.
| Tapşırıq | Sinif | Balanslaşdırılmış nümunə sayı |
|---|---|---|
| Task 1 | Predictive | 2.000 |
| Task 1 | Non-Predictive | 2.000 |
| Task 2 | Incremental | 570 |
| Task 2 | Decremental | 570 |
| Task 2 | Neutral | 570 |
GPT əsaslı məlumat balanslaşdırması model performansına necə təsir etdi?
Mənbədə GPT-4o ilə yaradılmış paraphrase nümunələri az təmsil olunan sinifləri bərabərləşdirdikdən sonra ənənəvi maşın öyrənməsi, dərin öyrənmə və transformer modellərinin macro F1 dəyərləri nəzərəçarpacaq dərəcədə yüksəlmişdir; lakin tədqiqat müstəqil xarici test dəsti bildirmədiyi və paraphrase nümunələrinin cross-validation fold-ları arasında necə qruplaşdırıldığını açıqlamadığı üçün bu artımın yeni və müstəqil real dünya tvitlərinə nə dərəcədə daşınacağı ayrıca doğrulanmalıdır.
Qiymətləndirmə metrikləri
Mənbə Accuracy, Precision, Recall və F1-score metriklərindən istifadə edir:
\[ Accuracy=\frac{TP+TN}{TP+TN+FP+FN} \]
\[ Precision=\frac{TP}{TP+FP} \]
\[ Recall=\frac{TP}{TP+FN} \]
\[ F1=2\times\frac{Precision\times Recall}{Precision+Recall} \]
Burada \(TP\) doğru müsbətləri, \(TN\) doğru mənfiləri, \(FP\) yanlış müsbətləri və \(FN\) yanlış mənfiləri ifadə edir.
Macro F1 hər sinfin F1 dəyərinə eyni çəki verir:
\[ MacroF1=\frac{1}{N}\sum_{i=1}^{N}F1_i \]
Weighted F1 isə hər sinfin dəstəyini, yəni nümunə sayını çəki kimi istifadə edir:
\[ WeightedF1= \sum_{i=1}^{N} \frac{support_i}{total\ instances} F1_i \]
Tədqiqat hər sinfə bərabər əhəmiyyət verdiyi üçün əsas müqayisə ölçüsü kimi macro F1-i üstün tutur. Qiymətləndirmə 5-fold cross-validation ilə aparılmışdır.
Araşdırılan model ailələri
| Model ailəsi | Modellər / təmsil |
|---|---|
| Ənənəvi maşın öyrənməsi | Logistic Regression, Random Forest, XGBoost, SVM Linear, SVM RBF; TF-IDF xüsusiyyətləri |
| Dərin öyrənmə | CNN və BiLSTM; GloVe və FastText embeddingləri |
| Transformer | DistilRoBERTa, RoBERTa-base, RoBERTuito, BERT-base, XLM-RoBERTa |
SenticNet ilə emosiya analizi
SenticNet hər predictive tvit üçün birdən çox emosiya siqnalı təmin edə bilər. Mənbə oxşar emosiyaları altı qrupda araşdırmışdır: Delight and Joy, Enthusiasm and Eagerness, Delight and Pleasantness, Grief and Sadness, Fear and Anxiety və Rage and Anger.
Faizlərin bir sətirdə 100-ə cəmlənməməsi xəta deyil; eyni tvit birdən çox emosiya kateqoriyası daşıya bilər.
| Kriptovalyuta | Delight and Joy | Enthusiasm and Eagerness |
|---|---|---|
| FTM | %81,82 | %41,82 |
| MATIC | %72,41 | %49,66 |
| ADA | %61,29 | %44,09 |
Incremental proqnozlarda müsbət emosiyalar üstünlük təşkil edir; Decremental tvitlərdə Grief and Sadness, Fear and Anxiety və Rage and Anger daha tez-tez görülür. Bununla yanaşı, bəzi eniş proqnozları da yüksək müsbət emosiya ehtiva edir. Mənbə bunu bəzi iştirakçıların gözlənilən qiymət enişini alış fürsəti kimi qiymətləndirə bilməsi ilə əlaqələndirir.
Tədqiqatın Metodu və Nəticələri
Orijinal balanssız məlumatda ənənəvi modellər
| Tapşırıq | Ən yüksək model | Macro F1 |
|---|---|---|
| Task 1 | XGBoost | 0,5068 |
| Task 2 | XGBoost | 0,3631 |
Task 2-də macro F1 dəyərlərinin nəzərəçarpacaq dərəcədə aşağı olması üç istiqamət sinfinin semantik baxımdan bir-birinə yaxın olması və Neutral sinfinin çox kiçik olması ilə uyğundur.
GPT ilə balanslaşdırılmış məlumatda ənənəvi modellər
| Model | Task 1 Macro F1 | Task 2 Macro F1 |
|---|---|---|
| Logistic Regression | 0,6672 | 0,6396 |
| Random Forest | 0,6380 | 0,6488 |
| XGBoost | 0,6389 | 0,6059 |
| SVM Linear | 0,6583 | 0,6463 |
| SVM RBF | 0,6825 | 0,6478 |
Mənbə mətnində Task 2 üçün SVM-RBF “ən yaxşı” adlandırılsa da, eyni cədvəldəki 0,6488 Random Forest dəyəri 0,6478-dən böyükdür. Nəticə bölməsi də Random Forest-ı Task 2-nin ən yaxşı ənənəvi modeli kimi göstərir. Buna görə rəqəmsal cədvələ əsaslanan müqayisədə Random Forest əsas götürülmüşdür.
Dərin öyrənmə nəticələri
| Model | Task 1 | Task 2 |
|---|---|---|
| CNN + GloVe | 0,6277 | 0,6149 |
| BiLSTM + GloVe | 0,6349 | 0,5737 |
| CNN + FastText | 0,6231 | 0,6153 |
| BiLSTM + FastText | 0,6222 | 0,6014 |
Mənbə anlatımında Task 2-nin ən yaxşı dərin öyrənmə modeli kimi CNN + GloVe və 0,6149 dəyəri göstərilsə də, Cədvəl 12 CNN + FastText üçün 0,6153 verir. Nəticə bölməsində də CNN + FastText 0,6153 düzgün şəkildə lider kimi göstərilmişdir.
Transformer nəticələri
| Model | Task 1 | Task 2 |
|---|---|---|
| DistilRoBERTa | 0,6593 | 0,5936 |
| RoBERTa-base | 0,6625 | 0,5901 |
| RoBERTuito | 0,6444 | 0,5505 |
| BERT-base | 0,6378 | 0,5439 |
| XLM-RoBERTa | 0,7011 | 0,5367 |
Task 1-də XLM-RoBERTa bütün tədqiqatdakı ən yüksək macro F1 dəyərinə çatmışdır. Task 2-də isə eyni model ailəsinin üstünlüyü davam etmir; DistilRoBERTa transformerlar arasında ən yaxşı olsa da Random Forest və CNN + FastText-dən geri qalır.
Üç model ailəsinin birbaşa müqayisəsi
| Tapşırıq | Ənənəvi ML | Dərin öyrənmə | Transformer | Ümumi lider |
|---|---|---|---|---|
| Task 1 | SVM-RBF — 0,6825 | BiLSTM + GloVe — 0,6349 | XLM-RoBERTa — 0,7011 | XLM-RoBERTa |
| Task 2 | Random Forest — 0,6488 | CNN + FastText — 0,6153 | DistilRoBERTa — 0,5936 | Random Forest |
Bu cədvəl mənbədəki “transformerlar balanslaşdırılmış məlumatda hər iki tapşırıqda açıq şəkildə daha yaxşıdır” ifadəsi ilə uyğun gəlmir. Task 1 üçün ifadə doğrudur; Task 2 üçün deyil. Mənbənin abstract-ı və nəticə bölməsi cədvəllərlə uyğun şəkildə transformerların Task 1-də, ənənəvi modellərin isə Task 2-də ən yüksək nəticəni verdiyini bildirir.
Ən yaxşı model niyə iki tapşırıqda eyni deyil?
Task 1 yalnız predictive və non-predictive mətnləri ayırdığı halda, Task 2 semantik baxımdan bir-birinə daha yaxın Incremental, Decremental və Neutral gözləntiləri ayırır; mənbə nəticələrində kontekstual transformer təmsilinin Task 1-də ən yüksək macro F1-i verməsinə qarşılıq, daha incə Task 2 ayrımında Random Forest-ın TF-IDF əsaslı ənənəvi yanaşması daha yüksək macro F1 vermişdir.
Balanssız və balanslaşdırılmış məlumat arasındakı performans dəyişməsi
| Model ailəsi / tapşırıq | Balanssız ən yaxşı | Balanslaşdırılmış ən yaxşı |
|---|---|---|
| Ənənəvi ML — Task 1 | 0,5068 | 0,6825 |
| Ənənəvi ML — Task 2 | 0,3631 | 0,6488 |
| Dərin öyrənmə — Task 1 | 0,5070 | 0,6349 |
| Dərin öyrənmə — Task 2 | 0,3656 | 0,6153 |
| Transformer — Task 1 | 0,5578 | 0,7011 |
| Transformer — Task 2 | 0,4051 | 0,5936 |
Mənbə bu nəticələri GPT əsaslı balanslaşdırmanın xüsusilə minority siniflərinin öyrənilməsini asanlaşdırdığı kimi şərh edir. Bununla belə, qiymətləndirmə yalnız eyni məlumat mənbəyi daxilində cross-validation-a əsaslandığı üçün real dünya ümumiləşməsi ayrıca sınaqdan keçirilməlidir.
Səhv analizi
| Tapşırıq / sinif | Precision | Recall | F1 |
|---|---|---|---|
| Task 1 — Non-Predictive | 0,7334 | 0,8000 | 0,7524 |
| Task 1 — Predictive | 0,7178 | 0,6255 | 0,6498 |
| Task 2 — Decremental | 0,5702 | 0,4851 | 0,5242 |
| Task 2 — Incremental | 0,5581 | 0,6316 | 0,5926 |
| Task 2 — Neutral | 0,8224 | 0,8368 | 0,8296 |
Neutral sinfinin digər iki istiqamət sinfindən nəzərəçarpacaq dərəcədə daha asan tanınması “artım” və “eniş” proqnozlarının dil baxımından daha çox ortaq xüsusiyyət paylaşa biləcəyini düşündürür. Mənbə bunu xüsusilə Incremental və Decremental siniflərindəki daha aşağı precision/recall dəyərləri ilə müzakirə edir.
Səhifə 9-dakı confusion matrix-lərin elmi mesajı
Mənbə Şəkil 1-in Task 1-də Non-Predictive nümunələrin Predictive nümunələrdən daha yüksək düzgün təsnifat nisbətinə malik olduğunu göstərdiyini bildirir. Şəkil 2 isə Random Forest-ın Task 2-də Neutral sinfini nəzərəçarpacaq dərəcədə daha yaxşı ayırdığını, Incremental və Decremental nümunələrin bir-biri ilə daha tez-tez qarışdığını göstərir. Bu vizuallar yalnız ümumi accuracy-yə baxmağın yetərli olmadığını; sinif üzrə səhv profilinin də ayrıca araşdırılmalı olduğunu ortaya qoyur.
Bu tədqiqat həqiqətən kriptovalyuta qiymətlərini proqnozlaşdırırmı?
Xeyr. Tədqiqat kriptovalyuta qiymətlərinin gələcək ədədi dəyərini və ya istiqamətini bazar məlumatlarına qarşı proqnozlaşdırmır; tvitlərdə insanların gələcəyə dair istiqamətli gözləntilərini təsnif edir və müəlliflər bu siniflərin real qiymət hərəkətləri ilə uyğunlaşdırılmasını açıq şəkildə gələcəkdə aparılmalı doğrulama kimi saxlayırlar.
Tədqiqatın dəstəklədiyi nəticələr
- Predictive statement ilə ümumi sentiment fərqi kripto sosial media mətnlərində tətbiq oluna bilən iki mərhələli təsnifat quruluşu təmin edir.
- GPT əsaslı paraphrase augmentation-dan sonra bütün model ailələrində macro F1 yüksəlmişdir.
- Task 1-də XLM-RoBERTa ən yüksək macro F1 dəyərini vermişdir.
- Task 2-də Random Forest transformer və dərin öyrənmə modellərindən daha yüksək macro F1 vermişdir.
- Incremental ifadələr əsasən müsbət emosiyalarla, Decremental ifadələr isə daha çox mənfi emosiyalarla əlaqəlidir.
- Emosiya ilə bazar istiqaməti gözləntisi tam eyni deyil; bəzi eniş proqnozları müsbət emosiya ilə birlikdə ola bilər.
- Neutral sinfi seçilmiş səhv analizində Incremental və Decremental siniflərdən daha yüksək precision, recall və F1 göstərir.
Tədqiqatın dəstəkləmədiyi nəticələr
Tədqiqat tvit siniflərinin real kriptovalyuta qiymət hərəkətlərini proqnozlaşdırdığını, modellərin gəlirli trading sistemi yaratdığını, nəticələrin başqa dillərə və ya sosial media platformalarına avtomatik ümumiləşdirilə biləcəyini, real vaxt bazarında eyni uğuru qoruyacağını və ya GPT ilə artırılmış məlumat üzərindəki cross-validation performansının müstəqil xarici məlumat performansı ilə eyni olduğunu göstərmir.
Əsas məhdudiyyətlər
Tək platforma: Məlumat yalnız X/Twitter-dan gəlir.
Tək dil: Yalnız ingiliscə tvitlər istifadə olunub; mədəni və dil üzrə ümumiləşmə sınaqdan keçirilməyib.
Real bazar məlumatı yoxdur: Predictive statement sinifləri hələ eyni vaxtlı və ya gələcək real qiymət hərəkətləri ilə doğrulanmayıb.
Xarici test dəsti bildirilmir: Qiymətləndirmə 5-fold cross-validation-a əsaslanır.
Augmentation-fold detalı çatışmır: GPT paraphrase-larının fold-lar arasında ilkin nümunələri ilə birlikdə qruplaşdırılıb-qruplaşdırılmadığı açıqlanmır. Buna görə sintetik nümunələrin qiymətləndirmə müstəqilliyinə təsiri tam nəzarət edilə bilmir.
Hiperparametr detalları məhduddur: Mənbə model ailələrini sadalasa da, hər model üçün detallı təlim hiperparametrlərini, optimizer ayarlarını, epoch saylarını və random seed kimi təkrar istehsal oluna bilmə detallarını geniş şəkildə vermir.
Mənbədaxili nəticə anlatımı uyğunsuzluqları: Bəzi alt bölmə mətnləri eyni səhifədəki rəqəmsal cədvəllərin model sıralaması ilə uyğun gəlmir; buna görə Verianla məqaləsində rəqəmsal cədvəllərə və nəticə bölməsinə üstünlük verilmişdir.
Gələcək tədqiqat istiqamətləri
Müəlliflər predictive statement siniflərini və SenticNet emosiya siqnallarını real qiymət hərəkətləri ilə eyni zaman intervallarında uyğunlaşdıraraq proqnoz potensialını sınaqdan keçirməyi planlaşdırırlar. Həmçinin çoxdilli məlumat, real vaxt tətbiqləri və PBC4cip kimi alternativ sinif balanslaşdırma üsulları gələcək tədqiqat sahələri kimi qeyd edilmişdir.
Mənbə və Metod Qeydi
Orijinal başlıq: Decoding Market Emotions in Cryptocurrency Tweets via Predictive Statement Classification with Machine Learning and Transformers
Müəlliflər: Moein Shahiki Tash; Zahra Ahani; Mohim Tash; Mostafa Keikhay Farzaneh; Ari Y. Barrera-Animas; Olga Kolesnikova.
Afiliyasiyalar: Centro de Investigación en Computación, Instituto Politécnico Nacional, Ciudad de México; Management and Economics Faculty, University of Sistan and Baluchestan, Zahedan; Universidad Panamericana, Ciudad de México.
Yüklənmiş mənbə versiyası: 25 mart 2026 tarixli preprint; PDF-də “Preprint submitted to Results in Physics” ifadəsi var.
Arxiv qeydi: arXiv:2603.24933. ArXiv obyekti üçün DOI: 10.48550/arXiv.2603.24933.
Cari nəşr statusu: Eyni tədqiqat və eyni altı müəllifin 2026-cı ildə Computación y Sistemas, Vol. 30 No. 3, s. 1943–1953 daxilində yayımlandığı görünür. Jurnal qeydində başlıq “Predictive-Statement Classification” formasında defislə yazılır.
Jurnal: Computación y Sistemas.
Nəşr edən qurum: Instituto Politécnico Nacional, Centro de Investigación en Computación.
Resenziya: Computación y Sistemas resenziyalı elmi jurnaldır; yüklənmiş sənəd isə jurnal nəşrindən əvvəlki preprint versiyasıdır.
Lisenziya: Computación y Sistemas nəşrləri Creative Commons Attribution 4.0 International (CC BY 4.0) lisenziyası altında yayımlanır.
Final jurnal DOI-si: Əlçatan rəsmi jurnal indeksində bu məqaləyə aid final DOI təsdiqlənmədiyinə görə uydurulmamışdır. 10.48550/arXiv.2603.24933 arXiv versiyasının DOI-sidir.
Məlumat: 2021-ci ilin sentyabrı–2023-cü ilin martı dövründə X/Twitter-dan toplanan təxminən 30.000 ingiliscə tvitlik mənbə kolleksiyasından təsadüfi seçilmiş 3.116 tvit.
Kriptovalyutalar: Cardano, Binance, Fantom, Matic və Ripple.
Annotation: İki insan annotatoru + GPT modelləri; GPT-4o ilə insan annotation-ı arasındakı Predictive Statement Detection Cohen's κ = 0,7493.
Məlumat balanslaşdırması: GPT-4o ilə mənanı qoruyan paraphrase augmentation.
İlkin emal: URL silinməsi, xüsusi simvolların təmizlənməsi, qısa tokenlərin çıxarılması, tokenization və normalization.
Ənənəvi modellər: Logistic Regression, Random Forest, XGBoost, SVM Linear, SVM RBF; TF-IDF təmsili.
Dərin öyrənmə: CNN və BiLSTM; GloVe və FastText embeddingləri.
Transformer modelləri: DistilRoBERTa, RoBERTa-base, RoBERTuito, BERT-base, XLM-RoBERTa.
Emosiya çıxarımı: SenticNet.
Qiymətləndirmə: 5-fold cross-validation; Accuracy, Precision, Recall, F1, Macro F1 və Weighted F1.
Maliyyələşdirmə və dəstək: Mexican Government CONACYT A1-S-47854; Instituto Politécnico Nacional Secretaría de Investigación y Posgrado 20241816, 20241819 və 20240951 qrantları; INAOE superkompüter resursları; Microsoft Latin America PhD Award.
Corresponding author: Yüklənmiş preprintdə açıq şəkildə göstərilmir.
Data Availability Statement: Yüklənmiş preprintdə ayrıca məlumat əlçatanlığı bəyanatı yoxdur.
CRediT / müəllif töhfələri: Yüklənmiş preprintdə ayrıca CRediT töhfə bölməsi yoxdur.
Maraqların toqquşması: Yüklənmiş preprintdə ayrıca conflict-of-interest bəyanatı yoxdur.
Əsas elmi sərhəd: Bu tədqiqat sosial media mətnində gələcəyə yönəlik bazar gözləntisinin təsnifatını qiymətləndirir; real kriptovalyuta qiyməti və ya investisiya gəliri forecasting uğurunu hələ sınaqdan keçirmir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib