


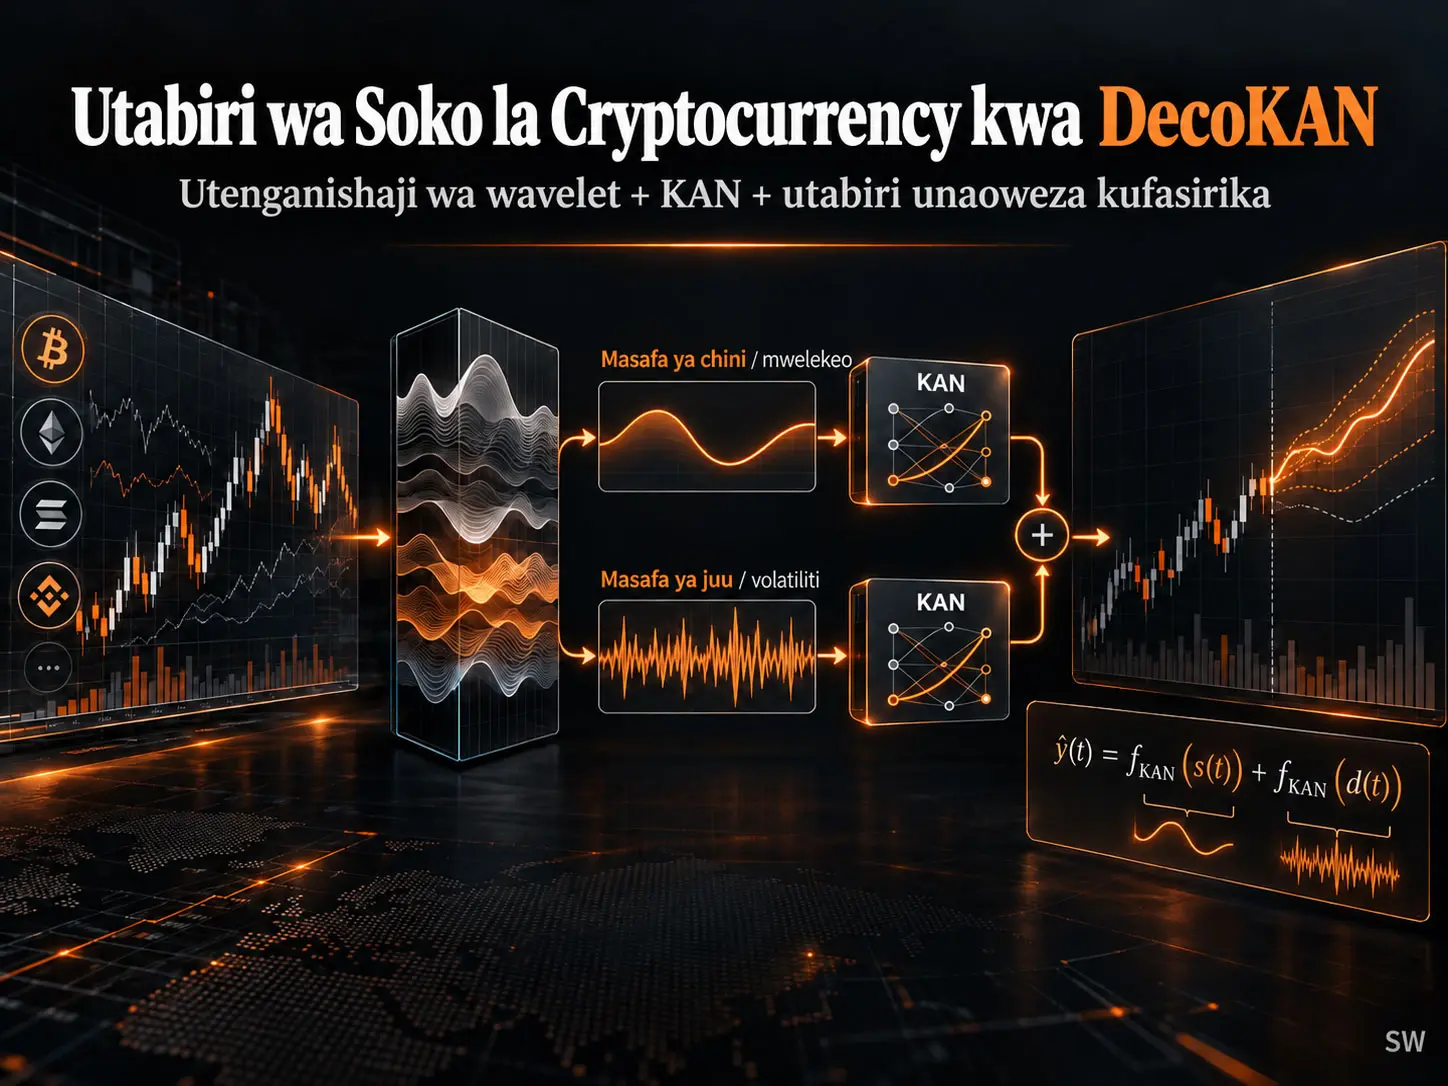
DecoKAN ni mfumo wa utabiri wa mfululizo wa muda wa muda mrefu unaoweza kufasirika, ambao hugawanya mifuatano ya muda yenye vigezo vingi katika masoko ya cryptocurrency katika vipengele vya masafa tofauti na kuviunda vipengele hivyo kimoja kimoja kwa kutumia Kolmogorov–Arnold Networks (KAN). Kwanza, modeli hutenganisha vipengele vya trend vya masafa ya chini kutoka kwenye mabadiliko na kelele za masafa ya juu kwa kutumia Discrete Wavelet Transform (DWT) ya ngazi nyingi; kisha huchakata kila wavelet component ndani ya KAN Resolution Branch maalum na kuunganisha tena vipengele vilivyotabiriwa katika time domain kwa kutumia Inverse Discrete Wavelet Transform (IDWT). Utafiti unatathmini si tu seti za data za kila siku zenye vigezo vingi za BTC, ETH na XMR, bali pia benchmark za jumla za mfululizo wa muda ETTh1, ETTh2, ETTm1 na ETTm2.
Lengo kuu la modeli si kupunguza prediction error pekee. Watafiti wanaeleza kwamba ingawa modeli za kisasa za utabiri zinazotegemea Transformer na MLP zinaweza kutoa performance ya juu, utendaji wao wa ndani mara nyingi hubaki kama “kisanduku cheusi”. DecoKAN inajaribu kushughulikia tatizo hili kwa kupitisha learnable B-spline functions katika miunganisho ya KAN kupitia hatua za sparsification, pruning na symbolification ili kuzibadilisha kuwa functions zinazoweza kuchunguzwa kihisabati.
Katika majaribio yaliyoripotiwa katika chanzo, DecoKAN ilipata average MSE na MAE za chini zaidi katika horizons zote za utabiri kwa seti zote za data za BTC, ETH na XMR. Ikilinganishwa na WPMixer, average MSE ilikuwa chini kwa takriban %15,0 kwa BTC, %29,1 kwa ETH na %15,1 kwa XMR. Hata hivyo, utafiti unatathmini metrics za model prediction pekee; investment return, mafanikio ya live trading, portfolio performance au economic causality ya mienendo ya soko ya baadaye hayakujaribiwa.
Tatizo la utafiti: mizani tofauti za muda ndani ya mfululizo mmoja wa muda
Data ya soko la cryptocurrency haitokani na dynamic moja tu. Wakati kupitishwa kwa muda mrefu, matumizi ya mtandao na mabadiliko katika muundo wa soko husogea kwa kiasi cha polepole, speculative transactions, short-term shocks na harakati za ghafla za volatility zinaweza kutokea katika frequency ya juu zaidi. Mizani hizi tofauti zinapopishana ndani ya mfululizo mmoja wa observations, prediction model hulazimika kutatua muundo wa muda mrefu na short-term fluctuation ndani ya representation moja.
Tatizo la kwanza la msingi la utafiti ni kutenganisha mixed signals hizi. Tatizo la pili ni ugumu wa mtumiaji kuelewa internal transformations za modeli za kisasa zenye performance ya juu. Watafiti wanashughulikia matatizo haya mawili pamoja: DWT hutenganisha signal katika frequency components, huku KAN ikilenga kufanya nonlinear transformations zilizojifunzwa ndani ya kila component iliyotenganishwa ziweze kuchunguzwa.
DecoKAN hutenganishaje mifuatano ya muda ya cryptocurrency?
DecoKAN hugawanya normalized multivariate time series kwa kutumia DWT kuwa approximation component moja ya masafa ya chini na detail components moja au zaidi za masafa ya juu; hutabiri kila component ndani ya KAN Resolution Branch tofauti na kubadilisha matokeo tena kuwa mfululizo mmoja wa muda wa baadaye kwa kutumia IDWT.
Ufafanuzi wa kihisabati wa tatizo la utabiri
Mfululizo wa kihistoria wa muda wenye vigezo vingi
\(\mathcal{X}=\{x_t\}_{t=1}^{N}\)
hufafanuliwa. Hapa \(N\) inawakilisha urefu wa jumla wa muda, huku \(x_t\in\mathbb{R}^{1\times C}\) ikiwakilisha observation vector katika wakati \(t\) yenye variables \(C\). Variables zinaweza kujumuisha vipimo mbalimbali vya soko na blockchain kama bei, market capitalization, volatility, transaction activity au network indicators.
Past observation window yenye urefu \(L\)
\(X_L=\{x_{t-L+1},...,x_t\}\)
hufafanuliwa. Kazi ya modeli ni kujifunza future yenye urefu \(T\) kupitia mapping \(F\) inayotabiri:
\[ X_T=F(X_L) \tag{1} \]
Hapa \(X_T=\{x_{t+1},...,x_{t+T}\}\) ni multivariate sequence inayokusudiwa kutabiriwa katika siku zijazo. Kwa hiyo, DecoKAN haifanyi one-step tu; inafanya multi-step na multivariate time-series forecasting.
Normalization dhidi ya distribution shift kwa RevIN
Volatility ya juu na kutokuwa stationary kwa data ya cryptocurrency kunaweza kusababisha data distribution kubadilika kati ya training na test periods. Kwa sababu hii DecoKAN hutumia Reversible Instance Normalization (RevIN). Katika input sequence, kila channel hunormalishwa kwa kutoa mean yake na kugawanywa kwa standard deviation yake. Katika implementation ya chanzo, kwa numerical stability epsilon ya \(1\times10^{-6}\) huongezwa kwenye variance na standard deviation huwekewa kikomo kisichopungua \(1\times10^{-4}\).
Statistics hizi huhifadhiwa. Baada ya model prediction kukamilika, output hurudishwa katika original data scale kwa kutumia RevIN.denorm. Hivyo normalization haibadilishi final scale ya physical au financial quantities ambazo modeli imetabiri.
Discrete Wavelet Transform ya ngazi nyingi
Input \(\underline{X}_L\), ambayo imenormalishwa na kubadilishwa kuwa channel-first form, hutenganishwa kwa matumizi ya kurudiwa ya high-pass na low-pass wavelet filters:
\[ [X_{A_m},X_{D_m},X_{D_{m-1}},...,X_{D_1}] = \mathrm{DWT}(\underline{X}_L,\psi,m) \tag{2} \]
\(X_{A_m}\) inawakilisha approximation coefficients katika level \(m\); \(X_{D_m},...,X_{D_1}\) zinawakilisha detail coefficients katika resolutions tofauti. Approximation component hubeba low-frequency structure inayobadilika polepole zaidi; detail components hubeba representation ya structures zinazobadilika haraka zaidi.
Katika cryptocurrency experiments, Daubechies 4 (db4) ilitumika kama base wavelet. Decomposition level \(m\) ni hyperparameter; katika maelezo ya architecture ya chanzo default value ni 1, huku katika cryptocurrency hyperparameter search \(m=1\) na \(m=2\) zilitathminiwa. Symmetric padding hutumika kupunguza boundary effects.
Kila frequency component huenda kwenye Resolution Branch tofauti
Kila moja ya coefficient series \(m+1\) zinazotokana na DWT huchakatwa na KAN Resolution Branch tofauti. Coefficient series \(X_{w_i}\in\mathbb{R}^{C\times L_i}\) kwanza hupitia RevIN normalization tena ndani ya branch, kisha hugawanywa kuwa overlapping patches:
\[ X_{P_i}\in\mathbb{R}^{C\times N_i\times P} \]
Hapa \(P\) ni patch size na \(N_i\) ni idadi ya patches. Patches hupitishwa kwenye shared linear embedding layer ili kuunda
\[ X_{d_i}=\mathrm{Embedding}(X_{P_i}) \in\mathbb{R}^{C\times N_i\times d} \tag{3} \]
representation. \(d\) ni embedding dimension ya modeli.
DecoKAN Mixer mbili zinazofuatana
Ndani ya kila Resolution Branch, KAN Mixer mbili hufanya kazi kwa kufuatana:
\[ X_{d_i}^{2}=\mathrm{KANMixer}_1(X_{d_i}) \tag{4} \]
\[ X_{d_i}^{3}=\mathrm{KANMixer}_2(X_{d_i}^{2}) \tag{5} \]
Output ya mixer ya pili huunganishwa na initial embedding katika residual connection ya kiwango cha branch:
\[ Y_{d_i}=X_{d_i}\oplus X_{d_i}^{3} \tag{6} \]
Residual structure huunda information path inayozuia initial representation kupotea kabisa huku ikiruhusu layers kujifunza transformations mpya.
Kwa nini KAN Mixer ni tofauti na MLP Mixer ya kawaida?
KAN Mixer ya DecoKAN hutumia learnable univariate B-spline functions kwenye connections badala ya standard MLP transformations zenye fixed activations; hivyo nonlinear transformations zilizojifunzwa katika temporal na feature dimensions zinaweza kuchunguzwa katika kiwango cha connection, kufanywa sparse, na baadaye kukadiriwa kwa symbolic functions.
Temporal KAN Mixer
Temporal mixer hujifunza relationships katika patch axis. Kwanza LayerNorm hutumika, tensor dimensions hubadilishwa ili KAN iweze kufanya kazi kwenye axis husika, KAN transformation hufanywa, na result huongezwa kwenye original input kupitia residual connection:
\[ Y'= P_{d\leftrightarrow N} \left( KAN_p \left( P_{N\leftrightarrow d}(N(X_{d_i})) \right) \right) \tag{7} \]
\[ X''_{d_i}=X_{d_i}+D(Y') \tag{8} \]
Hapa \(N\) inawakilisha normalization, \(P\) permutation operation, \(KAN_p\) temporal KAN layer na \(D\) dropout operation.
Feature KAN Mixer
Submodule ya pili huchakata relationships kati ya variables katika embedding/feature axis:
\[ Y''=KAN_e(N(X''_{d_i})) \tag{9} \]
\[ X_{d_i}^{2}=X''_{d_i}+D(Y'') \tag{10} \]
Hivyo, katika Mixer block moja, time/patch relationships humodeliwa kwanza, zikifuatiwa na nonlinear interactions katika feature dimension.
Learnable spline function ndani ya KANLinear
Katika kiini cha interpretability potential ya KAN kuna learnable function \(\phi(x)\) ya kila connection. Chanzo kinafafanua function hii kama ifuatavyo:
\[ \phi(x)= w_b b(x)+ w_s\sum_{j=0}^{G+k-1}c_jB_j(x) \tag{11} \]
\(b(x)\) ni base function inayotumika kama SiLU katika implementation; \(B_j(x)\) ni B-spline basis functions; \(c_j\) ni spline coefficients; na \(w_b\) pamoja na \(w_s\) ni learned weights. Default KAN grid size ni \(G=5\), na spline order ni \(k=3\).
Regularization kwa network sparse na inayoweza kufasirika
Regularization loss inayojumuisha connection magnitude na entropy components huongezwa kwa kila KANLinear layer:
\[ L_{reg} = \lambda_1 \sum_{\mathrm{edges}}|\phi|_1 + \lambda_2 \sum_{\mathrm{edges}}S(\phi) \tag{12} \]
Kwa normalized spline coefficients katika entropy term
\[ p_j=\frac{|c_j|}{\sum_k|c_k|} \]
na
\[ S(\phi)=-\sum_j p_j\log p_j \]
hutumika. Katika chanzo \(\lambda_1\) na \(\lambda_2\) kwa kawaida ni 1,0; total regularization strength \(\gamma\) hutolewa kwa mfano katika kiwango cha \(10^{-5}\).
Total training loss ni:
\[ L_{total}=L_{forecast}+\gamma L_{reg} \]
. \(L_{forecast}\) ni Mean Squared Error kati ya prediction na ground truth. Lengo hapa si error minimization pekee; pia ni kuhimiza uundaji wa KAN connections zilizo sparse zaidi na ambazo baadaye zinaweza kuchunguzwa.
Kurudisha predicted coefficients katika time domain
Katika final representation ya kila branch, patch na embedding dimensions hufanywa flat:
\[ Y_{f_i}=\mathrm{Flatten}(Y_{d_i}) \in\mathbb{R}^{C\times(N_i d)} \tag{13} \]
Kisha linear Head layer huzalisha future coefficients kwa wavelet component husika:
\[ Y_{h_i}=\mathrm{Linear}(Y_{f_i}) \in\mathbb{R}^{C\times T_i} \tag{14} \]
Approximation na detail predictions zote hupewa IDWT ili kurudishwa katika time domain:
\[ Y= \mathrm{IDWT} (Y_{A_m},Y_{D_m},...,Y_{D_1}) \in\mathbb{R}^{C\times T} \tag{15} \]
Final output hutranspose na kudenormalize kwa RevIN statistics zilizohifadhiwa mwanzoni, na hivyo kupata final prediction katika umbo \(X_T\in\mathbb{R}^{T\times C}\).
Interpretability si kuchora graph tu
Baada ya training, DecoKAN hutumia hatua ya pili ya interpretability. Kwanza, connections zilizofanywa sparse kwa regularization huchunguzwa. Kisha ikiwa \(L_2\) norm ya spline activation function iko chini ya threshold \(\tau\), connection hiyo huprune. Katika ETH case study \(\tau=0,05\) ilitumika. Functions zilizobaki hufanyiwa approximate symbolification kwa mathematical expressions zinazotoa \(R^2\) fit ya juu zaidi kati ya polynomial, trigonometric na candidate functions nyingine zinazofanana.
Kuna boundary muhimu ya interpretation hapa: symbolic expressions zinazopatikana ni mathematical approximations za transformations ambazo modeli imejifunza katika KAN connections fulani. Uwezo wa functions hizi kuwakilisha spline transformation kwa \(R^2\) ya juu haumaanishi kwamba function hiyo ni causal economic law katika soko la cryptocurrency.
Mbinu na Matokeo ya Utafiti
Seti za data zilizotumika
General long-term time-series forecasting performance ilijaribiwa kwenye benchmark za ETTh1, ETTh2, ETTm1 na ETTm2; target application area ilijaribiwa kwenye Bitcoin, Ethereum na Monero. Cryptocurrency data ni daily multivariate time series zilizopatikana kutoka Coin Metrics Community Network Data.
| Seti ya data | Idadi ya variables | Ukubwa wa data ulioripotiwa katika chanzo | Frequency |
|---|---|---|---|
| ETTh1 / ETTh2 | 7 | (8545, 2881, 2881) | Kila saa |
| ETTm1 / ETTm2 | 7 | (34465, 11521, 11521) | 15 dakika |
| BTC | 147 | (6099, 4269, 1219) | Kila siku |
| ETH | 146 | (3700, 2590, 740) | Kila siku |
| XMR | 48 | (4168, 2917, 833) | Kila siku |
Variables katika cryptocurrency datasets hazijumuishi bei pekee. Chanzo kinaeleza kwamba data structure inajumuisha market dynamics kama bei, market capitalization na volatility; on-chain activity measures kama transaction counts na fees; na network-security indicators kama hashrate/difficulty.
Hyperparameters kuu za cryptocurrency experiments
| Parameter | Cryptocurrency benchmarks |
|---|---|
| Look-back window \(L\) | 96 |
| Prediction horizon \(T\) | 24, 48, 96, 168 |
| Wavelet basis | db4 |
| Decomposition level \(m\) | 1, 2 |
| KAN grid size \(G\) | 5 |
| KAN spline order \(k\) | 3 |
| Patch size \(P\) | 8, 16 |
| Patch stride \(S\) | 4, 8 |
| Model dimension \(d\) | 64, 128, 256 |
| Temporal factors | 2–6 |
| Dimension factors | 2–6 |
| Dropout | 0,05–0,3 |
| Batch size | 4, 8, 16 |
| Learning rate | \(10^{-4}\)–\(5\times10^{-4}\) |
| Epoch | 30 |
Ulinganisho unajumuisha modeli za WPMixer, TimeFilter, TimeMixer, TimeXer, TimesNet, PatchTST, DLinear na Crossformer. Evaluation metrics ni Mean Squared Error (MSE) na Mean Absolute Error (MAE); katika metrics zote mbili value ya chini inaashiria performance bora. Experiments zilifanywa kwenye NVIDIA Tesla V100 GPU moja.
DecoKAN ilipata performance gani katika utabiri wa cryptocurrency?
Kulingana na Jedwali III katika chanzo, DecoKAN ilipata average MSE na MAE za chini zaidi katika seti zote tatu za data za BTC, ETH na XMR wakati prediction horizons za hatua 24, 48, 96 na 168 zilipotathminiwa pamoja; ikilinganishwa na WPMixer, ilipunguza average MSE kwa takriban %15,0 katika BTC, %29,1 katika ETH na %15,1 katika XMR.
| Seti ya data | DecoKAN MSE | DecoKAN MAE | WPMixer MSE | WPMixer MAE | TimeFilter MSE | TimeFilter MAE |
|---|---|---|---|---|---|---|
| BTC wastani | 0,136 | 0,130 | 0,160 | 0,161 | 0,146 | 0,135 |
| ETH wastani | 0,100 | 0,155 | 0,141 | 0,208 | 0,118 | 0,160 |
| XMR wastani | 0,219 | 0,160 | 0,258 | 0,190 | 0,235 | 0,160 |
Kwa BTC, values za DecoKAN MSE/MAE ni 0,108/0,096 kwa \(T=24\); 0,120/0,115 kwa \(T=48\); 0,142/0,138 kwa \(T=96\) na 0,174/0,172 kwa \(T=168\), mtawalia.
Kwa ETH, values zinazolingana ni 0,061/0,108; 0,084/0,136; 0,110/0,169 na 0,144/0,205. Hasa, kushuka kwa average MSE ya ETH hadi 0,100 kunawakilisha improvement ya takriban %29,1 iliyoripotiwa katika chanzo ikilinganishwa na value ya 0,141 ya WPMixer.
Kwa XMR, MSE/MAE values ni 0,142/0,112 kwa \(T=24\); 0,185/0,139 kwa \(T=48\); 0,239/0,175 kwa \(T=96\) na 0,310/0,215 kwa \(T=168\).
Nini kilitokea kwenye benchmark za jumla za ETT?
DecoKAN haikujaribiwa tu kwenye cryptocurrency datasets. Katika ETTh1, ilipata average ya jumla bora zaidi kwa MSE/MAE 0,413/0,430 na average MSE ilipungua kwa takriban %4,6 ikilinganishwa na WPMixer. Average MSE ya chini zaidi pia iliripotiwa katika ETTh2 na ETTm2. Katika ETTm1, ingawa average MSE ya DecoKAN ni imara kwa 0,358, kwenye average MAE value ya 0,383 ya WPMixer ni kidogo chini kuliko value ya 0,386 ya DecoKAN. Kwa hiyo, matokeo ya chanzo hayasemi kwamba DecoKAN ina ubora wa moja kwa moja katika kila dataset na kila metric.
Gharama ya ukokotoaji: FLOP ya chini, training polepole
Efficiency analysis tofauti ilifanywa kwenye ETTh1 kwa configuration ya pamoja ya \(L=96\), \(d_{model}=16\), batch size 64 na \(d_{ff}=4d_{model}\). Idadi ya parameters za DecoKAN hubadilika takriban kati ya 0,11–0,18 milioni kulingana na prediction horizon.
Katika hali ya \(T=96\), DecoKAN ina theoretical computational load ya takriban 0,0073 GFLOPs. Katika comparison hiyo hiyo, WPMixer ni takriban 0,12 GFLOPs na TimeMixer takriban 0,86 GFLOPs. Kwa hiyo, modeli ni ya gharama ndogo sana kwa theoretical FLOP.
Kwa upande mwingine, training ni polepole zaidi kwa sababu B-spline computations hazijaoptimizewa kwenye GPU kwa kiwango sawa na dense matrix multiplications. Kwa \(T=96\), training time ya DecoKAN kwa epoch ni takriban 12,6 sekunde; ya WPMixer takriban 2,5 sekunde na ya PatchTST takriban 1,3 sekunde. Full test-set inference time ni takriban 5,1 sekunde kwa DecoKAN, na takriban 4,7 sekunde kwa WPMixer na PatchTST.
Kwa hiyo computational profile ya architecture haiwezi kufupishwa tu kama “modeli ya haraka zaidi”: theoretical operation count ni ndogo sana, inference ni competitive, lakini training cost ni kubwa kutokana na implementation ya sasa ya B-spline.
Ablation study ilionyesha nini kuhusu jukumu la KAN components?
Katika ablation experiments zilizofanywa kwa random seed tano tofauti, Full DecoKAN inayotumia temporal na feature KAN components ilitoa average MSE ya chini zaidi kwenye ETTh2, huku kwenye ETH Feature KAN-only structure ikionyesha performance iliyo karibu na Full DecoKAN; Temporal KAN-only na hasa internal baseline inayotegemea MLP pekee zilitoa error ya juu zaidi.
Configurations nne za ablation
- Full KAN: Hutumia KAN kwa temporal na feature mixing.
- Temporal KAN only: Standard MLP hutumika badala ya Feature KAN.
- Feature KAN only: Standard MLP hutumika badala ya Temporal KAN.
- Baseline MLP only: DWT backbone hudumishwa lakini KAN mixers hubadilishwa na standard MLPs.
Kwenye ETTh2, Full DecoKAN ilitoa average MSE ya chini zaidi. Kuondolewa kwa temporal au feature KAN kuliharibu performance na MLP-only structure ilitoa average MSE ya juu zaidi. Kwa kuwa DWT backbone ilibaki sawa katika configurations zote nne, watafiti wanafasiri tofauti hii kama ushahidi wa contribution ya KAN mixers.
Kwa ETH, pattern tofauti ilijitokeza. Performance distribution ya Feature KAN-only model iko karibu sana na Full DecoKAN; error inaongezeka wazi katika Temporal KAN-only configuration. Watafiti wanaunganisha hili na umuhimu wa simultaneous cross-variable relationships za price, transaction volume, transaction fees na variables zinazofanana katika cryptocurrency dataset. Hata hivyo, maelezo haya ni interpretation ya model behavior; si independent causal market experiment.
Pruning analysis kwenye ETH
Katika interpretability case study, single-level wavelet decomposition \(m=1\) ilitumika. Hivyo njia kuu mbili huundwa: Approximation Branch inayochakata low-frequency trend, na Detail Branch inayochakata high-frequency volatility/noise components.
| Branch | Jumla ya connections | Zilizoprunewa | Zilizohifadhiwa | Prune ratio |
|---|---|---|---|---|
| Approximation | 12.720 | 609 | 12.111 | 4,79% |
| Detail | 12.720 | 9.703 | 3.017 | 76,28% |
| Modeli nzima | 25.440 | 10.312 | 15.128 | 40,53% |
Matokeo haya yanaashiria functional separation ya wazi ndani ya modeli. Wakati sehemu kubwa ya connections za Approximation Branch ilihifadhiwa, takriban robo tatu ya Detail Branch iliprunewa. Watafiti wanafasiri approximation path kama dense na stable backbone inayohifadhi low-frequency structure, na detail path kama sparse component inayochagua tu connections muhimu kutoka high initial capacity.
“Interpretability” ya DecoKAN huzalisha output gani halisi?
DecoKAN hukadiria B-spline connection functions zilizojifunzwa katika training kwa polynomial, trigonometric au candidate functions nyingine zinazofanana baada ya sparsification na pruning, na hivyo kuzalisha explicit mathematical expressions zenye \(R^2\) values za juu; expressions hizi zinaonyesha behavior ya baadhi ya internal connections za modeli lakini hazipaswi kutathminiwa kama causal economic laws za soko la crypto.
Mifano ya symbolic connections iliyotolewa kutoka ETH dataset
| Nafasi | Branch | Mixer | Symbolic expression | \(R^2\) |
|---|---|---|---|---|
| 1 | Detail | KAN Mixer 2 | \(-0.076x^4+0.216x^3+0.252x^2-1.370x-0.116\) | 0,9968 |
| 2 | Detail | KAN Mixer 1 | \(-0.153x^4+0.170x^3+0.610x^2-1.270x-0.334\) | 0,9958 |
| 3 | Detail | KAN Mixer 1 | \(-1.403\sin(0.905x+0.039)-0.156\cos(2.721x)\) | 0,9941 |
| 4 | Detail | KAN Mixer 1 | \(-1.307\sin(1.072x+0.056)-0.186\cos(-3.039x)\) | 0,9937 |
| 5 | Detail | KAN Mixer 1 | \(-0.047x^4+0.226x^3+0.080x^2-1.386x+0.004\) | 0,9931 |
| 6 | Detail | KAN Mixer 2 | \(0.163x^4-0.195x^3-0.596x^2+1.317x+0.302\) | 0,9926 |
| 7 | Detail | KAN Mixer 1 | \(-1.282\tanh(1.431x+0.029)\) | 0,9905 |
| 8 | Detail | KAN Mixer 1 | \(0.112x^4-0.144x^3-0.390x^2+1.240x+0.189\) | 0,9884 |
| 9 | Approximation | KAN Mixer 2 | \(0.923\sin(1.348x+0.695)+0.801\cos(2.624x)\) | 0,9862 |
| 10 | Detail | KAN Mixer 1 | \(1.044\sin(1.312x+0.462)+0.678\cos(2.631x)\) | 0,9826 |
Ukweli kwamba sehemu kubwa ya highest-ranked symbolic relationships iko katika Detail Branch unaunga mkono interpretation ya watafiti kwamba high-frequency fluctuations huwakilishwa kwa local mathematical functions zilizo wazi zaidi. Approximation Branch inaonekana kwa kiwango kidogo zaidi katika high-confidence symbolic ranking; hapa modeli inaonyesha kuwa information huhifadhiwa katika more distributed connection structure.
Hitimisho zinazoungwa mkono na utafiti
- DecoKAN ilizalisha average MSE na MAE values za chini zaidi katika cryptocurrency datasets zote tatu zilizojaribiwa.
- Frequency decomposition kwa DWT na KAN-based mixing ziliweza kutumika pamoja ndani ya architecture moja.
- Katika ETTh2 ablation, temporal na feature KAN components zote mbili zilichangia full model.
- Katika ETH ablation, feature KAN component inaonekana kuwa muhimu zaidi kuliko temporal KAN.
- KAN connections ziliweza kubadilishwa kwa kukadiriwa kuwa explicit symbolic functions zenye \(R^2\) values za juu.
- Modeli ina theoretical FLOP cost ya chini na competitive inference, lakini training time ni kubwa.
Hitimisho ambazo utafiti hauungi mkono
- Haijaonyeshwa kwamba DecoKAN itatoa faida katika live cryptocurrency trades.
- Prediction performance ya modeli haimaanishi investment advice au future price iliyo hakika.
- Matokeo kwenye BTC, ETH na XMR hayawezi kujumlishwa moja kwa moja kwa crypto assets zote.
- Symbolic KAN functions hazithibitishi economic causality au immutable market law.
- Low inference time haimaanishi kwamba end-to-end latency imethibitishwa katika real high-frequency trading infrastructure.
- Utafiti haukutathmini live market orders, slippage, transaction cost au portfolio return.
Mapungufu
Kizuizi cha kwanza kilichoelezwa wazi katika chanzo ni training efficiency. B-spline computations za KAN hazijaoptimizewa vizuri katika GPU infrastructure za sasa kama dense matrix multiplications katika MLP na Transformer models. Kwa hiyo, licha ya theoretical FLOP value kuwa chini, actual training time ni ndefu.
Kizuizi cha pili ni symbolification stage. Kubadilisha spline function kuwa explicit mathematical expression kunategemea finite candidate-function library. Kwa hiyo, symbolic expression iliyopatikana si absolute na unique solution kati ya mathematical explanations zote zinazowezekana; ni good approximate representation ndani ya candidate set iliyotumika.
Mpaka wa tatu unahusiana na human interpretation. Kupata mathematically explicit function hakumaanishi kwamba economic meaning ya function hiyo inaeleweka automatically. Chanzo pia kinaeleza kwamba interpretation ya symbolic graphs na functions inahitaji domain expertise.
Zaidi ya hayo, target cryptocurrency evaluation imezuiliwa kwa assets tatu, BTC, ETH na XMR. Kwa hiyo haiwezi kuhitimishwa kutokana na utafiti huu kwamba modeli itatoa performance sawa kwa token nyingine, stablecoin, low-liquidity assets au market periods tofauti.
Maana ya jumla ya kisayansi
Contribution kuu ya DecoKAN si kupendekeza prediction network mpya pekee, bali kuunganisha signal processing na interpretable neural-network approach katika flow moja. DWT hugawanya time series kulingana na frequency; KAN hujifunza nonlinear relationships katika kila sehemu; IDWT hurudisha predictions hizi katika common time domain; sparsification, pruning na symbolification hufanya baadhi ya internal connections za modeli ziweze kuchunguzwa kihisabati.
Muundo huu ni muhimu hasa katika cryptocurrency forecasting kwa sababu badala ya kubana long-term trend component na short-term volatility components ndani ya black box moja, modeli huzichakata katika separate resolution paths. Matokeo ya chanzo yanaonyesha kwamba design hii iliweza kutumika kwa BTC, ETH na XMR huku ikitoa strong prediction performance. Hata hivyo, matokeo hayamaanishi guarantee ya financial gain wala kwamba fundamental economic mechanism ya soko imeeleweka kikamilifu.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: DecoKAN: Interpretable Decomposition for Forecasting Cryptocurrency Market Dynamics
Waandishi: Yuan Gao; Zhenguo Dong; Xuelong Wang; Zhiqiang Wang; Yong Zhang; Shaofan Wang.
Corresponding author: Zhiqiang Wang.
Taasisi: Beijing Electronic Science and Technology Institute, Beijing, China; Beijing University of Technology, Beijing, China.
Aina ya chanzo: arXiv preprint.
Kitambulisho cha arXiv: arXiv:2512.20028v1 [cs.LG].
Tarehe ya kwanza ya kuwasilishwa: 23 Desemba 2025.
Hali ya peer review: Toleo lililopakiwa ni arXiv v1 preprint na toleo hili lenyewe halipaswi kutathminiwa kama peer-reviewed journal article. Waandishi hao hao baadaye wana makala kuhusu DecoKAN katika Expert Systems with Applications yenye kichwa tofauti na mbinu iliyopanuliwa; hata hivyo, scientific results katika maandishi haya ya Verianla zimetolewa tu kutoka kwenye chanzo cha arXiv v1 kilichopakiwa.
Ufadhili: Beijing Municipal Natural Science Foundation, No. L251067; Fundamental Research Funds for the Central Universities, No. 3282024058 na 3282024052; China Postdoctoral Science Foundation, No. 2019M650608.
Chanzo cha data: Coin Metrics Community Network Data kwa cryptocurrency benchmarks; ETT datasets kwa general benchmarks.
Hardware: Experiments zilifanywa kwenye NVIDIA Tesla V100 GPU moja.
Evaluation metrics: Mean Squared Error (MSE) na Mean Absolute Error (MAE).
Taarifa ambazo hazipo wazi katika chanzo: Hakuna sehemu tofauti ya CRediT author-contribution, explicit competing-interest statement, au Creative Commons license inayodhibiti wazi reuse iliyogunduliwa katika preprint iliyopakiwa. Hakuna taarifa ya nje ya chanzo iliyoongezwa katika maeneo haya.
Hakimiliki/mbinu ya kuona: Kwa kuwa open reuse license haikuthibitishwa katika chanzo, Fig. 1–Fig. 5 za asili hazipaswi kunakiliwa moja kwa moja. Architecture ya DWT → KAN Resolution Branch → IDWT, computational comparison, ablation relationships na pruning structure zinaweza kuchorwa upya kama original diagrams za Verianla huku source data zikihifadhiwa.
Maelezo muhimu ya kiasi: Maandishi ya chanzo yanaripoti overall average MSE reduction dhidi ya TimeFilter katika cryptocurrency datasets tatu kama %9,6. Simple recalculation kutoka average values za tarakimu tatu katika Jedwali III hutoa takriban %8,8. Kwa kuwa raw, unrounded values hazipatikani, tofauti hii inapaswa kuhifadhiwa kama ilivyo katika chanzo na value ya %9,6 haipaswi kuwasilishwa kama exact recalculated ratio.
Mpaka mkuu wa tafsiri: Utafiti ni tathmini ya time-series forecasting model. Model performance metrics si sawa na real-market profitability, investment success au causal economic mechanisms.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *