


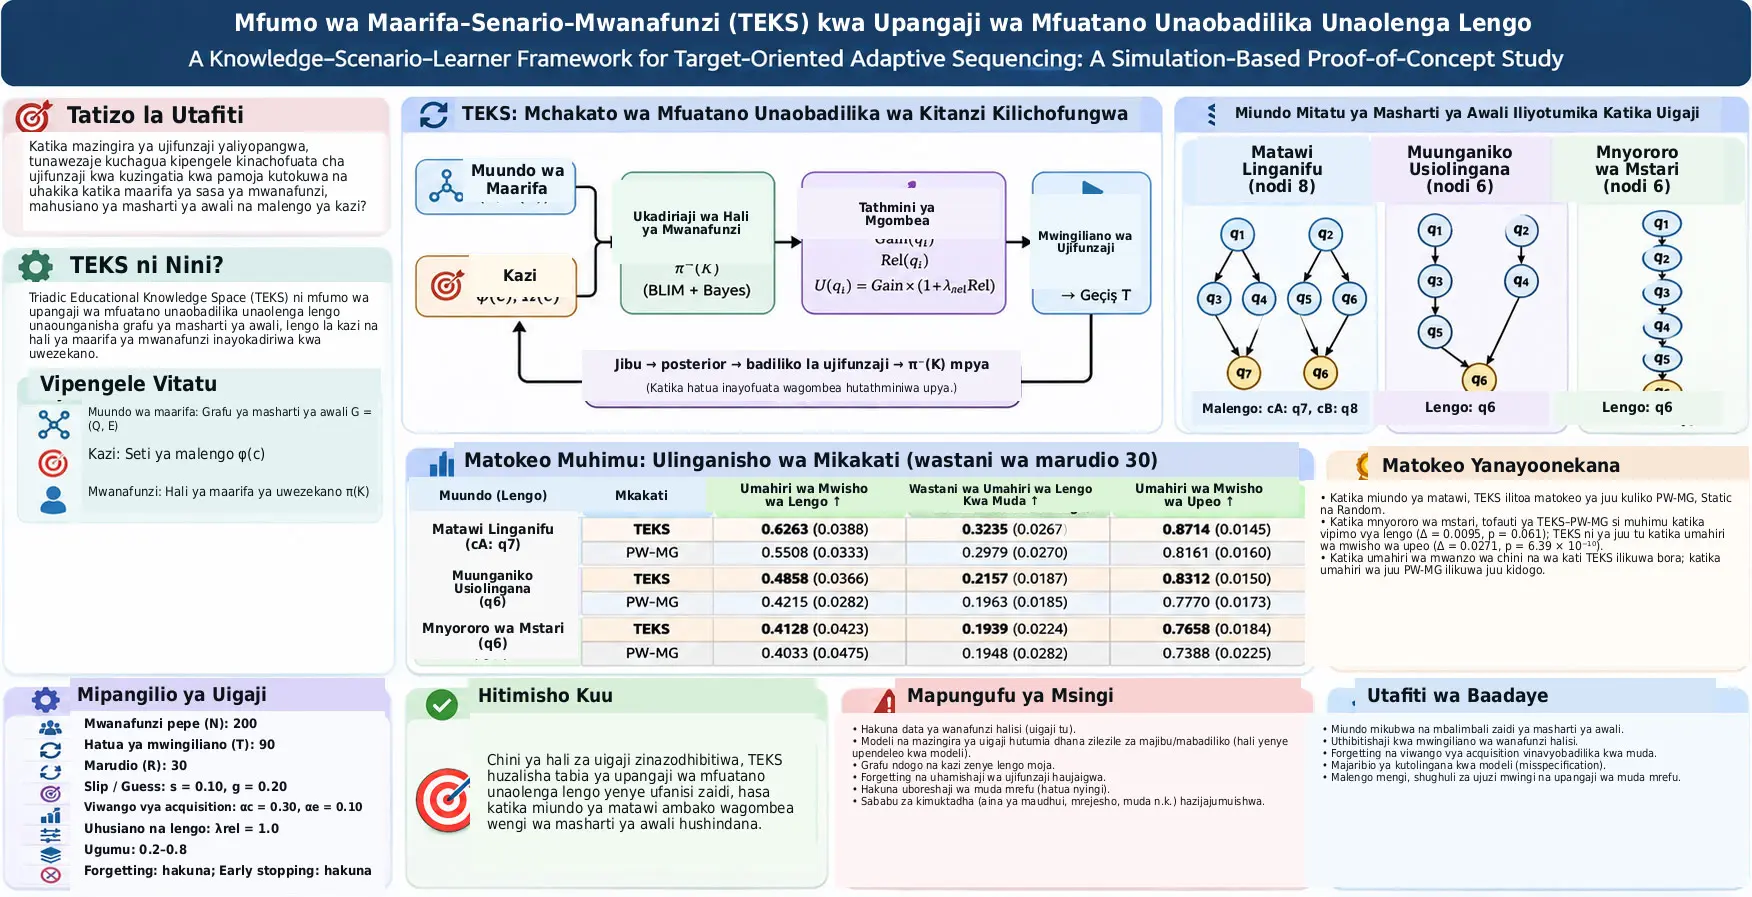
Triadic Educational Knowledge Space (TEKS) ni mfumo wa upangaji wa mfuatano unaobadilika unaolenga lengo ambao, katika maeneo ya ujifunzaji yaliyopangiliwa kimuundo, hutumia kwa pamoja grafu ya masharti ya awali, seti ya malengo mahususi ya kazi na makadirio ya kimawezekano ya hali ya maarifa ya mwanafunzi isiyoweza kuonekana moja kwa moja ili kuamua ni kipengele gani cha kujifunza ambacho mwanafunzi anapaswa kukutana nacho kinachofuata. Utafiti ulitathmini TEKS si kwa wanafunzi halisi, bali katika uigaji uliodhibitiwa wa kitanzi kilichofungwa. Miundo mitatu ya masharti ya awali ilichunguzwa: grafu ya matawi linganifu yenye nodi nane, grafu ya muunganiko usiolingana yenye nodi sita, na mnyororo wa masharti ya awali wa mstari wenye nodi sita. Katika kila hali zilitumika wanafunzi pepe 200, hatua 90 za mwingiliano na marudio huru 30; TEKS ililinganishwa na Prerequisite-Weighted Mastery Gap (PW-MG), Static ya kideterministi na mikakati ya Random chini ya hali zilezile za uigaji.
Mantiki ya uamuzi ya TEKS haitegemei tu swali “mwanafunzi hajui mada gani?”. Kwa kila kipengele cha maarifa kilicho mgombea, kwanza huhesabiwa uwezekano wa kipengele hicho kupatikana upya katika mwingiliano unaofuata kwa kuzingatia hali za sasa za maarifa zisizo na uhakika za mwanafunzi, majibu yanayowezekana ya sahihi/siyo sahihi na mabadiliko ya ujifunzaji yanayofuata. Kisha thamani hii hurekebishwa kwa target relevance inayotegemea umbali wa mwelekeo kwenye grafu kati ya kipengele mgombea na lengo la kazi. Hivyo mfumo hujaribu kutanguliza si tu kipengele ambacho hakijakamilika, bali kile ambacho kina uwezekano wa kupatikana katika hali ya sasa na kinahusiana kimuundo na lengo.
Chini ya miundo miwili mikuu ya matawi, TEKS ilitoa matokeo ya juu kuliko PW-MG, Static na Random katika vipimo vya final target mastery, wastani wa target mastery kwa muda na final target-conditioned scope mastery. Katika hali linganifu ya \(c_A\), final target mastery iliripotiwa kuwa 0.6263 kwa TEKS na 0.5508 kwa PW-MG; katika grafu ya muunganiko usiolingana, thamani hizo zilikuwa 0.4858 na 0.4215 mtawalia. Hata hivyo, katika mnyororo wa masharti ya awali wa mstari, matokeo ya target-level ya TEKS na PW-MG yalibaki karibu: tofauti ya final target mastery ilikuwa 0.0095 na \(p=0.061\), huku tofauti ya mean target mastery over time ikiwa −0.0009 na \(p=0.728\), na vipindi vyote viwili vya kujiamini vilijumuisha sifuri. Kinyume chake, final scope mastery ilionyesha tofauti ya 0.0271 kwa manufaa ya TEKS.
Kikomo cha tafsiri ya matokeo haya ni muhimu sana. Utafiti haukupima tabia ya wanafunzi halisi. Population initialization, response error, acquisition rates, difficulty na sheria za learning-transition ni vigezo vya uigaji vilivyowekwa mapema na watafiti. Katika majaribio ya baseline, mazingira ya uigaji na learner-state estimator hutumia miundo ileile ya response na transition. Kwa hiyo utafiti hauthibitishi kwamba TEKS huleta ujifunzaji bora katika madarasa halisi; unalinganisha tabia ya kimahesabu ya sheria tofauti za candidate-selection chini ya mawazo yaliyodhibitiwa.
Tatizo kuu la utafiti ni nini?
Katika ujifunzaji unaobadilika, kuangalia tu majibu ya mwanafunzi kwa maswali machache ya mwisho huenda kusiwe na kutosha. Katika maeneo yaliyopangiliwa kimuundo kama hisabati, uhandisi na sayansi ya kompyuta, ili kujifunza kipengele cha maarifa cha juu zaidi ni lazima kwanza masharti fulani ya awali yawe yamepatikana. Hata kama mfumo utachagua kipengele ambacho mwanafunzi ni dhaifu nacho, pendekezo linaweza kuwa la mapema kielimu ikiwa masharti ya awali ya kipengele hicho hayako tayari.
Kinyume chake, mfuatano wa ujifunzaji ulio thabiti kabisa unaweza kuhifadhi mpangilio wa masharti ya awali lakini usiweze kuzingatia tofauti za maarifa ya mwanzo kati ya wanafunzi, kasi ya maendeleo na majibu yaliyoonekana.
Tatizo ambalo utafiti unajaribu kutatua ni kuunganisha mahitaji haya mawili:
- kuzingatia kutokuwa na uhakika katika maarifa ya sasa ya mwanafunzi,
- kutokiuka mahusiano ya masharti ya awali,
- na kuingiza moja kwa moja lengo mahususi la kazi ya sasa katika uteuzi wa kipengele kinachofuata.
Maswali mawili ya utafiti
- Wakati hali ya maarifa ya mwanafunzi haina uhakika, lengo la kazi linawezaje kuingizwa katika mchakato wa next-item selection katika eneo la ujifunzaji lenye muundo wa masharti ya awali?
- Je, sheria hii ya uteuzi unaolenga lengo huzalisha matokeo tofauti ya upangaji wa mfuatano kuliko uteuzi unaobadilika unaotegemea mastery-gap katika miundo tofauti ya masharti ya awali?
TEKS ni Nini na Inaunganisha Vipi Vipengele Vyake Vitatu?
TEKS ni mfumo wa upangaji wa mfuatano unaobadilika wa kitanzi kilichofungwa ambao, kwa kuunganisha grafu inayowakilisha muundo wa masharti ya awali wa eneo la maarifa, seti ya malengo inayofafanua vipengele vya maarifa vinavyolengwa na kazi ya sasa, na usambazaji wa uwezekano juu ya hali fiche zinazowezekana za maarifa ya mwanafunzi, huweka upya alama za wagombea wa kipengele kinachofuata katika kila mwingiliano.
1. Seti ya vipengele vya maarifa
Vipengele vya maarifa katika eneo la ujifunzaji hufafanuliwa kama:
\[ Q=\{q_1,q_2,\ldots,q_n\} \]
.
Hapa \(q_i\) huwakilisha dhana moja au kipengele cha kujifunza; \(n\) ni jumla ya idadi ya vipengele vya maarifa. Hivi si vipimo vyenye vitengo vya kimwili; ni nodi bainifu za maarifa katika modeli.
2. Grafu ya masharti ya awali
Muundo wa maarifa huwakilishwa kwa grafu yenye mwelekeo:
\[ G=(Q,E) \]
Hapa \(E\subseteq Q\times Q\) ni seti ya kingo zenye mwelekeo. Ikiwa kuna ukingo:
\[ q_i\rightarrow q_j \]
basi \(q_i\) ni sharti la awali la moja kwa moja la \(q_j\).
Seti ya masharti ya awali ya moja kwa moja ya kipengele hufafanuliwa kama:
\[ Pre(q_j)=\{q_i\in Q:(q_i,q_j)\in E\} \]
.
3. Hali za maarifa zinazolingana na masharti ya awali
Hali fiche ya maarifa ya mwanafunzi haichukuliwi kuwa seti ndogo yoyote ya nasibu ya vipengele anavyovijua. Ikiwa mwanafunzi anajua kipengele cha juu zaidi, masharti yake ya awali ya moja kwa moja lazima pia yawe katika hali ya maarifa:
\[ \mathcal{K}(G)=\{K\subseteq Q:q_j\in K\Rightarrow Pre(q_j)\subseteq K\} \]
Seti hii ina hali zote za prerequisite-consistent latent knowledge states zinazoruhusiwa na grafu.
Kwa mfano, ikiwa \(q_1\rightarrow q_3\), hali ambayo mwanafunzi anajua \(q_3\) lakini hajui \(q_1\) haitachukuliwa kuwa halali ndani ya \(\mathcal{K}(G)\).
4. Senario au lengo la kazi
Katika utafiti, “scenario” haijaigwa kama simulizi changamani ya kimuktadha. Kila kazi \(c\) huwakilishwa na seti ya vipengele vya maarifa inayolenga:
\[ \phi(c)\subseteq Q \]
\(\phi(c)\) ni lengo la ujifunzaji la kazi \(c\).
Tofauti hii ni muhimu: grafu ya maarifa hutoa muundo wa eneo lote, ilhali \(\phi(c)\) hubainisha tu ni vipengele gani vya maarifa vinavyolengwa katika kazi hiyo.
5. Hali fiche ya mwanafunzi
Hali ya kweli lakini isiyoweza kuonekana moja kwa moja ya maarifa ya mwanafunzi huwakilishwa kwa:
\[ K_{u,t}\in\mathcal{K}(G) \]
.
Hapa:
- \(u\): faharasa ya mwanafunzi,
- \(t\): hatua ya mwingiliano,
- \(K_{u,t}\): seti ya vipengele ambavyo mwanafunzi anachukuliwa kuwa amevimudu kweli wakati huo.
Katika matumizi halisi mfumo hauwezi kuona \(K_{u,t}\) moja kwa moja. Katika uigaji, hidden state inajulikana tu ili mazingira ya uigaji yaweze kuzalisha majibu na mabadiliko ya ujifunzaji.
6. Imani kuhusu hali ya mwanafunzi
Badala ya kufanya uamuzi mmoja kwamba “mwanafunzi anajua mada hizi”, mfumo hubeba usambazaji wa makadirio juu ya hali zote zinazowezekana za maarifa:
\[ \pi_{u,t}^{-}(K)=P(K_{u,t}=K\mid H_{u,t}),\qquad K\in\mathcal{K}(G) \]
\(H_{u,t}\) ni historia ya mwingiliano inayopatikana hadi wakati huo. Alama ya juu “−” inaonyesha hali ya predictive distribution kabla jibu la sasa halijaonekana.
Faida ya usambazaji huu ni kuhifadhi kutokuwa na uhakika. Badala ya kusema “mwanafunzi yuko katika hali hii kwa uhakika”, mfumo unaweza kwa mfano kutoa uwezekano tofauti kwa hali kadhaa zinazofaa za maarifa.
BLIM Inasasishaje Hali ya Maarifa ya Mwanafunzi?
Basic Local Independence Model (BLIM) huunda uhusiano wa kimawezekano kati ya hali fiche ya maarifa ya mwanafunzi na jibu lililoonekana la sahihi/siyo sahihi; hata kama mwanafunzi anajua kipengele anaweza kujibu vibaya kwa sababu ya slip, na hata kama hakijui anaweza kujibu kwa usahihi kwa sababu ya guess, kisha jibu lililoonekana husasisha uwezekano wa hali zote zinazowezekana za maarifa kwa kutumia kanuni ya Bayes.
Kwa nini hali halisi ya mwanzo na imani ya modeli hutenganishwa?
Hali fiche ya mwanzo katika uigaji huchukuliwa sampuli kwa:
\[ K_{u,0}\sim \nu_0^{(c)} \]
.
Hapa:
\[ \nu_0^{(c)}(K)=P(K_{u,0}=K\mid c) \]
ni usambazaji halisi wa mwanzo wa idadi ya watu katika uigaji.
Learner-state estimator, kwa upande mwingine, mwanzoni hutumia usambazaji wa prior:
\[ \pi_{u,0}^{-}(K)=p_0^{(c)}(K) \]
.
Usambazaji wote miwili hunormalishwa juu ya hali halali:
\[ \sum_{K\in\mathcal{K}(G)}\nu_0^{(c)}(K) = \sum_{K\in\mathcal{K}(G)}p_0^{(c)}(K) =1 \]
Katika uigaji wa baseline:
\[ p_0^{(c)}=\nu_0^{(c)} \]
zilioanishwa. Hii ni hali inayofaa kwa estimator. Sehemu ya sensitivity analysis ya utafiti ilibadilisha \(p_0\) kwa prior mismatch huku ikiweka population distribution halisi \(\nu_0\) bila kubadilika.
Uwezekano uliokadiriwa wa umahiri katika kiwango cha nodi
Kutoka katika usambazaji kamili wa uwezekano, uwezekano uliokadiriwa wa umahiri wa kipengele kimoja hutolewa kama ifuatavyo:
\[ \widehat{m}_{u,t,i}^{-} = \sum_{K\in\mathcal{K}(G)} \mathbf{1}(q_i\in K)\pi_{u,t}^{-}(K) \]
Kifanyio cha kiashiria hapa huchukua thamani:
- 1 ikiwa \(q_i\in K\),
- 0 ikiwa sivyo
.
Kwa hiyo jumla huhesabu ni sehemu gani ya wingi wa uwezekano iliyo katika hali ambamo \(q_i\) tayari inajulikana.
Slip na guess
Mwanafunzi hujibu kipengele kilichochaguliwa \(q_{u,t}^{*}\) na matokeo huwakilishwa kama:
\[ r_{u,t}\in\{0,1\} \]
.
\(r=1\) humaanisha jibu sahihi, \(r=0\) jibu lisilo sahihi.
BLIM hufafanua uwezekano wa jibu sahihi kama:
\[ P(r_{u,t}=1\mid K_{u,t},q_{u,t}^{*})= \begin{cases} 1-s, & q_{u,t}^{*}\in K_{u,t}\\ g, & q_{u,t}^{*}\notin K_{u,t} \end{cases} \]
.
Hapa:
- \(s\): slip probability; uwezekano kwamba mwanafunzi atajibu vibaya kwenye kipengele ambacho kwa kweli anakijua.
- \(g\): guess probability; uwezekano kwamba mwanafunzi atajibu kwa usahihi kwenye kipengele ambacho kwa kweli hakijui.
Katika uigaji wa baseline:
- \(s=0.10\),
- \(g=0.20\)
zilitumika.
Kwa hiyo jibu sahihi halimaanishi “mwanafunzi anajua kwa uhakika”, wala jibu lisilo sahihi halimaanishi “mwanafunzi hajui kwa uhakika”.
Sasisho la Bayes
Baada ya jibu kuonekana, uwezekano wa hali za maarifa husasishwa kwa:
\[ \pi_{u,t}^{+}(K) = \frac{ P(r_{u,t}\mid K,q_{u,t}^{*})\pi_{u,t}^{-}(K) }{ \sum_{L\in\mathcal{K}(G)} P(r_{u,t}\mid L,q_{u,t}^{*})\pi_{u,t}^{-}(L) } \]
.
\(\pi^{+}\) ni filtering posterior baada ya jibu kuonekana.
Sehemu ya juu huzidisha vipengele viwili:
- uwezekano wa jibu kuonekana katika hali hiyo ya maarifa,
- uwezekano wa hali hiyo kabla ya jibu.
Sehemu ya chini hunormalisha juu ya hali zote zinazowezekana na kurudisha jumla ya uwezekano wa posterior kuwa 1.
Kiashiria cha utayari wa masharti ya awali
Ikiwa masharti yote ya awali ya moja kwa moja ya \(q_i\) yamejifunzwa katika hali fulani ya maarifa:
\[ R_i(K)=\mathbf{1}[Pre(q_i)\subseteq K] \]
thamani huwa 1.
Kwa root item, kwa kuwa \(Pre(q_i)=\varnothing\), sharti hili hutimizwa kiotomatiki.
Uwezekano wa kujifunza unaotegemea jibu
Ikiwa mwanafunzi bado hajui \(q_i\) na masharti ya awali yako tayari, acquisition probability ni:
\[ \rho_i(r)= \begin{cases} \alpha_c(1-d_i), & r=1\\ \alpha_e(1-d_i), & r=0 \end{cases} \]
.
Hapa:
- \(d_i\in[0,1]\): parameter ya difficulty ya kipengele,
- \(\alpha_c\): base acquisition rate baada ya jibu sahihi,
- \(\alpha_e\): base acquisition rate baada ya jibu lisilo sahihi.
Modeli hutumia dhana:
\[ \alpha_c>\alpha_e \]
.
Baseline:
- \(\alpha_c=0.30\),
- \(\alpha_e=0.10\).
Kwa sababu ya kizidishi \((1-d_i)\), acquisition probability hupungua chini ya jibu lilelile kadiri difficulty inavyoongezeka.
Mabadiliko ya ujifunzaji
Katika chanzo, Equation (16) hufafanua kwa transition kernel kamili jinsi kipengele kilichochaguliwa kinavyoweza kuhamia katika hali mpya fiche ya maarifa.
Mantiki iliyofupishwa ni hii:
- ikiwa kipengele hakijulikani na masharti ya awali yako tayari, kinaweza kuongezwa katika hali ya maarifa kwa uwezekano \(\rho_i(r)\);
- chini ya sharti hilo hilo, hali inaweza kubaki bila kubadilika kwa uwezekano \(1-\rho_i(r)\);
- ikiwa kipengele tayari kinajulikana au prerequisites haziko tayari, hali haibadiliki;
- uwezekano wa mabadiliko mengine ni 0.
Transition hii imefafanuliwa kuwa monotonic: maarifa yaliyopatikana hayapotei katika modeli. Forgetting haikujumuishwa katika uigaji huu.
Katika mazingira ya uigaji hali mpya halisi huchukuliwa sampuli kwa:
\[ K_{u,t+1}\sim T_i^{(r_{u,t})}(K_{u,t},\cdot) \]
.
Learner-state estimator husogeza mbele usambazaji wa posterior kupitia transition kernel ileile kwa:
\[ \pi_{u,t+1}^{-}(K') = \sum_{K\in\mathcal{K}(G)} T_i^{(r_{u,t})}(K,K')\pi_{u,t}^{+}(K) \]
.
Hivyo, mwingiliano mpya unapoanza, mfumo huwa na predictive distribution iliyosasishwa.
TEKS Huchagua Kipengele Kinachofuata kwa Fomula Gani?
TEKS kwanza huunda wigo wa wagombea kupitia lengo la kazi na recursive prerequisites zote, kisha huhesabu kwa kila mgombea uwezekano wa kupatikana upya katika mwingiliano unaofuata, huimarisha uwezekano huo kwa ukaribu wa mwelekeo wa mgombea na lengo kwenye grafu, na huchagua kipengele chenye target-adjusted acquisition score ya juu zaidi.
Wigo wa wagombea unaotegemea lengo
Kwa kazi \(c\), wigo wa wagombea hufafanuliwa kwa:
\[ \Omega(c)=\phi(c)\cup Pre^{*}(\phi(c)) \]
.
\(Pre^{*}\) huwakilisha si tu masharti ya awali ya moja kwa moja ya malengo, bali recursive prerequisite ancestors zote.
Kwa hiyo, badala ya kuchagua kwa nasibu kutoka ulimwengu wote wa \(Q\), mfumo hulenga vipengele vinavyohusiana kimuundo na lengo.
Uwezekano wa upatikanaji kwa hatua moja: Gain
Kiasi cha msingi cha TEKS ni:
\[ Gain_{u,t}(q_i) = \sum_{K\in\mathcal{K}(G)} \pi_{u,t}^{-}(K) \sum_{r\in\{0,1\}} P(r\mid K,q_i) \sum_{K'\in\mathcal{K}(G)} T_i^{(r)}(K,K') \left[ \mathbf{1}(q_i\in K')-\mathbf{1}(q_i\in K) \right] \]
.
Ingawa fomula inaonekana changamani kwa mtazamo wa kwanza, huweka wastani kwa pamoja wa kutokuwa na uhakika wa aina tatu:
- Mwanafunzi anaweza kuwa katika hali gani fiche sasa? — \(\pi^{-}(K)\)
- Anaweza kujibu kwa usahihi au kimakosa kwa kipengele kilichochaguliwa? — \(P(r\mid K,q_i)\)
- Baada ya jibu anaweza kuhamia katika hali gani mpya ya maarifa? — \(T_i^{(r)}(K,K')\)
Mabano ya mwisho ya mraba:
\[ \mathbf{1}(q_i\in K')-\mathbf{1}(q_i\in K) \]
huwa 1 tu wakati \(q_i\) haijulikani katika hali ya sasa lakini imejifunzwa katika hali inayofuata.
Kwa hiyo \(Gain_{u,t}(q_i)\), kama ilivyoelezwa katika chanzo, ni uwezekano uliokadiriwa kwamba kipengele mgombea kitapatikana upya katika mwingiliano unaofuata.
Umbali wenye mwelekeo hadi lengo
Umbali wa mgombea kwenye njia yenye mwelekeo ya prerequisite-to-dependent kuelekea target item ni:
\[ D_c^{tar}(q_i) = \min_{q_g\in\phi(c)} dist_G(q_i,q_g) \]
.
Alama ya ukaribu na lengo hufafanuliwa kama:
\[ Rel_c(q_i)=\frac{1}{1+D_c^{tar}(q_i)} \]
.
Kwa hiyo:
- kwa target item, \(D=0\) na \(Rel=1\),
- kwa prerequisite iliyo ukingo mmoja kutoka kwenye lengo, \(Rel=1/2\),
- kwa umbali wa kingo mbili, \(Rel=1/3\)
.
Mifano hii ni matokeo ya moja kwa moja ya kihisabati ya fomula; si matokeo mapya ya jaribio.
Alama ya utility ya TEKS
Alama ya mwisho ya TEKS ni:
\[ U_{u,t}^{TEKS}(q_i) = Gain_{u,t}(q_i) \left[ 1+\lambda_{rel}Rel_c(q_i) \right] \]
.
\(\lambda_{rel}\geq0\) huamua nguvu ya target relevance adjustment.
Katika utafiti wa baseline:
\[ \lambda_{rel}=1.0 \]
ilitumika.
Wakati \(\lambda_{rel}=0\):
\[ U^{TEKS}=Gain \]
; yaani kizidishi cha relevance kinachotegemea grafu huondolewa na mbinu hubaki kuwa predictive one-step acquisition scoring pekee.
Katika sensitivity analysis, kuendelea kwa tofauti ya TEKS–PW-MG hata chini ya sharti la \(\lambda_{rel}=0\) kunaonyesha kwamba tofauti kati ya TEKS na PW-MG haitokani tu na kizidishi cha relevance; hesabu ya expected-acquisition pia hutoa mchango tofauti. Hata hivyo, chanzo hakitafsiri matokeo haya kuwa \(\lambda_{rel}=1.0\) ni ya kiwango bora.
Sheria ya uteuzi
Kipengele kinachofuata huchaguliwa kwa:
\[ q_{u,t}^{*} = \arg\max_{q_i\in\Omega(c)} U_{u,t}^{TEKS}(q_i) \]
.
Yaani vipengele vyote katika wigo wa wagombea hupewa alama na kile chenye alama ya juu zaidi ya TEKS huchaguliwa.
Iwapo kuna alama sawa, chanzo hufanya tie-breaking kwa kuchagua mgombea mwenye node identifier ndogo zaidi.
Je, TEKS huboresha muda mrefu?
Hapana. TEKS imefafanuliwa wazi katika chanzo kama myopic one-step selection. Katika kila hatua huangalia mwingiliano unaofuata; haiboreshi moja kwa moja siku zijazo zote kwa cumulative reward ya muda mrefu kama reinforcement learning.
Hali hii huongeza uwezekano wa kutafsiri modeli, lakini haimaanishi kwamba njia bora ya muda mrefu ya ujifunzaji imehakikishwa.
Tofauti ya msingi na PW-MG ni nini?
Kwa PW-MG kwanza huhesabiwa uwezekano kwamba prerequisites za moja kwa moja zimejifunzwa:
\[ \widehat{R}_{u,t,i}^{-} = \sum_{K\in\mathcal{K}(G)} \mathbf{1}[Pre(q_i)\subseteq K] \pi_{u,t}^{-}(K) \]
.
Alama ya PW-MG ni:
\[ U_{u,t}^{PW-MG}(q_i) = \left(1-\widehat{m}_{u,t,i}^{-}\right) \widehat{R}_{u,t,i}^{-} \]
.
Hapa:
- \(1-\widehat{m}^{-}\): mastery gap, yaani uwezekano kwamba mgombea bado hajulikani,
- \(\widehat{R}^{-}\): uwezekano kwamba prerequisites ziko tayari.
Kwa hiyo PW-MG hutanguliza wagombea ambao “hawajamilikiwa na masharti yao ya awali yako tayari”.
TEKS badala yake huhesabu uwezekano halisi kwamba mgombea atapokea umahiri katika hatua inayofuata kupitia modeli ya response na transition, kisha hurekebisha kwa graph relevance kuelekea lengo.
Nafasi ya TEKS kati ya mbinu nne za kulinganisha
| Mkakati | Unaobadilika? | Matumizi ya prerequisite | Mantiki ya msingi ya uteuzi |
|---|---|---|---|
| TEKS | Ndiyo | Ndiyo | Predictive one-step acquisition + target relevance |
| PW-MG | Ndiyo | Ndiyo | Mastery gap × prerequisite readiness |
| Static | Hapana | Hutumia mpangilio wa kitopolojia | Ratiba ya kideterministi iliyowekwa mapema |
| Random | Hapana | Haitumii katika alama ya uteuzi | Uteuzi wa uniform random kutoka \(\Omega(c)\) |
Miundo mitatu ya maarifa iliyotumika katika uigaji
Grafu ya matawi linganifu
Katika chanzo, muundo wenye nodi nane una kingo zifuatazo:
\[ E_{sym}= \{ (q_1,q_3),(q_1,q_4),(q_2,q_5),(q_2,q_6), (q_3,q_7),(q_5,q_7),(q_4,q_8),(q_6,q_8) \} \]
Kuna hali mbili za kazi:
\[ \phi(c_A)=\{q_7\} \]
\[ \Omega(c_A)=\{q_1,q_2,q_3,q_5,q_7\} \]
na:
\[ \phi(c_B)=\{q_8\} \]
\[ \Omega(c_B)=\{q_1,q_2,q_4,q_6,q_8\} \]
Hali hizi mbili zina target depth, idadi ya prerequisite na path structure zinazofanana. Kwa hiyo chanzo hutafsiri \(c_A\) na \(c_B\) kwa pamoja kama symmetry check, si kama matokeo mawili huru ya grafu.
Grafu ya muunganiko usiolingana
Muundo wenye nodi sita umefafanuliwa kama:
\[ E_{asym} = \{ (q_1,q_3),(q_3,q_5),(q_2,q_4),(q_5,q_6),(q_4,q_6) \} \]
.
Hapa:
\[ q_1\rightarrow q_3\rightarrow q_5\rightarrow q_6 \]
huunda tawi refu zaidi,
\[ q_2\rightarrow q_4\rightarrow q_6 \]
huunda tawi fupi zaidi.
Lengo na wigo wa wagombea ni:
\[ \phi(c_{asym})=\{q_6\} \]
\[ \Omega(c_{asym})=\{q_1,q_2,q_3,q_4,q_5,q_6\} \]
.
Mnyororo wa masharti ya awali wa mstari
Muundo wa mstari ni:
\[ q_1\rightarrow q_2\rightarrow q_3\rightarrow q_4\rightarrow q_5\rightarrow q_6 \]
.
Hapa lengo ni \(q_6\) na nodi zote sita ziko ndani ya candidate scope.
Kwa sababu hakuna alternative prerequisite branch katika muundo huu, nafasi ambayo mbinu za upangaji wa mfuatano zinaweza kufanya chaguo tofauti ni ndogo sana kuliko katika grafu za matawi.
Difficulty hutolewaje?
Thamani ya difficulty ya nodi imetokana na topological depth:
\[ d_i = 0.2+ 0.6 \frac{depth(q_i)} {\max_{q_j\in Q}depth(q_j)} \]
Kwa source node, kwa kuwa depth=0:
\[ d_i=0.2 \]
.
Kwa nodi iliyo katika kina cha juu zaidi, kwa kuwa uwiano ni 1:
\[ d_i=0.8 \]
hupatikana.
Hivyo, kama ilivyoripotiwa katika chanzo, thamani za difficulty hubadilika katika masafa ya 0.2–0.8.
Nafasi ya hali za masharti ya grafu
| Hali | Lengo | |Ω(c)| | |K(G)| | |K0(c)| |
|---|---|---|---|---|
| Matawi linganifu \(c_A\) | q7 | 5 | 34 | 9 |
| Matawi linganifu \(c_B\) | q8 | 5 | 34 | 9 |
| Muunganiko usiolingana | q6 | 6 | 13 | 12 |
| Mnyororo wa mstari | q6 | 6 | 7 | 6 |
Makundi ya umahiri wa mwanzo
Msaada wa hali ya mwanzo hufafanuliwa kwa:
\[ \mathcal{K}_0(c) = \{ K\in\mathcal{K}(G): K\subseteq\Omega(c),\; \phi(c)\nsubseteq K \} \]
.
Sharti hili hufanya mambo mawili:
- huweka maarifa ya mwanzo ndani ya candidate scope ya kazi;
- huondoa mwanzoni wanafunzi ambao tayari wamejifunza seti yote ya lengo.
Thamani ya mastery proportion ya mwanzo ya hali huhesabiwa kama:
\[ m_0(K)= \frac{|K\cap\Omega(c)|}{|\Omega(c)|} \]
.
Makundi ni:
- Umahiri wa chini: \(m_0(K)<1/3\)
- Umahiri wa kati: \(1/3\leq m_0(K)<2/3\)
- Umahiri wa juu: \(m_0(K)\geq2/3\)
.
Balanced population initial-state distribution hutoa \(1/3\) ya wingi wa jumla wa uwezekano kwa kila moja ya makundi haya matatu ya umahiri na kusambaza wingi huo sawasawa kwa hali halali ndani ya kundi.
Mbinu na Matokeo ya Utafiti
Muundo wa uigaji
| Parameter | Thamani | Maana |
|---|---|---|
| Mwanafunzi pepe / marudio \(N\) | 200 | Idadi ya virtual learner katika kila marudio huru |
| Decision horizon \(T\) | 90 | Hatua ya item-selection/response kwa kila mwanafunzi |
| Marudio huru \(R\) | 30 | Idadi ya sampuli katika kiwango cha marudio kwa ulinganisho wa kitakwimu |
| Slip \(s\) | 0.10 | Uwezekano wa jibu lisilo sahihi kwa kipengele kinachojulikana |
| Guess \(g\) | 0.20 | Uwezekano wa jibu sahihi kwa kipengele kisichojulikana |
| \(\alpha_c\) | 0.30 | Base acquisition rate baada ya jibu sahihi |
| \(\alpha_e\) | 0.10 | Base acquisition rate baada ya jibu lisilo sahihi |
| \(\lambda_{rel}\) | 1.0 | Nguvu ya target relevance adjustment |
| Difficulty | 0.2–0.8 | Masafa yaliyotokana na topological depth |
| Forgetting | Imeondolewa | Mastered item haipotei |
| Early stopping | Hakuna | Wanafunzi wote hukamilisha horizon iliyowekwa |
Nini kilisawazishwa ili kuweka ulinganisho kuwa wa haki?
Mbinu nne zilitumia hali zilezile za:
- initial-state generation,
- response model,
- state-transition mechanism,
- candidate scope,
- interaction budget
.
Kwa kila learner/repetition, hidden initial state ileile ilishirikiwa kati ya mbinu. Kwa paired strategy comparisons, common random numbers zilitumika; kwa graph, repetition, learner na decision step mahususi, mikakati ilishiriki response na acquisition uniform draws zilezile.
Lengo la muundo huu ni kutenganisha kadiri iwezekanavyo tofauti kati ya mbinu na kelele ya sampuli ya nasibu.
Ratiba ya mkakati wa Static
Static baseline hupitia candidate kwanza kwa topological level, kisha kwa mpangilio wa node identifier.
Quota ya msingi huhesabiwa kwa:
\[ \left\lfloor\frac{T}{|\Omega(c)|}\right\rfloor \]
.
Kwa \(T=90\):
- katika hali linganifu, kwa kuwa kuna wagombea 5, kila mgombea huchaguliwa mara 18,
- katika hali za usiolingana na linear, kwa kuwa kuna wagombea 6, kila mgombea huchaguliwa mara 15
.
Vipimo vitatu vya tathmini
1. Final target mastery
\[ M_u^{tar}(T) = \frac{|K_{u,T}\cap\phi(c)|}{|\phi(c)|} \]
Kipimo hiki huonyesha ni kiasi gani cha seti ya lengo kimejifunzwa mwishoni mwa horizon.
Katika utafiti huu target set zote zina kipengele kimoja. Kwa hiyo thamani ya learner-level ni 0 au 1; matokeo ya desimali katika majedwali hutokea baada ya kufupisha wanafunzi 200 na marudio.
2. Mean target mastery over time
\[ \overline{M}_u^{tar} = \frac{1}{T+1} \sum_{t=0}^{T} \frac{|K_{u,t}\cap\phi(c)|}{|\phi(c)|} \]
Thamani hii huzingatia si tu matokeo katika hatua ya 90, bali pia jinsi lengo lilivyofikiwa mapema katika trajectory yote.
Chanzo kinaieleza kama sawa na discrete area under the curve iliyorekebishwa ya target-mastery trajectory.
3. Final scope mastery
\[ M_u^{\Omega}(T) = \frac{|K_{u,T}\cap\Omega(c)|}{|\Omega(c)|} \]
Kipimo hiki hupima kiwango cha ujifunzaji si katika nodi ya lengo pekee, bali katika task-specific scope yote, ikijumuisha prerequisites zinazohusiana na lengo.
Uchambuzi wa kitakwimu ulifanywaje?
Utoaji wa hitimisho la kitakwimu ulifanywa si katika kiwango cha learner, bali katika kiwango cha repetition.
Katika kila repetition, matokeo ya wanafunzi 200 yalipewa wastani kwanza. Hivyo 30 repetition-level mean zilipatikana kwa kila strategy × condition.
Tofauti zilizooanishwa kati ya TEKS na kila baseline zilitathminiwa kwa mantiki ya:
\[ D_r= \text{TEKS}_r-\text{Baseline}_r \]
.
Kwa primary comparisons, two-sided paired t-test ilitumika.
Vipengele vilivyoripotiwa ni:
- mean paired difference,
- %95 t confidence interval,
- paired Cohen's \(d_z\),
- thamani ya p,
- thamani ya Holm-adjusted p kwa primary branching analyses
.
Paired Cohen's dz inaonyesha nini?
Equation (40) ya chanzo ni:
\[ d_z=\frac{\overline{D}}{s_D} \]
.
Hapa:
- \(\overline{D}\): wastani wa paired differences katika marudio 30,
- \(s_D\): sample standard deviation ya paired differences hizo.
\(d_z\) huonyesha tofauti ya wastani iliyoanishwa kati ya TEKS na baseline kwa vitengo vya mkengeuko sanifu wa tofauti hizo.
Ukubwa huu wa athari haupaswi kutafsiriwa kama ukubwa sanifu wa athari ya elimu kwa wanafunzi halisi; katika utafiti huu ni ukubwa wa paired strategy difference kati ya marudio ya uigaji.
Kwa nini marekebisho ya Holm yalitumika?
Katika kila hali ya lengo linganifu, outcome tatu × TEKS–baseline contrast tatu = majaribio tisa. Kwa kuwa kufanya majaribio mengi ya nadharia huongeza uwezekano wa kupata thamani ndogo za p kwa bahati, Holm correction ilitumika kwa thamani za p za paired t-test.
Correction ilifanywa kando kwa \(c_A\) na \(c_B\). Kwa kuwa hali hizi mbili ni structurally isomorphic na zilitumia coupled random streams, matokeo yalitafsiriwa kama symmetry check.
Grafu usiolingana iliunda familia tofauti ya majaribio tisa.
Kwa kuwa linear chain ilikuwa secondary structural analysis, haikujumuishwa katika Holm-adjusted primary family na thamani za p zilitolewa kama unadjusted.
Wilcoxon signed-rank tests ziliripotiwa katika supplement kama unadjusted robustness check.
Matokeo makuu katika grafu ya matawi linganifu
| Mkakati | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.6263 (0.0388) | 0.3235 (0.0267) | 0.8714 (0.0145) |
| PW-MG | 0.5508 (0.0333) | 0.2979 (0.0270) | 0.8161 (0.0160) |
| Static | 0.2847 (0.0415) | 0.0318 (0.0046) | 0.7776 (0.0147) |
| Random | 0.1908 (0.0239) | 0.0913 (0.0137) | 0.7370 (0.0139) |
Matokeo ya paired ya TEKS–PW-MG:
| Kipimo | Tofauti ya wastani | %95 CI | Cohen's dz | Holm-adjusted p |
|---|---|---|---|---|
| Final target mastery | 0.0755 | [0.0641, 0.0869] | 2.48 | 8.39 × 10⁻¹⁴ |
| Mean target mastery over time | 0.0256 | [0.0200, 0.0312] | 1.71 | 2.79 × 10⁻¹⁰ |
| Final scope mastery | 0.0552 | [0.0499, 0.0605] | 3.89 | 8.86 × 10⁻¹⁹ |
Matokeo hayohayo ya TEKS–PW-MG yalipatikana pia kwa \(c_B\).
TEKS na PW-MG zilionyesha target-mastery trajectories zinazokaribiana katika hatua za mwanzo, huku katika sehemu ya baadaye ya upeo wa maamuzi trajectory ya wastani ya TEKS ikiwa juu zaidi.
Kwa kuvutia, TEKS ilitenga %52,31 ya chaguo zake kwa target node, huku PW-MG ikitenga %59,24 kwa target node. Licha ya hilo, TEKS ilitoa matokeo ya juu zaidi katika target mastery.
Chanzo kinaeleza hili hivi: ikiwa sehemu kubwa ya predictive state distribution inahusu hali ambazo target prerequisites bado haziko tayari, hali hizo hutoa mchango wa sifuri katika hesabu ya one-step acquisition gain ya target. Hivyo katika baadhi ya hatua TEKS huelekea kwenye prerequisites ambazo bado hazijajifunzwa badala ya kuchagua lengo moja kwa moja tena.
Matokeo katika grafu ya muunganiko usiolingana
| Mkakati | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.4858 (0.0366) | 0.2157 (0.0187) | 0.8312 (0.0150) |
| PW-MG | 0.4215 (0.0282) | 0.1963 (0.0185) | 0.7770 (0.0173) |
| Static | 0.1598 (0.0254) | 0.0151 (0.0028) | 0.7129 (0.0100) |
| Random | 0.0848 (0.0201) | 0.0360 (0.0092) | 0.6620 (0.0140) |
| Kipimo | Tofauti ya wastani | %95 CI | Cohen's dz | Holm-adjusted p |
|---|---|---|---|---|
| Final target mastery | 0.0643 | [0.0536, 0.0751] | 2.24 | 1.06 × 10⁻¹² |
| Mean target mastery over time | 0.0194 | [0.0142, 0.0247] | 1.37 | 2.72 × 10⁻⁸ |
| Final scope mastery | 0.0542 | [0.0490, 0.0594] | 3.92 | 7.28 × 10⁻¹⁹ |
Katika muundo huu TEKS ilitenga chaguo:
- %39,08 kwa prerequisite branch ndefu,
- %17,62 kwa branch fupi,
- %43,30 kwa target node
.
Thamani zinazolingana kwa PW-MG ziliripotiwa kuwa:
- %38,01 branch ndefu,
- %14,35 branch fupi,
- %47,65 target
.
Je, TEKS ni Bora kuliko PW-MG Pia katika Mnyororo wa Masharti ya Awali wa Mstari?
Kwa vipimo vya target-level, hapana: katika mnyororo wa mstari tofauti ya final target mastery kati ya TEKS na PW-MG ilikuwa 0.0095 na \(p=0.061\), tofauti ya mean target mastery over time ilikuwa −0.0009 na \(p=0.728\), na vipindi vyote viwili vya kujiamini vilijumuisha sifuri; faida iliyo wazi ya TEKS ilionekana katika final scope mastery.
| Mkakati | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.4128 (0.0423) | 0.1939 (0.0224) | 0.7658 (0.0184) |
| PW-MG | 0.4033 (0.0475) | 0.1948 (0.0282) | 0.7388 (0.0225) |
| Static | 0.1338 (0.0282) | 0.0122 (0.0028) | 0.6349 (0.0214) |
| Random | 0.0818 (0.0220) | 0.0417 (0.0129) | 0.5720 (0.0180) |
| Kipimo | Tofauti ya wastani | %95 CI | dz | p |
|---|---|---|---|---|
| Final target mastery | 0.0095 | [−0.0005, 0.0195] | 0.36 | 0.061 |
| Mean target mastery over time | −0.0009 | [−0.0059, 0.0042] | −0.06 | 0.728 |
| Final scope mastery | 0.0271 | [0.0209, 0.0332] | 1.65 | 6.39 × 10⁻¹⁰ |
Thamani hizi za p ni unadjusted kwa secondary linear analysis.
Kulingana na tafsiri ya chanzo, muundo wa mstari huweka kikomo kikubwa kwa chaguo. Wakati hakuna prerequisite branch nyingi zinazoshindana kwa uteuzi, sheria za uteuzi za TEKS na PW-MG hutofautiana kidogo zaidi katika matokeo ya target-level.
Matokeo kulingana na umahiri wa mwanzo
| Kundi | Mkakati | Final target | Mean target | Final scope |
|---|---|---|---|---|
| Chini | TEKS | 0.4006 | 0.1319 | 0.7682 |
| PW-MG | 0.2787 | 0.0884 | 0.6596 | |
| Static | 0.1972 | 0.0219 | 0.6803 | |
| Random | 0.0479 | 0.0106 | 0.5995 | |
| Kati | TEKS | 0.5593 | 0.2295 | 0.8601 |
| PW-MG | 0.4480 | 0.1736 | 0.8000 | |
| Static | 0.2530 | 0.0280 | 0.7683 | |
| Random | 0.1331 | 0.0458 | 0.7309 | |
| Juu | TEKS | 0.9130 | 0.6039 | 0.9826 |
| PW-MG | 0.9188 | 0.6266 | 0.9838 | |
| Static | 0.3998 | 0.0452 | 0.8800 | |
| Random | 0.3876 | 0.2154 | 0.8775 |
Katika kundi la proficiency ya chini, tofauti za TEKS − PW-MG zilikuwa:
- final target mastery: 0.1219,
- mean target mastery: 0.0436,
- final scope mastery: 0.1086.
Katika kundi la kati, tofauti zinazolingana zilikuwa:
- 0.1113,
- 0.0559,
- 0.0601.
Katika kundi la proficiency ya juu, PW-MG ilitoa wastani ulio juu kidogo katika vipimo vyote vitatu; tofauti za TEKS − PW-MG mtawalia zilikuwa:
- −0.0058,
- −0.0227,
- −0.0012
.
Chanzo kinaainisha subgroup comparisons hizi kuwa exploratory and descriptive; hakizitafsiri kama matokeo makuu ya uthibitishaji.
Uchambuzi wa unyeti
One-factor-at-a-time sensitivity analysis ilifanywa tu katika symmetric target condition mbili.
| Kigezo | Baseline | Hali mbadala |
|---|---|---|
| \(\lambda_{rel}\) | 1.0 | 0.0, 0.5, 2.0 |
| Decision horizon \(T\) | 90 | 60, 120 |
| Response noise \((s,g)\) | (0.10, 0.20) | (0.05, 0.10), (0.15, 0.30) |
| Acquisition \((\alpha_c,\alpha_e)\) | (0.30, 0.10) | (0.20, 0.05), (0.40, 0.15) |
| Difficulty function | 0.2 + 0.6h/hmax | 0.1 + 0.5h/hmax; 0.3 + 0.6h/hmax |
| Diagnostic prior | \(p_0=\nu_0\) | uniform juu ya \(\mathcal{K}_0(c)\) |
Katika hali 12 zilizochunguzwa, TEKS − PW-MG mean paired difference ilibadilika katika masafa ya:
- 0.0300–0.1048 kwa final target mastery,
- 0.0033–0.0407 kwa mean target mastery over time,
- 0.0212–0.0878 kwa final scope mastery
.
Katika hali ya slow-acquisition, tofauti ya mean target mastery over time iliripotiwa kuwa 0.0033 na %95 CI [−0.0002, 0.0069]; kipindi cha kujiamini kilijumuisha sifuri.
Tofauti kubwa zaidi ya final-target ilionekana katika sharti la \(\lambda_{rel}=0\). Hii inaonyesha kwamba sehemu ya predictive expected-acquisition huchangia kutofautiana na PW-MG hata bila relevance multiplier. Hata hivyo, haitoi hitimisho kwamba baseline \(\lambda_{rel}=1.0\) ni bora kabisa.
Kwa kuwa uchambuzi ulikuwa one-factor-at-a-time, mwingiliano kati ya response noise, acquisition speed, difficulty, horizon na prior haukuchunguzwa.
Je, Utafiti Huu Unathibitisha Kwamba TEKS Hutoa Ujifunzaji Bora kwa Wanafunzi Halisi?
Hapana. Matokeo yote ya utendaji yalipatikana kutoka kwa wanafunzi pepe wanaofanya kazi chini ya mawazo yaliyowekwa mapema ya learner initialization, response-error, acquisition, difficulty na transition; mwingiliano wa wanafunzi halisi, utekelezaji darasani, udumishaji wa maarifa, uhamishaji wa ujifunzaji au urahisi wa matumizi ya kufundishia haukupimwa katika utafiti huu.
Matokeo yanayoungwa mkono na utafiti
- Mfumo wa kihisabati wa TEKS umefafanuliwa ambao unaunganisha prerequisite constraints, task-specific targets na learner-state uncertainty katika sheria moja ya next-item scoring.
- Katika uigaji uliodhibitiwa wa symmetric branching na asymmetric converging, TEKS ilitoa wastani wa juu zaidi kuliko PW-MG, Static na Random katika vipimo vitatu vikuu vya utendaji.
- Katika miundo ya branching, tofauti za target-level kati ya TEKS na PW-MG zilitenganishwa na sifuri kwa kuzingatia confidence interval.
- Katika linear prerequisite chain, tofauti ya target-level TEKS–PW-MG ilipungua kwa kiasi kikubwa na CI katika vipimo viwili vya target ilijumuisha sifuri.
- TEKS ilitoa matokeo ya juu kuliko PW-MG katika final scope mastery kwenye linear chain.
- Katika makundi ya initial-proficiency ya chini na kati chini ya symmetric condition, wastani wa TEKS ulikuwa juu kuliko PW-MG.
- Katika high-proficiency subgroup, PW-MG ilitoa wastani ulio juu kidogo.
- Ilionekana kwamba tofauti ya TEKS–PW-MG ilikuwa dhahiri zaidi chini ya branching structures.
- Matokeo ya sensitivity analysis yanaonyesha kwamba magnitude ya tofauti ya TEKS–PW-MG hubadilika kulingana na vigezo vya uigaji.
Matokeo ambayo utafiti hauungi mkono
- Haijathibitishwa kwamba TEKS huongeza mafanikio ya ujifunzaji kwa wanafunzi halisi.
- Haiwezi kusemwa kwamba TEKS ni bora kuliko PW-MG katika miundo yote ya prerequisite graph.
- Haijaonyeshwa kwamba \(\lambda_{rel}=1.0\) ndiyo thamani bora.
- Haijathibitishwa kwamba TEKS huzalisha njia bora ya muda mrefu ya ujifunzaji.
- Modeli haiwakilishi forgetting, transfer between unselected items au time-varying acquisition.
- Haijathibitishwa kwamba michakato halisi ya response na learning transition inawakilishwa kikamilifu na BLIM na transition kernel iliyotumika.
- Hakuna runtime halisi au peak memory benchmark iliyoripotiwa katika knowledge graph kubwa.
- Authentic curriculum, engagement, feedback format, cognitive load au time constraint hazijajumuishwa katika alama ya sasa ya uteuzi ya modeli.
- Umuhimu wa kitakwimu katika uigaji si ushahidi wa umuhimu wa kiutendaji/kielimu katika mazingira halisi ya elimu.
Uwezo wa kukua kwa hesabu
Chanzo hufafanua kwa exact implementation:
- \(S=|\mathcal{K}(G)|\): ukubwa wa prerequisite-consistent state-space,
- \(M=|\Omega(c)|\): ukubwa wa task-specific candidate scope
.
Wakati BLIM measurement update na predictive propagation hukua kwa mstari kulingana na active state support, kwa tathmini ya TEKS candidate zote chanzo hutoa uchangamano wa kihafidhina wa full-support:
\[ O(MS) \]
.
Tatizo kuu la uwezo wa kukua si tu kizidisho cha \(O(MS)\); prerequisite-consistent feasible-state enumeration inaweza kukua kwa kiwango cha kielelezo kadiri idadi ya vipengele vya maarifa inavyoongezeka.
Miundo katika utafiti ina:
- symmetric graph: 34 feasible state,
- asymmetric graph: 13 feasible state,
- linear chain: 7 feasible state
.
Chanzo kinasema wazi kwamba hakikuhifadhi vipimo vya kuaminika vya wall-clock runtime au peak-memory kwa original formal runs. Kwa hiyo Verianla haitoi makadirio mapya ya utendaji/muda.
Mapungufu ya msingi
1. Controlled simulation: Hakuna data ya wanafunzi halisi iliyotumika.
2. Model-environment alignment: Katika baseline experiments, learner-state estimator na simulation environment hutumia miundo ileile ya response na transition na diagnostic prior imeoanishwa na population distribution.
3. Limited misspecification: Prior mismatch imechunguzwa lakini kutolingana kwa upana zaidi kwa response au learning process halisi na modeli hakujajaribiwa.
4. DAG ndogo: Directed acyclic graphs ndogo zenye nodi 8 au 6 pekee zimetumika.
5. Singleton targets: Kila condition ina target item moja.
6. Monotonic acquisition: Hakuna Forgetting.
7. Hakuna transfer: Uhamishaji wa ujifunzaji kati ya vipengele visivyochaguliwa haujaigwa.
8. Fixed acquisition parameters: Viwango vya acquisition havibadiliki kwa muda au kwa mwanafunzi.
9. Binary responses: Kila interaction ina kipengele kimoja cha maarifa na binary response.
10. Myopic utility: TEKS haitafuti mpango bora wa long-horizon.
11. Hakuna sifa za kimuktadha: Resource format, feedback type, time constraint, cognitive load na learner engagement haziko katika modeli ya uteuzi.
12. Hakuna benchmark ya kiwango kikubwa: Vipimo vya runtime na peak-memory havijaripotiwa.
13. Maana halisi ya kielimu haijulikani: Haiwezi kuhitimishwa kutokana na utafiti huu kama tofauti katika uigaji zitabadilika kuwa learning gain yenye maana katika ulimwengu halisi.
Mapendekezo ya utafiti wa baadaye
Chanzo kinapendekeza tathmini ya baadaye kupitia:
- prerequisite structures kubwa na tofauti zaidi,
- authentic curriculum graphs kutoka nyanja tofauti za kitaaluma,
- non-singleton target sets,
- multi-skill activities,
- forgetting,
- nonstationary acquisition,
- misspecified response models,
- misspecified transition models,
- approximate au decomposed inference,
- ulinganisho wa multistep planning na reinforcement-learning,
- authentic learner interaction data,
- predictive calibration,
- observed learning outcomes,
- persistence,
- instructional usability
.
Maelezo ya Chanzo na Mbinu
Kichwa asili: A Knowledge–Scenario–Learner Framework for Target-Oriented Adaptive Sequencing: A Simulation-Based Proof-of-Concept Study.
Waandishi: Bingqian Li; Hongwei Guo; Jia Hao; Xiaobei Jiang; Hongwei Niu.
Mpangilio wa waandishi: Mpangilio katika chanzo umehifadhiwa bila kubadilishwa.
Mchango sawa: Hakuna tamko la equal-contribution katika chanzo.
Mwandishi wa mawasiliano: Hongwei Guo.
Taasisi: School of Mechanical Engineering, Beijing Institute of Technology, 5 Zhongguancun South Street, Beijing 100081, China.
Jarida: Education Sciences.
Sehemu: Technology Enhanced Education.
Mchapishaji: MDPI, Basel, Switzerland.
Juzuu / toleo / nambari ya makala: 16(8), 1344.
DOI: 10.3390/educsci16081344.
Kiungo rasmi: https://doi.org/10.3390/educsci16081344
Received: 28 June 2026.
Revised: 15 August 2026.
Accepted: 19 August 2026.
Published: 21 August 2026.
Aina ya chanzo: Article; simulation-based proof-of-concept study.
Mapitio ya kitaaluma: Education Sciences ni jarida la kitaaluma linalopitiwa na wataalamu; utafiti ni makala ya jarida iliyochapishwa.
Preprint: Hakuna toleo tofauti la preprint lililotajwa katika PDF kuu iliyochunguzwa au rekodi rasmi ya uchapishaji.
Leseni: Creative Commons Attribution (CC BY).
Maneno muhimu: adaptive learning; target-oriented sequencing; prerequisite-aware sequencing; learner modeling; educational technology.
Modeli kuu: Triadic Educational Knowledge Space (TEKS).
Modeli ya learner-state response: Basic Local Independence Model (BLIM).
Mbinu za kulinganisha: Prerequisite-Weighted Mastery Gap (PW-MG), Static na Random.
Miundo ya graph: 8-node symmetric branching graph; 6-node asymmetric converging graph; 6-node linear prerequisite chain.
Symmetric target conditions: \(c_A\rightarrow q_7\) na \(c_B\rightarrow q_8\); zilitafsiriwa kama structurally isomorphic symmetry check.
Idadi ya wanafunzi pepe: N=200 kwa kila repetition.
Decision horizon: T=90 interaction steps.
Independent repetitions: R=30.
Slip: s=0.10.
Guess: g=0.20.
Correct-response acquisition rate: \(\alpha_c=0.30\).
Incorrect-response acquisition rate: \(\alpha_e=0.10\).
Target-relevance coefficient: \(\lambda_{rel}=1.0\).
Difficulty range: [0.2, 0.8].
Forgetting: Excluded.
Early stopping: Not applied.
Baseline diagnostic prior: \(p_0^{(c)}=\nu_0^{(c)}\).
Primary performance metrics: final target mastery, mean target mastery over time, final target-conditioned scope mastery.
Uchambuzi wa kitakwimu: Repetition-level paired contrasts; two-sided paired t-tests; %95 t confidence intervals; paired Cohen's \(d_z\); Holm correction kwa primary test families; Wilcoxon signed-rank test kwa supplementary robustness.
Matokeo makuu ya symmetric cA TEKS: final target mastery 0.6263 (SD 0.0388); mean target mastery 0.3235 (0.0267); final scope mastery 0.8714 (0.0145).
Tofauti za Symmetric TEKS–PW-MG: 0.0755; 0.0256; 0.0552. Thamani husika za \(d_z\) ni 2.48, 1.71 na 3.89.
Matokeo makuu ya asymmetric TEKS: 0.4858; 0.2157; 0.8312.
Tofauti za Asymmetric TEKS–PW-MG: 0.0643; 0.0194; 0.0542.
Matokeo ya Linear-chain: Katika vipimo vya final target na mean target, TEKS na PW-MG hazikutengana kwa confidence interval; final scope mastery ilikuwa juu zaidi kwa TEKS.
Matokeo ya Initial-proficiency: Chini ya Symmetric cA exploratory analysis, TEKS ilikuwa juu zaidi katika makundi ya chini na kati; katika kundi la juu PW-MG ilitoa wastani ulio juu kidogo.
Sensitivity: One-factor-at-a-time; tofauti za response noise, acquisition rate, horizon, difficulty, target relevance na diagnostic prior zilichunguzwa. Uchambuzi wa mwingiliano kati ya vigezo haukufanywa.
Uchangamano wa hesabu: Kwa exact implementation, tathmini ya conservative full-support ya TEKS candidates zote ni \(O(MS)\); feasible-state enumeration inaweza kukua kwa kiwango cha kielelezo kadiri idadi ya vipengele vya maarifa inavyoongezeka.
Runtime / peak memory: Kwa kuwa vipimo vya kuaminika havikuhifadhiwa kwa original formal runs, benchmark ya kimajaribio haikuripotiwa.
Supplementary Materials: Chanzo kinaeleza kuwa Supplementary Method S1, Tables S1–S3, Supplementary Method S2, Tables S4–S5, Supplementary Data S1 na S2 zinapatikana. Faili hizi tofauti hazijajumuishwa katika upakiaji wa sasa wa mtumiaji; makala kuu ya Verianla imewekewa mipaka kwa data iliyoripotiwa wazi katika source PDF ya kurasa 29 iliyopakiwa.
Source repository: Development repository haipatikani kwa umma katika hatua ya sasa ya mradi. Waandishi wanaeleza kwamba Supplementary Method S2 hutoa algorithmic na implementation specifications kwa independent reimplementation; Supplementary Data S1/S2 zina matokeo yanayoweza kukaguliwa.
Funding: National Key Research and Development Program of China, grant 2023YFC3305701.
Institutional Review Board Statement: Not applicable.
Data Availability: Development source repository si public; supplement zinasemekana kuwa na machine-readable simulation outputs, configurations, provenance/integrity records, analysis-ready results na figure source data. Additional clarification inaweza kuombwa kutoka kwa corresponding author kwa reasonable request.
Conflicts of Interest: Waandishi wameripoti kutokuwa na mgongano wa maslahi. Mfadhili hakuwa na jukumu katika muundo wa utafiti, uchambuzi wa data, uandishi wa makala au uamuzi wa kuchapisha.
Michango ya waandishi
- Conceptualization: Bingqian Li, Hongwei Guo.
- Methodology: Bingqian Li, Jia Hao.
- Validation: Bingqian Li, Jia Hao, Xiaobei Jiang, Hongwei Niu.
- Formal analysis: Bingqian Li.
- Investigation: Bingqian Li.
- Data curation: Bingqian Li.
- Writing — original draft preparation: Bingqian Li.
- Writing — review and editing: Hongwei Guo, Jia Hao, Hongwei Niu.
- Visualization: Bingqian Li, Xiaobei Jiang.
- Supervision: Hongwei Guo.
- Project administration: Hongwei Guo.
- Funding acquisition: Hongwei Guo.
Mapungufu makuu ya kimbinu: Uigaji uliodhibitiwa na unaotegemea modeli; kutokuwepo kwa data ya wanafunzi halisi; ulinganifu wa karibu wa estimator na environment model katika baseline; jaribio la prior misspecification lililo na mipaka; miundo midogo ya DAG; singleton target set; kutengwa kwa forgetting na cross-item transfer; binary response; parameter za acquisition zisizobadilika; kutokuwepo kwa long-horizon planning; contextual learner/instruction attributes kuachwa nje; kutokuwepo kwa larger-graph runtime na memory benchmark.
Kikomo kikuu cha tafsiri: Utafiti hauthibitishi ufanisi wa TEKS katika mazingira halisi ya elimu. Unatoa ushahidi wa proof-of-concept kwamba, chini ya uigaji uliodhibitiwa, target-adjusted one-step acquisition scoring inaweza kuzalisha tabia tofauti ya sequencing na matokeo ya juu zaidi ya mastery yaliyosimuliwa, hasa katika miundo ya branching ambako prerequisite-related candidate kadhaa hushindana.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *