


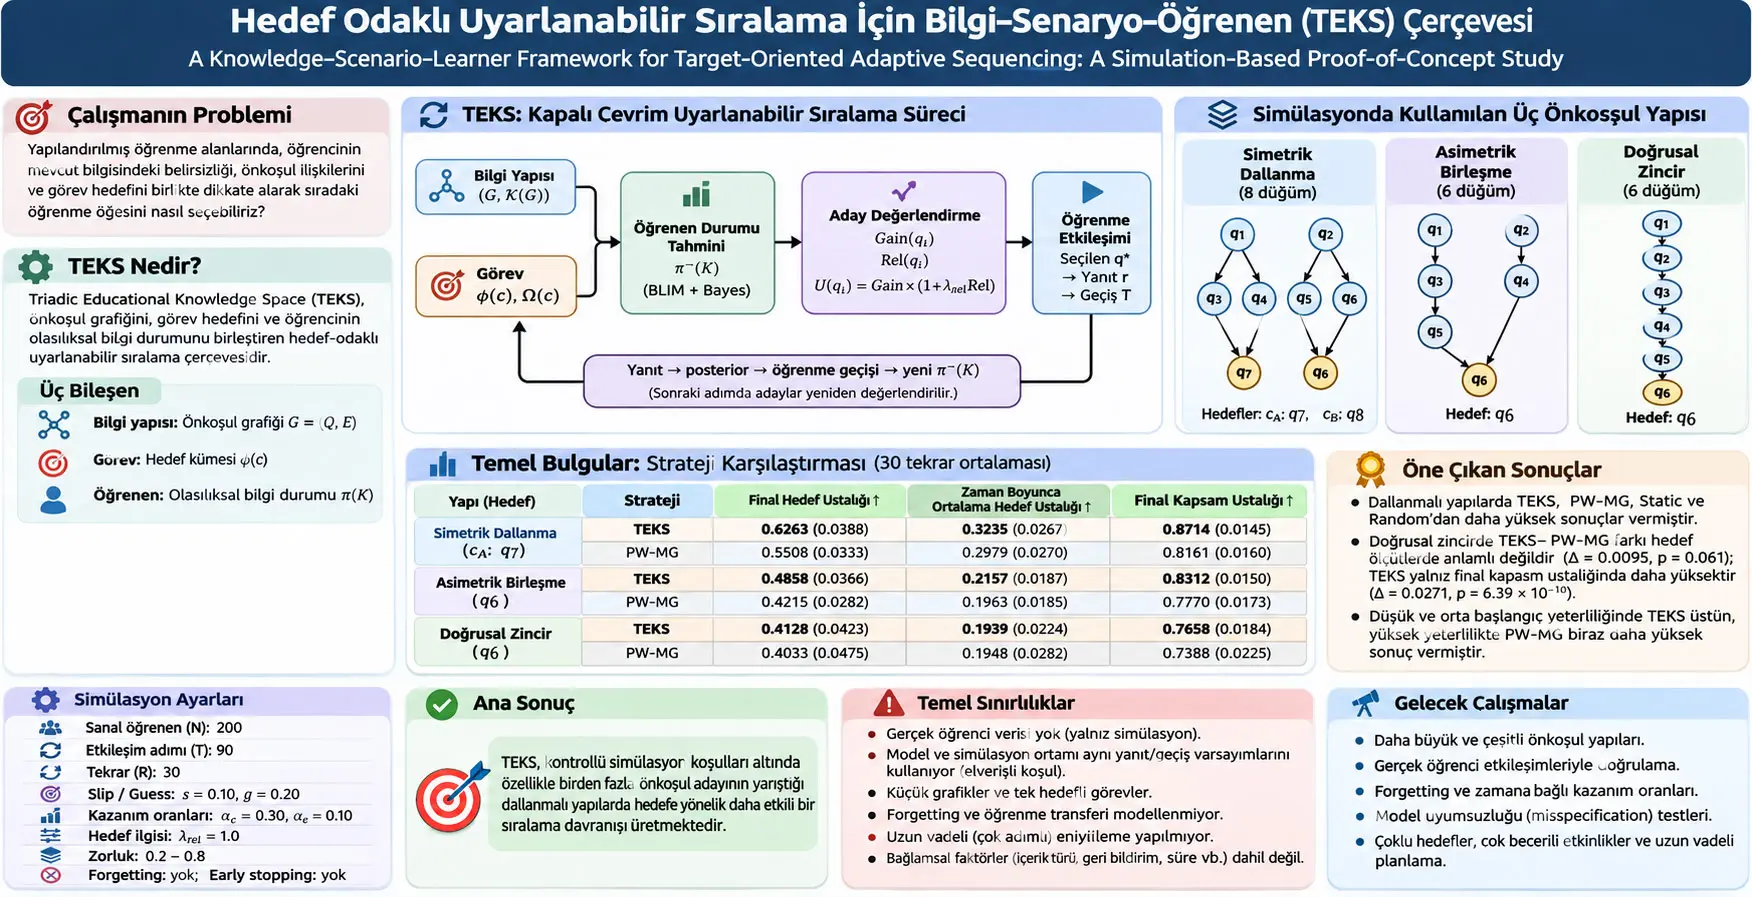
Triadic Educational Knowledge Space (TEKS), yapılandırılmış öğrenme alanlarında bir öğrencinin sırada hangi öğrenme öğesiyle etkileşime girmesi gerektiğini belirlemek için önkoşul grafiğini, göreve özgü hedef kümesini ve öğrencinin doğrudan gözlenemeyen bilgi durumuna ilişkin olasılıksal tahmini birlikte kullanan hedef-odaklı uyarlanabilir sıralama çerçevesidir. Çalışma TEKS'i gerçek öğrenciler üzerinde değil, kontrollü kapalı çevrim simülasyonda değerlendirmiştir. Üç önkoşul yapısı incelenmiştir: sekiz düğümlü simetrik dallanma grafiği, altı düğümlü asimetrik birleşme grafiği ve altı düğümlü doğrusal önkoşul zinciri. Her koşulda 200 sanal öğrenen, 90 etkileşim adımı ve 30 bağımsız tekrar kullanılmış; TEKS, Prerequisite-Weighted Mastery Gap (PW-MG), deterministik Static ve Random stratejileriyle aynı simülasyon koşulları altında karşılaştırılmıştır.
TEKS'in karar mantığı yalnız “öğrenci hangi konuyu bilmiyor?” sorusuna dayanmaz. Her aday bilgi öğesi için önce öğrencinin mevcut belirsiz bilgi durumları, olası doğru/yanlış yanıtlar ve sonraki öğrenme geçişleri üzerinden öğenin bir sonraki etkileşimde yeni kazanılma olasılığı hesaplanır. Bu değer daha sonra aday öğenin görev hedefinden grafik üzerindeki yönlü uzaklığına bağlı target relevance ile ayarlanır. Böylece sistem yalnız eksik olan öğeyi değil, mevcut durumda kazanılması olası ve hedefe yapısal olarak ilgili olan öğeyi önceliklendirmeye çalışır.
Dallanmalı iki ana yapı altında TEKS; final target mastery, zaman boyunca ortalama target mastery ve final target-conditioned scope mastery ölçütlerinde PW-MG, Static ve Random yöntemlerinden daha yüksek sonuçlar vermiştir. Simetrik \(c_A\) koşulunda final target mastery TEKS için 0.6263, PW-MG için 0.5508; asimetrik birleşme grafiğinde ise sırasıyla 0.4858 ve 0.4215 olarak raporlanmıştır. Ancak doğrusal önkoşul zincirinde TEKS ile PW-MG'nin target-level sonuçları birbirine yakın kalmıştır: final target mastery farkı 0.0095 ve \(p=0.061\), mean target mastery over time farkı −0.0009 ve \(p=0.728\) olup güven aralıkları sıfırı içermektedir. Buna karşılık final scope mastery TEKS lehine 0.0271 fark göstermiştir.
Bu sonuçların yorum sınırı çok önemlidir. Çalışma gerçek öğrenci davranışını ölçmemiştir. Population initialization, response error, acquisition rates, difficulty ve learning-transition kuralları araştırmacılar tarafından önceden belirlenmiş simülasyon parametreleridir. Baseline deneylerde simülasyon ortamıyla learner-state estimator aynı response ve transition biçimlerini kullanmaktadır. Bu nedenle çalışma TEKS'in gerçek sınıflarda daha iyi öğrenme sağladığını kanıtlamaz; kontrollü varsayımlar altında farklı candidate-selection kurallarının hesaplamalı davranışını karşılaştırır.
Araştırmanın temel problemi nedir?
Uyarlanabilir öğrenmede yalnız öğrencinin son birkaç soruya verdiği yanıta bakmak yeterli olmayabilir. Matematik, mühendislik ve bilgisayar bilimi gibi yapılandırılmış alanlarda ileri bir bilgi öğesini öğrenebilmek için önce belirli önkoşulların kazanılmış olması gerekir. Bir sistem öğrencinin zayıf olduğu bir öğeyi seçse bile bu öğenin önkoşulları hazır değilse öneri pedagojik olarak erken olabilir.
Tersine, tamamen sabit bir öğrenme sırası önkoşul düzenini koruyabilir fakat öğrenciler arasındaki başlangıç bilgi farkını, ilerleme hızını ve gözlenen yanıtları dikkate alamaz.
Çalışmanın çözmeye çalıştığı problem bu iki gereksinimi birleştirmektir:
- öğrencinin mevcut bilgisindeki belirsizliği hesaba katmak,
- önkoşul ilişkilerini ihlal etmemek,
- ve mevcut görevin belirli hedefini sıradaki öğenin seçimine doğrudan dahil etmek.
Çalışmanın iki araştırma sorusu
- Öğrencinin bilgi durumu belirsizken, önkoşul-yapılı bir öğrenme alanında görev hedefi next-item selection sürecine nasıl dahil edilebilir?
- Bu hedef-odaklı seçim kuralı, farklı önkoşul yapılarında mastery-gap tabanlı uyarlanabilir seçimden farklı sıralama sonuçları üretir mi?
TEKS Nedir ve Üç Bileşeni Nasıl Birleştirir?
TEKS, bilgi alanının önkoşul yapısını temsil eden bir grafik, mevcut görevin ulaşmak istediği bilgi öğelerini tanımlayan hedef kümesi ve öğrencinin olası gizli bilgi durumları üzerindeki olasılık dağılımını bir araya getirerek her etkileşimde sıradaki adayı yeniden puanlayan kapalı çevrim bir uyarlanabilir sıralama çerçevesidir.
1. Bilgi öğeleri kümesi
Öğrenme alanındaki bilgi öğeleri:
\[ Q=\{q_1,q_2,\ldots,q_n\} \]
olarak tanımlanır.
Burada \(q_i\), tek bir kavramı veya öğrenme öğesini; \(n\) ise toplam bilgi öğesi sayısını gösterir. Bunlar fiziksel birim taşıyan nicelikler değildir; modeldeki ayrık bilgi düğümleridir.
2. Önkoşul grafiği
Bilgi yapısı yönlü bir grafikle gösterilir:
\[ G=(Q,E) \]
Burada \(E\subseteq Q\times Q\) yönlü kenarlar kümesidir. Eğer:
\[ q_i\rightarrow q_j \]
kenarı varsa \(q_i\), \(q_j\)'nin doğrudan önkoşuludur.
Bir öğenin doğrudan önkoşul kümesi:
\[ Pre(q_j)=\{q_i\in Q:(q_i,q_j)\in E\} \]
şeklinde tanımlanır.
3. Önkoşullarla tutarlı bilgi durumları
Bir öğrencinin gizli bilgi durumu, bildiği öğelerin herhangi bir rastgele alt kümesi olarak kabul edilmez. Eğer öğrenci bir ileri öğeyi biliyorsa onun doğrudan önkoşullarının da bilgi durumunda bulunması gerekir:
\[ \mathcal{K}(G)=\{K\subseteq Q:q_j\in K\Rightarrow Pre(q_j)\subseteq K\} \]
Bu küme, grafiğe göre izin verilen tüm prerequisite-consistent latent knowledge states durumlarını içerir.
Örneğin \(q_1\rightarrow q_3\) ise öğrencinin \(q_3\)'ü bildiği fakat \(q_1\)'i bilmediği bir durum \(\mathcal{K}(G)\) içinde geçerli sayılmaz.
4. Senaryo veya görev hedefi
Çalışmada “scenario”, karmaşık bağlamsal bir hikâye olarak modellenmez. Her görev \(c\), hedeflediği bilgi öğeleri kümesiyle temsil edilir:
\[ \phi(c)\subseteq Q \]
\(\phi(c)\), görev \(c\)'nin öğrenme hedefidir.
Bu ayrım önemlidir: bilgi grafiği tüm alanın yapısını verirken \(\phi(c)\) yalnız o görevde hangi bilgi öğelerinin hedef olduğunu belirler.
5. Gizli öğrenci durumu
Öğrencinin gerçek fakat doğrudan gözlenemeyen bilgi durumu:
\[ K_{u,t}\in\mathcal{K}(G) \]
ile gösterilir.
Burada:
- \(u\): öğrenen indeksi,
- \(t\): etkileşim adımı,
- \(K_{u,t}\): öğrencinin o anda gerçekten ustalaştığı varsayılan öğeler kümesidir.
Gerçek uygulamada sistem \(K_{u,t}\)'yi doğrudan göremez. Simülasyonda hidden state, yalnız simülasyon ortamının yanıt ve öğrenme geçişi üretmesi için bilinmektedir.
6. Öğrenci durumu hakkındaki inanç
Sistem tek bir “öğrenci şu konuları biliyor” kararı vermek yerine olası bilgi durumlarının tamamı üzerinde bir tahmin dağılımı taşır:
\[ \pi_{u,t}^{-}(K)=P(K_{u,t}=K\mid H_{u,t}),\qquad K\in\mathcal{K}(G) \]
\(H_{u,t}\), o ana kadar mevcut etkileşim geçmişidir. Üst simgedeki “−”, mevcut yanıt henüz gözlenmeden önceki predictive distribution durumunu belirtir.
Bu dağılımın avantajı belirsizliği saklamasıdır. Sistem “öğrenci kesinlikle bu durumda” demek yerine örneğin birkaç uygun bilgi durumuna farklı olasılıklar verebilir.
BLIM Öğrencinin Bilgi Durumunu Nasıl Güncelliyor?
Basic Local Independence Model (BLIM), öğrencinin gizli bilgi durumu ile gözlenen doğru/yanlış yanıt arasında olasılıksal bir bağ kurar; öğrenci bir öğeyi biliyor olsa bile slip nedeniyle yanlış cevap verebilir, bilmiyor olsa bile guess nedeniyle doğru cevap verebilir ve gözlenen yanıt daha sonra Bayes kuralıyla bütün olası bilgi durumlarının olasılıklarını günceller.
Başlangıçta gerçek durum ve model inancı neden ayrı?
Simülasyondaki gizli başlangıç durumu:
\[ K_{u,0}\sim \nu_0^{(c)} \]
ile örneklenir.
Burada:
\[ \nu_0^{(c)}(K)=P(K_{u,0}=K\mid c) \]
simülasyon popülasyonunun gerçek başlangıç dağılımıdır.
Learner-state estimator ise başlangıçta:
\[ \pi_{u,0}^{-}(K)=p_0^{(c)}(K) \]
prior dağılımını kullanır.
Her iki dağılım da geçerli durumlar üzerinde normalize edilir:
\[ \sum_{K\in\mathcal{K}(G)}\nu_0^{(c)}(K) = \sum_{K\in\mathcal{K}(G)}p_0^{(c)}(K) =1 \]
Baseline simülasyonda:
\[ p_0^{(c)}=\nu_0^{(c)} \]
olarak eşleştirilmiştir. Bu durum estimator açısından elverişli bir koşuldur. Çalışmanın sensitivity analysis bölümü prior mismatch için \(p_0\)'ı değiştirirken gerçek population distribution \(\nu_0\)'ı sabit tutmuştur.
Düğüm düzeyinde tahmini ustalık olasılığı
Tam olasılık dağılımından tek bir öğenin tahmini ustalık olasılığı şu şekilde çıkarılır:
\[ \widehat{m}_{u,t,i}^{-} = \sum_{K\in\mathcal{K}(G)} \mathbf{1}(q_i\in K)\pi_{u,t}^{-}(K) \]
Buradaki gösterge fonksiyonu:
- \(q_i\in K\) ise 1,
- değilse 0
değerini alır.
Dolayısıyla toplam, olasılık kütlesinin ne kadarının \(q_i\)'nin zaten bilindiği durumlarda bulunduğunu hesaplar.
Slip ve guess
Öğrenci seçilen \(q_{u,t}^{*}\) öğesine yanıt verir ve sonuç:
\[ r_{u,t}\in\{0,1\} \]
olarak gösterilir.
\(r=1\) doğru, \(r=0\) yanlış yanıtı ifade eder.
BLIM doğru yanıt olasılığını:
\[ P(r_{u,t}=1\mid K_{u,t},q_{u,t}^{*})= \begin{cases} 1-s, & q_{u,t}^{*}\in K_{u,t}\\ g, & q_{u,t}^{*}\notin K_{u,t} \end{cases} \]
biçiminde tanımlar.
Burada:
- \(s\): slip probability; öğrencinin aslında bildiği bir öğede yanlış cevap verme olasılığıdır.
- \(g\): guess probability; öğrencinin aslında bilmediği bir öğede doğru cevap verme olasılığıdır.
Baseline simülasyonda:
- \(s=0.10\),
- \(g=0.20\)
kullanılmıştır.
Bu nedenle doğru yanıt “öğrenci kesin biliyor”, yanlış yanıt da “öğrenci kesin bilmiyor” anlamına gelmez.
Bayes güncellemesi
Yanıt gözlendikten sonra bilgi durumlarının olasılıkları:
\[ \pi_{u,t}^{+}(K) = \frac{ P(r_{u,t}\mid K,q_{u,t}^{*})\pi_{u,t}^{-}(K) }{ \sum_{L\in\mathcal{K}(G)} P(r_{u,t}\mid L,q_{u,t}^{*})\pi_{u,t}^{-}(L) } \]
ile güncellenir.
\(\pi^{+}\), yanıtın gözlenmesinden sonraki filtering posterior'dur.
Pay kısmı iki unsuru çarpar:
- yanıtın o bilgi durumunda gözlenme olasılığı,
- yanıttan önce o durumun olasılığı.
Payda ise bütün olası durumlar üzerinden normalizasyon yapar ve posterior olasılıkların toplamını tekrar 1'e getirir.
Önkoşula hazır olma göstergesi
Bir bilgi durumunda \(q_i\)'nin doğrudan önkoşullarının tamamı öğrenilmişse:
\[ R_i(K)=\mathbf{1}[Pre(q_i)\subseteq K] \]
değeri 1 olur.
Bir root item için \(Pre(q_i)=\varnothing\) olduğundan bu koşul otomatik karşılanır.
Yanıta bağlı öğrenme olasılığı
Öğrenci henüz \(q_i\)'yi bilmiyorsa ve önkoşulları hazırsa acquisition probability:
\[ \rho_i(r)= \begin{cases} \alpha_c(1-d_i), & r=1\\ \alpha_e(1-d_i), & r=0 \end{cases} \]
şeklindedir.
Burada:
- \(d_i\in[0,1]\): öğenin difficulty parametresi,
- \(\alpha_c\): doğru yanıttan sonra temel acquisition rate,
- \(\alpha_e\): yanlış yanıttan sonra temel acquisition rate'tir.
Model:
\[ \alpha_c>\alpha_e \]
varsayımını kullanmaktadır.
Baseline:
- \(\alpha_c=0.30\),
- \(\alpha_e=0.10\).
\((1-d_i)\) çarpanı nedeniyle difficulty yükseldikçe aynı yanıt altında acquisition probability azalır.
Öğrenme geçişi
Kaynakta Equation (16), seçilen öğenin yeni gizli bilgi durumuna nasıl geçebileceğini tam bir transition kernel ile tanımlar.
Özet mantığı şudur:
- öğe bilinmiyor ve önkoşullar hazırsa, \(\rho_i(r)\) olasılığıyla bilgi durumuna eklenebilir;
- aynı koşulda \(1-\rho_i(r)\) olasılığıyla durum değişmeden kalabilir;
- öğe zaten biliniyorsa veya prerequisites hazır değilse durum değişmez;
- başka geçişlerin olasılığı 0'dır.
Bu transition monotonic olarak tanımlanmıştır: kazanılan bilgi modelde kaybolmaz. Forgetting bu simülasyona dahil edilmemiştir.
Simülasyon ortamında yeni gerçek durum:
\[ K_{u,t+1}\sim T_i^{(r_{u,t})}(K_{u,t},\cdot) \]
ile örneklenir.
Learner-state estimator ise posterior dağılımı aynı transition kernel üzerinden:
\[ \pi_{u,t+1}^{-}(K') = \sum_{K\in\mathcal{K}(G)} T_i^{(r_{u,t})}(K,K')\pi_{u,t}^{+}(K) \]
şeklinde ileri taşır.
Böylece yeni etkileşim başladığında sistemin elinde güncellenmiş bir predictive distribution bulunur.
TEKS Sıradaki Öğeyi Hangi Formülle Seçiyor?
TEKS önce görevin hedefi ve tüm recursive prerequisites üzerinden aday kapsamını oluşturur, ardından her aday için bir sonraki etkileşimde yeni öğrenilme olasılığını hesaplar, bu olasılığı hedefe grafik üzerindeki yakınlığıyla güçlendirir ve en yüksek target-adjusted acquisition score'a sahip öğeyi seçer.
Hedefe bağlı aday kapsamı
Görev \(c\) için aday kapsamı:
\[ \Omega(c)=\phi(c)\cup Pre^{*}(\phi(c)) \]
ile tanımlanır.
\(Pre^{*}\), hedeflerin yalnız doğrudan değil, bütün recursive prerequisite ancestors'larını ifade eder.
Bu nedenle sistem bütün \(Q\) evreninden rastgele seçim yapmak yerine hedefle yapısal olarak ilişkili öğelere odaklanır.
Bir adımda kazanım olasılığı: Gain
TEKS'in merkezi niceliği:
\[ Gain_{u,t}(q_i) = \sum_{K\in\mathcal{K}(G)} \pi_{u,t}^{-}(K) \sum_{r\in\{0,1\}} P(r\mid K,q_i) \sum_{K'\in\mathcal{K}(G)} T_i^{(r)}(K,K') \left[ \mathbf{1}(q_i\in K')-\mathbf{1}(q_i\in K) \right] \]
ifadesidir.
Formül ilk bakışta karmaşık görünse de üç belirsizliği birlikte ortalamaktadır:
- Öğrenci şu anda hangi gizli durumda olabilir? — \(\pi^{-}(K)\)
- Seçilen öğeye doğru mu yanlış mı cevap verebilir? — \(P(r\mid K,q_i)\)
- Yanıttan sonra hangi yeni bilgi durumuna geçebilir? — \(T_i^{(r)}(K,K')\)
Son köşeli parantez:
\[ \mathbf{1}(q_i\in K')-\mathbf{1}(q_i\in K) \]
yalnız \(q_i\) mevcut durumda bilinmiyorken sonraki durumda öğrenildiğinde 1 olur.
Dolayısıyla \(Gain_{u,t}(q_i)\), kaynakta açıklandığı biçimiyle aday öğenin bir sonraki etkileşimde yeni kazanılmasının tahmini olasılığıdır.
Hedefe yönlü uzaklık
Bir adayın target item'a yönlü prerequisite-to-dependent yolu boyunca mesafesi:
\[ D_c^{tar}(q_i) = \min_{q_g\in\phi(c)} dist_G(q_i,q_g) \]
şeklindedir.
Hedefe yakınlık skoru:
\[ Rel_c(q_i)=\frac{1}{1+D_c^{tar}(q_i)} \]
olarak tanımlanır.
Sonuç olarak:
- target item için \(D=0\) ve \(Rel=1\),
- hedefe bir kenar uzaktaki prerequisite için \(Rel=1/2\),
- iki kenar uzakta \(Rel=1/3\)
olur.
Bu örnekler doğrudan formülün matematiksel sonucudur; yeni deney bulgusu değildir.
TEKS utility skoru
Son TEKS skoru:
\[ U_{u,t}^{TEKS}(q_i) = Gain_{u,t}(q_i) \left[ 1+\lambda_{rel}Rel_c(q_i) \right] \]
şeklindedir.
\(\lambda_{rel}\geq0\), target relevance adjustment'ın gücünü belirler.
Baseline çalışmada:
\[ \lambda_{rel}=1.0 \]
kullanılmıştır.
\(\lambda_{rel}=0\) olduğunda:
\[ U^{TEKS}=Gain \]
olur; yani grafik-temelli relevance çarpanı devreden çıkar ve yöntem yalnız predictive one-step acquisition scoring haline gelir.
Sensitivity analysis'te \(\lambda_{rel}=0\) koşulunda bile TEKS–PW-MG farkının devam etmesi, TEKS ile PW-MG arasındaki ayrımın yalnız relevance çarpanından gelmediğini; expected-acquisition hesabının da ayrı katkı yaptığını göstermektedir. Ancak kaynak bu bulguyu \(\lambda_{rel}=1.0\)'ın optimal olduğu şeklinde yorumlamamaktadır.
Seçim kuralı
Sıradaki öğe:
\[ q_{u,t}^{*} = \arg\max_{q_i\in\Omega(c)} U_{u,t}^{TEKS}(q_i) \]
ile seçilir.
Yani aday kapsamındaki bütün öğeler puanlanır ve en büyük TEKS skoruna sahip olan seçilir.
Eşit puan oluşursa kaynak, node identifier küçük olan adayı seçerek tie-breaking yapmaktadır.
TEKS uzun vadeyi optimize ediyor mu?
Hayır. TEKS kaynakta açık biçimde myopic one-step selection olarak tanımlanır. Her adımda bir sonraki etkileşime bakar; reinforcement learning gibi uzun dönem cumulative reward için bütün geleceği doğrudan optimize etmez.
Bu durum modelin yorumlanabilirliğini artırırken uzun vadeli optimum öğrenme yolunun garanti edildiği anlamına gelmez.
PW-MG ile temel fark nedir?
PW-MG için önce doğrudan prerequisites'in öğrenilmiş olma olasılığı:
\[ \widehat{R}_{u,t,i}^{-} = \sum_{K\in\mathcal{K}(G)} \mathbf{1}[Pre(q_i)\subseteq K] \pi_{u,t}^{-}(K) \]
hesaplanır.
PW-MG puanı:
\[ U_{u,t}^{PW-MG}(q_i) = \left(1-\widehat{m}_{u,t,i}^{-}\right) \widehat{R}_{u,t,i}^{-} \]
şeklindedir.
Burada:
- \(1-\widehat{m}^{-}\): mastery gap, yani adayın henüz bilinmiyor olma olasılığı,
- \(\widehat{R}^{-}\): prerequisites'in hazır olma olasılığıdır.
PW-MG böylece “eksik ve önkoşulları hazır” adayları öne çıkarır.
TEKS ise bunun yerine adayın gerçekten bir sonraki adımda kazanılma olasılığını response ve transition modeli üzerinden hesaplar ve hedefe olan graph relevance ile ayarlar.
TEKS'in dört karşılaştırma yöntemi içindeki konumu
| Strateji | Uyarlanabilir mi? | Prerequisite kullanımı | Temel seçim mantığı |
|---|---|---|---|
| TEKS | Evet | Evet | Predictive one-step acquisition + target relevance |
| PW-MG | Evet | Evet | Mastery gap × prerequisite readiness |
| Static | Hayır | Topolojik sıra kullanır | Önceden belirlenmiş deterministik program |
| Random | Hayır | Seçim skorunda kullanmaz | \(\Omega(c)\) içinden uniform random seçim |
Simülasyonda kullanılan üç bilgi yapısı
Simetrik dallanma grafiği
Kaynakta sekiz düğümlü yapı şu kenarlardan oluşur:
\[ E_{sym}= \{ (q_1,q_3),(q_1,q_4),(q_2,q_5),(q_2,q_6), (q_3,q_7),(q_5,q_7),(q_4,q_8),(q_6,q_8) \} \]
İki görev koşulu vardır:
\[ \phi(c_A)=\{q_7\} \]
\[ \Omega(c_A)=\{q_1,q_2,q_3,q_5,q_7\} \]
ve:
\[ \phi(c_B)=\{q_8\} \]
\[ \Omega(c_B)=\{q_1,q_2,q_4,q_6,q_8\} \]
Bu iki koşul aynı target depth, prerequisite sayısı ve path structure'a sahiptir. Bu yüzden kaynak \(c_A\) ve \(c_B\)'yi iki bağımsız grafik sonucu gibi değil, symmetry check olarak birlikte yorumlamaktadır.
Asimetrik birleşme grafiği
Altı düğümlü yapı:
\[ E_{asym} = \{ (q_1,q_3),(q_3,q_5),(q_2,q_4),(q_5,q_6),(q_4,q_6) \} \]
olarak tanımlanmıştır.
Burada:
\[ q_1\rightarrow q_3\rightarrow q_5\rightarrow q_6 \]
daha uzun dalı,
\[ q_2\rightarrow q_4\rightarrow q_6 \]
daha kısa dalı oluşturur.
Hedef ve aday kapsamı:
\[ \phi(c_{asym})=\{q_6\} \]
\[ \Omega(c_{asym})=\{q_1,q_2,q_3,q_4,q_5,q_6\} \]
şeklindedir.
Doğrusal önkoşul zinciri
Doğrusal yapı:
\[ q_1\rightarrow q_2\rightarrow q_3\rightarrow q_4\rightarrow q_5\rightarrow q_6 \]
şeklindedir.
Burada hedef \(q_6\)'dır ve bütün altı düğüm candidate scope içindedir.
Bu yapıda alternatif prerequisite branch bulunmadığından sıralama yöntemlerinin farklı seçim yapabileceği alan dallanmalı grafiklere göre çok daha sınırlıdır.
Difficulty nasıl atanıyor?
Düğüm difficulty değeri topological depth'ten türetilmiştir:
\[ d_i = 0.2+ 0.6 \frac{depth(q_i)} {\max_{q_j\in Q}depth(q_j)} \]
Source node'lar için depth=0 olduğundan:
\[ d_i=0.2 \]
olur.
Maksimum derinlikteki düğüm için oran 1 olduğundan:
\[ d_i=0.8 \]
elde edilir.
Böylece difficulty değerleri kaynakta bildirildiği üzere 0.2–0.8 aralığında değişir.
Grafik koşullarının durum uzayı
| Koşul | Hedef | |Ω(c)| | |K(G)| | |K0(c)| |
|---|---|---|---|---|
| Simetrik dallanma \(c_A\) | q7 | 5 | 34 | 9 |
| Simetrik dallanma \(c_B\) | q8 | 5 | 34 | 9 |
| Asimetrik birleşme | q6 | 6 | 13 | 12 |
| Doğrusal zincir | q6 | 6 | 7 | 6 |
Başlangıç yeterlilik grupları
Başlangıç durum desteği:
\[ \mathcal{K}_0(c) = \{ K\in\mathcal{K}(G): K\subseteq\Omega(c),\; \phi(c)\nsubseteq K \} \]
ile tanımlanır.
Bu koşul iki şey yapar:
- başlangıç bilgisini görevin candidate scope'u içinde tutar;
- hedef kümesinin tamamını zaten öğrenmiş öğrencileri başlangıçtan çıkarır.
Bir durumun başlangıç mastery proportion değeri:
\[ m_0(K)= \frac{|K\cap\Omega(c)|}{|\Omega(c)|} \]
olarak hesaplanır.
Gruplar:
- Düşük yeterlilik: \(m_0(K)<1/3\)
- Orta yeterlilik: \(1/3\leq m_0(K)<2/3\)
- Yüksek yeterlilik: \(m_0(K)\geq2/3\)
şeklindedir.
Balanced population initial-state distribution, bu üç yeterlilik grubunun her birine toplam olasılık kütlesinin \(1/3\)'ünü verir ve grup içindeki geçerli durumlara bu kütleyi eşit dağıtır.
Çalışmanın Yöntemi ve Bulguları
Simülasyon tasarımı
| Parametre | Değer | Anlamı |
|---|---|---|
| Sanal öğrenen / tekrar \(N\) | 200 | Her bağımsız tekrardaki virtual learner sayısı |
| Decision horizon \(T\) | 90 | Her öğrenen için item-selection/response adımı |
| Bağımsız tekrar \(R\) | 30 | İstatistiksel karşılaştırmanın tekrar düzeyi örneklem sayısı |
| Slip \(s\) | 0.10 | Bilinen öğede yanlış cevap olasılığı |
| Guess \(g\) | 0.20 | Bilinmeyen öğede doğru cevap olasılığı |
| \(\alpha_c\) | 0.30 | Doğru yanıt sonrası base acquisition rate |
| \(\alpha_e\) | 0.10 | Yanlış yanıt sonrası base acquisition rate |
| \(\lambda_{rel}\) | 1.0 | Target relevance adjustment gücü |
| Difficulty | 0.2–0.8 | Topological depth'ten türetilen aralık |
| Forgetting | Hariç | Mastered item kaybedilmiyor |
| Early stopping | Yok | Bütün öğrenenler sabit horizon'u tamamlıyor |
Karşılaştırmanın adil tutulması için ne eşitlendi?
Dört yöntem aynı:
- initial-state generation,
- response model,
- state-transition mechanism,
- candidate scope,
- interaction budget
koşullarını kullanmıştır.
Her learner/repetition için aynı hidden initial state yöntemler arasında paylaşılmıştır. Paired strategy comparisons için common random numbers kullanılmış; belirli graph, repetition, learner ve decision step için stratejiler aynı response ve acquisition uniform draws'ı paylaşmıştır.
Bu tasarımın amacı yöntemler arası farkı rastgele örnekleme gürültüsünden mümkün olduğunca ayırmaktır.
Static stratejinin programı
Static baseline candidate'ları önce topological level, sonra node identifier sırasına göre dolaşır.
Temel quota:
\[ \left\lfloor\frac{T}{|\Omega(c)|}\right\rfloor \]
olarak hesaplanır.
\(T=90\) için:
- simetrik koşullarda 5 aday bulunduğundan her aday 18 kez,
- asimetrik ve linear koşullarda 6 aday bulunduğundan her aday 15 kez
seçilir.
Üç değerlendirme metriği
1. Final target mastery
\[ M_u^{tar}(T) = \frac{|K_{u,T}\cap\phi(c)|}{|\phi(c)|} \]
Bu metrik horizon sonunda hedef kümesinin ne kadarının öğrenildiğini gösterir.
Bu çalışmada bütün target set'ler tek öğelidir. Dolayısıyla learner-level değer 0 veya 1'dir; tablolardaki ondalıklı sonuçlar 200 öğrenenin ve tekrarların özetlenmesiyle ortaya çıkar.
2. Mean target mastery over time
\[ \overline{M}_u^{tar} = \frac{1}{T+1} \sum_{t=0}^{T} \frac{|K_{u,t}\cap\phi(c)|}{|\phi(c)|} \]
Bu değer yalnız 90. adımdaki sonucu değil, bütün trajectory boyunca hedefe ne kadar erken ulaşıldığını da hesaba katar.
Kaynak bunu target-mastery trajectory'nin normalize edilmiş discrete area under the curve karşılığı olarak açıklamaktadır.
3. Final scope mastery
\[ M_u^{\Omega}(T) = \frac{|K_{u,T}\cap\Omega(c)|}{|\Omega(c)|} \]
Bu metrik yalnız hedef düğümünü değil, hedefe ilişkin prerequisites dahil bütün task-specific scope içindeki öğrenme düzeyini ölçer.
İstatistiksel analiz nasıl yapıldı?
İstatistiksel çıkarım learner düzeyinde değil, repetition düzeyinde yapılmıştır.
Her repetition içinde 200 öğrenenin sonuçları önce ortalanmıştır. Böylece her strategy × condition için 30 repetition-level mean elde edilmiştir.
TEKS ile her baseline arasındaki eşleştirilmiş farklar:
\[ D_r= \text{TEKS}_r-\text{Baseline}_r \]
mantığıyla değerlendirilmiştir.
Primary comparisons için two-sided paired t-test kullanılmıştır.
Raporlanan unsurlar:
- mean paired difference,
- %95 t confidence interval,
- paired Cohen's \(d_z\),
- p değeri,
- primary branching analyses için Holm-adjusted p değeri
şeklindedir.
Paired Cohen's dz neyi gösteriyor?
Kaynağın Equation (40)'ı:
\[ d_z=\frac{\overline{D}}{s_D} \]
şeklindedir.
Burada:
- \(\overline{D}\): 30 tekrardaki paired differences'ın ortalaması,
- \(s_D\): aynı paired differences'ın sample standard deviation değeridir.
\(d_z\), TEKS ile baseline arasındaki ortalama eşleştirilmiş farkı bu farkların standart sapması cinsinden ifade eder.
Bu etki büyüklüğü gerçek öğrencilerde eğitim etkisinin standartlaştırılmış büyüklüğü olarak yorumlanmamalıdır; bu çalışmada simülasyon tekrarları arasındaki paired strategy difference'ın büyüklüğüdür.
Holm düzeltmesi neden kullanıldı?
Her simetrik hedef koşulunda üç outcome × üç TEKS–baseline contrast = dokuz test oluşmaktadır. Çok sayıda hipotez testi yapıldığında tesadüfen küçük p değerleri elde etme olasılığı artabileceği için paired t-test p değerlerine Holm correction uygulanmıştır.
\(c_A\) ve \(c_B\) için correction ayrı ayrı yapılmıştır. İki koşul structurally isomorphic ve coupled random streams kullandığından sonuçlar bir symmetry check olarak yorumlanmıştır.
Asimetrik grafik ayrı dokuz testlik aile oluşturmuştur.
Linear chain ise secondary structural analysis olduğundan Holm-adjusted primary family'ye dahil edilmemiş ve p değerleri unadjusted olarak verilmiştir.
Wilcoxon signed-rank testleri supplementte unadjusted robustness check olarak raporlanmıştır.
Simetrik dallanma grafiğindeki ana sonuçlar
| Strateji | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.6263 (0.0388) | 0.3235 (0.0267) | 0.8714 (0.0145) |
| PW-MG | 0.5508 (0.0333) | 0.2979 (0.0270) | 0.8161 (0.0160) |
| Static | 0.2847 (0.0415) | 0.0318 (0.0046) | 0.7776 (0.0147) |
| Random | 0.1908 (0.0239) | 0.0913 (0.0137) | 0.7370 (0.0139) |
TEKS–PW-MG paired sonuçları:
| Metrik | Ortalama fark | %95 CI | Cohen's dz | Holm-adjusted p |
|---|---|---|---|---|
| Final target mastery | 0.0755 | [0.0641, 0.0869] | 2.48 | 8.39 × 10⁻¹⁴ |
| Mean target mastery over time | 0.0256 | [0.0200, 0.0312] | 1.71 | 2.79 × 10⁻¹⁰ |
| Final scope mastery | 0.0552 | [0.0499, 0.0605] | 3.89 | 8.86 × 10⁻¹⁹ |
Aynı TEKS–PW-MG sonuçları \(c_B\) için de elde edilmiştir.
TEKS ve PW-MG başlangıç adımlarında birbirine yakın target-mastery trajectories göstermiş, karar ufkunun daha sonraki bölümünde TEKS ortalama trajectory'si daha yüksek seyretmiştir.
İlginç biçimde TEKS seçimlerinin %52,31'ini target node'a ayırırken PW-MG %59,24'ünü target node'a ayırmıştır. Buna rağmen TEKS target mastery'de daha yüksek sonuç vermiştir.
Kaynak bunu şöyle açıklar: predictive state distribution'ın önemli bölümü target prerequisites'in henüz hazır olmadığı durumlara aitse, bu durumlar target'ın one-step acquisition gain hesabına sıfır katkı yapar. Böylece TEKS bazı aşamalarda doğrudan hedefi tekrar seçmek yerine henüz öğrenilmemiş prerequisites'e yönelir.
Asimetrik birleşme grafiğindeki sonuçlar
| Strateji | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.4858 (0.0366) | 0.2157 (0.0187) | 0.8312 (0.0150) |
| PW-MG | 0.4215 (0.0282) | 0.1963 (0.0185) | 0.7770 (0.0173) |
| Static | 0.1598 (0.0254) | 0.0151 (0.0028) | 0.7129 (0.0100) |
| Random | 0.0848 (0.0201) | 0.0360 (0.0092) | 0.6620 (0.0140) |
| Metrik | Ortalama fark | %95 CI | Cohen's dz | Holm-adjusted p |
|---|---|---|---|---|
| Final target mastery | 0.0643 | [0.0536, 0.0751] | 2.24 | 1.06 × 10⁻¹² |
| Mean target mastery over time | 0.0194 | [0.0142, 0.0247] | 1.37 | 2.72 × 10⁻⁸ |
| Final scope mastery | 0.0542 | [0.0490, 0.0594] | 3.92 | 7.28 × 10⁻¹⁹ |
TEKS bu yapıda seçimlerin:
- %39,08'ini uzun prerequisite branch'e,
- %17,62'sini kısa branch'e,
- %43,30'unu target node'a
ayırmıştır.
PW-MG için karşılık gelen değerler:
- %38,01 uzun branch,
- %14,35 kısa branch,
- %47,65 target
olarak raporlanmıştır.
TEKS Doğrusal Önkoşul Zincirinde de PW-MG'den Üstün mü?
Target-level ölçütlerde hayır: doğrusal zincirde TEKS ile PW-MG arasındaki final target mastery farkı 0.0095 ve \(p=0.061\), mean target mastery over time farkı −0.0009 ve \(p=0.728\) olup her iki güven aralığı sıfırı içermiştir; TEKS'in açık avantajı final scope mastery'de görülmüştür.
| Strateji | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.4128 (0.0423) | 0.1939 (0.0224) | 0.7658 (0.0184) |
| PW-MG | 0.4033 (0.0475) | 0.1948 (0.0282) | 0.7388 (0.0225) |
| Static | 0.1338 (0.0282) | 0.0122 (0.0028) | 0.6349 (0.0214) |
| Random | 0.0818 (0.0220) | 0.0417 (0.0129) | 0.5720 (0.0180) |
| Metrik | Ortalama fark | %95 CI | dz | p |
|---|---|---|---|---|
| Final target mastery | 0.0095 | [−0.0005, 0.0195] | 0.36 | 0.061 |
| Mean target mastery over time | −0.0009 | [−0.0059, 0.0042] | −0.06 | 0.728 |
| Final scope mastery | 0.0271 | [0.0209, 0.0332] | 1.65 | 6.39 × 10⁻¹⁰ |
Bu p değerleri secondary linear analysis için unadjusted'dır.
Kaynağın yorumuna göre doğrusal yapı seçenekleri güçlü biçimde sınırlar. Birden fazla prerequisite branch seçim için yarışmadığında TEKS ve PW-MG'nin seçim kuralları target-level sonuçlarda daha az ayrışır.
Başlangıç yeterliliğine göre sonuçlar
| Grup | Strateji | Final target | Mean target | Final scope |
|---|---|---|---|---|
| Düşük | TEKS | 0.4006 | 0.1319 | 0.7682 |
| PW-MG | 0.2787 | 0.0884 | 0.6596 | |
| Static | 0.1972 | 0.0219 | 0.6803 | |
| Random | 0.0479 | 0.0106 | 0.5995 | |
| Orta | TEKS | 0.5593 | 0.2295 | 0.8601 |
| PW-MG | 0.4480 | 0.1736 | 0.8000 | |
| Static | 0.2530 | 0.0280 | 0.7683 | |
| Random | 0.1331 | 0.0458 | 0.7309 | |
| Yüksek | TEKS | 0.9130 | 0.6039 | 0.9826 |
| PW-MG | 0.9188 | 0.6266 | 0.9838 | |
| Static | 0.3998 | 0.0452 | 0.8800 | |
| Random | 0.3876 | 0.2154 | 0.8775 |
Düşük proficiency grubunda TEKS − PW-MG farkları:
- final target mastery: 0.1219,
- mean target mastery: 0.0436,
- final scope mastery: 0.1086.
Orta grupta karşılık gelen farklar:
- 0.1113,
- 0.0559,
- 0.0601.
Yüksek proficiency grubunda ise PW-MG üç ölçütte de biraz daha yüksek ortalama vermiştir; TEKS − PW-MG farkları sırasıyla:
- −0.0058,
- −0.0227,
- −0.0012
olmuştur.
Kaynak bu subgroup comparisons'ı exploratory and descriptive olarak sınıflandırır; ana doğrulayıcı sonuç gibi yorumlamaz.
Duyarlılık analizi
One-factor-at-a-time sensitivity analysis yalnız iki symmetric target condition üzerinde yapılmıştır.
| Faktör | Baseline | Alternatif koşullar |
|---|---|---|
| \(\lambda_{rel}\) | 1.0 | 0.0, 0.5, 2.0 |
| Decision horizon \(T\) | 90 | 60, 120 |
| Response noise \((s,g)\) | (0.10, 0.20) | (0.05, 0.10), (0.15, 0.30) |
| Acquisition \((\alpha_c,\alpha_e)\) | (0.30, 0.10) | (0.20, 0.05), (0.40, 0.15) |
| Difficulty function | 0.2 + 0.6h/hmax | 0.1 + 0.5h/hmax; 0.3 + 0.6h/hmax |
| Diagnostic prior | \(p_0=\nu_0\) | \(\mathcal{K}_0(c)\) üzerinde uniform |
İncelenen 12 koşulda TEKS − PW-MG mean paired difference:
- final target mastery için 0.0300–0.1048,
- mean target mastery over time için 0.0033–0.0407,
- final scope mastery için 0.0212–0.0878
aralığında değişmiştir.
Slow-acquisition koşulunda mean target mastery over time farkı 0.0033 ve %95 CI [−0.0002, 0.0069] olarak raporlanmış; güven aralığı sıfırı içermiştir.
En büyük final-target farkı \(\lambda_{rel}=0\) koşulunda görülmüştür. Bu, predictive expected-acquisition bileşeninin PW-MG'den ayrışmaya relevance multiplier olmadan da katkı sağladığını göstermektedir. Ancak baseline \(\lambda_{rel}=1.0\)'ın optimal olduğu sonucunu vermez.
Analiz one-factor-at-a-time olduğundan response noise, acquisition speed, difficulty, horizon ve prior arasındaki etkileşimler araştırılmamıştır.
Bu Çalışma TEKS'in Gerçek Öğrencilerde Daha İyi Öğrenme Sağladığını Kanıtlıyor mu?
Hayır. Bütün performans sonuçları önceden belirlenmiş learner initialization, response-error, acquisition, difficulty ve transition varsayımları altında çalışan sanal öğrenenlerden elde edilmiştir; gerçek öğrenci etkileşimi, sınıf uygulaması, kalıcılık, öğrenme transferi veya öğretimsel kullanılabilirlik bu çalışmada ölçülmemiştir.
Çalışmanın desteklediği sonuçlar
- TEKS'in prerequisite constraints, task-specific targets ve learner-state uncertainty'yi tek bir next-item scoring kuralında birleştiren matematiksel bir çerçevesi tanımlanmıştır.
- Kontrollü symmetric branching ve asymmetric converging simülasyonlarda TEKS üç ana performans metriğinde PW-MG, Static ve Random'dan daha yüksek ortalamalar üretmiştir.
- Branching yapılarda TEKS ile PW-MG arasındaki target-level farklar confidence interval bakımından sıfırdan ayrılmıştır.
- Linear prerequisite chain'de target-level TEKS–PW-MG farkı belirgin biçimde küçülmüş ve iki target metriğinde CI sıfırı içermiştir.
- TEKS linear chain'de final scope mastery açısından PW-MG'den daha yüksek sonuç vermiştir.
- Düşük ve orta initial-proficiency gruplarında symmetric condition altında TEKS ortalamaları PW-MG'den daha yüksek olmuştur.
- Yüksek-proficiency subgroup'ta PW-MG biraz daha yüksek ortalamalar vermiştir.
- TEKS–PW-MG ayrımının branching structures altında daha belirgin olduğu gözlenmiştir.
- Sensitivity analysis sonuçları TEKS–PW-MG farkının magnitude'unun simülasyon parametrelerine göre değiştiğini göstermektedir.
Çalışmanın desteklemediği sonuçlar
- TEKS'in gerçek öğrencilerde öğrenme başarısını artırdığı kanıtlanmamıştır.
- TEKS'in bütün prerequisite graph yapılarında PW-MG'den üstün olduğu söylenemez.
- \(\lambda_{rel}=1.0\)'ın optimal değer olduğu gösterilmemiştir.
- TEKS'in uzun vadeli optimal öğrenme yolu ürettiği kanıtlanmamıştır.
- Model forgetting, transfer between unselected items veya time-varying acquisition'ı temsil etmemektedir.
- Gerçek response ve learning transition süreçlerinin BLIM ve kullanılan transition kernel ile tam olarak temsil edildiği doğrulanmamıştır.
- Büyük knowledge graph'larda gerçek çalışma süresi veya peak memory benchmark'ı raporlanmamıştır.
- Authentic curriculum, engagement, feedback formatı, cognitive load veya time constraint modelin mevcut seçim skoruna dahil edilmemiştir.
- Simülasyondaki istatistiksel anlamlılık gerçek eğitim ortamındaki pratik/öğretimsel anlamlılığın kanıtı değildir.
Hesaplama ölçeklenebilirliği
Kaynak exact implementation için:
- \(S=|\mathcal{K}(G)|\): prerequisite-consistent state-space büyüklüğü,
- \(M=|\Omega(c)|\): task-specific candidate scope büyüklüğü
olarak tanımlar.
BLIM measurement update ve predictive propagation active state support'a göre doğrusal ölçeklenirken bütün TEKS candidate'larının değerlendirilmesi için kaynak muhafazakâr tam-destek karmaşıklığını:
\[ O(MS) \]
olarak vermektedir.
Asıl ölçeklenebilirlik problemi yalnız \(O(MS)\) çarpımı değildir; prerequisite-consistent feasible-state enumeration, bilgi öğesi sayısı büyüdükçe üstel olarak artabilir.
Çalışmadaki yapılar:
- symmetric graph: 34 feasible state,
- asymmetric graph: 13 feasible state,
- linear chain: 7 feasible state
içermektedir.
Kaynak original formal runs için güvenilir wall-clock runtime veya peak-memory ölçümlerini saklamadığını açıkça belirtmektedir. Bu nedenle Verianla yeni performans/süre tahmini üretmez.
Temel sınırlılıklar
1. Controlled simulation: Gerçek öğrenci verisi kullanılmamıştır.
2. Model-environment alignment: Baseline experiments'ta learner-state estimator ile simulation environment aynı response ve transition biçimlerini kullanır ve diagnostic prior population distribution ile eşleştirilmiştir.
3. Sınırlı misspecification: Prior mismatch incelenmiştir fakat gerçek response veya learning process'in modele daha geniş biçimde uymaması test edilmemiştir.
4. Küçük DAG'ler: Yalnız 8 veya 6 düğümlü küçük directed acyclic graphs kullanılmıştır.
5. Singleton targets: Her condition tek target item içermektedir.
6. Monotonic acquisition: Forgetting yoktur.
7. Transfer yok: Seçilmeyen öğeler arasında öğrenme transferi modellenmemiştir.
8. Sabit acquisition parameters: Acquisition oranları zamanla veya öğrenciye göre değişmemektedir.
9. Binary responses: Her interaction yalnız bir bilgi öğesi ve binary response içerir.
10. Myopic utility: TEKS uzun-horizon optimum plan aramamaktadır.
11. Bağlamsal özellikler yok: Resource format, feedback type, time constraint, cognitive load ve learner engagement seçim modelinde yer almamaktadır.
12. Büyük ölçek benchmark yok: Runtime ve peak-memory ölçümü raporlanmamıştır.
13. Gerçek eğitimsel anlam bilinmiyor: Simülasyondaki farkların gerçek dünyada anlamlı learning gain'e dönüşüp dönüşmediği bu çalışmadan çıkarılamaz.
Gelecek çalışma önerileri
Kaynak gelecekte:
- daha büyük ve çeşitli prerequisite structures,
- farklı akademik alanlardan authentic curriculum graphs,
- non-singleton target sets,
- multi-skill activities,
- forgetting,
- nonstationary acquisition,
- misspecified response models,
- misspecified transition models,
- approximate veya decomposed inference,
- multistep planning ve reinforcement-learning karşılaştırmaları,
- authentic learner interaction data,
- predictive calibration,
- observed learning outcomes,
- persistence,
- instructional usability
üzerinden değerlendirme yapılmasını önermektedir.
Kaynak ve Yöntem Notu
Özgün başlık: A Knowledge–Scenario–Learner Framework for Target-Oriented Adaptive Sequencing: A Simulation-Based Proof-of-Concept Study.
Yazarlar: Bingqian Li; Hongwei Guo; Jia Hao; Xiaobei Jiang; Hongwei Niu.
Yazar sırası: Kaynaktaki sıra aynen korunmuştur.
Eş katkı: Kaynakta equal-contribution beyanı bulunmamaktadır.
Sorumlu yazar: Hongwei Guo.
Kurum: School of Mechanical Engineering, Beijing Institute of Technology, 5 Zhongguancun South Street, Beijing 100081, China.
Dergi: Education Sciences.
Bölüm: Technology Enhanced Education.
Yayınevi: MDPI, Basel, Switzerland.
Cilt / sayı / makale numarası: 16(8), 1344.
DOI: 10.3390/educsci16081344.
Resmî bağlantı: https://doi.org/10.3390/educsci16081344
Received: 28 June 2026.
Revised: 15 August 2026.
Accepted: 19 August 2026.
Published: 21 August 2026.
Kaynak türü: Article; simulation-based proof-of-concept study.
Hakemlik: Education Sciences hakemli akademik dergidir; çalışma yayımlanmış dergi makalesidir.
Preprint: İncelenen ana PDF ve resmî yayın kaydında ayrı bir preprint sürümü belirtilmemektedir.
Lisans: Creative Commons Attribution (CC BY).
Anahtar kelimeler: adaptive learning; target-oriented sequencing; prerequisite-aware sequencing; learner modeling; educational technology.
Ana model: Triadic Educational Knowledge Space (TEKS).
Learner-state response modeli: Basic Local Independence Model (BLIM).
Karşılaştırma yöntemleri: Prerequisite-Weighted Mastery Gap (PW-MG), Static ve Random.
Graph yapıları: 8-node symmetric branching graph; 6-node asymmetric converging graph; 6-node linear prerequisite chain.
Simetrik target conditions: \(c_A\rightarrow q_7\) ve \(c_B\rightarrow q_8\); structurally isomorphic symmetry check olarak yorumlanmıştır.
Sanal öğrenen sayısı: Her repetition için N=200.
Decision horizon: T=90 interaction steps.
Independent repetitions: R=30.
Slip: s=0.10.
Guess: g=0.20.
Correct-response acquisition rate: \(\alpha_c=0.30\).
Incorrect-response acquisition rate: \(\alpha_e=0.10\).
Target-relevance coefficient: \(\lambda_{rel}=1.0\).
Difficulty range: [0.2, 0.8].
Forgetting: Excluded.
Early stopping: Not applied.
Baseline diagnostic prior: \(p_0^{(c)}=\nu_0^{(c)}\).
Primary performance metrics: final target mastery, mean target mastery over time, final target-conditioned scope mastery.
İstatistiksel analiz: Repetition-level paired contrasts; two-sided paired t-tests; %95 t confidence intervals; paired Cohen's \(d_z\); primary test families için Holm correction; supplementary robustness için Wilcoxon signed-rank test.
Ana symmetric cA TEKS sonuçları: final target mastery 0.6263 (SD 0.0388); mean target mastery 0.3235 (0.0267); final scope mastery 0.8714 (0.0145).
Symmetric TEKS–PW-MG farkları: 0.0755; 0.0256; 0.0552. İlgili \(d_z\) değerleri 2.48, 1.71 ve 3.89'dur.
Ana asymmetric TEKS sonuçları: 0.4858; 0.2157; 0.8312.
Asymmetric TEKS–PW-MG farkları: 0.0643; 0.0194; 0.0542.
Linear-chain sonucu: final target ve mean target ölçütlerinde TEKS ile PW-MG confidence interval bakımından ayrışmamıştır; final scope mastery TEKS lehine daha yüksektir.
Initial-proficiency sonucu: Symmetric cA exploratory analysis altında düşük ve orta gruplarda TEKS daha yüksek; yüksek grupta PW-MG biraz daha yüksek ortalamalar vermiştir.
Sensitivity: One-factor-at-a-time; response noise, acquisition rate, horizon, difficulty, target relevance ve diagnostic prior varyasyonları incelenmiştir. Faktörler arası etkileşim analizi yapılmamıştır.
Hesaplama karmaşıklığı: Exact implementation için bütün TEKS candidates'ın conservative full-support değerlendirmesi \(O(MS)\); feasible-state enumeration bilgi öğesi sayısı büyüdükçe üstel büyüyebilir.
Runtime / peak memory: Original formal runs için güvenilir ölçümler saklanmadığından ampirik benchmark raporlanmamıştır.
Supplementary Materials: Kaynak Supplementary Method S1, Tables S1–S3, Supplementary Method S2, Tables S4–S5, Supplementary Data S1 ve S2 bulunduğunu belirtmektedir. Bu ayrı dosyalar mevcut kullanıcı yüklemesine dahil değildir; Verianla ana makalesi yüklenen 29 sayfalık source PDF'nin açıkça raporladığı verilerle sınırlıdır.
Source repository: Development repository mevcut proje aşamasında kamuya açık değildir. Yazarlar Supplementary Method S2'nin independent reimplementation için algoritmik ve implementation specifications sağladığını; Supplementary Data S1/S2'nin kontrol edilebilir çıktılar içerdiğini belirtmektedir.
Funding: National Key Research and Development Program of China, grant 2023YFC3305701.
Institutional Review Board Statement: Not applicable.
Data Availability: Development source repository public değildir; supplementlerde machine-readable simulation outputs, configurations, provenance/integrity records, analysis-ready results ve figure source data bulunduğu belirtilmektedir. Additional clarification corresponding author'dan reasonable request ile istenebilir.
Conflicts of Interest: Yazarlar çıkar çatışması olmadığını bildirmiştir. Fon sağlayıcı çalışma tasarımı, veri analizi, makale yazımı veya yayın kararında rol almamıştır.
Yazar katkıları
- Conceptualization: Bingqian Li, Hongwei Guo.
- Methodology: Bingqian Li, Jia Hao.
- Validation: Bingqian Li, Jia Hao, Xiaobei Jiang, Hongwei Niu.
- Formal analysis: Bingqian Li.
- Investigation: Bingqian Li.
- Data curation: Bingqian Li.
- Writing — original draft preparation: Bingqian Li.
- Writing — review and editing: Hongwei Guo, Jia Hao, Hongwei Niu.
- Visualization: Bingqian Li, Xiaobei Jiang.
- Supervision: Hongwei Guo.
- Project administration: Hongwei Guo.
- Funding acquisition: Hongwei Guo.
Temel yöntemsel sınırlılıklar: Kontrollü ve model-tabanlı simülasyon; gerçek öğrenci verisinin bulunmaması; baseline'da estimator ile environment modelinin yakından eşleşmesi; yalnız sınırlı prior misspecification testi; küçük DAG yapıları; singleton target set'ler; forgetting ve cross-item transfer'ın hariç tutulması; binary response; sabit acquisition parametreleri; uzun-horizon planning bulunmaması; contextual learner/instruction attributes'ın dışarıda tutulması; larger-graph runtime ve memory benchmark bulunmaması.
Temel yorum sınırı: Çalışma TEKS'in gerçek eğitim ortamındaki etkililiğini kanıtlamaz. Kontrollü simülasyon altında target-adjusted one-step acquisition scoring'in özellikle birden fazla prerequisite-related adayın rekabet ettiği branching yapılarda farklı sequencing davranışı ve daha yüksek simüle edilmiş mastery sonuçları üretebildiğini gösteren proof-of-concept kanıt sunar.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir