


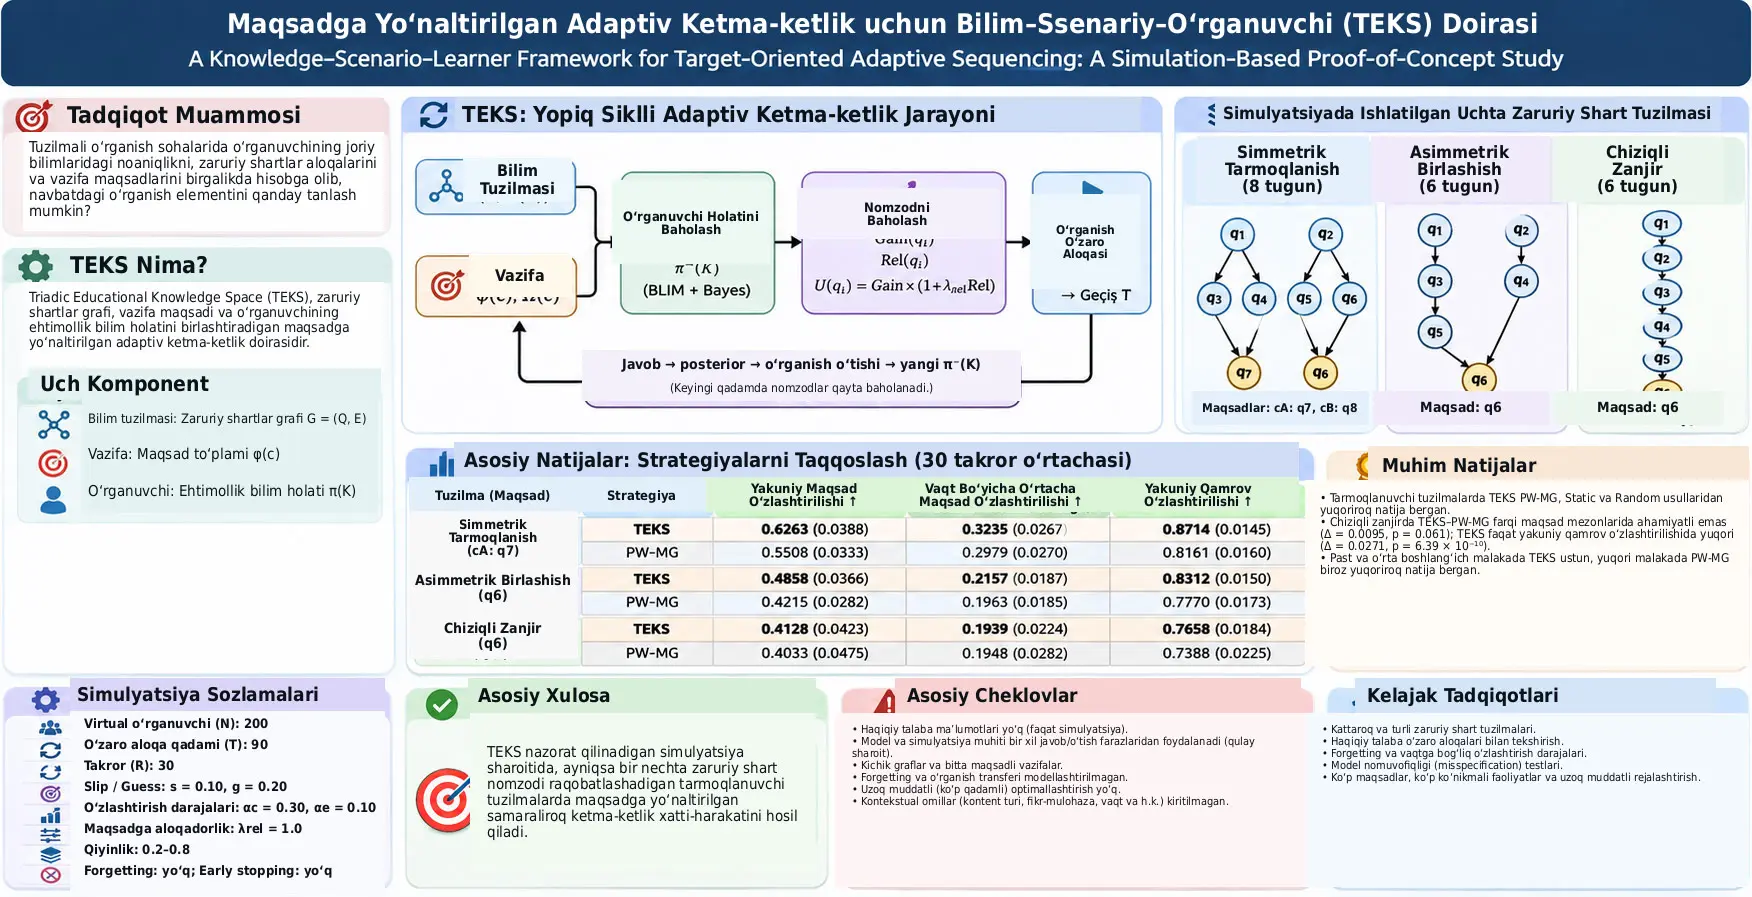
Triadic Educational Knowledge Space (TEKS), tuzilmali o‘rganish sohalarida talaba navbatda qaysi o‘rganish elementi bilan o‘zaro aloqaga kirishishi kerakligini aniqlash uchun zaruriy shartlar grafi, vazifaga xos maqsadlar to‘plami va talabaning bevosita kuzatib bo‘lmaydigan bilim holatiga oid ehtimollik bahosini birgalikda qo‘llaydigan maqsadga yo‘naltirilgan adaptiv ketma-ketlik doirasidir. Tadqiqot TEKSni haqiqiy talabalar bilan emas, nazorat qilinadigan yopiq siklli simulyatsiyada baholagan. Uchta zaruriy shart tuzilmasi o‘rganilgan: sakkiz tugunli simmetrik tarmoqlanish grafi, olti tugunli asimmetrik birlashish grafi va olti tugunli chiziqli zaruriy shart zanjiri. Har bir sharoitda 200 virtual o‘rganuvchi, 90 ta o‘zaro aloqa qadami va 30 ta mustaqil takror ishlatilgan; TEKS bir xil simulyatsiya sharoitlarida Prerequisite-Weighted Mastery Gap (PW-MG), deterministik Static va Random strategiyalari bilan taqqoslangan.
TEKSning qaror mantiqi faqat “talaba qaysi mavzuni bilmaydi?” degan savolga asoslanmaydi. Har bir nomzod bilim elementi uchun avval talabaning mavjud noaniq bilim holatlari, mumkin bo‘lgan to‘g‘ri/noto‘g‘ri javoblar va keyingi o‘rganish o‘tishlari orqali elementning keyingi o‘zaro aloqada yangidan o‘zlashtirilish ehtimoli hisoblanadi. Keyin bu qiymat nomzod elementning vazifa maqsadidan graf bo‘ylab yo‘naltirilgan masofasiga bog‘liq target relevance bilan moslashtiriladi. Shunday qilib, tizim faqat yetishmayotgan elementni emas, balki joriy holatda o‘zlashtirilishi ehtimol bo‘lgan va maqsad bilan tuzilmaviy jihatdan bog‘liq elementni ustuvorlashtirishga harakat qiladi.
Ikki asosiy tarmoqlanuvchi tuzilma ostida TEKS final target mastery, vaqt davomida o‘rtacha target mastery va final target-conditioned scope mastery mezonlarida PW-MG, Static va Random usullaridan yuqoriroq natijalar bergan. Simmetrik \(c_A\) sharoitida final target mastery TEKS uchun 0.6263, PW-MG uchun 0.5508; asimmetrik birlashish grafida esa mos ravishda 0.4858 va 0.4215 deb hisobot qilingan. Biroq chiziqli zaruriy shart zanjirida TEKS va PW-MGning target-level natijalari bir-biriga yaqin bo‘lgan: final target mastery farqi 0.0095 va \(p=0.061\), mean target mastery over time farqi −0.0009 va \(p=0.728\) bo‘lib, ishonch intervallari nolni o‘z ichiga olgan. Aksincha, final scope mastery TEKS foydasiga 0.0271 farq ko‘rsatgan.
Bu natijalarni talqin qilish chegarasi juda muhim. Tadqiqot haqiqiy talaba xatti-harakatini o‘lchamagan. Population initialization, response error, acquisition rates, difficulty va learning-transition qoidalari tadqiqotchilar tomonidan oldindan belgilangan simulyatsiya parametrlaridir. Baseline tajribalarda simulyatsiya muhiti va learner-state estimator bir xil response va transition shakllaridan foydalanadi. Shu sababli tadqiqot TEKS haqiqiy sinflarda yaxshiroq o‘rganishni ta’minlashini isbotlamaydi; nazorat qilinadigan farazlar ostida turli candidate-selection qoidalarining hisoblashdagi xatti-harakatini taqqoslaydi.
Tadqiqotning asosiy muammosi nima?
Adaptiv ta’limda faqat talabaning oxirgi bir necha savolga bergan javoblariga qarash yetarli bo‘lmasligi mumkin. Matematika, muhandislik va kompyuter fanlari kabi tuzilmali sohalarda ilg‘or bilim elementini o‘rganish uchun avval muayyan zaruriy shartlar o‘zlashtirilgan bo‘lishi kerak. Tizim talaba zaif bo‘lgan elementni tanlasa ham, ushbu elementning zaruriy shartlari tayyor bo‘lmasa, tavsiya pedagogik jihatdan erta bo‘lishi mumkin.
Aksincha, butunlay qat’iy o‘rganish ketma-ketligi zaruriy shartlar tartibini saqlashi mumkin, biroq talabalar o‘rtasidagi boshlang‘ich bilim farqini, rivojlanish tezligini va kuzatilgan javoblarni hisobga ololmaydi.
Tadqiqot hal qilishga urinayotgan muammo ushbu ikki ehtiyojni birlashtirishdir:
- talabaning joriy bilimlaridagi noaniqlikni hisobga olish,
- zaruriy shart munosabatlarini buzmaslik,
- va joriy vazifaning muayyan maqsadini navbatdagi element tanloviga bevosita kiritish.
Tadqiqotning ikki tadqiqot savoli
- Talabaning bilim holati noaniq bo‘lganda, zaruriy shartlarga tuzilgan o‘rganish sohasida vazifa maqsadi next-item selection jarayoniga qanday kiritilishi mumkin?
- Ushbu maqsadga yo‘naltirilgan tanlov qoidasi turli zaruriy shart tuzilmalarida mastery-gap asosidagi adaptiv tanlovdan farqli ketma-ketlik natijalarini hosil qiladimi?
TEKS Nima va Uch Komponentni Qanday Birlashtiradi?
TEKS bilim sohasining zaruriy shart tuzilmasini ifodalovchi graf, joriy vazifa erishishni ko‘zlagan bilim elementlarini belgilovchi maqsadlar to‘plami va talabaning mumkin bo‘lgan yashirin bilim holatlari ustidagi ehtimollik taqsimotini birlashtirib, har bir o‘zaro aloqada navbatdagi nomzodni qayta baholaydigan yopiq siklli adaptiv ketma-ketlik doirasidir.
1. Bilim elementlari to‘plami
O‘rganish sohasidagi bilim elementlari:
\[ Q=\{q_1,q_2,\ldots,q_n\} \]
deb belgilanadi.
Bu yerda \(q_i\) bitta tushuncha yoki o‘rganish elementini, \(n\) esa bilim elementlarining umumiy sonini bildiradi. Bular fizik birlikka ega kattaliklar emas; modeldagi diskret bilim tugunlaridir.
2. Zaruriy shartlar grafi
Bilim tuzilmasi yo‘naltirilgan graf bilan ko‘rsatiladi:
\[ G=(Q,E) \]
Bu yerda \(E\subseteq Q\times Q\) yo‘naltirilgan qirralar to‘plamidir. Agar:
\[ q_i\rightarrow q_j \]
qirrasi mavjud bo‘lsa, \(q_i\), \(q_j\)ning bevosita zaruriy shartidir.
Elementning bevosita zaruriy shartlari to‘plami:
\[ Pre(q_j)=\{q_i\in Q:(q_i,q_j)\in E\} \]
ko‘rinishida belgilanadi.
3. Zaruriy shartlarga mos bilim holatlari
Talabaning yashirin bilim holati u biladigan elementlarning istalgan tasodifiy kichik to‘plami deb qabul qilinmaydi. Agar talaba ilg‘orroq elementni bilsa, uning bevosita zaruriy shartlari ham bilim holatida mavjud bo‘lishi kerak:
\[ \mathcal{K}(G)=\{K\subseteq Q:q_j\in K\Rightarrow Pre(q_j)\subseteq K\} \]
Ushbu to‘plam grafga ko‘ra ruxsat etilgan barcha prerequisite-consistent latent knowledge states holatlarini o‘z ichiga oladi.
Masalan, \(q_1\rightarrow q_3\) bo‘lsa, talaba \(q_3\)ni bilib, \(q_1\)ni bilmaydigan holat \(\mathcal{K}(G)\) ichida yaroqli hisoblanmaydi.
4. Ssenariy yoki vazifa maqsadi
Tadqiqotda “scenario” murakkab kontekstual hikoya sifatida modellashtirilmaydi. Har bir vazifa \(c\) maqsad qilgan bilim elementlari to‘plami bilan ifodalanadi:
\[ \phi(c)\subseteq Q \]
\(\phi(c)\), vazifa \(c\)ning o‘rganish maqsadidir.
Bu farq muhim: bilim grafi butun sohaning tuzilishini bersa, \(\phi(c)\) faqat shu vazifada qaysi bilim elementlari maqsad ekanini belgilaydi.
5. Yashirin talaba holati
Talabaning haqiqiy, ammo bevosita kuzatib bo‘lmaydigan bilim holati:
\[ K_{u,t}\in\mathcal{K}(G) \]
bilan ko‘rsatiladi.
Bu yerda:
- \(u\): o‘rganuvchi indeksi,
- \(t\): o‘zaro aloqa qadami,
- \(K_{u,t}\): talabaning shu paytda haqiqatda o‘zlashtirgan deb faraz qilinadigan elementlar to‘plami.
Haqiqiy amaliyotda tizim \(K_{u,t}\)ni bevosita ko‘ra olmaydi. Simulyatsiyada hidden state faqat simulyatsiya muhiti javob va o‘rganish o‘tishini hosil qilishi uchun ma’lum.
6. Talaba holati haqidagi ishonch
Tizim bitta “talaba mana shu mavzularni biladi” qarorini berish o‘rniga barcha mumkin bo‘lgan bilim holatlari ustida baholash taqsimotini saqlaydi:
\[ \pi_{u,t}^{-}(K)=P(K_{u,t}=K\mid H_{u,t}),\qquad K\in\mathcal{K}(G) \]
\(H_{u,t}\), shu paytgacha mavjud o‘zaro aloqa tarixidir. Yuqori indeksdagi “−” joriy javob hali kuzatilishidan oldingi predictive distribution holatini bildiradi.
Bu taqsimotning afzalligi noaniqlikni saqlashidir. Tizim “talaba aynan shu holatda” demasdan, masalan, bir nechta mos bilim holatiga turlicha ehtimollar berishi mumkin.
BLIM Talabaning Bilim Holatini Qanday Yangilaydi?
Basic Local Independence Model (BLIM) talabaning yashirin bilim holati bilan kuzatilgan to‘g‘ri/noto‘g‘ri javob o‘rtasida ehtimollik bog‘lanishini o‘rnatadi; talaba elementni bilsa ham slip sabab noto‘g‘ri javob berishi, bilmasa ham guess sabab to‘g‘ri javob berishi mumkin va kuzatilgan javob keyin Bayes qoidasi orqali barcha mumkin bo‘lgan bilim holatlarining ehtimollarini yangilaydi.
Boshlanishida haqiqiy holat va model ishonchi nega alohida?
Simulyatsiyadagi yashirin boshlang‘ich holat:
\[ K_{u,0}\sim \nu_0^{(c)} \]
bilan tanlanadi.
Bu yerda:
\[ \nu_0^{(c)}(K)=P(K_{u,0}=K\mid c) \]
simulyatsiya populyatsiyasining haqiqiy boshlang‘ich taqsimotidir.
Learner-state estimator esa boshlanishida:
\[ \pi_{u,0}^{-}(K)=p_0^{(c)}(K) \]
prior taqsimotidan foydalanadi.
Har ikki taqsimot ham yaroqli holatlar ustida normallashtiriladi:
\[ \sum_{K\in\mathcal{K}(G)}\nu_0^{(c)}(K) = \sum_{K\in\mathcal{K}(G)}p_0^{(c)}(K) =1 \]
Baseline simulyatsiyada:
\[ p_0^{(c)}=\nu_0^{(c)} \]
ko‘rinishida moslashtirilgan. Bu estimator nuqtai nazaridan qulay sharoitdir. Tadqiqotning sensitivity analysis bo‘limi prior mismatch uchun \(p_0\)ni o‘zgartirgan holda haqiqiy population distribution \(\nu_0\)ni o‘zgarmas saqlagan.
Tugun darajasida taxminiy o‘zlashtirish ehtimoli
To‘liq ehtimollik taqsimotidan bitta elementning taxminiy o‘zlashtirish ehtimoli quyidagicha olinadi:
\[ \widehat{m}_{u,t,i}^{-} = \sum_{K\in\mathcal{K}(G)} \mathbf{1}(q_i\in K)\pi_{u,t}^{-}(K) \]
Bu yerdagi indikator funksiya:
- \(q_i\in K\) bo‘lsa 1,
- aks holda 0
qiymatini oladi.
Demak, yig‘indi ehtimollik massasining qanchasi \(q_i\) allaqachon ma’lum bo‘lgan holatlarda joylashganini hisoblaydi.
Slip va guess
Talaba tanlangan \(q_{u,t}^{*}\) elementiga javob beradi va natija:
\[ r_{u,t}\in\{0,1\} \]
bilan ko‘rsatiladi.
\(r=1\) to‘g‘ri, \(r=0\) noto‘g‘ri javobni anglatadi.
BLIM to‘g‘ri javob ehtimolini:
\[ P(r_{u,t}=1\mid K_{u,t},q_{u,t}^{*})= \begin{cases} 1-s, & q_{u,t}^{*}\in K_{u,t}\\ g, & q_{u,t}^{*}\notin K_{u,t} \end{cases} \]
ko‘rinishida belgilaydi.
Bu yerda:
- \(s\): slip probability; talabaning aslida biladigan elementga noto‘g‘ri javob berish ehtimoli.
- \(g\): guess probability; talabaning aslida bilmaydigan elementga to‘g‘ri javob berish ehtimoli.
Baseline simulyatsiyada:
- \(s=0.10\),
- \(g=0.20\)
ishlatilgan.
Shuning uchun to‘g‘ri javob “talaba albatta biladi”, noto‘g‘ri javob esa “talaba albatta bilmaydi” degani emas.
Bayes yangilanishi
Javob kuzatilgandan keyin bilim holatlarining ehtimollari:
\[ \pi_{u,t}^{+}(K) = \frac{ P(r_{u,t}\mid K,q_{u,t}^{*})\pi_{u,t}^{-}(K) }{ \sum_{L\in\mathcal{K}(G)} P(r_{u,t}\mid L,q_{u,t}^{*})\pi_{u,t}^{-}(L) } \]
bilan yangilanadi.
\(\pi^{+}\), javob kuzatilgandan keyingi filtering posterior hisoblanadi.
Surat qismi ikki unsurni ko‘paytiradi:
- javobning shu bilim holatida kuzatilish ehtimoli,
- javobdan oldin shu holatning ehtimoli.
Maxraj esa barcha mumkin bo‘lgan holatlar bo‘yicha normallashtiradi va posterior ehtimollar yig‘indisini yana 1 ga keltiradi.
Zaruriy shartlarga tayyorlik ko‘rsatkichi
Bilim holatida \(q_i\)ning barcha bevosita zaruriy shartlari o‘zlashtirilgan bo‘lsa:
\[ R_i(K)=\mathbf{1}[Pre(q_i)\subseteq K] \]
qiymati 1 bo‘ladi.
Root item uchun \(Pre(q_i)=\varnothing\) bo‘lganligi sababli bu shart avtomatik bajariladi.
Javobga bog‘liq o‘rganish ehtimoli
Talaba hali \(q_i\)ni bilmasa va zaruriy shartlar tayyor bo‘lsa acquisition probability:
\[ \rho_i(r)= \begin{cases} \alpha_c(1-d_i), & r=1\\ \alpha_e(1-d_i), & r=0 \end{cases} \]
ko‘rinishidadir.
Bu yerda:
- \(d_i\in[0,1]\): elementning difficulty parametri,
- \(\alpha_c\): to‘g‘ri javobdan keyingi asosiy acquisition rate,
- \(\alpha_e\): noto‘g‘ri javobdan keyingi asosiy acquisition rate.
Model:
\[ \alpha_c>\alpha_e \]
farazidan foydalanadi.
Baseline:
- \(\alpha_c=0.30\),
- \(\alpha_e=0.10\).
\((1-d_i)\) ko‘paytuvchisi sabab difficulty oshgani sari bir xil javob ostida acquisition probability kamayadi.
O‘rganish o‘tishi
Manbadagi Equation (16) tanlangan element yangi yashirin bilim holatiga qanday o‘tishi mumkinligini to‘liq transition kernel bilan belgilaydi.
Qisqacha mantiq quyidagicha:
- element noma’lum va zaruriy shartlar tayyor bo‘lsa, \(\rho_i(r)\) ehtimoli bilan bilim holatiga qo‘shilishi mumkin;
- xuddi shu sharoitda \(1-\rho_i(r)\) ehtimoli bilan holat o‘zgarmay qolishi mumkin;
- element allaqachon ma’lum bo‘lsa yoki prerequisites tayyor bo‘lmasa, holat o‘zgarmaydi;
- boshqa o‘tishlarning ehtimoli 0.
Ushbu transition monotonic deb belgilangan: o‘zlashtirilgan bilim modelda yo‘qolmaydi. Forgetting bu simulyatsiyaga kiritilmagan.
Simulyatsiya muhitida yangi haqiqiy holat:
\[ K_{u,t+1}\sim T_i^{(r_{u,t})}(K_{u,t},\cdot) \]
bilan tanlanadi.
Learner-state estimator esa posterior taqsimotni ayni transition kernel orqali:
\[ \pi_{u,t+1}^{-}(K') = \sum_{K\in\mathcal{K}(G)} T_i^{(r_{u,t})}(K,K')\pi_{u,t}^{+}(K) \]
ko‘rinishida oldinga o‘tkazadi.
Shunday qilib, yangi o‘zaro aloqa boshlanganda tizimda yangilangan predictive distribution mavjud bo‘ladi.
TEKS Navbatdagi Elementni Qaysi Formula Bilan Tanlaydi?
TEKS avval vazifa maqsadi va barcha recursive prerequisites orqali nomzod qamrovini yaratadi, so‘ng har bir nomzod uchun keyingi o‘zaro aloqada yangidan o‘zlashtirilish ehtimolini hisoblaydi, ushbu ehtimolni graf bo‘ylab maqsadga yaqinlik bilan kuchaytiradi va eng yuqori target-adjusted acquisition score ga ega elementni tanlaydi.
Maqsadga bog‘liq nomzod qamrovi
Vazifa \(c\) uchun nomzod qamrovi:
\[ \Omega(c)=\phi(c)\cup Pre^{*}(\phi(c)) \]
bilan belgilanadi.
\(Pre^{*}\), maqsadlarning nafaqat bevosita, balki barcha recursive prerequisite ancestors larini ifodalaydi.
Shu sababli tizim butun \(Q\) olamidan tasodifiy tanlash o‘rniga maqsad bilan tuzilmaviy jihatdan bog‘liq elementlarga e’tibor qaratadi.
Bir qadamda o‘zlashtirish ehtimoli: Gain
TEKSning markaziy miqdori:
\[ Gain_{u,t}(q_i) = \sum_{K\in\mathcal{K}(G)} \pi_{u,t}^{-}(K) \sum_{r\in\{0,1\}} P(r\mid K,q_i) \sum_{K'\in\mathcal{K}(G)} T_i^{(r)}(K,K') \left[ \mathbf{1}(q_i\in K')-\mathbf{1}(q_i\in K) \right] \]
ifodasidir.
Formula bir qarashda murakkab ko‘rinsa-da, uchta noaniqlikni birgalikda o‘rtachalaydi:
- Talaba hozir qaysi yashirin holatda bo‘lishi mumkin? — \(\pi^{-}(K)\)
- Tanlangan elementga to‘g‘ri yoki noto‘g‘ri javob berishi mumkinmi? — \(P(r\mid K,q_i)\)
- Javobdan keyin qaysi yangi bilim holatiga o‘tishi mumkin? — \(T_i^{(r)}(K,K')\)
Oxirgi kvadrat qavs:
\[ \mathbf{1}(q_i\in K')-\mathbf{1}(q_i\in K) \]
faqat \(q_i\) joriy holatda noma’lum bo‘lib, keyingi holatda o‘zlashtirilganda 1 bo‘ladi.
Demak, \(Gain_{u,t}(q_i)\), manbada tushuntirilganidek, nomzod elementning keyingi o‘zaro aloqada yangidan o‘zlashtirilishining taxminiy ehtimolidir.
Maqsadgacha yo‘naltirilgan masofa
Nomzodning target item ga yo‘naltirilgan prerequisite-to-dependent yo‘li bo‘ylab masofasi:
\[ D_c^{tar}(q_i) = \min_{q_g\in\phi(c)} dist_G(q_i,q_g) \]
ko‘rinishidadir.
Maqsadga yaqinlik balli:
\[ Rel_c(q_i)=\frac{1}{1+D_c^{tar}(q_i)} \]
deb belgilanadi.
Natijada:
- target item uchun \(D=0\) va \(Rel=1\),
- maqsaddan bir qirra uzoqlikdagi prerequisite uchun \(Rel=1/2\),
- ikki qirra uzoqlikda \(Rel=1/3\)
bo‘ladi.
Bu misollar to‘g‘ridan-to‘g‘ri formulaning matematik natijasidir; yangi eksperimental topilma emas.
TEKS utility balli
Yakuniy TEKS balli:
\[ U_{u,t}^{TEKS}(q_i) = Gain_{u,t}(q_i) \left[ 1+\lambda_{rel}Rel_c(q_i) \right] \]
ko‘rinishidadir.
\(\lambda_{rel}\geq0\), target relevance adjustment kuchini belgilaydi.
Baseline tadqiqotda:
\[ \lambda_{rel}=1.0 \]
ishlatilgan.
\(\lambda_{rel}=0\) bo‘lganda:
\[ U^{TEKS}=Gain \]
bo‘ladi; ya’ni graf-asosidagi relevance ko‘paytuvchisi bekor bo‘ladi va usul faqat predictive one-step acquisition scoring holiga keladi.
Sensitivity analysis da \(\lambda_{rel}=0\) sharoitida ham TEKS–PW-MG farqining saqlanishi, TEKS va PW-MG o‘rtasidagi tafovut faqat relevance ko‘paytuvchisidan kelmasligini; expected-acquisition hisobining ham alohida hissa qo‘shishini ko‘rsatadi. Biroq manba bu topilmani \(\lambda_{rel}=1.0\) optimal ekanini ko‘rsatadi deb talqin qilmaydi.
Tanlov qoidasi
Navbatdagi element:
\[ q_{u,t}^{*} = \arg\max_{q_i\in\Omega(c)} U_{u,t}^{TEKS}(q_i) \]
bilan tanlanadi.
Ya’ni nomzod qamrovidagi barcha elementlar ballanadi va eng katta TEKS balliga ega element tanlanadi.
Teng ball yuzaga kelsa, manba node identifier kichik bo‘lgan nomzodni tanlab tie-breaking qiladi.
TEKS uzoq muddatni optimallashtiradimi?
Yo‘q. TEKS manbada aniq myopic one-step selection deb ta’riflanadi. Har bir qadamda keyingi o‘zaro aloqaga qaraydi; reinforcement learning kabi uzoq muddatli cumulative reward uchun butun kelajakni bevosita optimallashtirmaydi.
Bu modelning talqin qilinishini oshiradi, biroq uzoq muddatli optimal o‘rganish yo‘li kafolatlangan degani emas.
PW-MG bilan asosiy farq nima?
PW-MG uchun avval bevosita prerequisites o‘zlashtirilgan bo‘lish ehtimoli:
\[ \widehat{R}_{u,t,i}^{-} = \sum_{K\in\mathcal{K}(G)} \mathbf{1}[Pre(q_i)\subseteq K] \pi_{u,t}^{-}(K) \]
hisoblanadi.
PW-MG balli:
\[ U_{u,t}^{PW-MG}(q_i) = \left(1-\widehat{m}_{u,t,i}^{-}\right) \widehat{R}_{u,t,i}^{-} \]
ko‘rinishidadir.
Bu yerda:
- \(1-\widehat{m}^{-}\): mastery gap, ya’ni nomzod hali noma’lum bo‘lish ehtimoli,
- \(\widehat{R}^{-}\): prerequisites tayyor bo‘lish ehtimoli.
Shunday qilib PW-MG “yetishmayotgan va zaruriy shartlari tayyor” nomzodlarni oldinga chiqaradi.
TEKS esa buning o‘rniga nomzodning haqiqatda keyingi qadamda o‘zlashtirilish ehtimolini response va transition modeli orqali hisoblaydi va maqsadga bo‘lgan graph relevance bilan moslashtiradi.
TEKSning to‘rtta taqqoslash usuli ichidagi o‘rni
| Strategiya | Adaptivmi? | Prerequisite ishlatilishi | Asosiy tanlov mantiqi |
|---|---|---|---|
| TEKS | Ha | Ha | Predictive one-step acquisition + target relevance |
| PW-MG | Ha | Ha | Mastery gap × prerequisite readiness |
| Static | Yo‘q | Topologik tartibdan foydalanadi | Oldindan belgilangan deterministik dastur |
| Random | Yo‘q | Tanlov ballida ishlatmaydi | \(\Omega(c)\) ichidan uniform random tanlov |
Simulyatsiyada ishlatilgan uchta bilim tuzilmasi
Simmetrik tarmoqlanish grafi
Manbadagi sakkiz tugunli tuzilma quyidagi qirralardan iborat:
\[ E_{sym}= \{ (q_1,q_3),(q_1,q_4),(q_2,q_5),(q_2,q_6), (q_3,q_7),(q_5,q_7),(q_4,q_8),(q_6,q_8) \} \]
Ikki vazifa sharoiti mavjud:
\[ \phi(c_A)=\{q_7\} \]
\[ \Omega(c_A)=\{q_1,q_2,q_3,q_5,q_7\} \]
va:
\[ \phi(c_B)=\{q_8\} \]
\[ \Omega(c_B)=\{q_1,q_2,q_4,q_6,q_8\} \]
Bu ikki sharoit bir xil target depth, prerequisite soni va path structure ga ega. Shu sabab manba \(c_A\) va \(c_B\)ni ikkita mustaqil graf natijasi sifatida emas, symmetry check sifatida birgalikda talqin qiladi.
Asimmetrik birlashish grafi
Olti tugunli tuzilma:
\[ E_{asym} = \{ (q_1,q_3),(q_3,q_5),(q_2,q_4),(q_5,q_6),(q_4,q_6) \} \]
deb belgilangan.
Bu yerda:
\[ q_1\rightarrow q_3\rightarrow q_5\rightarrow q_6 \]
uzunroq tarmoqni,
\[ q_2\rightarrow q_4\rightarrow q_6 \]
qisqaroq tarmoqni hosil qiladi.
Maqsad va nomzod qamrovi:
\[ \phi(c_{asym})=\{q_6\} \]
\[ \Omega(c_{asym})=\{q_1,q_2,q_3,q_4,q_5,q_6\} \]
ko‘rinishidadir.
Chiziqli zaruriy shart zanjiri
Chiziqli tuzilma:
\[ q_1\rightarrow q_2\rightarrow q_3\rightarrow q_4\rightarrow q_5\rightarrow q_6 \]
ko‘rinishidadir.
Bu yerda maqsad \(q_6\) va barcha olti tugun candidate scope ichida.
Ushbu tuzilmada alternativ prerequisite branch bo‘lmagani sabab ketma-ketlik usullari turlicha tanlov qilishi mumkin bo‘lgan maydon tarmoqlanuvchi graflarga qaraganda ancha cheklangan.
Difficulty qanday belgilanadi?
Tugunning difficulty qiymati topological depth dan chiqarilgan:
\[ d_i = 0.2+ 0.6 \frac{depth(q_i)} {\max_{q_j\in Q}depth(q_j)} \]
Source node lar uchun depth=0 bo‘lgani sabab:
\[ d_i=0.2 \]
bo‘ladi.
Maksimal chuqurlikdagi tugun uchun nisbat 1 bo‘lgani sabab:
\[ d_i=0.8 \]
hosil bo‘ladi.
Shu tariqa difficulty qiymatlari manbada bildirilganidek 0.2–0.8 oralig‘ida o‘zgaradi.
Graf sharoitlarining holatlar fazosi
| Sharoit | Maqsad | |Ω(c)| | |K(G)| | |K0(c)| |
|---|---|---|---|---|
| Simmetrik tarmoqlanish \(c_A\) | q7 | 5 | 34 | 9 |
| Simmetrik tarmoqlanish \(c_B\) | q8 | 5 | 34 | 9 |
| Asimmetrik birlashish | q6 | 6 | 13 | 12 |
| Chiziqli zanjir | q6 | 6 | 7 | 6 |
Boshlang‘ich malaka guruhlari
Boshlang‘ich holat tayanchi:
\[ \mathcal{K}_0(c) = \{ K\in\mathcal{K}(G): K\subseteq\Omega(c),\; \phi(c)\nsubseteq K \} \]
bilan belgilanadi.
Bu shart ikki ishni bajaradi:
- boshlang‘ich bilimni vazifaning candidate scope doirasida saqlaydi;
- maqsad to‘plamining barchasini allaqachon o‘zlashtirgan talabalarni boshlang‘ichdan chiqaradi.
Holatning boshlang‘ich mastery proportion qiymati:
\[ m_0(K)= \frac{|K\cap\Omega(c)|}{|\Omega(c)|} \]
deb hisoblanadi.
Guruhlar:
- Past malaka: \(m_0(K)<1/3\)
- O‘rta malaka: \(1/3\leq m_0(K)<2/3\)
- Yuqori malaka: \(m_0(K)\geq2/3\)
ko‘rinishidadir.
Balanced population initial-state distribution ushbu uch malaka guruhining har biriga umumiy ehtimollik massasining \(1/3\) qismini beradi va guruh ichidagi yaroqli holatlarga bu massani teng taqsimlaydi.
Tadqiqot Usuli va Natijalari
Simulyatsiya dizayni
| Parametr | Qiymat | Ma’nosi |
|---|---|---|
| Virtual o‘rganuvchi / takror \(N\) | 200 | Har bir mustaqil takrordagi virtual learner soni |
| Decision horizon \(T\) | 90 | Har bir o‘rganuvchi uchun item-selection/response qadami |
| Mustaqil takror \(R\) | 30 | Statistik taqqoslashning takror darajasidagi namuna soni |
| Slip \(s\) | 0.10 | Ma’lum elementda noto‘g‘ri javob ehtimoli |
| Guess \(g\) | 0.20 | Noma’lum elementda to‘g‘ri javob ehtimoli |
| \(\alpha_c\) | 0.30 | To‘g‘ri javobdan keyingi base acquisition rate |
| \(\alpha_e\) | 0.10 | Noto‘g‘ri javobdan keyingi base acquisition rate |
| \(\lambda_{rel}\) | 1.0 | Target relevance adjustment kuchi |
| Difficulty | 0.2–0.8 | Topological depth dan chiqarilgan oraliq |
| Forgetting | Chiqarilgan | Mastered item yo‘qolmaydi |
| Early stopping | Yo‘q | Barcha o‘rganuvchilar qat’iy horizon ni yakunlaydi |
Taqqoslash adolatli bo‘lishi uchun nima tenglashtirildi?
To‘rtta usul bir xil:
- initial-state generation,
- response model,
- state-transition mechanism,
- candidate scope,
- interaction budget
sharoitlaridan foydalangan.
Har bir learner/repetition uchun ayni hidden initial state usullar orasida bo‘lishilgan. Paired strategy comparisons uchun common random numbers qo‘llangan; muayyan graph, repetition, learner va decision step uchun strategiyalar bir xil response va acquisition uniform draws ni bo‘lishgan.
Bu dizaynning maqsadi usullar o‘rtasidagi farqni tasodifiy namuna olish shovqinidan imkon qadar ajratishdir.
Static strategiyaning dasturi
Static baseline nomzodlarni avval topological level, so‘ng node identifier tartibida aylantiradi.
Asosiy quota:
\[ \left\lfloor\frac{T}{|\Omega(c)|}\right\rfloor \]
deb hisoblanadi.
\(T=90\) uchun:
- simmetrik sharoitlarda 5 ta nomzod bo‘lgani sabab har bir nomzod 18 marta,
- asimmetrik va linear sharoitlarda 6 ta nomzod bo‘lgani sabab har bir nomzod 15 marta
tanlanadi.
Uchta baholash metriki
1. Final target mastery
\[ M_u^{tar}(T) = \frac{|K_{u,T}\cap\phi(c)|}{|\phi(c)|} \]
Bu metrik horizon oxirida maqsad to‘plamining qanchasi o‘zlashtirilganini ko‘rsatadi.
Ushbu tadqiqotda barcha target set lar bitta elementdan iborat. Shuning uchun learner-level qiymat 0 yoki 1; jadvallardagi o‘nli natijalar 200 o‘rganuvchi va takrorlarning umumlashtirilishi bilan hosil bo‘ladi.
2. Mean target mastery over time
\[ \overline{M}_u^{tar} = \frac{1}{T+1} \sum_{t=0}^{T} \frac{|K_{u,t}\cap\phi(c)|}{|\phi(c)|} \]
Bu qiymat faqat 90-qadamdagi natijani emas, butun trajectory davomida maqsadga qanchalik erta erishilganini ham hisobga oladi.
Manba buni target-mastery trajectory ning normallashtirilgan discrete area under the curve ekvivalenti sifatida tushuntiradi.
3. Final scope mastery
\[ M_u^{\Omega}(T) = \frac{|K_{u,T}\cap\Omega(c)|}{|\Omega(c)|} \]
Bu metrik faqat maqsad tugunini emas, balki maqsadga oid prerequisites ni ham o‘z ichiga olgan butun task-specific scope ichidagi o‘rganish darajasini o‘lchaydi.
Statistik tahlil qanday bajarildi?
Statistik xulosa learner darajasida emas, repetition darajasida bajarilgan.
Har bir repetition ichida 200 o‘rganuvchining natijalari avval o‘rtachalashtirilgan. Shu tariqa har bir strategy × condition uchun 30 ta repetition-level mean olingan.
TEKS va har bir baseline o‘rtasidagi juftlangan farqlar:
\[ D_r= \text{TEKS}_r-\text{Baseline}_r \]
mantiqi bilan baholangan.
Primary comparisons uchun two-sided paired t-test ishlatilgan.
Hisobot qilingan unsurlar:
- mean paired difference,
- %95 t confidence interval,
- paired Cohen's \(d_z\),
- p qiymati,
- primary branching analyses uchun Holm-adjusted p qiymati
ko‘rinishidadir.
Paired Cohen's dz nimani ko‘rsatadi?
Manbaning Equation (40)i:
\[ d_z=\frac{\overline{D}}{s_D} \]
ko‘rinishidadir.
Bu yerda:
- \(\overline{D}\): 30 ta takrordagi paired differences ning o‘rtachasi,
- \(s_D\): ayni paired differences ning sample standard deviation qiymati.
\(d_z\), TEKS va baseline o‘rtasidagi o‘rtacha juftlangan farqni ushbu farqlarning standart og‘ishi birliklarida ifodalaydi.
Bu ta’sir kattaligi haqiqiy talabalarda ta’lim ta’sirining standartlashtirilgan kattaligi sifatida talqin qilinmasligi kerak; ushbu tadqiqotda bu simulyatsiya takrorlari orasidagi paired strategy difference kattaligidir.
Holm tuzatishi nega ishlatilgan?
Har bir simmetrik maqsad sharoitida uchta outcome × uchta TEKS–baseline contrast = to‘qqizta test yuzaga keladi. Ko‘p sonli gipoteza testi bajarilganda tasodifan kichik p qiymatlarini olish ehtimoli ortishi mumkinligi sabab paired t-test p qiymatlariga Holm correction qo‘llangan.
\(c_A\) va \(c_B\) uchun correction alohida bajarilgan. Ikki sharoit structurally isomorphic va coupled random streams dan foydalangani sabab natijalar symmetry check sifatida talqin qilingan.
Asimmetrik graf alohida to‘qqiz testlik oilani hosil qilgan.
Linear chain esa secondary structural analysis bo‘lgani sabab Holm-adjusted primary family ga kiritilmagan va p qiymatlari unadjusted tarzda berilgan.
Wilcoxon signed-rank testlari supplement da unadjusted robustness check sifatida hisobot qilingan.
Simmetrik tarmoqlanish grafidagi asosiy natijalar
| Strategiya | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.6263 (0.0388) | 0.3235 (0.0267) | 0.8714 (0.0145) |
| PW-MG | 0.5508 (0.0333) | 0.2979 (0.0270) | 0.8161 (0.0160) |
| Static | 0.2847 (0.0415) | 0.0318 (0.0046) | 0.7776 (0.0147) |
| Random | 0.1908 (0.0239) | 0.0913 (0.0137) | 0.7370 (0.0139) |
TEKS–PW-MG paired natijalari:
| Metrik | O‘rtacha farq | %95 CI | Cohen's dz | Holm-adjusted p |
|---|---|---|---|---|
| Final target mastery | 0.0755 | [0.0641, 0.0869] | 2.48 | 8.39 × 10⁻¹⁴ |
| Mean target mastery over time | 0.0256 | [0.0200, 0.0312] | 1.71 | 2.79 × 10⁻¹⁰ |
| Final scope mastery | 0.0552 | [0.0499, 0.0605] | 3.89 | 8.86 × 10⁻¹⁹ |
Ayni TEKS–PW-MG natijalari \(c_B\) uchun ham olingan.
TEKS va PW-MG boshlang‘ich qadamlarda bir-biriga yaqin target-mastery trajectories ko‘rsatgan, qaror ufqining keyingi qismida esa TEKSning o‘rtacha trajectory si yuqoriroq bo‘lgan.
Qiziqarli ravishda, TEKS tanlovlarning %52,31 qismini target node ga ajratgan bo‘lsa, PW-MG %59,24 qismini target node ga ajratgan. Shunga qaramay, TEKS target mastery da yuqoriroq natija bergan.
Manba buni quyidagicha tushuntiradi: predictive state distribution ning muhim qismi target prerequisites hali tayyor bo‘lmagan holatlarga tegishli bo‘lsa, bu holatlar target ning one-step acquisition gain hisobiga nol hissa qo‘shadi. Shunday qilib, TEKS ayrim bosqichlarda maqsadni bevosita yana tanlash o‘rniga hali o‘zlashtirilmagan prerequisites ga yo‘naladi.
Asimmetrik birlashish grafidagi natijalar
| Strategiya | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.4858 (0.0366) | 0.2157 (0.0187) | 0.8312 (0.0150) |
| PW-MG | 0.4215 (0.0282) | 0.1963 (0.0185) | 0.7770 (0.0173) |
| Static | 0.1598 (0.0254) | 0.0151 (0.0028) | 0.7129 (0.0100) |
| Random | 0.0848 (0.0201) | 0.0360 (0.0092) | 0.6620 (0.0140) |
| Metrik | O‘rtacha farq | %95 CI | Cohen's dz | Holm-adjusted p |
|---|---|---|---|---|
| Final target mastery | 0.0643 | [0.0536, 0.0751] | 2.24 | 1.06 × 10⁻¹² |
| Mean target mastery over time | 0.0194 | [0.0142, 0.0247] | 1.37 | 2.72 × 10⁻⁸ |
| Final scope mastery | 0.0542 | [0.0490, 0.0594] | 3.92 | 7.28 × 10⁻¹⁹ |
TEKS ushbu tuzilmada tanlovlarning:
- %39,08 qismini uzun prerequisite branch ga,
- %17,62 qismini qisqa branch ga,
- %43,30 qismini target node ga
ajratgan.
PW-MG uchun tegishli qiymatlar:
- %38,01 uzun branch,
- %14,35 qisqa branch,
- %47,65 target
deb hisobot qilingan.
TEKS Chiziqli Zaruriy Shart Zanjirida Ham PW-MGdan Ustunmi?
Target-level mezonlarda yo‘q: chiziqli zanjirda TEKS va PW-MG o‘rtasidagi final target mastery farqi 0.0095 va \(p=0.061\), mean target mastery over time farqi −0.0009 va \(p=0.728\) bo‘lib, har ikkala ishonch intervali nolni o‘z ichiga olgan; TEKSning yaqqol ustunligi final scope mastery da kuzatilgan.
| Strategiya | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.4128 (0.0423) | 0.1939 (0.0224) | 0.7658 (0.0184) |
| PW-MG | 0.4033 (0.0475) | 0.1948 (0.0282) | 0.7388 (0.0225) |
| Static | 0.1338 (0.0282) | 0.0122 (0.0028) | 0.6349 (0.0214) |
| Random | 0.0818 (0.0220) | 0.0417 (0.0129) | 0.5720 (0.0180) |
| Metrik | O‘rtacha farq | %95 CI | dz | p |
|---|---|---|---|---|
| Final target mastery | 0.0095 | [−0.0005, 0.0195] | 0.36 | 0.061 |
| Mean target mastery over time | −0.0009 | [−0.0059, 0.0042] | −0.06 | 0.728 |
| Final scope mastery | 0.0271 | [0.0209, 0.0332] | 1.65 | 6.39 × 10⁻¹⁰ |
Bu p qiymatlari secondary linear analysis uchun unadjusted.
Manba talqiniga ko‘ra, chiziqli tuzilma tanlovlarni kuchli cheklaydi. Bir nechta prerequisite branch tanlov uchun raqobat qilmaganda TEKS va PW-MG tanlov qoidalari target-level natijalarda kamroq farqlanadi.
Boshlang‘ich malakaga ko‘ra natijalar
| Guruh | Strategiya | Final target | Mean target | Final scope |
|---|---|---|---|---|
| Past | TEKS | 0.4006 | 0.1319 | 0.7682 |
| PW-MG | 0.2787 | 0.0884 | 0.6596 | |
| Static | 0.1972 | 0.0219 | 0.6803 | |
| Random | 0.0479 | 0.0106 | 0.5995 | |
| O‘rta | TEKS | 0.5593 | 0.2295 | 0.8601 |
| PW-MG | 0.4480 | 0.1736 | 0.8000 | |
| Static | 0.2530 | 0.0280 | 0.7683 | |
| Random | 0.1331 | 0.0458 | 0.7309 | |
| Yuqori | TEKS | 0.9130 | 0.6039 | 0.9826 |
| PW-MG | 0.9188 | 0.6266 | 0.9838 | |
| Static | 0.3998 | 0.0452 | 0.8800 | |
| Random | 0.3876 | 0.2154 | 0.8775 |
Past proficiency guruhida TEKS − PW-MG farqlari:
- final target mastery: 0.1219,
- mean target mastery: 0.0436,
- final scope mastery: 0.1086.
O‘rta guruhda tegishli farqlar:
- 0.1113,
- 0.0559,
- 0.0601.
Yuqori proficiency guruhida esa PW-MG uchala mezonda ham biroz yuqoriroq o‘rtacha natija bergan; TEKS − PW-MG farqlari mos ravishda:
- −0.0058,
- −0.0227,
- −0.0012
bo‘lgan.
Manba ushbu subgroup comparisons ni exploratory and descriptive deb tasniflaydi; asosiy tasdiqlovchi natija sifatida talqin qilmaydi.
Sezgirlik tahlili
One-factor-at-a-time sensitivity analysis faqat ikkita symmetric target condition da bajarilgan.
| Omil | Baseline | Muqobil sharoitlar |
|---|---|---|
| \(\lambda_{rel}\) | 1.0 | 0.0, 0.5, 2.0 |
| Decision horizon \(T\) | 90 | 60, 120 |
| Response noise \((s,g)\) | (0.10, 0.20) | (0.05, 0.10), (0.15, 0.30) |
| Acquisition \((\alpha_c,\alpha_e)\) | (0.30, 0.10) | (0.20, 0.05), (0.40, 0.15) |
| Difficulty function | 0.2 + 0.6h/hmax | 0.1 + 0.5h/hmax; 0.3 + 0.6h/hmax |
| Diagnostic prior | \(p_0=\nu_0\) | \(\mathcal{K}_0(c)\) ustida uniform |
Ko‘rib chiqilgan 12 sharoitda TEKS − PW-MG mean paired difference:
- final target mastery uchun 0.0300–0.1048,
- mean target mastery over time uchun 0.0033–0.0407,
- final scope mastery uchun 0.0212–0.0878
oralig‘ida o‘zgargan.
Slow-acquisition sharoitida mean target mastery over time farqi 0.0033 va %95 CI [−0.0002, 0.0069] deb hisobot qilingan; ishonch intervali nolni o‘z ichiga olgan.
Eng katta final-target farqi \(\lambda_{rel}=0\) sharoitida kuzatilgan. Bu predictive expected-acquisition komponenti relevance multiplier siz ham PW-MGdan farqlanishga hissa qo‘shishini ko‘rsatadi. Biroq bu baseline \(\lambda_{rel}=1.0\) optimal degan xulosani bermaydi.
Tahlil one-factor-at-a-time bo‘lgani sabab response noise, acquisition speed, difficulty, horizon va prior o‘rtasidagi o‘zaro ta’sirlar o‘rganilmagan.
Bu Tadqiqot TEKS Haqiqiy Talabalarda Yaxshiroq O‘rganishni Ta’minlashini Isbotlaydimi?
Yo‘q. Barcha samaradorlik natijalari oldindan belgilangan learner initialization, response-error, acquisition, difficulty va transition farazlari ostida ishlaydigan virtual o‘rganuvchilardan olingan; haqiqiy talaba o‘zaro aloqasi, sinf amaliyoti, saqlanish, o‘rganish transferi yoki ta’limiy foydalanish qulayligi ushbu tadqiqotda o‘lchanmagan.
Tadqiqot qo‘llab-quvvatlaydigan xulosalar
- TEKSning prerequisite constraints, task-specific targets va learner-state uncertainty ni bitta next-item scoring qoidasida birlashtiradigan matematik doirasi belgilangan.
- Nazorat qilinadigan symmetric branching va asymmetric converging simulyatsiyalarida TEKS uchta asosiy samaradorlik metrikasida PW-MG, Static va Random dan yuqoriroq o‘rtacha natijalar hosil qilgan.
- Branching tuzilmalarda TEKS va PW-MG o‘rtasidagi target-level farqlar confidence interval jihatidan noldan ajralgan.
- Linear prerequisite chain da target-level TEKS–PW-MG farqi sezilarli darajada kamaygan va ikki target metrikasida CI nolni o‘z ichiga olgan.
- TEKS linear chain da final scope mastery bo‘yicha PW-MG dan yuqoriroq natija bergan.
- Past va o‘rta initial-proficiency guruhlarida symmetric condition ostida TEKS o‘rtacha natijalari PW-MG dan yuqori bo‘lgan.
- Yuqori-proficiency subgroup da PW-MG biroz yuqoriroq o‘rtacha natijalar bergan.
- TEKS–PW-MG farqi branching structures ostida yaqqolroq ekanligi kuzatilgan.
- Sensitivity analysis natijalari TEKS–PW-MG farqining magnitude i simulyatsiya parametrlariga qarab o‘zgarishini ko‘rsatadi.
Tadqiqot qo‘llab-quvvatlamaydigan xulosalar
- TEKS haqiqiy talabalarda o‘rganish muvaffaqiyatini oshirishi isbotlanmagan.
- TEKS barcha prerequisite graph tuzilmalarida PW-MG dan ustun deb aytib bo‘lmaydi.
- \(\lambda_{rel}=1.0\) optimal qiymat ekani ko‘rsatilmagan.
- TEKS uzoq muddatli optimal o‘rganish yo‘lini hosil qilishi isbotlanmagan.
- Model forgetting, transfer between unselected items yoki time-varying acquisition ni ifodalamaydi.
- Haqiqiy response va learning transition jarayonlari BLIM va ishlatilgan transition kernel bilan to‘liq ifodalangani tasdiqlanmagan.
- Katta knowledge graph larda haqiqiy ish vaqti yoki peak memory benchmark hisobot qilinmagan.
- Authentic curriculum, engagement, feedback formati, cognitive load yoki time constraint modelning joriy tanlov balliga kiritilmagan.
- Simulyatsiyadagi statistik ahamiyatlilik haqiqiy ta’lim muhitidagi amaliy/ta’limiy ahamiyatning dalili emas.
Hisoblash miqyoslanishi
Manba exact implementation uchun:
- \(S=|\mathcal{K}(G)|\): prerequisite-consistent state-space kattaligi,
- \(M=|\Omega(c)|\): task-specific candidate scope kattaligi
deb belgilaydi.
BLIM measurement update va predictive propagation active state support ga nisbatan chiziqli miqyoslanganda, barcha TEKS candidate larini baholash uchun manba konservativ to‘liq-tayanch murakkabligini:
\[ O(MS) \]
deb beradi.
Asosiy miqyoslanish muammosi faqat \(O(MS)\) ko‘paytmasi emas; prerequisite-consistent feasible-state enumeration bilim elementlari soni oshgani sari eksponensial o‘sishi mumkin.
Tadqiqotdagi tuzilmalar:
- symmetric graph: 34 feasible state,
- asymmetric graph: 13 feasible state,
- linear chain: 7 feasible state
ni o‘z ichiga oladi.
Manba original formal runs uchun ishonchli wall-clock runtime yoki peak-memory o‘lchovlarini saqlamaganini aniq bildiradi. Shu sabab Verianla yangi samaradorlik/vaqt taxminini yaratmaydi.
Asosiy cheklovlar
1. Controlled simulation: Haqiqiy talaba ma’lumotlari ishlatilmagan.
2. Model-environment alignment: Baseline experiments da learner-state estimator va simulation environment bir xil response va transition shakllaridan foydalanadi va diagnostic prior population distribution bilan moslashtirilgan.
3. Cheklangan misspecification: Prior mismatch o‘rganilgan, biroq haqiqiy response yoki learning process modelga kengroq tarzda mos kelmasligi sinovdan o‘tkazilmagan.
4. Kichik DAGlar: Faqat 8 yoki 6 tugunli kichik directed acyclic graphs ishlatilgan.
5. Singleton targets: Har bir condition bitta target item ni o‘z ichiga oladi.
6. Monotonic acquisition: Forgetting yo‘q.
7. Transfer yo‘q: Tanlanmagan elementlar o‘rtasida o‘rganish transferi modellashtirilmagan.
8. Qat’iy acquisition parameters: Acquisition darajalari vaqtga yoki talabaga qarab o‘zgarmaydi.
9. Binary responses: Har bir interaction faqat bitta bilim elementi va binary response ni o‘z ichiga oladi.
10. Myopic utility: TEKS uzun-horizon optimal reja izlamaydi.
11. Kontekstual xususiyatlar yo‘q: Resource format, feedback type, time constraint, cognitive load va learner engagement tanlov modelida mavjud emas.
12. Katta miqyosli benchmark yo‘q: Runtime va peak-memory o‘lchovi hisobot qilinmagan.
13. Haqiqiy ta’limiy ma’no noma’lum: Simulyatsiyadagi farqlar haqiqiy dunyoda mazmunli learning gain ga aylanadimi-yo‘qmi, ushbu tadqiqotdan chiqarib bo‘lmaydi.
Kelajak tadqiqotlari uchun tavsiyalar
Manba kelajakda:
- kattaroq va turli prerequisite structures,
- turli akademik sohalardan authentic curriculum graphs,
- non-singleton target sets,
- multi-skill activities,
- forgetting,
- nonstationary acquisition,
- misspecified response models,
- misspecified transition models,
- approximate yoki decomposed inference,
- multistep planning va reinforcement-learning taqqoslashlari,
- authentic learner interaction data,
- predictive calibration,
- observed learning outcomes,
- persistence,
- instructional usability
bo‘yicha baholash o‘tkazishni tavsiya qiladi.
Manba va Usul Haqida Izoh
Asl sarlavha: A Knowledge–Scenario–Learner Framework for Target-Oriented Adaptive Sequencing: A Simulation-Based Proof-of-Concept Study.
Mualliflar: Bingqian Li; Hongwei Guo; Jia Hao; Xiaobei Jiang; Hongwei Niu.
Mualliflar tartibi: Manbadagi tartib aynan saqlangan.
Teng hissa: Manbada equal-contribution bayonoti mavjud emas.
Mas’ul muallif: Hongwei Guo.
Muassasa: School of Mechanical Engineering, Beijing Institute of Technology, 5 Zhongguancun South Street, Beijing 100081, China.
Jurnal: Education Sciences.
Bo‘lim: Technology Enhanced Education.
Nashriyot: MDPI, Basel, Switzerland.
Jild / son / maqola raqami: 16(8), 1344.
DOI: 10.3390/educsci16081344.
Rasmiy havola: https://doi.org/10.3390/educsci16081344
Received: 28 June 2026.
Revised: 15 August 2026.
Accepted: 19 August 2026.
Published: 21 August 2026.
Manba turi: Article; simulation-based proof-of-concept study.
Taqriz: Education Sciences taqrizli akademik jurnaldir; tadqiqot nashr etilgan jurnal maqolasidir.
Preprint: Ko‘rib chiqilgan asosiy PDF va rasmiy nashr qaydida alohida preprint versiyasi ko‘rsatilmagan.
Litsenziya: Creative Commons Attribution (CC BY).
Kalit so‘zlar: adaptive learning; target-oriented sequencing; prerequisite-aware sequencing; learner modeling; educational technology.
Asosiy model: Triadic Educational Knowledge Space (TEKS).
Learner-state response modeli: Basic Local Independence Model (BLIM).
Taqqoslash usullari: Prerequisite-Weighted Mastery Gap (PW-MG), Static va Random.
Graph tuzilmalari: 8-node symmetric branching graph; 6-node asymmetric converging graph; 6-node linear prerequisite chain.
Simmetrik target conditions: \(c_A\rightarrow q_7\) va \(c_B\rightarrow q_8\); structurally isomorphic symmetry check sifatida talqin qilingan.
Virtual o‘rganuvchilar soni: Har bir repetition uchun N=200.
Decision horizon: T=90 interaction steps.
Independent repetitions: R=30.
Slip: s=0.10.
Guess: g=0.20.
Correct-response acquisition rate: \(\alpha_c=0.30\).
Incorrect-response acquisition rate: \(\alpha_e=0.10\).
Target-relevance coefficient: \(\lambda_{rel}=1.0\).
Difficulty range: [0.2, 0.8].
Forgetting: Excluded.
Early stopping: Not applied.
Baseline diagnostic prior: \(p_0^{(c)}=\nu_0^{(c)}\).
Primary performance metrics: final target mastery, mean target mastery over time, final target-conditioned scope mastery.
Statistik tahlil: Repetition-level paired contrasts; two-sided paired t-tests; %95 t confidence intervals; paired Cohen's \(d_z\); primary test families uchun Holm correction; supplementary robustness uchun Wilcoxon signed-rank test.
Asosiy symmetric cA TEKS natijalari: final target mastery 0.6263 (SD 0.0388); mean target mastery 0.3235 (0.0267); final scope mastery 0.8714 (0.0145).
Symmetric TEKS–PW-MG farqlari: 0.0755; 0.0256; 0.0552. Tegishli \(d_z\) qiymatlari 2.48, 1.71 va 3.89.
Asosiy asymmetric TEKS natijalari: 0.4858; 0.2157; 0.8312.
Asymmetric TEKS–PW-MG farqlari: 0.0643; 0.0194; 0.0542.
Linear-chain natijasi: final target va mean target mezonlarida TEKS va PW-MG confidence interval jihatidan ajralmagan; final scope mastery TEKS foydasiga yuqoriroq.
Initial-proficiency natijasi: Symmetric cA exploratory analysis ostida past va o‘rta guruhlarda TEKS yuqoriroq; yuqori guruhda PW-MG biroz yuqoriroq o‘rtacha natijalar bergan.
Sensitivity: One-factor-at-a-time; response noise, acquisition rate, horizon, difficulty, target relevance va diagnostic prior variatsiyalari o‘rganilgan. Omillararo o‘zaro ta’sir tahlili bajarilmagan.
Hisoblash murakkabligi: Exact implementation uchun barcha TEKS candidates ning conservative full-support baholashi \(O(MS)\); feasible-state enumeration bilim elementlari soni oshgani sari eksponensial o‘sishi mumkin.
Runtime / peak memory: Original formal runs uchun ishonchli o‘lchovlar saqlanmagani sabab empirik benchmark hisobot qilinmagan.
Supplementary Materials: Manba Supplementary Method S1, Tables S1–S3, Supplementary Method S2, Tables S4–S5, Supplementary Data S1 va S2 mavjudligini bildiradi. Ushbu alohida fayllar joriy foydalanuvchi yuklamasiga kiritilmagan; Verianla asosiy maqolasi yuklangan 29 sahifalik source PDF ochiq ravishda hisobot qilgan ma’lumotlar bilan cheklangan.
Source repository: Development repository joriy loyiha bosqichida ommaga ochiq emas. Mualliflar Supplementary Method S2 independent reimplementation uchun algoritmik va implementation specifications taqdim etishini; Supplementary Data S1/S2 esa tekshiriladigan natijalarni o‘z ichiga olishini bildiradi.
Funding: National Key Research and Development Program of China, grant 2023YFC3305701.
Institutional Review Board Statement: Not applicable.
Data Availability: Development source repository public emas; supplement larda machine-readable simulation outputs, configurations, provenance/integrity records, analysis-ready results va figure source data mavjudligi bildiriladi. Additional clarification corresponding author dan reasonable request bilan so‘ralishi mumkin.
Conflicts of Interest: Mualliflar manfaatlar to‘qnashuvi yo‘qligini bildirgan. Moliyalashtiruvchi tadqiqot dizayni, ma’lumot tahlili, maqola yozish yoki nashr qarorida rol o‘ynamagan.
Muallif hissalari
- Conceptualization: Bingqian Li, Hongwei Guo.
- Methodology: Bingqian Li, Jia Hao.
- Validation: Bingqian Li, Jia Hao, Xiaobei Jiang, Hongwei Niu.
- Formal analysis: Bingqian Li.
- Investigation: Bingqian Li.
- Data curation: Bingqian Li.
- Writing — original draft preparation: Bingqian Li.
- Writing — review and editing: Hongwei Guo, Jia Hao, Hongwei Niu.
- Visualization: Bingqian Li, Xiaobei Jiang.
- Supervision: Hongwei Guo.
- Project administration: Hongwei Guo.
- Funding acquisition: Hongwei Guo.
Asosiy metodologik cheklovlar: Nazorat qilinadigan va model-asosidagi simulyatsiya; haqiqiy talaba ma’lumotlarining yo‘qligi; baseline da estimator va environment modelining yaqindan mos kelishi; faqat cheklangan prior misspecification sinovi; kichik DAG tuzilmalari; singleton target set lar; forgetting va cross-item transfer ning chiqarib tashlanishi; binary response; qat’iy acquisition parametrlari; uzun-horizon planning ning yo‘qligi; contextual learner/instruction attributes ning tashqarida qoldirilishi; larger-graph runtime va memory benchmark ning yo‘qligi.
Asosiy talqin chegarasi: Tadqiqot TEKSning haqiqiy ta’lim muhitidagi samaradorligini isbotlamaydi. Nazorat qilinadigan simulyatsiya ostida target-adjusted one-step acquisition scoring, ayniqsa bir nechta prerequisite-related nomzod raqobatlashadigan branching tuzilmalarda, turli sequencing xatti-harakati va yuqoriroq simulyatsiya qilingan mastery natijalarini hosil qilishi mumkinligini ko‘rsatuvchi proof-of-concept dalil taqdim etadi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan