


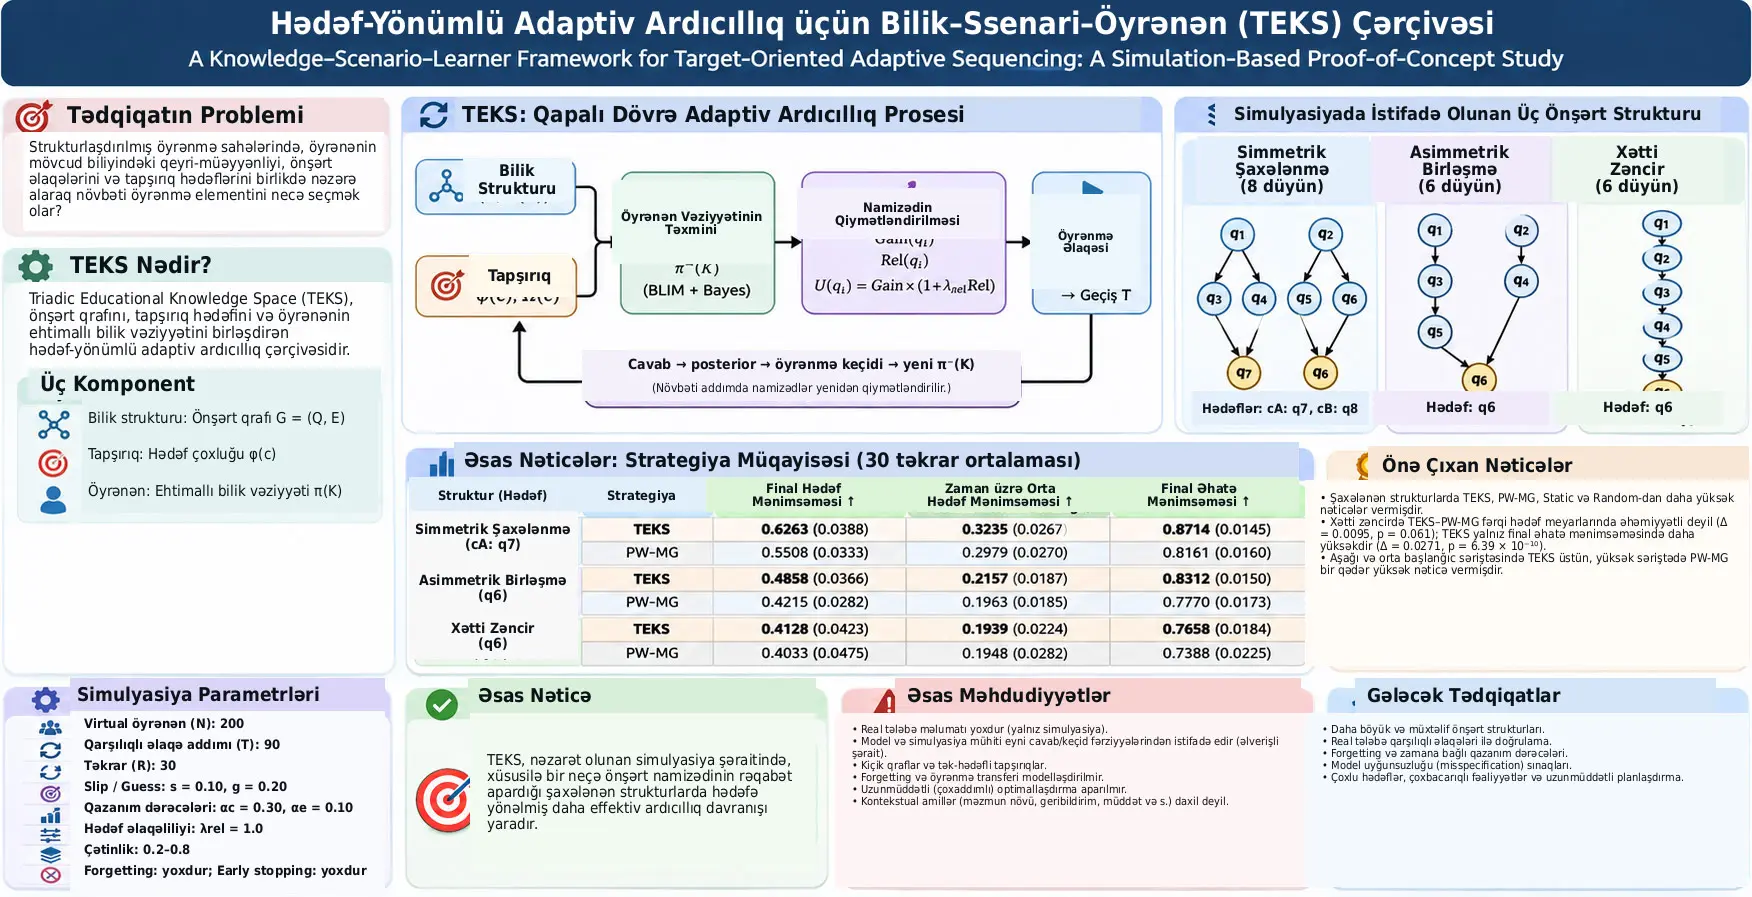
Triadic Educational Knowledge Space (TEKS), strukturlaşdırılmış öyrənmə sahələrində bir tələbənin növbəti olaraq hansı öyrənmə elementi ilə qarşılıqlı əlaqəyə girməli olduğunu müəyyən etmək üçün önşərt qrafını, tapşırığa xas hədəf çoxluğunu və tələbənin birbaşa müşahidə olunmayan bilik vəziyyətinə dair ehtimallı qiymətləndirməni birlikdə istifadə edən hədəf-yönümlü adaptiv ardıcıllıq çərçivəsidir. Tədqiqat TEKS-i real tələbələr üzərində deyil, nəzarət olunan qapalı dövrə simulyasiyada qiymətləndirmişdir. Üç önşərt strukturu araşdırılmışdır: səkkiz düyünlü simmetrik şaxələnmə qrafı, altı düyünlü asimmetrik birləşmə qrafı və altı düyünlü xətti önşərt zənciri. Hər şəraitdə 200 virtual öyrənən, 90 qarşılıqlı əlaqə addımı və 30 müstəqil təkrar istifadə edilmiş; TEKS eyni simulyasiya şərtləri altında Prerequisite-Weighted Mastery Gap (PW-MG), deterministik Static və Random strategiyaları ilə müqayisə edilmişdir.
TEKS-in qərar məntiqi yalnız “tələbə hansı mövzunu bilmir?” sualına əsaslanmır. Hər namizəd bilik elementi üçün əvvəlcə tələbənin mövcud qeyri-müəyyən bilik vəziyyətləri, mümkün doğru/yanlış cavablar və sonrakı öyrənmə keçidləri əsasında elementin növbəti qarşılıqlı əlaqədə yeni mənimsənilmə ehtimalı hesablanır. Bu dəyər daha sonra namizəd elementin tapşırıq hədəfindən qraf üzərində yönlü məsafəsinə bağlı target relevance ilə tənzimlənir. Beləliklə, sistem yalnız çatışmayan elementi deyil, mövcud vəziyyətdə mənimsənilməsi ehtimal olunan və hədəflə struktur baxımından əlaqəli olan elementi prioritetləşdirməyə çalışır.
İki əsas şaxələnən struktur altında TEKS final target mastery, zaman üzrə orta target mastery və final target-conditioned scope mastery meyarlarında PW-MG, Static və Random üsullarından daha yüksək nəticələr vermişdir. Simmetrik \(c_A\) şəraitində final target mastery TEKS üçün 0.6263, PW-MG üçün 0.5508; asimmetrik birləşmə qrafında isə müvafiq olaraq 0.4858 və 0.4215 kimi bildirilmişdir. Lakin xətti önşərt zəncirində TEKS ilə PW-MG-nin target-level nəticələri bir-birinə yaxın qalmışdır: final target mastery fərqi 0.0095 və \(p=0.061\), mean target mastery over time fərqi −0.0009 və \(p=0.728\) olmuş, etibar intervalları sıfırı əhatə etmişdir. Bunun əksinə, final scope mastery TEKS lehinə 0.0271 fərq göstərmişdir.
Bu nəticələrin şərh sərhədi çox vacibdir. Tədqiqat real tələbə davranışını ölçməmişdir. Population initialization, response error, acquisition rates, difficulty və learning-transition qaydaları tədqiqatçılar tərəfindən əvvəlcədən müəyyən edilmiş simulyasiya parametrləridir. Baseline təcrübələrində simulyasiya mühiti ilə learner-state estimator eyni response və transition formalarından istifadə edir. Buna görə tədqiqat TEKS-in real siniflərdə daha yaxşı öyrənmə təmin etdiyini sübut etmir; nəzarət olunan fərziyyələr altında müxtəlif candidate-selection qaydalarının hesablama davranışını müqayisə edir.
Tədqiqatın əsas problemi nədir?
Adaptiv öyrənmədə yalnız tələbənin son bir neçə suala verdiyi cavablara baxmaq kifayət etməyə bilər. Riyaziyyat, mühəndislik və kompüter elmləri kimi strukturlaşdırılmış sahələrdə daha irəli bilik elementini öyrənə bilmək üçün əvvəlcə müəyyən önşərtlərin mənimsənilmiş olması tələb olunur. Sistem tələbənin zəif olduğu elementi seçsə belə, həmin elementin önşərtləri hazır deyilsə, tövsiyə pedaqoji baxımdan vaxtından əvvəl ola bilər.
Əksinə, tamamilə sabit öyrənmə ardıcıllığı önşərt nizamını qoruya bilər, lakin tələbələr arasındakı başlanğıc bilik fərqini, irəliləyiş sürətini və müşahidə olunan cavabları nəzərə ala bilməz.
Tədqiqatın həll etməyə çalışdığı problem bu iki tələbi birləşdirməkdir:
- tələbənin mövcud biliyindəki qeyri-müəyyənliyi nəzərə almaq,
- önşərt əlaqələrini pozmamaq,
- və mövcud tapşırığın konkret hədəfini növbəti elementin seçiminə birbaşa daxil etmək.
Tədqiqatın iki tədqiqat sualı
- Tələbənin bilik vəziyyəti qeyri-müəyyən olduqda, önşərt-strukturlu öyrənmə sahəsində tapşırıq hədəfi next-item selection prosesinə necə daxil edilə bilər?
- Bu hədəf-yönümlü seçim qaydası müxtəlif önşərt strukturlarında mastery-gap əsaslı adaptiv seçimdən fərqli ardıcıllıq nəticələri yaradırmı?
TEKS Nədir və Üç Komponenti Necə Birləşdirir?
TEKS bilik sahəsinin önşərt strukturunu təmsil edən qrafı, mövcud tapşırığın çatmaq istədiyi bilik elementlərini müəyyən edən hədəf çoxluğunu və tələbənin mümkün gizli bilik vəziyyətləri üzrə ehtimal paylanmasını bir araya gətirərək hər qarşılıqlı əlaqədə növbəti namizədi yenidən qiymətləndirən qapalı dövrə adaptiv ardıcıllıq çərçivəsidir.
1. Bilik elementləri çoxluğu
Öyrənmə sahəsindəki bilik elementləri:
\[ Q=\{q_1,q_2,\ldots,q_n\} \]
kimi müəyyən edilir.
Burada \(q_i\) tək bir anlayışı və ya öyrənmə elementini, \(n\) isə bilik elementlərinin ümumi sayını göstərir. Bunlar fiziki vahid daşıyan kəmiyyətlər deyil; modeldəki diskret bilik düyünləridir.
2. Önşərt qrafı
Bilik strukturu yönlü qrafla göstərilir:
\[ G=(Q,E) \]
Burada \(E\subseteq Q\times Q\) yönlü kənarlar çoxluğudur. Əgər:
\[ q_i\rightarrow q_j \]
kənarı varsa, \(q_i\), \(q_j\)-nin birbaşa önşərtidir.
Elementin birbaşa önşərtlər çoxluğu:
\[ Pre(q_j)=\{q_i\in Q:(q_i,q_j)\in E\} \]
şəklində müəyyən edilir.
3. Önşərtlərlə uyğun bilik vəziyyətləri
Tələbənin gizli bilik vəziyyəti bildiyi elementlərin istənilən təsadüfi alt çoxluğu kimi qəbul edilmir. Əgər tələbə daha irəli səviyyəli elementi bilirsə, həmin elementin birbaşa önşərtləri də bilik vəziyyətində mövcud olmalıdır:
\[ \mathcal{K}(G)=\{K\subseteq Q:q_j\in K\Rightarrow Pre(q_j)\subseteq K\} \]
Bu çoxluq qrafa əsasən icazə verilən bütün prerequisite-consistent latent knowledge states vəziyyətlərini ehtiva edir.
Məsələn, \(q_1\rightarrow q_3\) olduqda tələbənin \(q_3\)-ü bildiyi, lakin \(q_1\)-i bilmədiyi vəziyyət \(\mathcal{K}(G)\) daxilində keçərli sayılmır.
4. Ssenari və ya tapşırıq hədəfi
Tədqiqatda “scenario” mürəkkəb kontekstual hekayə kimi modelləşdirilmir. Hər tapşırıq \(c\) hədəflədiyi bilik elementləri çoxluğu ilə təmsil olunur:
\[ \phi(c)\subseteq Q \]
\(\phi(c)\), tapşırıq \(c\)-nin öyrənmə hədəfidir.
Bu fərq vacibdir: bilik qrafı bütün sahənin strukturunu verdiyi halda, \(\phi(c)\) yalnız həmin tapşırıqda hansı bilik elementlərinin hədəf olduğunu müəyyən edir.
5. Gizli tələbə vəziyyəti
Tələbənin həqiqi, lakin birbaşa müşahidə olunmayan bilik vəziyyəti:
\[ K_{u,t}\in\mathcal{K}(G) \]
ilə göstərilir.
Burada:
- \(u\): öyrənən indeksi,
- \(t\): qarşılıqlı əlaqə addımı,
- \(K_{u,t}\): tələbənin həmin anda həqiqətən mənimsədiyi fərz edilən elementlər çoxluğudur.
Real tətbiqdə sistem \(K_{u,t}\)-ni birbaşa görə bilmir. Simulyasiyada hidden state yalnız simulyasiya mühitinin cavab və öyrənmə keçidi yaratması üçün məlumdur.
6. Tələbə vəziyyəti haqqında inam
Sistem tək bir “tələbə bu mövzuları bilir” qərarı vermək əvəzinə mümkün bilik vəziyyətlərinin hamısı üzrə qiymətləndirmə paylanması saxlayır:
\[ \pi_{u,t}^{-}(K)=P(K_{u,t}=K\mid H_{u,t}),\qquad K\in\mathcal{K}(G) \]
\(H_{u,t}\), həmin ana qədər mövcud qarşılıqlı əlaqə tarixçəsidir. Yuxarı indeksdəki “−” mövcud cavab hələ müşahidə edilməzdən əvvəlki predictive distribution vəziyyətini göstərir.
Bu paylanmanın üstünlüyü qeyri-müəyyənliyi saxlamasıdır. Sistem “tələbə mütləq bu vəziyyətdədir” demək əvəzinə, məsələn, bir neçə uyğun bilik vəziyyətinə fərqli ehtimallar verə bilər.
BLIM Tələbənin Bilik Vəziyyətini Necə Yeniləyir?
Basic Local Independence Model (BLIM), tələbənin gizli bilik vəziyyəti ilə müşahidə olunan doğru/yanlış cavab arasında ehtimallı əlaqə qurur; tələbə elementi bilsə belə slip səbəbindən yanlış cavab verə bilər, bilməsə belə guess səbəbindən doğru cavab verə bilər və müşahidə olunan cavab daha sonra Bayes qaydası ilə bütün mümkün bilik vəziyyətlərinin ehtimallarını yeniləyir.
Başlanğıcda həqiqi vəziyyət ilə model inamı niyə ayrıdır?
Simulyasiyadakı gizli başlanğıc vəziyyəti:
\[ K_{u,0}\sim \nu_0^{(c)} \]
ilə nümunələnir.
Burada:
\[ \nu_0^{(c)}(K)=P(K_{u,0}=K\mid c) \]
simulyasiya populyasiyasının həqiqi başlanğıc paylanmasıdır.
Learner-state estimator isə başlanğıcda:
\[ \pi_{u,0}^{-}(K)=p_0^{(c)}(K) \]
prior paylanmasını istifadə edir.
Hər iki paylanma keçərli vəziyyətlər üzərində normallaşdırılır:
\[ \sum_{K\in\mathcal{K}(G)}\nu_0^{(c)}(K) = \sum_{K\in\mathcal{K}(G)}p_0^{(c)}(K) =1 \]
Baseline simulyasiyada:
\[ p_0^{(c)}=\nu_0^{(c)} \]
kimi uyğunlaşdırılmışdır. Bu, estimator baxımından əlverişli şərtdir. Tədqiqatın sensitivity analysis bölməsi prior mismatch üçün \(p_0\)-ı dəyişdirərkən həqiqi population distribution \(\nu_0\)-ı sabit saxlamışdır.
Düyün səviyyəsində təxmin edilən mənimsəmə ehtimalı
Tam ehtimal paylanmasından tək bir elementin təxmin edilən mənimsəmə ehtimalı belə çıxarılır:
\[ \widehat{m}_{u,t,i}^{-} = \sum_{K\in\mathcal{K}(G)} \mathbf{1}(q_i\in K)\pi_{u,t}^{-}(K) \]
Buradakı göstərici funksiyası:
- \(q_i\in K\) olduqda 1,
- əks halda 0
dəyərini alır.
Beləliklə, cəm ehtimal kütləsinin nə qədərinin \(q_i\)-nin artıq bilindiyi vəziyyətlərdə yerləşdiyini hesablayır.
Slip və guess
Tələbə seçilmiş \(q_{u,t}^{*}\) elementinə cavab verir və nəticə:
\[ r_{u,t}\in\{0,1\} \]
ilə göstərilir.
\(r=1\) doğru, \(r=0\) yanlış cavabı ifadə edir.
BLIM doğru cavab ehtimalını:
\[ P(r_{u,t}=1\mid K_{u,t},q_{u,t}^{*})= \begin{cases} 1-s, & q_{u,t}^{*}\in K_{u,t}\\ g, & q_{u,t}^{*}\notin K_{u,t} \end{cases} \]
şəklində müəyyən edir.
Burada:
- \(s\): slip probability; tələbənin əslində bildiyi elementdə yanlış cavab vermə ehtimalıdır.
- \(g\): guess probability; tələbənin əslində bilmədiyi elementdə doğru cavab vermə ehtimalıdır.
Baseline simulyasiyada:
- \(s=0.10\),
- \(g=0.20\)
istifadə edilmişdir.
Buna görə doğru cavab “tələbə mütləq bilir”, yanlış cavab isə “tələbə mütləq bilmir” demək deyil.
Bayes yenilənməsi
Cavab müşahidə edildikdən sonra bilik vəziyyətlərinin ehtimalları:
\[ \pi_{u,t}^{+}(K) = \frac{ P(r_{u,t}\mid K,q_{u,t}^{*})\pi_{u,t}^{-}(K) }{ \sum_{L\in\mathcal{K}(G)} P(r_{u,t}\mid L,q_{u,t}^{*})\pi_{u,t}^{-}(L) } \]
ilə yenilənir.
\(\pi^{+}\), cavab müşahidə edildikdən sonrakı filtering posterior-dur.
Surət hissəsi iki elementi vurur:
- cavabın həmin bilik vəziyyətində müşahidə olunma ehtimalı,
- cavabdan əvvəl həmin vəziyyətin ehtimalı.
Məxrəc isə bütün mümkün vəziyyətlər üzrə normallaşdırma aparır və posterior ehtimalların cəmini yenidən 1-ə gətirir.
Önşərtə hazır olma göstəricisi
Bilik vəziyyətində \(q_i\)-nin bütün birbaşa önşərtləri mənimsənilibsə:
\[ R_i(K)=\mathbf{1}[Pre(q_i)\subseteq K] \]
dəyəri 1 olur.
Root item üçün \(Pre(q_i)=\varnothing\) olduğundan bu şərt avtomatik ödənir.
Cavabdan asılı öyrənmə ehtimalı
Tələbə hələ \(q_i\)-ni bilmirsə və önşərtlər hazırdırsa acquisition probability:
\[ \rho_i(r)= \begin{cases} \alpha_c(1-d_i), & r=1\\ \alpha_e(1-d_i), & r=0 \end{cases} \]
şəklindədir.
Burada:
- \(d_i\in[0,1]\): elementin difficulty parametri,
- \(\alpha_c\): doğru cavabdan sonra əsas acquisition rate,
- \(\alpha_e\): yanlış cavabdan sonra əsas acquisition rate-dir.
Model:
\[ \alpha_c>\alpha_e \]
fərziyyəsindən istifadə edir.
Baseline:
- \(\alpha_c=0.30\),
- \(\alpha_e=0.10\).
\((1-d_i)\) vurğu amilinə görə difficulty artdıqca eyni cavab altında acquisition probability azalır.
Öyrənmə keçidi
Mənbədə Equation (16) seçilmiş elementin yeni gizli bilik vəziyyətinə necə keçə biləcəyini tam transition kernel ilə müəyyən edir.
Xülasə məntiq belədir:
- element bilinmir və önşərtlər hazırdırsa, \(\rho_i(r)\) ehtimalı ilə bilik vəziyyətinə əlavə oluna bilər;
- eyni şəraitdə \(1-\rho_i(r)\) ehtimalı ilə vəziyyət dəyişmədən qala bilər;
- element artıq bilinirsə və ya prerequisites hazır deyilsə, vəziyyət dəyişmir;
- başqa keçidlərin ehtimalı 0-dır.
Bu transition monotonic kimi müəyyən edilmişdir: əldə edilən bilik modeldə itmir. Forgetting bu simulyasiyaya daxil edilməmişdir.
Simulyasiya mühitində yeni həqiqi vəziyyət:
\[ K_{u,t+1}\sim T_i^{(r_{u,t})}(K_{u,t},\cdot) \]
ilə nümunələnir.
Learner-state estimator isə posterior paylanmanı eyni transition kernel vasitəsilə:
\[ \pi_{u,t+1}^{-}(K') = \sum_{K\in\mathcal{K}(G)} T_i^{(r_{u,t})}(K,K')\pi_{u,t}^{+}(K) \]
şəklində irəli daşıyır.
Beləliklə, yeni qarşılıqlı əlaqə başlayanda sistemin əlində yenilənmiş predictive distribution olur.
TEKS Növbəti Elementi Hansı Formula ilə Seçir?
TEKS əvvəlcə tapşırığın hədəfi və bütün recursive prerequisites əsasında namizəd əhatəsini yaradır, sonra hər namizəd üçün növbəti qarşılıqlı əlaqədə yeni mənimsənilmə ehtimalını hesablayır, bu ehtimalı qraf üzərində hədəfə yaxınlıqla gücləndirir və ən yüksək target-adjusted acquisition score-a malik elementi seçir.
Hədəfə bağlı namizəd əhatəsi
Tapşırıq \(c\) üçün namizəd əhatəsi:
\[ \Omega(c)=\phi(c)\cup Pre^{*}(\phi(c)) \]
ilə müəyyən edilir.
\(Pre^{*}\), hədəflərin yalnız birbaşa deyil, bütün recursive prerequisite ancestors-larını ifadə edir.
Buna görə sistem bütün \(Q\) kainatından təsadüfi seçim etmək əvəzinə hədəflə struktur baxımından əlaqəli elementlərə fokuslanır.
Bir addımda mənimsəmə ehtimalı: Gain
TEKS-in mərkəzi kəmiyyəti:
\[ Gain_{u,t}(q_i) = \sum_{K\in\mathcal{K}(G)} \pi_{u,t}^{-}(K) \sum_{r\in\{0,1\}} P(r\mid K,q_i) \sum_{K'\in\mathcal{K}(G)} T_i^{(r)}(K,K') \left[ \mathbf{1}(q_i\in K')-\mathbf{1}(q_i\in K) \right] \]
ifadəsidir.
Formula ilk baxışda mürəkkəb görünsə də, üç qeyri-müəyyənliyi birlikdə ortalayır:
- Tələbə hazırda hansı gizli vəziyyətdə ola bilər? — \(\pi^{-}(K)\)
- Seçilən elementə doğru, yoxsa yanlış cavab verə bilər? — \(P(r\mid K,q_i)\)
- Cavabdan sonra hansı yeni bilik vəziyyətinə keçə bilər? — \(T_i^{(r)}(K,K')\)
Son kvadrat mötərizə:
\[ \mathbf{1}(q_i\in K')-\mathbf{1}(q_i\in K) \]
yalnız \(q_i\) mövcud vəziyyətdə bilinmədiyi halda növbəti vəziyyətdə mənimsəniləndə 1 olur.
Beləliklə, \(Gain_{u,t}(q_i)\), mənbədə izah edildiyi kimi, namizəd elementin növbəti qarşılıqlı əlaqədə yeni mənimsənilməsinin təxmin edilən ehtimalıdır.
Hədəfə yönlü məsafə
Namizədin target item-a yönlü prerequisite-to-dependent yolu boyunca məsafəsi:
\[ D_c^{tar}(q_i) = \min_{q_g\in\phi(c)} dist_G(q_i,q_g) \]
şəklindədir.
Hədəfə yaxınlıq skoru:
\[ Rel_c(q_i)=\frac{1}{1+D_c^{tar}(q_i)} \]
kimi müəyyən edilir.
Nəticədə:
- target item üçün \(D=0\) və \(Rel=1\),
- hədəfdən bir kənar uzaqlıqdakı prerequisite üçün \(Rel=1/2\),
- iki kənar uzaqlıqda \(Rel=1/3\)
olur.
Bu nümunələr birbaşa formulun riyazi nəticəsidir; yeni eksperimental nəticə deyil.
TEKS utility skoru
Yekun TEKS skoru:
\[ U_{u,t}^{TEKS}(q_i) = Gain_{u,t}(q_i) \left[ 1+\lambda_{rel}Rel_c(q_i) \right] \]
şəklindədir.
\(\lambda_{rel}\geq0\), target relevance adjustment-ın gücünü müəyyən edir.
Baseline tədqiqatda:
\[ \lambda_{rel}=1.0 \]
istifadə edilmişdir.
\(\lambda_{rel}=0\) olduqda:
\[ U^{TEKS}=Gain \]
olur; yəni qraf-əsaslı relevance vurğu amili aradan qalxır və üsul yalnız predictive one-step acquisition scoring formasına çevrilir.
Sensitivity analysis-də \(\lambda_{rel}=0\) şəraitində belə TEKS–PW-MG fərqinin davam etməsi, TEKS ilə PW-MG arasındakı fərqin yalnız relevance vurğu amilindən qaynaqlanmadığını; expected-acquisition hesabının da ayrıca töhfə verdiyini göstərir. Lakin mənbə bu nəticəni \(\lambda_{rel}=1.0\)-ın optimal olması kimi şərh etmir.
Seçim qaydası
Növbəti element:
\[ q_{u,t}^{*} = \arg\max_{q_i\in\Omega(c)} U_{u,t}^{TEKS}(q_i) \]
ilə seçilir.
Yəni namizəd əhatəsindəki bütün elementlər qiymətləndirilir və ən böyük TEKS skoruna malik olan seçilir.
Bərabər skor yarandıqda mənbə node identifier daha kiçik olan namizədi seçərək tie-breaking tətbiq edir.
TEKS uzun müddəti optimallaşdırırmı?
Xeyr. TEKS mənbədə açıq şəkildə myopic one-step selection kimi müəyyən edilir. Hər addımda növbəti qarşılıqlı əlaqəyə baxır; reinforcement learning kimi uzunmüddətli cumulative reward üçün bütün gələcəyi birbaşa optimallaşdırmır.
Bu, modelin şərh edilə bilməsini artırsa da, uzunmüddətli optimal öyrənmə yoluna zəmanət verildiyi demək deyil.
PW-MG ilə əsas fərq nədir?
PW-MG üçün əvvəlcə birbaşa prerequisites-in mənimsənilmiş olma ehtimalı:
\[ \widehat{R}_{u,t,i}^{-} = \sum_{K\in\mathcal{K}(G)} \mathbf{1}[Pre(q_i)\subseteq K] \pi_{u,t}^{-}(K) \]
hesablanır.
PW-MG skoru:
\[ U_{u,t}^{PW-MG}(q_i) = \left(1-\widehat{m}_{u,t,i}^{-}\right) \widehat{R}_{u,t,i}^{-} \]
şəklindədir.
Burada:
- \(1-\widehat{m}^{-}\): mastery gap, yəni namizədin hələ bilinməmə ehtimalı,
- \(\widehat{R}^{-}\): prerequisites-in hazır olma ehtimalıdır.
PW-MG beləliklə “çatışmayan və önşərtləri hazır” namizədləri önə çıxarır.
TEKS isə bunun əvəzinə namizədin həqiqətən növbəti addımda mənimsənilmə ehtimalını response və transition modeli üzərindən hesablayır və hədəfə olan graph relevance ilə tənzimləyir.
TEKS-in dörd müqayisə üsulu arasındakı mövqeyi
| Strategiya | Adaptivdirmi? | Prerequisite istifadəsi | Əsas seçim məntiqi |
|---|---|---|---|
| TEKS | Bəli | Bəli | Predictive one-step acquisition + target relevance |
| PW-MG | Bəli | Bəli | Mastery gap × prerequisite readiness |
| Static | Xeyr | Topoloji ardıcıllıqdan istifadə edir | Əvvəlcədən müəyyən edilmiş deterministik proqram |
| Random | Xeyr | Seçim skorunda istifadə etmir | \(\Omega(c)\) daxilindən uniform random seçim |
Simulyasiyada istifadə olunan üç bilik strukturu
Simmetrik şaxələnmə qrafı
Mənbədə səkkiz düyünlü struktur aşağıdakı kənarlardan ibarətdir:
\[ E_{sym}= \{ (q_1,q_3),(q_1,q_4),(q_2,q_5),(q_2,q_6), (q_3,q_7),(q_5,q_7),(q_4,q_8),(q_6,q_8) \} \]
İki tapşırıq şəraiti vardır:
\[ \phi(c_A)=\{q_7\} \]
\[ \Omega(c_A)=\{q_1,q_2,q_3,q_5,q_7\} \]
və:
\[ \phi(c_B)=\{q_8\} \]
\[ \Omega(c_B)=\{q_1,q_2,q_4,q_6,q_8\} \]
Bu iki şərait eyni target depth, prerequisite sayı və path structure-a malikdir. Buna görə mənbə \(c_A\) və \(c_B\)-ni iki müstəqil qraf nəticəsi kimi deyil, symmetry check kimi birlikdə şərh edir.
Asimmetrik birləşmə qrafı
Altı düyünlü struktur:
\[ E_{asym} = \{ (q_1,q_3),(q_3,q_5),(q_2,q_4),(q_5,q_6),(q_4,q_6) \} \]
kimi müəyyən edilmişdir.
Burada:
\[ q_1\rightarrow q_3\rightarrow q_5\rightarrow q_6 \]
daha uzun şaxəni,
\[ q_2\rightarrow q_4\rightarrow q_6 \]
daha qısa şaxəni yaradır.
Hədəf və namizəd əhatəsi:
\[ \phi(c_{asym})=\{q_6\} \]
\[ \Omega(c_{asym})=\{q_1,q_2,q_3,q_4,q_5,q_6\} \]
şəklindədir.
Xətti önşərt zənciri
Xətti struktur:
\[ q_1\rightarrow q_2\rightarrow q_3\rightarrow q_4\rightarrow q_5\rightarrow q_6 \]
şəklindədir.
Burada hədəf \(q_6\)-dır və altı düyünün hamısı candidate scope daxilindədir.
Bu strukturda alternativ prerequisite branch olmadığı üçün ardıcıllıq üsullarının fərqli seçim edə biləcəyi məkan şaxələnən qraflarla müqayisədə xeyli məhduddur.
Difficulty necə təyin edilir?
Düyünün difficulty dəyəri topological depth-dən törədilmişdir:
\[ d_i = 0.2+ 0.6 \frac{depth(q_i)} {\max_{q_j\in Q}depth(q_j)} \]
Source node-lar üçün depth=0 olduğuna görə:
\[ d_i=0.2 \]
olur.
Maksimum dərinlikdəki düyün üçün nisbət 1 olduğuna görə:
\[ d_i=0.8 \]
alınır.
Beləliklə, difficulty dəyərləri mənbədə bildirildiyi kimi 0.2–0.8 aralığında dəyişir.
Qraf şərtlərinin vəziyyət fəzası
| Şərait | Hədəf | |Ω(c)| | |K(G)| | |K0(c)| |
|---|---|---|---|---|
| Simmetrik şaxələnmə \(c_A\) | q7 | 5 | 34 | 9 |
| Simmetrik şaxələnmə \(c_B\) | q8 | 5 | 34 | 9 |
| Asimmetrik birləşmə | q6 | 6 | 13 | 12 |
| Xətti zəncir | q6 | 6 | 7 | 6 |
Başlanğıc səriştə qrupları
Başlanğıc vəziyyət dəstəyi:
\[ \mathcal{K}_0(c) = \{ K\in\mathcal{K}(G): K\subseteq\Omega(c),\; \phi(c)\nsubseteq K \} \]
ilə müəyyən edilir.
Bu şərt iki işi görür:
- başlanğıc biliyini tapşırığın candidate scope-u daxilində saxlayır;
- hədəf çoxluğunun hamısını artıq mənimsəmiş tələbələri başlanğıcdan çıxarır.
Vəziyyətin başlanğıc mastery proportion dəyəri:
\[ m_0(K)= \frac{|K\cap\Omega(c)|}{|\Omega(c)|} \]
kimi hesablanır.
Qruplar:
- Aşağı səriştə: \(m_0(K)<1/3\)
- Orta səriştə: \(1/3\leq m_0(K)<2/3\)
- Yüksək səriştə: \(m_0(K)\geq2/3\)
şəklindədir.
Balanced population initial-state distribution bu üç səriştə qrupunun hər birinə ümumi ehtimal kütləsinin \(1/3\)-ni verir və qrup daxilindəki keçərli vəziyyətlərə bu kütləni bərabər paylayır.
Tədqiqatın Metodu və Nəticələri
Simulyasiya dizaynı
| Parametr | Dəyər | Mənası |
|---|---|---|
| Virtual öyrənən / təkrar \(N\) | 200 | Hər müstəqil təkrardakı virtual learner sayı |
| Decision horizon \(T\) | 90 | Hər öyrənən üçün item-selection/response addımı |
| Müstəqil təkrar \(R\) | 30 | Statistik müqayisənin təkrar səviyyəli nümunə sayı |
| Slip \(s\) | 0.10 | Bilinən elementdə yanlış cavab ehtimalı |
| Guess \(g\) | 0.20 | Bilinməyən elementdə doğru cavab ehtimalı |
| \(\alpha_c\) | 0.30 | Doğru cavabdan sonrakı base acquisition rate |
| \(\alpha_e\) | 0.10 | Yanlış cavabdan sonrakı base acquisition rate |
| \(\lambda_{rel}\) | 1.0 | Target relevance adjustment gücü |
| Difficulty | 0.2–0.8 | Topological depth-dən törədilmiş interval |
| Forgetting | Xaric edilib | Mastered item itirilmir |
| Early stopping | Yoxdur | Bütün öyrənənlər sabit horizon-u tamamlayır |
Müqayisənin ədalətli saxlanması üçün nə bərabərləşdirildi?
Dörd üsul eyni:
- initial-state generation,
- response model,
- state-transition mechanism,
- candidate scope,
- interaction budget
şərtlərindən istifadə etmişdir.
Hər learner/repetition üçün eyni hidden initial state üsullar arasında paylaşılmışdır. Paired strategy comparisons üçün common random numbers istifadə edilmiş; müəyyən graph, repetition, learner və decision step üçün strategiyalar eyni response və acquisition uniform draws-ları paylaşmışdır.
Bu dizaynın məqsədi üsullar arasındakı fərqi təsadüfi nümunələmə səs-küyündən mümkün qədər ayırmaqdır.
Static strategiyasının proqramı
Static baseline namizədləri əvvəlcə topological level, sonra node identifier sırası ilə dövr edir.
Əsas quota:
\[ \left\lfloor\frac{T}{|\Omega(c)|}\right\rfloor \]
kimi hesablanır.
\(T=90\) üçün:
- simmetrik şərtlərdə 5 namizəd olduğuna görə hər namizəd 18 dəfə,
- asimmetrik və linear şərtlərdə 6 namizəd olduğuna görə hər namizəd 15 dəfə
seçilir.
Üç qiymətləndirmə metriyi
1. Final target mastery
\[ M_u^{tar}(T) = \frac{|K_{u,T}\cap\phi(c)|}{|\phi(c)|} \]
Bu metrik horizon sonunda hədəf çoxluğunun nə qədərinin mənimsənildiyini göstərir.
Bu tədqiqatda bütün target set-lər tək elementlidir. Buna görə learner-level dəyər 0 və ya 1-dir; cədvəllərdəki onluq nəticələr 200 öyrənənin və təkrarların ümumiləşdirilməsi ilə yaranır.
2. Mean target mastery over time
\[ \overline{M}_u^{tar} = \frac{1}{T+1} \sum_{t=0}^{T} \frac{|K_{u,t}\cap\phi(c)|}{|\phi(c)|} \]
Bu dəyər yalnız 90. addımdakı nəticəni deyil, bütün trajectory boyunca hədəfə nə qədər erkən çatıldığını da nəzərə alır.
Mənbə bunu target-mastery trajectory-nin normallaşdırılmış discrete area under the curve qarşılığı kimi izah edir.
3. Final scope mastery
\[ M_u^{\Omega}(T) = \frac{|K_{u,T}\cap\Omega(c)|}{|\Omega(c)|} \]
Bu metrik yalnız hədəf düyününü deyil, hədəflə əlaqəli prerequisites daxil olmaqla bütün task-specific scope daxilindəki öyrənmə səviyyəsini ölçür.
Statistik təhlil necə aparıldı?
Statistik nəticəçıxarma learner səviyyəsində deyil, repetition səviyyəsində aparılmışdır.
Hər repetition daxilində 200 öyrənənin nəticələri əvvəlcə ortalanmışdır. Beləliklə, hər strategy × condition üçün 30 repetition-level mean əldə edilmişdir.
TEKS ilə hər baseline arasındakı cütləşdirilmiş fərqlər:
\[ D_r= \text{TEKS}_r-\text{Baseline}_r \]
məntiqi ilə qiymətləndirilmişdir.
Primary comparisons üçün two-sided paired t-test istifadə edilmişdir.
Hesabat verilən elementlər:
- mean paired difference,
- %95 t confidence interval,
- paired Cohen's \(d_z\),
- p dəyəri,
- primary branching analyses üçün Holm-adjusted p dəyəri
şəklindədir.
Paired Cohen's dz nəyi göstərir?
Mənbənin Equation (40)-ı:
\[ d_z=\frac{\overline{D}}{s_D} \]
şəklindədir.
Burada:
- \(\overline{D}\): 30 təkrardakı paired differences-ın ortalaması,
- \(s_D\): həmin paired differences-ın sample standard deviation dəyəridir.
\(d_z\), TEKS ilə baseline arasındakı orta cütləşdirilmiş fərqi bu fərqlərin standart sapması vahidində ifadə edir.
Bu təsir ölçüsü real tələbələrdə təhsil təsirinin standartlaşdırılmış böyüklüyü kimi şərh edilməməlidir; bu tədqiqatda simulyasiya təkrarları arasındakı paired strategy difference-ın böyüklüyüdür.
Holm düzəlişi niyə istifadə edildi?
Hər simmetrik hədəf şəraitində üç outcome × üç TEKS–baseline contrast = doqquz test yaranır. Çox sayda hipotez testi aparıldıqda təsadüfən kiçik p dəyərləri əldə etmə ehtimalı arta bildiyi üçün paired t-test p dəyərlərinə Holm correction tətbiq edilmişdir.
\(c_A\) və \(c_B\) üçün correction ayrı-ayrılıqda aparılmışdır. İki şərt structurally isomorphic olduğuna və coupled random streams istifadə etdiyinə görə nəticələr symmetry check kimi şərh edilmişdir.
Asimmetrik qraf ayrıca doqquz testlik ailə yaratmışdır.
Linear chain isə secondary structural analysis olduğuna görə Holm-adjusted primary family-yə daxil edilməmiş və p dəyərləri unadjusted olaraq verilmişdir.
Wilcoxon signed-rank testləri supplement-də unadjusted robustness check kimi hesabatlanmışdır.
Simmetrik şaxələnmə qrafındakı əsas nəticələr
| Strategiya | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.6263 (0.0388) | 0.3235 (0.0267) | 0.8714 (0.0145) |
| PW-MG | 0.5508 (0.0333) | 0.2979 (0.0270) | 0.8161 (0.0160) |
| Static | 0.2847 (0.0415) | 0.0318 (0.0046) | 0.7776 (0.0147) |
| Random | 0.1908 (0.0239) | 0.0913 (0.0137) | 0.7370 (0.0139) |
TEKS–PW-MG paired nəticələri:
| Metrik | Orta fərq | %95 CI | Cohen's dz | Holm-adjusted p |
|---|---|---|---|---|
| Final target mastery | 0.0755 | [0.0641, 0.0869] | 2.48 | 8.39 × 10⁻¹⁴ |
| Mean target mastery over time | 0.0256 | [0.0200, 0.0312] | 1.71 | 2.79 × 10⁻¹⁰ |
| Final scope mastery | 0.0552 | [0.0499, 0.0605] | 3.89 | 8.86 × 10⁻¹⁹ |
Eyni TEKS–PW-MG nəticələri \(c_B\) üçün də əldə edilmişdir.
TEKS və PW-MG başlanğıc addımlarda bir-birinə yaxın target-mastery trajectories göstərmiş, qərar üfüqünün sonrakı hissəsində TEKS-in orta trajectory-si daha yüksək olmuşdur.
Maraqlıdır ki, TEKS seçimlərinin %52,31-ni target node-a ayırdığı halda, PW-MG %59,24-nü target node-a ayırmışdır. Buna baxmayaraq, TEKS target mastery-də daha yüksək nəticə vermişdir.
Mənbə bunu belə izah edir: predictive state distribution-ın mühüm hissəsi target prerequisites-in hələ hazır olmadığı vəziyyətlərə aiddirsə, bu vəziyyətlər target-ın one-step acquisition gain hesabına sıfır töhfə verir. Beləliklə, TEKS bəzi mərhələlərdə birbaşa hədəfi yenidən seçmək əvəzinə hələ mənimsənilməmiş prerequisites-ə yönəlir.
Asimmetrik birləşmə qrafındakı nəticələr
| Strategiya | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.4858 (0.0366) | 0.2157 (0.0187) | 0.8312 (0.0150) |
| PW-MG | 0.4215 (0.0282) | 0.1963 (0.0185) | 0.7770 (0.0173) |
| Static | 0.1598 (0.0254) | 0.0151 (0.0028) | 0.7129 (0.0100) |
| Random | 0.0848 (0.0201) | 0.0360 (0.0092) | 0.6620 (0.0140) |
| Metrik | Orta fərq | %95 CI | Cohen's dz | Holm-adjusted p |
|---|---|---|---|---|
| Final target mastery | 0.0643 | [0.0536, 0.0751] | 2.24 | 1.06 × 10⁻¹² |
| Mean target mastery over time | 0.0194 | [0.0142, 0.0247] | 1.37 | 2.72 × 10⁻⁸ |
| Final scope mastery | 0.0542 | [0.0490, 0.0594] | 3.92 | 7.28 × 10⁻¹⁹ |
TEKS bu strukturda seçimlərin:
- %39,08-ni uzun prerequisite branch-ə,
- %17,62-ni qısa branch-ə,
- %43,30-nu target node-a
ayırmışdır.
PW-MG üçün müvafiq dəyərlər:
- %38,01 uzun branch,
- %14,35 qısa branch,
- %47,65 target
kimi bildirilmişdir.
TEKS Xətti Önşərt Zəncirində də PW-MG-dən Üstündürmü?
Target-level meyarlarda xeyr: xətti zəncirdə TEKS ilə PW-MG arasındakı final target mastery fərqi 0.0095 və \(p=0.061\), mean target mastery over time fərqi −0.0009 və \(p=0.728\) olmuş, hər iki etibar intervalı sıfırı əhatə etmişdir; TEKS-in aydın üstünlüyü final scope mastery-də görülmüşdür.
| Strategiya | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.4128 (0.0423) | 0.1939 (0.0224) | 0.7658 (0.0184) |
| PW-MG | 0.4033 (0.0475) | 0.1948 (0.0282) | 0.7388 (0.0225) |
| Static | 0.1338 (0.0282) | 0.0122 (0.0028) | 0.6349 (0.0214) |
| Random | 0.0818 (0.0220) | 0.0417 (0.0129) | 0.5720 (0.0180) |
| Metrik | Orta fərq | %95 CI | dz | p |
|---|---|---|---|---|
| Final target mastery | 0.0095 | [−0.0005, 0.0195] | 0.36 | 0.061 |
| Mean target mastery over time | −0.0009 | [−0.0059, 0.0042] | −0.06 | 0.728 |
| Final scope mastery | 0.0271 | [0.0209, 0.0332] | 1.65 | 6.39 × 10⁻¹⁰ |
Bu p dəyərləri secondary linear analysis üçün unadjusted-dır.
Mənbənin şərhinə görə xətti struktur seçimləri ciddi şəkildə məhdudlaşdırır. Bir neçə prerequisite branch seçim üçün rəqabət aparmadıqda TEKS və PW-MG-nin seçim qaydaları target-level nəticələrdə daha az fərqlənir.
Başlanğıc səriştəsinə görə nəticələr
| Qrup | Strategiya | Final target | Mean target | Final scope |
|---|---|---|---|---|
| Aşağı | TEKS | 0.4006 | 0.1319 | 0.7682 |
| PW-MG | 0.2787 | 0.0884 | 0.6596 | |
| Static | 0.1972 | 0.0219 | 0.6803 | |
| Random | 0.0479 | 0.0106 | 0.5995 | |
| Orta | TEKS | 0.5593 | 0.2295 | 0.8601 |
| PW-MG | 0.4480 | 0.1736 | 0.8000 | |
| Static | 0.2530 | 0.0280 | 0.7683 | |
| Random | 0.1331 | 0.0458 | 0.7309 | |
| Yüksək | TEKS | 0.9130 | 0.6039 | 0.9826 |
| PW-MG | 0.9188 | 0.6266 | 0.9838 | |
| Static | 0.3998 | 0.0452 | 0.8800 | |
| Random | 0.3876 | 0.2154 | 0.8775 |
Aşağı proficiency qrupunda TEKS − PW-MG fərqləri:
- final target mastery: 0.1219,
- mean target mastery: 0.0436,
- final scope mastery: 0.1086.
Orta qrupda müvafiq fərqlər:
- 0.1113,
- 0.0559,
- 0.0601.
Yüksək proficiency qrupunda isə PW-MG hər üç meyarda bir qədər daha yüksək orta dəyər vermişdir; TEKS − PW-MG fərqləri müvafiq olaraq:
- −0.0058,
- −0.0227,
- −0.0012
olmuşdur.
Mənbə bu subgroup comparisons-ı exploratory and descriptive kimi təsnif edir; əsas təsdiqləyici nəticə kimi şərh etmir.
Həssaslıq təhlili
One-factor-at-a-time sensitivity analysis yalnız iki symmetric target condition üzərində aparılmışdır.
| Amil | Baseline | Alternativ şərtlər |
|---|---|---|
| \(\lambda_{rel}\) | 1.0 | 0.0, 0.5, 2.0 |
| Decision horizon \(T\) | 90 | 60, 120 |
| Response noise \((s,g)\) | (0.10, 0.20) | (0.05, 0.10), (0.15, 0.30) |
| Acquisition \((\alpha_c,\alpha_e)\) | (0.30, 0.10) | (0.20, 0.05), (0.40, 0.15) |
| Difficulty function | 0.2 + 0.6h/hmax | 0.1 + 0.5h/hmax; 0.3 + 0.6h/hmax |
| Diagnostic prior | \(p_0=\nu_0\) | \(\mathcal{K}_0(c)\) üzərində uniform |
Araşdırılan 12 şəraitdə TEKS − PW-MG mean paired difference:
- final target mastery üçün 0.0300–0.1048,
- mean target mastery over time üçün 0.0033–0.0407,
- final scope mastery üçün 0.0212–0.0878
aralığında dəyişmişdir.
Slow-acquisition şəraitində mean target mastery over time fərqi 0.0033 və %95 CI [−0.0002, 0.0069] kimi bildirilmiş; etibar intervalı sıfırı əhatə etmişdir.
Ən böyük final-target fərqi \(\lambda_{rel}=0\) şəraitində görülmüşdür. Bu, predictive expected-acquisition komponentinin relevance multiplier olmadan da PW-MG-dən fərqlənməyə töhfə verdiyini göstərir. Lakin bu, baseline \(\lambda_{rel}=1.0\)-ın optimal olduğu nəticəsini vermir.
Təhlil one-factor-at-a-time olduğu üçün response noise, acquisition speed, difficulty, horizon və prior arasındakı qarşılıqlı təsirlər araşdırılmamışdır.
Bu Tədqiqat TEKS-in Real Tələbələrdə Daha Yaxşı Öyrənmə Təmin Etdiyini Sübut Edirmi?
Xeyr. Bütün performans nəticələri əvvəlcədən müəyyən edilmiş learner initialization, response-error, acquisition, difficulty və transition fərziyyələri altında işləyən virtual öyrənənlərdən əldə edilmişdir; real tələbə qarşılıqlı əlaqəsi, sinif tətbiqi, davamlılıq, öyrənmə transferi və ya tədris istifadəliliyi bu tədqiqatda ölçülməmişdir.
Tədqiqatın dəstəklədiyi nəticələr
- TEKS-in prerequisite constraints, task-specific targets və learner-state uncertainty-ni vahid next-item scoring qaydasında birləşdirən riyazi çərçivəsi müəyyən edilmişdir.
- Nəzarət olunan symmetric branching və asymmetric converging simulyasiyalarında TEKS üç əsas performans metrikinə görə PW-MG, Static və Random-dan daha yüksək orta nəticələr yaratmışdır.
- Branching strukturlarda TEKS ilə PW-MG arasındakı target-level fərqlər confidence interval baxımından sıfırdan ayrılmışdır.
- Linear prerequisite chain-də target-level TEKS–PW-MG fərqi nəzərəçarpacaq dərəcədə azalmış və iki target metriki üzrə CI sıfırı əhatə etmişdir.
- TEKS linear chain-də final scope mastery baxımından PW-MG-dən daha yüksək nəticə vermişdir.
- Aşağı və orta initial-proficiency qruplarında symmetric condition altında TEKS orta dəyərləri PW-MG-dən daha yüksək olmuşdur.
- Yüksək-proficiency subgroup-da PW-MG bir qədər daha yüksək orta dəyərlər vermişdir.
- TEKS–PW-MG fərqinin branching structures altında daha nəzərəçarpan olduğu müşahidə edilmişdir.
- Sensitivity analysis nəticələri TEKS–PW-MG fərqinin magnitude-unun simulyasiya parametrlərinə görə dəyişdiyini göstərir.
Tədqiqatın dəstəkləmədiyi nəticələr
- TEKS-in real tələbələrdə öyrənmə nailiyyətini artırdığı sübut edilməmişdir.
- TEKS-in bütün prerequisite graph strukturlarında PW-MG-dən üstün olduğu deyilə bilməz.
- \(\lambda_{rel}=1.0\)-ın optimal dəyər olduğu göstərilməmişdir.
- TEKS-in uzunmüddətli optimal öyrənmə yolu yaratdığı sübut edilməmişdir.
- Model forgetting, transfer between unselected items və ya time-varying acquisition-ı təmsil etmir.
- Real response və learning transition proseslərinin BLIM və istifadə olunan transition kernel ilə tam şəkildə təmsil edildiyi təsdiqlənməmişdir.
- Böyük knowledge graph-larda real işləmə müddəti və ya peak memory benchmark-ı hesabatlanmamışdır.
- Authentic curriculum, engagement, feedback formatı, cognitive load və ya time constraint modelin mövcud seçim skoruna daxil edilməmişdir.
- Simulyasiyadakı statistik əhəmiyyətlilik real təhsil mühitində praktik/tədris əhəmiyyətinin sübutu deyil.
Hesablama miqyaslana bilməsi
Mənbə exact implementation üçün:
- \(S=|\mathcal{K}(G)|\): prerequisite-consistent state-space ölçüsü,
- \(M=|\Omega(c)|\): task-specific candidate scope ölçüsü
kimi müəyyən edir.
BLIM measurement update və predictive propagation active state support-a görə xətti miqyaslandığı halda, bütün TEKS candidate-larının qiymətləndirilməsi üçün mənbə konservativ tam-dəstək mürəkkəbliyini:
\[ O(MS) \]
kimi verir.
Əsas miqyaslanma problemi yalnız \(O(MS)\) hasili deyil; prerequisite-consistent feasible-state enumeration bilik elementlərinin sayı artdıqca eksponensial şəkildə arta bilər.
Tədqiqatdakı strukturlar:
- symmetric graph: 34 feasible state,
- asymmetric graph: 13 feasible state,
- linear chain: 7 feasible state
ehtiva edir.
Mənbə original formal runs üçün etibarlı wall-clock runtime və ya peak-memory ölçmələrini saxlamadığını açıq şəkildə bildirir. Buna görə Verianla yeni performans/müddət təxmini yaratmır.
Əsas məhdudiyyətlər
1. Controlled simulation: Real tələbə məlumatı istifadə edilməmişdir.
2. Model-environment alignment: Baseline experiments-də learner-state estimator ilə simulation environment eyni response və transition formalarından istifadə edir və diagnostic prior population distribution ilə uyğunlaşdırılmışdır.
3. Məhdud misspecification: Prior mismatch araşdırılmışdır, lakin real response və ya learning process-in modelə daha geniş şəkildə uyğun gəlməməsi sınaqdan keçirilməmişdir.
4. Kiçik DAG-lər: Yalnız 8 və ya 6 düyünlü kiçik directed acyclic graphs istifadə edilmişdir.
5. Singleton targets: Hər condition tək target item ehtiva edir.
6. Monotonic acquisition: Forgetting yoxdur.
7. Transfer yoxdur: Seçilməyən elementlər arasında öyrənmə transferi modelləşdirilməmişdir.
8. Sabit acquisition parameters: Acquisition dərəcələri zamanla və ya tələbəyə görə dəyişmir.
9. Binary responses: Hər interaction yalnız bir bilik elementi və binary response ehtiva edir.
10. Myopic utility: TEKS uzun-horizon optimal plan axtarmır.
11. Kontekstual xüsusiyyətlər yoxdur: Resource format, feedback type, time constraint, cognitive load və learner engagement seçim modelində yer almır.
12. Böyük miqyaslı benchmark yoxdur: Runtime və peak-memory ölçməsi hesabatlanmamışdır.
13. Real təhsil mənası məlum deyil: Simulyasiyadakı fərqlərin real dünyada mənalı learning gain-ə çevrilib-çevrilmədiyi bu tədqiqatdan çıxarıla bilməz.
Gələcək tədqiqat təklifləri
Mənbə gələcəkdə:
- daha böyük və müxtəlif prerequisite structures,
- müxtəlif akademik sahələrdən authentic curriculum graphs,
- non-singleton target sets,
- multi-skill activities,
- forgetting,
- nonstationary acquisition,
- misspecified response models,
- misspecified transition models,
- approximate və ya decomposed inference,
- multistep planning və reinforcement-learning müqayisələri,
- authentic learner interaction data,
- predictive calibration,
- observed learning outcomes,
- persistence,
- instructional usability
üzrə qiymətləndirmə aparılmasını təklif edir.
Mənbə və Metod Qeydi
Orijinal başlıq: A Knowledge–Scenario–Learner Framework for Target-Oriented Adaptive Sequencing: A Simulation-Based Proof-of-Concept Study.
Müəlliflər: Bingqian Li; Hongwei Guo; Jia Hao; Xiaobei Jiang; Hongwei Niu.
Müəllif sırası: Mənbədəki sıra olduğu kimi qorunmuşdur.
Bərabər töhfə: Mənbədə equal-contribution bəyanı yoxdur.
Məsul müəllif: Hongwei Guo.
Qurum: School of Mechanical Engineering, Beijing Institute of Technology, 5 Zhongguancun South Street, Beijing 100081, China.
Jurnal: Education Sciences.
Bölmə: Technology Enhanced Education.
Nəşriyyat: MDPI, Basel, Switzerland.
Cild / nömrə / məqalə nömrəsi: 16(8), 1344.
DOI: 10.3390/educsci16081344.
Rəsmi keçid: https://doi.org/10.3390/educsci16081344
Received: 28 June 2026.
Revised: 15 August 2026.
Accepted: 19 August 2026.
Published: 21 August 2026.
Mənbə növü: Article; simulation-based proof-of-concept study.
Rəyçilik: Education Sciences rəyli akademik jurnaldır; tədqiqat dərc edilmiş jurnal məqaləsidir.
Preprint: Araşdırılan əsas PDF və rəsmi nəşr qeydində ayrıca preprint versiyası göstərilmir.
Lisenziya: Creative Commons Attribution (CC BY).
Açar sözlər: adaptive learning; target-oriented sequencing; prerequisite-aware sequencing; learner modeling; educational technology.
Əsas model: Triadic Educational Knowledge Space (TEKS).
Learner-state response modeli: Basic Local Independence Model (BLIM).
Müqayisə üsulları: Prerequisite-Weighted Mastery Gap (PW-MG), Static və Random.
Graph strukturları: 8-node symmetric branching graph; 6-node asymmetric converging graph; 6-node linear prerequisite chain.
Simmetrik target conditions: \(c_A\rightarrow q_7\) və \(c_B\rightarrow q_8\); structurally isomorphic symmetry check kimi şərh edilmişdir.
Virtual öyrənən sayı: Hər repetition üçün N=200.
Decision horizon: T=90 interaction steps.
Independent repetitions: R=30.
Slip: s=0.10.
Guess: g=0.20.
Correct-response acquisition rate: \(\alpha_c=0.30\).
Incorrect-response acquisition rate: \(\alpha_e=0.10\).
Target-relevance coefficient: \(\lambda_{rel}=1.0\).
Difficulty range: [0.2, 0.8].
Forgetting: Excluded.
Early stopping: Not applied.
Baseline diagnostic prior: \(p_0^{(c)}=\nu_0^{(c)}\).
Primary performance metrics: final target mastery, mean target mastery over time, final target-conditioned scope mastery.
Statistik təhlil: Repetition-level paired contrasts; two-sided paired t-tests; %95 t confidence intervals; paired Cohen's \(d_z\); primary test families üçün Holm correction; supplementary robustness üçün Wilcoxon signed-rank test.
Əsas symmetric cA TEKS nəticələri: final target mastery 0.6263 (SD 0.0388); mean target mastery 0.3235 (0.0267); final scope mastery 0.8714 (0.0145).
Symmetric TEKS–PW-MG fərqləri: 0.0755; 0.0256; 0.0552. Müvafiq \(d_z\) dəyərləri 2.48, 1.71 və 3.89-dur.
Əsas asymmetric TEKS nəticələri: 0.4858; 0.2157; 0.8312.
Asymmetric TEKS–PW-MG fərqləri: 0.0643; 0.0194; 0.0542.
Linear-chain nəticəsi: final target və mean target meyarlarında TEKS ilə PW-MG confidence interval baxımından fərqlənməmişdir; final scope mastery TEKS lehinə daha yüksəkdir.
Initial-proficiency nəticəsi: Symmetric cA exploratory analysis altında aşağı və orta qruplarda TEKS daha yüksək; yüksək qrupda PW-MG bir qədər daha yüksək orta nəticələr vermişdir.
Sensitivity: One-factor-at-a-time; response noise, acquisition rate, horizon, difficulty, target relevance və diagnostic prior variasiyaları araşdırılmışdır. Faktorlararası qarşılıqlı təsir təhlili aparılmamışdır.
Hesablama mürəkkəbliyi: Exact implementation üçün bütün TEKS candidates-ın conservative full-support qiymətləndirilməsi \(O(MS)\); feasible-state enumeration bilik elementlərinin sayı artdıqca eksponensial arta bilər.
Runtime / peak memory: Original formal runs üçün etibarlı ölçmələr saxlanmadığına görə empirik benchmark hesabatlanmamışdır.
Supplementary Materials: Mənbə Supplementary Method S1, Tables S1–S3, Supplementary Method S2, Tables S4–S5, Supplementary Data S1 və S2 olduğunu bildirir. Bu ayrıca fayllar hazırkı istifadəçi yükləməsinə daxil deyil; Verianla əsas məqaləsi yüklənmiş 29 səhifəlik source PDF-nin açıq şəkildə bildirdiyi məlumatlarla məhduddur.
Source repository: Development repository hazırkı layihə mərhələsində ictimaiyyətə açıq deyil. Müəlliflər Supplementary Method S2-nin independent reimplementation üçün alqoritmik və implementation specifications verdiyini; Supplementary Data S1/S2-nin yoxlanıla bilən nəticələr ehtiva etdiyini bildirir.
Funding: National Key Research and Development Program of China, grant 2023YFC3305701.
Institutional Review Board Statement: Not applicable.
Data Availability: Development source repository public deyil; supplement-lərdə machine-readable simulation outputs, configurations, provenance/integrity records, analysis-ready results və figure source data olduğu bildirilir. Additional clarification corresponding author-dan reasonable request ilə istənilə bilər.
Conflicts of Interest: Müəlliflər maraqlar toqquşmasının olmadığını bildirmişdir. Maliyyə təminatçısı tədqiqat dizaynı, məlumat təhlili, məqalənin yazılması və ya nəşr qərarında rol oynamamışdır.
Müəllif töhfələri
- Conceptualization: Bingqian Li, Hongwei Guo.
- Methodology: Bingqian Li, Jia Hao.
- Validation: Bingqian Li, Jia Hao, Xiaobei Jiang, Hongwei Niu.
- Formal analysis: Bingqian Li.
- Investigation: Bingqian Li.
- Data curation: Bingqian Li.
- Writing — original draft preparation: Bingqian Li.
- Writing — review and editing: Hongwei Guo, Jia Hao, Hongwei Niu.
- Visualization: Bingqian Li, Xiaobei Jiang.
- Supervision: Hongwei Guo.
- Project administration: Hongwei Guo.
- Funding acquisition: Hongwei Guo.
Əsas metodoloji məhdudiyyətlər: Nəzarət olunan və model-əsaslı simulyasiya; real tələbə məlumatının olmaması; baseline-da estimator ilə environment modelinin yaxından uyğunlaşması; yalnız məhdud prior misspecification sınağı; kiçik DAG strukturları; singleton target set-lər; forgetting və cross-item transfer-ın xaric edilməsi; binary response; sabit acquisition parametrləri; uzun-horizon planning-in olmaması; contextual learner/instruction attributes-ın xaricdə saxlanması; larger-graph runtime və memory benchmark-ın olmaması.
Əsas şərh sərhədi: Tədqiqat TEKS-in real təhsil mühitində effektivliyini sübut etmir. Nəzarət olunan simulyasiya altında target-adjusted one-step acquisition scoring-in, xüsusilə bir neçə prerequisite-related namizədin rəqabət apardığı branching strukturlarda, fərqli sequencing davranışı və daha yüksək simulyasiya olunmuş mastery nəticələri yarada bildiyini göstərən proof-of-concept sübut təqdim edir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib