


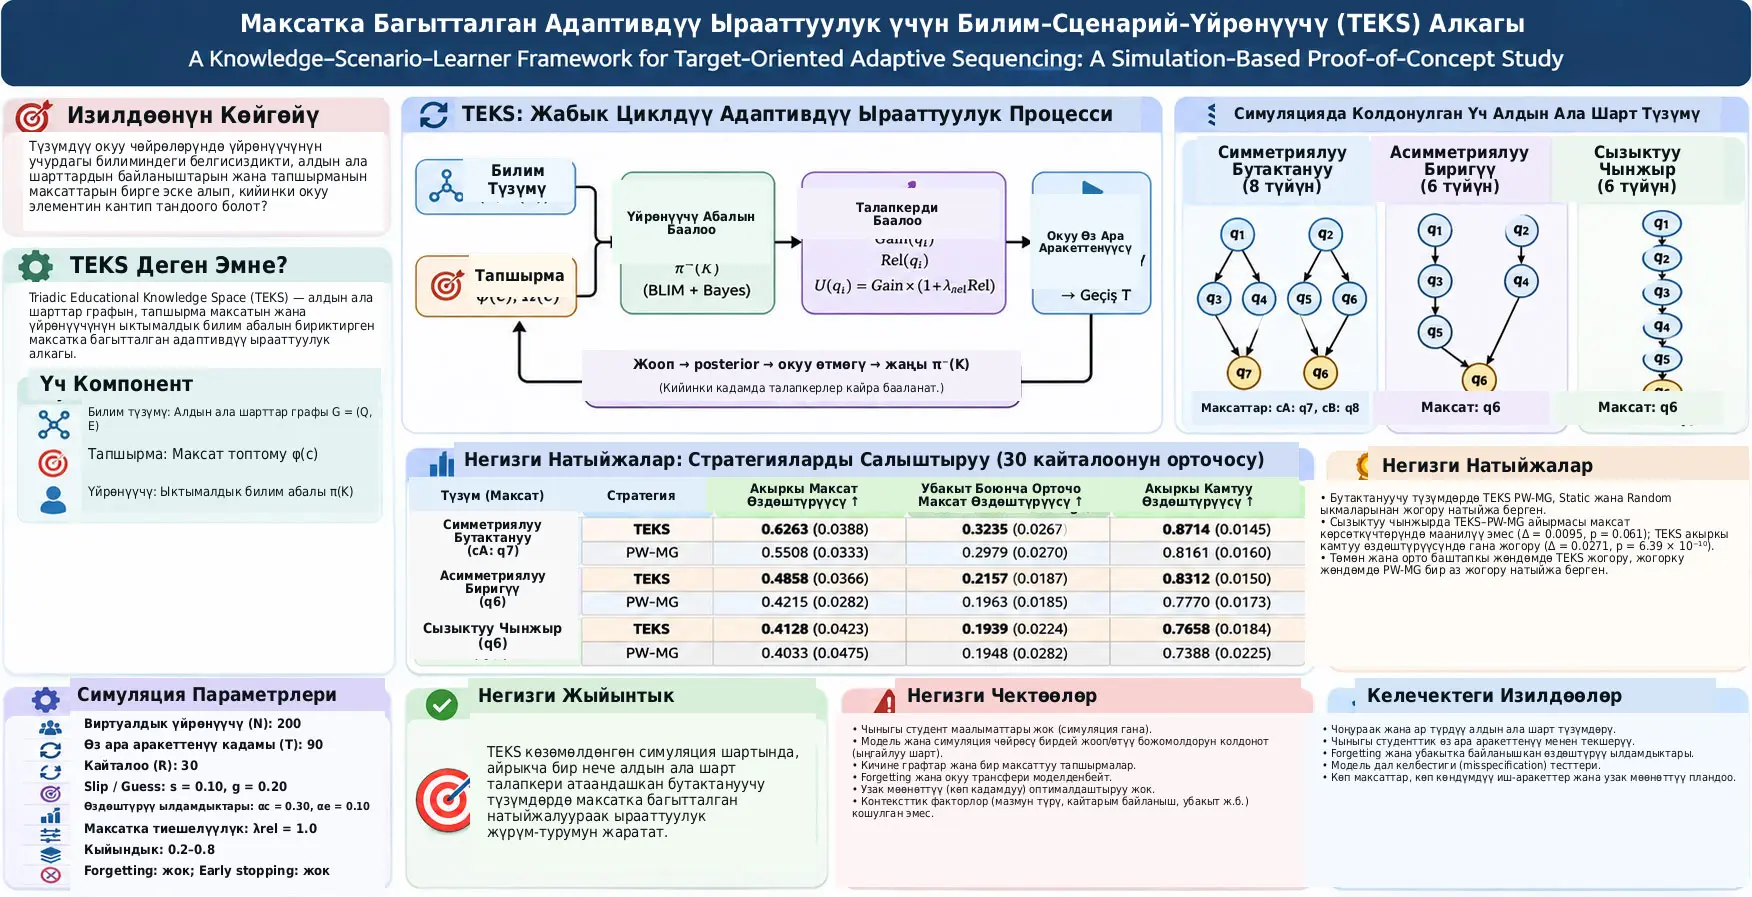
Triadic Educational Knowledge Space (TEKS) — түзүмдүү окуу чөйрөлөрүндө үйрөнүүчү кийинки кезекте кайсы окуу элементи менен өз ара аракеттениши керектигин аныктоо үчүн алдын ала шарттар графын, тапшырмага мүнөздүү максаттар топтомун жана үйрөнүүчүнүн түздөн-түз байкалбаган билим абалы боюнча ыктымалдык баалоону бирге колдонгон максатка багытталган адаптивдүү ырааттуулук алкагы. Изилдөө TEKSти чыныгы студенттерде эмес, көзөмөлдөнгөн жабык циклдүү симуляцияда баалаган. Үч алдын ала шарт түзүмү каралган: сегиз түйүндүү симметриялуу бутактануу графы, алты түйүндүү асимметриялуу биригүү графы жана алты түйүндүү сызыктуу алдын ала шарттар чынжыры. Ар бир шартта 200 виртуалдык үйрөнүүчү, 90 өз ара аракеттенүү кадамы жана 30 көз карандысыз кайталоо колдонулуп; TEKS бирдей симуляция шарттарында Prerequisite-Weighted Mastery Gap (PW-MG), детерминисттик Static жана Random стратегиялары менен салыштырылган.
TEKSтин чечим логикасы “үйрөнүүчү кайсы теманы билбейт?” деген суроого гана негизделбейт. Ар бир талапкер билим элементи үчүн адегенде үйрөнүүчүнүн учурдагы белгисиз билим абалдары, мүмкүн болгон туура/туура эмес жооптор жана кийинки окуу өтмөлөрү аркылуу элементтин кийинки өз ара аракеттенүүдө жаңы өздөштүрүлүү ыктымалдыгы эсептелет. Андан кийин бул маани талапкер элементтин тапшырма максатынан граф боюнча багытталган аралыгына байланышкан target relevance менен жөнгө салынат. Ошентип, система жетишпеген элементти гана эмес, учурдагы абалда өздөштүрүлүшү мүмкүн жана максат менен түзүмдүк жактан байланышкан элементти артыкчылыктуу кылууга аракеттенет.
Эки негизги бутактануучу түзүмдө TEKS final target mastery, убакыт боюнча орточо target mastery жана final target-conditioned scope mastery көрсөткүчтөрүндө PW-MG, Static жана Random ыкмаларынан жогору натыйжаларды берген. Симметриялуу \(c_A\) шартында final target mastery TEKS үчүн 0.6263, PW-MG үчүн 0.5508; асимметриялуу биригүү графында тиешелүүлүгүнө жараша 0.4858 жана 0.4215 деп билдирилген. Бирок сызыктуу алдын ала шарттар чынжырында TEKS менен PW-MGнин target-level натыйжалары бири-бирине жакын болгон: final target mastery айырмасы 0.0095 жана \(p=0.061\), mean target mastery over time айырмасы −0.0009 жана \(p=0.728\) болуп, ишеним интервалдары нөлдү камтыган. Ал эми final scope mastery TEKS пайдасына 0.0271 айырма көрсөткөн.
Бул натыйжаларды чечмелөөнүн чеги абдан маанилүү. Изилдөө чыныгы студенттин жүрүм-турумун өлчөгөн эмес. Population initialization, response error, acquisition rates, difficulty жана learning-transition эрежелери изилдөөчүлөр тарабынан алдын ала белгиленген симуляция параметрлери. Baseline эксперименттеринде симуляция чөйрөсү менен learner-state estimator бирдей response жана transition формаларын колдонот. Ошондуктан изилдөө TEKS чыныгы класстарда жакшыраак окууну камсыз кыларын далилдебейт; көзөмөлдөнгөн божомолдордо ар башка candidate-selection эрежелеринин эсептөө жүрүм-турумун салыштырат.
Изилдөөнүн негизги көйгөйү эмнеде?
Адаптивдүү окутууда үйрөнүүчүнүн акыркы бир нече суроого берген жоопторуна гана кароо жетишсиз болушу мүмкүн. Математика, инженерия жана компьютердик илимдер сыяктуу түзүмдүү тармактарда өнүккөн билим элементин үйрөнүү үчүн алгач белгилүү алдын ала шарттар өздөштүрүлүшү керек. Система үйрөнүүчү начар билген элементти тандаса да, ал элементтин алдын ала шарттары даяр болбосо, сунуш педагогикалык жактан эрте болушу мүмкүн.
Тескерисинче, толугу менен туруктуу окуу ырааттуулугу алдын ала шарттардын тартибин сактай алат, бирок үйрөнүүчүлөрдүн баштапкы билим айырмасын, өнүгүү ылдамдыгын жана байкалган жоопторун эске албайт.
Изилдөө чечүүгө аракеттенген маселе ушул эки талапты бириктирүү:
- үйрөнүүчүнүн учурдагы билиминдеги белгисиздикти эске алуу,
- алдын ала шарт мамилелерин бузбоо,
- жана учурдагы тапшырманын конкреттүү максатын кийинки элементти тандоого түздөн-түз кошуу.
Изилдөөнүн эки изилдөө суроосу
- Үйрөнүүчүнүн билим абалы белгисиз кезде, алдын ала шарттарга негизделген окуу чөйрөсүндө тапшырма максаты next-item selection процессине кантип кошулушу мүмкүн?
- Бул максатка багытталган тандоо эрежеси ар башка алдын ала шарт түзүмдөрүндө mastery-gap негизиндеги адаптивдүү тандоодон башка ырааттуулук натыйжаларын чыгарабы?
TEKS Деген Эмне жана Үч Компонентти Кантип Бириктирет?
TEKS билим тармагынын алдын ала шарт түзүмүн көрсөткөн графты, учурдагы тапшырма жетүүнү көздөгөн билим элементтерин аныктаган максат топтомун жана үйрөнүүчүнүн мүмкүн болгон жашыруун билим абалдары боюнча ыктымалдык бөлүштүрүүнү бириктирип, ар бир өз ара аракеттенүүдө кийинки талапкерди кайра баалаган жабык циклдүү адаптивдүү ырааттуулук алкагы.
1. Билим элементтеринин топтому
Окуу тармагындагы билим элементтери:
\[ Q=\{q_1,q_2,\ldots,q_n\} \]
деп аныкталат.
Бул жерде \(q_i\) бир түшүнүктү же окуу элементин, \(n\) болсо билим элементтеринин жалпы санын билдирет. Булар физикалык бирдикке ээ чоңдуктар эмес; моделдеги дискреттүү билим түйүндөрү.
2. Алдын ала шарттар графы
Билим түзүмү багытталган граф менен көрсөтүлөт:
\[ G=(Q,E) \]
Бул жерде \(E\subseteq Q\times Q\) — багытталган кырлардын топтому. Эгер:
\[ q_i\rightarrow q_j \]
кыры бар болсо, \(q_i\), \(q_j\)нин түздөн-түз алдын ала шарты.
Элементтин түздөн-түз алдын ала шарттарынын топтому:
\[ Pre(q_j)=\{q_i\in Q:(q_i,q_j)\in E\} \]
түрүндө аныкталат.
3. Алдын ала шарттарга шайкеш билим абалдары
Үйрөнүүчүнүн жашыруун билим абалы ал билген элементтердин каалаган кокустук чакан топтому катары кабыл алынбайт. Эгер үйрөнүүчү өнүккөн элементти билсе, анын түздөн-түз алдын ала шарттары да билим абалында болушу керек:
\[ \mathcal{K}(G)=\{K\subseteq Q:q_j\in K\Rightarrow Pre(q_j)\subseteq K\} \]
Бул топтом графка ылайык уруксат берилген бардык prerequisite-consistent latent knowledge states абалдарын камтыйт.
Мисалы, \(q_1\rightarrow q_3\) болсо, үйрөнүүчү \(q_3\)тү билип, \(q_1\)ди билбеген абал \(\mathcal{K}(G)\) ичинде жарактуу деп эсептелбейт.
4. Сценарий же тапшырма максаты
Изилдөөдө “scenario” татаал контексттик окуя катары моделденбейт. Ар бир тапшырма \(c\) максат кылган билим элементтеринин топтому менен көрсөтүлөт:
\[ \phi(c)\subseteq Q \]
\(\phi(c)\) — тапшырма \(c\)нин окуу максаты.
Бул айырма маанилүү: билим графы бүт тармактын түзүмүн берсе, \(\phi(c)\) ошол тапшырмада кайсы билим элементтери максат экенин гана аныктайт.
5. Жашыруун үйрөнүүчү абалы
Үйрөнүүчүнүн чыныгы, бирок түздөн-түз байкалбаган билим абалы:
\[ K_{u,t}\in\mathcal{K}(G) \]
менен көрсөтүлөт.
Бул жерде:
- \(u\): үйрөнүүчү индекси,
- \(t\): өз ара аракеттенүү кадамы,
- \(K_{u,t}\): үйрөнүүчү ошол учурда чындап өздөштүрдү деп кабыл алынган элементтердин топтому.
Чыныгы колдонмодо система \(K_{u,t}\)ни түздөн-түз көрө албайт. Симуляцияда hidden state симуляция чөйрөсү жоопту жана окуу өтмөгүн жаратышы үчүн гана белгилүү.
6. Үйрөнүүчү абалы тууралуу ишеним
Система “үйрөнүүчү ушул темаларды билет” деген бир гана чечим чыгаруунун ордуна мүмкүн болгон бардык билим абалдары боюнча баалоо бөлүштүрүүсүн алып жүрөт:
\[ \pi_{u,t}^{-}(K)=P(K_{u,t}=K\mid H_{u,t}),\qquad K\in\mathcal{K}(G) \]
\(H_{u,t}\) — ошол учурга чейинки өз ара аракеттенүү тарыхы. Жогорку индекстеги “−” учурдагы жооп али байкала электеги predictive distribution абалын билдирет.
Бул бөлүштүрүүнүн артыкчылыгы — белгисиздикти сакташы. Система “үйрөнүүчү сөзсүз ушул абалда” дебестен, мисалы, бир нече ылайыктуу билим абалына ар башка ыктымалдыктарды бере алат.
BLIM Үйрөнүүчүнүн Билим Абалын Кантип Жаңыртат?
Basic Local Independence Model (BLIM) үйрөнүүчүнүн жашыруун билим абалы менен байкалган туура/туура эмес жооптун ортосунда ыктымалдык байланыш түзөт; үйрөнүүчү элементти билсе да slip себептүү туура эмес жооп бериши, билбесе да guess себептүү туура жооп бериши мүмкүн жана байкалган жооп андан кийин Байес эрежеси аркылуу бардык мүмкүн болгон билим абалдарынын ыктымалдыктарын жаңыртат.
Башында чыныгы абал менен моделдин ишеними эмне үчүн өзүнчө?
Симуляциядагы жашыруун баштапкы абал:
\[ K_{u,0}\sim \nu_0^{(c)} \]
менен тандалат.
Бул жерде:
\[ \nu_0^{(c)}(K)=P(K_{u,0}=K\mid c) \]
симуляция популяциясынын чыныгы баштапкы бөлүштүрүүсү.
Learner-state estimator болсо башында:
\[ \pi_{u,0}^{-}(K)=p_0^{(c)}(K) \]
prior бөлүштүрүүсүн колдонот.
Эки бөлүштүрүү тең жарактуу абалдардын үстүндө нормалдаштырылат:
\[ \sum_{K\in\mathcal{K}(G)}\nu_0^{(c)}(K) = \sum_{K\in\mathcal{K}(G)}p_0^{(c)}(K) =1 \]
Baseline симуляцияда:
\[ p_0^{(c)}=\nu_0^{(c)} \]
түрүндө дал келтирилген. Бул estimator үчүн ыңгайлуу шарт. Изилдөөнүн sensitivity analysis бөлүмү prior mismatch үчүн \(p_0\)ду өзгөртүп, чыныгы population distribution \(\nu_0\)ду туруктуу кармаган.
Түйүн деңгээлиндеги болжолдуу өздөштүрүү ыктымалдыгы
Толук ыктымалдык бөлүштүрүүдөн бир элементтин болжолдуу өздөштүрүү ыктымалдыгы төмөнкүдөй алынат:
\[ \widehat{m}_{u,t,i}^{-} = \sum_{K\in\mathcal{K}(G)} \mathbf{1}(q_i\in K)\pi_{u,t}^{-}(K) \]
Бул жердеги көрсөткүч функция:
- \(q_i\in K\) болсо 1,
- болбосо 0
маанисин алат.
Демек, сумма ыктымалдык массасынын канчасы \(q_i\) мурунтан белгилүү болгон абалдарда жайгашканын эсептейт.
Slip жана guess
Үйрөнүүчү тандалган \(q_{u,t}^{*}\) элементине жооп берет жана натыйжа:
\[ r_{u,t}\in\{0,1\} \]
менен көрсөтүлөт.
\(r=1\) туура, \(r=0\) туура эмес жоопту билдирет.
BLIM туура жооптун ыктымалдыгын:
\[ P(r_{u,t}=1\mid K_{u,t},q_{u,t}^{*})= \begin{cases} 1-s, & q_{u,t}^{*}\in K_{u,t}\\ g, & q_{u,t}^{*}\notin K_{u,t} \end{cases} \]
түрүндө аныктайт.
Бул жерде:
- \(s\): slip probability; үйрөнүүчү чындыгында билген элементке туура эмес жооп берүү ыктымалдыгы.
- \(g\): guess probability; үйрөнүүчү чындыгында билбеген элементке туура жооп берүү ыктымалдыгы.
Baseline симуляцияда:
- \(s=0.10\),
- \(g=0.20\)
колдонулган.
Ошондуктан туура жооп “үйрөнүүчү сөзсүз билет”, туура эмес жооп болсо “үйрөнүүчү сөзсүз билбейт” дегенди билдирбейт.
Байес жаңыртуусу
Жооп байкалгандан кийин билим абалдарынын ыктымалдыктары:
\[ \pi_{u,t}^{+}(K) = \frac{ P(r_{u,t}\mid K,q_{u,t}^{*})\pi_{u,t}^{-}(K) }{ \sum_{L\in\mathcal{K}(G)} P(r_{u,t}\mid L,q_{u,t}^{*})\pi_{u,t}^{-}(L) } \]
менен жаңыртылат.
\(\pi^{+}\) — жооп байкалгандан кийинки filtering posterior.
Алым бөлүгү эки нерсени көбөйтөт:
- жооптун ошол билим абалында байкалуу ыктымалдыгы,
- жоопко чейин ошол абалдын ыктымалдыгы.
Бөлүм болсо бардык мүмкүн болгон абалдар боюнча нормалдаштырып, posterior ыктымалдыктарынын суммасын кайра 1 ге келтирет.
Алдын ала шарттарга даярдык көрсөткүчү
Билим абалында \(q_i\)нин бардык түздөн-түз алдын ала шарттары өздөштүрүлгөн болсо:
\[ R_i(K)=\mathbf{1}[Pre(q_i)\subseteq K] \]
мааниси 1 болот.
Root item үчүн \(Pre(q_i)=\varnothing\) болгондуктан, бул шарт автоматтык аткарылат.
Жоопко байланышкан окуу ыктымалдыгы
Үйрөнүүчү али \(q_i\)ни билбесе жана алдын ала шарттары даяр болсо acquisition probability:
\[ \rho_i(r)= \begin{cases} \alpha_c(1-d_i), & r=1\\ \alpha_e(1-d_i), & r=0 \end{cases} \]
түрүндө болот.
Бул жерде:
- \(d_i\in[0,1]\): элементтин difficulty параметри,
- \(\alpha_c\): туура жооптон кийинки негизги acquisition rate,
- \(\alpha_e\): туура эмес жооптон кийинки негизги acquisition rate.
Модель:
\[ \alpha_c>\alpha_e \]
божомолун колдонот.
Baseline:
- \(\alpha_c=0.30\),
- \(\alpha_e=0.10\).
\((1-d_i)\) көбөйткүчү себептүү difficulty жогорулаган сайын бирдей жооп шартында acquisition probability төмөндөйт.
Окуу өтмөгү
Булактагы Equation (16) тандалган элемент жаңы жашыруун билим абалына кантип өтүшү мүмкүн экенин толук transition kernel менен аныктайт.
Кыскача логика мындай:
- элемент белгисиз жана алдын ала шарттар даяр болсо, \(\rho_i(r)\) ыктымалдыгы менен билим абалына кошулушу мүмкүн;
- ошол эле шартта \(1-\rho_i(r)\) ыктымалдыгы менен абал өзгөрбөй калышы мүмкүн;
- элемент мурунтан белгилүү болсо же prerequisites даяр эмес болсо, абал өзгөрбөйт;
- башка өтмөлөрдүн ыктымалдыгы 0.
Бул transition monotonic деп аныкталган: алынган билим моделде жоголбойт. Forgetting бул симуляцияга киргизилген эмес.
Симуляция чөйрөсүндөгү жаңы чыныгы абал:
\[ K_{u,t+1}\sim T_i^{(r_{u,t})}(K_{u,t},\cdot) \]
менен тандалат.
Learner-state estimator болсо posterior бөлүштүрүүнү ошол эле transition kernel аркылуу:
\[ \pi_{u,t+1}^{-}(K') = \sum_{K\in\mathcal{K}(G)} T_i^{(r_{u,t})}(K,K')\pi_{u,t}^{+}(K) \]
түрүндө алдыга өткөрөт.
Ошентип, жаңы өз ара аракеттенүү башталганда системада жаңыртылган predictive distribution болот.
TEKS Кийинки Элементти Кайсы Формула Менен Тандайт?
TEKS адегенде тапшырманын максаты жана бардык recursive prerequisites аркылуу талапкер камтууну түзөт, андан соң ар бир талапкер үчүн кийинки өз ара аракеттенүүдө жаңы өздөштүрүлүү ыктымалдыгын эсептейт, бул ыктымалдыкты граф боюнча максатка жакындык менен күчөтүп, эң жогорку target-adjusted acquisition score алган элементти тандайт.
Максатка байланышкан талапкер камтуу
Тапшырма \(c\) үчүн талапкер камтуу:
\[ \Omega(c)=\phi(c)\cup Pre^{*}(\phi(c)) \]
менен аныкталат.
\(Pre^{*}\) максаттардын түздөн-түз гана эмес, бардык recursive prerequisite ancestors элементтерин билдирет.
Ошондуктан система бүт \(Q\) мейкиндигинен кокус тандоонун ордуна максат менен түзүмдүк жактан байланышкан элементтерге көңүл бурат.
Бир кадамдагы өздөштүрүү ыктымалдыгы: Gain
TEKSтин борбордук чоңдугу:
\[ Gain_{u,t}(q_i) = \sum_{K\in\mathcal{K}(G)} \pi_{u,t}^{-}(K) \sum_{r\in\{0,1\}} P(r\mid K,q_i) \sum_{K'\in\mathcal{K}(G)} T_i^{(r)}(K,K') \left[ \mathbf{1}(q_i\in K')-\mathbf{1}(q_i\in K) \right] \]
туюнтмасы.
Формула биринчи караганда татаал көрүнгөнү менен үч белгисиздикти бирге орточолойт:
- Үйрөнүүчү азыр кайсы жашыруун абалда болушу мүмкүн? — \(\pi^{-}(K)\)
- Тандалган элементке туурабы же туура эмеспи жооп бериши мүмкүн? — \(P(r\mid K,q_i)\)
- Жооптон кийин кайсы жаңы билим абалына өтүшү мүмкүн? — \(T_i^{(r)}(K,K')\)
Акыркы квадрат кашаа:
\[ \mathbf{1}(q_i\in K')-\mathbf{1}(q_i\in K) \]
\(q_i\) учурдагы абалда белгисиз болуп, кийинки абалда өздөштүрүлгөндө гана 1 болот.
Демек, \(Gain_{u,t}(q_i)\), булакта түшүндүрүлгөндөй, талапкер элементтин кийинки өз ара аракеттенүүдө жаңы өздөштүрүлүшүнүн болжолдуу ыктымалдыгы.
Максатка багытталган аралык
Талапкердин target item га багытталган prerequisite-to-dependent жолу боюнча аралыгы:
\[ D_c^{tar}(q_i) = \min_{q_g\in\phi(c)} dist_G(q_i,q_g) \]
түрүндө.
Максатка жакындык упайы:
\[ Rel_c(q_i)=\frac{1}{1+D_c^{tar}(q_i)} \]
деп аныкталат.
Натыйжада:
- target item үчүн \(D=0\) жана \(Rel=1\),
- максаттан бир кыр алыстыктагы prerequisite үчүн \(Rel=1/2\),
- эки кыр алыстыкта \(Rel=1/3\)
болот.
Бул мисалдар формуланын түз математикалык натыйжасы; жаңы эксперименттик табылга эмес.
TEKS utility упайы
Акыркы TEKS упайы:
\[ U_{u,t}^{TEKS}(q_i) = Gain_{u,t}(q_i) \left[ 1+\lambda_{rel}Rel_c(q_i) \right] \]
түрүндө.
\(\lambda_{rel}\geq0\) target relevance adjustment күчүн аныктайт.
Baseline изилдөөдө:
\[ \lambda_{rel}=1.0 \]
колдонулган.
\(\lambda_{rel}=0\) болгондо:
\[ U^{TEKS}=Gain \]
болот; башкача айтканда графка негизделген relevance көбөйткүчү өчөт жана ыкма predictive one-step acquisition scoring гана болуп калат.
Sensitivity analysis те \(\lambda_{rel}=0\) шартында да TEKS–PW-MG айырмасынын сакталышы TEKS менен PW-MGнин айырмасы relevance көбөйткүчүнөн гана келбесин; expected-acquisition эсеби да өзүнчө салым кошорун көрсөтөт. Бирок булак бул табылганы \(\lambda_{rel}=1.0\) оптималдуу деген мааниде чечмелебейт.
Тандоо эрежеси
Кийинки элемент:
\[ q_{u,t}^{*} = \arg\max_{q_i\in\Omega(c)} U_{u,t}^{TEKS}(q_i) \]
менен тандалат.
Башкача айтканда, талапкер камтуудагы бардык элементтерге упай берилип, эң чоң TEKS упайына ээси тандалат.
Упайлар тең болуп калса, булак node identifier кичине болгон талапкерди тандап tie-breaking жүргүзөт.
TEKS узак мөөнөттү оптималдаштырабы?
Жок. TEKS булакта ачык myopic one-step selection деп аныкталган. Ар бир кадамда кийинки өз ара аракеттенүүгө карайт; reinforcement learning сыяктуу узак мөөнөттүү cumulative reward үчүн бүт келечекти түздөн-түз оптималдаштырбайт.
Бул моделдин түшүндүрүлмөлүүлүгүн жогорулатат, бирок узак мөөнөттүү оптималдуу окуу жолу кепилденген дегенди билдирбейт.
PW-MG менен негизги айырмасы эмнеде?
PW-MG үчүн адегенде түздөн-түз prerequisites өздөштүрүлгөн болушунун ыктымалдыгы:
\[ \widehat{R}_{u,t,i}^{-} = \sum_{K\in\mathcal{K}(G)} \mathbf{1}[Pre(q_i)\subseteq K] \pi_{u,t}^{-}(K) \]
эсептелет.
PW-MG упайы:
\[ U_{u,t}^{PW-MG}(q_i) = \left(1-\widehat{m}_{u,t,i}^{-}\right) \widehat{R}_{u,t,i}^{-} \]
түрүндө.
Бул жерде:
- \(1-\widehat{m}^{-}\): mastery gap, башкача айтканда талапкер али белгилүү эмес болушунун ыктымалдыгы,
- \(\widehat{R}^{-}\): prerequisites даяр болушунун ыктымалдыгы.
Ошентип PW-MG “жетишпеген жана алдын ала шарттары даяр” талапкерлерди алдыга чыгарат.
TEKS болсо мунун ордуна талапкердин чындап кийинки кадамда өздөштүрүлүү ыктымалдыгын response жана transition модели аркылуу эсептеп, максатка болгон graph relevance менен жөнгө салат.
TEKSтин төрт салыштыруу ыкмасынын арасындагы орду
| Стратегия | Адаптивдүүбү? | Prerequisite колдонуу | Негизги тандоо логикасы |
|---|---|---|---|
| TEKS | Ооба | Ооба | Predictive one-step acquisition + target relevance |
| PW-MG | Ооба | Ооба | Mastery gap × prerequisite readiness |
| Static | Жок | Топологиялык тартипти колдонот | Алдын ала белгиленген детерминисттик программа |
| Random | Жок | Тандоо упайында колдонбойт | \(\Omega(c)\) ичинен uniform random тандоо |
Симуляцияда колдонулган үч билим түзүмү
Симметриялуу бутактануу графы
Булактагы сегиз түйүндүү түзүм төмөнкү кырлардан турат:
\[ E_{sym}= \{ (q_1,q_3),(q_1,q_4),(q_2,q_5),(q_2,q_6), (q_3,q_7),(q_5,q_7),(q_4,q_8),(q_6,q_8) \} \]
Эки тапшырма шарты бар:
\[ \phi(c_A)=\{q_7\} \]
\[ \Omega(c_A)=\{q_1,q_2,q_3,q_5,q_7\} \]
жана:
\[ \phi(c_B)=\{q_8\} \]
\[ \Omega(c_B)=\{q_1,q_2,q_4,q_6,q_8\} \]
Бул эки шарт бирдей target depth, prerequisite саны жана path structure га ээ. Ошондуктан булак \(c_A\) жана \(c_B\)ни эки өз алдынча граф натыйжасы катары эмес, symmetry check катары бирге чечмелейт.
Асимметриялуу биригүү графы
Алты түйүндүү түзүм:
\[ E_{asym} = \{ (q_1,q_3),(q_3,q_5),(q_2,q_4),(q_5,q_6),(q_4,q_6) \} \]
деп аныкталган.
Бул жерде:
\[ q_1\rightarrow q_3\rightarrow q_5\rightarrow q_6 \]
узунураак бутакты,
\[ q_2\rightarrow q_4\rightarrow q_6 \]
кыскараак бутакты түзөт.
Максат жана талапкер камтуу:
\[ \phi(c_{asym})=\{q_6\} \]
\[ \Omega(c_{asym})=\{q_1,q_2,q_3,q_4,q_5,q_6\} \]
түрүндө.
Сызыктуу алдын ала шарттар чынжыры
Сызыктуу түзүм:
\[ q_1\rightarrow q_2\rightarrow q_3\rightarrow q_4\rightarrow q_5\rightarrow q_6 \]
түрүндө.
Бул жерде максат \(q_6\), ал эми алты түйүндүн баары candidate scope ичинде.
Бул түзүмдө альтернативдүү prerequisite branch жок болгондуктан, ырааттуулук ыкмалары ар башка тандоо жасай турган мейкиндик бутактануучу графтарга салыштырмалуу кыйла чектелүү.
Difficulty кантип дайындалат?
Түйүндүн difficulty мааниси topological depth тен чыгарылган:
\[ d_i = 0.2+ 0.6 \frac{depth(q_i)} {\max_{q_j\in Q}depth(q_j)} \]
Source node лор үчүн depth=0 болгондуктан:
\[ d_i=0.2 \]
болот.
Максималдуу тереңдиктеги түйүн үчүн катыш 1 болгондуктан:
\[ d_i=0.8 \]
алынат.
Ошентип, difficulty маанилери булакта билдирилгендей 0.2–0.8 аралыгында өзгөрөт.
Граф шарттарынын абал мейкиндиги
| Шарт | Максат | |Ω(c)| | |K(G)| | |K0(c)| |
|---|---|---|---|---|
| Симметриялуу бутактануу \(c_A\) | q7 | 5 | 34 | 9 |
| Симметриялуу бутактануу \(c_B\) | q8 | 5 | 34 | 9 |
| Асимметриялуу биригүү | q6 | 6 | 13 | 12 |
| Сызыктуу чынжыр | q6 | 6 | 7 | 6 |
Баштапкы жөндөм топтору
Баштапкы абалдын колдоосу:
\[ \mathcal{K}_0(c) = \{ K\in\mathcal{K}(G): K\subseteq\Omega(c),\; \phi(c)\nsubseteq K \} \]
менен аныкталат.
Бул шарт эки нерсени аткарат:
- баштапкы билимди тапшырманын candidate scope ичинде кармайт;
- максат топтомун толугу менен мурунтан өздөштүргөн үйрөнүүчүлөрдү баштапкы абалдан чыгарат.
Абалдын баштапкы mastery proportion мааниси:
\[ m_0(K)= \frac{|K\cap\Omega(c)|}{|\Omega(c)|} \]
деп эсептелет.
Топтор:
- Төмөн жөндөм: \(m_0(K)<1/3\)
- Орто жөндөм: \(1/3\leq m_0(K)<2/3\)
- Жогорку жөндөм: \(m_0(K)\geq2/3\)
түрүндө.
Balanced population initial-state distribution ушул үч жөндөм тобунун ар бирине жалпы ыктымалдык массасынын \(1/3\) бөлүгүн берет жана топ ичиндеги жарактуу абалдарга бул массаны тең бөлүштүрөт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Симуляция дизайны
| Параметр | Маани | Мааниси |
|---|---|---|
| Виртуалдык үйрөнүүчү / кайталоо \(N\) | 200 | Ар бир көз карандысыз кайталоодогу virtual learner саны |
| Decision horizon \(T\) | 90 | Ар бир үйрөнүүчү үчүн item-selection/response кадамы |
| Көз карандысыз кайталоо \(R\) | 30 | Статистикалык салыштыруунун кайталоо деңгээлиндеги тандалма саны |
| Slip \(s\) | 0.10 | Белгилүү элементке туура эмес жооп берүү ыктымалдыгы |
| Guess \(g\) | 0.20 | Белгисиз элементке туура жооп берүү ыктымалдыгы |
| \(\alpha_c\) | 0.30 | Туура жооптон кийинки base acquisition rate |
| \(\alpha_e\) | 0.10 | Туура эмес жооптон кийинки base acquisition rate |
| \(\lambda_{rel}\) | 1.0 | Target relevance adjustment күчү |
| Difficulty | 0.2–0.8 | Topological depth тен алынган аралык |
| Forgetting | Киргизилген эмес | Mastered item жоголбойт |
| Early stopping | Жок | Бардык үйрөнүүчүлөр туруктуу horizon ды аяктайт |
Салыштырууну адилеттүү кармоо үчүн эмне теңдештирилди?
Төрт ыкма бирдей:
- initial-state generation,
- response model,
- state-transition mechanism,
- candidate scope,
- interaction budget
шарттарын колдонгон.
Ар бир learner/repetition үчүн бир эле hidden initial state ыкмалар арасында бөлүшүлгөн. Paired strategy comparisons үчүн common random numbers колдонулган; белгилүү graph, repetition, learner жана decision step үчүн стратегиялар бирдей response жана acquisition uniform draws ды бөлүшкөн.
Бул дизайн ыкмалар арасындагы айырманы кокустук тандоо ызы-чуусунан мүмкүн болушунча ажыратууга багытталган.
Static стратегиясынын программасы
Static baseline талапкерлерди адегенде topological level, андан кийин node identifier тартиби боюнча айланып чыгат.
Негизги quota:
\[ \left\lfloor\frac{T}{|\Omega(c)|}\right\rfloor \]
деп эсептелет.
\(T=90\) үчүн:
- симметриялуу шарттарда 5 талапкер болгондуктан ар бир талапкер 18 жолу,
- асимметриялуу жана linear шарттарда 6 талапкер болгондуктан ар бир талапкер 15 жолу
тандалат.
Үч баалоо метрикасы
1. Final target mastery
\[ M_u^{tar}(T) = \frac{|K_{u,T}\cap\phi(c)|}{|\phi(c)|} \]
Бул метрика horizon аягында максат топтомунун канчасы өздөштүрүлгөнүн көрсөтөт.
Бул изилдөөдө бардык target set бир элементтен турат. Ошондуктан learner-level мааниси 0 же 1; таблицалардагы ондук натыйжалар 200 үйрөнүүчү жана кайталоолордун жыйынтыкталышынан чыгат.
2. Mean target mastery over time
\[ \overline{M}_u^{tar} = \frac{1}{T+1} \sum_{t=0}^{T} \frac{|K_{u,t}\cap\phi(c)|}{|\phi(c)|} \]
Бул маани 90-кадамдагы натыйжаны гана эмес, бүт trajectory ичинде максатка канчалык эрте жеткенин да эске алат.
Булак муну target-mastery trajectory нин нормалдаштырылган discrete area under the curve эквиваленти катары түшүндүрөт.
3. Final scope mastery
\[ M_u^{\Omega}(T) = \frac{|K_{u,T}\cap\Omega(c)|}{|\Omega(c)|} \]
Бул метрика максат түйүнүн гана эмес, максатка тиешелүү prerequisites камтылган бүт task-specific scope ичиндеги окуу деңгээлин өлчөйт.
Статистикалык талдоо кантип жүргүзүлгөн?
Статистикалык жыйынтык learner деңгээлинде эмес, repetition деңгээлинде чыгарылган.
Ар бир repetition ичинде 200 үйрөнүүчүнүн натыйжалары адегенде орточолонгон. Натыйжада ар бир strategy × condition үчүн 30 repetition-level mean алынган.
TEKS менен ар бир baseline арасындагы жупташкан айырмалар:
\[ D_r= \text{TEKS}_r-\text{Baseline}_r \]
логикасы менен бааланган.
Primary comparisons үчүн two-sided paired t-test колдонулган.
Отчет берилген элементтер:
- mean paired difference,
- %95 t confidence interval,
- paired Cohen's \(d_z\),
- p мааниси,
- primary branching analyses үчүн Holm-adjusted p мааниси
болгон.
Paired Cohen's dz эмнени көрсөтөт?
Булактын Equation (40) теңдемеси:
\[ d_z=\frac{\overline{D}}{s_D} \]
түрүндө.
Бул жерде:
- \(\overline{D}\): 30 кайталоодогу paired differences орточосу,
- \(s_D\): ошол paired differences тин sample standard deviation мааниси.
\(d_z\), TEKS менен baseline арасындагы орточо жупташкан айырманы ушул айырмалардын стандарттык четтөөсү бирдигинде көрсөтөт.
Бул таасир көлөмү чыныгы студенттердеги билим берүү таасиринин стандартташтырылган көлөмү катары чечмеленбеши керек; бул изилдөөдө ал симуляция кайталоолорунун ортосундагы paired strategy difference көлөмү.
Holm түзөтүүсү эмне үчүн колдонулган?
Ар бир симметриялуу максат шартында үч outcome × үч TEKS–baseline contrast = тогуз тест түзүлөт. Көп гипотеза тести жүргүзүлгөндө кокусунан кичине p маанилерин алуу ыктымалдыгы жогорулай тургандыктан paired t-test p маанилерине Holm correction колдонулган.
\(c_A\) жана \(c_B\) үчүн correction өз-өзүнчө жүргүзүлгөн. Эки шарт structurally isomorphic болуп, coupled random streams колдонгондуктан натыйжалар symmetry check катары чечмеленген.
Асимметриялуу граф өзүнчө тогуз тесттик үй-бүлө түзгөн.
Linear chain secondary structural analysis болгондуктан Holm-adjusted primary family ге киргизилген эмес жана p маанилери unadjusted түрүндө берилген.
Wilcoxon signed-rank тесттери supplement те unadjusted robustness check катары отчет берилген.
Симметриялуу бутактануу графындагы негизги натыйжалар
| Стратегия | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.6263 (0.0388) | 0.3235 (0.0267) | 0.8714 (0.0145) |
| PW-MG | 0.5508 (0.0333) | 0.2979 (0.0270) | 0.8161 (0.0160) |
| Static | 0.2847 (0.0415) | 0.0318 (0.0046) | 0.7776 (0.0147) |
| Random | 0.1908 (0.0239) | 0.0913 (0.0137) | 0.7370 (0.0139) |
TEKS–PW-MG paired натыйжалары:
| Метрика | Орточо айырма | %95 CI | Cohen's dz | Holm-adjusted p |
|---|---|---|---|---|
| Final target mastery | 0.0755 | [0.0641, 0.0869] | 2.48 | 8.39 × 10⁻¹⁴ |
| Mean target mastery over time | 0.0256 | [0.0200, 0.0312] | 1.71 | 2.79 × 10⁻¹⁰ |
| Final scope mastery | 0.0552 | [0.0499, 0.0605] | 3.89 | 8.86 × 10⁻¹⁹ |
Ошол эле TEKS–PW-MG натыйжалары \(c_B\) үчүн да алынган.
TEKS жана PW-MG баштапкы кадамдарда бири-бирине жакын target-mastery trajectories көрсөткөн, чечим горизонтуунун кийинки бөлүгүндө TEKSтин орточо trajectory си жогору болгон.
Кызыгы, TEKS тандоолорунун %52,31 бөлүгүн target node га бөлсө, PW-MG %59,24 бөлүгүн target node га бөлгөн. Ошого карабастан TEKS target mastery боюнча жогору натыйжа берген.
Булак муну мындай түшүндүрөт: predictive state distribution дин маанилүү бөлүгү target prerequisites али даяр эмес абалдарга тиешелүү болсо, бул абалдар target тын one-step acquisition gain эсебине нөл салым берет. Ошентип, TEKS айрым этаптарда максатты түздөн-түз кайра тандоонун ордуна али өздөштүрүлбөгөн prerequisites ке багытталат.
Асимметриялуу биригүү графындагы натыйжалар
| Стратегия | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.4858 (0.0366) | 0.2157 (0.0187) | 0.8312 (0.0150) |
| PW-MG | 0.4215 (0.0282) | 0.1963 (0.0185) | 0.7770 (0.0173) |
| Static | 0.1598 (0.0254) | 0.0151 (0.0028) | 0.7129 (0.0100) |
| Random | 0.0848 (0.0201) | 0.0360 (0.0092) | 0.6620 (0.0140) |
| Метрика | Орточо айырма | %95 CI | Cohen's dz | Holm-adjusted p |
|---|---|---|---|---|
| Final target mastery | 0.0643 | [0.0536, 0.0751] | 2.24 | 1.06 × 10⁻¹² |
| Mean target mastery over time | 0.0194 | [0.0142, 0.0247] | 1.37 | 2.72 × 10⁻⁸ |
| Final scope mastery | 0.0542 | [0.0490, 0.0594] | 3.92 | 7.28 × 10⁻¹⁹ |
TEKS бул түзүмдө тандоолордун:
- %39,08 бөлүгүн узун prerequisite branch ке,
- %17,62 бөлүгүн кыска branch ке,
- %43,30 бөлүгүн target node га
бөлгөн.
PW-MG үчүн тиешелүү маанилер:
- %38,01 узун branch,
- %14,35 кыска branch,
- %47,65 target
деп билдирилген.
TEKS Сызыктуу Алдын Ала Шарттар Чынжырында да PW-MGден Жогорубу?
Target-level көрсөткүчтөрүндө жок: сызыктуу чынжырда TEKS менен PW-MGнин final target mastery айырмасы 0.0095 жана \(p=0.061\), mean target mastery over time айырмасы −0.0009 жана \(p=0.728\) болуп, эки ишеним интервалы тең нөлдү камтыган; TEKSтин ачык артыкчылыгы final scope mastery көрсөткүчүндө байкалган.
| Стратегия | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.4128 (0.0423) | 0.1939 (0.0224) | 0.7658 (0.0184) |
| PW-MG | 0.4033 (0.0475) | 0.1948 (0.0282) | 0.7388 (0.0225) |
| Static | 0.1338 (0.0282) | 0.0122 (0.0028) | 0.6349 (0.0214) |
| Random | 0.0818 (0.0220) | 0.0417 (0.0129) | 0.5720 (0.0180) |
| Метрика | Орточо айырма | %95 CI | dz | p |
|---|---|---|---|---|
| Final target mastery | 0.0095 | [−0.0005, 0.0195] | 0.36 | 0.061 |
| Mean target mastery over time | −0.0009 | [−0.0059, 0.0042] | −0.06 | 0.728 |
| Final scope mastery | 0.0271 | [0.0209, 0.0332] | 1.65 | 6.39 × 10⁻¹⁰ |
Бул p маанилери secondary linear analysis үчүн unadjusted.
Булактын чечмелөөсүнө ылайык, сызыктуу түзүм тандоолорду катуу чектейт. Бир нече prerequisite branch тандоо үчүн атаандашпаганда TEKS жана PW-MGнин тандоо эрежелери target-level натыйжаларда азыраак айырмаланат.
Баштапкы жөндөмгө жараша натыйжалар
| Топ | Стратегия | Final target | Mean target | Final scope |
|---|---|---|---|---|
| Төмөн | TEKS | 0.4006 | 0.1319 | 0.7682 |
| PW-MG | 0.2787 | 0.0884 | 0.6596 | |
| Static | 0.1972 | 0.0219 | 0.6803 | |
| Random | 0.0479 | 0.0106 | 0.5995 | |
| Орто | TEKS | 0.5593 | 0.2295 | 0.8601 |
| PW-MG | 0.4480 | 0.1736 | 0.8000 | |
| Static | 0.2530 | 0.0280 | 0.7683 | |
| Random | 0.1331 | 0.0458 | 0.7309 | |
| Жогорку | TEKS | 0.9130 | 0.6039 | 0.9826 |
| PW-MG | 0.9188 | 0.6266 | 0.9838 | |
| Static | 0.3998 | 0.0452 | 0.8800 | |
| Random | 0.3876 | 0.2154 | 0.8775 |
Төмөн proficiency тобунда TEKS − PW-MG айырмалары:
- final target mastery: 0.1219,
- mean target mastery: 0.0436,
- final scope mastery: 0.1086.
Орто топтогу тиешелүү айырмалар:
- 0.1113,
- 0.0559,
- 0.0601.
Жогорку proficiency тобунда болсо PW-MG үч көрсөткүчтө тең бир аз жогору орточо натыйжа берген; TEKS − PW-MG айырмалары тиешелүүлүгүнө жараша:
- −0.0058,
- −0.0227,
- −0.0012
болгон.
Булак бул subgroup comparisons ты exploratory and descriptive деп классификациялайт; негизги ырастоочу натыйжа катары чечмелебейт.
Сезгичтик талдоосу
One-factor-at-a-time sensitivity analysis эки symmetric target condition шартында гана жүргүзүлгөн.
| Фактор | Baseline | Альтернативдүү шарттар |
|---|---|---|
| \(\lambda_{rel}\) | 1.0 | 0.0, 0.5, 2.0 |
| Decision horizon \(T\) | 90 | 60, 120 |
| Response noise \((s,g)\) | (0.10, 0.20) | (0.05, 0.10), (0.15, 0.30) |
| Acquisition \((\alpha_c,\alpha_e)\) | (0.30, 0.10) | (0.20, 0.05), (0.40, 0.15) |
| Difficulty function | 0.2 + 0.6h/hmax | 0.1 + 0.5h/hmax; 0.3 + 0.6h/hmax |
| Diagnostic prior | \(p_0=\nu_0\) | \(\mathcal{K}_0(c)\) үстүндө uniform |
Каралган 12 шартта TEKS − PW-MG mean paired difference:
- final target mastery үчүн 0.0300–0.1048,
- mean target mastery over time үчүн 0.0033–0.0407,
- final scope mastery үчүн 0.0212–0.0878
аралыгында өзгөргөн.
Slow-acquisition шартында mean target mastery over time айырмасы 0.0033 жана %95 CI [−0.0002, 0.0069] деп билдирилген; ишеним интервалы нөлдү камтыган.
Эң чоң final-target айырмасы \(\lambda_{rel}=0\) шартында байкалган. Бул predictive expected-acquisition компоненти relevance multiplier жок кезде да PW-MGден айырмаланууга салым кошорун көрсөтөт. Бирок бул baseline \(\lambda_{rel}=1.0\) оптималдуу деген жыйынтыкты бербейт.
Талдоо one-factor-at-a-time болгондуктан response noise, acquisition speed, difficulty, horizon жана prior ортосундагы өз ара таасирлер изилденген эмес.
Бул Изилдөө TEKS Чыныгы Студенттерде Жакшыраак Окууну Камсыз Кыларын Далилдейби?
Жок. Бардык натыйжалуулук жыйынтыктары алдын ала белгиленген learner initialization, response-error, acquisition, difficulty жана transition божомолдору астында иштеген виртуалдык үйрөнүүчүлөрдөн алынган; чыныгы студенттин өз ара аракеттенүүсү, класстагы колдонуу, билимдин сакталышы, окуу трансфери же окутуудагы колдонууга жарамдуулук бул изилдөөдө өлчөнгөн эмес.
Изилдөө колдогон жыйынтыктар
- TEKSтин prerequisite constraints, task-specific targets жана learner-state uncertainty ни бир next-item scoring эрежесинде бириктирген математикалык алкагы аныкталган.
- Көзөмөлдөнгөн symmetric branching жана asymmetric converging симуляцияларында TEKS үч негизги натыйжалуулук метрикасы боюнча PW-MG, Static жана Random дан жогору орточо натыйжалар чыгарган.
- Branching түзүмдөрүндө TEKS менен PW-MG ортосундагы target-level айырмалар confidence interval боюнча нөлдөн айырмаланган.
- Linear prerequisite chain де target-level TEKS–PW-MG айырмасы байкаларлык азайып, эки target метрикасында CI нөлдү камтыган.
- TEKS linear chain де final scope mastery боюнча PW-MGден жогору натыйжа берген.
- Төмөн жана орто initial-proficiency топторунда symmetric condition астында TEKS орточо натыйжалары PW-MGден жогору болгон.
- Жогорку-proficiency subgroup та PW-MG бир аз жогору орточо натыйжаларды берген.
- TEKS–PW-MG айырмасы branching structures астында даана байкалганы көрүнгөн.
- Sensitivity analysis натыйжалары TEKS–PW-MG айырмасынын magnitude у симуляция параметрлерине жараша өзгөрөрүн көрсөтөт.
Изилдөө колдобогон жыйынтыктар
- TEKS чыныгы студенттерде окуу жетишкендигин жогорулатары далилденген эмес.
- TEKS бардык prerequisite graph түзүмдөрүндө PW-MGден жогору деп айтууга болбойт.
- \(\lambda_{rel}=1.0\) оптималдуу маани экени көрсөтүлгөн эмес.
- TEKS узак мөөнөттүү оптималдуу окуу жолун түзөрү далилденген эмес.
- Модель forgetting, transfer between unselected items же time-varying acquisition ды көрсөткөн эмес.
- Чыныгы response жана learning transition процесстери BLIM жана колдонулган transition kernel менен толук көрсөтүлгөнү ырасталган эмес.
- Чоң knowledge graph тарда чыныгы иштөө убактысы же peak memory benchmark отчет берилген эмес.
- Authentic curriculum, engagement, feedback форматы, cognitive load же time constraint моделдин учурдагы тандоо упайына кошулган эмес.
- Симуляциядагы статистикалык маанилүүлүк чыныгы билим берүү чөйрөсүндөгү практикалык/окутуучулук маанилүүлүктүн далили эмес.
Эсептөө масштабдуулугу
Булак exact implementation үчүн:
- \(S=|\mathcal{K}(G)|\): prerequisite-consistent state-space көлөмү,
- \(M=|\Omega(c)|\): task-specific candidate scope көлөмү
деп аныктайт.
BLIM measurement update жана predictive propagation active state support ка жараша сызыктуу масштабдалса, бардык TEKS candidate тарын баалоо үчүн булак консервативдүү толук-колдоо татаалдыгын:
\[ O(MS) \]
деп берет.
Негизги масштабдуулук көйгөйү \(O(MS)\) көбөйтмөсү гана эмес; prerequisite-consistent feasible-state enumeration билим элементтеринин саны өскөн сайын экспоненциалдуу көбөйүшү мүмкүн.
Изилдөөдөгү түзүмдөр:
- symmetric graph: 34 feasible state,
- asymmetric graph: 13 feasible state,
- linear chain: 7 feasible state
камтыйт.
Булак original formal runs үчүн ишенимдүү wall-clock runtime же peak-memory өлчөөлөрүн сактабаганын ачык белгилейт. Ошондуктан Verianla жаңы натыйжалуулук/убакыт божомолун чыгарбайт.
Негизги чектөөлөр
1. Controlled simulation: Чыныгы студент маалыматтары колдонулган эмес.
2. Model-environment alignment: Baseline experiments та learner-state estimator менен simulation environment бирдей response жана transition формаларын колдонот жана diagnostic prior population distribution менен дал келтирилген.
3. Чектелген misspecification: Prior mismatch изилденген, бирок чыныгы response же learning process моделге кеңири түрдө дал келбеши текшерилген эмес.
4. Кичине DAGдар: Болгону 8 же 6 түйүндүү кичине directed acyclic graphs колдонулган.
5. Singleton targets: Ар бир condition бир target item камтыйт.
6. Monotonic acquisition: Forgetting жок.
7. Transfer жок: Тандалбаган элементтер арасында окуу трансфери моделденген эмес.
8. Туруктуу acquisition parameters: Acquisition ылдамдыктары убакытка же үйрөнүүчүгө жараша өзгөрбөйт.
9. Binary responses: Ар бир interaction бир гана билим элементи жана binary response камтыйт.
10. Myopic utility: TEKS узак-horizon оптималдуу план издебейт.
11. Контексттик өзгөчөлүктөр жок: Resource format, feedback type, time constraint, cognitive load жана learner engagement тандоо моделинде жок.
12. Чоң масштаб benchmark жок: Runtime жана peak-memory өлчөөсү отчет берилген эмес.
13. Чыныгы билим берүү мааниси белгисиз: Симуляциядагы айырмалар чыныгы дүйнөдө маанилүү learning gain ге айланабы-жокпу бул изилдөөдөн чыгарууга болбойт.
Келечектеги изилдөөлөр үчүн сунуштар
Булак келечекте:
- чоңураак жана ар түрдүү prerequisite structures,
- ар башка академиялык тармактардан authentic curriculum graphs,
- non-singleton target sets,
- multi-skill activities,
- forgetting,
- nonstationary acquisition,
- misspecified response models,
- misspecified transition models,
- approximate же decomposed inference,
- multistep planning жана reinforcement-learning салыштыруулары,
- authentic learner interaction data,
- predictive calibration,
- observed learning outcomes,
- persistence,
- instructional usability
аркылуу баалоону сунуштайт.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталыш: A Knowledge–Scenario–Learner Framework for Target-Oriented Adaptive Sequencing: A Simulation-Based Proof-of-Concept Study.
Авторлор: Bingqian Li; Hongwei Guo; Jia Hao; Xiaobei Jiang; Hongwei Niu.
Авторлордун ирети: Булактагы ирет толугу менен сакталган.
Тең салым: Булакта equal-contribution билдирүүсү жок.
Жооптуу автор: Hongwei Guo.
Мекеме: School of Mechanical Engineering, Beijing Institute of Technology, 5 Zhongguancun South Street, Beijing 100081, China.
Журнал: Education Sciences.
Бөлүм: Technology Enhanced Education.
Басмачы: MDPI, Basel, Switzerland.
Том / номер / макала номери: 16(8), 1344.
DOI: 10.3390/educsci16081344.
Расмий шилтеме: https://doi.org/10.3390/educsci16081344
Received: 28 June 2026.
Revised: 15 August 2026.
Accepted: 19 August 2026.
Published: 21 August 2026.
Булак түрү: Article; simulation-based proof-of-concept study.
Рецензиялоо: Education Sciences рецензияланган академиялык журнал; изилдөө жарыяланган журнал макаласы.
Preprint: Каралган негизги PDF жана расмий жарыя жазуусунда өзүнчө preprint версиясы көрсөтүлгөн эмес.
Лицензия: Creative Commons Attribution (CC BY).
Негизги сөздөр: adaptive learning; target-oriented sequencing; prerequisite-aware sequencing; learner modeling; educational technology.
Негизги модель: Triadic Educational Knowledge Space (TEKS).
Learner-state response модели: Basic Local Independence Model (BLIM).
Салыштыруу ыкмалары: Prerequisite-Weighted Mastery Gap (PW-MG), Static жана Random.
Graph түзүмдөрү: 8-node symmetric branching graph; 6-node asymmetric converging graph; 6-node linear prerequisite chain.
Симметриялуу target conditions: \(c_A\rightarrow q_7\) жана \(c_B\rightarrow q_8\); structurally isomorphic symmetry check катары чечмеленген.
Виртуалдык үйрөнүүчүлөрдүн саны: Ар бир repetition үчүн N=200.
Decision horizon: T=90 interaction steps.
Independent repetitions: R=30.
Slip: s=0.10.
Guess: g=0.20.
Correct-response acquisition rate: \(\alpha_c=0.30\).
Incorrect-response acquisition rate: \(\alpha_e=0.10\).
Target-relevance coefficient: \(\lambda_{rel}=1.0\).
Difficulty range: [0.2, 0.8].
Forgetting: Excluded.
Early stopping: Not applied.
Baseline diagnostic prior: \(p_0^{(c)}=\nu_0^{(c)}\).
Primary performance metrics: final target mastery, mean target mastery over time, final target-conditioned scope mastery.
Статистикалык талдоо: Repetition-level paired contrasts; two-sided paired t-tests; %95 t confidence intervals; paired Cohen's \(d_z\); primary test families үчүн Holm correction; supplementary robustness үчүн Wilcoxon signed-rank test.
Негизги symmetric cA TEKS натыйжалары: final target mastery 0.6263 (SD 0.0388); mean target mastery 0.3235 (0.0267); final scope mastery 0.8714 (0.0145).
Symmetric TEKS–PW-MG айырмалары: 0.0755; 0.0256; 0.0552. Тиешелүү \(d_z\) маанилери 2.48, 1.71 жана 3.89.
Негизги asymmetric TEKS натыйжалары: 0.4858; 0.2157; 0.8312.
Asymmetric TEKS–PW-MG айырмалары: 0.0643; 0.0194; 0.0542.
Linear-chain натыйжасы: final target жана mean target көрсөткүчтөрүндө TEKS менен PW-MG confidence interval боюнча айырмаланган эмес; final scope mastery TEKS пайдасына жогору.
Initial-proficiency натыйжасы: Symmetric cA exploratory analysis астында төмөн жана орто топтордо TEKS жогору; жогорку топто PW-MG бир аз жогору орточо натыйжаларды берген.
Sensitivity: One-factor-at-a-time; response noise, acquisition rate, horizon, difficulty, target relevance жана diagnostic prior өзгөрүүлөрү каралган. Факторлор аралык өз ара таасир талдоосу жүргүзүлгөн эмес.
Эсептөө татаалдыгы: Exact implementation үчүн бардык TEKS candidates тын conservative full-support баалоосу \(O(MS)\); feasible-state enumeration билим элементтеринин саны өскөн сайын экспоненциалдуу өсүшү мүмкүн.
Runtime / peak memory: Original formal runs үчүн ишенимдүү өлчөөлөр сакталбагандыктан эмпирикалык benchmark отчет берилген эмес.
Supplementary Materials: Булак Supplementary Method S1, Tables S1–S3, Supplementary Method S2, Tables S4–S5, Supplementary Data S1 жана S2 бар экенин билдирет. Бул өзүнчө файлдар учурдагы колдонуучу жүктөмүнө кирген эмес; Verianla негизги макаласы жүктөлгөн 29 беттик source PDF ачык билдирген маалыматтар менен гана чектелет.
Source repository: Development repository учурдагы долбоор этабында коомчулукка ачык эмес. Авторлор Supplementary Method S2 independent reimplementation үчүн алгоритмдик жана implementation specifications берерин; Supplementary Data S1/S2 текшерүүгө боло турган жыйынтыктарды камтарын билдиришет.
Funding: National Key Research and Development Program of China, grant 2023YFC3305701.
Institutional Review Board Statement: Not applicable.
Data Availability: Development source repository public эмес; supplement терде machine-readable simulation outputs, configurations, provenance/integrity records, analysis-ready results жана figure source data бар экени белгиленет. Additional clarification corresponding author дан reasonable request менен суралышы мүмкүн.
Conflicts of Interest: Авторлор кызыкчылыктардын кагылышы жок экенин билдирген. Каржылоочу изилдөө дизайнына, маалымат талдоого, макаланы жазууга же жарыялоо чечимине катышкан эмес.
Авторлордун салымдары
- Conceptualization: Bingqian Li, Hongwei Guo.
- Methodology: Bingqian Li, Jia Hao.
- Validation: Bingqian Li, Jia Hao, Xiaobei Jiang, Hongwei Niu.
- Formal analysis: Bingqian Li.
- Investigation: Bingqian Li.
- Data curation: Bingqian Li.
- Writing — original draft preparation: Bingqian Li.
- Writing — review and editing: Hongwei Guo, Jia Hao, Hongwei Niu.
- Visualization: Bingqian Li, Xiaobei Jiang.
- Supervision: Hongwei Guo.
- Project administration: Hongwei Guo.
- Funding acquisition: Hongwei Guo.
Негизги методологиялык чектөөлөр: Көзөмөлдөнгөн жана моделге негизделген симуляция; чыныгы студент маалыматтарынын жоктугу; baseline да estimator менен environment моделинин жакын дал келиши; чектелген prior misspecification тести гана; кичине DAG түзүмдөрү; singleton target set тер; forgetting жана cross-item transfer алып салынганы; binary response; туруктуу acquisition параметрлери; узак-horizon planning жоктугу; contextual learner/instruction attributes сыртта калтырылганы; larger-graph runtime жана memory benchmark жоктугу.
Негизги чечмелөө чеги: Изилдөө TEKSтин чыныгы билим берүү чөйрөсүндөгү натыйжалуулугун далилдебейт. Көзөмөлдөнгөн симуляция шартында target-adjusted one-step acquisition scoring, айрыкча бир нече prerequisite-related талапкер атаандашкан branching түзүмдөрүндө, башка sequencing жүрүм-турумун жана жогору симуляцияланган mastery натыйжаларын жарата аларын көрсөткөн proof-of-concept далил берет.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген