


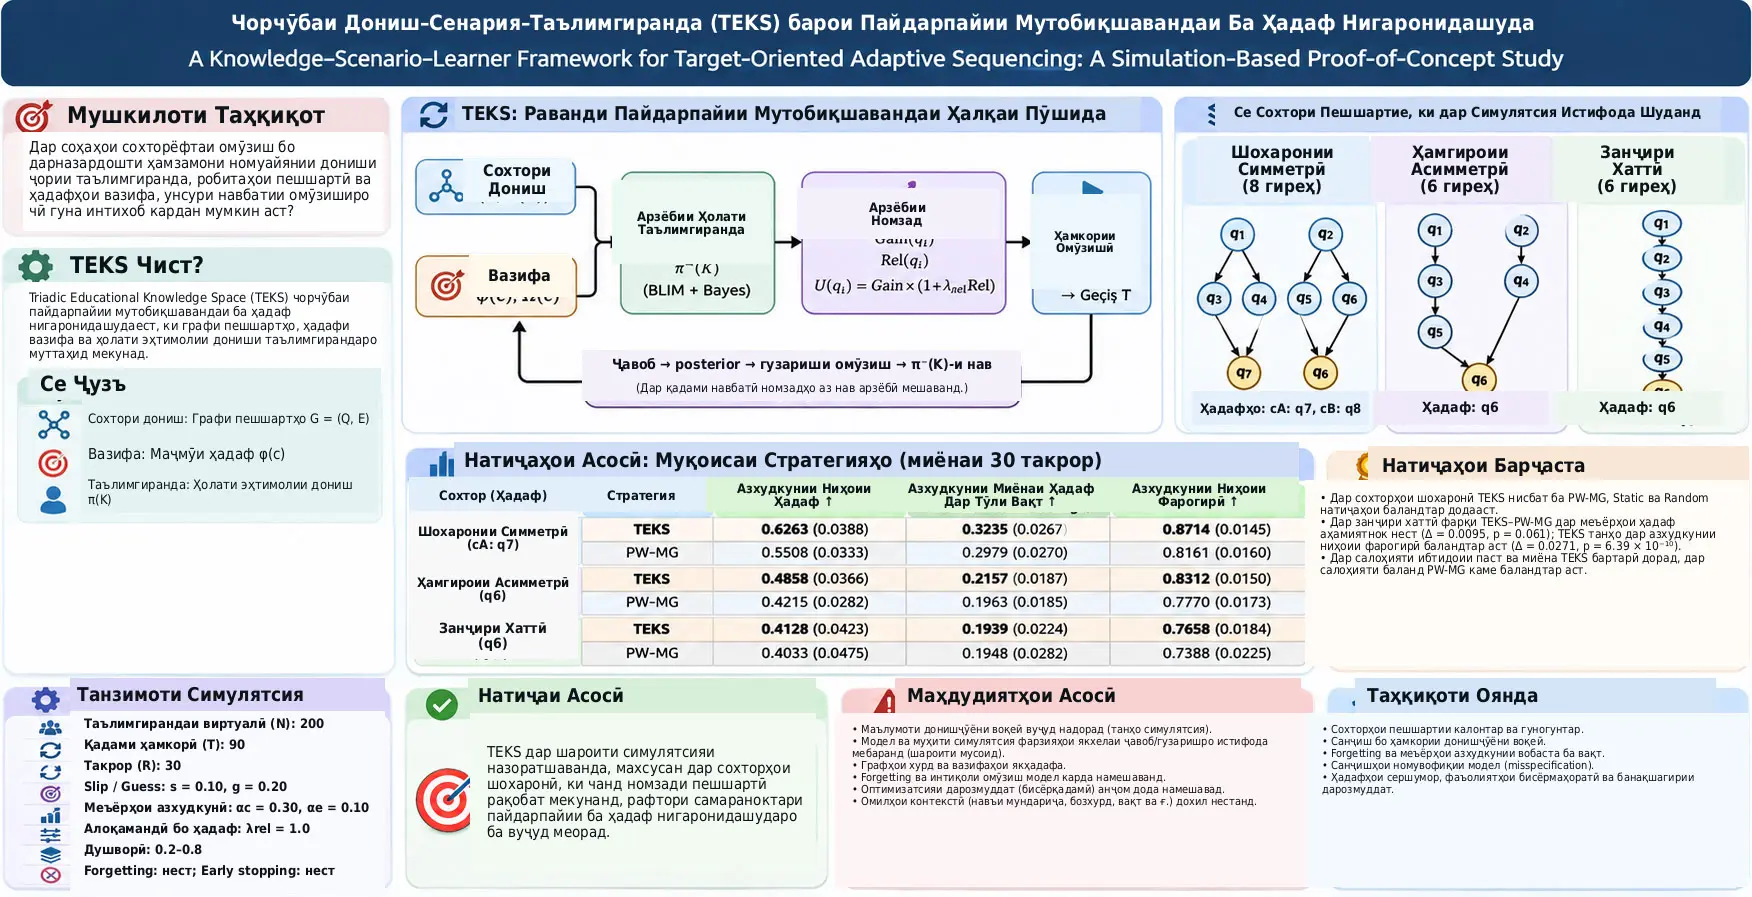
Triadic Educational Knowledge Space (TEKS) — чорчӯбаи пайдарпайии мутобиқшавандаи ба ҳадаф нигаронидашудаест, ки дар соҳаҳои сохторёфтаи омӯзиш барои муайян кардани он ки таълимгиранда дар қадами навбатӣ бояд бо кадом унсури омӯзишӣ ҳамкорӣ кунад, графи пешшартҳо, маҷмӯи ҳадафҳои хоси вазифа ва арзёбии эҳтимолии ҳолати дониши бевосита мушоҳиданашавандаи таълимгирандаро якҷоя истифода мебарад. Таҳқиқот TEKS-ро на дар донишҷӯёни воқеӣ, балки дар симулятсияи назоратшавандаи ҳалқаи пӯшида арзёбӣ кардааст. Се сохтори пешшартӣ баррасӣ шудааст: графи симметрии шохаронии ҳаштгиреҳӣ, графи асимметрии ҳамгироии шашгиреҳӣ ва занҷири хаттии пешшартии шашгиреҳӣ. Дар ҳар шароит 200 таълимгирандаи виртуалӣ, 90 қадами ҳамкорӣ ва 30 такрори мустақил истифода шуда; TEKS дар ҳамон шароити симулятсия бо Prerequisite-Weighted Mastery Gap (PW-MG), стратегияҳои детерминистии Static ва Random муқоиса шудааст.
Мантиқи тасмимгирии TEKS танҳо ба саволи «таълимгиранда кадом мавзӯъро намедонад?» асос намеёбад. Барои ҳар унсури номзади дониш аввал бо дарназардошти ҳолатҳои ҳозираи номуайяни дониш, ҷавобҳои эҳтимолии дуруст/нодуруст ва гузаришҳои минбаъдаи омӯзиш эҳтимоли азхудкунии нави унсур дар ҳамкории навбатӣ ҳисоб карда мешавад. Сипас ин арзиш бо target relevance, ки ба масофаи самтноки унсури номзад аз ҳадафи вазифа дар граф вобаста аст, танзим мешавад. Ҳамин тавр, низом мекӯшад на танҳо унсури норасоро, балки унсуреро авлавият диҳад, ки дар ҳолати ҷорӣ эҳтимоли азхуд шуданаш баланд ва аз ҷиҳати сохторӣ бо ҳадаф алоқаманд аст.
Дар ду сохтори асосии шохаронӣ TEKS аз рӯи меъёрҳои final target mastery, target mastery миёна дар тӯли вақт ва final target-conditioned scope mastery нисбат ба PW-MG, Static ва Random натиҷаҳои баландтар додааст. Дар шароити симметрии \(c_A\) final target mastery барои TEKS 0.6263 ва барои PW-MG 0.5508; дар графи асимметрии ҳамгироӣ бошад мутаносибан 0.4858 ва 0.4215 гузориш шудааст. Аммо дар занҷири хаттии пешшартӣ натиҷаҳои target-level-и TEKS ва PW-MG ба ҳам наздик мондаанд: фарқи final target mastery 0.0095 бо \(p=0.061\), фарқи mean target mastery over time −0.0009 бо \(p=0.728\) буда, фосилаҳои эътимод сифрро дар бар гирифтаанд. Дар муқобил, final scope mastery ба нафъи TEKS фарқи 0.0271 нишон додааст.
Ҳадди тафсири ин натиҷаҳо бисёр муҳим аст. Таҳқиқот рафтори воқеии донишҷӯёнро чен накардааст. Population initialization, response error, acquisition rates, difficulty ва қоидаҳои learning-transition параметрҳои симулятсионие мебошанд, ки муҳаққиқон пешакӣ муайян кардаанд. Дар озмоишҳои Baseline муҳити симулятсия ва learner-state estimator шаклҳои якхелаи response ва transition-ро истифода мебаранд. Аз ин рӯ, таҳқиқот исбот намекунад, ки TEKS дар синфҳои воқеӣ омӯзиши беҳтарро таъмин мекунад; он рафтори ҳисоббарории қоидаҳои гуногуни candidate-selection-ро дар зери фарзияҳои назоратшаванда муқоиса мекунад.
Мушкилоти асосии таҳқиқот чист?
Дар таълими мутобиқшаванда танҳо ба ҷавобҳои таълимгиранда ба чанд саволи охир нигаристан шояд кофӣ набошад. Дар соҳаҳои сохторёфта, аз қабили математика, муҳандисӣ ва илмҳои компютерӣ, барои омӯхтани унсури пешрафтаи дониш аввал бояд пешшартҳои муайян азхуд шуда бошанд. Ҳатто агар низом унсуреро интихоб кунад, ки таълимгиранда дар он заиф аст, агар пешшартҳои он омода набошанд, тавсия метавонад аз ҷиҳати педагогӣ бармаҳал бошад.
Баръакс, пайдарпайии комилан собити омӯзиш метавонад тартиби пешшартҳоро нигоҳ дорад, аммо фарқи дониши ибтидоии таълимгирандагон, суръати пешрафт ва ҷавобҳои мушоҳидашударо ба назар гирифта наметавонад.
Мушкилоте, ки таҳқиқот мехоҳад ҳал кунад, муттаҳид сохтани ин ду талабот аст:
- ба ҳисоб гирифтани номуайянии дониши ҷории таълимгиранда,
- вайрон накардани муносибатҳои пешшартӣ,
- ва бевосита ворид кардани ҳадафи мушаххаси вазифаи ҷорӣ ба интихоби унсури навбатӣ.
Ду саволи таҳқиқот
- Ҳангоми номуайян будани ҳолати дониши таълимгиранда, ҳадафи вазифа дар муҳити омӯзишии сохторёфта бо пешшартҳо чӣ гуна ба раванди next-item selection ворид карда мешавад?
- Оё ин қоидаи интихоби ба ҳадаф нигаронидашуда дар сохторҳои гуногуни пешшартӣ нисбат ба интихоби мутобиқшавандаи бар mastery-gap асосёфта натиҷаҳои дигари пайдарпайӣ ба вуҷуд меорад?
TEKS Чист ва Се Ҷузъро Чӣ Гуна Муттаҳид Мекунад?
TEKS чорчӯбаи пайдарпайии мутобиқшавандаи ҳалқаи пӯшидаест, ки графи ифодакунандаи сохтори пешшартии соҳаи дониш, маҷмӯи ҳадафҳои муайянкунандаи унсурҳои донише, ки вазифаи ҷорӣ мехоҳад ба онҳо бирасад, ва тақсимоти эҳтимолӣ бар ҳолатҳои имконпазири ниҳонии дониши таълимгирандаро якҷоя карда, дар ҳар ҳамкорӣ номзади навбатиро аз нав баҳо медиҳад.
1. Маҷмӯи унсурҳои дониш
Унсурҳои дониш дар соҳаи омӯзиш:
\[ Q=\{q_1,q_2,\ldots,q_n\} \]
муайян карда мешаванд.
Дар ин ҷо \(q_i\) як мафҳум ё унсури омӯзиширо, \(n\) бошад шумораи умумии унсурҳои донишро нишон медиҳад. Инҳо бузургиҳои дорои воҳиди физикӣ нестанд; онҳо гиреҳҳои дискретии дониш дар модел мебошанд.
2. Графи пешшартҳо
Сохтори дониш бо графи самтнок нишон дода мешавад:
\[ G=(Q,E) \]
Дар ин ҷо \(E\subseteq Q\times Q\) маҷмӯи канораҳои самтнок аст. Агар:
\[ q_i\rightarrow q_j \]
канора вуҷуд дошта бошад, \(q_i\) пешшарти бевоситаи \(q_j\) мебошад.
Маҷмӯи пешшартҳои бевоситаи як унсур:
\[ Pre(q_j)=\{q_i\in Q:(q_i,q_j)\in E\} \]
ба ин шакл муайян мешавад.
3. Ҳолатҳои дониш, ки бо пешшартҳо мувофиқанд
Ҳолати ниҳонии дониши таълимгиранда ҳамчун ҳар гуна зермаҷмӯи тасодуфии унсурҳои донистааш қабул намешавад. Агар таълимгиранда як унсури пешрафтаро донад, пешшартҳои бевоситаи он низ бояд дар ҳолати дониш мавҷуд бошанд:
\[ \mathcal{K}(G)=\{K\subseteq Q:q_j\in K\Rightarrow Pre(q_j)\subseteq K\} \]
Ин маҷмӯъ ҳамаи ҳолатҳои prerequisite-consistent latent knowledge states-ро, ки мувофиқи граф иҷозат дода шудаанд, дар бар мегирад.
Масалан, агар \(q_1\rightarrow q_3\) бошад, ҳолате ки таълимгиранда \(q_3\)-ро медонад, вале \(q_1\)-ро намедонад, дар \(\mathcal{K}(G)\) дуруст ҳисоб намешавад.
4. Сенария ё ҳадафи вазифа
Дар таҳқиқот “scenario” ҳамчун ҳикояи мураккаби контекстӣ модел намешавад. Ҳар вазифаи \(c\) бо маҷмӯи унсурҳои донише, ки ҳадаф қарор медиҳад, ифода мешавад:
\[ \phi(c)\subseteq Q \]
\(\phi(c)\) ҳадафи омӯзишии вазифаи \(c\) мебошад.
Ин тафовут муҳим аст: дар ҳоле ки графи дониш сохтори тамоми соҳаро медиҳад, \(\phi(c)\) танҳо муайян мекунад, ки дар ҳамон вазифа кадом унсурҳои дониш ҳадафанд.
5. Ҳолати ниҳонии таълимгиранда
Ҳолати воқеӣ, вале бевосита мушоҳиданашавандаи дониши таълимгиранда:
\[ K_{u,t}\in\mathcal{K}(G) \]
нишон дода мешавад.
Дар ин ҷо:
- \(u\): индекси таълимгиранда,
- \(t\): қадами ҳамкорӣ,
- \(K_{u,t}\): маҷмӯи унсурҳое мебошад, ки тахмин мешавад таълимгиранда дар ҳамон лаҳза воқеан азхуд кардааст.
Дар татбиқи воқеӣ низом \(K_{u,t}\)-ро бевосита дида наметавонад. Дар симулятсия hidden state танҳо барои он маълум аст, ки муҳити симулятсия ҷавоб ва гузариши омӯзишӣ тавлид кунад.
6. Эътиқод дар бораи ҳолати таълимгиранда
Низом ба ҷойи додани як қарор, ки “таълимгиранда ҳамин мавзӯъҳоро медонад”, тақсимоти арзёбиро бар ҳамаи ҳолатҳои имконпазири дониш нигоҳ медорад:
\[ \pi_{u,t}^{-}(K)=P(K_{u,t}=K\mid H_{u,t}),\qquad K\in\mathcal{K}(G) \]
\(H_{u,t}\) таърихи ҳамкории мавҷуд то ҳамон лаҳза мебошад. Аломати болоии “−” ҳолати predictive distribution-ро пеш аз он ки ҷавоби ҷорӣ мушоҳида шавад, нишон медиҳад.
Бартарии ин тақсимот дар нигоҳ доштани номуайянӣ аст. Низом ба ҷойи гуфтани “таълимгиранда ҳатман дар ҳамин ҳолат аст”, метавонад, масалан, ба чанд ҳолати мувофиқи дониш эҳтимолҳои гуногун диҳад.
BLIM Ҳолати Дониши Таълимгирандаро Чӣ Гуна Нав Мекунад?
Basic Local Independence Model (BLIM) байни ҳолати ниҳонии дониши таълимгиранда ва ҷавоби мушоҳидашудаи дуруст/нодуруст робитаи эҳтимолӣ месозад; таълимгиранда ҳатто агар унсурро донад, аз сабаби slip метавонад ҷавоби нодуруст диҳад, ва ҳатто агар надонад, аз сабаби guess метавонад ҷавоби дуруст диҳад; баъдан ҷавоби мушоҳидашуда эҳтимолҳои ҳамаи ҳолатҳои имконпазири донишро бо қоидаи Байес нав мекунад.
Чаро дар оғоз ҳолати воқеӣ ва эътиқоди модел ҷудоанд?
Ҳолати ниҳонии ибтидоӣ дар симулятсия:
\[ K_{u,0}\sim \nu_0^{(c)} \]
намунагирӣ мешавад.
Дар ин ҷо:
\[ \nu_0^{(c)}(K)=P(K_{u,0}=K\mid c) \]
тақсимоти воқеии ибтидоии популятсияи симулятсия мебошад.
Learner-state estimator бошад дар оғоз:
\[ \pi_{u,0}^{-}(K)=p_0^{(c)}(K) \]
тақсимоти prior-ро истифода мебарад.
Ҳар ду тақсимот бар ҳолатҳои дуруст нормализатсия мешаванд:
\[ \sum_{K\in\mathcal{K}(G)}\nu_0^{(c)}(K) = \sum_{K\in\mathcal{K}(G)}p_0^{(c)}(K) =1 \]
Дар симулятсияи Baseline:
\[ p_0^{(c)}=\nu_0^{(c)} \]
мутобиқ карда шудааст. Ин барои estimator шароити мусоид аст. Бахши sensitivity analysis-и таҳқиқот барои prior mismatch \(p_0\)-ро тағйир дода, population distribution-и воқеии \(\nu_0\)-ро собит нигоҳ доштааст.
Эҳтимоли тахминии азхудкунӣ дар сатҳи гиреҳ
Аз тақсимоти пурраи эҳтимолӣ эҳтимоли тахминии азхудкунии як унсур чунин гирифта мешавад:
\[ \widehat{m}_{u,t,i}^{-} = \sum_{K\in\mathcal{K}(G)} \mathbf{1}(q_i\in K)\pi_{u,t}^{-}(K) \]
Функсияи нишондиҳанда дар ин ҷо:
- агар \(q_i\in K\) бошад 1,
- агар не 0
арзиш мегирад.
Аз ин рӯ, ҷамъ ҳисоб мекунад, ки чӣ қадар аз массаи эҳтимолӣ дар ҳолатҳое ҷойгир аст, ки \(q_i\) аллакай дониста шудааст.
Slip ва guess
Таълимгиранда ба унсури интихобшудаи \(q_{u,t}^{*}\) ҷавоб медиҳад ва натиҷа:
\[ r_{u,t}\in\{0,1\} \]
нишон дода мешавад.
\(r=1\) ҷавоби дуруст ва \(r=0\) ҷавоби нодурустро ифода мекунад.
BLIM эҳтимоли ҷавоби дурустро:
\[ P(r_{u,t}=1\mid K_{u,t},q_{u,t}^{*})= \begin{cases} 1-s, & q_{u,t}^{*}\in K_{u,t}\\ g, & q_{u,t}^{*}\notin K_{u,t} \end{cases} \]
ба ин шакл муайян мекунад.
Дар ин ҷо:
- \(s\): slip probability; эҳтимоли он ки таълимгиранда ба унсуре, ки воқеан медонад, ҷавоби нодуруст диҳад.
- \(g\): guess probability; эҳтимоли он ки таълимгиранда ба унсуре, ки воқеан намедонад, ҷавоби дуруст диҳад.
Дар симулятсияи Baseline:
- \(s=0.10\),
- \(g=0.20\)
истифода шудааст.
Аз ин рӯ, ҷавоби дуруст маънои «таълимгиранда ҳатман медонад» ва ҷавоби нодуруст маънои «таълимгиранда ҳатман намедонад»-ро надорад.
Навсозии Байес
Пас аз мушоҳидаи ҷавоб эҳтимолҳои ҳолатҳои дониш:
\[ \pi_{u,t}^{+}(K) = \frac{ P(r_{u,t}\mid K,q_{u,t}^{*})\pi_{u,t}^{-}(K) }{ \sum_{L\in\mathcal{K}(G)} P(r_{u,t}\mid L,q_{u,t}^{*})\pi_{u,t}^{-}(L) } \]
нав карда мешаванд.
\(\pi^{+}\) filtering posterior пас аз мушоҳидаи ҷавоб мебошад.
Сурат ду унсурро зарб мекунад:
- эҳтимоли мушоҳида шудани ҷавоб дар ҳамон ҳолати дониш,
- эҳтимоли он ҳолат пеш аз ҷавоб.
Махраҷ бар ҳамаи ҳолатҳои имконпазир нормализатсия мекунад ва ҷамъи эҳтимолҳои posterior-ро боз ба 1 меорад.
Нишондиҳандаи омодагии пешшартҳо
Агар дар як ҳолати дониш ҳамаи пешшартҳои бевоситаи \(q_i\) азхуд шуда бошанд:
\[ R_i(K)=\mathbf{1}[Pre(q_i)\subseteq K] \]
арзиш 1 мешавад.
Барои root item, зеро \(Pre(q_i)=\varnothing\), ин шарт худкор иҷро мешавад.
Эҳтимоли омӯзиш вобаста ба ҷавоб
Агар таълимгиранда ҳанӯз \(q_i\)-ро надонад ва пешшартҳо омода бошанд, acquisition probability:
\[ \rho_i(r)= \begin{cases} \alpha_c(1-d_i), & r=1\\ \alpha_e(1-d_i), & r=0 \end{cases} \]
чунин аст.
Дар ин ҷо:
- \(d_i\in[0,1]\): параметри difficulty-и унсур,
- \(\alpha_c\): base acquisition rate пас аз ҷавоби дуруст,
- \(\alpha_e\): base acquisition rate пас аз ҷавоби нодуруст.
Модел фарзияи:
\[ \alpha_c>\alpha_e \]
ро истифода мебарад.
Baseline:
- \(\alpha_c=0.30\),
- \(\alpha_e=0.10\).
Ба сабаби зарбкунандаи \((1-d_i)\), бо зиёд шудани difficulty acquisition probability дар зери ҳамон ҷавоб кам мешавад.
Гузариши омӯзиш
Equation (16) дар манбаъ бо transition kernel-и пурра муайян мекунад, ки унсури интихобшуда чӣ гуна метавонад ба ҳолати нави ниҳонии дониш гузарад.
Мантиқи мухтасар чунин аст:
- агар унсур дониста нашуда бошад ва пешшартҳо омода бошанд, бо эҳтимоли \(\rho_i(r)\) метавонад ба ҳолати дониш илова шавад;
- дар ҳамон шароит бо эҳтимоли \(1-\rho_i(r)\) ҳолат метавонад бетағйир монад;
- агар унсур аллакай дониста шавад ё prerequisites омода набошанд, ҳолат тағйир намеёбад;
- эҳтимоли дигар гузаришҳо 0 аст.
Ин transition ҳамчун monotonic муайян шудааст: дониши бадастомада дар модел гум намешавад. Forgetting ба ин симулятсия дохил карда нашудааст.
Дар муҳити симулятсия ҳолати нави воқеӣ:
\[ K_{u,t+1}\sim T_i^{(r_{u,t})}(K_{u,t},\cdot) \]
намунагирӣ мешавад.
Learner-state estimator бошад тақсимоти posterior-ро тавассути ҳамон transition kernel:
\[ \pi_{u,t+1}^{-}(K') = \sum_{K\in\mathcal{K}(G)} T_i^{(r_{u,t})}(K,K')\pi_{u,t}^{+}(K) \]
ба пеш мебарад.
Ҳамин тавр, ҳангоми оғози ҳамкории нав низом predictive distribution-и навшуда дорад.
TEKS Унсури Баъдиро Бо Кадом Формула Интихоб Мекунад?
TEKS аввал доираи номзадҳоро бар асоси ҳадафи вазифа ва ҳамаи recursive prerequisites месозад, сипас барои ҳар номзад эҳтимоли азхудкунии навро дар ҳамкории навбатӣ ҳисоб мекунад, ин эҳтимолро бо наздикии графии он ба ҳадаф тақвият медиҳад ва унсуреро интихоб мекунад, ки баландтарин target-adjusted acquisition score дорад.
Доираи номзадҳои вобаста ба ҳадаф
Барои вазифаи \(c\) доираи номзадҳо:
\[ \Omega(c)=\phi(c)\cup Pre^{*}(\phi(c)) \]
муайян карда мешавад.
\(Pre^{*}\) на танҳо пешшартҳои мустақим, балки ҳамаи recursive prerequisite ancestors-и ҳадафҳоро ифода мекунад.
Аз ин рӯ, система ба ҷойи интихоби тасодуфӣ аз тамоми олами \(Q\), ба унсурҳое тамаркуз мекунад, ки аз ҷиҳати сохторӣ бо ҳадаф алоқаманданд.
Эҳтимоли азхудкунӣ дар як қадам: Gain
Бузургии марказии TEKS:
\[ Gain_{u,t}(q_i) = \sum_{K\in\mathcal{K}(G)} \pi_{u,t}^{-}(K) \sum_{r\in\{0,1\}} P(r\mid K,q_i) \sum_{K'\in\mathcal{K}(G)} T_i^{(r)}(K,K') \left[ \mathbf{1}(q_i\in K')-\mathbf{1}(q_i\in K) \right] \]
мебошад.
Ҳарчанд формула дар назари аввал мураккаб менамояд, он се номуайяниро якҷоя миёнагирӣ мекунад:
- Таълимгиранда ҳоло метавонад дар кадом ҳолати ниҳонӣ бошад? — \(\pi^{-}(K)\)
- Ба унсури интихобшуда метавонад дуруст ё нодуруст ҷавоб диҳад? — \(P(r\mid K,q_i)\)
- Пас аз ҷавоб метавонад ба кадом ҳолати нави дониш гузарад? — \(T_i^{(r)}(K,K')\)
Қавси квадратии охирин:
\[ \mathbf{1}(q_i\in K')-\mathbf{1}(q_i\in K) \]
танҳо вақте ба 1 баробар мешавад, ки \(q_i\) дар ҳолати ҷорӣ маълум набошад, вале дар ҳолати баъдӣ азхуд шавад.
Пас, \(Gain_{u,t}(q_i)\), тавре ки дар манбаъ шарҳ дода шудааст, эҳтимоли тахминии азхудкунии нави унсури номзад дар ҳамкории навбатӣ мебошад.
Масофаи самтнок то ҳадаф
Масофаи номзад дар тӯли роҳи самтноки prerequisite-to-dependent то target item:
\[ D_c^{tar}(q_i) = \min_{q_g\in\phi(c)} dist_G(q_i,q_g) \]
мебошад.
Холи наздикӣ ба ҳадаф:
\[ Rel_c(q_i)=\frac{1}{1+D_c^{tar}(q_i)} \]
муайян карда мешавад.
Дар натиҷа:
- барои target item \(D=0\) ва \(Rel=1\),
- барои prerequisite, ки як канор аз ҳадаф дур аст, \(Rel=1/2\),
- дар масофаи ду канор \(Rel=1/3\)
мешавад.
Ин мисолҳо натиҷаи мустақими математикии формула мебошанд; онҳо бозёфти нави таҷрибавӣ нестанд.
Холи utility-и TEKS
Холи ниҳоии TEKS:
\[ U_{u,t}^{TEKS}(q_i) = Gain_{u,t}(q_i) \left[ 1+\lambda_{rel}Rel_c(q_i) \right] \]
мебошад.
\(\lambda_{rel}\geq0\) қувваи target relevance adjustment-ро муайян мекунад.
Дар таҳқиқоти baseline:
\[ \lambda_{rel}=1.0 \]
истифода шудааст.
Вақте ки \(\lambda_{rel}=0\):
\[ U^{TEKS}=Gain \]
мешавад; яъне зарбкунандаи relevance-и графӣ аз амал мебарояд ва усул танҳо ба predictive one-step acquisition scoring табдил меёбад.
Дар sensitivity analysis идома ёфтани фарқи TEKS–PW-MG ҳатто дар шарти \(\lambda_{rel}=0\) нишон медиҳад, ки тафовути TEKS ва PW-MG танҳо аз зарбкунандаи relevance сарчашма намегирад; ҳисоби expected-acquisition низ саҳми алоҳида дорад. Аммо манбаъ ин бозёфтро ба маънои он шарҳ намедиҳад, ки \(\lambda_{rel}=1.0\) оптималӣ аст.
Қоидаи интихоб
Унсури навбатӣ:
\[ q_{u,t}^{*} = \arg\max_{q_i\in\Omega(c)} U_{u,t}^{TEKS}(q_i) \]
интихоб карда мешавад.
Яъне ҳамаи унсурҳои доираи номзадҳо хол мегиранд ва унсуре, ки холи бузургтарини TEKS дорад, интихоб мешавад.
Агар холҳо баробар шаванд, манбаъ бо интихоби номзаде, ки node identifier-и хурдтар дорад, tie-breaking анҷом медиҳад.
Оё TEKS давраи дарозмуддатро оптимизатсия мекунад?
Не. TEKS дар манбаъ ба таври равшан ҳамчун myopic one-step selection муайян карда мешавад. Дар ҳар қадам он ба ҳамкории навбатӣ менигарад; тамоми ояндаро барои cumulative reward-и дарозмуддат мисли reinforcement learning мустақиман оптимизатсия намекунад.
Ин ҳолат тафсирпазирии моделро беҳтар мекунад, вале маънои кафолат дода шудани роҳи оптималии дарозмуддати омӯзишро надорад.
Фарқи асосӣ аз PW-MG чист?
Барои PW-MG аввал эҳтимоли азхуд шудани prerequisites-и мустақим:
\[ \widehat{R}_{u,t,i}^{-} = \sum_{K\in\mathcal{K}(G)} \mathbf{1}[Pre(q_i)\subseteq K] \pi_{u,t}^{-}(K) \]
ҳисоб карда мешавад.
Холи PW-MG:
\[ U_{u,t}^{PW-MG}(q_i) = \left(1-\widehat{m}_{u,t,i}^{-}\right) \widehat{R}_{u,t,i}^{-} \]
мебошад.
Дар ин ҷо:
- \(1-\widehat{m}^{-}\): mastery gap, яъне эҳтимоли ҳанӯз маълум набудани номзад,
- \(\widehat{R}^{-}\): эҳтимоли омода будани prerequisites мебошад.
Ҳамин тавр, PW-MG номзадҳои «камбуд ва пешшартҳояшон омода»-ро дар авлавият мегузорад.
TEKS бошад, ба ҷойи ин, эҳтимоли воқеии азхуд шудани номзад дар қадами навбатӣ-ро тавассути модели response ва transition ҳисоб карда, онро бо graph relevance ба ҳадаф танзим мекунад.
Мавқеи TEKS дар байни чор усули муқоиса
| Стратегия | Мутобиқшаванда аст? | Истифодаи prerequisite | Мантиқи асосии интихоб |
|---|---|---|---|
| TEKS | Бале | Бале | Predictive one-step acquisition + target relevance |
| PW-MG | Бале | Бале | Mastery gap × prerequisite readiness |
| Static | Не | Тартиби топологиро истифода мебарад | Барномаи детерминистии пешакӣ муайяншуда |
| Random | Не | Дар холи интихоб истифода намекунад | Интихоби uniform random аз дохили \(\Omega(c)\) |
Се сохтори дониш, ки дар симулятсия истифода шудаанд
Графи шохаронии симметрӣ
Дар манбаъ сохтори ҳаштгиреҳӣ аз канорҳои зерин иборат аст:
\[ E_{sym}= \{ (q_1,q_3),(q_1,q_4),(q_2,q_5),(q_2,q_6), (q_3,q_7),(q_5,q_7),(q_4,q_8),(q_6,q_8) \} \]
Ду шарти вазифа вуҷуд дорад:
\[ \phi(c_A)=\{q_7\} \]
\[ \Omega(c_A)=\{q_1,q_2,q_3,q_5,q_7\} \]
ва:
\[ \phi(c_B)=\{q_8\} \]
\[ \Omega(c_B)=\{q_1,q_2,q_4,q_6,q_8\} \]
Ин ду шарт target depth, шумораи prerequisite ва path structure-и якхела доранд. Аз ин рӯ, манбаъ \(c_A\) ва \(c_B\)-ро на ҳамчун ду натиҷаи мустақили графӣ, балки якҷоя ҳамчун symmetry check шарҳ медиҳад.
Графи ҳамгироии асимметрӣ
Сохтори шашгиреҳӣ:
\[ E_{asym} = \{ (q_1,q_3),(q_3,q_5),(q_2,q_4),(q_5,q_6),(q_4,q_6) \} \]
муайян шудааст.
Дар ин ҷо:
\[ q_1\rightarrow q_3\rightarrow q_5\rightarrow q_6 \]
шохаи дарозтарро,
\[ q_2\rightarrow q_4\rightarrow q_6 \]
шохаи кӯтоҳтарро ташкил медиҳад.
Ҳадаф ва доираи номзадҳо:
\[ \phi(c_{asym})=\{q_6\} \]
\[ \Omega(c_{asym})=\{q_1,q_2,q_3,q_4,q_5,q_6\} \]
мебошанд.
Занҷири хаттии пешшартҳо
Сохтори хаттӣ:
\[ q_1\rightarrow q_2\rightarrow q_3\rightarrow q_4\rightarrow q_5\rightarrow q_6 \]
мебошад.
Дар ин ҷо ҳадаф \(q_6\) аст ва ҳамаи шаш гиреҳ дар candidate scope қарор доранд.
Азбаски дар ин сохтор alternative prerequisite branch вуҷуд надорад, фазое, ки дар он усулҳои пайдарпайӣ метавонанд интихоби гуногун кунанд, нисбат ба графҳои шохаронӣ хеле маҳдудтар аст.
Difficulty чӣ гуна таъин мешавад?
Арзиши difficulty-и гиреҳ аз topological depth ҳосил шудааст:
\[ d_i = 0.2+ 0.6 \frac{depth(q_i)} {\max_{q_j\in Q}depth(q_j)} \]
Азбаски барои source node-ҳо depth=0:
\[ d_i=0.2 \]
мешавад.
Барои гиреҳ дар амиқии максималӣ, азбаски таносуб 1 аст:
\[ d_i=0.8 \]
ба даст меояд.
Ҳамин тавр, тавре ки дар манбаъ гузориш шудааст, арзишҳои difficulty дар фосилаи 0.2–0.8 тағйир меёбанд.
Фазои ҳолатҳои шароити графӣ
| Шарт | Ҳадаф | |Ω(c)| | |K(G)| | |K0(c)| |
|---|---|---|---|---|
| Шохаронии симметрӣ \(c_A\) | q7 | 5 | 34 | 9 |
| Шохаронии симметрӣ \(c_B\) | q8 | 5 | 34 | 9 |
| Ҳамгироии асимметрӣ | q6 | 6 | 13 | 12 |
| Занҷири хаттӣ | q6 | 6 | 7 | 6 |
Гурӯҳҳои салоҳияти ибтидоӣ
Дастгирии ҳолати ибтидоӣ:
\[ \mathcal{K}_0(c) = \{ K\in\mathcal{K}(G): K\subseteq\Omega(c),\; \phi(c)\nsubseteq K \} \]
муайян карда мешавад.
Ин шарт ду корро анҷом медиҳад:
- дониши ибтидоиро дар дохили candidate scope-и вазифа нигоҳ медорад;
- таълимгирандагонеро, ки аллакай тамоми маҷмӯи ҳадафро азхуд кардаанд, аз ибтидо хориҷ мекунад.
Арзиши mastery proportion-и ибтидоии як ҳолат:
\[ m_0(K)= \frac{|K\cap\Omega(c)|}{|\Omega(c)|} \]
ҳисоб карда мешавад.
Гурӯҳҳо:
- Салоҳияти паст: \(m_0(K)<1/3\)
- Салоҳияти миёна: \(1/3\leq m_0(K)<2/3\)
- Салоҳияти баланд: \(m_0(K)\geq2/3\)
мебошанд.
Balanced population initial-state distribution ба ҳар яке аз ин се гурӯҳи салоҳият \(1/3\)-и массаи умумии эҳтимолро медиҳад ва ин массаро байни ҳолатҳои эътиборноки дохили гурӯҳ баробар тақсим мекунад.
Усул ва Натиҷаҳои Таҳқиқот
Тарҳи симулятсия
| Параметр | Арзиш | Маъно |
|---|---|---|
| Таълимгирандаи виртуалӣ / такрор \(N\) | 200 | Шумораи virtual learner дар ҳар такрори мустақил |
| Decision horizon \(T\) | 90 | Қадами item-selection/response барои ҳар таълимгиранда |
| Такрори мустақил \(R\) | 30 | Шумораи намунаҳо дар сатҳи такрор барои муқоисаи оморӣ |
| Slip \(s\) | 0.10 | Эҳтимоли ҷавоби нодуруст ба унсури маълум |
| Guess \(g\) | 0.20 | Эҳтимоли ҷавоби дуруст ба унсури номаълум |
| \(\alpha_c\) | 0.30 | Base acquisition rate пас аз ҷавоби дуруст |
| \(\alpha_e\) | 0.10 | Base acquisition rate пас аз ҷавоби нодуруст |
| \(\lambda_{rel}\) | 1.0 | Қувваи target relevance adjustment |
| Difficulty | 0.2–0.8 | Фосилаи аз topological depth ҳосилшуда |
| Forgetting | Хориҷ карда шудааст | Mastered item аз даст намеравад |
| Early stopping | Нест | Ҳамаи таълимгирандагон horizon-и собитро ба анҷом мерасонанд |
Барои одилона нигоҳ доштани муқоиса чӣ баробар карда шуд?
Чор усул шартҳои якхелаи:
- initial-state generation,
- response model,
- state-transition mechanism,
- candidate scope,
- interaction budget
истифода карданд.
Барои ҳар learner/repetition ҳамон hidden initial state байни усулҳо муштарак буд. Барои paired strategy comparisons common random numbers истифода шуданд; барои graph, repetition, learner ва decision step-и муайян стратегияҳо ҳамон response ва acquisition uniform draws-ро муштарак истифода карданд.
Ҳадафи ин тарҳ то ҳадди имкон ҷудо кардани фарқи байни усулҳо аз садои интихоби тасодуфӣ мебошад.
Барномаи стратегияи Static
Static baseline номзадҳоро аввал аз рӯи topological level, сипас аз рӯи node identifier давр мезанад.
Quota-и асосӣ:
\[ \left\lfloor\frac{T}{|\Omega(c)|}\right\rfloor \]
ҳисоб карда мешавад.
Барои \(T=90\):
- дар шароити симметрӣ, азбаски 5 номзад вуҷуд дорад, ҳар номзад 18 маротиба,
- дар шароити асимметрӣ ва linear, азбаски 6 номзад вуҷуд дорад, ҳар номзад 15 маротиба
интихоб мешавад.
Се метрикаи арзёбӣ
1. Final target mastery
\[ M_u^{tar}(T) = \frac{|K_{u,T}\cap\phi(c)|}{|\phi(c)|} \]
Ин метрика нишон медиҳад, ки дар охири horizon чӣ қадар аз маҷмӯи ҳадаф азхуд шудааст.
Дар ин таҳқиқот ҳамаи target set-ҳо аз як унсур иборатанд. Аз ин рӯ, арзиши learner-level 0 ё 1 аст; натиҷаҳои даҳӣ дар ҷадвалҳо аз ҷамъбасти 200 таълимгиранда ва такрорҳо ба вуҷуд меоянд.
2. Mean target mastery over time
\[ \overline{M}_u^{tar} = \frac{1}{T+1} \sum_{t=0}^{T} \frac{|K_{u,t}\cap\phi(c)|}{|\phi(c)|} \]
Ин арзиш на танҳо натиҷаи қадами 90, балки то чӣ андоза барвақт расидан ба ҳадафро дар тамоми trajectory низ ба ҳисоб мегирад.
Манбаъ онро ҳамчун муодили discrete area under the curve-и нормализатсияшудаи target-mastery trajectory шарҳ медиҳад.
3. Final scope mastery
\[ M_u^{\Omega}(T) = \frac{|K_{u,T}\cap\Omega(c)|}{|\Omega(c)|} \]
Ин метрика сатҳи омӯзишро на танҳо дар гиреҳи ҳадаф, балки дар тамоми task-specific scope, аз ҷумла prerequisites-и марбут ба ҳадаф, чен мекунад.
Таҳлили оморӣ чӣ гуна анҷом дода шуд?
Хулосабарории оморӣ на дар сатҳи learner, балки дар сатҳи repetition анҷом дода шуд.
Дар дохили ҳар repetition натиҷаҳои 200 таълимгиранда аввал миёнагирӣ шуданд. Ҳамин тавр, барои ҳар strategy × condition 30 repetition-level mean ба даст омад.
Фарқҳои ҷуфтшуда байни TEKS ва ҳар baseline:
\[ D_r= \text{TEKS}_r-\text{Baseline}_r \]
бо ҳамин мантиқ арзёбӣ шуданд.
Барои primary comparisons two-sided paired t-test истифода шуд.
Унсурҳои гузоришшуда:
- mean paired difference,
- %95 t confidence interval,
- paired Cohen's \(d_z\),
- арзиши p,
- арзиши Holm-adjusted p барои primary branching analyses
мебошанд.
Paired Cohen's dz чиро нишон медиҳад?
Equation (40)-и манбаъ:
\[ d_z=\frac{\overline{D}}{s_D} \]
мебошад.
Дар ин ҷо:
- \(\overline{D}\): миёнаи paired differences дар 30 такрор,
- \(s_D\): sample standard deviation-и ҳамон paired differences мебошад.
\(d_z\) фарқи миёнаи ҷуфтшудаи байни TEKS ва baseline-ро дар воҳидҳои инҳирофи стандартии ҳамин фарқҳо ифода мекунад.
Ин андозаи таъсир набояд ҳамчун андозаи стандартии таъсири таълимӣ дар донишҷӯёни воқеӣ тафсир карда шавад; дар ин таҳқиқот он бузургии paired strategy difference байни такрорҳои симулятсия мебошад.
Чаро ислоҳи Holm истифода шуд?
Дар ҳар шарти ҳадафи симметрӣ се outcome × се TEKS–baseline contrast = нӯҳ санҷиш ба вуҷуд меояд. Азбаски ҳангоми гузаронидани шумораи зиёди санҷишҳои гипотеза эҳтимоли тасодуфан гирифтани арзишҳои хурди p меафзояд, ба арзишҳои p-и paired t-test Holm correction татбиқ карда шуд.
Барои \(c_A\) ва \(c_B\) correction алоҳида анҷом дода шуд. Азбаски ин ду шарт structurally isomorphic мебошанд ва coupled random streams истифода мекунанд, натиҷаҳо ҳамчун symmetry check тафсир шуданд.
Графи асимметрӣ як оилаи ҷудогонаи нӯҳсанҷиширо ташкил дод.
Азбаски linear chain secondary structural analysis мебошад, он ба Holm-adjusted primary family дохил нашуд ва арзишҳои p ҳамчун unadjusted дода шуданд.
Wilcoxon signed-rank test-ҳо дар supplement ҳамчун unadjusted robustness check гузориш шуданд.
Натиҷаҳои асосӣ дар графи шохаронии симметрӣ
| Стратегия | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.6263 (0.0388) | 0.3235 (0.0267) | 0.8714 (0.0145) |
| PW-MG | 0.5508 (0.0333) | 0.2979 (0.0270) | 0.8161 (0.0160) |
| Static | 0.2847 (0.0415) | 0.0318 (0.0046) | 0.7776 (0.0147) |
| Random | 0.1908 (0.0239) | 0.0913 (0.0137) | 0.7370 (0.0139) |
Натиҷаҳои paired TEKS–PW-MG:
| Метрика | Фарқи миёна | %95 CI | Cohen's dz | Holm-adjusted p |
|---|---|---|---|---|
| Final target mastery | 0.0755 | [0.0641, 0.0869] | 2.48 | 8.39 × 10⁻¹⁴ |
| Mean target mastery over time | 0.0256 | [0.0200, 0.0312] | 1.71 | 2.79 × 10⁻¹⁰ |
| Final scope mastery | 0.0552 | [0.0499, 0.0605] | 3.89 | 8.86 × 10⁻¹⁹ |
Ҳамин натиҷаҳои TEKS–PW-MG барои \(c_B\) низ ба даст омадаанд.
TEKS ва PW-MG дар қадамҳои ибтидоӣ target-mastery trajectories-и ба ҳам наздик нишон доданд, вале дар қисми баъдии уфуқи қарор trajectory-и миёнаи TEKS баландтар буд.
Ҷолиб он аст, ки TEKS %52,31-и интихобҳоро ба target node ҷудо кардааст, дар ҳоле ки PW-MG %59,24-ро ба target node ҷудо кардааст. Бо вуҷуди ин, TEKS дар target mastery натиҷаи баландтар дод.
Манбаъ инро чунин шарҳ медиҳад: агар қисми назарраси predictive state distribution ба ҳолатҳое тааллуқ дошта бошад, ки target prerequisites ҳанӯз омода нестанд, ин ҳолатҳо ба ҳисоби one-step acquisition gain-и target саҳми сифр медиҳанд. Ҳамин тавр, TEKS дар баъзе марҳилаҳо ба ҷойи дубора интихоб кардани худи ҳадаф, ба prerequisites-и ҳанӯз азхуднашуда равона мешавад.
Натиҷаҳо дар графи ҳамгироии асимметрӣ
| Стратегия | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.4858 (0.0366) | 0.2157 (0.0187) | 0.8312 (0.0150) |
| PW-MG | 0.4215 (0.0282) | 0.1963 (0.0185) | 0.7770 (0.0173) |
| Static | 0.1598 (0.0254) | 0.0151 (0.0028) | 0.7129 (0.0100) |
| Random | 0.0848 (0.0201) | 0.0360 (0.0092) | 0.6620 (0.0140) |
| Метрика | Фарқи миёна | %95 CI | Cohen's dz | Holm-adjusted p |
|---|---|---|---|---|
| Final target mastery | 0.0643 | [0.0536, 0.0751] | 2.24 | 1.06 × 10⁻¹² |
| Mean target mastery over time | 0.0194 | [0.0142, 0.0247] | 1.37 | 2.72 × 10⁻⁸ |
| Final scope mastery | 0.0542 | [0.0490, 0.0594] | 3.92 | 7.28 × 10⁻¹⁹ |
Дар ин сохтор TEKS интихобҳоро чунин тақсим кардааст:
- %39,08 ба prerequisite branch-и дароз,
- %17,62 ба branch-и кӯтоҳ,
- %43,30 ба target node
ҷудо кардааст.
Арзишҳои мувофиқ барои PW-MG:
- %38,01 branch-и дароз,
- %14,35 branch-и кӯтоҳ,
- %47,65 target
гузориш шудаанд.
Оё TEKS Дар Занҷири Хаттии Пешшартҳо Низ Аз PW-MG Бартарӣ Дорад?
Аз рӯи меъёрҳои target-level не: дар занҷири хаттӣ фарқи final target mastery байни TEKS ва PW-MG 0.0095 ва \(p=0.061\), фарқи mean target mastery over time −0.0009 ва \(p=0.728\) буд ва ҳар ду фосилаи эътимод сифрро дар бар гирифтанд; бартарии равшани TEKS дар final scope mastery дида шуд.
| Стратегия | Final target mastery | Mean target mastery over time | Final scope mastery |
|---|---|---|---|
| TEKS | 0.4128 (0.0423) | 0.1939 (0.0224) | 0.7658 (0.0184) |
| PW-MG | 0.4033 (0.0475) | 0.1948 (0.0282) | 0.7388 (0.0225) |
| Static | 0.1338 (0.0282) | 0.0122 (0.0028) | 0.6349 (0.0214) |
| Random | 0.0818 (0.0220) | 0.0417 (0.0129) | 0.5720 (0.0180) |
| Метрика | Фарқи миёна | %95 CI | dz | p |
|---|---|---|---|---|
| Final target mastery | 0.0095 | [−0.0005, 0.0195] | 0.36 | 0.061 |
| Mean target mastery over time | −0.0009 | [−0.0059, 0.0042] | −0.06 | 0.728 |
| Final scope mastery | 0.0271 | [0.0209, 0.0332] | 1.65 | 6.39 × 10⁻¹⁰ |
Ин арзишҳои p барои secondary linear analysis unadjusted мебошанд.
Мувофиқи тафсири манбаъ, сохтори хаттӣ имконоти интихобро сахт маҳдуд мекунад. Вақте чанд prerequisite branch барои интихоб рақобат намекунанд, қоидаҳои интихоби TEKS ва PW-MG дар натиҷаҳои target-level камтар аз ҳам ҷудо мешаванд.
Натиҷаҳо аз рӯи салоҳияти ибтидоӣ
| Гурӯҳ | Стратегия | Final target | Mean target | Final scope |
|---|---|---|---|---|
| Паст | TEKS | 0.4006 | 0.1319 | 0.7682 |
| PW-MG | 0.2787 | 0.0884 | 0.6596 | |
| Static | 0.1972 | 0.0219 | 0.6803 | |
| Random | 0.0479 | 0.0106 | 0.5995 | |
| Миёна | TEKS | 0.5593 | 0.2295 | 0.8601 |
| PW-MG | 0.4480 | 0.1736 | 0.8000 | |
| Static | 0.2530 | 0.0280 | 0.7683 | |
| Random | 0.1331 | 0.0458 | 0.7309 | |
| Баланд | TEKS | 0.9130 | 0.6039 | 0.9826 |
| PW-MG | 0.9188 | 0.6266 | 0.9838 | |
| Static | 0.3998 | 0.0452 | 0.8800 | |
| Random | 0.3876 | 0.2154 | 0.8775 |
Дар гурӯҳи proficiency-и паст фарқҳои TEKS − PW-MG:
- final target mastery: 0.1219,
- mean target mastery: 0.0436,
- final scope mastery: 0.1086.
Дар гурӯҳи миёна фарқҳои мувофиқ:
- 0.1113,
- 0.0559,
- 0.0601.
Дар гурӯҳи proficiency-и баланд бошад, PW-MG дар ҳар се меъёр миёнаи каме баландтар дод; фарқҳои TEKS − PW-MG мутаносибан:
- −0.0058,
- −0.0227,
- −0.0012
буданд.
Манбаъ ин subgroup comparisons-ро ҳамчун exploratory and descriptive тасниф мекунад; онҳоро ҳамчун натиҷаи асосии тасдиқкунанда шарҳ намедиҳад.
Таҳлили ҳассосият
One-factor-at-a-time sensitivity analysis танҳо дар ду symmetric target condition анҷом дода шудааст.
| Омил | Baseline | Шартҳои алтернативӣ |
|---|---|---|
| \(\lambda_{rel}\) | 1.0 | 0.0, 0.5, 2.0 |
| Decision horizon \(T\) | 90 | 60, 120 |
| Response noise \((s,g)\) | (0.10, 0.20) | (0.05, 0.10), (0.15, 0.30) |
| Acquisition \((\alpha_c,\alpha_e)\) | (0.30, 0.10) | (0.20, 0.05), (0.40, 0.15) |
| Difficulty function | 0.2 + 0.6h/hmax | 0.1 + 0.5h/hmax; 0.3 + 0.6h/hmax |
| Diagnostic prior | \(p_0=\nu_0\) | uniform дар болои \(\mathcal{K}_0(c)\) |
Дар 12 шарти омӯхташуда TEKS − PW-MG mean paired difference:
- барои final target mastery 0.0300–0.1048,
- барои mean target mastery over time 0.0033–0.0407,
- барои final scope mastery 0.0212–0.0878
тағйир ёфтааст.
Дар шарти slow-acquisition фарқи mean target mastery over time 0.0033 ва %95 CI [−0.0002, 0.0069] гузориш шудааст; фосилаи эътимод сифрро дар бар гирифтааст.
Бузургтарин фарқи final-target дар шарти \(\lambda_{rel}=0\) дида шудааст. Ин нишон медиҳад, ки ҷузъи predictive expected-acquisition ҳатто бидуни relevance multiplier низ ба фарқ аз PW-MG саҳм мегузорад. Аммо ин маънои онро надорад, ки baseline \(\lambda_{rel}=1.0\) оптималӣ аст.
Азбаски таҳлил one-factor-at-a-time мебошад, ҳамкориҳои байни response noise, acquisition speed, difficulty, horizon ва prior омӯхта нашудаанд.
Оё Ин Таҳқиқот Исбот Мекунад, Ки TEKS Дар Донишҷӯёни Воқеӣ Омӯзиши Беҳтарро Таъмин Мекунад?
Не. Ҳамаи натиҷаҳои иҷроиш аз таълимгирандагони виртуалӣ ба даст омадаанд, ки дар доираи фарзияҳои пешакӣ муайяншудаи learner initialization, response-error, acquisition, difficulty ва transition кор мекарданд; ҳамкории донишҷӯёни воқеӣ, татбиқи синфӣ, устувории дониш, интиқоли омӯзиш ё қобили истифода будани таълимӣ дар ин таҳқиқот чен нашудааст.
Натиҷаҳое, ки таҳқиқот дастгирӣ мекунад
- Барои TEKS чорчӯбаи математикӣ муайян шудааст, ки prerequisite constraints, task-specific targets ва learner-state uncertainty-ро дар як қоидаи next-item scoring муттаҳид мекунад.
- Дар симулятсияҳои назоратшавандаи symmetric branching ва asymmetric converging TEKS дар се метрикаи асосии иҷроиш миёнаҳои баландтар аз PW-MG, Static ва Random ба даст овардааст.
- Дар сохторҳои branching фарқҳои target-level байни TEKS ва PW-MG аз рӯи confidence interval аз сифр ҷудо шудаанд.
- Дар linear prerequisite chain фарқи target-level TEKS–PW-MG ба таври намоён кам шуда, CI дар ду метрикаи target сифрро дар бар гирифтааст.
- TEKS дар linear chain аз рӯи final scope mastery нисбат ба PW-MG натиҷаи баландтар дод.
- Дар гурӯҳҳои initial-proficiency-и паст ва миёна таҳти symmetric condition миёнаҳои TEKS аз PW-MG баландтар буданд.
- Дар high-proficiency subgroup PW-MG миёнаҳои каме баландтар дод.
- Мушоҳида шуд, ки фарқи TEKS–PW-MG дар branching structures равшантар аст.
- Натиҷаҳои sensitivity analysis нишон медиҳанд, ки magnitude-и фарқи TEKS–PW-MG вобаста ба параметрҳои симулятсия тағйир меёбад.
Натиҷаҳое, ки таҳқиқот дастгирӣ намекунад
- Исбот нашудааст, ки TEKS муваффақияти омӯзишро дар донишҷӯёни воқеӣ зиёд мекунад.
- Гуфтан мумкин нест, ки TEKS дар ҳамаи сохторҳои prerequisite graph аз PW-MG бартар аст.
- Нишон дода нашудааст, ки \(\lambda_{rel}=1.0\) арзиши оптималӣ мебошад.
- Исбот нашудааст, ки TEKS роҳи оптималии дарозмуддати омӯзишро тавлид мекунад.
- Модел forgetting, transfer between unselected items ё time-varying acquisition-ро намояндагӣ намекунад.
- Тасдиқ нашудааст, ки равандҳои воқеии response ва learning transition бо BLIM ва transition kernel-и истифодашуда пурра намояндагӣ мешаванд.
- Барои knowledge graph-ҳои калон runtime-и воқеӣ ё peak memory benchmark гузориш нашудааст.
- Authentic curriculum, engagement, feedback format, cognitive load ё time constraint ба холи ҷории интихоби модел дохил нашудаанд.
- Аҳамияти омории симулятсия далели аҳамияти амалӣ/таълимӣ дар муҳити воқеии таълим нест.
Миқёспазирии ҳисоббарорӣ
Манбаъ барои exact implementation чунин муайян мекунад:
- \(S=|\mathcal{K}(G)|\): андозаи prerequisite-consistent state-space,
- \(M=|\Omega(c)|\): андозаи task-specific candidate scope
мебошанд.
Дар ҳоле ки BLIM measurement update ва predictive propagation нисбат ба active state support хаттӣ миқёс мегиранд, барои арзёбии ҳамаи TEKS candidate-ҳо манбаъ мураккабии консервативии дастгирии пурраро:
\[ O(MS) \]
медиҳад.
Мушкилоти асосии миқёспазирӣ танҳо ҳосили \(O(MS)\) нест; prerequisite-consistent feasible-state enumeration метавонад бо зиёд шудани шумораи унсурҳои дониш ба таври экспоненсиалӣ афзоиш ёбад.
Сохторҳои таҳқиқот:
- symmetric graph: 34 feasible state,
- asymmetric graph: 13 feasible state,
- linear chain: 7 feasible state
дар бар мегиранд.
Манбаъ ошкоро мегӯяд, ки барои original formal runs андозагириҳои боэътимоди wall-clock runtime ё peak-memory нигоҳ дошта нашудаанд. Аз ин рӯ, Verianla тахмини нави иҷроиш/вақт тавлид намекунад.
Маҳдудиятҳои асосӣ
1. Controlled simulation: Маълумоти донишҷӯёни воқеӣ истифода нашудааст.
2. Model-environment alignment: Дар baseline experiments learner-state estimator ва simulation environment ҳамон шаклҳои response ва transition-ро истифода мебаранд ва diagnostic prior бо population distribution мутобиқ карда шудааст.
3. Limited misspecification: Prior mismatch омӯхта шудааст, вале номувофиқии васеътари response ё learning process-и воқеӣ ба модел санҷида нашудааст.
4. DAG-ҳои хурд: Танҳо directed acyclic graphs-и хурди 8 ё 6 гиреҳ истифода шудаанд.
5. Singleton targets: Ҳар condition як target item дорад.
6. Monotonic acquisition: Forgetting вуҷуд надорад.
7. Transfer нест: Интиқоли омӯзиш байни унсурҳои интихобнашуда моделсозӣ нашудааст.
8. Fixed acquisition parameters: Нисбатҳои acquisition бо вақт ё вобаста ба донишҷӯ тағйир намеёбанд.
9. Binary responses: Ҳар interaction танҳо як унсури дониш ва binary response-ро дар бар мегирад.
10. Myopic utility: TEKS нақшаи оптималии long-horizon-ро ҷустуҷӯ намекунад.
11. Хусусиятҳои контекстӣ нестанд: Resource format, feedback type, time constraint, cognitive load ва learner engagement дар модели интихоб ҷой надоранд.
12. Benchmark-и миқёси калон нест: Андозагирии runtime ва peak-memory гузориш нашудааст.
13. Маънои воқеии таълимӣ номаълум аст: Аз ин таҳқиқот баровардан мумкин нест, ки оё фарқҳои симулятсия ба learning gain-и маънодор дар ҷаҳони воқеӣ табдил меёбанд ё не.
Пешниҳодҳо барои таҳқиқоти оянда
Манбаъ пешниҳод мекунад, ки дар оянда арзёбӣ тавассути:
- prerequisite structures-и калонтар ва гуногунтар,
- authentic curriculum graphs аз соҳаҳои гуногуни академӣ,
- non-singleton target sets,
- multi-skill activities,
- forgetting,
- nonstationary acquisition,
- misspecified response models,
- misspecified transition models,
- approximate ё decomposed inference,
- муқоисаҳои multistep planning ва reinforcement-learning,
- authentic learner interaction data,
- predictive calibration,
- observed learning outcomes,
- persistence,
- instructional usability
анҷом дода шавад.
Ёддошт оид ба Манбаъ ва Усул
Унвони аслӣ: A Knowledge–Scenario–Learner Framework for Target-Oriented Adaptive Sequencing: A Simulation-Based Proof-of-Concept Study.
Муаллифон: Bingqian Li; Hongwei Guo; Jia Hao; Xiaobei Jiang; Hongwei Niu.
Тартиби муаллифон: Тартиби манбаъ айнан нигоҳ дошта шудааст.
Саҳми баробар: Дар манбаъ изҳороти equal-contribution вуҷуд надорад.
Муаллифи масъул: Hongwei Guo.
Муассиса: School of Mechanical Engineering, Beijing Institute of Technology, 5 Zhongguancun South Street, Beijing 100081, China.
Маҷалла: Education Sciences.
Бахш: Technology Enhanced Education.
Ношир: MDPI, Basel, Switzerland.
Ҷилд / шумора / рақами мақола: 16(8), 1344.
DOI: 10.3390/educsci16081344.
Пайванди расмӣ: https://doi.org/10.3390/educsci16081344
Received: 28 June 2026.
Revised: 15 August 2026.
Accepted: 19 August 2026.
Published: 21 August 2026.
Навъи манбаъ: Article; simulation-based proof-of-concept study.
Тақриз: Education Sciences маҷаллаи академии тақризшаванда аст; таҳқиқот мақолаи нашршудаи маҷалла мебошад.
Preprint: Дар PDF-и асосии баррасишуда ва сабти расмии нашр версияи алоҳидаи preprint нишон дода нашудааст.
Иҷозатнома: Creative Commons Attribution (CC BY).
Калидвожаҳо: adaptive learning; target-oriented sequencing; prerequisite-aware sequencing; learner modeling; educational technology.
Модели асосӣ: Triadic Educational Knowledge Space (TEKS).
Модели learner-state response: Basic Local Independence Model (BLIM).
Усулҳои муқоиса: Prerequisite-Weighted Mastery Gap (PW-MG), Static ва Random.
Сохторҳои graph: 8-node symmetric branching graph; 6-node asymmetric converging graph; 6-node linear prerequisite chain.
Symmetric target conditions: \(c_A\rightarrow q_7\) ва \(c_B\rightarrow q_8\); ҳамчун structurally isomorphic symmetry check тафсир шудаанд.
Шумораи таълимгирандагони виртуалӣ: Барои ҳар repetition N=200.
Decision horizon: T=90 interaction steps.
Independent repetitions: R=30.
Slip: s=0.10.
Guess: g=0.20.
Correct-response acquisition rate: \(\alpha_c=0.30\).
Incorrect-response acquisition rate: \(\alpha_e=0.10\).
Target-relevance coefficient: \(\lambda_{rel}=1.0\).
Difficulty range: [0.2, 0.8].
Forgetting: Excluded.
Early stopping: Not applied.
Baseline diagnostic prior: \(p_0^{(c)}=\nu_0^{(c)}\).
Primary performance metrics: final target mastery, mean target mastery over time, final target-conditioned scope mastery.
Таҳлили оморӣ: Repetition-level paired contrasts; two-sided paired t-tests; %95 t confidence intervals; paired Cohen's \(d_z\); Holm correction барои primary test families; Wilcoxon signed-rank test барои supplementary robustness.
Натиҷаҳои асосии symmetric cA TEKS: final target mastery 0.6263 (SD 0.0388); mean target mastery 0.3235 (0.0267); final scope mastery 0.8714 (0.0145).
Фарқҳои Symmetric TEKS–PW-MG: 0.0755; 0.0256; 0.0552. Арзишҳои марбут ба \(d_z\) 2.48, 1.71 ва 3.89 мебошанд.
Натиҷаҳои асосии asymmetric TEKS: 0.4858; 0.2157; 0.8312.
Фарқҳои Asymmetric TEKS–PW-MG: 0.0643; 0.0194; 0.0542.
Натиҷаи Linear-chain: Дар меъёрҳои final target ва mean target TEKS ва PW-MG аз рӯи confidence interval аз ҳам ҷудо нашуданд; final scope mastery ба фоидаи TEKS баландтар аст.
Натиҷаи Initial-proficiency: Дар доираи Symmetric cA exploratory analysis, TEKS дар гурӯҳҳои паст ва миёна баландтар буд; дар гурӯҳи баланд PW-MG миёнаҳои каме баландтар дод.
Sensitivity: One-factor-at-a-time; тағйироти response noise, acquisition rate, horizon, difficulty, target relevance ва diagnostic prior омӯхта шудаанд. Таҳлили ҳамкории байни омилҳо анҷом дода нашудааст.
Мураккабии ҳисоббарорӣ: Барои exact implementation арзёбии conservative full-support-и ҳамаи TEKS candidates \(O(MS)\) аст; feasible-state enumeration бо зиёд шудани шумораи унсурҳои дониш метавонад ба таври экспоненсиалӣ афзоиш ёбад.
Runtime / peak memory: Азбаски барои original formal runs андозагириҳои боэътимод нигоҳ дошта нашудаанд, benchmark-и эмпирикӣ гузориш нашудааст.
Supplementary Materials: Манбаъ мавҷудияти Supplementary Method S1, Tables S1–S3, Supplementary Method S2, Tables S4–S5, Supplementary Data S1 ва S2-ро нишон медиҳад. Ин файлҳои алоҳида ба боргузории ҷории корбар дохил нестанд; мақолаи асосии Verianla бо маълумоте маҳдуд аст, ки source PDF-и 29-саҳифаи боршуда ошкоро гузориш кардааст.
Source repository: Development repository дар марҳилаи ҷории лоиҳа барои умум дастрас нест. Муаллифон мегӯянд, ки Supplementary Method S2 барои independent reimplementation алгоритмӣ ва implementation specifications медиҳад; Supplementary Data S1/S2 натиҷаҳои санҷиданшавандаро дар бар мегиранд.
Funding: National Key Research and Development Program of China, grant 2023YFC3305701.
Institutional Review Board Statement: Not applicable.
Data Availability: Development source repository public нест; дар supplement-ҳо мавҷудияти machine-readable simulation outputs, configurations, provenance/integrity records, analysis-ready results ва figure source data зикр шудааст. Additional clarification-ро метавон аз corresponding author бо reasonable request дархост кард.
Conflicts of Interest: Муаллифон изҳор кардаанд, ки ихтилофи манфиатҳо вуҷуд надорад. Маблағгузор дар тарҳи таҳқиқот, таҳлили маълумот, навиштани мақола ё қарори нашр нақш надоштааст.
Саҳми муаллифон
- Conceptualization: Bingqian Li, Hongwei Guo.
- Methodology: Bingqian Li, Jia Hao.
- Validation: Bingqian Li, Jia Hao, Xiaobei Jiang, Hongwei Niu.
- Formal analysis: Bingqian Li.
- Investigation: Bingqian Li.
- Data curation: Bingqian Li.
- Writing — original draft preparation: Bingqian Li.
- Writing — review and editing: Hongwei Guo, Jia Hao, Hongwei Niu.
- Visualization: Bingqian Li, Xiaobei Jiang.
- Supervision: Hongwei Guo.
- Project administration: Hongwei Guo.
- Funding acquisition: Hongwei Guo.
Маҳдудиятҳои асосии методологӣ: Симулятсияи назоратшаванда ва ба модел асосёфта; набудани маълумоти донишҷӯёни воқеӣ; мутобиқати наздики estimator ва environment model дар baseline; танҳо санҷиши маҳдуди prior misspecification; сохторҳои хурди DAG; singleton target set-ҳо; хориҷ кардани forgetting ва cross-item transfer; binary response; параметрҳои собити acquisition; набудани long-horizon planning; берун мондани contextual learner/instruction attributes; набудани larger-graph runtime ва memory benchmark.
Ҳадди асосии тафсир: Таҳқиқот самаранокии TEKS-ро дар муҳити воқеии таълимӣ исбот намекунад. Он proof-of-concept далел пешниҳод мекунад, ки дар симулятсияи назоратшаванда target-adjusted one-step acquisition scoring, махсусан дар сохторҳои branching, ки чанд prerequisite-related номзад рақобат мекунанд, метавонад рафтори гуногуни sequencing ва натиҷаҳои баландтари mastery-и симулятсияшударо тавлид кунад.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд