


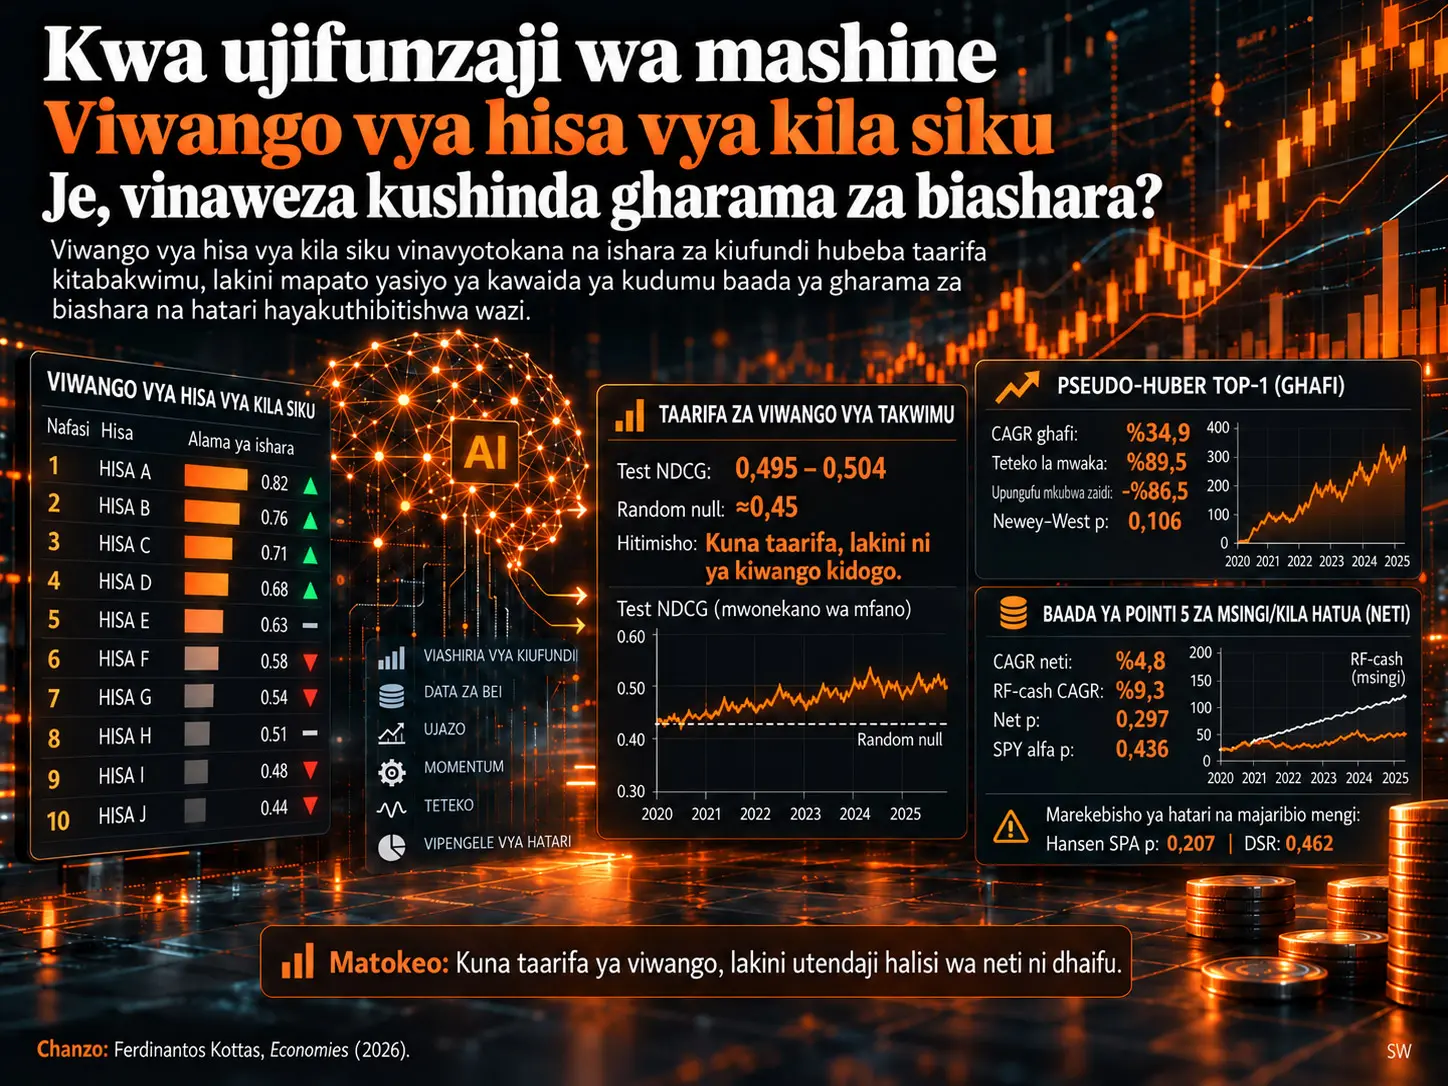
Mfumo wa kila siku wa kupanga hisa kwa ujifunzaji wa mashine unaobadilika katika utafiti huu ni mfumo wa uteuzi wa muda mfupi unaolenga kupanga kwa kulinganisha hisa katika ulimwengu chanzo wa Nasdaq unaochujwa kwa nguvu kulingana na mapato ya kufungua-kufunga ya siku inayofuata ya biashara, kwa kutumia malengo manne ya ujifunzaji ya XGBoost na vigezo 196 vya utabiri wa kiufundi. Utafiti unalinganisha regresha ya Pseudo-Huber, regresha maalumu inayoadhibu makosa ya upande wa chini, pamoja na modeli za pairwise ranking na NDCG-oriented ranking katika mpangilio wa kimfuatano wa walk-forward. Katika kipindi cha majaribio, wastani wa NDCG unakaribia takribani 0,495-0,504, ilhali wastani wa null wa upangaji nasibu ni takribani 0,453-0,454. Tofauti hii inaonyesha kuwa modeli zina taarifa ya kiasi, lakini inayoweza kugunduliwa kitakwimu, kuhusu upangaji wa kimkataba. Hata hivyo, utafiti hauonyeshi kwamba taarifa hii hubadilika kuwa mapato yasiyo ya kawaida ya portfolia yaliyo thabiti baada ya gharama za biashara, tete, kutokuwa thabiti kwa muda, marekebisho ya hatari na udhibiti wa majaribio mengi.
Matokeo ghafi yanayovutia zaidi yalionekana katika portfolia ya Pseudo-Huber Top-1, ambayo haikuwa mkakati mkuu ulioteuliwa mapema katika hatua ya validation na baadaye ilichunguzwa kama uchunguzi wa mkusanyiko. Ingawa mapato ghafi ya kijiometri ya kila mwaka ya portfolia hii yalikuwa %34,91 na mapato ya jumla %266,45, tete yake ya mwaka ilikuwa %89,51 na drawdown ya juu zaidi %86,47. Jaribio la Newey-West kwa wastani wa mapato ghafi halikuwa na umuhimu wa kitakwimu (p = 0,106). Gharama ya pointi 5 za msingi inapowekwa kwa kila upande wa muamala, CAGR halisi chini ya dhana ya sifuri-fedha hushuka hadi %4,83; hata katika hesabu ambayo mtaji usiotumika hupata mapato yasiyo na hatari na CAGR ya jumla ya mapato kufikia %9,3, matokeo ya Newey-West kwa mapato ya ziada hayabadiliki (p = 0,297). Jaribio la alfa halisi la SPY kwa upeo uleule wa kufungua-kufunga pia si muhimu kitakwimu (p = 0,436). Kwa hiyo, utafiti unaonyesha kuwa ni lazima kutenganisha hitimisho la “modeli inaweza kupanga” na dai kwamba “upangaji huu unaweza kutoa mapato yasiyo ya kawaida yaliyo ya kuaminika na yanayotekelezeka.”
Kizuizi muhimu cha matokeo ni kwamba ulimwengu wa data umeundwa kutoka orodha ya wagombea wa Nasdaq iliyokusanywa mwaka 2026. Baadhi ya dhamana zilizoondolewa kihistoria kwenye soko huenda hazipo katika orodha chanzo, na utafiti haujengi upya mapato ya delisting. Kwa hiyo, ukubwa wa mapato ulioripotiwa hauwezi kutafsiriwa kuwa matokeo ya ulimwengu kamili wa kihistoria wa Nasdaq usio na survivorship bias.
Tatizo la msingi la utafiti
Katika tafiti za muda mfupi za ujifunzaji wa mashine katika fedha, vipimo viwili tofauti vya mafanikio vinaweza kuchanganywa kwa urahisi. Kwanza ni uwezo wa modeli kupanga kwa usahihi zaidi kuliko upangaji nasibu nafasi za jamaa kati ya hisa nyingi katika siku moja ya biashara. Pili ni kama, baada ya kubadilisha upangaji huo kuwa maamuzi halisi ya kununua na kuuza, inaweza kupatikana faida yenye maana kiuchumi baada ya kuzingatia gharama za biashara, tete, hatari ya soko na utafutaji wa modeli nyingi. Swali kuu la utafiti wa Kottas limejengwa juu ya tofauti hii.
Utafiti unajaribu hasa tatizo hili la mfululizo: je, alama za ujifunzaji wa mashine zinazotokana na data za kiufundi za bei na biashara zinaweza kupanga sehemu ya hisa ya siku inayofuata vizuri kuliko upangaji nasibu? Ikiwa zinaweza, je, wazo la kununua hisa zenye alama za juu zaidi linaweza kushinda gharama chini ya uhasibu wa kweli wa biashara? Je, utendaji unaoonekana ni thabiti kwa muda? Je, unabaki baada ya marekebisho ya hatari? Je, matokeo bado yanashawishi baada ya kuzingatia hatari ya data-snooping/multiplicity inayotokana na kuchunguza mikakati na miundo mingi kwenye data ileile?
Je, upangaji ni wa nasibu wakati NDCG ni takribani 0,50?
Hapana; katika utafiti huu NDCG ya takribani 0,50 haimaanishi moja kwa moja upangaji nasibu. Chini ya ubadilishaji wa relevance wa asilimia ndani ya siku na muundo wa faida wa NDCG wa kielelezo, wastani wa upangaji nasibu wa Monte Carlo ni takribani 0,45; thamani za NDCG za majaribio za modeli katika safu ya 0,495-0,504 zilikuwa juu ya usambazaji huu wa null, na katika majaribio 2000 ya uanzishaji nasibu thamani ya p ya upande mmoja ilikuwa 0,0005 katika azimio la Monte Carlo. Hata hivyo, tofauti hii si ishara kubwa kiuchumi; inaonyesha tu taarifa ya upangaji iliyo ndogo lakini inayoweza kupimwa.
Kipindi cha data na ulimwengu wa uwekezaji
| Kipengele | Thamani iliyoripotiwa katika chanzo | Maana ya kisayansi |
|---|---|---|
| Data ghafi za soko | 2 Agosti 2021-31 Julai 2026 | Kipindi kikuu cha data ambacho vipengele na malengo ya mbele yalitengenezwa |
| Kipindi cha majaribio nje ya sampuli | 21 Machi 2022-30 Julai 2026 | Kipindi cha tarehe za majaribio ambazo hazikuonekana baada ya uteuzi wa modeli |
| Dirisha la mafunzo | 105 siku za biashara | Bloku ya nje ya mafunzo ya kila iteresheni ya walk-forward |
| Dirisha la validation | 21 siku za biashara | Uteuzi wa uwakilishi wa vipengele na ukubwa wa portfolia |
| Iteresheni ya majaribio ya walk-forward | 1094 | Katika kila iteresheni kuna siku moja tu inayofuata ya majaribio ambayo haijaonekana |
| Ulinganisho uliorekebishwa wa mapato yaliyotimia kwa pamoja | 1093 tarehe | Uchambuzi wa portfolia uliopangiliwa na tarehe za benchmark/factor |
Data ghafi za bei ziliundwa kupitia kiolesura cha yfinance kutoka mfululizo wa kila siku wa kufungua, juu zaidi, chini zaidi, kufunga, kufunga kulikorekebishwa na ujazo. Faili ya wagombea katika kiwango cha chanzo ina alama 5138, na seti tofauti ya metadata yenye metadata muhimu za dhamana na mtiririko wa kazi wa data za soko ina ticker 454. Bei ya kila siku, urefu wa historia, upatikanaji wa vipengele na masharti ya ukwasi baadaye huamua sehemu inayoweza kuwekezeka kwa kweli.
Hisa katika siku fulani lazima iwe na historia ya angalau siku 35, bei ya kufunga ya angalau 5 USD, na median ya ujazo wa dola wa siku 20 zilizopita lazima ibaki juu ya sehemu ya chini ya %10 ya ukwasi ya sehemu inayostahiki ya siku hiyo. Baada ya vichujio hivi, wastani wa idadi ya hisa zinazostahiki kwa siku ni takribani 347,6, median ni 341, kiwango cha chini kilichoonekana ni 320 na cha juu ni 392.
Ujazo wa dola na median ya ujazo wa dola wa siku 20 hufafanuliwa katika chanzo kama ifuatavyo:
\[ DV_{i,t}=Close_{i,t}\times Volume_{i,t} \]
\[ ADV20_{i,t}=\operatorname{median}\{DV_{i,s}:s=t-19,\ldots,t\} \]
DV inawakilisha makadirio ya ujazo wa biashara wa dola wa hisa katika siku hiyo; ADV20 ni median ya ujazo wa dola wa siku 20 zilizopita hadi tarehe ya sasa. Katika utafiti huu ADV20 haitumiki kama modeli ya kimuundo ya athari ya bei, bali kama kigezo mbadala wazi cha ukwasi na ushiriki wa biashara.
Vigezo 196 vya utabiri wa kiufundi vinahusisha nini?
| Familia ya vipengele | Idadi | Taarifa ya msingi |
|---|---|---|
| Muundo wa bei ndani ya siku | 38 | Gap, mapato ya ndani ya siku, miundo ya mishumaa na safu za biashara |
| Uendelevu wa mapato na reversal | 25 | Momentum ya muda mfupi, reversal na utendaji wa jamaa |
| Mwelekeo na umbali wa bei | 45 | Wastani unaosogea, nguvu ya mwelekeo, drawdown na umbali kutoka viwango vya bei vya karibu |
| Tete na hatari ya upande wa chini | 32 | Tete ya jumla/upande wa chini, safu za juu-chini na mabadiliko ya tete |
| Oscillator na shinikizo la bei | 19 | Nafasi ya jamaa ya bei na shinikizo la karibu la kununua/kuuza |
| Ujazo na ukwasi | 22 | Ujazo usio wa kawaida, ujazo wa dola, ukwasi na mwingiliano wa bei-ujazo |
| Muktadha wa soko | 14 | Upana wa soko, momentum ya jumla, tete ya soko na usambazaji wa kimkataba |
| Kipimo kingine cha kiufundi | 1 | Taarifa ya ziada inayotegemea safu |
| Jumla | 196 | Vigezo vyote vya utabiri wa kiufundi |
Vipengele vingi hutumia madirisha ya historia ya siku 1, 2, 3, 5, 10 na 20 za biashara, na baadhi hutumia muktadha mpana wa siku 30. Vipengele hivi havijajaribiwa kila kimoja kama “kanuni ya biashara”; vimeingizwa pamoja katika modeli ili miti ya XGBoost iweze kutumia mwingiliano usio wa mstari kati ya momentum, reversal, tete, ujazo na hali za soko.
Utafiti unajaribu uwakilishi tatu tofauti wa ingizo. Uwakilishi wa Raw huhifadhi vipengele 196 vya nambari ghafi. Uwakilishi wa Ranked hubadilisha kila kigezo kuwa nafasi ya daraja ya kimkataba kati ya 0 na 1 ndani ya ulimwengu wa hisa zinazostahiki wa siku hiyo:
\[ x^{rank}_{i,t,j}=\frac{\operatorname{rank}_{t}(x_{i,t,j})-1}{N_t-1} \]
Ubadilishaji huu hauhifadhi umbali wa nambari kati ya thamani ghafi, bali huhifadhi mpangilio wa jamaa ndani ya sehemu. Uwakilishi wa Combined hutumia pamoja vigezo 196 ghafi na wenzao 196 wa ranked, hivyo kufikisha jumla ya ingizo kuwa 392.
Kwa nini lengo la utabiri ni mapato ya kufungua-kufunga ya siku inayofuata pekee?
Kigezo lengwa cha modeli ni:
\[ r_{i,t+1}=\frac{Close_{i,t+1}}{Open_{i,t+1}}-1 \]
Kwa hiyo, modeli hutumia taarifa ya kiufundi inayojulikana hadi kufungwa kwa siku t; lengo linalotimia ni mapato kutoka kufunguliwa kwa siku t+1 hadi kufungwa kwa siku hiyo hiyo. Harakati ya close-to-open inayotokea usiku haijumuishwi katika lengo. Tofauti hii si ya kihisabati tu, bali ni chaguo kuu la muundo linaloamua uhasibu wa biashara: portfolia lazima inunuliwe wakati wa kufungua siku inayofuata na ifungwe kabisa wakati wa kufunga siku hiyo hiyo.
Muundo wa walk-forward unapunguzaje uvujaji wa data?
Katika kila iteresheni ya nje kuna siku 105 za mafunzo, zikifuatiwa na siku 21 za validation na kisha siku moja ya majaribio:
\[ \max T_k < \min V_k < t_k,\qquad |T_k|=105,\quad |V_k|=21 \]
Uteuzi wa hyperparameter pia unafanywa kwa mpangilio wa wakati ndani ya bloku ya mafunzo ya siku 105: siku 84 za kwanza ni mafunzo ya ndani na siku 21 za mwisho ni bloku ya ndani ya tuning. Baada ya hyperparameter kuchaguliwa, modeli hufunzwa kwenye bloku ya nje ya mafunzo ya siku 105; kipindi kinachofuata cha siku 21 cha validation ya nje hutumiwa kuchagua uwakilishi wa vipengele na idadi K ya hisa zitakazoshikiliwa katika portfolia. Baada ya uteuzi huu, modeli hutabiri upya kwa siku 126 zilizopita na kutumika kwa siku moja ya majaribio ambayo haijaonekana. Kisha dirisha husogezwa mbele kwa siku moja ya biashara.
Kizuizi muhimu cha utafiti ni kwamba tarehe 105 za mafunzo ni chache ikilinganishwa na ingizo 196 ghafi na hasa 392 za combined. Mwandishi hawasilishi makadirio mapya ya siku 252 au 504 ambayo hayakufanywa kana kwamba yalikuwepo, na anaacha uwiano mkubwa wa kipengele/tarehe kama chanzo kinachowezekana cha kutokuwa thabiti.
Malengo manne ya ujifunzaji ya XGBoost
Modeli nne zinatumia miundombinu ileile ya miti ya gradient boosting, lakini zinatofautiana kwa kosa au lengo la upangaji linalotakiwa kujifunzwa. Kazi ya jumla ya lengo la XGBoost inaelezwa kama:
\[ \mathcal{L}(\Theta)=\sum_{i=1}^{n}\ell(y_i,\hat{y}_i)+\sum_{m=1}^{M}\Omega(f_m) \]
Jumla ya kwanza inawakilisha kosa la utabiri/upangaji wa modeli, na jumla ya pili inawakilisha regularization inayodhibiti ugumu wa miti.
Regresha ya Pseudo-Huber
Wakati modeli za regresha zinafunzwa, mapato ya kila siku katika mfumo wa desimali yalizidishwa kwa 100 na baada ya utabiri yakagawanywa tena kwa 100. Kwa hiyo, \(\delta=1\) haiwakilishi kitengo cha mapato ya desimali, bali takribani kipimo cha mabaki cha pointi moja ya asilimia. Hasara ni:
\[ L_{\delta}(e)=\delta^2\left(\sqrt{1+\frac{e^2}{\delta^2}}-1\right),\qquad e=\hat{y}-y,\quad \delta=1 \]
Kwa makosa madogo tabia huwa takribani ya mraba, huku athari ya mabaki makubwa ikikaribia ukuaji wa mstari polepole. Hivyo, athari za makosa makubwa sana ya mapato hupunguzwa bila kuyaondoa kabisa.
Regresha yenye adhabu ya makosa ya upande wa chini
Modeli ya pili ya regresha huadhibu kwa uzito zaidi ishara za long position za false-positive ambapo modeli inatabiri mapato chanya wakati mapato halisi ni hasi:
\[ L_D(y,\hat{y})=a(y,\hat{y})(\hat{y}-y)^2 \]
\[ a(y,\hat{y})=1+4\,\mathbf{1}\{y<0,\hat{y}>0\} \]
Sharti lisipotimia uzito ni 1, na likitimia ni 5. Kwa hiyo, lengo si kuadhibu makosa yote hasi, bali hasa hali ambazo mwelekeo chanya umetabiriwa dhidi ya matokeo hasi.
Pairwise Ranking
Katika modeli za Ranking, mapato yaliyotimia ya siku inayofuata hubadilishwa ndani ya kila tarehe kuwa madarasa matano ya relevance \(q\in\{0,1,2,3,4\}\). Mbinu ya Pairwise hujaribu kujifunza kwamba alama ya hisa yenye kiwango cha juu cha relevance iwe juu kuliko ya nyingine:
\[ L_{pair}=\sum_{q_i>q_j}\log\left(1+\exp(-(s_i-s_j))\right) \]
Modeli hii haidai kutabiri ukubwa kamili wa mapato; lengo ni upangaji wa jamaa.
NDCG-oriented Ranking
Modeli ya NDCG pia hufunzwa kwa kutumia madarasa hayo ya ordinal. Katika tathmini ya majaribio, mapato yaliyotimia hubadilishwa kuwa nafasi za asilimia ndani ya tarehe na kisha huhesabiwa kipimo cha Normalized Discounted Cumulative Gain kinachotoa uzito mkubwa zaidi kwa nafasi za juu za orodha:
\[ \mathrm{NDCG}_t@K= \frac{\mathrm{DCG}_t(K)}{\mathrm{IDCG}_t(K)} = \frac{1}{\mathrm{IDCG}_t(K)} \sum_{j=1}^{K} \frac{2^{rel_{i,t+1}}-1}{\log_2(j+1)} \]
\(j\) inawakilisha nafasi katika upangaji uliotolewa na modeli; \(rel\) ni thamani halisi ya relevance ya hisa iliyowekwa katika nafasi hiyo; na IDCG ni upangaji bora wa siku hiyo. Kwa sababu ya punguzo la logarithmic, makosa katika nafasi za mwanzo za orodha ni muhimu zaidi.
Hyperparameter na usanidi wa portfolia hutenganishwa
Tuning ya hyperparameter haifanywi moja kwa moja kwa mapato ya kifedha. Alama ya ndani ya tuning ni wastani wenye uzito sawa wa ubadilishaji unaohamisha Spearman information coefficient kutoka safu ya [−1,1] hadi [0,1] na NDCG@10:
\[ TuneScore_{inner} = \frac{1}{2}\left(\frac{IC_{inner}+1}{2}\right) + \frac{1}{2}\mathrm{NDCG@10}_{inner} \]
Hyperparameter zinazorekebishwa ni pamoja na idadi ya boosting iteration, learning rate, kina cha juu cha mti, minimum child weight, minimum loss reduction, uwiano wa usampulishaji wa safu na nguzo, pamoja na regularization ya L1/L2.
Katika hatua inayofuata ya usanidi wa portfolia, uwakilishi tatu za vipengele huunganishwa na ukubwa minne ya portfolia kwa kila modeli:
\[ 3\;\text{gösterim}\times K\in\{5,10,20,30\}=12\;\text{aday} \]
Wagombea hutathminiwa kwa vipengele vitatu: validation NDCG, tofauti ya IC kati ya mafunzo-validation, na mapato ya validation Top-K. Kila kipengele hubadilishwa kuwa alama ya daraja ya jamaa katika safu ya 0-1:
\[ RS_{high}(z_c)=\frac{\operatorname{rank}(z_c)-1}{C-1}, \qquad RS_{low}(z_c)=1-RS_{high}(z_c), \qquad C=12 \]
Kipimo cha uthabiti ni:
\[ GapIC_{c,t}= \left|IC^{train}_{c,t}-IC^{valid}_{c,t}\right| \]
na alama inayohusiana nayo ni:
\[ StabilityScore_{c,t}=RS_{low}(GapIC_{c,t}) \]
Tofauti ndogo ya mafunzo-validation hupata alama ya juu zaidi ya uthabiti.
Kwa nini turnover ya kila siku ni 2 katika portfolia inayonunuliwa wakati wa kufungua na kuuzwa wakati wa kufunga?
Kwa sababu katika upeo wa mwisho wa biashara wa utafiti huu, kitengo kimoja cha mtaji wa portfolia iliyowekezwa kikamilifu hununuliwa wakati wa kufungua siku inayofuata na mtaji huohuo kuuzwa kabisa wakati wa kufunga; jumla ya kitengo kimoja cha kununua na kitengo kimoja cha kuuza hutoa round-trip turnover = 2. Hata ikiwa hisa ileile itachaguliwa tena siku inayofuata, nafasi ya siku iliyotangulia tayari imefungwa wakati wa kufunga, kwa hiyo kufanana kwa majina kati ya siku mbili hakupunguzi kiasi halisi cha biashara. Kwa hiyo holding overlap kati ya portfolia ya zamani na mpya haiwezi kutumika badala ya gharama ya biashara.
Chanzo pia kinaonyesha uchunguzi wa mpito-uingiliano katika kanuni ya awali ya uteuzi kwa madhumuni ya reproducibility:
\[ \tau_{c,t}=\sum_i\left|w^{c}_{i,t}-w_{i,t-1}\right| \]
Usemi huu ni muhimu kwa kueleza mwendelezo wa majina yaliyochaguliwa kati ya siku; lakini katika utafiti uliorekebishwa hautumiki kama execution turnover halisi ya mkakati wa open-to-close.
Mapato ya validation yenye gharama kwa ujumla ni:
\[ R^{net,valid}_{c,t} = R^{gross,valid}_{c,t} - \lambda\tau_{c,t}, \qquad \lambda=0.0005 \]
Katika uhasibu wa mwisho wa intraday, wagombea wote waliowekezwa kikamilifu hukumbana na gharama ya round-trip ya \(\tau=2\) katika siku ileile, hivyo pointi 5 za msingi/upande hutoa jumla ya pointi 10 za msingi/siku. Kwa kuwa gharama ya pamoja haibadilishi mpangilio wa jamaa wa wagombea waliowekezwa kikamilifu ndani ya siku hiyo hiyo, kipengele cha finance kwa vitendo hupangwa kulingana na mapato ya validation Top-K:
\[ FinanceScore_{c,t} = RS_{high}\left(R^{net,valid}_{c,t}\right) \]
Vipengele vitatu hatimaye huunganishwa kwa uzito sawa:
\[ AdaptiveScore_{c,t} = \frac{ MLScore_{c,t} + StabilityScore_{c,t} + FinanceScore_{c,t} }{3} \]
Uwakilishi wa kipengele na thamani ya K yenye AdaptiveScore ya juu zaidi hufungwa kwa siku inayofuata ya majaribio ambayo haijaonekana. Mapato yaliyotimia ya siku ya majaribio hayatumiwi wakati wa uteuzi.
Mtiririko wa mbinu unaofuata chanzo: Data ya kila siku ya bei/ujazo → kichujio cha kustahiki katika nukta ya muda → vigezo 196 vya kiufundi → uwakilishi raw/ranked/combined → malengo manne ya XGBoost → tuning ya hyperparameter ya ndani ya kimfuatano → validation ya nje ya siku 21 → wagombea 12 wa portfolia → AdaptiveScore → siku moja ya majaribio isiyoonekana → kununua wakati wa kufungua/kuuza wakati wa kufunga → uchambuzi wa gharama ya biashara, hatari na uthabiti wa kitakwimu.
Mbinu na Matokeo ya Utafiti
1. Utendaji wa upangaji: tofauti za mafunzo hupotea kwa kiasi kikubwa katika majaribio
| Modeli | Training NDCG | Validation NDCG | Test NDCG | Tofauti ya Train-Test | Random null | Permutation p |
|---|---|---|---|---|---|---|
| Downside-Penalized | 0,642 | 0,532 | 0,504 | 0,138 | 0,454 | 0,0005 |
| Pseudo-Huber | 0,561 | 0,533 | 0,503 | 0,057 | 0,454 | 0,0005 |
| NDCG Ranking | 0,694 | 0,524 | 0,495 | 0,199 | 0,453 | 0,0005 |
| Pairwise Ranking | 0,773 | 0,535 | 0,501 | 0,272 | 0,454 | 0,0005 |
Training NDCG ya juu zaidi ni 0,773 kwa Pairwise Ranking; lakini katika majaribio ubora huu hupotea na thamani kushuka hadi 0,501. Ingawa Pseudo-Huber huzalisha NDCG ya 0,561 tu katika mafunzo, hufikia thamani ya majaribio ya 0,503 na hivyo kuwa na pengo dogo zaidi la mafunzo-majaribio. Matokeo haya yanaonyesha wazi kwamba kufaa kwa mafunzo pekee si kiashiria cha kuaminika cha ubora wa upangaji wa baadaye.
Jambo muhimu ni kwamba test NDCG ya modeli zote nne iko juu ya wastani wa random-null. Hata hivyo, malengo manne tofauti ya ujifunzaji yanakaribia safu ileile nyembamba katika kipindi cha majaribio. Kwa hiyo, tofauti kubwa za utendaji zinazosababishwa na lengo la ujifunzaji wakati wa mafunzo hazihifadhiwi nje ya sampuli.
2. Umuhimu wa vipengele na uthabiti wa modeli
Usambazaji wa importance wa modeli yenye adhabu ya makosa ya upande wa chini umejikita kwa kiasi kikubwa katika familia ya tete na hatari ya upande wa chini: familia hii inawakilisha %67,2 ya jumla ya gain importance. Katika modeli ya NDCG Ranking, sehemu ya familia hiyo ni %54,4. Pairwise Ranking inaonyesha usambazaji mpana zaidi wa importance; sehemu ya familia kubwa zaidi ni %28,8 tu.
Kuna kikomo maalumu cha tafsiri kwa Pseudo-Huber. Katika paneli ya data ya chanzo, vigezo 14 vya soko kwa ujumla ni vya kudumu kwa hisa zote ndani ya tarehe ileile. Kwa hiyo, vigezo hivi haviwezi kutofautisha moja kwa moja hisa za siku hiyo. Hata hivyo, katika njia iliyochaguliwa nje ya sampuli, vigezo hivi 14 vinawakilisha kwa wastani %38,1 ya Top-20 XGBoost gain importance ya Pseudo-Huber. Thamani hii haimaanishi “vigezo vya soko vinapanga hisa moja kwa moja”; athari zake zinaweza kutokea kupitia mabadiliko kati ya tarehe au mwingiliano na vigezo vya kiwango cha hisa.
| Modeli | Top-10 Jaccard | Top-20 Jaccard | Importance cosine similarity | Top-1 predictor persistence |
|---|---|---|---|---|
| Downside-Penalized | 0,359 | 0,315 | 0,638 | 0,361 |
| Pseudo-Huber | 0,289 | 0,328 | 0,477 | 0,238 |
| NDCG Ranking | 0,185 | 0,196 | 0,360 | 0,083 |
| Pairwise Ranking | 0,068 | 0,099 | 0,182 | 0,027 |
Ingawa Pairwise Ranking ndiyo modeli yenye training NDCG ya juu zaidi, inaonyesha wazi uthabiti wa chini zaidi wa ndani katika feature attribution. canonical predictor yenye importance ya juu zaidi hubaki sawa siku inayofuata katika %2,7 tu ya matukio. Katika modeli ya Downside-Penalized kiwango hiki ni %36,1. Ulinganisho huu unaonyesha kwamba alama kubwa ya mafunzo haimaanishi muundo thabiti zaidi wa modeli.
3. Je, tabaka linalobadilika ni thabiti kweli?
Mfumo wa uteuzi wa portfolia ulitumia thamani zote nne za K na uwakilishi wote watatu wa vipengele katika kipindi cha majaribio; hakuna muundo mmoja wa pamoja uliotawala kwa kudumu. K = 5 ndiyo ukubwa wa portfolia uliochaguliwa mara nyingi zaidi katika modeli zote, na vipengele vya ranked ndiyo uwakilishi uliochaguliwa mara nyingi zaidi; hata hivyo, chaguo hizi mbili kwa pamoja hazigeuki kuwa usanidi mmoja wa kudumu.
Kiwango cha kubadilika kwa usanidi uliounganishwa katika siku zinazofuatana ni %73,4 kwa Pseudo-Huber, %72,6 kwa Downside-Penalized, %76,3 kwa NDCG Ranking na %83,8 kwa Pairwise Ranking. Katika modeli ya Pairwise, hata ukubwa wa portfolia K hubadilika katika %63,9 ya mipito. Median ya tofauti ya AdaptiveScore kati ya mgombea aliyechaguliwa na wa pili ni 0,0606 tu kwa modeli zote; usawa kamili wa alama hutokea katika takribani %15,2-%18,8 ya siku. Kwa hiyo, tabaka linalobadilika linapaswa kutafsiriwa si kama utaratibu unaopata optimum za kila siku zilizotenganishwa kwa nguvu, bali kama mchakato wa uteuzi unaobadilika mara kwa mara kati ya wagombea wa validation walio karibu sana.
4. Utendaji ghafi wa portfolia za Adaptive Top-K
| Modeli | Mapato ya arithmetiki ya mwaka | Mapato ya kijiometri ya mwaka | Tete ya mwaka | Sharpe | Mapato ya jumla | Drawdown ya juu |
|---|---|---|---|---|---|---|
| Downside-Penalized | %18,29 | %9,47 | %43,03 | 0,425 | %48,07 | −%62,09 |
| Pseudo-Huber | %12,60 | %4,51 | %40,46 | 0,311 | %21,10 | −%54,20 |
| NDCG Ranking | %12,33 | −%0,96 | %51,62 | 0,239 | −%4,08 | −%72,92 |
| Pairwise Ranking | −%10,91 | −%15,91 | %35,78 | −0,305 | −%52,85 | −%64,38 |
| Ulimwengu wa hisa zinazostahiki wenye uzito sawa | %6,93 | %5,11 | %19,82 | 0,350 | %24,11 | −%24,53 |
Katika matokeo ghafi yanayobadilika, mapato ya juu zaidi ya kijiometri ni %9,47 katika modeli ya Downside-Penalized; hata hivyo, tete yake ya mwaka ni %43,03 na drawdown ya juu ni %62,09. Benchmark ya ulimwengu wa hisa zinazostahiki wenye uzito sawa hutoa mapato ya kijiometri ya %5,11 huku ikiwa na tete ya %19,82 tu na drawdown ya juu ya %24,53. Kwa hiyo, modeli zinazobadilika huzalisha hatari kubwa zaidi lakini hazionyeshi mapato ya ziada yanayoaminika kitakwimu.
Tofauti ya arithmetiki-kijiometri katika modeli ya NDCG ni ya kufundisha sana. Wakati wastani wa mapato ya arithmetiki ya mwaka ni %12,33, mapato ya kijiometri ni −%0,96. Kwa sababu ya tete kubwa, hata kama wastani wa mapato ya kila siku ni chanya, ukuaji wa mali uliochanganywa unaweza kuwa hasi. Hii inaonyesha kwa nini kuangalia tu wastani wa arithmetiki uliowekwa kwa mwaka kunaweza kupotosha katika mikakati ya kifedha.
5. Uchunguzi wa mkusanyiko wa Top-1
Baada ya kuchunguza matokeo ya K = 5, chanzo kilichunguza pia portfolia za Top-1 zinazoshikilia hisa moja tu yenye alama ya juu zaidi ili kuelewa tabia katika sehemu ya juu kabisa ya upangaji wa modeli. Uchambuzi huu si kanuni ya validation iliyowekwa mapema; ni uchunguzi wa mkusanyiko wa ex-post. Kwa hiyo, takwimu kubwa ghafi za Pseudo-Huber Top-1 haziwezi kutumika kama ushahidi wa mkakati wa uwekezaji uliothibitishwa.
| Modeli | Mapato ya arithmetiki ya mwaka | Mapato ya kijiometri ya mwaka | Tete ya mwaka | Sharpe | Mapato ya jumla | Drawdown ya juu |
|---|---|---|---|---|---|---|
| Pseudo-Huber | %71,24 | %34,91 | %89,51 | 0,796 | %266,45 | −%86,47 |
| NDCG Ranking | %43,03 | −%6,58 | %99,63 | 0,432 | −%25,56 | −%87,51 |
| Downside-Penalized | %48,68 | −%7,60 | %106,36 | 0,458 | −%29,03 | −%82,59 |
| Pairwise Ranking | %22,76 | −%8,61 | %78,96 | 0,288 | −%32,32 | −%65,95 |
Pseudo-Huber Top-1 kwa mtazamo wa kwanza inaonekana kuwa na nguvu ya ajabu. Hata hivyo, tete ya mwaka ya portfolia hiyo ni takribani %90, drawdown yake ya juu ni takribani %86,5, na kwa wastani wa mapato ghafi ya kila siku takwimu ya t ya Newey-West ni 1,615 na thamani ya p ni 0,106. Kwa hiyo, ukubwa wa CAGR ghafi peke yake hauwezi kuthibitisha wastani wa mapato unaotofautiana kwa kuaminika na sifuri.
La muhimu zaidi, utendaji haukusambazwa sawa kwa muda. CAGR ghafi ya Pseudo-Huber Top-1 ilikuwa %646,8 mwaka 2022 na %75,9 mwaka 2023, lakini −%19,4 mwaka 2024, −%7,7 mwaka 2025 na −%61,0 katika sehemu iliyochunguzwa ya 2026. Katika nusu ya kwanza ya kipindi cha majaribio CAGR ilikuwa %154,9, lakini katika nusu ya pili ilikuwa −%28,9. Wasifu huu wa muda unapunguza kwa kiasi kikubwa dhana kwamba CAGR ya kipindi kizima inawakilisha mchakato wa kudumu wa mapato yanayotarajiwa.
6. Gharama za biashara hubadilishaje matokeo?
Kwa kuwa mkakati huanzisha nafasi wakati wa kufungua na kuzifunga kabisa wakati wa kufunga katika kila siku ya uwekezaji, kigezo kikuu cha gharama ya biashara si uingiliano wa portfolia kati ya siku bali muamala kamili wa round-trip. Gharama ya upande mmoja ya pointi 5 za msingi inamaanisha jumla ya pointi 10 za msingi za gharama katika siku iliyowekezwa kikamilifu.
| Modeli | Mkakati | Turnover ya kila siku | CAGR ghafi | CAGR halisi | NW t halisi | p halisi |
|---|---|---|---|---|---|---|
| Downside-Penalized | Adaptive | 2,00 | %9,47 | −%14,92 | −0,36 | 0,723 |
| Downside-Penalized | Top-1 | 2,00 | −%7,60 | −%28,24 | 0,46 | 0,645 |
| Pseudo-Huber | Adaptive | 2,00 | %4,51 | −%18,78 | −0,70 | 0,482 |
| Pseudo-Huber | Top-1 | 2,00 | %34,91 | %4,83 | 1,04 | 0,297 |
| NDCG Ranking | Adaptive | 2,00 | −%0,96 | −%23,04 | −0,56 | 0,579 |
| NDCG Ranking | Top-1 | 2,00 | −%6,58 | −%27,44 | 0,38 | 0,702 |
| Pairwise Ranking | Adaptive | 2,00 | −%15,91 | −%34,67 | −2,22 | 0,026 |
| Pairwise Ranking | Top-1 | 2,00 | −%8,61 | −%29,00 | −0,06 | 0,949 |
CAGR ghafi ya Pseudo-Huber Top-1 ya %34,91 hushuka hadi %4,83 chini ya gharama ya upande mmoja ya pointi 5 za msingi tu. Chanzo pia kinaripoti kwamba kwenye njia hii halisi drawdown ya juu hufikia takribani %92,8. Katika uhasibu wa RF-cash, ambapo fedha zisizotumika hupata mapato ya kila siku yasiyo na hatari, CAGR halisi ya jumla huongezeka hadi %9,3; lakini excess-return Sharpe inabaki 0,514 na Newey-West p = 0,297. Sababu ni kwamba mapato ya riba yasiyo na hatari huondolewa tena wakati wa kukokotoa mapato ya ziada.
Kwa nini kugunduliwa kitakwimu kwa taarifa ya upangaji hakumaanishi mapato yasiyo ya kawaida yanayoweza kuwekezeka?
Kwa sababu uwezo wa modeli kupanga hisa vizuri kidogo kuliko upangaji nasibu hauhakikishi kwamba taarifa hiyo inaleta faida ya kiuchumi iliyo kubwa kuliko gharama za miamala ya kila siku zinazohitajika, tete ya portfolia, drawdown kubwa, mwendo wa pamoja na hatari ya soko, kuvunjika kwa utendaji kwa muda na tatizo la multiplicity linalotokana na kujaribu mikakati mingi. Katika utafiti huu, ingawa nadharia tete ya null ya upangaji inavukwa wazi, ushahidi wa mapato chanya yasiyo ya kawaida yaliyo thabiti hautokei wakati mapato baada ya gharama za biashara, matched-horizon alfa, Hansen SPA, Deflated Sharpe Ratio na kutokuwa na uhakika wa bootstrap vinatathminiwa kwa pamoja.
7. Marekebisho ya hatari na majaribio mengi
Kwa Pseudo-Huber Top-1, katika regresha dhidi ya SPY kwa upeo uleule wa open-to-close, alfa ghafi ya mwaka ni %58,5 lakini p = 0,171. Baada ya gharama ya pointi 5 za msingi/upande, alfa halisi ya mwaka hushuka hadi %33,3 na p = 0,436. Kuonekana kwa makadirio ya nukta ya alfa kuwa makubwa hakumaanishi kwamba muda wa kujiamini na kutokuwa na uhakika wa kitakwimu vinaweza kupuuzwa.
Chanzo pia kinaripoti regresha za close-to-close CAPM, Fama-French 3 factor na Fama-French 5 factor katika supplementary material, lakini kinaeleza wazi kuwa modeli hizi zina upeo tofauti unaojumuisha pia mapato ya usiku ambayo mkakati haushikilii. Kwa hiyo, ushahidi mkuu uliorekebishwa kwa hatari wa utafiti ni regresha ya matched open-to-close SPY.
| Udhibiti | Matokeo | Tafsiri |
|---|---|---|
| Newey-West ghafi | t = 1,615; p = 0,106 | Wastani wa mapato ghafi hautofautiani na sifuri katika kiwango cha kawaida cha umuhimu |
| 5 bps Newey-West halisi | t = 1,044; p = 0,297 | Ushahidi baada ya gharama ni dhaifu zaidi |
| Alfa halisi ya SPY open-to-close | %33,3 kwa mwaka; p = 0,436 | Makadirio ya nukta ni makubwa, lakini si muhimu kitakwimu |
| Hansen SPA | p = 0,207 | Ubora haujathibitishwa katika familia iliyosawazishwa ya mikakati 12 |
| White-style reality check, ghafi | p = 0,182 | Hakuna matokeo yenye nguvu baada ya multiplicity |
| White-style reality check, 5 bps halisi | p = 0,450 | Ushahidi kwa utendaji halisi ni dhaifu zaidi |
| Uwezekano wa Deflated Sharpe Ratio | 0,462 | Hautoi ubora unaoshawishi baada ya kuzingatia familia ya mikakati iliyojaribiwa |
| Safu ya %95 ya stationary-bootstrap ya CAGR halisi | −%58,1 hadi +%147,5 | Kutokuwa na uhakika katika makadirio ya utendaji uliounganishwa ni pana sana |
Ni muhimu hasa kwamba majaribio ya Newey-West hayajaribu CAGR, bali wastani wa arithmetiki wa mapato ya kila siku. Kwa sababu ya tete kubwa, wastani chanya wa kila siku na ukuaji hasi wa mali uliounganishwa vinaweza kuonekana kwa wakati mmoja. Kwa hiyo, chanzo pia kinatathmini tofauti za CAGR na terminal wealth kwa stationary bootstrap.
Usikivu wa Newey-West lag katika Appendix pia haubadilishi matokeo ya Pseudo-Huber Top-1: kwa chaguo za ucheleweshaji wa 1, 5, 10 na 21, takwimu ya t inabaki takribani 1,03-1,12 na thamani ya p takribani 0,305-0,261.
8. Ukwasi na turnover si kitu kimoja
Utafiti unatathmini biashara ya mara kwa mara na ukubwa wa muamala ikilinganishwa na ujazo wa soko kama msuguano miwili tofauti. Chini ya dhana ya mtaji wa jumla wa 50.000 USD, median ya ADV20 ya hisa zilizochaguliwa na Pseudo-Huber Top-1 ni takribani 48,59 milioni USD; katika %88,0 ya siku-hisa zilizochaguliwa ADV20 iko juu ya 10 milioni USD, na katika %49,4 iko juu ya 50 milioni USD.
Katika Pseudo-Huber Top-1, ukubwa wa median wa muamala wa upande mmoja ni %0,103 tu ya ADV20. Percentile ya 95 ni %0,899, percentile ya 99 ni %1,723 na thamani ya juu zaidi iliyoonekana ni %2,138; %95,8 ya pande za muamala zilibaki chini ya %1 ya ADV20. Katika portfolia za Adaptive Top-K, ushiriki wa median uko chini ya %0,008 kwa modeli zote, na katika kiwango cha 50.000 USD cha utafiti pande zote za miamala ya upande mmoja ya adaptive zilibaki chini ya kikomo cha %1 ADV20.
Matokeo haya hayamaanishi kwamba “mkakati unaweza kutekelezwa kwa gharama nafuu.” Uwiano wa ADV20 haupimi bid-ask spread, market-on-open slippage, athari ya bei au gharama ya execution inayotokana na order-size. Hitimisho la utafiti linaonyesha tu kwamba katika kiwango cha rejareja kama 50.000 USD, muamala wa kawaida unaohitajika mara nyingi ni mdogo ikilinganishwa na ujazo wa soko unaoonekana. Matokeo haya hayawezi kujumlishwa kwa mtaji mkubwa zaidi au uwezo wa kitaasisi.
9. Vizingiti vya ukwasi pia havileti ubora thabiti
Chanzo kinatathmini upya matokeo ya Top-1 kwa kubadilisha kiwango cha chini cha ADV20 kuwa 10, 25, 50 na 100 milioni USD. Kwa Pseudo-Huber Top-1, RF-cash CAGR ni takribani %2,4, %10,9, −%16,4 na −%8,3 mtawalia; hakuna thamani husika ya p inayoonyesha umuhimu chanya. Makadirio bora ya nukta katika vizingiti vya kati yanaathiriwa na ukweli kwamba mkakati unawekeza katika siku chache zaidi na ni siku zipi zinabaki kuwa zinaweza kuwekezeka. Utafiti hauchukulii vizingiti hivi kama mikakati mipya iliyoboreshwa, bali kama uchunguzi wa usikivu.
10. Matokeo yanayoungwa mkono na yasiyoungwa mkono na utafiti
Matokeo yanayoungwa mkono na utafiti:
- Upangaji nje ya sampuli wa modeli zote nne za XGBoost unabaki juu ya usambazaji wa random ranking null chini ya ufafanuzi wa NDCG uliotumika.
- Ukubwa wa faida hii ya upangaji ni wa kiasi, na tofauti kubwa za modeli katika mafunzo hupungua katika majaribio.
- Modeli za Ranking, hasa Pairwise Ranking, ni zisizo thabiti zaidi kuliko modeli za regresha kwa feature importance na usanidi.
- Pseudo-Huber Top-1 ilitoa CAGR ghafi kubwa sana, lakini matokeo yalikuja pamoja na tete kubwa, drawdown kali, utegemezi wa kipindi na usikivu kwa matukio ya mkia.
- Gharama ya kila siku ya round-trip kamili hupunguza kwa kiasi kikubwa utendaji ghafi unaoonekana kuwa chanya.
- Katika kiwango cha 50.000 USD, ushiriki wa soko kwa kawaida ni mdogo; hata hivyo, tatizo la jumla la gharama ya execution linaendelea kwa sababu ya biashara ya mara kwa mara.
Matokeo yasiyoungwa mkono na utafiti:
- Dai kwamba Pseudo-Huber Top-1 ni mkakati wa uwekezaji uliothibitishwa au unaopendekezwa halijaungwa mkono.
- Haijaonyeshwa kwamba NDCG ya takribani 0,50 pekee inamaanisha alfa inayoweza kutumiwa kiuchumi.
- Haidaiwi kwamba gharama ya pointi 5 za msingi/upande ni gharama ya biashara ya jumla au sahihi katika soko halisi.
- Ushiriki mdogo wa ADV20 kwa 50.000 USD hauthibitishi uwezo wa mtaji wa kitaasisi.
- Ulimwengu chanzo si ulimwengu kamili wa kihistoria wa Nasdaq uliosafishwa dhidi ya matatizo ya survivorship na delisting selection.
- Utafiti haujaribu utendaji wa short-side au long-short; mkia wa chini wa upangaji wa kila siku haukuhifadhiwa kikamilifu.
- Thamani za feature importance hazithibitishi athari za kiuchumi za kisababishi za viashiria vya kiufundi.
11. Vizuizi vya msingi
Kizuizi cha kwanza ni utegemezi wa ulimwengu chanzo kwenye orodha iliyokusanywa mwaka 2026. Kukosekana kwa kampuni zilizoondolewa kihistoria kwenye orodha kunaweza kuleta athari za survivorship na delisting selection. Kizuizi cha pili ni kwamba dirisha la mafunzo la siku 105 ni fupi ikilinganishwa na ingizo 196 au 392. Kizuizi cha tatu ni kwamba matoleo mahususi ya kihistoria ya vifurushi vya programu hayakuhifadhiwa.
Kizuizi cha nne ni modeli ya execution. Hali ya pointi 5 za msingi/upande hutoa rejea ya chini yenye manufaa kwa usikivu wa gharama za biashara, lakini spread, market-on-open slippage, athari ya soko na ukubwa wa oda havikuonekana moja kwa moja. Kizuizi cha tano ni kwamba uchambuzi wa Top-1 ni wa ex-post. Kizuizi cha sita ni kwamba muundo mkuu ulihifadhi tu chaguo za long-only Top-K na vekta kamili ya alama za kila siku katika nafasi za chini haikuhifadhiwa.
Mwishowe, vigezo 14 vya soko kwa ujumla ni vya kudumu kwa hisa zote ndani ya tarehe ileile. Kuviondoa kwenye modeli au kuweka upya katikati lengo kulingana na sehemu ya ndani ya siku hakungekuwa ukaguzi rahisi wa uthabiti wa matokeo yaliyopo, bali muundo mpya wa majaribio unaohitaji kukadiriwa upya. Chanzo kinahifadhi tofauti hii wazi.
12. Maana ya kisayansi ya utafiti
Matokeo yenye thamani zaidi ya utafiti ni kuonyesha kwamba utendaji katika ujifunzaji wa mashine wa kifedha haupaswi kupunguzwa hadi kipimo kimoja cha modeli. NDCG nje ya sampuli, uthabiti wa feature attribution, mali iliyounganishwa ya portfolia, drawdown ya juu, turnover ya biashara, usikivu wa gharama, marekebisho ya hatari ya matched-horizon, vipindi vidogo vya muda na udhibiti wa multiplicity hujibu maswali tofauti.
Tofauti hii ni muhimu hasa katika modeli za upeo mfupi. Faida ndogo ya upangaji wa kimkataba inaweza kuwa halisi kitakwimu; lakini ikiwa nafasi zote lazima zifunguliwe na kufungwa kila siku ili kubadilisha faida hiyo kuwa pesa, thamani ya kiuchumi ya ishara ya utabiri lazima izidi gharama na hatari ya itifaki ya biashara. Katika utafiti huu, kizingiti hiki cha pili hakivukwi kwa kuaminika.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Do Daily Adaptive Machine Learning Stock Rankings Survive Trading Costs? Evidence from Cross-Sectional Technical Signals
Mwandishi: Ferdinantos Kottas
Mahusiano ya taasisi: School of Business, National University of Ireland Maynooth, Maynooth, Ireland; School of Engineering, Civil Engineering, Democritus University of Thrace, Xanthi, Greece; Department of Computer Science, Aristotle University of Thessaloniki, Thessaloniki, Greece.
Jarida: Economies
Mchapishaji: MDPI
Rekodi ya bibliografia: Economies, 2026, 14(9), Article 393
DOI: 10.3390/economies14090393
Kiungo rasmi cha chapisho: https://doi.org/10.3390/economies14090393
Mchakato wa uchapishaji: Received 14 Agosti 2026; revised 31 Agosti 2026; accepted 1 Septemba 2026; published 5 Septemba 2026.
Aina na hali ya chanzo: Makala ya utafiti yenye ufikiaji wazi iliyochapishwa katika jarida lililopitiwa na wataalamu; kwenye rekodi ya mchapishaji ni Version of Record.
Leseni: Creative Commons Attribution, CC BY 4.0.
Mbinu kuu: Kwenye ulimwengu chanzo wa Nasdaq unaobadilika, predictor 196 za kiufundi, uwakilishi wa vipengele raw/ranked/combined, XGBoost objective nne, muundo wa kimfuatano wa walk-forward wa mafunzo-validation-majaribio, uteuzi wa portfolia Adaptive Top-K, uchambuzi wa gharama za biashara na ushiriki wa soko, inference ya Newey-West, marekebisho ya hatari ya matched-horizon SPY, stationary bootstrap na udhibiti wa multiplicity.
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Kamati ya maadili: Haitumiki kwa sababu washiriki wa kibinadamu au data binafsi hazikutumika.
Upatikanaji wa data: Data za bei na ujazo zilipatikana kutoka Yahoo Finance kupitia kiolesura cha yfinance. Msimbo uliotengeneza matokeo ya majaribio unaweza kupatikana kutoka kwa mwandishi kwa ombi la busara; imeelezwa kuwa codebase kamili inayoweza kurudiwa itachapishwa baadaye kupitia GitHub. Mazingira ya utekelezaji yaliripotiwa kuwa Python 3, Google Colab na G4 High-RAM.
Supplementary material: Katalogi kamili ya viashiria vya kiufundi, maelezo ya hyperparameter na reproducibility ya XGBoost, mapato makubwa zaidi ya kila siku katika njia kuu za modeli-mkakati, pamoja na jedwali za uthabiti za CAPM/Fama-French zinatolewa.
Mgongano wa maslahi: Mwandishi ametangaza kwamba hakuna mgongano wa maslahi.
Michango ya mwandishi: Hakuna sehemu tofauti ya CRediT/michango ya mwandishi iliyoripotiwa katika PDF ya chanzo. Kuna mwandishi mmoja.
Kikomo kikuu cha tafsiri: Utafiti huu hautoi ushauri wa uwekezaji au algorithimu iliyothibitishwa ya kununua na kuuza. Hasa, matokeo ya Top-1 ni uchunguzi wa mkusanyiko wa ex-post. Matokeo yanategemea ulimwengu chanzo wa 2026-vintage, kipindi cha tarehe kilichochunguzwa, upeo wa biashara wa open-to-close na dhana za usikivu wa gharama zilizotumika.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *