


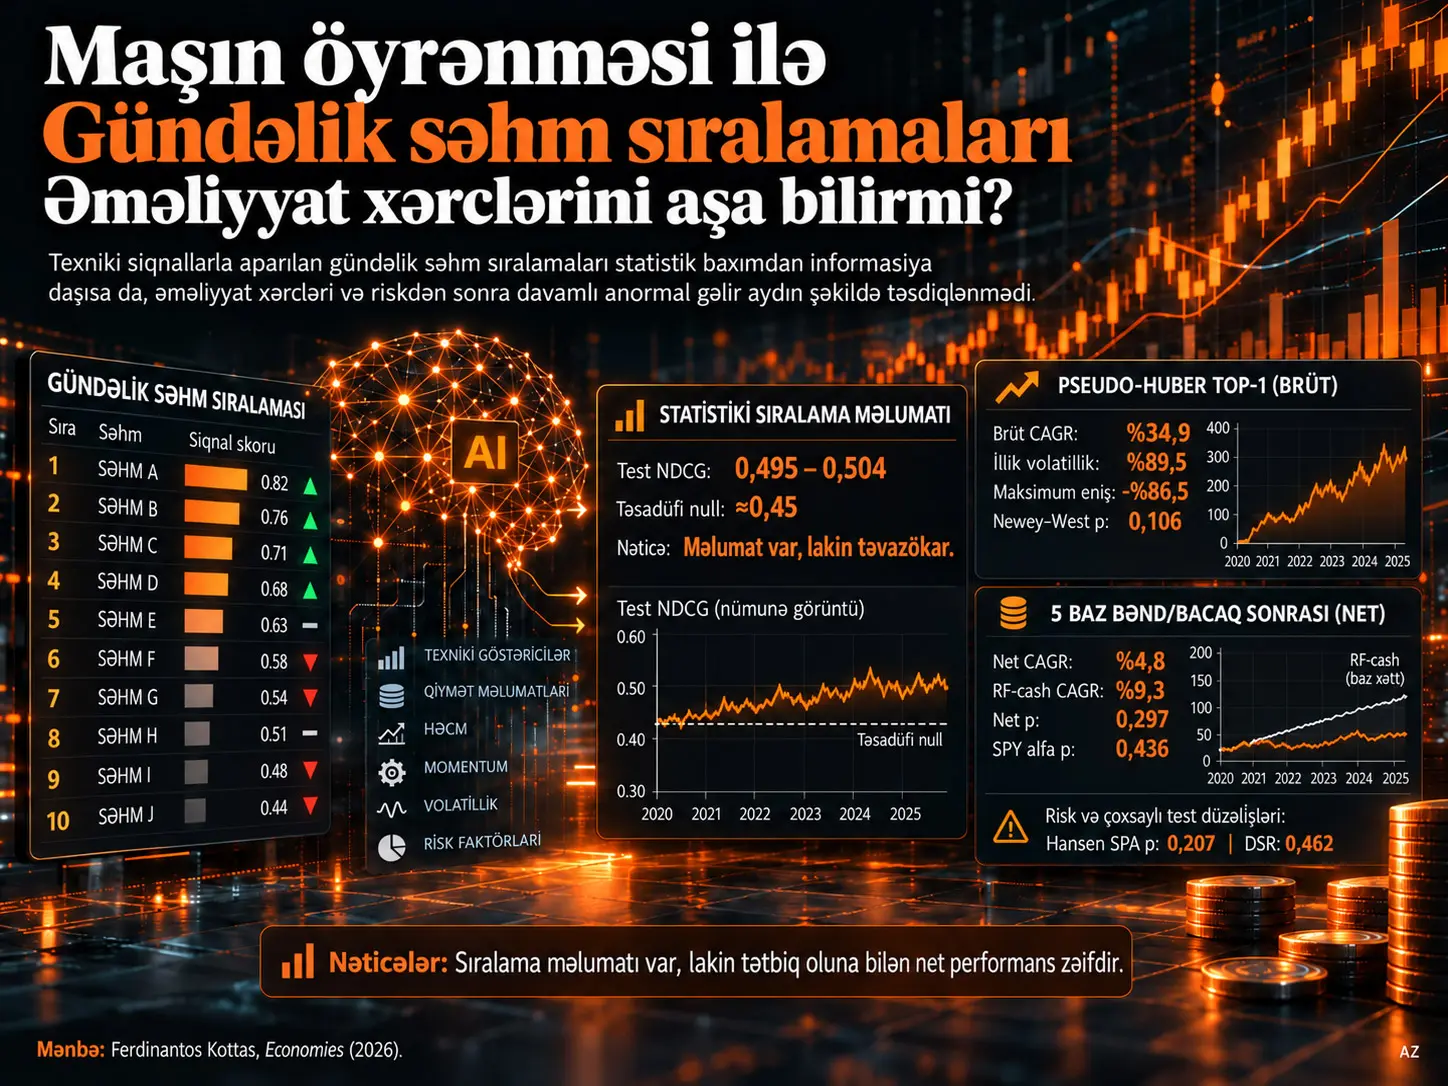
Bu tədqiqatdakı gündəlik adaptiv maşın öyrənməsi səhm sıralama çərçivəsi, dinamik şəkildə süzgəcdən keçirilən Nasdaq mənbə kainatındakı səhmləri, 196 texniki proqnoz dəyişənindən istifadə edən dörd XGBoost öyrənmə məqsədi ilə növbəti ticarət gününün açılış-bağlanış gəlirinə görə nisbi şəkildə sıralamağı hədəfləyən qısa üfüqlü seçim sistemidir. Araşdırma Pseudo-Huber reqressiyasını, aşağı istiqamətli xətaları cəzalandıran xüsusi reqressiyanı, pairwise ranking və NDCG-oriented ranking modellərini xronoloji walk-forward quruluşunda müqayisə edir. Test dövründə orta NDCG təxminən 0,495-0,504 aralığına yaxınlaşarkən təsadüfi sıralama null ortalaması təxminən 0,453-0,454-dür. Bu fərq modellərin təvazökar, lakin statistik olaraq aşkar edilə bilən kəsiklərarası sıralama məlumatı daşıdığını göstərir. Bununla belə, tədqiqat bu məlumatın əməliyyat xərcləri, dəyişkənlik, zaman üzrə qeyri-sabitlik, risk düzəlişi və çoxsaylı test nəzarətlərindən sonra davamlı anomal portfel gəlirinə çevrildiyini göstərmir.
Ən diqqətəlayiq brüt nəticə, doğrulama mərhələsində əvvəlcədən seçilmiş əsas strategiya olmayan və sonradan konsentrasiya diaqnostikası kimi araşdırılan Pseudo-Huber Top-1 portfelində müşahidə edilmişdir. Bu portfelin brüt illik həndəsi gəliri %34,91 və kumulyativ gəliri %266,45 olsa da, illikləşdirilmiş dəyişkənliyi %89,51, maksimum enişi %86,47-dir. Brüt orta gəlir üçün Newey-West testi əhəmiyyətli deyil (p = 0,106). Hər əməliyyat ayağına 5 baza bəndi xərc tətbiq edildikdə sıfır-nağd fərziyyəsində net CAGR %4,83-ə düşür; boş qalan kapitalın risksiz gəlir qazandığı hesablamada ümumi gəlir CAGR-ı %9,3 olsa da, artıq gəlir üzrə Newey-West nəticəsi dəyişmir (p = 0,297). SPY-nin eyni açılış-bağlanış üfüqü ilə aparılan net alfa testi də əhəmiyyətli deyil (p = 0,436). Buna görə tədqiqat “model sıralaya bilir” tapıntısı ilə “bu sıralamadan etibarlı və tətbiq edilə bilən anomal gəlir əldə etmək mümkündür” iddiasının bir-birindən ayrılmalı olduğunu göstərir.
Nəticələrin mühüm məhdudiyyətlərindən biri də məlumat kainatının 2026-cı ildə toplanmış Nasdaq namizəd siyahısından qurulmasıdır. Tarixi olaraq bazardan çıxmış bəzi qiymətli kağızlar mənbə siyahısında olmaya bilər və tədqiqat delisting gəlirlərini yenidən qurmur. Buna görə hesabatda göstərilən gəlir ölçüləri tam survivorship-bias-free tarixi Nasdaq kainatının nəticələri kimi şərh edilə bilməz.
Tədqiqatın əsas problemi
Qısa müddətli maliyyə maşın öyrənməsi tədqiqatlarında iki ayrı uğur meyarı asanlıqla bir-birinə qarışa bilər. Birincisi, modelin eyni ticarət günündə çoxlu səhmlər arasındakı nisbi sıralamanı təsadüfi sıralamadan daha yaxşı edə bilməsidir. İkincisi isə bu sıralamanı real alqı-satqı qərarlarına çevirdikdən sonra əməliyyat xərcləri, dəyişkənlik, bazar riski və çoxsaylı model axtarışı nəzərə alındıqda iqtisadi baxımdan mənalı gəlir əldə edilə bilməsidir. Kottasın tədqiqatının əsas araşdırma sualı bu fərq üzərində qurulmuşdur.
Araşdırma xüsusilə bu ardıcıl problemi sınaqdan keçirir: Texniki qiymət və əməliyyat məlumatlarından yaradılan maşın öyrənməsi skorları növbəti günün səhm kəsiyini təsadüfi sıralamadan daha yaxşı sıralayırmı? Əgər sıralayırsa, ən yüksək skorlu səhmləri almaq ideyası real əməliyyat uçotu altında xərcləri üstələyə bilirmi? Görünən performans zamanla sabitdirmi? Risk düzəlişindən sonra qalırmı? Eyni məlumat üzərində çoxsaylı strategiya və quruluşun araşdırılmasının yaratdığı data-snooping/multiplicity riski nəzərə alındıqda nəticə yenə də inandırıcıdırmı?
NDCG təxminən 0,50 olduqda sıralama təsadüfidirmi?
Xeyr; bu tədqiqatda təxminən 0,50-lik NDCG avtomatik olaraq təsadüfi sıralama demək deyil. İstifadə edilən gün içi faizli relevance çevrilməsi və eksponensial NDCG qazanc quruluşu altında Monte Carlo təsadüfi sıralama ortalaması təxminən 0,45-dir; modellərin 0,495-0,504 aralığındakı test NDCG dəyərləri bu null paylanmasının üzərində tapılmış və 2000 təsadüfiləşdirmə təcrübəsində birtərəfli p dəyəri Monte Carlo qətnaməsində 0,0005 səviyyəsində olmuşdur. Bununla belə, bu fərq iqtisadi baxımdan böyük siqnal deyil; yalnız təvazökar, lakin ölçülə bilən sıralama məlumatı olduğunu göstərir.
Məlumat dövrü və investisiya kainatı
| Element | Mənbədə bildirilən dəyər | Elmi mənası |
|---|---|---|
| Xam bazar məlumatı | 2 Avqust 2021-31 İyul 2026 | Xüsusiyyətlərin və irəli tarixli hədəflərin yaradıldığı əsas məlumat dövrü |
| Nümunədənkənar test dövrü | 21 Mart 2022-30 İyul 2026 | Model seçiminin ardından görülməmiş test tarixlərinin dövrü |
| Təlim pəncərəsi | 105 ticarət günü | Hər walk-forward iterasiyasının xarici təlim bloku |
| Doğrulama pəncərəsi | 21 ticarət günü | Xüsusiyyət təmsilinin və portfel ölçüsünün seçimi |
| Walk-forward test iterasiyası | 1094 | Hər iterasiyada yalnız bir növbəti görülməmiş test günü |
| Yenidən nəzərdən keçirilmiş ortaq reallaşmış-gəlir müqayisələri | 1093 tarix | Benchmark/faktor tarixləri ilə uyğunlaşdırılan portfel analizləri |
Xam qiymət məlumatları yfinance interfeysi vasitəsilə gündəlik açılış, ən yüksək, ən aşağı, bağlanış, düzəldilmiş bağlanış və həcm sıralarından yaradılmışdır. Mənbə səviyyəsindəki namizəd faylda 5138 simvol vardır, zəruri qiymətli kağız metadatasının və bazar məlumatı iş axınının mövcud olduğu ayrıca metadata dəstində isə 454 ticker yer alır. Gündəlik qiymət, tarixi uzunluq, xüsusiyyət mövcudluğu və likvidlik şərtləri sonradan real investisiya edilə bilən kəsiyi müəyyən edir.
Bir səhm müəyyən gündə ən azı 35 günlük tarixçəyə malik olmalı, bağlanış qiyməti ən az 5 USD olmalı və son 20 günlük median dollar həcmi həmin günün uyğun kəsiyinin ən aşağı %10-luq likvidlik hissəsinin üzərində qalmalıdır. Bu filtrlərdən sonra gündəlik uyğun səhm sayının ortalaması təxminən 347,6, medianı 341, müşahidə olunan minimumu 320 və maksimumu 392-dir.
Dollar həcmi və 20 günlük median dollar həcmi mənbədə belə müəyyən edilir:
\[ DV_{i,t}=Close_{i,t}\times Volume_{i,t} \]
\[ ADV20_{i,t}=\operatorname{median}\{DV_{i,s}:s=t-19,\ldots,t\} \]
DV bir səhmin həmin gün üçün təxmini dollar əməliyyat həcmini; ADV20 isə mövcud tarixə qədər son 20 günlük dollar həcmlərinin medianını ifadə edir. ADV20 bu tədqiqatda qiymət təsirinin struktur modeli kimi deyil, likvidlik və əməliyyat iştirakçılığı üçün şəffaf proksi dəyişən kimi istifadə olunur.
196 texniki proqnoz dəyişəni nəyi əhatə edir?
| Xüsusiyyət ailəsi | Sayı | Əsas məlumat |
|---|---|---|
| Gün içi qiymət quruluşu | 38 | Gap-lər, gün içi gəlirlər, şam quruluşları və ticarət aralıqları |
| Gəlirin davamlılığı və geri dönüş | 25 | Qısa müddətli momentum, reversal və nisbi performans |
| Trend və qiymət məsafəsi | 45 | Hərəkətli ortalamalar, trend gücü, drawdown və yaxın dövr qiymət səviyyələrindən məsafə |
| Dəyişkənlik və aşağı istiqamətli risk | 32 | Ümumi/aşağı istiqamətli dəyişkənlik, yüksək-aşağı aralıqları və dəyişkənlik dəyişikliyi |
| Osillyatorlar və qiymət təzyiqi | 19 | Nisbi qiymət mövqeyi və yaxın dövr alış/satış təzyiqi |
| Həcm və likvidlik | 22 | Anormal həcm, dollar həcmi, likvidlik və qiymət-həcm qarşılıqlı təsirləri |
| Bazar konteksti | 14 | Bazar genişliyi, ümumi momentum, bazar dəyişkənliyi və kəsiklərarası paylanma |
| Digər texniki ölçü | 1 | Əlavə aralıq əsaslı məlumat |
| Cəmi | 196 | Bütün texniki proqnoz dəyişənləri |
Xüsusiyyətlərin çoxu 1, 2, 3, 5, 10 və 20 ticarət günlük keçmiş pəncərələrindən, bəziləri isə 30 günlük daha geniş kontekstdən istifadə edir. Bu xüsusiyyətlər ayrı-ayrılıqda “ticarət qaydası” kimi sınaqdan keçirilməmişdir; XGBoost ağaclarının momentum, reversal, dəyişkənlik, həcm və bazar şərtləri arasındakı qeyri-xətti qarşılıqlı təsirlərdən istifadə edə bilməsi üçün birlikdə modelə verilir.
Tədqiqat üç fərqli giriş təmsilini sınaqdan keçirir. Raw təmsil 196 xam ədədi xüsusiyyəti saxlayır. Ranked təmsil hər dəyişəni həmin günün uyğun səhm kainatı daxilində 0 ilə 1 arasındakı kəsiklərarası sıra mövqeyinə çevirir:
\[ x^{rank}_{i,t,j}=\frac{\operatorname{rank}_{t}(x_{i,t,j})-1}{N_t-1} \]
Bu çevrilmə xam dəyərlər arasındakı ədədi məsafəni deyil, kəsik daxilindəki nisbi sıralamanı saxlayır. Combined təmsil isə 196 xam dəyişənlə onların 196 ranked qarşılığını birlikdə istifadə edərək ümumi girişi 392-yə çatdırır.
Proqnoz hədəfi niyə yalnız növbəti günün açılış-bağlanış gəliridir?
Modelin hədəf dəyişəni:
\[ r_{i,t+1}=\frac{Close_{i,t+1}}{Open_{i,t+1}}-1 \]
şəklindədir. Beləliklə, model t gününün bağlanışına qədər məlum olan texniki məlumatdan istifadə edir; reallaşan hədəf isə t+1 gününün açılışından həmin günün bağlanışına qədər olan gəlirdir. Gecə ərzində yaranan close-to-open hərəkəti hədəfə daxil edilmir. Bu fərq yalnız riyazi deyil, əməliyyat uçotunu müəyyən edən əsas dizayn seçimidir: portfel növbəti gün açılışda alınmalı və eyni gün bağlanışda tamamilə bağlanmalıdır.
Walk-forward quruluşu məlumat sızmasını necə məhdudlaşdırır?
Hər xarici iterasiyada 105 gün təlim, onun ardınca 21 gün doğrulama və sonra bir test günü vardır:
\[ \max T_k < \min V_k < t_k,\qquad |T_k|=105,\quad |V_k|=21 \]
Hiperparametr seçimi 105 günlük təlim blokunun daxilində əlavə olaraq xronoloji aparılır: ilk 84 gün daxili təlim, son 21 gün daxili tuning blokudur. Hiperparametrlər seçildikdən sonra model 105 günlük xarici təlim blokunda öyrədilir; növbəti 21 günlük xarici validation dövrü xüsusiyyət təmsilini və portfeldə saxlanılacaq səhm sayı K-nı seçmək üçün istifadə olunur. Bu seçim tamamlandıqdan sonra model əvvəlki 126 gün üzrə yenidən proqnozlaşdırılaraq yalnız bir görülməmiş test gününə tətbiq edilir. Pəncərə daha sonra bir ticarət günü irəli sürüşdürülür.
Tədqiqatın mühüm məhdudiyyətlərindən biri 105 təlim tarixinin 196 xam və xüsusilə 392 combined girişlə müqayisədə qısa olmasıdır. Müəllif aparılmamış 252 və ya 504 günlük yenidən təxminləri sonradan mövcud imiş kimi təqdim etmir və yüksək xüsusiyyət/tarix nisbətini mümkün qeyri-sabitlik mənbəyi kimi saxlayır.
Dörd XGBoost öyrənmə məqsədi
Dörd model eyni gradient boosting ağac infrastrukturunu paylaşır, lakin öyrəniləcək xəta və ya sıralama məqsədi baxımından fərqlənir. Ümumi XGBoost məqsəd funksiyası:
\[ \mathcal{L}(\Theta)=\sum_{i=1}^{n}\ell(y_i,\hat{y}_i)+\sum_{m=1}^{M}\Omega(f_m) \]
şəklində ifadə olunur. Birinci cəm modelin proqnoz/sıralama xətasını, ikinci cəm isə ağac mürəkkəbliyinə nəzarət edən nizamlamanı ifadə edir.
Pseudo-Huber reqressiyası
Reqressiya modelləri öyrədilərkən onluq gündəlik gəlirlər 100-ə vurulmuş, proqnozlardan sonra yenidən 100-ə bölünmüşdür. Buna görə \(\delta=1\), onluq gəlir vahidi deyil, təxminən bir faiz bəndlik qalıq miqyasına uyğun gəlir. İtki:
\[ L_{\delta}(e)=\delta^2\left(\sqrt{1+\frac{e^2}{\delta^2}}-1\right),\qquad e=\hat{y}-y,\quad \delta=1 \]
şəklindədir. Kiçik xətalarda təxminən kvadratik davranarkən böyük qalıqların təsiri tədricən xətti artıma yaxınlaşır. Beləliklə, həddən artıq böyük gəlir xətaları tamamilə atılmadan onların təsiri məhdudlaşdırılır.
Aşağı istiqamətli xəta cəzalı reqressiya
İkinci reqressiya modeli, faktiki olaraq mənfi gəlir baş verərkən modelin müsbət gəlir proqnozlaşdırdığı yanlış-müsbət uzun mövqe siqnallarını xüsusi olaraq daha ağır cəzalandırır:
\[ L_D(y,\hat{y})=a(y,\hat{y})(\hat{y}-y)^2 \]
\[ a(y,\hat{y})=1+4\,\mathbf{1}\{y<0,\hat{y}>0\} \]
Şərt baş vermədikdə çəki 1, baş verdikdə 5 olur. Buna görə məqsəd bütün mənfi xətaları deyil, mənfi reallaşma qarşısında müsbət istiqamət proqnozu verilmiş halları xüsusilə cəzalandırmaqdır.
Pairwise Ranking
Ranking modellərində reallaşan növbəti gün gəlirləri hər tarix daxilində beş relevance sinfinə \(q\in\{0,1,2,3,4\}\) çevrilir. Pairwise yanaşma daha yüksək relevance dərəcəsinə malik səhmin skorunun digərindən yüksək olmasını öyrənməyə çalışır:
\[ L_{pair}=\sum_{q_i>q_j}\log\left(1+\exp(-(s_i-s_j))\right) \]
Bu model mütləq gəlir böyüklüyünü proqnozlaşdırdığını iddia etmir; hədəf nisbi sıralamadır.
NDCG-oriented Ranking
NDCG modeli də eyni ordinal siniflərdən istifadə edərək öyrədilir. Test qiymətləndirməsində isə reallaşan gəlirlər tarix daxilində faiz mövqelərinə çevrilir və siyahının yuxarı sıralarına daha çox çəki verən Normalized Discounted Cumulative Gain metriyi hesablanır:
\[ \mathrm{NDCG}_t@K= \frac{\mathrm{DCG}_t(K)}{\mathrm{IDCG}_t(K)} = \frac{1}{\mathrm{IDCG}_t(K)} \sum_{j=1}^{K} \frac{2^{rel_{i,t+1}}-1}{\log_2(j+1)} \]
\(j\) model tərəfindən verilən sıralamadakı mövqeni; \(rel\) həmin mövqeyə yerləşdirilən səhmin reallaşmış relevance dəyərini; IDCG isə eyni günün ideal sıralamasını ifadə edir. Loqarifmik diskont səbəbindən siyahının ilk sıralarındakı xətalar daha vacibdir.
Hiperparametr və portfel konfiqurasiyası bir-birindən ayrılır
Hiperparametr tuning-i birbaşa maliyyə gəliri ilə aparılmır. Daxili tuning skoru, [−1,1] aralığındakı Spearman məlumat əmsalını [0,1]-ə keçirən çevrilmə ilə NDCG@10-un bərabər çəkili ortalamasıdır:
\[ TuneScore_{inner} = \frac{1}{2}\left(\frac{IC_{inner}+1}{2}\right) + \frac{1}{2}\mathrm{NDCG@10}_{inner} \]
Tənzimlənən hiperparametrlər arasında boosting iterasiyası, learning rate, maksimum ağac dərinliyi, minimum child weight, minimum loss reduction, sətir və sütun seçmə nisbətləri ilə L1/L2 nizamlaması yer alır.
Daha sonrakı portfel konfiqurasiyası mərhələsində isə hər model üçün üç xüsusiyyət təmsili ilə dörd portfel ölçüsü birləşdirilir:
\[ 3\;\text{gösterim}\times K\in\{5,10,20,30\}=12\;\text{aday} \]
Namizədlər validation NDCG, təlim-validation IC fərqi və validation Top-K gəliri olmaqla üç komponent üzrə qiymətləndirilir. Hər komponent 0-1 aralığında nisbi sıra skoruna çevrilir:
\[ RS_{high}(z_c)=\frac{\operatorname{rank}(z_c)-1}{C-1}, \qquad RS_{low}(z_c)=1-RS_{high}(z_c), \qquad C=12 \]
Sabitlik ölçüsü:
\[ GapIC_{c,t}= \left|IC^{train}_{c,t}-IC^{valid}_{c,t}\right| \]
və buna bağlı skor:
\[ StabilityScore_{c,t}=RS_{low}(GapIC_{c,t}) \]
kimi müəyyən edilir. Daha kiçik təlim-validation fərqi daha yüksək sabitlik skoru alır.
Açılışda alınıb bağlanışda satılan portfeldə gündəlik dövriyyə niyə 2-dir?
Çünki bu tədqiqatın yekun əməliyyat üfüqündə tam investisiya edilmiş portfelin bir vahid kapitalı növbəti gün açılışda alınır və eyni kapital bağlanışda tamamilə satılır; bir vahid alış ilə bir vahid satışın cəmi round-trip turnover = 2 verir. Eyni səhm növbəti gün yenidən seçilsə belə əvvəlki günün mövqeyi bağlanışda ləğv edildiyindən iki gün arasındakı ad örtüşməsi reallaşan əməliyyat miqdarını azaltmır. Buna görə köhnə portfellə yeni portfel arasındakı holding overlap əməliyyat xərcinin yerinə istifadə edilə bilməz.
Mənbə, orijinal seçim qaydasındakı keçid-örtüşmə diaqnostikasını da təkrar istehsal edilə bilmə məqsədilə göstərir:
\[ \tau_{c,t}=\sum_i\left|w^{c}_{i,t}-w_{i,t-1}\right| \]
Bu ifadə seçilmiş adların günlər arasındakı davamlılığını təsvir etmək üçün faydalıdır; lakin yenidən nəzərdən keçirilmiş tədqiqatda open-to-close strategiyasının faktiki execution turnover-ı kimi istifadə edilmir.
Xərcli validation gəliri ümumilikdə:
\[ R^{net,valid}_{c,t} = R^{gross,valid}_{c,t} - \lambda\tau_{c,t}, \qquad \lambda=0.0005 \]
şəklindədir. Yekun intraday uçotunda tam investisiya edilmiş bütün namizədlər eyni gündə \(\tau=2\) round-trip xərcinə məruz qaldığından 5 baza bəndi/ayaq cəmi 10 baza bəndi/gün yaradır. Ortaq xərc eyni gün daxilində tam investisiya edilmiş namizədlərin nisbi sırasını dəyişmədiyi üçün finance komponenti praktik olaraq validation Top-K gəlirinə görə sıralanır:
\[ FinanceScore_{c,t} = RS_{high}\left(R^{net,valid}_{c,t}\right) \]
Üç komponent sonda bərabər çəki ilə birləşdirilir:
\[ AdaptiveScore_{c,t} = \frac{ MLScore_{c,t} + StabilityScore_{c,t} + FinanceScore_{c,t} }{3} \]
Ən yüksək AdaptiveScore-a malik xüsusiyyət təmsili və K dəyəri növbəti görülməmiş test günü üçün sabitlənir. Test gününün reallaşmış gəliri seçim zamanı istifadə olunmur.
Mənbəyə sadiq metod axını: Gündəlik qiymət/həcm məlumatı → zaman-nöqtəli uyğunluq filtri → 196 texniki dəyişən → raw/ranked/combined təmsil → dörd XGBoost məqsədi → xronoloji daxili hiperparametr tuning-i → 21 günlük xarici validation → 12 portfel namizədi → AdaptiveScore → bir görülməmiş test günü → açılışda alış/bağlanışda satış → əməliyyat xərci, risk və statistik möhkəmlik analizi.
Tədqiqatın Metodu və Nəticələri
1. Sıralama performansı: təlimdəki fərqlər testdə böyük ölçüdə yox olur
| Model | Training NDCG | Validation NDCG | Test NDCG | Train-Test fərqi | Random null | Permutasiya p |
|---|---|---|---|---|---|---|
| Downside-Penalized | 0,642 | 0,532 | 0,504 | 0,138 | 0,454 | 0,0005 |
| Pseudo-Huber | 0,561 | 0,533 | 0,503 | 0,057 | 0,454 | 0,0005 |
| NDCG Ranking | 0,694 | 0,524 | 0,495 | 0,199 | 0,453 | 0,0005 |
| Pairwise Ranking | 0,773 | 0,535 | 0,501 | 0,272 | 0,454 | 0,0005 |
Ən yüksək təlim NDCG-si 0,773 ilə Pairwise Ranking-dədir; lakin testdə bu üstünlük yox olur və dəyər 0,501-ə enir. Pseudo-Huber təlimdə yalnız 0,561 NDCG yaratmasına baxmayaraq 0,503 test dəyərinə çatdığı üçün ən kiçik təlim-test boşluğuna malikdir. Bu nəticə təlim uyğunluğunun təkbaşına gələcək sıralama keyfiyyətinin etibarlı göstəricisi olmadığını açıq şəkildə göstərir.
Mühüm məqam dörd modelin də test NDCG-sinin random-null ortalamasından yüksək olmasıdır. Lakin dörd fərqli öyrənmə məqsədi test dövründə təxminən eyni dar aralığa yaxınlaşır. Buna görə öyrənmə məqsədinin təlimdə yaratdığı böyük performans fərqlənməsi nümunədənkənarda qorunmur.
2. Xüsusiyyət əhəmiyyətləri və model sabitliyi
Aşağı istiqamətli xəta cəzalı modelin importance paylanması böyük ölçüdə dəyişkənlik və aşağı istiqamətli risk ailəsində cəmlənmişdir: bu ailə ümumi gain importance-ın %67,2-sini təşkil edir. NDCG Ranking modelində eyni ailənin payı %54,4-dür. Pairwise Ranking daha geniş importance paylanması göstərir; ən böyük ailənin payı yalnız %28,8-dir.
Pseudo-Huber üçün xüsusi şərh sərhədi vardır. Mənbə məlumat panelində 14 bazar-ümumi dəyişən eyni tarix daxilində bütün səhmlər üçün sabitdir. Buna görə bu dəyişənlər həmin günün səhmlərini birbaşa bir-birindən ayıra bilməz. Buna baxmayaraq, seçilmiş nümunədənkənar yolda bu 14 dəyişən Pseudo-Huber-ın Top-20 XGBoost gain importance-ının orta hesabla %38,1-ni təşkil edir. Bu dəyər “bazar dəyişənləri səhmləri birbaşa sıralayır” mənasına gəlmir; təsirləri tarixlərarası dəyişmə və ya səhm-səviyyəli dəyişənlərlə qarşılıqlı təsirlər üzərindən ortaya çıxa bilər.
| Model | Top-10 Jaccard | Top-20 Jaccard | Importance cosine similarity | Top-1 predictor persistence |
|---|---|---|---|---|
| Downside-Penalized | 0,359 | 0,315 | 0,638 | 0,361 |
| Pseudo-Huber | 0,289 | 0,328 | 0,477 | 0,238 |
| NDCG Ranking | 0,185 | 0,196 | 0,360 | 0,083 |
| Pairwise Ranking | 0,068 | 0,099 | 0,182 | 0,027 |
Pairwise Ranking, təlim NDCG-si ən yüksək model olmasına baxmayaraq xüsusiyyət attribution-da açıq şəkildə ən aşağı lokal sabitliyi göstərir. Ən yüksək importance-a malik canonical predictor yalnız %2,7 nisbətində növbəti günə eyni şəkildə daşınır. Downside-Penalized modeldə bu nisbət %36,1-dir. Bu müqayisə güclü təlim skorunun daha sabit model quruluşu demək olmadığını göstərir.
3. Adaptiv təbəqə həqiqətən sabitdirmi?
Portfel seçim sistemi dörd K dəyərinin və üç xüsusiyyət təmsilinin hamısından test dövründə istifadə etmişdir; heç bir ortaq quruluş davamlı şəkildə dominant olmayıb. K = 5 bütün modellərdə ən çox seçilən portfel ölçüsüdür və ranked xüsusiyyətlər ən çox seçilən təmsil formasıdır; lakin bu iki seçim birlikdə daimi vahid konfiqurasiyaya çevrilmir.
Birləşmiş konfiqurasiyanın ardıcıl günlərdə dəyişmə nisbəti Pseudo-Huber üçün %73,4, Downside-Penalized üçün %72,6, NDCG Ranking üçün %76,3 və Pairwise Ranking üçün %83,8-dir. Pairwise modelində hətta portfel ölçüsü K keçidlərin %63,9-da dəyişir. Seçilmiş namizədlə ikinci namizəd arasındakı AdaptiveScore fərqinin medianı bütün modellər üçün yalnız 0,0606-dır; tam skor bərabərlikləri günlərin təxminən %15,2-%18,8-də müşahidə olunur. Buna görə adaptiv təbəqə, güclü şəkildə ayrılmış gündəlik optimumlar tapan mexanizm kimi deyil, bir-birinə yaxın validation namizədləri arasında tez-tez dəyişən seçim prosesi kimi şərh edilməlidir.
4. Adaptiv Top-K portfellərinin brüt performansı
| Model | İllik arifmetik gəlir | İllik həndəsi gəlir | İllik dəyişkənlik | Sharpe | Kumulyativ gəlir | Maks. eniş |
|---|---|---|---|---|---|---|
| Downside-Penalized | %18,29 | %9,47 | %43,03 | 0,425 | %48,07 | −%62,09 |
| Pseudo-Huber | %12,60 | %4,51 | %40,46 | 0,311 | %21,10 | −%54,20 |
| NDCG Ranking | %12,33 | −%0,96 | %51,62 | 0,239 | −%4,08 | −%72,92 |
| Pairwise Ranking | −%10,91 | −%15,91 | %35,78 | −0,305 | −%52,85 | −%64,38 |
| Bərabər çəkili uyğun səhm kainatı | %6,93 | %5,11 | %19,82 | 0,350 | %24,11 | −%24,53 |
Brüt adaptiv nəticələrdə ən yüksək həndəsi gəlir %9,47 ilə Downside-Penalized modelindədir; lakin illik dəyişkənliyi %43,03 və maksimum enişi %62,09-dur. Bərabər çəkili uyğun səhm benchmark-ı %5,11 həndəsi gəlir yaradarkən yalnız %19,82 dəyişkənliyə və %24,53 maksimum enişə malikdir. Buna görə adaptiv modellər daha yüksək risk yaradır, lakin statistik olaraq etibarlı əlavə gəlir ortaya qoymur.
NDCG modelindəki arifmetik-həndəsi fərq xüsusilə öyrədicidir. İllik arifmetik orta gəlir %12,33 ikən həndəsi gəlir −%0,96-dır. Yüksək dəyişkənlik səbəbindən gündəlik gəlirlərin ortalaması müsbət olduğu halda belə mürəkkəb sərvət artımı mənfiyə çevrilə bilər. Bu, maliyyə strategiyalarında yalnız arifmetik illikləşdirilmiş orta göstəriciyə baxmağın niyə yanıltıcı ola biləcəyini göstərir.
5. Top-1 konsentrasiya diaqnostikası
Mənbə K = 5 nəticələrinin araşdırılmasından sonra model sıralamasının ən uc üst hissəsindəki davranışı anlamaq üçün yalnız ən yüksək skorlu səhmi saxlayan Top-1 portfellərini ayrıca araşdırmışdır. Bu analiz əvvəlcədən müəyyən edilmiş doğrulama qaydası deyil; ex-post konsentrasiya diaqnostikasıdır. Buna görə Pseudo-Huber Top-1-in güclü brüt göstəriciləri təsdiqlənmiş investisiya strategiyasının sübutu kimi istifadə edilə bilməz.
| Model | İllik arifmetik gəlir | İllik həndəsi gəlir | İllik dəyişkənlik | Sharpe | Kumulyativ gəlir | Maks. eniş |
|---|---|---|---|---|---|---|
| Pseudo-Huber | %71,24 | %34,91 | %89,51 | 0,796 | %266,45 | −%86,47 |
| NDCG Ranking | %43,03 | −%6,58 | %99,63 | 0,432 | −%25,56 | −%87,51 |
| Downside-Penalized | %48,68 | −%7,60 | %106,36 | 0,458 | −%29,03 | −%82,59 |
| Pairwise Ranking | %22,76 | −%8,61 | %78,96 | 0,288 | −%32,32 | −%65,95 |
Pseudo-Huber Top-1 ilk baxışda fövqəladə güclü görünür. Lakin eyni portfelin illik dəyişkənliyi təxminən %90, maksimum enişi təxminən %86,5-dir və brüt gündəlik orta gəlir üçün Newey-West t statistikası 1,615, p dəyəri 0,106-dır. Yəni brüt CAGR-ın böyüklüyü təkbaşına sıfırdan etibarlı şəkildə fərqli orta gəliri sübut etmir.
Daha mühümü, performans zaman üzrə bərabər paylanmamışdır. Pseudo-Huber Top-1-in brüt CAGR-ı 2022-də %646,8 və 2023-də %75,9 olduğu halda 2024-də −%19,4, 2025-də −%7,7 və 2026-nın araşdırılan hissəsində −%61,0-dır. Test dövrünün ilk yarısında CAGR %154,9, ikinci yarısında isə −%28,9-dur. Belə zaman profili tam dövr CAGR-ının davamlı gözlənilən gəlir prosesini təmsil etdiyi fərziyyəsini ciddi şəkildə məhdudlaşdırır.
6. Əməliyyat xərcləri nəticəni necə dəyişir?
Strategiya hər investisiya günündə mövqeləri açılışda qurub bağlanışda tamamilə bağladığı üçün əməliyyat xərcinin əsas müəyyənedicisi günlərarası portfel örtüşməsi deyil, tam round-trip əməliyyatıdır. 5 baza bəndlik birtərəfli xərc tam investisiya edilmiş gündə cəmi 10 baza bəndi xərc deməkdir.
| Model | Strategiya | Gündəlik turnover | Brüt CAGR | Net CAGR | Net NW t | Net p |
|---|---|---|---|---|---|---|
| Downside-Penalized | Adaptive | 2,00 | %9,47 | −%14,92 | −0,36 | 0,723 |
| Downside-Penalized | Top-1 | 2,00 | −%7,60 | −%28,24 | 0,46 | 0,645 |
| Pseudo-Huber | Adaptive | 2,00 | %4,51 | −%18,78 | −0,70 | 0,482 |
| Pseudo-Huber | Top-1 | 2,00 | %34,91 | %4,83 | 1,04 | 0,297 |
| NDCG Ranking | Adaptive | 2,00 | −%0,96 | −%23,04 | −0,56 | 0,579 |
| NDCG Ranking | Top-1 | 2,00 | −%6,58 | −%27,44 | 0,38 | 0,702 |
| Pairwise Ranking | Adaptive | 2,00 | −%15,91 | −%34,67 | −2,22 | 0,026 |
| Pairwise Ranking | Top-1 | 2,00 | −%8,61 | −%29,00 | −0,06 | 0,949 |
Pseudo-Huber Top-1-in %34,91-lik brüt CAGR-ı yalnız 5 baza bəndlik birtərəfli xərc altında %4,83-ə enir. Mənbə əlavə olaraq bu net trayektoriyada maksimum enişin təxminən %92,8-ə qədər yüksəldiyini bildirir. Boş qalan pulun gündəlik risksiz gəlir qazandığı RF-cash uçotunda ümumi net CAGR %9,3-ə yüksəlir; lakin excess-return Sharpe 0,514 və Newey-West p = 0,297 olaraq qalır. Bunun səbəbi risksiz faiz gəlirinin artıq gəlir hesablanarkən yenidən çıxılmasıdır.
Sıralama məlumatının statistik olaraq aşkar edilməsi niyə investisiya edilə bilən anomal gəlir demək deyil?
Çünki modelin səhmləri təsadüfi sıralamadan bir qədər yaxşı sıralaması, bu məlumatdan istifadə etmək üçün tələb olunan gündəlik əməliyyatların xərcindən, portfel dəyişkənliyindən, böyük drawdown-lardan, bazar riski ilə ortaq hərəkətdən, zaman üzrə performans qırılmalarından və çoxsaylı strategiya sınağının yaratdığı multiplicity problemindən daha böyük iqtisadi üstünlük təmin etdiyinə zəmanət vermir. Bu tədqiqatda sıralama null hipotezi açıq şəkildə aşılarkən, əməliyyat xərci sonrası gəlir, matched-horizon alfa, Hansen SPA, Deflated Sharpe Ratio və bootstrap qeyri-müəyyənliyi birlikdə qiymətləndirildikdə davamlı müsbət anomal gəlir sübutu yaranmır.
7. Risk düzəlişi və çoxsaylı testlər
Pseudo-Huber Top-1 üçün SPY-nin eyni open-to-close üfüqü ilə aparılan reqressiyada brüt illikləşdirilmiş alfa %58,5-dir, lakin p = 0,171-dir. 5 baza bəndi/ayaq xərcindən sonra net illikləşdirilmiş alfa %33,3-ə düşür və p = 0,436-dır. Alfa nöqtə təxmininin böyük görünməsi etibar intervalının və statistik qeyri-müəyyənliyin nəzərə alınmaya biləcəyi anlamına gəlmir.
Mənbə əlavə olaraq close-to-close CAPM, Fama-French 3 faktor və Fama-French 5 faktor reqressiyalarını supplementary materialda bildirir, lakin bu modellərin strategiyanın saxlamadığı gecə gəlirini də ehtiva edən fərqli üfüqə malik olduğunu açıq şəkildə qeyd edir. Buna görə tədqiqatın əsas risk-düzəlişli sübutu matched open-to-close SPY reqressiyasıdır.
| Nəzarət | Nəticə | Şərh |
|---|---|---|
| Brüt Newey-West | t = 1,615; p = 0,106 | Brüt orta gəlir ənənəvi əhəmiyyətlilik səviyyəsində sıfırdan fərqlənmir |
| 5 bps net Newey-West | t = 1,044; p = 0,297 | Xərcdən sonrakı sübut daha da zəifdir |
| Net SPY open-to-close alfa | %33,3 illik; p = 0,436 | Nöqtə təxmini yüksəkdir, statistik olaraq əhəmiyyətli deyil |
| Hansen SPA | p = 0,207 | Sinxronlaşdırılmış 12 strategiya ailəsində üstünlük təsdiqlənmir |
| White-style reality check, brüt | p = 0,182 | Multiplicity-dən sonra güclü tapıntı yoxdur |
| White-style reality check, 5 bps net | p = 0,450 | Net performans üçün sübut daha da zəifdir |
| Deflated Sharpe Ratio ehtimalı | 0,462 | Sınaqdan keçirilən strategiya ailəsi nəzərə alındıqda inandırıcı üstünlük təmin etmir |
| Stationary-bootstrap net CAGR %95 intervalı | −%58,1 ilə +%147,5 | Mürəkkəb performans təxminində qeyri-müəyyənlik çox genişdir |
Newey-West testlərinin CAGR-ı deyil, gündəlik arifmetik orta gəliri sınaqdan keçirməsi xüsusilə vacibdir. Yüksək dəyişkənlik səbəbindən müsbət gündəlik orta ilə mənfi mürəkkəb sərvət artımı eyni zamanda müşahidə oluna bilər. Buna görə mənbə CAGR və terminal wealth qeyri-müəyyənliyini əlavə olaraq stationary bootstrap ilə qiymətləndirir.
Appendix-dəki Newey-West lag həssaslığı da Pseudo-Huber Top-1-in nəticəsini dəyişmir: 1, 5, 10 və 21 gecikmə seçimlərində t statistikası təxminən 1,03-1,12 arasında, p dəyəri isə təxminən 0,305-0,261 arasında qalır.
8. Likvidliklə turnover eyni şey deyil
Tədqiqat tez-tez alqı-satqı aparılması ilə əməliyyatın bazar həcminə görə böyük olmasını iki ayrı sürtünmə kimi qiymətləndirir. 50.000 USD ümumi kapital fərziyyəsində Pseudo-Huber Top-1 tərəfindən seçilən səhmlərin median ADV20 dəyəri təxminən 48,59 milyon USD-dir; seçilmiş səhm-günlərinin %88,0-da ADV20 10 milyon USD-dən, %49,4-də 50 milyon USD-dən yüksəkdir.
Pseudo-Huber Top-1-də birtərəfli əməliyyatın median böyüklüyü yalnız ADV20-nin %0,103-üdür. 95-ci percentil %0,899, 99-cu percentil %1,723 və maksimum müşahidə olunan dəyər %2,138-dir; əməliyyat ayaqlarının %95,8-i ADV20-nin %1-dən aşağı qalmışdır. Adaptiv Top-K portfellərində median iştirak bütün modellər üçün %0,008-dən aşağıdır və tədqiqatdakı 50.000 USD miqyasında bütün adaptiv birtərəfli əməliyyat ayaqları %1 ADV20 həddinin altında qalır.
Bu tapıntı “strategiya ucuz tətbiq edilə bilər” demək deyil. ADV20 nisbəti alış-satış spread-ini, market-on-open slippage-ı, qiymət təsirini və ya order-size mənşəli execution xərcini ölçmür. Tədqiqatın nəticəsi yalnız 50.000 USD kimi pərakəndə miqyasda tələb olunan nominal əməliyyatın çox vaxt müşahidə olunan bazar həcminə nisbətən kiçik olduğunu göstərir. Bu nəticə daha böyük kapitala və ya institusional tutuma ümumiləşdirilə bilməz.
9. Likvidlik qapıları da sabit üstünlük yaratmır
Mənbə minimum ADV20 həddini 10, 25, 50 və 100 milyon USD olaraq dəyişdirərək Top-1 nəticələrini yenidən qiymətləndirir. Pseudo-Huber Top-1 üçün RF-cash CAGR müvafiq olaraq təxminən %2,4, %10,9, −%16,4 və −%8,3-dür; əlaqəli p dəyərlərinin heç biri müsbət əhəmiyyətlilik göstərmir. Aralıq hədlərdəki daha yaxşı nöqtə təxminləri strategiyanın daha az sayda günə investisiya etməsindən və hansı günlərin investisiya edilə bilən qalmasından təsirlənir. Tədqiqat bu hədləri optimallaşdırılmış yeni strategiyalar kimi deyil, həssaslıq diaqnostikaları kimi nəzərdən keçirir.
10. Tədqiqatın dəstəklədiyi və dəstəkləmədiyi nəticələr
Tədqiqatın dəstəklədiyi nəticələr:
- Dörd XGBoost modelinin də nümunədənkənar sıralaması istifadə edilən NDCG tərifi altında random ranking null paylanmasının üzərində qalır.
- Bu sıralama üstünlüyünün böyüklüyü təvazökardır və təlimdəki böyük model fərqləri testdə daralır.
- Ranking modelləri, xüsusilə Pairwise Ranking, feature importance və konfiqurasiya baxımından reqressiya modellərinə nisbətən daha qeyri-sabitdir.
- Pseudo-Huber Top-1 çox böyük brüt CAGR yaratmışdır, lakin nəticə yüksək dəyişkənlik, həddən artıq drawdown, dövr asılılığı və quyruq hadisələrinə həssaslıqla birlikdə ortaya çıxmışdır.
- Gündəlik tam round-trip əməliyyat xərci müsbət görünən brüt performansı nəzərəçarpacaq dərəcədə azaldır.
- 50.000 USD miqyasında bazar iştirakı əsasən kiçikdir; buna baxmayaraq, tez-tez əməliyyat səbəbindən ümumi execution xərc problemi davam edir.
Tədqiqatın dəstəkləmədiyi nəticələr:
- Pseudo-Huber Top-1-in təsdiqlənmiş və ya tövsiyə olunan investisiya strategiyası olduğu iddiası dəstəklənmir.
- Təxminən 0,50 NDCG-nin təkbaşına iqtisadi olaraq istifadə edilə bilən alfa mənasına gəldiyi göstərilmir.
- 5 baza bəndi/ayaq xərcin real bazardakı universal və ya dəqiq əməliyyat xərci olduğu iddia edilmir.
- 50.000 USD üçün aşağı ADV20 iştirakı institusional kapital tutumunu sübut etmir.
- Mənbə kainatı survivorship və delisting selection problemlərindən təmizlənmiş tam tarixi Nasdaq kainatı deyil.
- Tədqiqat short-side və ya long-short performansını sınaqdan keçirmir; gündəlik sıralamanın aşağı quyruğu tam saxlanmamışdır.
- Feature importance dəyərləri texniki göstəricilərin səbəbli iqtisadi təsirlərini sübut etmir.
11. Əsas məhdudiyyətlər
Birinci məhdudiyyət mənbə kainatının 2026-cı ildə tərtib edilmiş siyahıya bağlı olmasıdır. Tarixi olaraq siyahıdan çıxmış şirkətlərin çatışmaması survivorship və delisting selection təsiri yarada bilər. İkinci məhdudiyyət 105 günlük təlim pəncərəsinin 196 və ya 392 girişlə müqayisədə qısa olmasıdır. Üçüncü məhdudiyyət dəqiq tarixi proqram paket versiyalarının saxlanılmamış olmasıdır.
Dördüncü məhdudiyyət execution modelidir. 5 baza bəndi/ayaq ssenarisi əməliyyat xərci həssaslığı üçün faydalı aşağı istinad verir, lakin spread, market-on-open slippage, bazar təsiri və sifariş ölçüsü birbaşa müşahidə edilməmişdir. Beşinci məhdudiyyət Top-1 analizinin ex-post olmasıdır. Altıncı məhdudiyyət əsas dizaynın yalnız long-only Top-K seçimlərini saxlaması və aşağı sıralardakı tam gündəlik skor vektorunun olmamasıdır.
Nəhayət, 14 bazar-ümumi dəyişən eyni tarix daxilində bütün səhmlər üçün sabitdir. Bunları modeldən çıxarmaq və ya hədəfi gün içindəki kəsiyə görə yenidən mərkəzləşdirmək mövcud nəticələrin sadə möhkəmlik yoxlaması deyil, yenidən təxmin edilməli yeni eksperimental dizayn olacaqdır. Mənbə bu fərqi açıq şəkildə qoruyur.
12. Tədqiqatın elmi mənası
Tədqiqatın ən dəyərli nəticəsi maliyyə maşın öyrənməsində performansın tək model metrikasına endirilməməli olduğunu göstərməsidir. Nümunədənkənar NDCG, feature attribution sabitliyi, portfel mürəkkəb sərvəti, maksimum eniş, əməliyyat turnover-ı, xərc həssaslığı, matched-horizon risk düzəlişi, zaman alt-dövrləri və multiplicity nəzarətləri fərqli suallara cavab verir.
Bu fərq xüsusilə qısa üfüqlü modellərdə vacibdir. Kiçik kəsiklərarası sıralama üstünlüyü statistik olaraq real ola bilər; lakin eyni üstünlüyü pula çevirmək üçün hər gün bütün mövqelərin açılıb bağlanması tələb olunursa, proqnoz siqnalının iqtisadi dəyəri əməliyyat protokolunun xərcini və riskini üstələməlidir. Bu tədqiqatda sözügedən ikinci hədd etibarlı şəkildə keçilmir.
Mənbə və Metod Qeydi
Orijinal başlıq: Do Daily Adaptive Machine Learning Stock Rankings Survive Trading Costs? Evidence from Cross-Sectional Technical Signals
Müəllif: Ferdinantos Kottas
Afiliasiyalar: School of Business, National University of Ireland Maynooth, Maynooth, Ireland; School of Engineering, Civil Engineering, Democritus University of Thrace, Xanthi, Greece; Department of Computer Science, Aristotle University of Thessaloniki, Thessaloniki, Greece.
Jurnal: Economies
Nəşriyyat: MDPI
Biblioqrafik qeyd: Economies, 2026, 14(9), Article 393
DOI: 10.3390/economies14090393
Rəsmi nəşr keçidi: https://doi.org/10.3390/economies14090393
Nəşr prosesi: Received 14 Avqust 2026; revised 31 Avqust 2026; accepted 1 Sentyabr 2026; published 5 Sentyabr 2026.
Mənbə növü və statusu: Hakemli jurnalda dərc olunmuş açıq girişli tədqiqat məqaləsi; nəşriyyat qeydində Version of Record.
Lisenziya: Creative Commons Attribution, CC BY 4.0.
Əsas metod: Dinamik Nasdaq mənbə kainatı üzərində 196 texniki predictor, raw/ranked/combined xüsusiyyət təmsilləri, dörd XGBoost objective, xronoloji walk-forward təlim-doğrulama-test quruluşu, adaptiv Top-K portfel seçimi, əməliyyat xərci və bazar iştirakçılığı analizi, Newey-West çıxarışı, matched-horizon SPY risk düzəlişi, stationary bootstrap və multiplicity nəzarətləri.
Maliyyələşdirmə: Tədqiqat xarici maliyyə almayıb.
Etik komitə: İnsan iştirakçıları və ya şəxsi məlumat istifadə edilmədiyinə görə tətbiq edilə bilən deyil.
Məlumat əlçatanlığı: Qiymət və həcm məlumatları Yahoo Finance-dən yfinance interfeysi vasitəsilə əldə edilmişdir. Empirik nəticələri yaradan kod müəllifdən əsaslandırılmış sorğu əsasında əldə edilə bilər; tam reproduktiv kod bazasının gələcəkdə GitHub vasitəsilə yayımlanacağı bildirilmişdir. İşlətmə mühiti Python 3, Google Colab və G4 High-RAM olaraq göstərilmişdir.
Supplementary material: Tam texniki göstərici kataloqu, XGBoost hiperparametr və reproducibility detalları, əsas model-strategiya yollarındakı ən böyük gündəlik gəlirlər ilə CAPM/Fama-French möhkəmlik cədvəlləri təqdim olunur.
Maraqlar toqquşması: Müəllif maraqlar toqquşmasının olmadığını bəyan edir.
Müəllif töhfələri: Mənbə PDF-də ayrıca CRediT/müəllif töhfələri bölməsi bildirilməmişdir. Tək müəllif vardır.
Əsas şərh sərhədi: Bu tədqiqat investisiya məsləhəti və ya təsdiqlənmiş alqı-satqı alqoritmi təqdim etmir. Xüsusilə Top-1 nəticəsi ex-post konsentrasiya diaqnostikasıdır. Tapıntılar 2026-vintage mənbə kainatına, araşdırılan tarix intervalına, open-to-close əməliyyat üfüqünə və istifadə edilən xərc həssaslığı fərziyyələrinə bağlıdır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib