


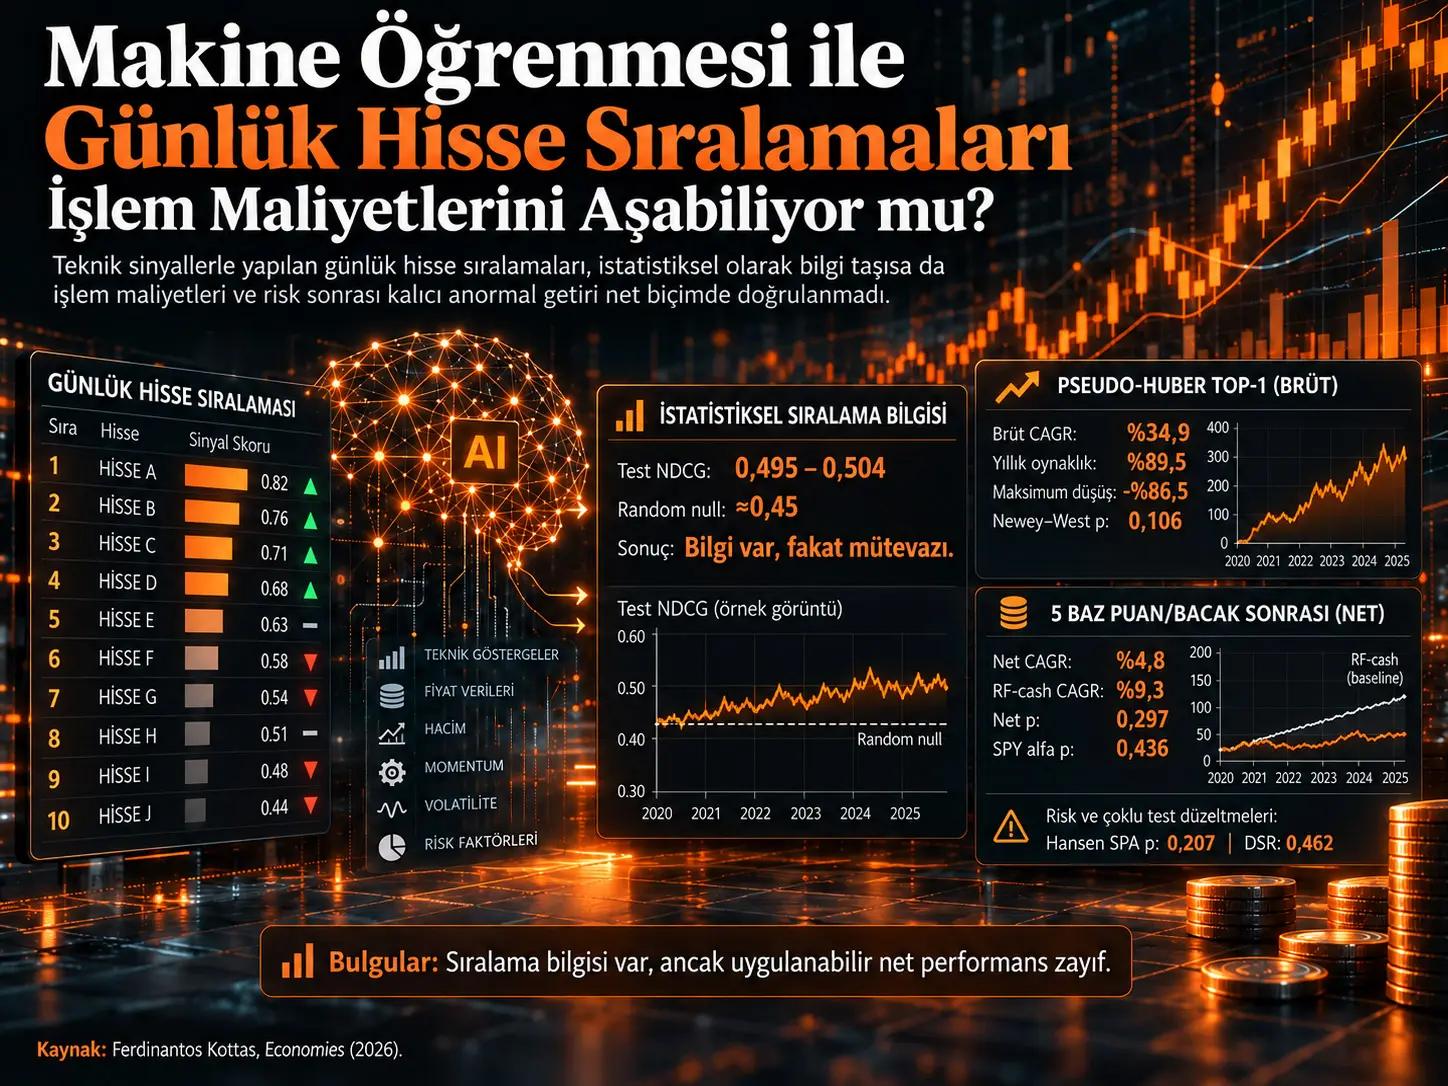
Bu çalışmadaki günlük uyarlamalı makine öğrenmesi hisse sıralama çerçevesi, dinamik biçimde filtrelenen bir Nasdaq kaynak evrenindeki hisseleri, 196 teknik tahmin değişkenini kullanan dört XGBoost öğrenme amacıyla bir sonraki işlem gününün açılış-kapanış getirisine göre göreli olarak sıralamayı amaçlayan kısa ufuklu bir seçim sistemidir. Araştırma, Pseudo-Huber regresyonu, aşağı yönlü hataları cezalandıran özel regresyon, pairwise ranking ve NDCG-oriented ranking modellerini kronolojik walk-forward düzende karşılaştırmaktadır. Test döneminde ortalama NDCG yaklaşık 0,495-0,504 aralığına yakınsarken rastgele sıralama null ortalaması yaklaşık 0,453-0,454'tür. Bu fark, modellerin mütevazı fakat istatistiksel olarak saptanabilir kesitsel sıralama bilgisi taşıdığını göstermektedir. Buna karşılık çalışma, bu bilginin işlem maliyetleri, oynaklık, zaman içi istikrarsızlık, risk düzeltmesi ve çoklu test kontrollerinden sonra dayanıklı bir anormal portföy getirisine dönüştüğünü göstermemektedir.
En dikkat çekici brüt sonuç, doğrulama aşamasında önceden seçilmiş ana strateji olmayan ve daha sonra yoğunlaşma tanısı olarak incelenen Pseudo-Huber Top-1 portföyünde görülmüştür. Bu portföyün brüt yıllık geometrik getirisi %34,91 ve kümülatif getirisi %266,45 olmasına karşın yıllıklaştırılmış oynaklığı %89,51, maksimum düşüşü %86,47'dir. Brüt ortalama getiri için Newey-West testi anlamlı değildir (p = 0,106). Her işlem bacağı için 5 baz puan maliyet uygulandığında sıfır-nakit varsayımındaki net CAGR %4,83'e düşmektedir; boşta kalan sermayenin risksiz getiri kazandığı hesapta toplam getiri CAGR'ı %9,3 olsa da aşırı getiriye ilişkin Newey-West sonucu değişmemektedir (p = 0,297). SPY'nin aynı açılış-kapanış ufkuyla yapılan net alfa testi de anlamlı değildir (p = 0,436). Dolayısıyla çalışma, “model sıralama yapabiliyor” bulgusuyla “bu sıralamadan güvenilir ve uygulanabilir anormal getiri elde edilebilir” iddiasının birbirinden ayrılması gerektiğini göstermektedir.
Sonuçların önemli bir sınırı da veri evreninin 2026'da toplanmış Nasdaq aday listesinden oluşturulmasıdır. Tarihsel olarak piyasadan çıkmış bazı menkul kıymetler kaynak listede bulunmayabilir ve çalışma delisting getirilerini yeniden kurmamaktadır. Bu nedenle raporlanan getiri büyüklükleri tam survivorship-bias-free tarihsel Nasdaq evreninin sonuçları olarak yorumlanamaz.
Araştırmanın temel problemi
Kısa vadeli finansal makine öğrenmesi çalışmalarında iki ayrı başarı ölçütü kolayca birbirine karışabilir. Birincisi, modelin aynı işlem gününde birçok hisse arasındaki göreli sıralamayı rastgele bir sıralamadan daha iyi yapabilmesidir. İkincisi ise bu sıralamayı gerçek alım-satım kararlarına dönüştürdükten sonra işlem maliyetleri, oynaklık, piyasa riski ve çoklu model araması dikkate alındığında ekonomik olarak anlamlı bir getiri elde edilebilmesidir. Kottas'ın çalışmasının ana araştırma sorusu bu ayrım üzerine kuruludur.
Araştırma özellikle şu sıralı problemi sınamaktadır: Teknik fiyat ve işlem verilerinden üretilen makine öğrenmesi skorları, ertesi günün hisse kesitini rastgele sıralamadan daha iyi sıralıyor mu? Eğer sıralıyorsa, en yüksek skorlu hisseleri satın alma fikri gerçekçi işlem muhasebesi altında maliyetleri aşabiliyor mu? Görünen performans zaman içinde kararlı mı? Risk düzeltmesinden sonra kalıyor mu? Aynı veri üzerinde çok sayıda strateji ve yapı incelenmesinin oluşturduğu data-snooping/multiplicity riski hesaba katıldığında sonuç hâlâ ikna edici mi?
NDCG yaklaşık 0,50 olduğunda sıralama rastgele midir?
Hayır; bu çalışmada yaklaşık 0,50'lik NDCG otomatik olarak rastgele sıralama anlamına gelmemektedir. Kullanılan gün-içi yüzdelik relevance dönüşümü ve üstel NDCG kazanç yapısı altında Monte Carlo rastgele sıralama ortalaması yaklaşık 0,45'tir; modellerin 0,495-0,504 aralığındaki test NDCG değerleri bu null dağılımının üzerinde bulunmuştur ve 2000 rastgeleleştirme deneyinde tek yönlü p değeri Monte Carlo çözünürlüğünde 0,0005 düzeyindedir. Bununla birlikte bu fark ekonomik olarak büyük bir sinyal değildir; yalnızca mütevazı fakat ölçülebilir sıralama bilgisi olduğunu gösterir.
Veri dönemi ve yatırım evreni
| Öğe | Kaynakta raporlanan değer | Bilimsel anlamı |
|---|---|---|
| Ham piyasa verisi | 2 Ağustos 2021-31 Temmuz 2026 | Özelliklerin ve ileri tarihli hedeflerin üretildiği ana veri dönemi |
| Dış-örnek test dönemi | 21 Mart 2022-30 Temmuz 2026 | Model seçiminden sonra görülmeyen test tarihlerinin dönemi |
| Eğitim penceresi | 105 işlem günü | Her walk-forward iterasyonunun dış eğitim bloğu |
| Doğrulama penceresi | 21 işlem günü | Özellik temsili ve portföy büyüklüğü seçimi |
| Walk-forward test iterasyonu | 1094 | Her iterasyonda tek bir sonraki görülmemiş test günü |
| Revize ortak gerçekleştirilmiş-getiri karşılaştırmaları | 1093 tarih | Benchmark/faktör tarihleriyle hizalanan portföy analizleri |
Ham fiyat verileri yfinance arayüzü üzerinden günlük açılış, en yüksek, en düşük, kapanış, düzeltilmiş kapanış ve hacim serilerinden oluşturulmuştur. Kaynak düzeyindeki aday dosyada 5138 sembol bulunmakta, gerekli güvenlik metadatası ve piyasa verisi iş akışının mevcut olduğu ayrı metadata kümesinde 454 ticker yer almaktadır. Günlük fiyat, geçmiş uzunluğu, özellik kullanılabilirliği ve likidite koşulları daha sonra gerçek yatırım yapılabilir kesiti belirlemektedir.
Bir hisse, belirli bir günde en az 35 günlük geçmişe sahip olmalı, kapanış fiyatı en az 5 USD olmalı ve son 20 günlük medyan dolar hacmi o günkü uygun kesitin en düşük %10'luk likidite bölümünün üzerinde kalmalıdır. Bu filtrelerin ardından günlük uygun hisse sayısının ortalaması yaklaşık 347,6, medyanı 341, gözlenen minimumu 320 ve maksimumu 392'dir.
Dolar hacmi ve 20 günlük medyan dolar hacmi kaynakta şu şekilde tanımlanmaktadır:
\[ DV_{i,t}=Close_{i,t}\times Volume_{i,t} \]
\[ ADV20_{i,t}=\operatorname{median}\{DV_{i,s}:s=t-19,\ldots,t\} \]
DV, bir hissenin o günkü yaklaşık dolar işlem hacmini; ADV20 ise mevcut tarihe kadar son 20 günlük dolar hacimlerinin medyanını temsil eder. ADV20 bu çalışmada fiyat etkisinin yapısal modeli olarak değil, likidite ve işlem katılımı için şeffaf bir vekil değişken olarak kullanılmaktadır.
196 teknik tahmin değişkeni neyi kapsıyor?
| Özellik ailesi | Sayı | Temel bilgi |
|---|---|---|
| Gün içi fiyat yapısı | 38 | Gap'ler, gün içi getiriler, mum yapıları ve işlem aralıkları |
| Getiri devamlılığı ve tersine dönüş | 25 | Kısa dönem momentum, reversal ve göreli performans |
| Trend ve fiyat uzaklığı | 45 | Hareketli ortalamalar, trend gücü, drawdown ve yakın dönem fiyat seviyelerinden uzaklık |
| Oynaklık ve aşağı yönlü risk | 32 | Toplam/aşağı yönlü oynaklık, yüksek-düşük aralıkları ve oynaklık değişimi |
| Osilatörler ve fiyat baskısı | 19 | Göreli fiyat konumu ve yakın dönem alış/satış baskısı |
| Hacim ve likidite | 22 | Anormal hacim, dolar hacmi, likidite ve fiyat-hacim etkileşimleri |
| Piyasa bağlamı | 14 | Piyasa genişliği, toplam momentum, piyasa oynaklığı ve kesitsel dağılım |
| Diğer teknik ölçüt | 1 | Ek aralık tabanlı bilgi |
| Toplam | 196 | Tüm teknik tahmin değişkenleri |
Özelliklerin çoğu 1, 2, 3, 5, 10 ve 20 işlem günlük geçmiş pencerelerini, bazıları da 30 günlük daha geniş bağlamı kullanmaktadır. Bu özellikler ayrı ayrı “ticaret kuralı” olarak sınanmamıştır; XGBoost ağaçlarının momentum, reversal, oynaklık, hacim ve piyasa koşulları arasındaki doğrusal olmayan etkileşimleri kullanabilmesi için birlikte modele verilmektedir.
Çalışma üç farklı giriş gösterimini sınamaktadır. Raw temsil 196 ham sayısal özelliği korur. Ranked temsil, her değişkeni aynı günkü uygun hisse evreni içinde 0 ile 1 arasındaki kesitsel sıra konumuna dönüştürür:
\[ x^{rank}_{i,t,j}=\frac{\operatorname{rank}_{t}(x_{i,t,j})-1}{N_t-1} \]
Bu dönüşüm, ham değerler arasındaki sayısal mesafeyi değil kesit içindeki göreli sırayı korur. Combined temsil ise 196 ham değişken ile bunların 196 ranked karşılığını birlikte kullanarak toplam 392 girdiye çıkar.
Tahmin hedefi neden yalnız ertesi gün açılış-kapanış getirisidir?
Modelin hedef değişkeni:
\[ r_{i,t+1}=\frac{Close_{i,t+1}}{Open_{i,t+1}}-1 \]
şeklindedir. Dolayısıyla model, t gününün kapanışına kadar bilinen teknik bilgiyi kullanır; gerçekleşen hedef ise t+1 gününün açılışından aynı günün kapanışına kadar olan getiridir. Gece boyunca oluşan close-to-open hareket hedefe dahil değildir. Bu ayrım yalnız matematiksel değil, işlem muhasebesini belirleyen temel tasarım seçimidir: bir portföy ertesi gün açılışta alınmalı ve aynı gün kapanışta tamamen kapatılmalıdır.
Walk-forward yapı veri sızıntısını nasıl sınırlandırıyor?
Her dış iterasyonda 105 gün eğitim, onu izleyen 21 gün doğrulama ve daha sonra tek bir test günü bulunmaktadır:
\[ \max T_k < \min V_k < t_k,\qquad |T_k|=105,\quad |V_k|=21 \]
Hiperparametre seçimi 105 günlük eğitim bloğunun içinde ayrıca kronolojik olarak yapılır: ilk 84 gün iç eğitim, son 21 gün iç tuning bloğudur. Hiperparametreler seçildikten sonra model 105 günlük dış eğitim bloğunda eğitilir; sonraki 21 günlük dış validation dönemi özellik gösterimini ve portföyde tutulacak hisse sayısı K'yı seçmek için kullanılır. Bu seçim tamamlandıktan sonra model önceki 126 gün üzerinde yeniden tahmin edilerek tek görülmemiş test gününe uygulanır. Pencere daha sonra bir işlem günü ileri kaydırılır.
Çalışmanın önemli sınırlılıklarından biri, 105 eğitim tarihinin 196 ham ve özellikle 392 combined girdiye göre kısa olmasıdır. Yazar, yapılmamış 252 veya 504 günlük yeniden tahminleri sonradan varmış gibi sunmamakta ve yüksek özellik/tarih oranını olası kararsızlık kaynağı olarak bırakmaktadır.
Dört XGBoost öğrenme amacı
Dört model aynı gradyan artırmalı ağaç altyapısını paylaşmakta, ancak öğrenilecek hata veya sıralama amacı bakımından ayrılmaktadır. Genel XGBoost amaç fonksiyonu:
\[ \mathcal{L}(\Theta)=\sum_{i=1}^{n}\ell(y_i,\hat{y}_i)+\sum_{m=1}^{M}\Omega(f_m) \]
şeklinde ifade edilmektedir. İlk toplam modelin tahmin/sıralama hatasını, ikinci toplam ise ağaç karmaşıklığını kontrol eden düzenlileştirmeyi temsil eder.
Pseudo-Huber regresyonu
Regresyon modelleri eğitilirken ondalık günlük getiriler 100 ile çarpılmış, tahminlerden sonra tekrar 100'e bölünmüştür. Bu nedenle \(\delta=1\), ondalık getiri birimi değil yaklaşık bir yüzde puanlık artık ölçeğine karşılık gelir. Kayıp:
\[ L_{\delta}(e)=\delta^2\left(\sqrt{1+\frac{e^2}{\delta^2}}-1\right),\qquad e=\hat{y}-y,\quad \delta=1 \]
biçimindedir. Küçük hatalarda yaklaşık karesel davranırken büyük artıkların etkisi giderek doğrusal büyümeye yaklaşır. Böylece aşırı büyük getiri hataları tamamen atılmadan etkileri sınırlandırılır.
Aşağı yönlü hata cezalı regresyon
İkinci regresyon modeli, gerçekte negatif getiri oluşurken modelin pozitif getiri tahmin ettiği yanlış-pozitif uzun pozisyon sinyallerini özel olarak daha ağır cezalandırır:
\[ L_D(y,\hat{y})=a(y,\hat{y})(\hat{y}-y)^2 \]
\[ a(y,\hat{y})=1+4\,\mathbf{1}\{y<0,\hat{y}>0\} \]
Koşul gerçekleşmediğinde ağırlık 1, gerçekleştiğinde 5 olur. Dolayısıyla amaç bütün negatif hataları değil, negatif gerçekleşme karşısında pozitif yön tahmin edilmiş durumları özellikle cezalandırmaktır.
Pairwise Ranking
Ranking modellerinde gerçekleşen ertesi gün getirileri her tarih içinde beş relevance sınıfına \(q\in\{0,1,2,3,4\}\) dönüştürülür. Pairwise yaklaşım, daha yüksek relevance derecesine sahip hissenin skorunun diğerinden yüksek olmasını öğrenmeye çalışır:
\[ L_{pair}=\sum_{q_i>q_j}\log\left(1+\exp(-(s_i-s_j))\right) \]
Bu model mutlak getiri büyüklüğünü tahmin ettiğini iddia etmez; hedef göreli sıralamadır.
NDCG-oriented Ranking
NDCG modeli de aynı ordinal sınıfları kullanarak eğitilir. Test değerlendirmesinde ise gerçekleşen getiriler tarih içindeki yüzde konumlarına dönüştürülür ve listenin üst sıralarına daha fazla ağırlık veren Normalized Discounted Cumulative Gain metriği hesaplanır:
\[ \mathrm{NDCG}_t@K= \frac{\mathrm{DCG}_t(K)}{\mathrm{IDCG}_t(K)} = \frac{1}{\mathrm{IDCG}_t(K)} \sum_{j=1}^{K} \frac{2^{rel_{i,t+1}}-1}{\log_2(j+1)} \]
\(j\), model tarafından verilen sıralamadaki pozisyonu; \(rel\), o pozisyona yerleştirilen hissenin gerçekleşen relevance değerini; IDCG ise aynı günün ideal sıralamasını temsil eder. Logaritmik iskonto nedeniyle listenin ilk sıralarındaki hatalar daha önemlidir.
Hiperparametre ve portföy yapılandırması birbirinden ayrılıyor
Hiperparametre tuning'i doğrudan finansal getiriyle yapılmamaktadır. İç tuning skoru, [−1,1] aralığındaki Spearman bilgi katsayısını [0,1]'e taşıyan dönüşüm ile NDCG@10'un eşit ağırlıklı ortalamasıdır:
\[ TuneScore_{inner} = \frac{1}{2}\left(\frac{IC_{inner}+1}{2}\right) + \frac{1}{2}\mathrm{NDCG@10}_{inner} \]
Ayarlanan hiperparametreler arasında boosting iterasyonu, learning rate, maksimum ağaç derinliği, minimum child weight, minimum loss reduction, satır ve sütun örnekleme oranları ile L1/L2 düzenlileştirme yer almaktadır.
Daha sonraki portföy konfigürasyon aşamasında ise her model için üç özellik gösterimi ile dört portföy büyüklüğü birleştirilir:
\[ 3\;\text{gösterim}\times K\in\{5,10,20,30\}=12\;\text{aday} \]
Adaylar validation NDCG, eğitim-validation IC farkı ve validation Top-K getirisi olmak üzere üç bileşenden değerlendirilir. Her bileşen 0-1 aralığında göreli sıra skoruna dönüştürülür:
\[ RS_{high}(z_c)=\frac{\operatorname{rank}(z_c)-1}{C-1}, \qquad RS_{low}(z_c)=1-RS_{high}(z_c), \qquad C=12 \]
Kararlılık ölçüsü:
\[ GapIC_{c,t}= \left|IC^{train}_{c,t}-IC^{valid}_{c,t}\right| \]
ve buna bağlı skor:
\[ StabilityScore_{c,t}=RS_{low}(GapIC_{c,t}) \]
olarak tanımlanır. Daha küçük eğitim-validation farkı daha yüksek kararlılık skoru alır.
Açılışta alınıp kapanışta satılan portföyde günlük devir neden 2'dir?
Çünkü bu çalışmanın nihai işlem ufkunda tamamen yatırılmış portföyün bir birimlik sermayesi ertesi gün açılışta satın alınır ve aynı sermaye kapanışta tamamen satılır; bir birim alış ile bir birim satışın toplamı round-trip turnover = 2 verir. Aynı hisse ertesi gün yeniden seçilmiş olsa bile önceki günün pozisyonu kapanışta tasfiye edildiğinden iki gün arasındaki isim örtüşmesi gerçekleşen işlem miktarını azaltmaz. Bu nedenle eski portföyle yeni portföy arasındaki holding overlap'i işlem maliyetinin yerine kullanılamaz.
Kaynak, orijinal seçim kuralındaki geçiş-örtüşme tanısını da yeniden üretilebilirlik amacıyla göstermektedir:
\[ \tau_{c,t}=\sum_i\left|w^{c}_{i,t}-w_{i,t-1}\right| \]
Bu ifade seçilen isimlerin günler arasındaki sürekliliğini tanımlamak için yararlıdır; fakat revize çalışmada open-to-close stratejinin gerçek execution turnover'ı olarak kullanılmamaktadır.
Maliyetli validation getirisi genel olarak:
\[ R^{net,valid}_{c,t} = R^{gross,valid}_{c,t} - \lambda\tau_{c,t}, \qquad \lambda=0.0005 \]
biçimindedir. Nihai intraday muhasebede tam yatırım yapılan bütün adaylar aynı günde \(\tau=2\) round-trip maliyetine maruz kaldığından 5 baz puan/bacak toplam 10 baz puan/gün oluşturur. Ortak maliyet, aynı gün içindeki tam yatırılmış adayların göreli sırasını değiştirmediği için finance bileşeni pratikte validation Top-K getirisine göre sıralanır:
\[ FinanceScore_{c,t} = RS_{high}\left(R^{net,valid}_{c,t}\right) \]
Üç bileşen son olarak eşit ağırlıkla birleştirilir:
\[ AdaptiveScore_{c,t} = \frac{ MLScore_{c,t} + StabilityScore_{c,t} + FinanceScore_{c,t} }{3} \]
En yüksek AdaptiveScore'a sahip özellik gösterimi ve K değeri sonraki görülmemiş test günü için sabitlenir. Test gününün gerçekleşmiş getirisi seçim sırasında kullanılmaz.
Kaynak-faithful yöntem akışı: Günlük fiyat/hacim verisi → nokta-zamanlı uygunluk filtresi → 196 teknik değişken → raw/ranked/combined temsil → dört XGBoost amacı → kronolojik iç hiperparametre tuning'i → 21 günlük dış validation → 12 portföy adayı → AdaptiveScore → tek görülmemiş test günü → açılışta alım/kapanışta satış → işlem maliyeti, risk ve istatistiksel sağlamlık analizi.
Çalışmanın Yöntemi ve Bulguları
1. Sıralama performansı: eğitimdeki farklar testte büyük ölçüde kayboluyor
| Model | Training NDCG | Validation NDCG | Test NDCG | Train-Test farkı | Random null | Permütasyon p |
|---|---|---|---|---|---|---|
| Downside-Penalized | 0,642 | 0,532 | 0,504 | 0,138 | 0,454 | 0,0005 |
| Pseudo-Huber | 0,561 | 0,533 | 0,503 | 0,057 | 0,454 | 0,0005 |
| NDCG Ranking | 0,694 | 0,524 | 0,495 | 0,199 | 0,453 | 0,0005 |
| Pairwise Ranking | 0,773 | 0,535 | 0,501 | 0,272 | 0,454 | 0,0005 |
En yüksek eğitim NDCG'si 0,773 ile Pairwise Ranking'dedir; fakat testte bu üstünlük kaybolmakta ve değer 0,501'e inmektedir. Pseudo-Huber eğitimde yalnız 0,561 NDCG üretmesine rağmen 0,503 test değerine ulaştığı için en küçük eğitim-test boşluğuna sahiptir. Bu sonuç, eğitim uyumunun tek başına gelecekteki sıralama kalitesinin güvenilir göstergesi olmadığını açıkça göstermektedir.
Önemli nokta, dört modelin de test NDCG'sinin random-null ortalamasından yüksek olmasıdır. Fakat dört farklı öğrenme amacı test döneminde yaklaşık aynı dar aralığa yakınsamaktadır. Dolayısıyla öğrenme amacının eğitimde yarattığı büyük performans ayrışması dış-örnekte korunmamaktadır.
2. Özellik önemleri ve model kararlılığı
Aşağı yönlü hata cezalı modelin importance dağılımı büyük ölçüde oynaklık ve aşağı yönlü risk ailesinde yoğunlaşmıştır: bu aile toplam gain importance'ın %67,2'sini oluşturur. NDCG Ranking modelinde aynı ailenin payı %54,4'tür. Pairwise Ranking daha yaygın bir importance dağılımı gösterir; en büyük ailenin payı yalnız %28,8'dir.
Pseudo-Huber için özel bir yorum sınırı bulunmaktadır. Kaynak veri panelinde 14 piyasa-geneli değişken aynı tarih içinde bütün hisseler için sabittir. Dolayısıyla bu değişkenler o günün hisselerini doğrudan birbirinden ayıramaz. Buna rağmen seçilmiş dış-örnek yolunda bu 14 değişken Pseudo-Huber'ın Top-20 XGBoost gain importance'ının ortalama %38,1'ini oluşturmaktadır. Bu değer, “piyasa değişkenleri hisseleri doğrudan sıralıyor” anlamına gelmez; etkileri tarihler arası değişim veya hisse-düzeyi değişkenlerle etkileşimler üzerinden ortaya çıkabilir.
| Model | Top-10 Jaccard | Top-20 Jaccard | Importance cosine similarity | Top-1 predictor persistence |
|---|---|---|---|---|
| Downside-Penalized | 0,359 | 0,315 | 0,638 | 0,361 |
| Pseudo-Huber | 0,289 | 0,328 | 0,477 | 0,238 |
| NDCG Ranking | 0,185 | 0,196 | 0,360 | 0,083 |
| Pairwise Ranking | 0,068 | 0,099 | 0,182 | 0,027 |
Pairwise Ranking, eğitim NDCG'si en yüksek model olmasına rağmen özellik attribution'ında açık biçimde en düşük yerel kararlılığı göstermektedir. En yüksek importance'a sahip canonical predictor yalnız %2,7 oranında bir sonraki güne aynı şekilde taşınmaktadır. Downside-Penalized modelde bu oran %36,1'dir. Bu karşılaştırma, güçlü eğitim skorunun daha istikrarlı bir model yapısı anlamına gelmediğini göstermektedir.
3. Adaptif katman gerçekten istikrarlı mı?
Portföy seçim sistemi dört K değerinin ve üç özellik temsilinin tamamını test dönemi içinde kullanmıştır; hiçbir ortak yapı kalıcı biçimde baskın hale gelmemiştir. K = 5 bütün modellerde en sık seçilen portföy boyutudur ve ranked özellikler en sık seçilen temsil biçimidir; ancak iki tercih birlikte kalıcı tek bir konfigürasyona dönüşmemektedir.
Birleşik konfigürasyonun ardışık günlerde değişme oranı Pseudo-Huber için %73,4, Downside-Penalized için %72,6, NDCG Ranking için %76,3 ve Pairwise Ranking için %83,8'dir. Pairwise modelinde portföy büyüklüğü K dahi geçişlerin %63,9'unda değişmektedir. Seçilen aday ile ikinci aday arasındaki AdaptiveScore farkının medyanı bütün modeller için yalnız 0,0606'dır; tam skor eşitlikleri günlerin yaklaşık %15,2-%18,8'inde görülmektedir. Bu nedenle adaptif katman, güçlü biçimde ayrılmış günlük optimumlar bulan bir mekanizma olarak değil, birbirine yakın validation adayları arasında sık değişen bir seçim süreci olarak yorumlanmalıdır.
4. Adaptif Top-K portföylerin brüt performansı
| Model | Yıllık aritmetik getiri | Yıllık geometrik getiri | Yıllık oynaklık | Sharpe | Kümülatif getiri | Maks. düşüş |
|---|---|---|---|---|---|---|
| Downside-Penalized | %18,29 | %9,47 | %43,03 | 0,425 | %48,07 | −%62,09 |
| Pseudo-Huber | %12,60 | %4,51 | %40,46 | 0,311 | %21,10 | −%54,20 |
| NDCG Ranking | %12,33 | −%0,96 | %51,62 | 0,239 | −%4,08 | −%72,92 |
| Pairwise Ranking | −%10,91 | −%15,91 | %35,78 | −0,305 | −%52,85 | −%64,38 |
| Eşit ağırlıklı uygun hisse evreni | %6,93 | %5,11 | %19,82 | 0,350 | %24,11 | −%24,53 |
Brüt adaptif sonuçlarda en yüksek geometrik getiri %9,47 ile Downside-Penalized modelindedir; ancak yıllık oynaklığı %43,03 ve maksimum düşüşü %62,09'dur. Eşit ağırlıklı uygun hisse benchmark'ı %5,11 geometrik getiri üretirken yalnız %19,82 oynaklığa ve %24,53 maksimum düşüşe sahiptir. Dolayısıyla adaptif modeller daha yüksek risk üretmekte fakat istatistiksel olarak güvenilir ek getiri ortaya koymamaktadır.
NDCG modelindeki aritmetik-geometrik fark özellikle öğreticidir. Yıllık aritmetik ortalama getiri %12,33 iken geometrik getiri −%0,96'dır. Yüksek oynaklık nedeniyle günlük getirilerin ortalaması pozitif olduğu halde bileşik servet büyümesi negatife dönebilmektedir. Bu, finansal stratejilerde yalnız aritmetik yıllıklaştırılmış ortalamaya bakmanın neden yanıltıcı olabileceğini gösterir.
5. Top-1 yoğunlaşma tanısı
Kaynak, K = 5 sonuçlarının incelenmesinden sonra, model sıralamasının en uç üst bölümündeki davranışı anlamak amacıyla yalnız en yüksek skorlu hisseyi tutan Top-1 portföylerini ayrıca incelemiştir. Bu analiz önceden belirlenmiş doğrulama kuralı değildir; ex-post yoğunlaşma tanısıdır. Bu nedenle Pseudo-Huber Top-1'in güçlü brüt sayıları doğrulanmış yatırım stratejisi kanıtı olarak kullanılamaz.
| Model | Yıllık aritmetik getiri | Yıllık geometrik getiri | Yıllık oynaklık | Sharpe | Kümülatif getiri | Maks. düşüş |
|---|---|---|---|---|---|---|
| Pseudo-Huber | %71,24 | %34,91 | %89,51 | 0,796 | %266,45 | −%86,47 |
| NDCG Ranking | %43,03 | −%6,58 | %99,63 | 0,432 | −%25,56 | −%87,51 |
| Downside-Penalized | %48,68 | −%7,60 | %106,36 | 0,458 | −%29,03 | −%82,59 |
| Pairwise Ranking | %22,76 | −%8,61 | %78,96 | 0,288 | −%32,32 | −%65,95 |
Pseudo-Huber Top-1 ilk bakışta olağanüstü güçlü görünmektedir. Fakat aynı portföyün yıllık oynaklığı yaklaşık %90, maksimum düşüşü yaklaşık %86,5'tir ve brüt günlük ortalama getiri için Newey-West t istatistiği 1,615, p değeri 0,106'dır. Yani brüt CAGR'ın büyüklüğü tek başına sıfırdan güvenilir biçimde farklı bir ortalama getiri kanıtlamamaktadır.
Daha da önemlisi performans zamana eşit dağılmamıştır. Pseudo-Huber Top-1'in brüt CAGR'ı 2022'de %646,8 ve 2023'te %75,9 iken 2024'te −%19,4, 2025'te −%7,7 ve 2026'nın incelenen bölümünde −%61,0'dır. Test döneminin ilk yarısında CAGR %154,9, ikinci yarısında ise −%28,9'dur. Böyle bir zaman profili, tam dönem CAGR'ının kalıcı beklenen getiri sürecini temsil ettiği varsayımını ciddi biçimde sınırlar.
6. İşlem maliyetleri sonucu nasıl değiştiriyor?
Strateji her yatırım gününde pozisyonları açılışta kurup kapanışta tamamen kapattığı için işlem maliyetinin temel belirleyicisi günler arası portföy örtüşmesi değil tam round-trip işlemidir. 5 baz puanlık tek yön maliyet, tam yatırım yapılan günde toplam 10 baz puan maliyet demektir.
| Model | Strateji | Günlük turnover | Brüt CAGR | Net CAGR | Net NW t | Net p |
|---|---|---|---|---|---|---|
| Downside-Penalized | Adaptive | 2,00 | %9,47 | −%14,92 | −0,36 | 0,723 |
| Downside-Penalized | Top-1 | 2,00 | −%7,60 | −%28,24 | 0,46 | 0,645 |
| Pseudo-Huber | Adaptive | 2,00 | %4,51 | −%18,78 | −0,70 | 0,482 |
| Pseudo-Huber | Top-1 | 2,00 | %34,91 | %4,83 | 1,04 | 0,297 |
| NDCG Ranking | Adaptive | 2,00 | −%0,96 | −%23,04 | −0,56 | 0,579 |
| NDCG Ranking | Top-1 | 2,00 | −%6,58 | −%27,44 | 0,38 | 0,702 |
| Pairwise Ranking | Adaptive | 2,00 | −%15,91 | −%34,67 | −2,22 | 0,026 |
| Pairwise Ranking | Top-1 | 2,00 | −%8,61 | −%29,00 | −0,06 | 0,949 |
Pseudo-Huber Top-1'in %34,91'lik brüt CAGR'ı, yalnız 5 baz puanlık tek yön maliyet altında %4,83'e inmektedir. Kaynak ayrıca bu net patikada maksimum düşüşün yaklaşık %92,8'e kadar çıktığını bildirmektedir. Boşta kalan paranın günlük risksiz getiri kazandığı RF-cash muhasebesinde toplam net CAGR %9,3'e yükselir; fakat excess-return Sharpe 0,514 ve Newey-West p = 0,297 olarak kalır. Bunun nedeni risksiz faiz gelirinin aşırı getiri hesaplanırken tekrar çıkarılmasıdır.
Sıralama bilgisinin istatistiksel olarak saptanması neden yatırım yapılabilir anormal getiri anlamına gelmez?
Çünkü bir modelin hisseleri rastgele sıralamadan biraz daha iyi sıralaması, bu bilgiye ulaşmak için gereken günlük işlemlerin maliyetinden, portföy oynaklığından, büyük drawdown'lardan, piyasa riskiyle ortak hareketten, zaman içi performans kırılmalarından ve çok sayıda strateji denemesinin yarattığı multiplicity sorunundan daha büyük bir ekonomik avantaj sağladığını garanti etmez. Bu çalışmada sıralama null hipotezi açık biçimde aşılırken, işlem maliyeti sonrası getiri, matched-horizon alfa, Hansen SPA, Deflated Sharpe Ratio ve bootstrap belirsizliği birlikte değerlendirildiğinde dayanıklı pozitif anormal getiri kanıtı oluşmamaktadır.
7. Risk düzeltmesi ve çoklu testler
Pseudo-Huber Top-1 için SPY'nin aynı open-to-close ufkuyla yapılan regresyonda brüt yıllıklaştırılmış alfa %58,5'tir ancak p = 0,171'dir. 5 baz puan/bacak maliyetten sonra net yıllıklaştırılmış alfa %33,3'e düşer ve p = 0,436'dır. Alfa nokta tahmininin büyük görünmesi, güven aralığının ve istatistiksel belirsizliğin göz ardı edilebileceği anlamına gelmez.
Kaynak ayrıca close-to-close CAPM, Fama-French 3 faktör ve Fama-French 5 faktör regresyonlarını supplementary materyalde raporlamakta, fakat bu modellerin stratejinin tutmadığı gece getirisini de içeren farklı bir ufka sahip olduğunu açıkça belirtmektedir. Bu nedenle çalışmanın birincil risk-düzeltilmiş kanıtı matched open-to-close SPY regresyonudur.
| Kontrol | Sonuç | Yorum |
|---|---|---|
| Brüt Newey-West | t = 1,615; p = 0,106 | Brüt ortalama getiri geleneksel anlamlılık düzeyinde sıfırdan ayrılmıyor |
| 5 bps net Newey-West | t = 1,044; p = 0,297 | Maliyet sonrası kanıt daha da zayıf |
| Net SPY open-to-close alfa | %33,3 yıllık; p = 0,436 | Nokta tahmini yüksek, istatistiksel olarak anlamlı değil |
| Hansen SPA | p = 0,207 | Senkronize 12 strateji ailesinde üstünlük doğrulanmıyor |
| White-style reality check, brüt | p = 0,182 | Multiplicity sonrası güçlü bulgu yok |
| White-style reality check, 5 bps net | p = 0,450 | Net performans için daha da zayıf kanıt |
| Deflated Sharpe Ratio olasılığı | 0,462 | Test edilen strateji ailesi dikkate alındığında ikna edici üstünlük sağlamıyor |
| Stationary-bootstrap net CAGR %95 aralığı | −%58,1 ile +%147,5 | Bileşik performans tahminindeki belirsizlik çok geniş |
Newey-West testlerinin CAGR'ı değil günlük aritmetik ortalama getiriyi sınadığı özellikle önemlidir. Yüksek oynaklık nedeniyle pozitif günlük ortalama ile negatif bileşik servet büyümesi aynı anda görülebilir. Bu nedenle kaynak, CAGR ve terminal wealth belirsizliğini ayrıca stationary bootstrap ile değerlendirmektedir.
Appendix'teki Newey-West lag duyarlılığı da Pseudo-Huber Top-1'in sonucunu değiştirmemektedir: 1, 5, 10 ve 21 gecikme seçimlerinde t istatistiği yaklaşık 1,03-1,12 arasında, p değeri ise yaklaşık 0,305-0,261 arasında kalmaktadır.
8. Likidite ile turnover aynı şey değildir
Çalışma, sık alım-satım yapılması ile işlemin piyasa hacmine göre büyük olmasını iki ayrı sürtünme olarak değerlendirir. 50.000 USD toplam sermaye varsayımında Pseudo-Huber Top-1 tarafından seçilen hisselerin medyan ADV20 değeri yaklaşık 48,59 milyon USD'dir; seçilmiş hisse-günlerinin %88,0'ında ADV20 10 milyon USD'nin, %49,4'ünde 50 milyon USD'nin üzerindedir.
Pseudo-Huber Top-1'de tek yönlü işlemin medyan büyüklüğü yalnız ADV20'nin %0,103'üdür. 95. yüzdelik %0,899, 99. yüzdelik %1,723 ve maksimum gözlenen değer %2,138'dir; işlem bacaklarının %95,8'i ADV20'nin %1'inin altında kalmıştır. Adaptif Top-K portföylerinde medyan katılım bütün modeller için %0,008'in altındadır ve çalışmadaki 50.000 USD ölçeğinde bütün adaptif tek-yön işlem bacakları %1 ADV20 sınırının altında kalmaktadır.
Bu bulgu, “strateji ucuz uygulanabilir” demek değildir. ADV20 oranı alış-satış spread'ini, market-on-open slippage'ı, fiyat etkisini veya order-size kaynaklı execution maliyetini ölçmemektedir. Çalışmanın sonucu yalnızca 50.000 USD gibi perakende ölçeğinde gerekli nominal işlemin çoğu zaman gözlenen piyasa hacmine göre küçük olduğunu göstermektedir. Bu sonuç daha büyük sermayeye veya kurumsal kapasiteye genellenemez.
9. Likidite kapıları da kararlı bir üstünlük oluşturmuyor
Kaynak, minimum ADV20 eşiğini 10, 25, 50 ve 100 milyon USD olarak değiştirerek Top-1 sonuçlarını yeniden değerlendirmektedir. Pseudo-Huber Top-1 için RF-cash CAGR sırasıyla yaklaşık %2,4, %10,9, −%16,4 ve −%8,3'tür; ilgili p değerlerinin hiçbiri pozitif anlamlılık göstermemektedir. Ara eşiklerdeki daha iyi nokta tahminleri, stratejinin daha az sayıda güne yatırım yapmasından ve hangi günlerin yatırım yapılabilir kaldığından etkilenmektedir. Çalışma bu eşikleri optimize edilmiş yeni stratejiler olarak değil, duyarlılık tanıları olarak ele almaktadır.
10. Çalışmanın desteklediği ve desteklemediği sonuçlar
Çalışmanın desteklediği sonuçlar:
- Dört XGBoost modelinin de dış-örnek sıralaması kullanılan NDCG tanımı altında random ranking null dağılımının üzerinde kalmaktadır.
- Bu sıralama avantajının büyüklüğü mütevazıdır ve eğitimdeki büyük model farkları testte daralmaktadır.
- Ranking modelleri, özellikle Pairwise Ranking, feature importance ve konfigürasyon bakımından regresyon modellerine göre daha kararsızdır.
- Pseudo-Huber Top-1 çok büyük bir brüt CAGR üretmiştir, ancak sonuç yüksek oynaklık, aşırı drawdown, dönem bağımlılığı ve kuyruk olaylarına duyarlılıkla birlikte ortaya çıkmıştır.
- Günlük tam round-trip işlem maliyeti, pozitif görünen brüt performansı belirgin biçimde azaltmaktadır.
- 50.000 USD ölçeğinde piyasa katılımı çoğunlukla küçüktür; buna rağmen sık işlem nedeniyle toplam execution maliyeti sorunu devam etmektedir.
Çalışmanın desteklemediği sonuçlar:
- Pseudo-Huber Top-1'in doğrulanmış veya önerilen bir yatırım stratejisi olduğu iddiası desteklenmemektedir.
- Yaklaşık 0,50 NDCG'nin tek başına ekonomik olarak kullanılabilir alfa anlamına geldiği gösterilmemektedir.
- 5 baz puan/bacak maliyetin gerçek piyasadaki evrensel veya kesin işlem maliyeti olduğu iddia edilmemektedir.
- 50.000 USD için düşük ADV20 katılımı kurumsal sermaye kapasitesi kanıtlamamaktadır.
- Kaynak evreni survivorship ve delisting selection sorunlarından arındırılmış tam tarihsel Nasdaq evreni değildir.
- Çalışma short-side veya long-short performansı sınamamaktadır; günlük sıralamanın alt kuyruğu tam olarak saklanmamıştır.
- Feature importance değerleri teknik göstergelerin nedensel ekonomik etkilerini kanıtlamamaktadır.
11. Temel sınırlılıklar
Birinci sınırlılık, kaynak evreninin 2026'da derlenmiş listeye bağlı olmasıdır. Tarihsel olarak listeden çıkmış şirketlerin eksik olması survivorship ve delisting selection etkisi yaratabilir. İkinci sınırlılık, 105 günlük eğitim penceresinin 196 veya 392 girdiye göre kısa olmasıdır. Üçüncü sınırlılık, kesin tarihsel yazılım paket sürümlerinin saklanmamış olmasıdır.
Dördüncü sınırlılık execution modelidir. 5 baz puan/bacak senaryosu işlem maliyeti duyarlılığı için kullanışlı bir alt referans sağlar fakat spread, market-on-open slippage, piyasa etkisi ve emir büyüklüğü doğrudan gözlenmemiştir. Beşinci sınırlılık, Top-1 analizinin ex-post olmasıdır. Altıncı sınırlılık, ana tasarımın yalnız long-only Top-K seçimlerini saklamış olması ve alt sıralardaki tam günlük skor vektörünün bulunmamasıdır.
Son olarak, 14 piyasa-geneli değişken aynı tarih içinde bütün hisseler için sabittir. Bunları modelden çıkarmak veya hedefi gün içindeki kesite göre yeniden merkezlemek mevcut sonuçların basit sağlamlık kontrolü değil, yeniden tahmin edilmesi gereken yeni bir deney tasarımı olacaktır. Kaynak bu ayrımı açıkça korumaktadır.
12. Araştırmanın bilimsel anlamı
Çalışmanın en değerli sonucu, finansal makine öğrenmesinde performansın tek bir model metriğine indirgenmemesi gerektiğini göstermesidir. Dış-örnek NDCG, feature attribution kararlılığı, portföy bileşik serveti, maksimum düşüş, işlem turnover'ı, maliyet duyarlılığı, matched-horizon risk düzeltmesi, zaman alt dönemleri ve multiplicity kontrolleri farklı soruları yanıtlamaktadır.
Bu ayrım özellikle kısa ufuklu modellerde önemlidir. Küçük bir kesitsel sıralama avantajı istatistiksel olarak gerçek olabilir; fakat aynı avantajı paraya çevirmek için her gün bütün pozisyonların açılıp kapanması gerekiyorsa, tahmin sinyalinin ekonomik değeri işlem protokolünün maliyetini ve riskini aşmak zorundadır. Bu çalışmada söz konusu ikinci eşik güvenilir biçimde geçilememektedir.
Kaynak ve Yöntem Notu
Özgün başlık: Do Daily Adaptive Machine Learning Stock Rankings Survive Trading Costs? Evidence from Cross-Sectional Technical Signals
Yazar: Ferdinantos Kottas
Afiliasyonlar: School of Business, National University of Ireland Maynooth, Maynooth, Ireland; School of Engineering, Civil Engineering, Democritus University of Thrace, Xanthi, Greece; Department of Computer Science, Aristotle University of Thessaloniki, Thessaloniki, Greece.
Dergi: Economies
Yayınevi: MDPI
Bibliyografik kayıt: Economies, 2026, 14(9), Article 393
DOI: 10.3390/economies14090393
Resmî yayın bağlantısı: https://doi.org/10.3390/economies14090393
Yayın süreci: Received 14 Ağustos 2026; revised 31 Ağustos 2026; accepted 1 Eylül 2026; published 5 Eylül 2026.
Kaynak türü ve durum: Hakemli dergide yayımlanmış açık erişim araştırma makalesi; yayıncı kaydında Version of Record.
Lisans: Creative Commons Attribution, CC BY 4.0.
Temel yöntem: Dinamik Nasdaq kaynak evreni üzerinde 196 teknik predictor, raw/ranked/combined özellik temsilleri, dört XGBoost objective, kronolojik walk-forward eğitim-doğrulama-test yapısı, adaptif Top-K portföy seçimi, işlem maliyeti ve piyasa katılımı analizi, Newey-West çıkarımı, matched-horizon SPY risk düzeltmesi, stationary bootstrap ve multiplicity kontrolleri.
Finansman: Çalışma dış finansman almamıştır.
Etik kurul: İnsan katılımcısı veya kişisel veri kullanılmadığından uygulanabilir değildir.
Veri erişilebilirliği: Fiyat ve hacim verileri Yahoo Finance üzerinden yfinance arayüzüyle elde edilmiştir. Ampirik sonuçları üreten kod yazardan makul talep üzerine temin edilebilmektedir; tam yeniden üretilebilir kod tabanının gelecekte GitHub üzerinden yayımlanacağı belirtilmiştir. Çalıştırma ortamı Python 3, Google Colab ve G4 High-RAM olarak raporlanmıştır.
Supplementary materyal: Tam teknik gösterge kataloğu, XGBoost hiperparametre ve reproducibility ayrıntıları, ana model-strateji yollarındaki en büyük günlük getiriler ile CAPM/Fama-French sağlamlık tabloları sağlanmaktadır.
Çıkar çatışması: Yazar çıkar çatışması olmadığını beyan etmektedir.
Yazar katkıları: Kaynak PDF'de ayrı bir CRediT/yazar katkıları bölümü raporlanmamıştır. Tek yazar bulunmaktadır.
Temel yorum sınırı: Bu çalışma yatırım tavsiyesi veya doğrulanmış alım-satım algoritması sunmamaktadır. Özellikle Top-1 sonucu ex-post yoğunlaşma tanısıdır. Bulgular 2026-vintage kaynak evrenine, incelenen tarih aralığına, open-to-close işlem ufkuna ve kullanılan maliyet duyarlılık varsayımlarına bağlıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir