


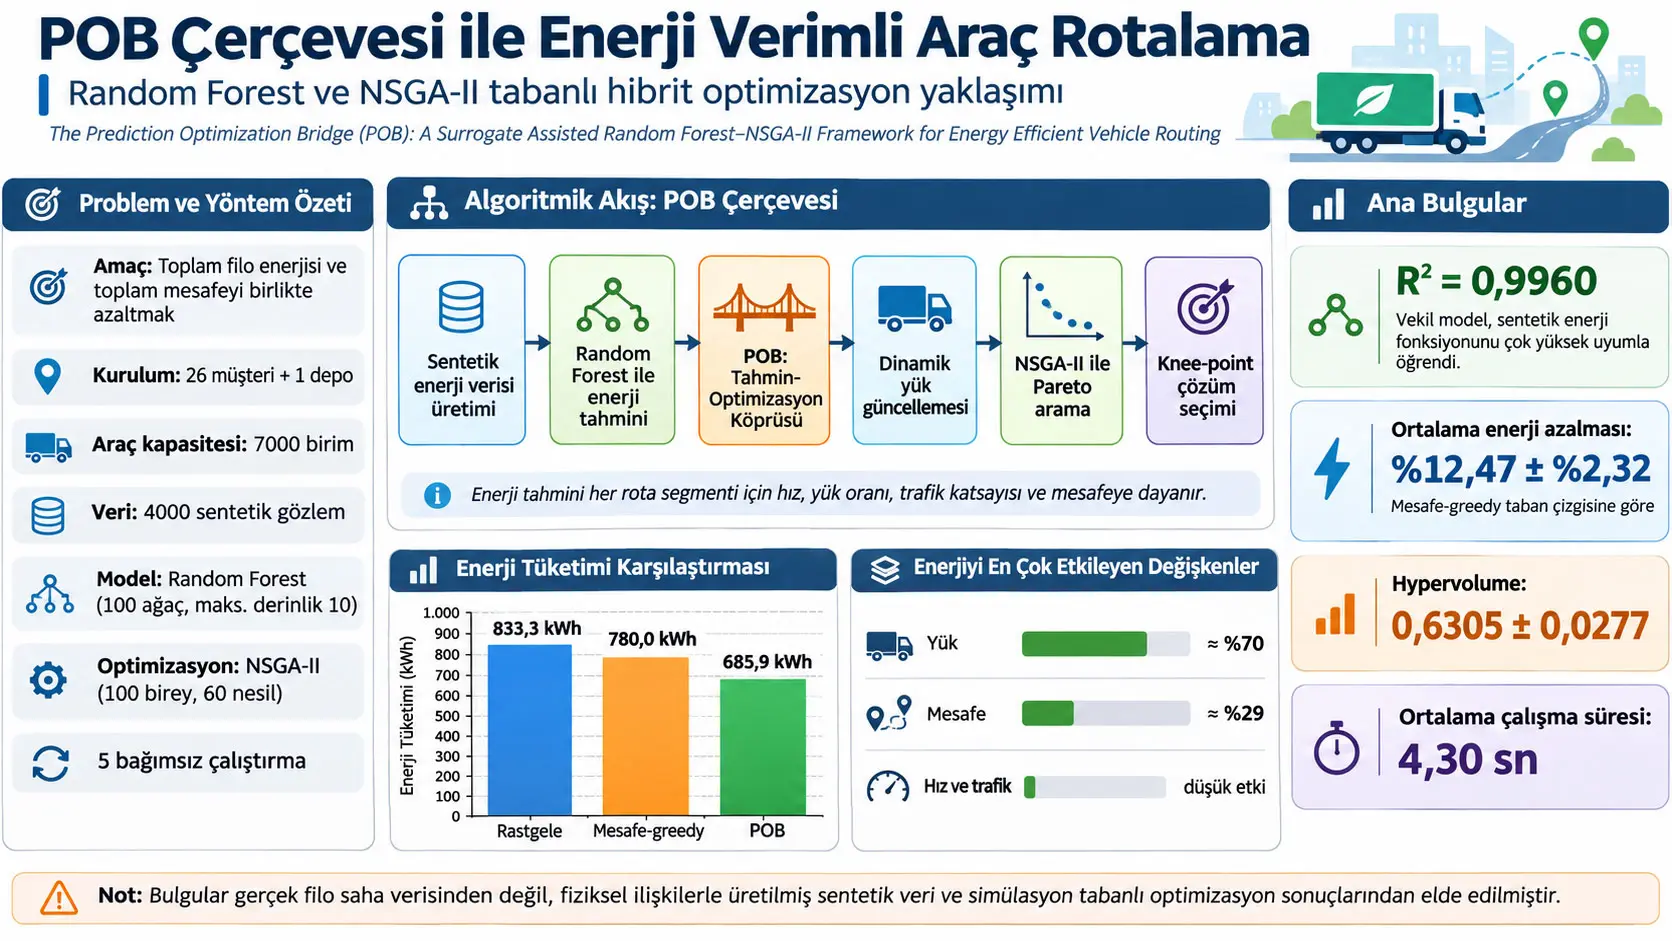
Tahmin-Optimizasyon Köprüsü (Prediction–Optimization Bridge, POB), araç rotalarının enerji tüketimini önce Random Forest (RF) adlı bir vekil makine öğrenmesi modeliyle tahmin eden ve bu enerji tahminlerini Baskın Olmayan Sıralamalı Genetik Algoritma II'ye (Non-dominated Sorting Genetic Algorithm II, NSGA-II) aktararak toplam filo enerjisi ile toplam seyahat mesafesini birlikte azaltmaya çalışan hibrit bir optimizasyon çerçevesidir. Çalışmada 26 müşteri ve bir depodan oluşan sentetik bir araç rotalama örneği kullanılmış; RF modeli fiziksel ilişkilerden esinlenen bir enerji fonksiyonuyla oluşturulan 4000 sentetik gözlem üzerinde eğitilmiş, ardından NSGA-II ile 100 bireylik popülasyon 60 nesil boyunca optimize edilmiştir.
Random Forest vekil modelinin kaynak enerji fonksiyonunu yeniden üretme başarısı \(R^2=0{,}9960\) olarak raporlanmıştır. Beş bağımsız optimizasyon çalıştırmasında, kaynağın “distance-greedy” veya “Industry Standard Greedy” olarak adlandırdığı mesafe öncelikli sezgisel rotalama yaklaşımına kıyasla ortalama enerji azalması %12,47 ± %2,32 bulunmuştur. Normalize edilmiş Hypervolume değeri 0,6305 ± 0,0277, Spacing değeri ise 109,32 ± 46,20 olarak raporlanmıştır.
Seçilen örnek knee-point çözümünde enerji tüketimi 685,9 kWh iken aynı örnekte mesafe-greedy yaklaşımı 780,0 kWh, rastgele rotalama ise 833,3 kWh enerji tüketmiştir. Bu seçili çözüm mesafe-greedy yönteme göre yaklaşık %12,1, rastgele rotalamaya göre yaklaşık %17,7 daha düşük enerji tüketmektedir. Beş bağımsız çalıştırmanın ortalaması olan %12,47 ± %2,32 değeri ise tek bir seçili çözümün %12,1 değerinden ayrı tutulmalıdır.
Çalışmanın en önemli yöntemsel sınırı, enerji modelinin gerçek kamyon, van veya elektrikli araç telemetrisinden öğrenilmemiş olmasıdır. Eğitim verileri çalışmanın tanımladığı sentetik enerji fonksiyonuyla üretilmiştir. Bu nedenle \(R^2=0{,}9960\), RF'nin gerçek dünyadaki araç enerji tüketimini %99,6 doğrulukla tahmin ettiğini değil, kaynak çalışmanın kendi sentetik enerji yüzeyini çok yüksek uyumla yaklaşıklaştırdığını gösterir. Benzer biçimde %12,47 ortalama enerji azalması, gerçek bir kentsel filoda doğrulanmış saha tasarrufu değil, bu sentetik optimizasyon ortamının sonucudur.
Araştırmanın çözmeye çalıştığı problem
Klasik Araç Rotalama Problemi (Vehicle Routing Problem, VRP), bir araç veya araç filosunun müşterilere hangi sırayla hizmet vereceğini ve hangi rotaları kullanacağını belirlemeye çalışan kombinatoryal optimizasyon problemidir. Geleneksel VRP uygulamalarında ana hedef sıklıkla toplam mesafeyi veya taşıma maliyetini azaltmaktır. Enerji Verimli Araç Rotalama Problemi (Energy-Efficient Vehicle Routing Problem, EE-VRP) ise yalnız mesafeye değil enerji tüketimine etki eden yük, hız, trafik ve diğer operasyonel faktörlere de odaklanır.
Çalışmanın hareket noktası, en kısa rotanın her zaman en düşük enerjiyi tüketmeyebileceğidir. Bir teslimat aracının taşıdığı kütle rota boyunca sabit değildir. Araç yüksek miktarda yük taşıdığı ilk bölümlerde aynı mesafeyi katetmek için, daha fazla teslimat yaptıktan sonraki daha hafif durumuna göre farklı enerji tüketebilir. Dolayısıyla müşteri ziyaret sırası, yalnız geometrik mesafeyi değil aracın yol boyunca taşıdığı yükün nasıl azaldığını da belirler.
Yazarlar bu problemi iki hesaplama katmanına ayırmaktadır. İlk katman, her yol kesiminin enerji tüketimini hızlı biçimde tahmin eden Random Forest vekil modelidir. İkinci katman ise binlerce olası müşteri sıralaması arasında enerji-mesafe dengesi arayan NSGA-II optimizasyonudur.
Literatür bağlamında yöntem sınıfları
| Yöntem sınıfı | Temel mantık | Çalışmayla ilişkisi |
|---|---|---|
| Kesin yöntemler | Çözüm uzayını sistematik biçimde araştırarak matematiksel olarak optimum çözümü bulmayı amaçlar. | Branch and Bound, Branch and Cut, dinamik programlama, sütun üretimi ve Lagrange gevşetmesi örnekleri kaynakta tartışılır. |
| Sezgisel yöntemler | Makûl sürede iyi veya yaklaşık çözüm üretmeye çalışır; optimumluk garantisi zorunlu değildir. | Çalışmanın karşılaştırma taban çizgisi olan distance-greedy yaklaşımı bu genel mantığa yakındır. |
| Meta-sezgisel yöntemler | Büyük ve karmaşık çözüm uzaylarında keşif ve sömürü arasında denge kurarak yüksek kaliteli çözümler arar. | NSGA-II bu çalışmanın çok amaçlı optimizasyon motorudur. |
| Hibrit yöntemler | İki veya daha fazla algoritmik tekniği birleştirerek tek bir yöntemin sınırlılıklarını azaltmaya çalışır. | POB, Random Forest vekil tahmini ile NSGA-II'yi birleştiren hibrit yaklaşımdır. |
Prediction–Optimization Bridge (POB) Nedir?
Prediction–Optimization Bridge (POB), Random Forest tarafından tahmin edilen segment düzeyindeki enerji değerlerini doğrudan NSGA-II'nin uygunluk değerlendirmesine bağlayan ve böylece rota adaylarını hem enerji tüketimi hem toplam mesafe açısından değerlendiren hibrit tahmin-optimizasyon katmanıdır.
Çalışmanın dört aşamalı yöntemi
Kaynak yöntem şeması dört temel aşama tanımlar. İlk aşamada fiziksel ilişkilerden esinlenen sentetik enerji verisi oluşturulur ve Random Forest eğitilir. İkinci aşamada müşteri permütasyonları kapasiteye uygun araç rotalarına dönüştürülür ve dinamik araç yükü hesaplanır. Üçüncü aşamada NSGA-II rota adaylarını enerji ve mesafe açısından evrimleştirir. Dördüncü aşamada Pareto cephesi, Hypervolume, Spacing, enerji tasarrufu, çalışma süresi ve karşılaştırmalı rotalar değerlendirilir.
Problem hangi matematiksel uzayda kuruluyor?
Problem tam yönlü bir grafik olarak tanımlanır:
\[ G=(V,A), \]
burada \(V=\{0,1,\ldots,N\}\) düğüm kümesi, \(A=\{(i,j):i,j\in V,\ i\neq j\}\) kullanılabilir yönlü bağlantıları temsil eder. Düğüm \(0\) merkezi depodur; \(C=\{1,\ldots,N\}\) müşteri kümesidir ve çalışmada \(N=26\)'dır.
| Sembol | Kaynak tanımı |
|---|---|
| \(N\) | Dağıtım müşterisi sayısı: 26 |
| \(Q\) | Maksimum araç yük kapasitesi: 7000 birim |
| \(q_i\) | Müşteri \(i\)'nin statik talebi; \(q_i\in[500,2500]\subset\mathbb{Z}^{+}\) |
| \(c_i^x,c_i^y\) | Düğüm koordinatları; \([-300,300]\) aralığındaki ayrık tamsayı ızgarası |
| \(K\) | Rota bölücü tarafından dinamik olarak belirlenen filo büyüklüğü |
| \(d_{ij}\) | \(i\) ve \(j\) düğümleri arasındaki Öklid uzaklığı |
Denklem (1): Kromozom gösterimi
\[ \pi=(\pi_1,\pi_2,\ldots,\pi_N) \tag{1} \]
\(\pi\), müşterilerin ziyaret sırasını belirleyen permütasyon tabanlı kromozomdur. Her \(\pi_i\) bir müşteri indeksidir. Depo kromozoma dahil edilmez; rota değerlendirilirken başlangıç ve bitiş noktası olarak ayrıca eklenir. Bu gösterim, genetik algoritmanın doğrudan “müşteri sırası” üzerinde çalışmasını sağlar.
Denklem (2): İki amaçlı optimizasyon
\[ \min F(\pi)= \begin{bmatrix} F_1(\pi),F_2(\pi) \end{bmatrix}^{T} \tag{2} \]
Çalışmanın matematiksel bölümünde \(F_1\) toplam filo enerji tüketimi, \(F_2\) toplam seyahat mesafesidir. Tek bir “en iyi” sayı yerine iki hedef aynı anda azaltılmaya çalışılır. Hedefler çatışabildiği için sonuç tek çözüm değil, bir Pareto çözüm kümesi olabilir.
Denklem (3): Toplam filo enerjisi
\[ F_1(\pi) = \sum_{e=1}^{E}\Psi(X_e) \tag{3} \]
\(E\), kromozom rota kümelerine dönüştürüldükten sonra ortaya çıkan toplam yol segmenti sayısıdır. \(X_e=[v_e,L_e,T_e,d_e]\) segment \(e\)'nin özellik vektörüdür. \(\Psi\), Random Forest vekil tahmincisidir. Her segment için tahmin edilen enerji toplanarak bütün filonun enerji amacı elde edilir.
Denklem (4): Segment hızı
\[ v_e=\max(25,\ 80-0.3d_e) \tag{4} \]
Hız, segment mesafesine bağlı deterministik bir ilişkiyle oluşturulur. \(d_e\) büyüdükçe \(80-0.3d_e\) terimi azalır; ancak \(\max\) işlemi hızın 25'in altına düşmesini engeller. Kaynak matematiksel tabloda koordinatların ve bu hız bağıntısının fiziksel birimlerini ayrıca tanımlamamaktadır. Bu nedenle bu bağıntıyı gerçek bir şehirde geçerli kalibre edilmiş hız-mesafe yasası olarak değil, sentetik modelin operasyonel kuralı olarak okumak gerekir.
Denklem (5): Dinamik yük oranı
\[ L_e=\frac{w_e}{Q} \tag{5} \]
\(w_e\), araç segment \(e\)'yi geçerken üzerinde kalan yük; \(Q=7000\) ise kapasitedir. \(L_e\) boyutsuz bir yük oranıdır. Araç teslimat yaptıkça \(w_e\) azalır ve sonraki segmentlerin enerji girdisi değişir. Çalışmanın özgün yönlerinden biri, bütün rota boyunca sabit yük varsaymak yerine bu değeri her teslimattan sonra güncellemesidir.
Denklem (6): Trafik katsayısı
\[ T_e=1.2 \tag{6} \]
Kaynak rota değerlendirmesinde trafik koşulunu sabit \(1.2\) ölçekleme katsayısıyla temsil eder. Bu nedenle optimizasyon sırasında trafik dinamik, zamanla değişen veya gerçek zamanlı ölçülen bir değişken değildir.
Denklem (7)–(9): Toplam mesafenin hesaplanması
\[ F_2(\pi)=\sum_{k=1}^{K}D(r_k) \tag{7} \]
\[ D(r_k)=\sum_{(i,j)\in r_k}d_{ij} \tag{8} \]
\[ d_{ij} = \sqrt{(c_i^x-c_j^x)^2+(c_i^y-c_j^y)^2} \tag{9} \]
Denklem (7), bütün araç rotalarının mesafelerini toplar. Denklem (8), tek bir aracın rotasındaki ardışık bağlantıların mesafelerini toplar. Denklem (9) ise iki düğüm arasındaki Öklid uzaklığını koordinatlardan hesaplar. Dolayısıyla mesafe amacı üç seviyeli bir hesaplama zinciridir: düğümler arası mesafe → rota mesafesi → filo toplam mesafesi.
Random Forest Vekil Modeli Bu Çalışmada Neyi Öğreniyor?
Random Forest vekil modeli, gerçek araçlardan ölçülmüş enerji verisini değil, hız, dinamik yük oranı, trafik katsayısı ve mesafeyi kullanan kaynak Denklem (10)'daki sentetik enerji fonksiyonunun giriş-çıkış ilişkisini öğrenerek NSGA-II içinde hızlı enerji tahmini yapan bir yaklaşık model görevi görmektedir.
Denklem (10): Sentetik enerji hedef fonksiyonu
\[ y = 0.05v_e + 0.8L_ed_e + 0.003v_e^2L_e + 0.3T_e \tag{10} \]
Bu denklem 4000 sentetik eğitim gözleminin hedef değerlerini üretir. \(v_e\) hız, \(L_e\) yük oranı, \(d_e\) mesafe ve \(T_e\) trafik katsayısıdır.
İkinci terim \(0.8L_ed_e\), yük ile mesafenin birlikte büyümesinin enerji hedefini artırmasına izin verir. Üçüncü terim \(0.003v_e^2L_e\), hızın karesini yükle etkileştirerek doğrusal olmayan davranış oluşturur. Böylece Random Forest'ın öğreneceği yüzey yalnız basit bir mesafe fonksiyonu değildir.
Ancak kaynak, bu katsayıların belirli bir kamyon, motor, batarya, yakıt tüketim haritası veya ölçülmüş filo telemetrisiyle nasıl kalibre edildiğini raporlamamaktadır. Sonuç tablolarında enerji kWh olarak ifade edilse de Denklem (10)'daki katsayıların boyutsal kalibrasyonu ayrıca gösterilmemektedir. Bu nedenle denklem kaynak tarafından “physics-informed” olarak kullanılsa da gerçek bir araç enerji ölçüm modeliyle eşdeğer kabul edilmemelidir.
Denklem (11): Random Forest tahmini
\[ \Psi(X_{\text{edge}}) = \frac{1}{B} \sum_{b=1}^{B} T_b(X_{\text{edge}};\Theta_b) \tag{11} \]
\(B=100\) karar ağacı sayısıdır. \(T_b\), \(b\)'nci regresyon ağacının çıktısıdır; \(\Theta_b\) ağacın bölme parametrelerini, kullanılan özellikleri ve yaprak çıktılarını temsil eder. Random Forest tek bir ağacın tahminine güvenmez; 100 ağacın tahminlerini ortalayarak \(\Psi\) çıktısını oluşturur. Maksimum ağaç derinliği 10 olarak sınırlandırılmıştır.
Eğitim/test ayrımı
Kaynak Şekil 3'te 4000 sentetik gözlemin %80 eğitim ve %20 test olarak ayrıldığı gösterilmektedir. Ana metin modelin R² ve MAPE metrikleriyle değerlendirildiğini belirtmektedir. Bununla birlikte makalenin ana sonuçlarında R² değeri açıkça raporlanırken sayısal MAPE sonucu verilmemektedir; bu nedenle eksik MAPE değeri burada tahmin edilmemiştir.
Denklem (12): Müşteri benzersizliği
\[ \pi=(\pi_1,\pi_2,\ldots,\pi_N), \qquad \pi_i\neq\pi_j,\ \forall i\neq j \tag{12} \]
Her müşteri kromozomda tam bir kez bulunur. Bu yapı müşterinin atlanmasını veya aynı müşterinin kromozom içinde iki kez ziyaret edilmesini engeller.
Denklem (13): Depodan çıkış ve depoya dönüş
\[ Route_k=(0,i_1,i_2,\ldots,i_m,0) \tag{13} \]
Her araç rotası depo düğümü \(0\)'dan başlar, kendisine atanmış müşteri dizisini ziyaret eder ve yeniden depo \(0\)'a döner.
Denklem (14): Kapasite kısıtı
\[ \sum_{i\in r_k}q_i\leq Q, \qquad \forall k\in\{1,\ldots,K\} \tag{14} \]
Bir aracın rotasına atanan müşteri taleplerinin toplamı maksimum kapasite \(Q\)'yu aşamaz. Greedy rota bölücü müşterileri sırayla mevcut araca ekler; bir sonraki müşteri kapasiteyi aşacaksa mevcut rota kapatılır ve yeni araç rotası başlatılır.
Yük neden her teslimattan sonra yeniden hesaplanıyor?
Bir rota başlangıcında araç birden fazla müşterinin ürününü taşır. Her teslimattan sonra yük azalır. POB, kalan \(w_e\) yükünü güncellediği için aynı fiziksel mesafeye sahip iki farklı müşteri sıralaması farklı enerji maliyeti üretebilir. Bu mekanizma, çalışmanın mesafeyi tek başına optimize etmek yerine yük sıralamasını da önemli görmesinin temelidir.
Denklem (15): Cache'de olmayan bireylerin seçilmesi
\[ P_{\text{invalid}} = \{\pi\in P:\pi\notin \operatorname{dom}(\mathcal{H})\} \tag{15} \]
\(\mathcal{H}\) daha önce değerlendirilmiş kromozomların uygunluk değerlerini saklayan memoization sözlüğüdür. Eğer aynı kromozom tekrar ortaya çıkarsa enerji ve mesafe yeniden hesaplanmak yerine cache'deki sonuç kullanılabilir. \(P_{\text{invalid}}\), henüz cache'de bulunmayan ve gerçekten yeniden değerlendirilmesi gereken bireyleri seçer.
Denklem (16): Vektörleştirilmiş toplu RF tahmini
\[ Y_{\text{predictions}} = \Psi(M_{\text{batch}}) \in \mathbb{R}^{E_{\text{total}}} \tag{16} \]
Tüm yeni kromozomların rota segmentleri tek tek Python döngülerinde değerlendirilmek yerine \(M_{\text{batch}}\) adlı büyük özellik matrisinde birleştirilir. Random Forest bu matrise bir defada tahmin uygular. \(E_{\text{total}}\), o toplu değerlendirmedeki toplam segment sayısıdır.
Denklem (17): Enerji uygunluğunun tekrar kromozoma toplanması
\[ F_1(\pi) = \sum_{e=1}^{E} Y_{\text{predictions}}[e], \qquad \mathcal{H}(\pi) \leftarrow \bigl(F_1(\pi),F_2(\pi)\bigr) \tag{17} \]
Toplu RF çıktıları yeniden ilgili kromozomlara ayrılır; her rota adayının segment enerjileri toplanır ve elde edilen enerji-mesafe çifti cache'e kaydedilir. Vektörleştirme ve memoization, çalışmanın birkaç saniyelik çalışma sürelerine ulaşmasındaki iki temel hesaplama hızlandırma tekniğidir.
Pareto Cephesi ve Knee-Point Çözümü Nasıl Seçiliyor?
NSGA-II, enerji ile mesafeyi tek bir ağırlıklı puana zorla birleştirmek yerine hiçbir başka çözüm tarafından her iki amaçta birden yenilmeyen Pareto çözümlerini üretir; çalışma daha sonra normalize edilmiş amaç uzayında ideal noktaya Öklid uzaklığı en küçük olan Pareto çözümünü pratik uzlaşma veya knee-point çözümü olarak seçer.
Denklem (18): Pareto baskınlığı
\[ x_1 \lt x_2 \iff \left[ F_i(x_1)\leq F_i(x_2)\ \forall i\in\{1,2\} \right] \land \left[ \exists j\in\{1,2\}:F_j(x_1)<F_j(x_2) \right] \tag{18} \]
Bir çözüm diğerinden her iki amaçta da kötü değilse ve en az bir amaçta kesin biçimde daha iyiyse diğer çözümü baskılar. Hiçbir çözüm tarafından baskılanmayan bireyler ilk Pareto cephesine \(PF_1\) yerleştirilir.
Denklem (19): Crowding distance
\[ I_d(x_i) = \sum_{m=1}^{2} \frac{ F_m(x_{i+1})-F_m(x_{i-1}) }{ F_m^{\max}-F_m^{\min} } \tag{19} \]
Crowding distance, aynı Pareto cephesindeki bir çözümün komşularından ne kadar uzakta olduğunu ölçer. Daha yüksek değer, çözümün daha seyrek bir bölgede bulunduğunu gösterir. NSGA-II aynı kalite cephesindeki çözümler arasında daha yüksek crowding distance değerlerini tercih ederek bütün çözümlerin tek bir noktaya yığılmasını önlemeye çalışır.
Genetik operatörler
Ordered Crossover (OX) olasılığı \(p_c=0.8\)'dir. Bir ebeveynden ardışık müşteri bloğu alınır ve kalan müşteri kimlikleri ikinci ebeveynden sıraları korunarak tamamlanır. Böylece müşteri tekrarları oluşturmadan rota sırası aktarılabilir.
Shuffle Indexes Mutation olasılığı \(p_m=0.2\)'dir. Mutasyona giren kromozomda her genin başka bir rastgele genle yer değiştirme olasılığı %10'dur. Bu değişiklikler çözüm uzayında yeni müşteri sıralamalarının denenmesini sağlar.
Denklem (20): Amaçların normalize edilmesi
\[ f_1= \frac{F_1-400}{1200-400}, \qquad f_2= \frac{F_2-3000}{14000-3000} \tag{20} \]
Enerji ve mesafe farklı ölçeklerde olduğu için Hypervolume hesabından önce önceden belirlenmiş global alt ve üst sınırlar kullanılarak normalize edilir. Kaynak \(F_1\) için 400–1200, \(F_2\) için 3000–14000 sınırlarını kullanır.
Denklem (21): Hypervolume
\[ HV(PF) = \Lambda \left( \bigcup_{f\in PF} [f_1,1.1]\times[f_2,1.1] \right) \tag{21} \]
\(\Lambda\), Lebesgue ölçüsünü; \([1.1,1.1]^T\) ise sabit referans noktasını temsil eder. Hypervolume, Pareto cephesinin referans noktasına göre kapladığı/dominant olduğu amaç uzayı büyüklüğünü özetler. Aynı normalizasyon ve referans noktası altında daha yüksek HV, genel olarak daha iyi yakınsama ve kapsama işaret eder.
Denklem (22): Knee-point / uzlaşma çözümü
\[ \pi^* = \underset{\pi\in PF_1}{\arg\min} \sqrt{ f_1(\pi)^2+f_2(\pi)^2 } \tag{22} \]
Normalize edilmiş amaç uzayında ideal nokta \((0,0)\)'dır. Denklem her Pareto çözümünün bu noktaya Öklid uzaklığını hesaplar ve en yakın çözümü seçer. Böylece yalnız en düşük enerji veya yalnız en düşük mesafe yerine iki hedef arasında dengeli bir çözüm seçilmeye çalışılır.
Denklem (23): Beş bağımsız rastgele tohum
\[ \sigma_r=42+r, \qquad r\in\{0,1,2,3,4\} \tag{23} \]
Beş çalıştırma 42, 43, 44, 45 ve 46 rastgele tohumlarıyla başlatılır. Bunun amacı stokastik NSGA-II sonuçlarının tek bir rastgele başlangıca bağımlı olup olmadığını incelemektir.
Denklem (24): Spacing metriği
\[ S = \sqrt{ \frac{1}{|PF_1|-1} \sum_{i=1}^{|PF_1|-1} (\bar d-d_i)^2 } \tag{24} \]
\(d_i\), amaç uzayındaki ardışık Pareto noktaları arasındaki Öklid uzaklığı; \(\bar d\) bu uzaklıkların ortalamasıdır. \(S\)'nin sıfıra yaklaşması çözümlerin cephe boyunca daha eşit aralıklarla dağıldığını gösterir. Daha yüksek değer kümelenmenin veya düzensiz aralıkların arttığını ifade eder.
Denklem (25): Mesafe-greedy taban çizgisine göre enerji tasarrufu
\[ \Delta E = \left( \frac{ F_1(\pi_{\text{greedy}}) - F_1(\pi^*) }{ F_1(\pi_{\text{greedy}}) } \right) \times100\% \tag{25} \]
Bu oran seçilen POB knee-point çözümünün, kaynağın standart endüstriyel mesafe-greedy taban çizgisi olarak adlandırdığı çözüme göre enerji azalmasını yüzdelik olarak verir.
Çalışmanın Yöntemi ve Bulguları
Sentetik deney ortamı
Çalışmanın optimizasyon örneğinde bir merkezi depo ve 26 müşteri vardır. Müşteri talepleri 500–2500 aralığındadır. Düğüm koordinatları \([-300,300]\) aralığındaki ayrık iki boyutlu ızgarada tanımlanmıştır. Araç kapasitesi ana metin ve Tablo 5'te 7000 “birim” olarak belirtilmiştir. Filo büyüklüğü önceden sabit verilmek yerine permütasyonun kapasiteye göre bölünmesi sırasında ortaya çıkar.
| Bileşen | Kaynakta kullanılan ayar |
|---|---|
| Sentetik veri | 4000 gözlem |
| Eğitim/test | %80 / %20; kaynak Şekil 3 |
| Random Forest ağaç sayısı | 100 |
| Random Forest maksimum derinliği | 10 |
| Müşteri sayısı | 26 |
| Araç kapasitesi | 7000 birim |
| NSGA-II popülasyonu | 100 birey |
| Nesil sayısı | 60 |
| Ordered Crossover olasılığı | 0.8 |
| Shuffle mutation olasılığı | 0.2 |
| Mutasyon sırasında gen swap olasılığı | %10 |
| Bağımsız optimizasyon tekrarı | 5 |
| Rastgele tohumlar | 42, 43, 44, 45, 46 |
| Uygulama | Python 3.13.15 / Google Colab |
| NumPy | 2.1.3 |
| Pandas | 2.2.3 |
| Scikit-learn | 1.6.1 |
| DEAP | 1.4 |
| Matplotlib | 3.10.0 |
Çalışma süresi
| Çalıştırma | Süre (s) |
|---|---|
| 1 | 7.00 |
| 2 | 3.95 |
| 3 | 3.51 |
| 4 | 3.29 |
| 5 | 3.74 |
İlk çalıştırma 7 saniyedir; kaynak bunu optimizasyon ortamının kurulması, bellek tahsisi, cache oluşturulması ve vekil modelin devreye alınmasıyla ilişkilendirir. Sonraki dört çalıştırma yaklaşık 3–4 saniye aralığındadır.
Denklem (26): Ortalama çalışma süresi
\[ T_{\text{avg}}=4.30\ {\rm s} \tag{26} \]
Kaynak bu değere dayanarak yöntemin “near-real-time” lojistik planlama açısından umut verici olduğunu savunmaktadır. Ancak 4,30 saniye, gerçek trafik API'leri, gerçek filo telemetrisi veya sürekli değişen saha talepleri üzerinde ölçülmüş uçtan uca sistem gecikmesi değildir; sentetik 26 müşterili örneğin Google Colab ortamındaki hesaplama süresidir.
R² = 0,9960 Sonucu Nasıl Yorumlanmalıdır?
\(R^2=0{,}9960\), Random Forest vekil modelinin kaynak Denklem (10) ile oluşturulan sentetik test enerji değerlerindeki değişkenliğin yaklaşık %99,6'sını açıkladığını gösterir; bu sonuç gerçek araçların ölçülmüş enerji tüketiminde %99,6 saha doğruluğu anlamına gelmez.
Vekil model doğrulaması
Kaynak Şekil 6'da gerçek fiziksel enerji adı verilen sentetik hedef değerleri x ekseninde, Random Forest tarafından tahmin edilen enerji değerleri y ekseninde göstermektedir. Noktalar \(y=x\) özdeşlik doğrusuna yakın kümelenmektedir ve kaynak bunu düşük tahmin sapmasının göstergesi olarak yorumlamaktadır.
Burada “gerçek fiziksel enerji” ifadesi dikkatle okunmalıdır: grafikteki referans enerji laboratuvar veya saha aracından ölçülmemiştir; Denklem (10)'la oluşturulan sentetik hedef değerdir. Dolayısıyla grafik, Random Forest'ın kendi eğitim probleminin altında yatan formülü ne kadar iyi yaklaşıklaştırdığını test etmektedir.
Enerji ile mesafe arasında neden çatışma ortaya çıkıyor?
Kaynak Pareto cephesinde enerji azaldıkça toplam mesafenin bazı çözümlerde artabildiğini göstermektedir. Bunun mekanik açıklaması dinamik yük güncellemesidir. Yüksek talebe sahip müşteriler daha erken ziyaret edilirse araç kütlesi daha erken azalır; daha sonraki yol bölümleri daha hafif yükle geçilebilir. Bu nedenle daha uzun bir rota, modelin enerji fonksiyonunda bazı daha kısa rotalardan daha az enerji tüketebilir.
Bu bulgu, “gerçek dünyada daha uzun rota her zaman daha ekonomiktir” anlamına gelmez. Kaynak yalnız kendi enerji fonksiyonu, sentetik talep yapısı ve rota kuralları altında mesafe ile enerji amaçlarının tam olarak aynı olmadığını göstermektedir.
Denklem (27): Sonuç bölümündeki iki amaçlı özet
\[ \min(E_{\text{fleet}},D_{\text{fleet}}) \tag{27} \]
\(E_{\text{fleet}}\) toplam filo enerjisini, \(D_{\text{fleet}}\) toplam filo mesafesini temsil eder. Bu denklem çalışmanın bütün optimizasyon problemini kısa biçimde özetler: amaç hem enerjiyi hem mesafeyi mümkün olduğunca azaltmak, fakat ikisi arasında ortaya çıkan ödünleşimi Pareto çözümleriyle görünür kılmaktır.
Üç rota stratejisinin enerji karşılaştırması
| Rota yaklaşımı | Enerji tüketimi | Yorum |
|---|---|---|
| Rastgele rotalama | 833.3 kWh | Kaynak karşılaştırmasındaki en yüksek enerji tüketimi. |
| Distance-greedy / Industry Standard Greedy | 780.0 kWh | Mesafeyi önceleyen karşılaştırma taban çizgisi. |
| POB knee-point çözümü | 685.9 kWh | Seçili POB uzlaşma çözümü. |
Seçili POB çözümünün 685,9 kWh değeri, rastgele çözümdeki 833,3 kWh'a göre yaklaşık %17,7 ve mesafe-greedy çözümdeki 780,0 kWh'a göre yaklaşık %12,1 azalmaya karşılık gelir. Kaynağın beş bağımsız çalıştırma üzerinden raporladığı ortalama mesafe-greedy enerji azalması ise %12,47 ± %2,32'dir.
Kaynak, “±2,32” bileşeninin standart sapma, standart hata veya güven aralığı olarak hangi istatistiksel tanıma karşılık geldiğini ilgili sonuç cümlesinde ayrıca etiketlememektedir. Bu nedenle Verianla bunu yalnız kaynakta raporlandığı biçimiyle aktarır.
Hypervolume ve Pareto kararlılığı
Beş bağımsız çalıştırma için normalize edilmiş Hypervolume:
\[ HV=0.6305\pm0.0277 \]
olarak raporlanmıştır. Kaynak, düşük çalıştırmalar-arası değişkenliği optimizasyon sürecinin farklı başlangıç koşullarında benzer yüksek kaliteli bölgelere yakınsadığının göstergesi olarak yorumlamaktadır.
Hypervolume değeri çalışmada kullanılan Denklem (20) normalizasyon sınırlarına ve \([1.1,1.1]^T\) referans noktasına bağlıdır. Bu nedenle 0,6305 değeri başka bir çalışmadaki farklı ölçek veya referans noktasıyla hesaplanmış HV değeriyle bağlamdan bağımsız karşılaştırılmamalıdır.
Spacing sonucu
Kaynak ortalama Spacing değerini:
\[ S=109.32\pm46.20 \]
olarak raporlamakta ve bunu Pareto çözümlerinin cephe boyunca orta düzeyde dağılmış olduğunun göstergesi şeklinde yorumlamaktadır. Spacing sıfıra yaklaştıkça dağılım daha düzenli olur; yüksek değer çözümler arasındaki mesafenin daha değişken olduğunu gösterir.
Özellik önem analizi
| Özellik | Kaynak yorumu |
|---|---|
| Araç yükü | Yaklaşık %70; en yüksek önem |
| Mesafe | Yaklaşık %29 |
| Hız | Kaynak “ihmal edilebilir” düzeyde olarak tanımlar; kesin yüzde verilmez |
| Trafik | Kaynak “ihmal edilebilir” düzeyde olarak tanımlar; kesin yüzde verilmez |
Bu sonuç, çalışmanın sentetik enerji fonksiyonunun yapısı ve test koşulları içinde yükün en güçlü açıklayıcı değişken olduğunu gösterir. Ancak trafik rota değerlendirmesinde \(T_e=1.2\) olarak sabittir ve hız da Denklem (4) ile mesafeden deterministik olarak türetilmektedir. Bu nedenle “hız ve trafik gerçek dünyadaki araç enerjisinde önemsizdir” sonucu bu çalışmadan çıkarılmamalıdır.
Kaynak bu bölümü “sensitivity analysis” olarak adlandırsa da yapılan işlem esasen Random Forest Gini özellik önemlerinin yorumlanmasıdır. Kontrollü biçimde her parametreyi ayrı ayrı değiştirerek oluşturulmuş klasik bir küresel duyarlılık analizi raporlanmamaktadır.
Optimize edilmiş rota desenleri
Kaynak Şekil 9, rastgele rota ile seçilen optimize rota konfigürasyonunu görsel olarak karşılaştırır. Rastgele çözüm daha fazla rota kesişmesi, dağınık müşteri sırası ve gereksiz sapma göstermektedir. Optimize edilmiş çözüm daha düzenli müşteri kümeleri ve daha tutarlı rota dizileri üretmektedir.
Şekil 9'un müşteri koordinatlarına ait ham nokta/rota dizisi makalede bağımsız veri tablosu olarak verilmediğinden, Verianla bu haritayı tahmini koordinatlarla yeniden çizmemektedir.
Çalışmanın desteklediği sonuçlar
- Random Forest, çalışmanın sentetik enerji hedef fonksiyonunu test verisinde \(R^2=0.9960\) düzeyinde yaklaşıklaştırmıştır.
- POB, enerji tahminini NSGA-II optimizasyonuyla teknik olarak birleştirebilmiştir.
- Dinamik yük güncellemesi nedeniyle en kısa mesafeli rota ile en düşük enerjili rota her zaman aynı değildir.
- Beş bağımsız sentetik optimizasyon çalıştırmasında distance-greedy taban çizgisine göre ortalama enerji azalması %12,47 ± %2,32 olarak raporlanmıştır.
- Normalize Hypervolume 0,6305 ± 0,0277, Spacing 109,32 ± 46,20 olarak raporlanmıştır.
- Vektörleştirilmiş RF tahmini ve memoization yaklaşımı, bu problem örneğinde optimizasyonu birkaç saniye ölçeğine indirmiştir.
- Kaynağın Gini analizinde araç yükü yaklaşık %70, mesafe yaklaşık %29 önem taşımıştır.
Çalışmanın desteklemediği sonuçlar
- POB'nin gerçek bir lojistik şirketinde kesin olarak %12,47 enerji tasarrufu sağlayacağı gösterilmemiştir.
- Random Forest gerçek araç telemetrisi üzerinde \(R^2=0.9960\) ile doğrulanmamıştır.
- Model gerçek zamanlı trafik verisi kullanmamaktadır; rota değerlendirmesinde trafik katsayısı 1.2'dir.
- Çalışma belirli bir kamyon, van, elektrikli araç veya motor/batarya modeli üzerinde saha doğrulaması yapmamıştır.
- Gini özellik önemi nedensel etki büyüklüğü değildir.
- Yaklaşık %70 yük önemi bütün şehirler, filolar ve enerji modelleri için evrensel oran olarak yorumlanamaz.
- 4,30 saniyelik ortalama süre gerçek bir üretim lojistik sisteminin uçtan uca gecikmesi değildir.
- Kaynak gerçek trafik, hava koşulları, yol eğimi, araç teknolojisi, sürücü davranışı veya şarj/yakıt dinamiklerinin tam saha entegrasyonunu test etmemiştir.
Başlıca yöntemsel sınırlılıklar
Sentetik enerji verisi: Modelin temel enerji fonksiyonu ölçülmüş filo verisinden türetilmemiştir. Bu nedenle vekil modelin yüksek R² değeri öncelikle sentetik fonksiyonu öğrenme başarısını gösterir.
Enerji fonksiyonunun fiziksel kalibrasyonu: Denklem (10)'un katsayılarının belirli bir araç güç aktarma sistemi veya ölçülmüş kWh/fuel tüketimiyle nasıl kalibre edildiği kaynakta gösterilmemektedir.
Trafik değişkeni: Rota değerlendirmesinde \(T_e=1.2\) sabittir. Dolayısıyla gerçek trafik dalgalanmaları optimizasyon içinde dinamik olarak temsil edilmemektedir.
Hız değişkeni: Hız gerçek sürüş verisinden değil \(v_e=\max(25,80-0.3d_e)\) bağıntısından hesaplanır.
Ölçek: Optimizasyon örneği 26 müşteriden oluşur. Daha büyük filo ve müşteri ağlarında aynı çalışma süresi veya aynı çözüm kalitesi bu çalışma tarafından kanıtlanmamaktadır.
MAPE raporlaması: Yöntem MAPE'yi değerlendirme metriği olarak belirtse de ana sonuçlarda sayısal MAPE değeri verilmemektedir.
İstatistik: Çalışma beş bağımsız rastgele tohumlu optimizasyon çalıştırması kullanır; klasik hipotez testi, p değeri veya güven aralığı analizi raporlanmamaktadır.
Veri/kod erişimi: Kaynak, özgün katkıların makale içinde bulunduğunu ve ek soruların sorumlu yazara yöneltilebileceğini belirtmektedir; ayrı açık kod deposu veya gerçek filo veri seti ana makalede bildirilmemektedir.
Kaynak içindeki gösterim farklılıkları
Matematiksel Bölüm 3.1.2'de \(F_1\) toplam enerji, \(F_2\) toplam mesafe olarak tanımlanmaktadır. Kaynak Şekil 4'ün algoritmik mimari görselinde ise “Objective 1” mesafe, “Objective 2” global enerji biçiminde etiketlenmiştir. Verianla matematiksel denklemleri esas almakta ancak bu görsel etiketleme farkını gizlememektedir.
Tablo 5 ve ana yöntem metni araç kapasitesini \(Q=7000\) “units/birim” biçiminde verirken kaynak Şekil 4 görselinde “7000 kg per vehicle” ifadesi bulunmaktadır. Ana metinde fiziksel kütle birimi açık ve tutarlı biçimde sabitlenmediği için Verianla hesaplama anlatımında “7000 birim” ifadesini korumaktadır.
Kaynak ve Yöntem Notu
Özgün çalışma: The Prediction Optimization Bridge (POB): A Surrogate Assisted Random Forest–NSGA-II Framework for Energy Efficient Vehicle Routing
Yazarlar: Manal El Yadari; Fouad Jawab; Imane Moufad; Imane Tronnebati.
Yazar sırası: Kaynaktaki sıra aynen korunmuştur.
Sorumlu yazar: Fouad Jawab.
Kurum: Laboratory of Technologies and Industrial Services, Sidi Mohamed Ben Abdellah University, Fes 30000, Morocco.
Eş katkı: Kaynakta eş birinci yazarlık veya eş katkı işareti belirtilmemektedir.
Dergi: Urban Science.
Yayınevi: MDPI, Basel, Switzerland.
Cilt / sayı / makale numarası: 10(11), 626.
DOI: 10.3390/urbansci10110626
Gönderim tarihi: 28 Haziran 2026.
Revizyon tarihi: 19 Eylül 2026.
Kabul tarihi: 20 Eylül 2026.
Yayın tarihi: 29 Ekim 2026.
Kaynak türü: Article; hesaplamalı araç rotalama, makine öğrenmesi vekil modelleme ve çok amaçlı evrimsel optimizasyon çalışması.
Hakemlik durumu: Urban Science dergisinde yayımlanmış hakemli dergi makalesidir.
Lisans: Creative Commons Attribution (CC BY) açık erişim lisansı.
Resmî yayın bağlantısı: DOI 10.3390/urbansci10110626 üzerinden MDPI Urban Science resmî makale sayfası.
Finansman: Yazarlar araştırmanın dış finansman almadığını bildirmektedir.
Etik kurul: Institutional Review Board Statement: Not applicable.
Bilgilendirilmiş onam: Informed Consent Statement: Not applicable.
Veri erişilebilirliği: Yazarlar çalışmanın özgün katkılarının makale içinde bulunduğunu ve ek soruların sorumlu yazara yöneltilebileceğini belirtmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını beyan etmektedir.
Üretken yapay zekâ bildirimi: Yazarlar makalenin hazırlanması sırasında sınırlı dil desteği ve iki şeklin renk/ikon gibi görsel biçimlendirmeleri için üretken yapay zekâ araçlarının kullanıldığını; çıktıları kendilerinin gözden geçirip düzenlediklerini ve yayın içeriğinin sorumluluğunu üstlendiklerini belirtmektedir.
Yazar katkıları: Kavramsallaştırma: F.J., I.M., I.T.; yöntem: M.E.Y., F.J.; özgün taslak yazımı: M.E.Y.; gözden geçirme ve düzenleme: M.E.Y., F.J., I.T.; danışmanlık/gözetim: F.J., I.M. Tüm yazarlar yayımlanan sürümü okuyup onaylamıştır.
Temel yöntem: Fiziksel ilişkilerden esinlenen 4000 sentetik gözlem; %80/%20 eğitim-test ayrımı; 100 ağaçlı ve maksimum derinliği 10 olan Random Forest vekil modeli; 26 müşteri ve bir depolu sentetik EE-VRP; dinamik yük güncellemesi; kapasite tabanlı greedy route-splitting; vektörleştirilmiş toplu RF çıkarımı; memoization cache; 100 birey ve 60 nesilli NSGA-II; Ordered Crossover; Shuffle Indexes Mutation; beş bağımsız rastgele tohum; Hypervolume, Spacing, enerji tasarrufu, çalışma süresi ve Gini özellik önem analizi.
Temel yorum sınırı: Çalışmanın performans sonuçları gerçek araç telemetrisi veya gerçek şehir filosu üzerinde dış doğrulamadan geçirilmemiş sentetik optimizasyon ortamına aittir. Bu nedenle enerji değerleri ve tasarruf oranları doğrudan saha performansı gibi genellenmemelidir.
Kaynak içi gösterim notu: Matematiksel bölüm \(F_1\)'i enerji ve \(F_2\)'yi mesafe olarak tanımlarken Şekil 4'te amaç numaraları ters etiketlenmektedir. Aynı şekil \(Q=7000\) kapasitesini kg olarak gösterirken ana metin ve Tablo 5 birimi “units” olarak vermektedir. Bu farklılıklar sessizce düzeltilmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir