


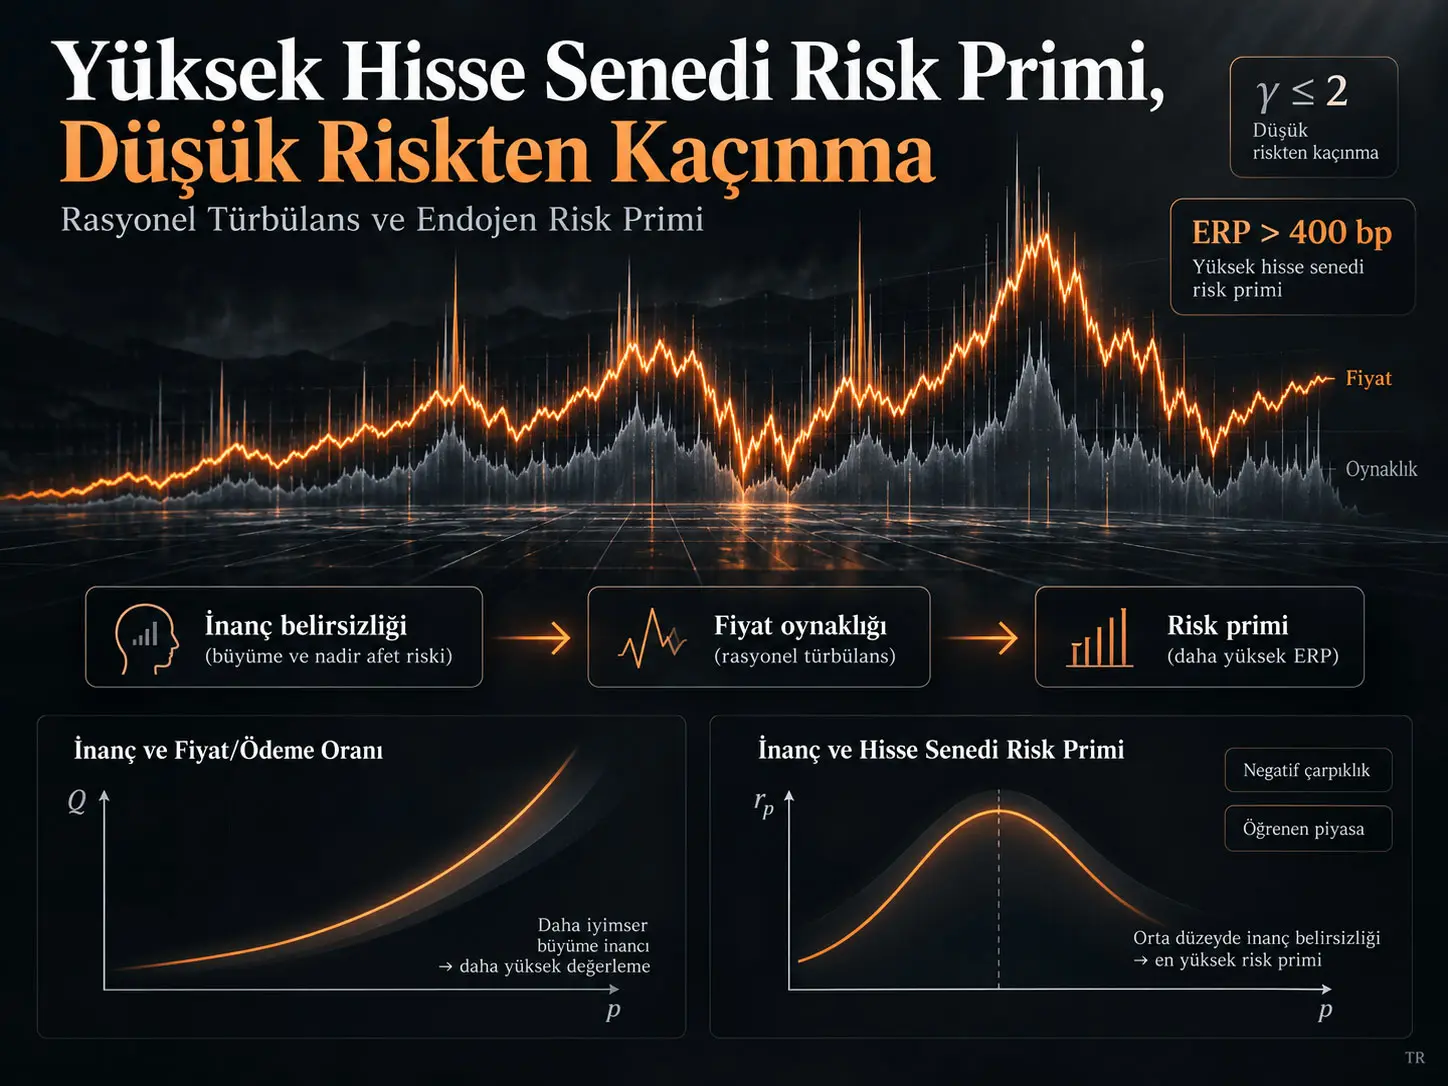
Hisse senedi risk primi (Equity Risk Premium, ERP), yatırımcıların risksiz bir varlık yerine hisse senedi taşımak için beklediği ilave getiridir. Kent Osband'ın çalışması, ortalama ERP'nin 400 baz puanı aşabilmesini çok yüksek göreli riskten kaçınma varsaymadan açıklamaya çalışan teorik ve hesaplamalı bir varlık fiyatlama modeli geliştiriyor. Model, hisse senedi yatırımını toplam tüketim düzleştirmesinden ayırıyor; yatırımcıların büyüme eğilimi hakkındaki inançlarını yeni bilgiler geldikçe Bayesian biçimde güncellediğini varsayıyor; risk primini bu değişen inançlara endojen olarak bağlıyor ve nadir düşük-büyüme rejimlerinden kaynaklanan güçlü negatif çarpıklığı sisteme ekliyor.
Çalışmanın ana iddiası, gözlenen yüksek ERP'nin mutlaka \(\gamma\geq4\) gibi yüksek göreli riskten kaçınma gerektirmediğidir. Etkili \(\gamma\) yaklaşık 1,5–2 düzeyindeyken, büyüme rejimindeki negatif çarpıklık ve değişen yatırımcı güveni fiyat/ödeme oranının haber akışına hassasiyetini artırabilir. Fiyat oynaklığı yükseldiğinde endojen risk primi de yükselir; yükselen iskonto oranı fiyat fonksiyonunu daha da dikleştirir. Yazar bu karşılıklı güçlenmeyi “rasyonel türbülans” olarak adlandırır.
Temsilî kalibrasyonda \((\sigma_B,\lambda,\gamma)=(0.06,1.0,2)\) alınırken ortalama \(440\) baz puan risk primi; uzun dönem ödeme varyans oranı \(\sigma_{LT}^2=120\) baz puan olduğunda \(s=-3.5\), 130 baz puanda \(s=-3.0\), 157 baz puanda ise \(s=-2.0\) çarpıklıkla üretilebilmektedir. Bu sonuçlar doğrudan gözlenmiş piyasa nedenselliği değil, modelin belirtilen parametreler altında verdiği denge ve simülasyon sonuçlarıdır.
Hisse senedi risk primi bulmacası nedir?
Hisse senedi risk primi bulmacası, hisse senetlerinin tarihsel olarak risksiz varlıklardan çok daha yüksek getiri sağlamasına karşın standart tüketim-temelli modellerin bu farkı ancak gözlenen hane davranışına göre aşırı yüksek görünen riskten kaçınma katsayılarıyla açıklayabilmesi problemidir.
Standart Merton ilişkisi
Çalışma klasik Merton portföy probleminden başlar. Optimal hisse senedi ağırlığı:
\[ w=\frac{r_p}{\gamma\sigma^2} \tag{1} \]
olarak yazılır. Burada \(w\) servetin hisse senedine yatırılan oranını, \(r_p=\mu-\delta\) beklenen hisse senedi risk primini, \(\mu\) beklenen hisse senedi getirisini, \(\delta\) risksiz faiz oranını, \(\sigma^2\) göreli getiri varyansını ve \(\gamma\) sabit göreli riskten kaçınma katsayısını (CRRA) gösterir.
Temsilî yatırımcının bütün piyasa portföyünü tutması gereken dengede \(w=1\) alınır ve:
\[ r_p=\gamma\sigma^2 \tag{2} \]
elde edilir. Eğer hisse senetleri toplam tüketimin üzerine yazılmış bir hak gibi ele alınırsa tüketim oynaklığının düşük olması bu eşitliğin yüksek bir \(r_p\) üretebilmesi için çok büyük \(\gamma\) gerektirmesine yol açar.
Kaynak 400 baz puanı temel ERP ölçütü olarak kullanır. Bir baz puan 0,01 yüzde puanıdır; dolayısıyla 400 baz puan yaklaşık 4 yüzde puanlık primdir.
Tüketimden hisse senedi fiyat oynaklığına geçiş
Çalışmanın ilk temel adımı, marjinal hisse senedi yatırımcısının portföy kararını doğrudan toplam tüketim oynaklığına bağlamamaktır. Yazar, özellikle yüksek servetli ve tüketimi yeterince tamponlanmış yatırımcıların servetin geri kalanını uzun dönemli büyüme amacıyla quasi-Kelly tarzında yönetebileceğini savunur.
Bu durumda denklem (2)'deki ilgili risk ölçüsü tüketim değişkenliği yerine göreli hisse senedi fiyat oynaklığı \(\zeta\) olur:
\[ r_p=\gamma\zeta^2. \tag{3} \]
Ortalama risk primi için önemli olan ortalama varyanstır:
\[ \langle\zeta^2\rangle = \langle\zeta\rangle^2+\operatorname{var}(\zeta). \tag{4} \]
Kaynağa göre S&P 500 için yaygın yıllık RMS oynaklık tahminleri %15–17 düzeyindedir. Bu, \(\langle\zeta^2\rangle\) için yaklaşık 225–300 baz puanlık varyans oranına karşılık gelir. Böyle bir fiyat varyansı denklem (3) altında \(\gamma<2\) ile 400 baz puanın üzerinde ERP üretebilir.
Ancak bu yalnız problemi başka yere taşır: ödeme veya kâr akışı bu kadar oynak değilse, fiyat neden bu kadar oynaktır? Çalışmanın geri kalanı esas olarak bu aşırı oynaklık bulmacasını açıklamaya çalışır.
CRRA ve düşük riskten kaçınma argümanı
Standart zaman-toplamsal beklenen fayda:
\[ EU= \int_0^\infty u(c(t))e^{-\rho t}\,dt \tag{5} \]
ve CRRA fayda fonksiyonu:
\[ u(c)=\frac{c^{1-\gamma}-1}{1-\gamma}, \qquad \gamma\geq0 \tag{6} \]
biçimindedir; \(\gamma=1\) sınırında \(u(c)=\log c\) elde edilir.
Yazar tüketim, sigorta, emek arzı ve refah literatüründeki çeşitli tahminleri kullanarak gerçekçi \(\gamma\) değerlerinin çoğunlukla 1–2 çevresinde kümelendiğini savunur. Bu literatür taraması çalışmanın yeni ampirik tahmini değildir; model için gerekçelendirilen parametre aralığıdır.
Kelly ve fractional Kelly neden modele giriyor?
Kelly kriteri, uzun dönemde beklenen log-servet büyümesini maksimize eden bahis/yatırım oranını ifade eder. Tam Kelly küçük model hatalarına ve büyük drawdown'lara karşı agresif olabilir. Bunun belirli bir kısmını kullanmak fractional Kelly olarak adlandırılır.
Kaynak, tam Kelly bahis miktarının \(f\) oranını kullanmanın yaklaşık olarak:
\[ \gamma\approx\frac{1}{f} \]
ile ilişkilendirilebileceğini belirtir. Buna göre half-Kelly, \(f=0.5\), etkili olarak \(\gamma=2\)'ye karşılık gelir. Yazar profesyonel yatırım pratiğinde half-Kelly'yi temkinli bir referans noktası kabul ederek modelin ana hedefini \(\gamma=2\) ile 400 baz puanın üzerinde ERP üretmek olarak belirler.
Buradaki \(\gamma\), yalnız psikolojik riskten kaçınma değildir. Yazar bunun bir bölümünün model/parametre belirsizliğine karşı yapılan ihtiyatlı küçültmeyi de temsil edebileceğini açıkça belirtir ve iki bileşeni ayrı ayrı tanımlamaya çalışmaz.
Tarihsel ödeme oynaklığı ne kadar?
Kaynağın Şekil 1'i Robert Shiller'ın S&P Composite serisinden gerçek yıllık temettü ve gerçek kârları 1871'den itibaren karşılaştırır. Grafikte gerçek kârlar temettülerden çok daha dalgalıdır. Kaynak 1871–1950 döneminde temettü kısa dönem oynaklığını %6,4, 1951–2024 döneminde %2,3 olarak verir. Kârların kısa dönem oynaklığı ise belirli uç yıllar hariç yaklaşık %9,5'tir.
Kaynağın 10. sayfasındaki Şekil 1, özellikle 1950 sonrası temettü serisinin kâr serisine göre belirgin biçimde daha fazla yumuşatıldığını gösterir. Yazar bunu yönetimsel dividend smoothing, teknoloji şirketlerinin kârı yeniden yatırıma yönlendirmesi ve hisse geri alımlarının yaygınlaşması gibi faktörlerle ilişkilendirir.
Uzun dönem varyans oranı
Şekil 2, gerçek temettü ve kâr büyümesinin 20–40 yıllık pencerelerde varyans oranlarını gösterir. Kaynakta bu aralıktaki ortalama uzun dönem varyans oranı temettüler için 46 baz puan, kârlar için 102 baz puan olarak raporlanır.
| Ölçüm | Kaynak değeri | Bilimsel rol |
|---|---|---|
| Temettü kısa dönem oynaklığı, 1871–1950 | %6,4 | Tarihsel ödeme değişkenliği |
| Temettü kısa dönem oynaklığı, 1951–2024 | %2,3 | Temettü yumuşamasını gösterir |
| Kâr kısa dönem oynaklığı | Yaklaşık %9,5 | Temettüden daha yüksek ödeme riski |
| 20–40 yıllık ortalama temettü VR | 46 baz puan | Uzun dönem varyans oranı |
| 20–40 yıllık ortalama kâr VR | 102 baz puan | Model kalibrasyonunun ana ampirik dayanağı |
Yazar, \(\gamma=2\) altında yaklaşık 400 baz puan ERP için kabaca 200 baz puanlık ilgili fiyat varyansı gerektiğinden 102 baz puanlık kâr varyansının hâlâ yetersiz olduğunu vurgular. Böylece ERP bulmacası aşırı fiyat oynaklığı bulmacasına dönüşür.
“Rasyonel türbülans” nasıl oluşuyor?
Rasyonel türbülans, yatırımcıların gelecekteki ödeme büyüme eğilimi hakkında rasyonel biçimde öğrenirken inanç belirsizliğinin fiyat/ödeme oranını değiştirmesi, bu değişimin fiyat oynaklığını artırması ve yükselen fiyat oynaklığının endojen risk primini daha da yükselterek fiyatları haberlere daha hassas hâle getirmesiyle oluşan geri besleme mekanizmasıdır.
Stokastik drift modeli
Modelde log ödeme \(x\)'in büyüme eğilimi \(\mu\) sabit değildir. Drift belirli bir stokastik yenilenme oranı \(\lambda\) ile yeniden çekilir. İki durumlu sadeleştirmede drift:
\[ \mu_H \quad \text{ve} \quad \mu_L \]
olmak üzere iki olası rejime sahiptir. \(p\), yatırımcının yüksek-drift rejiminin geçerli olduğuna verdiği olasılıktır. Algılanan ortalama drift:
\[ E=p\mu_H+(1-p)\mu_L \]
olarak tanımlanır.
Ödemeler ayrıca \(\sigma_B\) büyüklüğünde Brownian gürültü içerir.
Rasyonel öğrenme denklemi
İki rejim altında inanç güncellemesi kaynakta:
\[ dp= p(1-p)(\mu_H-\mu_L) \frac{dx-E\,dt}{\sigma_B^2} + \lambda(\pi_H-p)\,dt \tag{8} \]
olarak verilir.
İlk terim yeni ödeme haberinin Bayesian etkisidir. Gerçekleşen \(dx\), beklenen \(E\,dt\)'den yüksekse yüksek-drift rejimine verilen \(p\) olasılığı yükselme eğilimindedir; kötü haber ters yönde çalışır.
İkinci terim drift rejiminin gelecekte reset olabileceği bilgisini içerir. \(\pi_H\), reset sonrasında yüksek rejimin uzun dönem olasılığıdır; \(\lambda\) büyüdükçe mevcut rejimin daha kısa ömürlü olması beklenir.
Normalize edilmiş yenilik:
\[ dy=\frac{dx-E\,dt}{\sigma_B} \]
kullanıldığında inanç sürecinin drift ve volatilite terimleri:
\[ a(p)=\lambda(\pi_H-p) \]
ve:
\[ b(p)= p(1-p) \frac{\mu_H-\mu_L}{\sigma_B} \]
olur. \(p(1-p)\) ifadesi inanç belirsizliğinin merkezde en yüksek, \(p\) 0 veya 1'e yaklaşırken en düşük olduğunu gösterir.
Fiyat/ödeme oranının denge denklemi
\(Q(p)\), belirli bir \(p\) inancı altında fiyatın mevcut ödeme akışına oranıdır. Kaynakta adil fiyatlama koşulu:
\[ \left( \delta+r_p-E-\frac{1}{2}\sigma_B^2 \right)Q = 1+ (a+b\sigma_B)Q' + \frac{1}{2}b^2Q'' \tag{9} \]
olarak yazılır.
Sol tarafta \(\delta+r_p\) iskonto oranı, \(E+\sigma_B^2/2\) ise beklenen yüzde ödeme büyümesidir. Sağ tarafta normalize edilmiş ödeme akışı \(1\), \(p\)'deki beklenen değişimin oluşturduğu sermaye kazancı ve inanç volatilitesinin fiyat eğrisi üzerindeki doğrusal/konvekslik etkileri yer alır.
Risk primi endojen hâle geliyor
Fiyat oynaklığı yalnız ödeme gürültüsü \(\sigma_B\)'den oluşmaz. \(p\) değiştiğinde \(Q(p)\) de değişir. Dolayısıyla değerleme oranının inançlara duyarlılığı ekstra fiyat oynaklığı yaratır.
Kaynağın merkezi eşitliği:
\[ r_p = \gamma\zeta^2 = \gamma \left( \sigma_B+ b\frac{Q'}{Q} \right)^2 \tag{10} \]
biçimindedir.
Bu denklem modelin rezonans mekanizmasını doğrudan gösterir. \(\frac{Q'}{Q}\) yükseldiğinde aynı inanç şoku fiyat üzerinde daha büyük yüzde hareketi yaratır. Bu, \(\zeta\)'yı yükseltir. Daha yüksek \(\zeta\) ise aynı denklem aracılığıyla \(r_p\)'yi yükseltir. Risk primi tekrar \(Q\)'nun iskonto oranına girdiği için fiyat eğrisinin şekli de değişir.
Dolayısıyla risk primi dışarıdan verilen sabit parametre değildir; yatırımcıların belirsizliğiyle birlikte model içinde değişir.
Negatif çarpıklık neden risk primini bu kadar büyütebiliyor?
Negatif çarpıklık, nadir rejimin düşük büyüme rejimi olduğu durumda yatırımcıların çoğu zaman normal büyümeye çok güvenmesini fakat küçük bir felaket olasılığına ilişkin şüphelerin \(Q(p)\) eğrisini özellikle yüksek \(p\) bölgesinde dikleştirmesini sağlar; bu da haberlerin fiyat etkisini, fiyat varyansını ve denklem (10) üzerinden endojen risk primini güçlü biçimde artırır.
İki noktalı drift dağılımı
İki drift durumunun olasılıkları ortalama \(m\), drift varyansı \(\sigma_D^2\) ve çarpıklık \(s\) ile parametrikleştirilir:
\[ \pi_H = 1-\pi_L = \frac{1}{2} - \frac{1}{2} \frac{s}{\sqrt{s^2+4}}, \]
\[ \mu_H = m+\sigma_D\sqrt{\frac{\pi_L}{\pi_H}}, \qquad \mu_L = m-\sigma_D\sqrt{\frac{\pi_H}{\pi_L}}. \tag{11} \]
Negatif \(s\), düşük drift rejimini nadir fakat ağır bir aşağı yönlü durum hâline getirir. Yazarın temel ilgisi tam olarak bu negatif kuyruktur.
Green–Kubo bağıntısı ve uzun dönem risk
Modelde kısa dönem Brownian gürültüsü ile zaman içinde değişen driftin toplam uzun dönem varyans oranı:
\[ \sigma_{LT}^2 = \sigma_B^2 + \frac{2\sigma_D^2}{\lambda} \tag{12} \]
şeklindedir.
\(\sigma_B^2\), sürekli kısa dönem ödeme gürültüsünü temsil eder. \(\sigma_D^2\), drift rejimleri arasındaki dağılımın varyansıdır. \(\lambda\), rejim reset hızıdır. Küçük \(\lambda\), driftin daha uzun süre kalıcı olması demektir ve \(\frac{2\sigma_D^2}{\lambda}\) terimini büyütür. Dolayısıyla aynı yıllık kısa dönem oynaklığı altında daha kalıcı drift değişimleri uzun vadeli ödeme riskini artırır.
Varyans çarpanı
Çalışma:
\[ \frac{\langle\zeta^2\rangle}{\sigma_{LT}^2} \]
oranını variance multiplier — varyans çarpanı olarak adlandırır. Bu oran fiyat varyansının temel uzun dönem ödeme varyansını ne ölçüde aştığını gösterir.
Şekil 3'te \(\sigma_{LT}^2=100\) baz puan ve \(\gamma=2\) sabitlenerek 25 farklı \((\sigma_B,\lambda)\) kombinasyonu incelenir. \(\sigma_B\) yıllık %4–8, \(\lambda\) 0,4–1,2 arasındadır; bu da yaklaşık 2,5 yıldan 10 aya uzanan rejim sürelerine karşılık gelir.
| Çarpıklık \(s\) | Kaynak sonucu | Yorum |
|---|---|---|
| \(s\geq-1\) | Hiçbir kombinasyon varyans çarpanı 1,2'ye ulaşmıyor | Önemli aşırı oynaklık oluşmuyor |
| \(s\) daha negatif oldukça | Varyans çarpanı hızla yükseliyor | Nadir kötü rejimlerin etkisi güçleniyor |
| \(s\leq-6\) | Neredeyse bütün kombinasyonlar >2; yarıdan fazlası >3 | Fiyat varyansı temel ödeme varyansının birkaç katına ulaşabiliyor |
Asimetri neden negatif tarafta daha güçlü?
Kaynak dört mekanizma ayırır. Birincisi, \(|s|\) büyüdükçe iki drift durumu arasındaki \(\mu_H-\mu_L\) mesafesi büyür ve inanç haberlerinin etkisi güçlenir. İkincisi, nadir rejim hakkında daha az gözlem bulunduğu için belirsizlik yüksektir. Üçüncüsü, negatif çarpıklıkta nadir rejim aynı anda hem kötü büyüme hem yüksek belirsizlik anlamına gelir; bu, yüksek-\(p\) bölgesindeki \(Q'\)'yu sert biçimde artırır. Dördüncüsü, pozitif çarpıklıkta yüksek büyüme rejimi aynı zamanda yüksek iskonto oranıyla karşılaştığından \(Q\) daha fazla düzleşir.
Şekil 4'te \((\sigma_B,\lambda)=(0.05,0.8)\) iken \(s=0\) için \(Q'\) yaklaşık 0,13'tür. \(s=-4\) olduğunda, inançların yaklaşık %90'ının toplandığı bölgede \(Q'\) 0,75'i aşar. Bu fark modelde haberlerin fiyat üzerindeki etkisini dramatik biçimde değiştirir.
Çalışmanın Yöntemi ve Bulguları
Sayısal çözüm
Denklem (9) ve (10) kapalı biçimde analitik çözüme sahip değildir. Kaynak iki ayrı sonlu-fark algoritması kullanır.
Birinci algoritma \(p\)'yi 4.000 noktalı uniform grid üzerinde ayrıklaştırır. \(Q'\) ve \(Q''\) standart sonlu farklarla yaklaşık hesaplanır. Diferansiyel operatörler seyrek üç diyagonalli bir generator matrise dönüştürülür. \(r_p\), \(Q\)'ya endojen olarak bağlı olduğu için çözüm iteratiftir:
- Geçici \(r_p\) sabit tutulur.
- Ayrık denklem çözülerek yeni \(Q\) elde edilir.
- Denklem (10) ile \(r_p\) yeniden hesaplanır.
- Bütün \(p\) değerleri için \(Q\) yakınsayana kadar süreç tekrarlanır.
İkinci algoritma:
\[ y=\log\left(\frac{p}{1-p}\right) \]
log-odds/Lamperti dönüşümünü kullanır. Bu dönüşüm \(p\approx0\) ve \(p\approx1\) uçlarında daha yüksek sayısal çözünürlük sağlar ve state volatility'yi sabit:
\[ \beta=\frac{\mu_H-\mu_L}{\sigma_B} \]
değerine dönüştürür. Kaynak ikinci yöntemin uç başlangıç koşullarında daha sağlam ve daha hızlı yakınsadığını, ancak birinci algoritmayla esas olarak aynı sonuçları verdiğini bildirir. Bu, çözümün sayısal yönteme aşırı bağımlı olmadığına dair bir kontrol sağlar.
Uzun dönem varyans tahmininin Monte Carlo kontrolü
Kaynak, S&P kâr serisinden ölçülen yaklaşık 100 baz puanlık uzun dönem varyans oranının gerçek \(\sigma_{LT}^2\)'yi aşağı yönlü tahmin edebileceğini inceler. Bunun için her biri tarihsel veriyle aynı uzunlukta, 154 yıllık 2.500 Monte Carlo simülasyonu gerçekleştirir.
Simülasyonlarda 20–40 yıllık varyans-oranı tahminlerinin beklenenden çok daha gürültülü olduğu bulunur. Kaynak standard error'ın tahminin ortalamasının yaklaşık %85'i olduğunu raporlar.
| Aşama | Sonuç | Kaynak yorumu |
|---|---|---|
| Tarihsel kâr VR ortalaması | ≈100 baz puan | Ham uzun dönem ölçüm |
| Working etkisi düzeltmesi | ≈111 baz puan | Simülasyonlarda yaklaşık %8 aşağı yönlü bias |
| Median yaklaşımı | ≈147 baz puan | Simülasyon medianı ortalamanın yaklaşık %75'i |
| Üst %10'u kırpılmış ortalama yaklaşımı | ≈142 baz puan | Kırpılmış ortalama tam ortalamanın yaklaşık %78'i |
| Yazarın pratik özeti | \(\sigma_{LT}\approx12\%\) | Yaklaşık 10% ham, 10,5% Working düzeltmeli; daha yüksek gerçek değer makul |
Yazar yüksek belirsizlik nedeniyle \(\sigma_{LT}^2\)'nin kesin değerini iddia etmez; yaklaşık 80–160 baz puan aralığını makul görür.
Çarpıklık için ampirik kontrol
Gerçek yıllık S&P ödeme büyümesinin örneklem çarpıklığı temettülerde −0,57, kârlarda −0,82'dir. Yazar, kısa dönem mean-reverting bileşenlerin ve Brownian gürültünün gözlenen çarpıklığı seyreltmesi nedeniyle temel drift dağılımındaki gerçek \(s\)'nin daha negatif olabileceğini savunur.
Ancak kaynak burada açık bir tutarsızlık da raporlar. Gerçek aylık S&P getirilerinin çarpıklığı −0,37'dir ve model \(s=-3\) civarında aylık değeri yaklaşık yakalayabilir. Buna karşılık modelin yıllık getiri çarpıklığı çoğu zaman −1'in altında kalırken gerçek S&P yıllık değeri yaklaşık −0,44'tür. Yazar bu uyuşmazlığı çözemediğini açıkça belirtmektedir.
440 baz puan ERP için parametre kombinasyonları
Kaynağın ana simülasyon setinde:
\[ (\sigma_B,\lambda,\gamma)=(0.06,1.0,2) \]
alınır ve ortalama:
\[ \langle r_p\rangle=440\text{ baz puan} \]
hedeflenir.
| \(\sigma_{LT}^2\) | Gerekli \(s\) | Yorum |
|---|---|---|
| 110 baz puan | −4,0 | Daha düşük temel ödeme varyansı daha ağır negatif kuyruk gerektiriyor |
| 120 baz puan | −3,5 | Ana ayrıntılı simülasyonda kullanılan değer |
| 130 baz puan | −3,0 | Daha ılımlı negatif çarpıklık yeterli oluyor |
| 157 baz puan | −2,0 | Yüksek temel uzun dönem varyansında daha az uç çarpıklık yeterli |
Bu çözümlerin ürettiği fiyat oynaklığı için kaynak \(RMS(\zeta)=14,8\%\) bildirir. Bu değer yazarın referans verdiği geleneksel S&P %15–17 bandının alt ucuna yakındır.
Ayrıntılı temsilî çözüm
Kaynak daha ayrıntılı inceleme için:
\[ (\sigma_{LT}^2,s,\sigma_B,\lambda,\gamma) = (0.012,-3.5,0.06,1.0,2) \]
parametrelerini seçer.
Bu çözümde yüksek-drift rejimine güven çoğu zaman çok yüksektir. Stationary distribution için:
- \(p>0.99\) olasılığı yaklaşık %50,
- \(p<0.50\) olasılığı yaklaşık %4,9,
- \(p<0.10\) olasılığı yaklaşık %1,5'tir.
Buna rağmen bu nadir şüphe dönemleri fiyatlama üzerinde çok büyük etkiye sahiptir.
Şekil 5 — inanç, fiyat/ödeme oranı ve risk primi
Kaynağın 21. PDF sayfasındaki Şekil 5'te yatay eksen yüksek büyüme rejimine inanç \(p\)'dir. Sol dikey eksen fiyat/ödeme oranı \(Q\), sağ dikey eksen risk primi \(r_p\)'yi baz puan cinsinden gösterir.
\(Q\) yaklaşık 35'ten 50'ye kadar yükselir ve ortalaması yaklaşık 48'dir. \(p>0.8\) bölgesi zamanın yaklaşık %90'ını kapsar; burada log-lineer \(Q\) yaklaşımının uyumu \(R^2=0.999\)'dur.
| İnanç \(p\) | \(r_p\) |
|---|---|
| Uçlar \(p\to0\) veya \(p\to1\) | Yaklaşık 72 baz puan taban |
| \(p=0.99\) | 156 baz puan |
| \(p=0.95\) | 692 baz puan |
| \(0.36<p<0.84\) | 2500 baz puanın üzerinde |
| Tepe | 4000 baz puanın biraz üzerinde |
Kaynağın ana mekanizması burada açıkça görünür: piyasa kötü rejimin kesin olduğuna inanırken değil, hangi rejimde olduğunu en fazla sorguladığı ara bölgede risk primi en yüksek seviyelere çıkar.
Şekil 6 — 40 yıllık simülasyon
Kaynağın 22. PDF sayfasındaki Şekil 6 aynı modelden üretilmiş 40 yıllık bir \(Q\) ve fiyat oynaklığı \(\zeta\) yolu gösterir. Oynaklık 21 günlük süreye karşılık gelen üstel hareketli ortalamalı varyansın kareköküyle yumuşatılmıştır.
Simülasyonda uzun sakin dönemler kısa panik dönemleriyle kesilir; değerlemeler zaman zaman hızlı düşer ve çoğu düşüş hızla geri dönerken bazıları daha uzun sürer. Oynaklık iyi zamanlarda düşük, kötü dönemlerde yüksektir ve kendi başına da güçlü biçimde değişkendir.
Ancak bu şekil aynı zamanda modelin temel kusurlarından birini görünür kılar. \(p\) çoğu zaman 1'e çok yakın olduğu için \(\zeta\), sakin dönemlerde \(\sigma_B\)'ye kadar düşebilir. Kaynak bu tabanın gerçek S&P'de gözlenen %10'un üzerindeki tipik oynaklık tabanından fazla düşük olduğunu ve bunun iki-rejimli modelin bir artefaktı olduğunu açıkça belirtir. Yazar daha zengin çok-durumlu modellerin bu sorunu azaltabileceğini ve bunu sonraki çalışmaya bıraktığını söyler.
Çalışmanın desteklediği ve desteklemediği sonuçlar
| Çalışmanın desteklediği | Çalışmanın tek başına desteklemediği |
|---|---|
| Düşük etkili riskten kaçınma ile yüksek ERP belirli bir rasyonel öğrenme modeli içinde birlikte üretilebilir. | Gerçek piyasa yatırımcılarının tamamında \(\gamma=2\) olduğu sonucu. |
| Negatif drift çarpıklığı, inanç belirsizliği ve endojen iskonto oranı güçlü aşırı fiyat oynaklığı yaratabilir. | Bütün tarihsel borsa çöküşlerinin yalnız bu mekanizmayla açıklandığı sonucu. |
| Model 400 baz puanın üzerinde ortalama risk primi ve piyasa-benzeri volatilite kümelenmesi üretebilir. | Bu modelin gelecekteki S&P getirilerini veya kriz tarihlerini öngördüğü sonucu. |
| Uzun dönem kâr varyansı standart tarihsel tahminlerden daha yüksek olabilir. | Gerçek \(\sigma_{LT}^2\)'nin kesin olarak 140 veya 157 baz puan olduğu sonucu. |
| İki sayısal çözüm algoritması esas olarak aynı sonuçları verir. | Model spesifikasyonunun tek doğru ekonomik model olduğu sonucu. |
| Rasyonel öğrenme, davranışsal “irrational exuberance” görünümüne benzeyen fiyat hareketleri oluşturabilir. | Davranışsal önyargıların gerçek piyasalarda önemsiz veya mevcut olmadığı sonucu. |
Güçlü yönler
- ERP bulmacası ile excess-volatility bulmacasını tek mekanizma altında ilişkilendirmesi.
- Risk primini sabit parametre olarak vermek yerine inanç belirsizliğinden endojen üretmesi.
- Rasyonel öğrenme, nadir felaketler, fractional Kelly ve zamanla değişen iskonto oranını aynı modelde birleştirmesi.
- Model çözümünü iki ayrı sayısal algoritmayla kontrol etmesi.
- Uzun dönem varyans tahmininin belirsizliğini 2.500 Monte Carlo simülasyonuyla incelemesi.
- Yıllık getiri çarpıklığı gibi modele uymayan bir bulguyu açıkça raporlaması.
Temel sınırlılıklar
İki durum sınırlaması: Model büyüme driftini yalnız yüksek ve düşük iki rejime ayırır. Bu nedenle felaket dışlandığında mevcut drift hakkında kalan gerçek dünya belirsizliği yapay biçimde çok küçülebilir.
Kısa dönem mean reversion dışarıda: Kaynak, gerçek ödemelerde büyük mean-reverting bileşenler bulunduğunu kabul eder ancak model bunları doğrudan içermez. Yatırımcıların bunları kalıcı drift haberinden ayırabildiği varsayılır.
Yapısal parametre bilgisi: Yatırımcıların \(\{\mu,\pi,\lambda\}\) yapısal parametrelerini bildiği varsayılır. Gerçek epistemik belirsizlik daha geniştir.
\(\gamma\)'nın birleşik yorumu: \(\gamma\), saf psikolojik riskten kaçınma ile model belirsizliğine karşı ihtiyatlı fractional-Kelly küçültmesini birbirinden ayırmaz.
Varyans tahmininin yüksek belirsizliği: 154 yıllık tarihsel örnek dahi uzun dönem varyansı dar güven aralığıyla belirlemek için yetersizdir; simülasyon standard error'ı çok büyüktür.
Çarpıklık uyuşmazlığı: Model aylık getiri çarpıklığını yaklaşık yakalarken yıllık getiri çarpıklığını gerçek S&P'ye göre fazla negatif üretebilir. Kaynak bu sorunu çözülmemiş olarak bırakır.
Simülasyon ≠ tahmin: 40 yıllık fiyat yolları model davranışını gösterir; gelecek piyasa yolunun tahmini değildir.
Kaynak ve Yöntem Notu
Özgün çalışma: Reconciling High Equity Risk Premia with Low Risk Aversion.
Yazar: Kent Osband.
PDF tarihi: July 2026.
PDF'deki iletişim bilgisi: kosband@risktick.com.
Kurum/afiliasyon: Yüklenen PDF'nin başlık sayfasında kurumsal afiliyasyon belirtilmemektedir.
Teşekkür: Yazar John Cochrane'a yararlı yorumları için teşekkür etmektedir.
Anahtar kelimeler: equity risk premium; drift uncertainty; risk aversion; Kelly criterion; asset pricing.
JEL: G12, D81, D53.
Kaynak türü: Teorik ve hesaplamalı varlık fiyatlama çalışması; tarihsel S&P verileri ve Monte Carlo/model simülasyonları kullanır.
Hakemlik: PDF'de hakemli dergi, cilt, sayı veya yayınevi bilgisi bulunmamaktadır. Hakemli nihai dergi sürümü bağımsız olarak doğrulanamamıştır; bu nedenle çalışma Verianla'da hakemli makale olarak sınıflandırılmamalıdır.
DOI: İkincil ResearchGate bibliyografik kaydı 10.2139/ssrn.6185899 vermektedir. Aynı DOI'nin resmî SSRN sayfası bu doğrulama sırasında erişilebilir arama sonucu olarak bulunamadığı için DOI “ikincil metadata ile doğrulanmış, resmî kayıtla tam teyit edilememiş” statüsünde tutulmalıdır.
Tarih farklılığı: ResearchGate aynı başlık için January 2026 tarihi gösterirken yüklenen PDF July 2026 tarihini taşımaktadır. Verianla bilimsel içeriği için yüklenen PDF sürümü kaynak-of-truth olarak kullanılmıştır.
Lisans: Yüklenen PDF'de açık Creative Commons veya başka bir yeniden kullanım lisansı belirtilmemektedir. Tam sürümün resmî lisansı doğrulanamadığından kaynak şekilleri birebir yeniden kullanılmamalıdır.
Finansman: Yüklenen PDF'de ayrı bir finansman bildirimi bulunmamaktadır.
Çıkar çatışması: Yüklenen PDF'de ayrı bir çıkar çatışması bildirimi bulunmamaktadır. Bu nedenle “çıkar çatışması yoktur” sonucu varsayılmamıştır.
Veri erişilebilirliği: Ayrı Data Availability bölümü bulunmamaktadır. Tarihsel S&P temettü, kâr ve getiri analizleri Robert Shiller'ın çevrimiçi veri serisine dayandırılmıştır; kaynak ayrıca BEA ve Federal Reserve serilerine referans verir.
Temel yöntem: CRRA/Merton risk primi çerçevesi; fractional-Kelly yorumu; iki durumlu stokastik payout-drift modeli; Wonham tipi sürekli-zaman Bayesian filtering; endojen risk primi ve price-to-payout denge diferansiyel denklemi; finite-difference numerical solution; log-odds/Lamperti alternatif çözümü; stationary distribution; Green–Kubo uzun dönem varyans hesabı; parametre duyarlılığı; 2.500 Monte Carlo simülasyonu.
Ana bilimsel sonuç: Kaynak, \(\gamma\leq2\) düzeyindeki etkili riskten kaçınma altında bile negatif drift çarpıklığı, rasyonel öğrenme ve endojen iskonto oranı arasındaki geri besleme yeterince güçlü olduğunda ortalama 400 baz puanın üzerindeki ERP'nin model içinde üretilebildiğini göstermektedir.
Ana yorum sınırı: Bu, yüksek ERP'nin gerçek dünyadaki tek mekanizmasının kanıtı değildir. Parametreler ve iki durumlu yapı model varsayımlarıdır; yazar da belirli tahminlerin yeniden değerlendirilmesi gerektiğini açıkça kabul eder.
Görsel yeniden yapılandırma: Şekil 2'nin uzun dönem varyans karşılaştırması, Şekil 3'ün çarpıklık–varyans çarpanı ilişkisi ve Şekil 5'in \(p\)–\(Q\)–\(r_p\) yapısı kaynak değerlerinden veya model denklemlerinden özgün Verianla grafikleri olarak yeniden kurulabilir. Şekil 6'nın rastgele 40 yıllık yolu için random seed verilmediğinden birebir yeniden çizim yapılmamalıdır.
Verianla Live: Denklem 8–10 için Live Equation, belief → valuation → volatility → risk premium geri beslemesi için Live Process ve parametrik karşılaştırmalar için Live Compare uygundur. Bilimsel parametreyi kullanıcıya değiştiren simülasyon arayüzü oluşturulmamalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir