


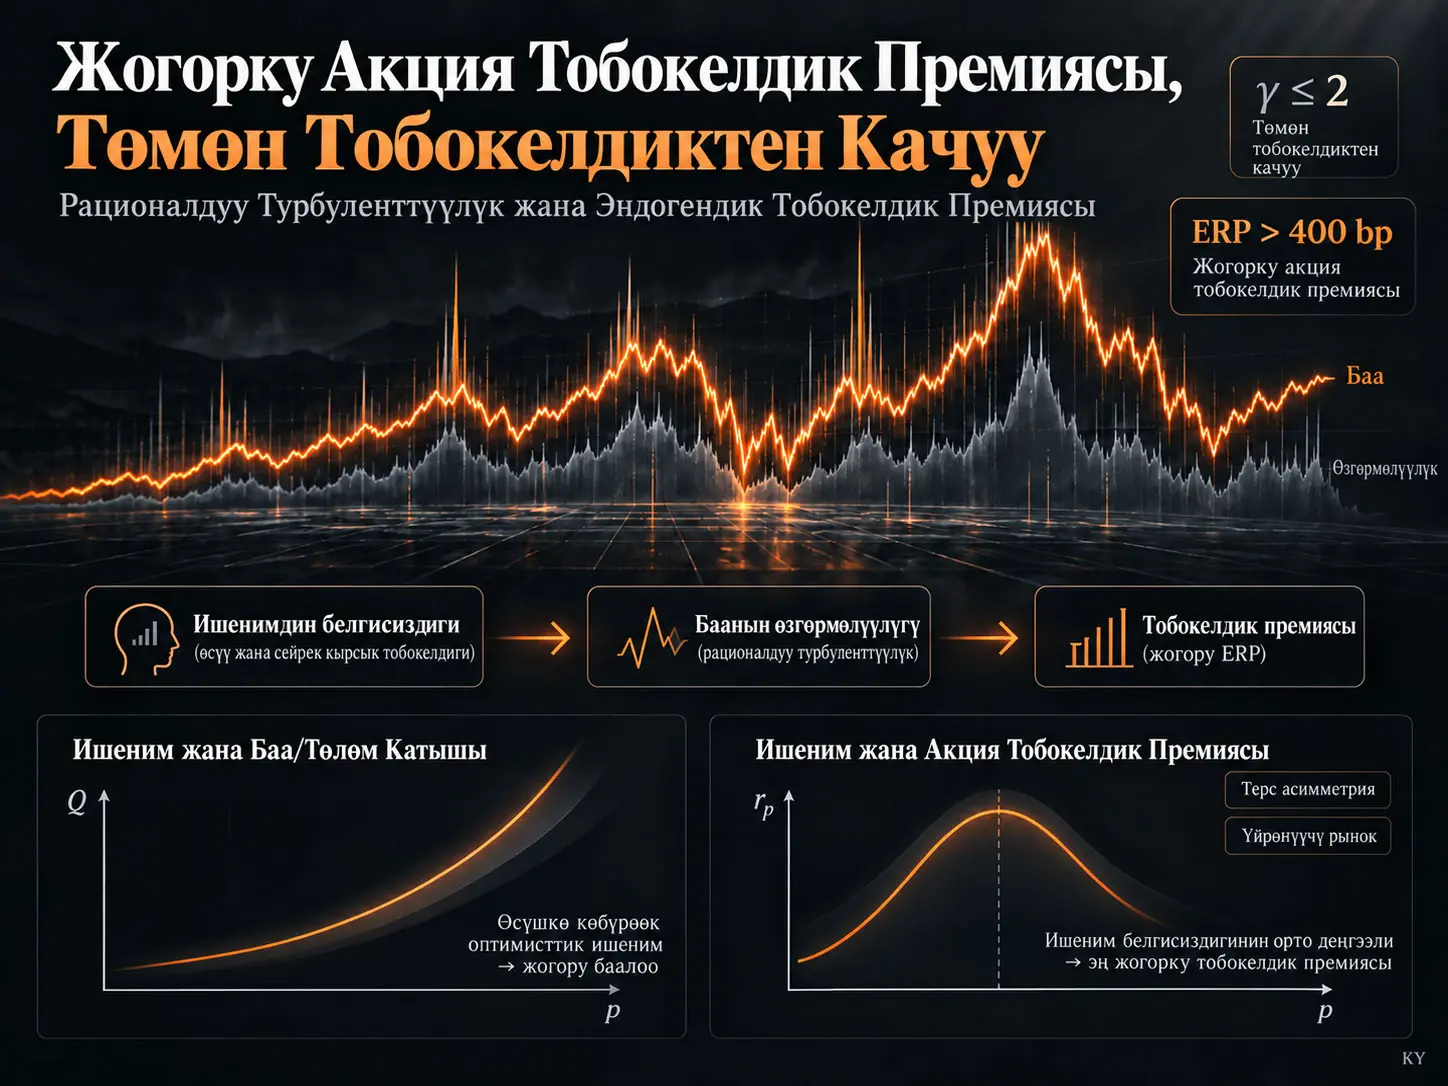
Акциялардын тобокелдик премиясы (Equity Risk Premium, ERP), инвесторлор тобокелсиз активдин ордуна акцияларды кармоо үчүн күткөн кошумча киреше. Kent Osbandдын изилдөөсү орточо ERPнин 400 базистик пункттан ашышын өтө жогорку салыштырмалуу тобокелдиктен качууну божомолдобостон түшүндүрүүгө аракет кылган теориялык жана эсептөөчү активдерди баалоо моделин иштеп чыгат. Модель акцияга инвестициялоону жалпы керектөөнү тегиздөөдөн бөлөт; инвесторлор өсүү тенденциясы жөнүндөгү ишенимдерин жаңы маалымат келген сайын Bayesian ыкмасы менен жаңыртат деп болжолдойт; тобокелдик премиясын ушул өзгөрүп турган ишенимдерге эндогендик түрдө байланыштырат жана сейрек кездешкен төмөн-өсүү режимдеринен келип чыккан күчтүү терс асимметрияны системага кошот.
Изилдөөнүн негизги ырастоосу — байкалган жогорку ERP сөзсүз түрдө \(\gamma\geq4\) сыяктуу жогорку салыштырмалуу тобокелдиктен качууну талап кылбайт. Натыйжалуу \(\gamma\) болжол менен 1,5–2 деңгээлинде болгондо, өсүү режиминдеги терс асимметрия жана өзгөрүп турган инвестор ишеними баа/төлөм катышынын жаңылыктар агымына сезимталдыгын күчөтүшү мүмкүн. Баанын өзгөрмөлүүлүгү өскөндө эндогендик тобокелдик премиясы да өсөт; жогорулаган дисконт чени баа функциясын дагы тик кылат. Автор бул өз ара күчөтүүнү “рационалдуу турбуленттүүлүк” деп атайт.
Өкүлчүлүктүү калибрлөөдө \((\sigma_B,\lambda,\gamma)=(0.06,1.0,2)\) алынганда орточо \(440\) базистик пункт тобокелдик премиясы; узак мөөнөттүү төлөм дисперсиясынын катышы \(\sigma_{LT}^2=120\) базистик пункт болгондо \(s=-3.5\), 130 базистик пунктта \(s=-3.0\), 157 базистик пунктта болсо \(s=-2.0\) асимметрия менен жаралышы мүмкүн. Бул жыйынтыктар түз байкалган рыноктук себептүүлүк эмес, моделдин көрсөтүлгөн параметрлердеги тең салмак жана симуляция жыйынтыктары.
Акциялардын тобокелдик премиясынын табышмагы деген эмне?
Акциялардын тобокелдик премиясынын табышмагы — акциялар тарыхый жактан тобокелсиз активдерге караганда кыйла жогорку киреше бергенине карабастан, стандарттуу керектөөгө негизделген моделдер бул айырманы байкалган үй чарба жүрүм-турумуна салыштырмалуу өтө жогору көрүнгөн тобокелдиктен качуу коэффициенттери менен гана түшүндүрө алган көйгөй.
Стандарттуу Merton байланышы
Изилдөө классикалык Merton портфель көйгөйүнөн башталат. Акциялардын оптималдуу салмагы:
\[ w=\frac{r_p}{\gamma\sigma^2} \tag{1} \]
түрүндө жазылат. Бул жерде \(w\) байлыктын акцияга инвестицияланган үлүшүн, \(r_p=\mu-\delta\) күтүлгөн акция тобокелдик премиясын, \(\mu\) күтүлгөн акция кирешесин, \(\delta\) тобокелсиз пайыздык ченди, \(\sigma^2\) салыштырмалуу кирешенин дисперсиясын жана \(\gamma\) туруктуу салыштырмалуу тобокелдиктен качуу коэффициентин (CRRA) көрсөтөт.
Өкүлчүлүктүү инвестор бүт рыноктук портфелди кармоого тийиш болгон тең салмакта \(w=1\) алынат жана:
\[ r_p=\gamma\sigma^2 \tag{2} \]
алынат. Эгер акциялар жалпы керектөөгө жазылган талап укугу катары каралса, керектөөнүн өзгөрмөлүүлүгүнүн төмөн болушу бул теңдиктин жогорку \(r_p\) жаратышы үчүн өтө чоң \(\gamma\) талап кылышына алып келет.
Булак 400 базистик пунктту негизги ERP өлчөмү катары колдонот. Бир базистик пункт 0,01 пайыздык пунктка барабар; демек, 400 базистик пункт болжол менен 4 пайыздык пункт премияны билдирет.
Керектөөдөн акция баасынын өзгөрмөлүүлүгүнө өтүү
Изилдөөнүн биринчи негизги кадамы — маржиналдык акция инвесторунун портфель чечимин түздөн-түз жалпы керектөөнүн өзгөрмөлүүлүгүнө байлабоо. Автор өзгөчө байлыгы жогору жана керектөөсү жетиштүү деңгээлде буферленген инвесторлор байлыктын калган бөлүгүн узак мөөнөттүү өсүү максатында quasi-Kelly стилинде башкара алат деп эсептейт.
Бул учурда (2)-теңдемедеги тиешелүү тобокелдик өлчөмү керектөөнүн өзгөрмөлүүлүгүнүн ордуна салыштырмалуу акция баасынын өзгөрмөлүүлүгү \(\zeta\) болот:
\[ r_p=\gamma\zeta^2. \tag{3} \]
Орточо тобокелдик премиясы үчүн маанилүү нерсе — орточо дисперсия:
\[ \langle\zeta^2\rangle = \langle\zeta\rangle^2+\operatorname{var}(\zeta). \tag{4} \]
Булакка ылайык S&P 500 үчүн кеңири колдонулган жылдык RMS өзгөрмөлүүлүк баалоолору %15–17 деңгээлинде. Бул \(\langle\zeta^2\rangle\) үчүн болжол менен 225–300 базистик пункттук дисперсия катышына туура келет. Мындай баа дисперсиясы (3)-теңдеме боюнча \(\gamma<2\) менен 400 базистик пункттан жогору ERP жаратышы мүмкүн.
Бирок бул көйгөйдү башка жерге гана жылдырат: төлөм же пайда агымы мынчалык өзгөрмөлүү болбосо, баа эмне үчүн мынчалык өзгөрмөлүү? Изилдөөнүн калган бөлүгү негизинен ушул ашыкча өзгөрмөлүүлүк табышмагын түшүндүрүүгө аракет кылат.
CRRA жана төмөн тобокелдиктен качуу аргументи
Стандарттуу убакыт боюнча кошулма күтүлгөн пайдалуулук:
\[ EU= \int_0^\infty u(c(t))e^{-\rho t}\,dt \tag{5} \]
жана CRRA пайдалуулук функциясы:
\[ u(c)=\frac{c^{1-\gamma}-1}{1-\gamma}, \qquad \gamma\geq0 \tag{6} \]
түрүндө; \(\gamma=1\) чегинде \(u(c)=\log c\) алынат.
Автор керектөө, камсыздандыруу, эмгек сунушу жана жыргалчылык адабиятындагы түрдүү баалоолорду колдонуп, реалисттик \(\gamma\) маанилери көбүнчө 1–2 айланасында топтолот деп ырастайт. Бул адабияттык обзор изилдөөнүн жаңы эмпирикалык баалоосу эмес; модель үчүн негизделген параметр аралыгы.
Kelly жана fractional Kelly эмне үчүн моделге кирет?
Kelly критерийи, узак мөөнөттө күтүлгөн log-байлыктын өсүшүн максималдаштырган коюм/инвестиция үлүшүн билдирет. Толук Kelly чакан модель каталарына жана чоң drawdownдарга карата агрессивдүү болушу мүмкүн. Анын белгилүү бир бөлүгүн колдонуу fractional Kelly деп аталат.
Булак толук Kelly коюм суммасынын \(f\) үлүшүн колдонуу болжол менен:
\[ \gamma\approx\frac{1}{f} \]
менен байланыштырыларын белгилейт. Ошого жараша half-Kelly, \(f=0.5\), натыйжалуу түрдө \(\gamma=2\)-ге туура келет. Автор профессионалдык инвестиция практикасында half-Kellyни этият эталондук чекит катары кабыл алып, моделдин негизги максатын \(\gamma=2\) менен 400 базистик пункттан жогору ERP өндүрүү деп аныктайт.
Бул жердеги \(\gamma\) бир гана психологиялык тобокелдиктен качуу эмес. Автор анын бир бөлүгү модель/параметр белгисиздигине каршы этият кыскартууну да чагылдырышы мүмкүн экенин ачык айтат жана эки компонентти өз-өзүнчө аныктоого аракет кылбайт.
Тарыхый төлөм өзгөрмөлүүлүгү канча?
Булактын 1-сүрөтү Robert Shillerдин S&P Composite катарындагы реалдуу жылдык дивиденддерди жана реалдуу пайдаларды 1871-жылдан тартып салыштырат. Графикте реалдуу пайдалар дивиденддерге караганда кыйла өзгөрмөлүү. Булак 1871–1950 мезгилинде дивиденддердин кыска мөөнөттүү өзгөрмөлүүлүгүн %6,4, 1951–2024 мезгилинде %2,3 деп берет. Пайданын кыска мөөнөттүү өзгөрмөлүүлүгү болсо айрым экстремалдуу жылдарды кошпогондо болжол менен %9,5.
Булактын 10-бетиндеги 1-сүрөт айрыкча 1950-жылдан кийинки дивиденд катарлары пайда катарына караганда кыйла көбүрөөк тегизделгенин көрсөтөт. Автор муну башкаруучулук dividend smoothing, технологиялык компаниялардын пайданы кайра инвестициялоого багыттоосу жана акцияларды кайра сатып алуунун кеңири жайылышы сыяктуу факторлор менен байланыштырат.
Узак мөөнөттүү дисперсия катышы
2-сүрөт реалдуу дивиденд жана пайда өсүшүнүн 20–40 жылдык терезелердеги дисперсия катыштарын көрсөтөт. Булакта бул аралыктагы орточо узак мөөнөттүү дисперсия катышы дивиденддер үчүн 46 базистик пункт, пайдалар үчүн 102 базистик пункт деп берилет.
| Өлчөө | Булактагы мааниси | Илимий ролу |
|---|---|---|
| Дивиденддин кыска мөөнөттүү өзгөрмөлүүлүгү, 1871–1950 | %6,4 | Тарыхый төлөм өзгөрмөлүүлүгү |
| Дивиденддин кыска мөөнөттүү өзгөрмөлүүлүгү, 1951–2024 | %2,3 | Дивиденддин тегизделишин көрсөтөт |
| Пайданын кыска мөөнөттүү өзгөрмөлүүлүгү | Болжол менен %9,5 | Дивидендге караганда жогорку төлөм тобокелдиги |
| 20–40 жылдык орточо дивиденд VR | 46 базистик пункт | Узак мөөнөттүү дисперсия катышы |
| 20–40 жылдык орточо пайда VR | 102 базистик пункт | Модель калибрлөөсүнүн негизги эмпирикалык таянычы |
Автор \(\gamma=2\) шартында болжол менен 400 базистик пункт ERP үчүн болжолдуу 200 базистик пункт тиешелүү баа дисперсиясы керек болгондуктан 102 базистик пункт пайда дисперсиясы дагы эле жетишсиз экенин баса белгилейт. Ошентип ERP табышмагы ашыкча баа өзгөрмөлүүлүгү табышмагына айланат.
“Рационалдуу турбуленттүүлүк” кантип пайда болот?
Рационалдуу турбуленттүүлүк — инвесторлор келечектеги төлөм өсүшүнүн тенденциясы тууралуу рационалдуу үйрөнүп жатканда ишеним белгисиздиги баа/төлөм катышын өзгөртүп, бул өзгөрүү баа өзгөрмөлүүлүгүн көбөйтүп, ал эми жогорулаган баа өзгөрмөлүүлүгү эндогендик тобокелдик премиясын дагы көбөйтүп, бааларды жаңылыктарга сезимталыраак кылган кайтарым байланыш механизми.
Стохастикалык drift модели
Моделде log төлөм \(x\)тин өсүү тенденциясы \(\mu\) туруктуу эмес. Drift белгилүү стохастикалык жаңылануу ылдамдыгы \(\lambda\) менен кайра тартылат. Эки абалдуу жөнөкөйлөтүүдө drift:
\[ \mu_H \quad \text{ve} \quad \mu_L \]
болуп, эки мүмкүн режимге ээ. \(p\) — инвестор жогорку-drift режими күчүндө экенине берген ыктымалдык. Кабыл алынган орточо drift:
\[ E=p\mu_H+(1-p)\mu_L \]
деп аныкталат.
Төлөмдөр ошондой эле \(\sigma_B\) чоңдугунда Brownian ызы-чуусун камтыйт.
Рационалдуу үйрөнүү теңдемеси
Эки режим шартында ишенимди жаңылоо булакта:
\[ dp= p(1-p)(\mu_H-\mu_L) \frac{dx-E\,dt}{\sigma_B^2} + \lambda(\pi_H-p)\,dt \tag{8} \]
түрүндө берилет.
Биринчи мүчө жаңы төлөм жаңылыгынын Bayesian таасири. Ишке ашкан \(dx\), күтүлгөн \(E\,dt\)-ден жогору болсо, жогорку-drift режимине берилген \(p\) ыктымалдыгы өсүүгө жакын болот; жаман жаңылык тескери багытта иштейт.
Экинчи мүчө drift режими келечекте reset болушу мүмкүн деген маалыматты камтыйт. \(\pi_H\) — resetтен кийин жогорку режимдин узак мөөнөттүү ыктымалдыгы; \(\lambda\) өскөн сайын учурдагы режим кыскараак жашайт деп күтүлөт.
Нормалдаштырылган инновация:
\[ dy=\frac{dx-E\,dt}{\sigma_B} \]
колдонулганда ишеним процессинин drift жана өзгөрмөлүүлүк мүчөлөрү:
\[ a(p)=\lambda(\pi_H-p) \]
жана:
\[ b(p)= p(1-p) \frac{\mu_H-\mu_L}{\sigma_B} \]
болот. \(p(1-p)\) туюнтмасы ишеним белгисиздиги борбордо эң жогору, \(p\) 0 же 1ге жакындаганда эң төмөн экенин көрсөтөт.
Баa/төлөм катышынын тең салмак теңдемеси
\(Q(p)\) — белгилүү \(p\) ишеними шартында баанын учурдагы төлөм агымына катышы. Булактагы адилет баалоо шарты:
\[ \left( \delta+r_p-E-\frac{1}{2}\sigma_B^2 \right)Q = 1+ (a+b\sigma_B)Q' + \frac{1}{2}b^2Q'' \tag{9} \]
түрүндө жазылат.
Сол жакта \(\delta+r_p\) дисконт чени, \(E+\sigma_B^2/2\) болсо күтүлгөн пайыздык төлөм өсүшү. Оң жакта нормалдаштырылган төлөм агымы \(1\), \(p\)деги күтүлгөн өзгөрүүдөн жаралган капитал өсүшү жана ишеним өзгөрмөлүүлүгүнүн баа ийри сызыгындагы сызыктуу/томпоктук таасирлери жайгашат.
Тобокелдик премиясы эндогендик болуп калат
Баанын өзгөрмөлүүлүгү төлөм ызы-чуусу \(\sigma_B\) менен эле чектелбейт. \(p\) өзгөргөндө \(Q(p)\) да өзгөрөт. Ошондуктан баалоо катышынын ишенимдерге сезимталдыгы кошумча баа өзгөрмөлүүлүгүн жаратат.
Булактын борбордук теңдиги:
\[ r_p = \gamma\zeta^2 = \gamma \left( \sigma_B+ b\frac{Q'}{Q} \right)^2 \tag{10} \]
түрүндө.
Бул теңдеме моделдин резонанс механизмин түз көрсөтөт. \(\frac{Q'}{Q}\) өскөндө бир эле ишеним шогу баада чоңураак пайыздык кыймыл жаратат. Бул \(\zeta\)ны жогорулатат. Жогорку \(\zeta\) ошол эле теңдеме аркылуу \(r_p\)ни жогорулатат. Тобокелдик премиясы кайра \(Q\)нун дисконт ченине киргендиктен баа ийри сызыгынын формасы да өзгөрөт.
Демек, тобокелдик премиясы сырттан берилген туруктуу параметр эмес; инвесторлордун белгисиздиги менен кошо моделдин ичинде өзгөрөт.
Терс асимметрия эмне үчүн тобокелдик премиясын мынчалык чоңойто алат?
Терс асимметрия сейрек режим төмөн өсүү режими болгон учурда инвесторлордун көпчүлүк убакта нормалдуу өсүүгө абдан ишенишине, бирок чакан катастрофа ыктымалдыгы боюнча күмөндөр \(Q(p)\) ийри сызыгын өзгөчө жогорку \(p\) аймагында тик кылышына алып келет; бул жаңылыктардын баага таасирин, баа дисперсиясын жана (10)-теңдеме аркылуу эндогендик тобокелдик премиясын күчтүү көбөйтөт.
Эки чекиттүү drift бөлүштүрүүсү
Эки drift абалынын ыктымалдыктары орточо \(m\), drift дисперсиясы \(\sigma_D^2\) жана асимметрия \(s\) менен параметрлештирилет:
\[ \pi_H = 1-\pi_L = \frac{1}{2} - \frac{1}{2} \frac{s}{\sqrt{s^2+4}}, \]
\[ \mu_H = m+\sigma_D\sqrt{\frac{\pi_L}{\pi_H}}, \qquad \mu_L = m-\sigma_D\sqrt{\frac{\pi_H}{\pi_L}}. \tag{11} \]
Терс \(s\) төмөн drift режимин сейрек, бирок оор төмөндөөчү абалга айлантат. Автордун негизги кызыгуусу дал ушул терс куйрук.
Green–Kubo байланышы жана узак мөөнөттүү тобокелдик
Моделде кыска мөөнөттүү Brownian ызы-чуусу менен убакыт боюнча өзгөргөн driftтин жалпы узак мөөнөттүү дисперсия катышы:
\[ \sigma_{LT}^2 = \sigma_B^2 + \frac{2\sigma_D^2}{\lambda} \tag{12} \]
түрүндө.
\(\sigma_B^2\) үзгүлтүксүз кыска мөөнөттүү төлөм ызы-чуусун билдирет. \(\sigma_D^2\) drift режимдеринин бөлүштүрүүсүнүн дисперсиясы. \(\lambda\) режимдин reset ылдамдыгы. Кичине \(\lambda\) driftтин узагыраак туруктуу болушун билдирет жана \(\frac{2\sigma_D^2}{\lambda}\) мүчөсүн чоңойтот. Демек, бирдей жылдык кыска мөөнөттүү өзгөрмөлүүлүктө узагыраак туруктуу drift өзгөрүүлөрү узак мөөнөттүү төлөм тобокелдигин жогорулатат.
Дисперсия көбөйткүчү
Изилдөө:
\[ \frac{\langle\zeta^2\rangle}{\sigma_{LT}^2} \]
катышын variance multiplier — дисперсия көбөйткүчү деп атайт. Бул катыш баа дисперсиясы негизги узак мөөнөттүү төлөм дисперсиясынан канчалык ашканын көрсөтөт.
3-сүрөттө \(\sigma_{LT}^2=100\) базистик пункт жана \(\gamma=2\) туруктуу кармалып, 25 ар башка \((\sigma_B,\lambda)\) комбинациясы каралат. \(\sigma_B\) жылдык %4–8, \(\lambda\) 0,4–1,2 арасында; бул болжол менен 2,5 жылдан 10 айга чейинки режим узактыгына туура келет.
| Асимметрия \(s\) | Булактын жыйынтыгы | Түшүндүрмө |
|---|---|---|
| \(s\geq-1\) | Эч бир комбинация дисперсия көбөйткүчүн 1,2ге жеткирбейт | Маанилүү ашыкча өзгөрмөлүүлүк пайда болбойт |
| \(s\) көбүрөөк терс болгондо | Дисперсия көбөйткүчү тез өсөт | Сейрек жаман режимдердин таасири күчөйт |
| \(s\leq-6\) | Дээрлик бардык комбинациялар >2; жарымынан көбү >3 | Баa дисперсиясы негизги төлөм дисперсиясынын бир нече эсесине жетиши мүмкүн |
Асимметрия эмне үчүн терс тарапта күчтүүрөөк?
Булак төрт механизмди бөлүп көрсөтөт. Биринчиден, \(|s|\) чоңойгон сайын эки drift абалынын ортосундагы \(\mu_H-\mu_L\) аралык чоңоёт жана ишеним жаңылыктарынын таасири күчөйт. Экинчиден, сейрек режим тууралуу байкоо азыраак болгондуктан белгисиздик жогору. Үчүнчүдөн, терс асимметрияда сейрек режим бир эле учурда начар өсүүнү да, жогорку белгисиздикти да билдирет; бул жогорку-\(p\) аймагындагы \(Q'\)ну кескин жогорулатат. Төртүнчүдөн, оң асимметрияда жогорку өсүү режими ошол эле учурда жогорку дисконт ченине туш болгондуктан \(Q\) көбүрөөк тегизделет.
4-сүрөттө \((\sigma_B,\lambda)=(0.05,0.8)\) болгондо \(s=0\) үчүн \(Q'\) болжол менен 0,13. \(s=-4\) болгондо, ишенимдердин болжол менен %90ы топтолгон аймакта \(Q'\) 0,75тен ашат. Бул айырма моделде жаңылыктардын баага таасирин кескин өзгөртөт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Сандык чечим
(9) жана (10)-теңдемелер жабык формадагы аналитикалык чечимге ээ эмес. Булак эки өзүнчө finite-difference алгоритмин колдонот.
Биринчи алгоритм \(p\)ни 4.000 чекиттүү uniform gridүстүндө дискреттештирет. \(Q'\) жана \(Q''\) стандарттуу акыркы айырмалар менен болжолдуу эсептелет. Дифференциалдык операторлор сейрек үч-диагоналдуу generator матрицасына айландырылат. \(r_p\), \(Q\)га эндогендик байланышкандыктан чечим итеративдүү:
- Убактылуу \(r_p\) туруктуу кармалат.
- Дискреттүү теңдеме чечилип, жаңы \(Q\) алынат.
- (10)-теңдеме менен \(r_p\) кайра эсептелет.
- Бардык \(p\) маанилери үчүн \(Q\) жакындаганча процесс кайталанат.
Экинчи алгоритм:
\[ y=\log\left(\frac{p}{1-p}\right) \]
log-odds/Lamperti өзгөртүүсүн колдонот. Бул өзгөртүү \(p\approx0\) жана \(p\approx1\) четтеринде жогорку сандык чечилишти камсыздайт жана state volatilityни туруктуу:
\[ \beta=\frac{\mu_H-\mu_L}{\sigma_B} \]
маанисине айлантат. Булак экинчи ыкма четки баштапкы шарттарда туруктуураак жана тезирээк жакындай турганын, бирок биринчи алгоритм менен негизинен бирдей жыйынтыктарды берерин билдирет. Бул чечим сандык ыкмага ашыкча көз каранды эмес экенин текшерет.
Узак мөөнөттүү дисперсия баалоосунун Monte Carlo текшерүүсү
Булак S&P пайда катарынан өлчөнгөн болжол менен 100 базистик пункт узак мөөнөттүү дисперсия катышы чыныгы \(\sigma_{LT}^2\)ни төмөн баалашы мүмкүн экенин изилдейт. Бул үчүн ар бири тарыхый маалымат менен бирдей узундукта болгон 154 жылдык 2.500 Monte Carlo симуляциясын жүргүзөт.
Симуляцияларда 20–40 жылдык дисперсия-катыш баалоолору күтүлгөндөн кыйла ызы-чуулуу экени табылат. Булак standard error баалоонун орточо маанисинин болжол менен %85и экенин билдирет.
| Этап | Жыйынтык | Булактын түшүндүрмөсү |
|---|---|---|
| Тарыхый пайда VR орточосу | ≈100 базистик пункт | Чийки узак мөөнөттүү өлчөм |
| Working таасирин оңдоо | ≈111 базистик пункт | Симуляцияларда болжол менен %8 төмөн багыттагы bias |
| Median ыкмасы | ≈147 базистик пункт | Симуляция medianы орточонун болжол менен %75и |
| Жогорку %10у кесилген орточо ыкмасы | ≈142 базистик пункт | Кесилген орточо толук орточонун болжол менен %78и |
| Автордун практикалык кыскача жыйынтыгы | \(\sigma_{LT}\approx12\%\) | Болжол менен 10% чийки, 10,5% Working оңдоосу менен; жогорураак чыныгы маани ыктымалдуу |
Автор жогорку белгисиздиктен улам \(\sigma_{LT}^2\)нин так маанисин ырастабайт; болжол менен 80–160 базистик пункт аралыгын негиздүү деп эсептейт.
Асимметрия үчүн эмпирикалык текшерүү
Чыныгы жылдык S&P төлөм өсүшүнүн тандалма асимметриясы дивиденддерде −0,57, пайдаларда −0,82. Автор кыска мөөнөттүү mean-reverting компоненттер жана Brownian ызы-чуусу байкалган асимметрияны басаңдаткандыктан негизги drift бөлүштүрүүсүндөгү чыныгы \(s\) көбүрөөк терс болушу мүмкүн деп эсептейт.
Бирок булак бул жерде ачык дал келбестикти да билдирет. Чыныгы айлык S&P кирешелеринин асимметриясы −0,37 жана модель \(s=-3\) айланасында айлык маанини болжол менен кармай алат. Ал эми моделдин жылдык киреше асимметриясы көп учурда −1ден төмөн калат, чыныгы S&P жылдык мааниси болсо болжол менен −0,44. Автор бул дал келбестикти чече албаганын ачык белгилейт.
440 базистик пункт ERP үчүн параметр комбинациялары
Булактын негизги симуляция топтомунда:
\[ (\sigma_B,\lambda,\gamma)=(0.06,1.0,2) \]
алынат жана орточо:
\[ \langle r_p\rangle=440\text{ baz puan} \]
максатталат.
| \(\sigma_{LT}^2\) | Керектүү \(s\) | Түшүндүрмө |
|---|---|---|
| 110 базистик пункт | −4,0 | Төмөнүрөөк негизги төлөм дисперсиясы оорураак терс куйрукту талап кылат |
| 120 базистик пункт | −3,5 | Негизги кеңири симуляцияда колдонулган маани |
| 130 базистик пункт | −3,0 | Жумшагыраак терс асимметрия жетиштүү болот |
| 157 базистик пункт | −2,0 | Жогорку негизги узак мөөнөттүү дисперсияда азыраак экстремалдуу асимметрия жетиштүү |
Бул чечимдер жараткан баа өзгөрмөлүүлүгү үчүн булак \(RMS(\zeta)=14,8\%\) деп билдирет. Бул маани автор шилтеме берген салттуу S&P %15–17 диапазонунун төмөнкү четине жакын.
Кеңири өкүлчүлүктүү чечим
Булак кененирээк талдоо үчүн:
\[ (\sigma_{LT}^2,s,\sigma_B,\lambda,\gamma) = (0.012,-3.5,0.06,1.0,2) \]
параметрлерин тандайт.
Бул чечимде жогорку-drift режимине ишеним көп учурда абдан жогору. Stationary distribution үчүн:
- \(p>0.99\) ыктымалдыгы болжол менен %50,
- \(p<0.50\) ыктымалдыгы болжол менен %4,9,
- \(p<0.10\) ыктымалдыгы болжол менен %1,5.
Ошого карабастан, бул сейрек күмөн мезгилдер баалоого өтө чоң таасир берет.
5-сүрөт — ишеним, баа/төлөм катышы жана тобокелдик премиясы
Булактын PDFинин 21-бетиндеги 5-сүрөттө горизонталдык ок жогорку өсүү режимине ишеним \(p\). Сол вертикалдык ок баа/төлөм катышы \(Q\), оң вертикалдык ок тобокелдик премиясы \(r_p\)ни базистик пункт менен көрсөтөт.
\(Q\) болжол менен 35тен 50гө чейин өсөт жана орточосу болжол менен 48. \(p>0.8\) аймагы убакыттын болжол менен %90ын камтыйт; бул жерде log-сызыктуу \(Q\) жакындашуусунун шайкештиги \(R^2=0.999\).
| Ишеним \(p\) | \(r_p\) |
|---|---|
| Чектер \(p\to0\) же \(p\to1\) | Болжол менен 72 базистик пункттук база |
| \(p=0.99\) | 156 базистик пункт |
| \(p=0.95\) | 692 базистик пункт |
| \(0.36<p<0.84\) | 2500 базистик пункттан жогору |
| Чоку | 4000 базистик пункттан бир аз жогору |
Булактын негизги механизми бул жерде ачык көрүнөт: тобокелдик премиясы рынок жаман режим анык деп ишенгенде эмес, кайсы режимде турганын эң көп суроого алган аралык аймакта эң жогорку деңгээлге чыгат.
6-сүрөт — 40 жылдык симуляция
Булактын PDFинин 22-бетиндеги 6-сүрөт ошол эле моделден чыгарылган 40 жылдык \(Q\) жана баа өзгөрмөлүүлүгү \(\zeta\) жолун көрсөтөт. Өзгөрмөлүүлүк 21 күндүк мезгилге туура келген экспоненциалдык кыймылдуу орточо дисперсиянын квадраттык тамыры менен тегизделген.
Симуляцияда узак тынч мезгилдер кыска паника мезгилдери менен үзүлөт; баалоолор кээде тез төмөндөйт жана көпчүлүк төмөндөөлөр тез калыбына келгени менен айрымдары узагыраак созулат. Өзгөрмөлүүлүк жакшы убакта төмөн, жаман мезгилдерде жогору жана өзү да күчтүү өзгөрмөлүү.
Бирок бул сүрөт моделдин негизги кемчиликтеринин бирин да көрсөтөт. \(p\) көп учурда 1ге абдан жакын болгондуктан \(\zeta\) тынч мезгилдерде \(\sigma_B\)ге чейин төмөндөшү мүмкүн. Булак бул базанын чыныгы S&Pде байкалган %10дон жогорку типтүү өзгөрмөлүүлүк базасынан өтө төмөн экенин жана бул эки-режимдүү моделдин артефакты экенин ачык белгилейт. Автор байыраак көп-абалдуу моделдер бул көйгөйдү азайтышы мүмкүн экенин жана муну кийинки ишке калтырарын айтат.
Изилдөө колдогон жана колдобогон жыйынтыктар
| Изилдөө колдойт | Изилдөө өз алдынча колдобойт |
|---|---|
| Төмөн натыйжалуу тобокелдиктен качуу менен жогорку ERP белгилүү бир рационалдуу үйрөнүү модели ичинде чогуу жаралышы мүмкүн. | Чыныгы рынок инвесторлорунун баарында \(\gamma=2\) деген жыйынтык. |
| Терс drift асимметриясы, ишеним белгисиздиги жана эндогендик дисконт чени күчтүү ашыкча баа өзгөрмөлүүлүгүн жаратышы мүмкүн. | Бардык тарыхый фондулук рынок кыйроолору ушул механизм менен гана түшүндүрүлөт деген жыйынтык. |
| Модель 400 базистик пункттан жогорку орточо тобокелдик премиясын жана рынокко окшош өзгөрмөлүүлүк кластерлешүүсүн жаратышы мүмкүн. | Бул модель келечектеги S&P кирешелерин же кризис даталарын болжолдойт деген жыйынтык. |
| Узак мөөнөттүү пайда дисперсиясы стандарттуу тарыхый баалоолордон жогору болушу мүмкүн. | Чыныгы \(\sigma_{LT}^2\) так 140 же 157 базистик пункт деген жыйынтык. |
| Эки сандык чечим алгоритми негизинен бирдей жыйынтыктарды берет. | Модель спецификациясы жалгыз туура экономикалык модель деген жыйынтык. |
| Рационалдуу үйрөнүү жүрүм-турумдук “irrational exuberance” көрүнүшүнө окшогон баа кыймылдарын жаратышы мүмкүн. | Жүрүм-турумдук жаңылыштыктар чыныгы рыноктордо маанисиз же жок деген жыйынтык. |
Күчтүү жактары
- ERP табышмагы менен excess-volatility табышмагын бир механизм алдында байланыштырышы.
- Тобокелдик премиясын туруктуу параметр катары берүүнүн ордуна ишеним белгисиздигинен эндогендик жаратышы.
- Рационалдуу үйрөнүү, сейрек катастрофалар, fractional Kelly жана убакыт боюнча өзгөргөн дисконт ченин бир моделде бириктириши.
- Модель чечимин эки башка сандык алгоритм менен текшериши.
- Узак мөөнөттүү дисперсия баалоосунун белгисиздигин 2.500 Monte Carlo симуляциясы менен изилдеши.
- Жылдык киреше асимметриясы сыяктуу моделге туура келбеген табылганы ачык билдириши.
Негизги чектөөлөр
Эки абал чектөөсү: Модель өсүү driftин жогорку жана төмөн деген эки гана режимге бөлөт. Ошондуктан катастрофа алынып салынганда учурдагы drift тууралуу калган чыныгы дүйнө белгисиздиги жасалма түрдө өтө аз болуп калышы мүмкүн.
Кыска мөөнөттүү mean reversion сыртта: Булак чыныгы төлөмдөрдө чоң mean-reverting компоненттер бар экенин кабыл алат, бирок модель аларды түз камтыбайт. Инвесторлор аларды туруктуу drift жаңылыгынан ажырата алат деп болжолдонот.
Структуралык параметр маалыматы: Инвесторлор \(\{\mu,\pi,\lambda\}\) структуралык параметрлерин билет деп болжолдонот. Чыныгы эпистемикалык белгисиздик кеңири.
\(\gamma\)нын бириккен чечмелөөсү: \(\gamma\) таза психологиялык тобокелдиктен качуу менен модель белгисиздигине каршы этият fractional-Kelly кыскартууну бири-биринен ажыратпайт.
Дисперсия баалоосунун жогорку белгисиздиги: 154 жылдык тарыхый үлгү да узак мөөнөттүү дисперсияны тар ишеним интервалы менен аныктоо үчүн жетишсиз; симуляция standard errorу абдан чоң.
Асимметрия дал келбестиги: Модель айлык киреше асимметриясын болжол менен кармаса да, жылдык киреше асимметриясын чыныгы S&Pге салыштырмалуу өтө терс жаратышы мүмкүн. Булак бул көйгөйдү чечилбеген бойдон калтырат.
Симуляция ≠ болжол: 40 жылдык баа жолдору моделдин жүрүм-турумун көрсөтөт; келечектеги рынок жолунун болжолу эмес.
Булак жана Ыкма Жөнүндө Эскертүү
Түп нускадагы изилдөө: Reconciling High Equity Risk Premia with Low Risk Aversion.
Автор: Kent Osband.
PDF датасы: July 2026.
PDFдеги байланыш маалыматы: kosband@risktick.com.
Мекеме/аффилиация: Жүктөлгөн PDFтин титулдук бетинде институционалдык аффилиация көрсөтүлгөн эмес.
Ыраазычылык: Автор пайдалуу пикирлери үчүн John Cochraneга ыраазычылык билдирет.
Ачкыч сөздөр: equity risk premium; drift uncertainty; risk aversion; Kelly criterion; asset pricing.
JEL: G12, D81, D53.
Булак түрү: Теориялык жана эсептөөчү активдерди баалоо изилдөөсү; тарыхый S&P маалыматтарын жана Monte Carlo/модель симуляцияларын колдонот.
Рецензия статусу: PDFте рецензияланган журнал, том, сан же басмакана маалыматы жок. Рецензияланган акыркы журнал версиясы көз карандысыз түрдө ырасталган жок; ошондуктан изилдөө Verianlaда рецензияланган макала катары классификацияланбашы керек.
DOI: Экинчи даражадагы ResearchGate библиографиялык жазуусу 10.2139/ssrn.6185899 көрсөтөт. Ошол эле DOIнин расмий SSRN барагы бул текшерүү учурунда жеткиликтүү издөө натыйжасы катары табылган жок, ошондуктан DOI “экинчи metadata менен ырасталган, расмий жазуу менен толук тастыкталган эмес” статусунда сакталышы керек.
Дата айырмасы: ResearchGate ошол эле аталыш үчүн January 2026 датасын көрсөтөт, ал эми жүктөлгөн PDF July 2026 датасын алып жүрөт. Verianla илимий мазмуну үчүн жүктөлгөн PDF версиясы source-of-truth катары колдонулган.
Лицензия: Жүктөлгөн PDFте ачык Creative Commons же башка кайра колдонуу лицензиясы көрсөтүлгөн эмес. Толук версиянын расмий лицензиясы ырасталбагандыктан булактагы сүрөттөр сөзмө-сөз кайра колдонулбашы керек.
Каржылоо: Жүктөлгөн PDFте өзүнчө каржылоо билдирүүсү жок.
Кызыкчылыктардын кагылышы: Жүктөлгөн PDFте өзүнчө кызыкчылыктардын кагылышы тууралуу билдирүү жок. Ошондуктан “кызыкчылыктардын кагылышы жок” деген жыйынтык болжолдонгон эмес.
Маалыматтын жеткиликтүүлүгү: Өзүнчө Data Availability бөлүмү жок. Тарыхый S&P дивиденд, пайда жана киреше талдоолору Robert Shillerдин онлайн маалымат катарына негизделет; булак ошондой эле BEA жана Federal Reserve катарларына шилтеме берет.
Негизги ыкма: CRRA/Merton тобокелдик премиясынын алкагы; fractional-Kelly чечмелөөсү; эки абалдуу стохастикалык payout-drift модели; Wonham тибиндеги үзгүлтүксүз-убакыт Bayesian filtering; эндогендик тобокелдик премиясы жана price-to-payout тең салмак дифференциалдык теңдемеси; finite-difference numerical solution; log-odds/Lamperti альтернативдүү чечими; stationary distribution; Green–Kubo узак мөөнөттүү дисперсия эсеби; параметр сезимталдыгы; 2.500 Monte Carlo симуляциясы.
Негизги илимий жыйынтык: Булак \(\gamma\leq2\) деңгээлиндеги натыйжалуу тобокелдиктен качууда да терс drift асимметриясы, рационалдуу үйрөнүү жана эндогендик дисконт ченинин ортосундагы кайтарым байланыш жетиштүү күчтүү болгондо модель ичинде орточо 400 базистик пункттан жогорку ERP өндүрүлүшү мүмкүн экенин көрсөтөт.
Негизги чечмелөө чеги: Бул жогорку ERPнин чыныгы дүйнөдөгү жалгыз механизми экенинин далили эмес. Параметрлер жана эки абалдуу түзүлүш модель божомолдору; автор да айрым баалоолор кайра каралышы керек экенин ачык кабыл алат.
Визуалдык кайра куруу: 2-сүрөттүн узак мөөнөттүү дисперсия салыштыруусу, 3-сүрөттүн асимметрия–дисперсия көбөйткүчү байланышы жана 5-сүрөттүн \(p\)–\(Q\)–\(r_p\) түзүлүшү булак маанилеринен же модель теңдемелеринен оригиналдуу Verianla графиктери катары кайра курулушу мүмкүн. 6-сүрөттүн кокустук 40 жылдык жолу үчүн random seed берилбегендиктен, сөзмө-сөз кайра чийилбеши керек.
Verianla Live: 8–10 теңдемелер үчүн Live Equation, belief → valuation → volatility → risk premium кайтарым байланышы үчүн Live Process жана параметрдик салыштыруулар үчүн Live Compare ылайыктуу. Колдонуучуга илимий параметрди өзгөртүүгө мүмкүндүк берген симуляция интерфейси түзүлбөшү керек.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген