


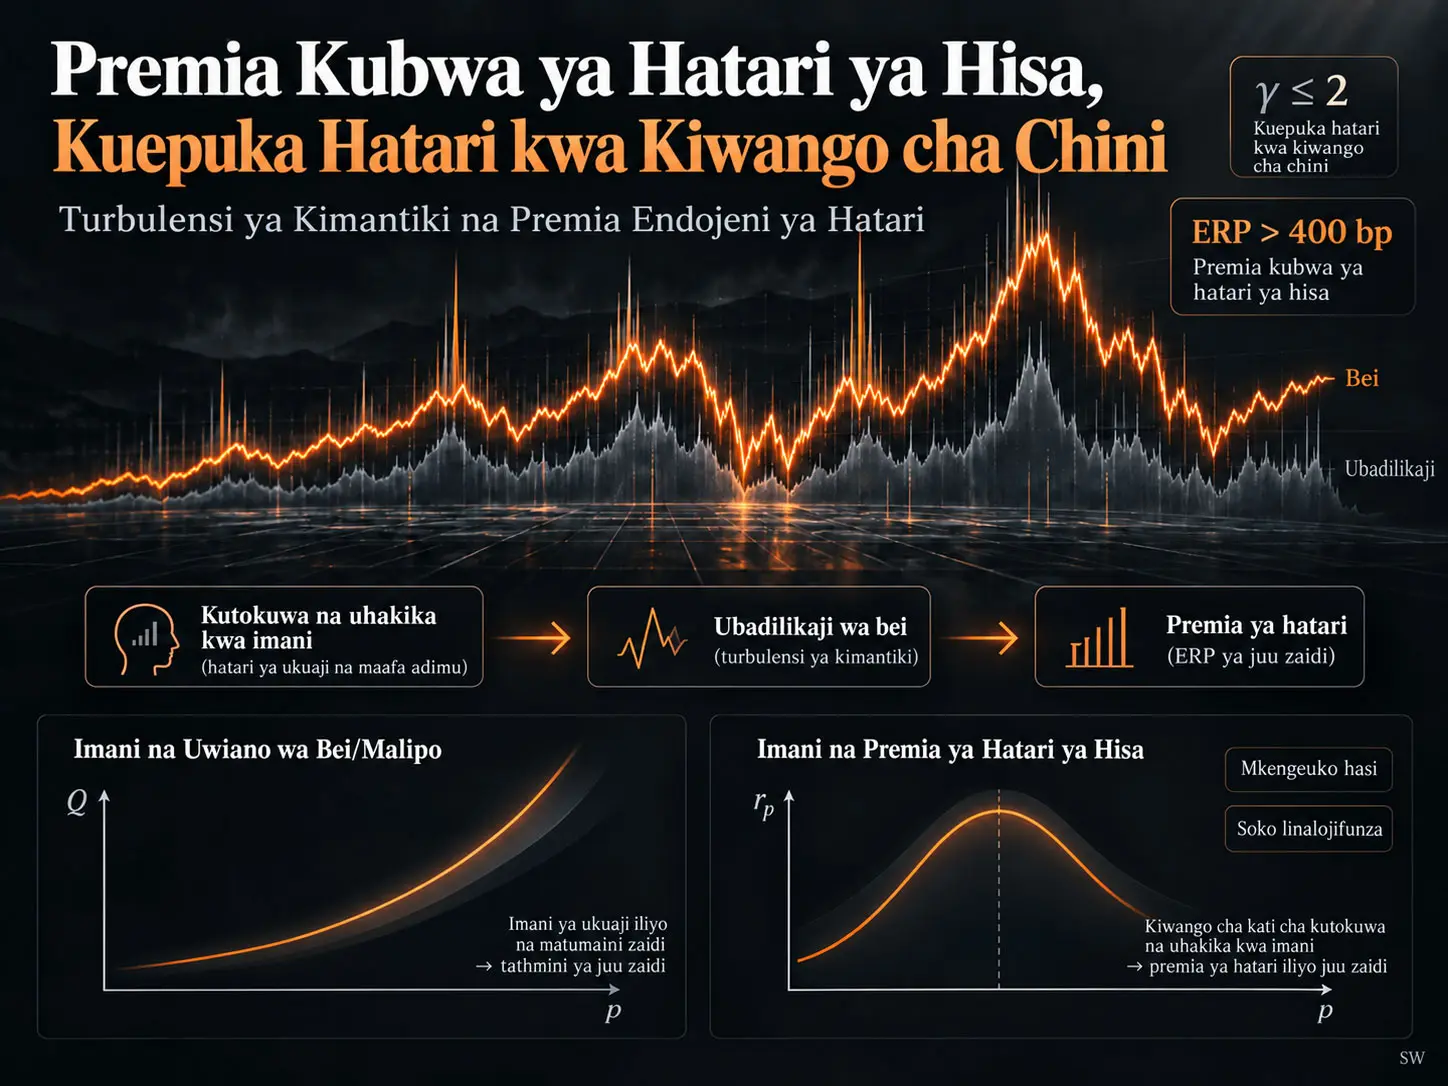
Premia ya Hatari ya Hisa (Equity Risk Premium, ERP), ni mapato ya ziada ambayo wawekezaji hutarajia ili kushikilia hisa badala ya mali isiyo na hatari. Utafiti wa Kent Osband unatengeneza modeli ya kinadharia na ya kihesabu ya uwekaji bei wa mali inayojaribu kueleza jinsi ERP ya wastani inaweza kuzidi pointi msingi 400 bila kudhani kiwango cha juu sana cha kuepuka hatari kwa uwiano. Modeli hutenganisha uwekezaji wa hisa na ulainishaji wa jumla wa matumizi; hudhani kwamba wawekezaji husasisha imani zao kuhusu mwelekeo wa ukuaji kwa njia ya Bayesian kadiri taarifa mpya zinavyowasili; huunganisha premia ya hatari kwa namna ya ndani na imani hizi zinazobadilika, na huingiza skewness hasi yenye nguvu inayotokana na rejimu nadra za ukuaji mdogo.
Dai kuu la utafiti ni kwamba ERP ya juu inayozingatiwa si lazima ihitaji kiwango kikubwa cha kuepuka hatari kwa uwiano kama \(\gamma\geq4\). Wakati \(\gamma\) yenye ufanisi iko takriban katika kiwango cha 1,5–2, skewness hasi katika rejimu ya ukuaji na imani ya wawekezaji inayobadilika inaweza kuongeza unyeti wa uwiano wa bei/malipo kwa mtiririko wa habari. Volatiliti ya bei inapoongezeka, premia ya hatari ya ndani pia huongezeka; kiwango cha punguzo kinachoongezeka hufanya fungsi ya bei kuwa yenye mteremko mkali zaidi. Mwandishi anaita uimarishaji huu wa pande mbili “msukosuko wa kimantiki”.
Katika urekebishaji wakilishi, \((\sigma_B,\lambda,\gamma)=(0.06,1.0,2)\) unapochukuliwa, premia ya hatari ya wastani ya \(440\) pointi msingi inaweza kuzalishwa; ikiwa uwiano wa variansi ya malipo ya muda mrefu ni \(\sigma_{LT}^2=120\) pointi msingi kwa \(s=-3.5\), pointi msingi 130 kwa \(s=-3.0\), na pointi msingi 157 kwa \(s=-2.0\). Matokeo haya si uhusiano wa kisababishi wa soko uliotazamwa moja kwa moja, bali ni matokeo ya usawa na uigaji wa modeli chini ya vigezo vilivyotajwa.
Kitendawili cha premia ya hatari ya hisa ni nini?
Kitendawili cha premia ya hatari ya hisa ni tatizo kwamba, ingawa kihistoria hisa zimeleta mapato makubwa zaidi kuliko mali zisizo na hatari, modeli za kawaida zinazotegemea matumizi zinaweza kueleza tofauti hii tu kwa kutumia vigawo vya kuepuka hatari vinavyoonekana kuwa vya juu kupita kiasi ukilinganisha na tabia ya kaya inayozingatiwa.
Uhusiano wa kawaida wa Merton
Utafiti huanza na tatizo la kawaida la jalada la Merton. Uzito bora wa hisa ni:
\[ w=\frac{r_p}{\gamma\sigma^2} \tag{1} \]
Hapa \(w\) ni sehemu ya utajiri iliyowekezwa katika hisa, \(r_p=\mu-\delta\) ni premia ya hatari ya hisa inayotarajiwa, \(\mu\) ni mapato ya hisa yanayotarajiwa, \(\delta\) ni kiwango cha riba kisicho na hatari, \(\sigma^2\) ni variansi ya mapato ya uwiano, na \(\gamma\) ni mgawo wa kudumu wa kuepuka hatari kwa uwiano (CRRA).
Katika usawa ambao mwekezaji wakilishi anapaswa kushikilia jalada lote la soko, \(w=1\) huchukuliwa na:
\[ r_p=\gamma\sigma^2 \tag{2} \]
hupatikana. Ikiwa hisa zinachukuliwa kama dai juu ya matumizi ya jumla, volatiliti ndogo ya matumizi husababisha usawa huu kuhitaji \(r_p\) kubwa, jambo ambalo nalo huhitaji \(\gamma\) kubwa sana.
Chanzo hutumia pointi msingi 400 kama kipimo cha msingi cha ERP. Pointi msingi moja ni pointi ya asilimia 0,01; hivyo pointi msingi 400 ni takriban premia ya pointi 4 za asilimia.
Kutoka matumizi hadi volatiliti ya bei ya hisa
Hatua ya kwanza kuu ya utafiti ni kutounganisha moja kwa moja uamuzi wa jalada wa mwekezaji wa pembezoni wa hisa na volatiliti ya matumizi ya jumla. Mwandishi anasema kwamba hasa wawekezaji wenye utajiri mkubwa na matumizi yaliyokingwa vya kutosha wanaweza kusimamia sehemu iliyobaki ya utajiri kwa lengo la ukuaji wa muda mrefu kwa mtindo wa quasi-Kelly.
Katika hali hii, kipimo husika cha hatari katika mlinganyo (2) huwa volatiliti ya bei ya hisa kwa uwiano \(\zeta\), badala ya mabadiliko ya matumizi:
\[ r_p=\gamma\zeta^2. \tag{3} \]
Kwa premia ya hatari ya wastani, kinachohusika ni variansi ya wastani:
\[ \langle\zeta^2\rangle = \langle\zeta\rangle^2+\operatorname{var}(\zeta). \tag{4} \]
Kwa mujibu wa chanzo, makadirio ya kawaida ya volatiliti ya kila mwaka ya RMS kwa S&P 500 yako katika kiwango cha %15–17. Hii inalingana na uwiano wa variansi wa takriban pointi msingi 225–300 kwa \(\langle\zeta^2\rangle\). Variansi ya bei ya kiwango hiki inaweza kuzalisha ERP ya zaidi ya pointi msingi 400 chini ya mlinganyo (3) kwa \(\gamma<2\).
Lakini hili huhamisha tu tatizo mahali pengine: ikiwa mkondo wa malipo au faida si wenye volatiliti kubwa kiasi hiki, kwa nini bei ni tete kiasi hiki? Sehemu iliyobaki ya utafiti inajaribu hasa kueleza kitendawili cha volatiliti kupita kiasi.
CRRA na hoja ya kuepuka hatari kwa kiwango cha chini
Faida-tarajiwa ya kawaida inayojumlishwa kwa muda:
\[ EU= \int_0^\infty u(c(t))e^{-\rho t}\,dt \tag{5} \]
na fungsi ya faida ya CRRA:
\[ u(c)=\frac{c^{1-\gamma}-1}{1-\gamma}, \qquad \gamma\geq0 \tag{6} \]
huchukua umbo hili; katika kikomo cha \(\gamma=1\), \(u(c)=\log c\) hupatikana.
Mwandishi, akitumia makadirio mbalimbali katika fasihi ya matumizi, bima, ugavi wa kazi na ustawi, anasema kuwa thamani halisi za \(\gamma\) mara nyingi hukusanyika karibu na 1–2. Mapitio haya ya fasihi si makadirio mapya ya kiempiria ya utafiti; ni safu ya vigezo inayohalalishwa kwa ajili ya modeli.
Kwa nini Kelly na fractional Kelly vinaingia katika modeli?
Kigezo cha Kelly, kinaeleza sehemu ya dau/uwekezaji inayoongeza hadi kiwango cha juu ukuaji unaotarajiwa wa log-utajiri kwa muda mrefu. Kelly kamili inaweza kuwa kali dhidi ya makosa madogo ya modeli na drawdown kubwa. Kutumia sehemu fulani yake huitwa fractional Kelly.
Chanzo kinaeleza kwamba kutumia sehemu \(f\) ya kiasi cha dau cha Kelly kamili kunaweza kuhusishwa takriban na:
\[ \gamma\approx\frac{1}{f} \]
Kwa hiyo half-Kelly, \(f=0.5\), kwa ufanisi inalingana na \(\gamma=2\). Mwandishi anachukua half-Kelly kama rejea ya tahadhari katika mazoezi ya kitaalamu ya uwekezaji na kuweka lengo kuu la modeli kuwa kuzalisha ERP ya zaidi ya pointi msingi 400 kwa \(\gamma=2\).
\(\gamma\) hapa si kuepuka hatari kwa upande wa kisaikolojia pekee. Mwandishi anaeleza wazi kwamba sehemu yake inaweza pia kuwakilisha upunguzaji wa tahadhari dhidi ya kutokuwa na uhakika wa modeli/kigezo, na hajaribu kutambua vipengele hivyo viwili kila kimoja peke yake.
Volatiliti ya kihistoria ya malipo ni kiasi gani?
Kielelezo 1 cha chanzo kinalinganisha gawio halisi la kila mwaka na faida halisi kutoka mfululizo wa S&P Composite wa Robert Shiller tangu 1871. Kwenye grafu, faida halisi ni tete zaidi kuliko gawio. Chanzo kinatoa volatiliti ya muda mfupi ya gawio kuwa %6,4 katika 1871–1950 na %2,3 katika 1951–2024. Volatiliti ya muda mfupi ya faida ni takriban %9,5, isipokuwa miaka fulani ya kipekee.
Kielelezo 1 kwenye ukurasa wa 10 wa chanzo kinaonyesha kwamba hasa baada ya 1950 mfululizo wa gawio umelainishwa kwa kiwango kikubwa zaidi kuliko mfululizo wa faida. Mwandishi anahusisha hili na mambo kama dividend smoothing ya usimamizi, kampuni za teknolojia kuelekeza tena faida kwenye uwekezaji, na kuenea kwa ununuzi wa hisa wenyewe.
Uwiano wa variansi ya muda mrefu
Kielelezo 2 kinaonyesha uwiano wa variansi wa ukuaji halisi wa gawio na faida katika madirisha ya miaka 20–40. Chanzo kinaripoti kwamba uwiano wa wastani wa variansi ya muda mrefu katika kipindi hiki ni pointi msingi 46 kwa gawio na pointi msingi 102 kwa faida.
| Kipimo | Thamani ya chanzo | Jukumu la kisayansi |
|---|---|---|
| Volatiliti ya muda mfupi ya gawio, 1871–1950 | %6,4 | Mabadiliko ya kihistoria ya malipo |
| Volatiliti ya muda mfupi ya gawio, 1951–2024 | %2,3 | Huonyesha ulainishaji wa gawio |
| Volatiliti ya muda mfupi ya faida | Takriban %9,5 | Hatari ya malipo iliyo juu kuliko gawio |
| VR ya wastani ya gawio ya miaka 20–40 | pointi msingi 46 | Uwiano wa variansi ya muda mrefu |
| VR ya wastani ya faida ya miaka 20–40 | pointi msingi 102 | Msingi mkuu wa kiempiria wa urekebishaji wa modeli |
Mwandishi anasisitiza kwamba kwa \(\gamma=2\), ERP ya takriban pointi msingi 400 inahitaji karibu pointi msingi 200 za variansi husika ya bei, hivyo variansi ya faida ya pointi msingi 102 bado haitoshi. Kwa njia hii, kitendawili cha ERP kinabadilika kuwa kitendawili cha volatiliti ya bei kupita kiasi.
“Msukosuko wa kimantiki” hutokeaje?
Msukosuko wa kimantiki ni utaratibu wa mrejesho ambapo wawekezaji wanapojifunza kwa mantiki kuhusu mwelekeo wa ukuaji wa malipo ya baadaye, kutokuwa na uhakika wa imani hubadilisha uwiano wa bei/malipo; mabadiliko hayo huongeza volatiliti ya bei, na volatiliti ya bei inayoongezeka huongeza zaidi premia ya hatari ya ndani, hivyo kufanya bei ziwe nyeti zaidi kwa habari.
Modeli ya drift ya stokastiki
Katika modeli, log-malipo \(x\) yana mwelekeo wa ukuaji \(\mu\) ambao si wa kudumu. Drift huchorwa upya kwa kiwango fulani cha uhuishaji wa stokastiki \(\lambda\). Katika urahisishaji wa hali mbili, drift ina:
\[ \mu_H \quad \text{ve} \quad \mu_L \]
rejimu mbili zinazowezekana. \(p\) ni uwezekano ambao mwekezaji anaupa uhalali wa rejimu ya high-drift. Drift ya wastani inayotambuliwa:
\[ E=p\mu_H+(1-p)\mu_L \]
hufafanuliwa hivyo.
Malipo pia yana kelele ya Brownian yenye ukubwa \(\sigma_B\).
Mlinganyo wa kujifunza kwa mantiki
Chini ya rejimu mbili, usasishaji wa imani katika chanzo umetolewa kama:
\[ dp= p(1-p)(\mu_H-\mu_L) \frac{dx-E\,dt}{\sigma_B^2} + \lambda(\pi_H-p)\,dt \tag{8} \]
.
Neno la kwanza ni athari ya Bayesian ya habari mpya ya malipo. Ikiwa \(dx\) iliyotokea ni kubwa kuliko \(E\,dt\) inayotarajiwa, uwezekano \(p\) unaopewa rejimu ya high-drift huelekea kuongezeka; habari mbaya hufanya kazi kwa mwelekeo tofauti.
Neno la pili lina taarifa kwamba rejimu ya drift inaweza kufanyiwa reset baadaye. \(\pi_H\) ni uwezekano wa muda mrefu wa rejimu ya juu baada ya reset; kadiri \(\lambda\) inavyoongezeka, ndivyo rejimu ya sasa inavyotarajiwa kuwa na muda mfupi zaidi.
Ubunifu uliosanifishwa:
\[ dy=\frac{dx-E\,dt}{\sigma_B} \]
unapotumika, vipengele vya drift na volatiliti vya mchakato wa imani huwa:
\[ a(p)=\lambda(\pi_H-p) \]
na:
\[ b(p)= p(1-p) \frac{\mu_H-\mu_L}{\sigma_B} \]
. Usemi \(p(1-p)\) unaonyesha kwamba kutokuwa na uhakika wa imani ni juu zaidi katikati na chini zaidi kadiri \(p\) inavyokaribia 0 au 1.
Mlinganyo wa usawa wa uwiano wa bei/malipo
\(Q(p)\) ni uwiano wa bei kwa mtiririko wa sasa wa malipo chini ya imani fulani \(p\). Sharti la uwekaji bei wa haki katika chanzo ni:
\[ \left( \delta+r_p-E-\frac{1}{2}\sigma_B^2 \right)Q = 1+ (a+b\sigma_B)Q' + \frac{1}{2}b^2Q'' \tag{9} \]
.
Upande wa kushoto, \(\delta+r_p\) ni kiwango cha punguzo, huku \(E+\sigma_B^2/2\) ikiwa ukuaji wa asilimia wa malipo unaotarajiwa. Upande wa kulia kuna mtiririko uliosanifishwa wa malipo \(1\), faida ya mtaji inayotokana na mabadiliko yanayotarajiwa katika \(p\), na athari za mstari/ukunjufu za volatiliti ya imani kwenye mkunjo wa bei.
Premia ya hatari inakuwa ya ndani
Volatiliti ya bei haijumuishi tu kelele ya malipo \(\sigma_B\). \(p\) inapobadilika, \(Q(p)\) pia hubadilika. Kwa hiyo unyeti wa uwiano wa uthamini kwa imani huzalisha volatiliti ya ziada ya bei.
Usawa mkuu wa chanzo ni:
\[ r_p = \gamma\zeta^2 = \gamma \left( \sigma_B+ b\frac{Q'}{Q} \right)^2 \tag{10} \]
.
Mlinganyo huu unaonyesha moja kwa moja utaratibu wa resonance wa modeli. \(\frac{Q'}{Q}\) inapoongezeka, mshtuko uleule wa imani huzalisha harakati kubwa zaidi ya asilimia katika bei. Hii huongeza \(\zeta\). \(\zeta\) ya juu zaidi huongeza \(r_p\) kupitia mlinganyo huohuo. Kwa kuwa premia ya hatari huingia tena katika kiwango cha punguzo cha \(Q\), umbo la mkunjo wa bei pia hubadilika.
Kwa hiyo premia ya hatari si kigezo cha kudumu kinachotolewa kutoka nje; hubadilika ndani ya modeli pamoja na kutokuwa na uhakika kwa wawekezaji.
Kwa nini skewness hasi inaweza kuongeza premia ya hatari kwa kiwango kikubwa?
Skewness hasi, wakati rejimu nadra ni rejimu ya ukuaji mdogo, husababisha wawekezaji kuwa na imani kubwa katika ukuaji wa kawaida kwa muda mwingi, lakini mashaka kuhusu uwezekano mdogo wa janga hufanya mkunjo wa \(Q(p)\) kuwa mkali hasa katika eneo la \(p\) ya juu; jambo hili huongeza kwa nguvu athari ya habari kwenye bei, variansi ya bei na premia ya hatari ya ndani kupitia mlinganyo (10).
Usambazaji wa drift wa pointi mbili
Uwezekano wa hali mbili za drift huwekewa vigezo kwa kutumia wastani \(m\), variansi ya drift \(\sigma_D^2\), na skewness \(s\):
\[ \pi_H = 1-\pi_L = \frac{1}{2} - \frac{1}{2} \frac{s}{\sqrt{s^2+4}}, \]
\[ \mu_H = m+\sigma_D\sqrt{\frac{\pi_L}{\pi_H}}, \qquad \mu_L = m-\sigma_D\sqrt{\frac{\pi_H}{\pi_L}}. \tag{11} \]
\(s\) hasi hufanya rejimu ya drift ya chini kuwa hali ya nadra lakini nzito ya upande wa chini. Huu ndio mkia hasi unaolengwa hasa na mwandishi.
Uhusiano wa Green–Kubo na hatari ya muda mrefu
Katika modeli, uwiano wa jumla wa variansi ya muda mrefu wa kelele ya Brownian ya muda mfupi na drift inayobadilika kwa muda ni:
\[ \sigma_{LT}^2 = \sigma_B^2 + \frac{2\sigma_D^2}{\lambda} \tag{12} \]
.
\(\sigma_B^2\) inawakilisha kelele endelevu ya malipo ya muda mfupi. \(\sigma_D^2\) ni variansi ya usambazaji kati ya rejimu za drift. \(\lambda\) ni kasi ya reset ya rejimu. \(\lambda\) ndogo humaanisha drift kudumu kwa muda mrefu zaidi na huongeza neno \(\frac{2\sigma_D^2}{\lambda}\). Hivyo, chini ya volatiliti ileile ya kila mwaka ya muda mfupi, mabadiliko ya drift yanayodumu zaidi huongeza hatari ya malipo ya muda mrefu.
Kizidishi cha variansi
Utafiti unaita:
\[ \frac{\langle\zeta^2\rangle}{\sigma_{LT}^2} \]
uwiano huu variance multiplier — kizidishi cha variansi. Uwiano huu unaonyesha ni kwa kiasi gani variansi ya bei inazidi variansi msingi ya malipo ya muda mrefu.
Katika Kielelezo 3, \(\sigma_{LT}^2=100\) pointi msingi na \(\gamma=2\) zinawekwa thabiti, na mchanganyiko 25 tofauti wa \((\sigma_B,\lambda)\) unachunguzwa. \(\sigma_B\) ni %4–8 kwa mwaka, na \(\lambda\) iko kati ya 0,4–1,2; hii inalingana na muda wa rejimu kuanzia takriban miaka 2,5 hadi miezi 10.
| Skewness \(s\) | Matokeo ya chanzo | Tafsiri |
|---|---|---|
| \(s\geq-1\) | Hakuna mchanganyiko unaofikisha kizidishi cha variansi 1,2 | Hakuna volatiliti kubwa kupita kiasi inayojitokeza |
| Kadiri \(s\) inavyokuwa hasi zaidi | Kizidishi cha variansi huongezeka kwa kasi | Athari ya rejimu nadra mbaya huimarika |
| \(s\leq-6\) | Karibu mchanganyiko wote >2; zaidi ya nusu >3 | Variansi ya bei inaweza kufikia mara kadhaa variansi msingi ya malipo |
Kwa nini asimetria ina nguvu zaidi upande hasi?
Chanzo kinatenganisha taratibu nne. Kwanza, kadiri \(|s|\) inavyoongezeka, umbali wa \(\mu_H-\mu_L\) kati ya hali mbili za drift huongezeka na athari ya habari za imani huimarika. Pili, kutokuwa na uhakika ni juu kwa sababu kuna uchunguzi mchache kuhusu rejimu nadra. Tatu, katika skewness hasi rejimu nadra humaanisha wakati huo huo ukuaji mbaya na kutokuwa na uhakika mkubwa; katika eneo la \(p\) ya juu hali hii huongeza kwa kasi \(Q'\). Nne, katika skewness chanya rejimu ya ukuaji wa juu hukutana pia na kiwango cha juu cha punguzo, hivyo \(Q\) hulainika zaidi.
Katika Kielelezo 4, wakati \((\sigma_B,\lambda)=(0.05,0.8)\), kwa \(s=0\), \(Q'\) ni takriban 0,13. Wakati \(s=-4\), katika eneo ambako takriban %90 ya imani zimejikusanya, \(Q'\) huzidi 0,75. Tofauti hii hubadilisha kwa kiasi kikubwa athari ya habari kwenye bei katika modeli.
Mbinu na Matokeo ya Utafiti
Suluhisho la namba
Milinganyo (9) na (10) haina suluhisho la uchanganuzi la umbo funge. Chanzo hutumia algoriti mbili tofauti za finite-difference.
Algoriti ya kwanza hugawanya \(p\) kwenye uniform grid yenye pointi 4.000. \(Q'\) na \(Q''\) hukadiriwa kwa finite differences za kawaida. Waendeshaji tofauti hubadilishwa kuwa matriki ya generator ya sparse tridiagonal. Kwa kuwa \(r_p\) inategemea \(Q\) kwa njia ya ndani, suluhisho ni la marudio:
- \(r_p\) ya muda hushikiliwa thabiti.
- Mlinganyo uliogawanywa hutatuliwa na \(Q\) mpya hupatikana.
- \(r_p\) huhesabiwa upya kwa mlinganyo (10).
- Mchakato hurudiwa kwa thamani zote za \(p\) hadi \(Q\) ikaribie suluhisho.
Algoriti ya pili:
\[ y=\log\left(\frac{p}{1-p}\right) \]
hutumia badiliko la log-odds/Lamperti. Badiliko hili hutoa azimio kubwa zaidi la kihesabu kwenye mipaka ya \(p\approx0\) na \(p\approx1\), na hubadilisha state volatility kuwa thamani thabiti:
\[ \beta=\frac{\mu_H-\mu_L}{\sigma_B} \]
. Chanzo kinaripoti kwamba njia ya pili ni imara zaidi na hufikia ukaribu wa suluhisho kwa kasi zaidi katika hali za kuanzia za mipakani, lakini kimsingi hutoa matokeo yale yale kama algoriti ya kwanza. Huu ni ukaguzi kwamba suluhisho halitegemei kupita kiasi njia ya kihesabu.
Ukaguzi wa Monte Carlo wa makadirio ya variansi ya muda mrefu
Chanzo kinachunguza kama uwiano wa variansi ya muda mrefu wa takriban pointi msingi 100 uliopimwa kutoka mfululizo wa faida wa S&P unaweza kukadiria chini \(\sigma_{LT}^2\) halisi. Kwa hili hufanya, kila moja ikiwa na urefu sawa na data ya kihistoria, uigaji 2.500 wa Monte Carlo wa miaka 154.
Katika uigaji, makadirio ya uwiano wa variansi wa miaka 20–40 yanaonekana kuwa na kelele nyingi zaidi kuliko ilivyotarajiwa. Chanzo kinaripoti kwamba standard error ni takriban %85 ya wastani wa makadirio.
| Hatua | Matokeo | Tafsiri ya chanzo |
|---|---|---|
| Wastani wa kihistoria wa VR ya faida | ≈pointi msingi 100 | Kipimo ghafi cha muda mrefu |
| Marekebisho ya athari ya Working | ≈pointi msingi 111 | Takriban %8 bias ya kuelekea chini katika uigaji |
| Mbinu ya Median | ≈pointi msingi 147 | Median ya uigaji ni takriban %75 ya wastani |
| Mbinu ya wastani iliyokatwa %10 ya juu | ≈pointi msingi 142 | Wastani uliokatwa ni takriban %78 ya wastani kamili |
| Muhtasari wa vitendo wa mwandishi | \(\sigma_{LT}\approx12\%\) | Takriban 10% ghafi, 10,5% ikiwa imerekebishwa kwa Working; thamani halisi ya juu zaidi inawezekana |
Kwa sababu ya kutokuwa na uhakika mkubwa, mwandishi hadai thamani sahihi ya \(\sigma_{LT}^2\); anaona safu ya takriban pointi msingi 80–160 kuwa ya kuaminika.
Ukaguzi wa kiempiria wa skewness
Skewness ya sampuli ya ukuaji halisi wa malipo ya kila mwaka ya S&P ni −0,57 kwa gawio na −0,82 kwa faida. Mwandishi anasema kwamba \(s\) halisi katika usambazaji msingi wa drift inaweza kuwa hasi zaidi kwa sababu vipengele vya muda mfupi vya mean-reverting na kelele ya Brownian hupunguza skewness inayozingatiwa.
Hata hivyo, chanzo pia kinaripoti ukinzani ulio wazi hapa. Skewness ya mapato halisi ya kila mwezi ya S&P ni −0,37 na modeli inaweza kulinganisha takriban thamani ya kila mwezi karibu na \(s=-3\). Kwa upande mwingine, skewness ya mapato ya kila mwaka ya modeli mara nyingi hubaki chini ya −1, wakati thamani halisi ya kila mwaka ya S&P ni takriban −0,44. Mwandishi anasema wazi kwamba hajaweza kutatua kutolingana huku.
Mchanganyiko wa vigezo kwa ERP ya pointi msingi 440
Katika seti kuu ya uigaji wa chanzo:
\[ (\sigma_B,\lambda,\gamma)=(0.06,1.0,2) \]
huchukuliwa na wastani wa:
\[ \langle r_p\rangle=440\text{ baz puan} \]
hulengwa.
| \(\sigma_{LT}^2\) | \(s\) inayohitajika | Tafsiri |
|---|---|---|
| pointi msingi 110 | −4,0 | Variansi ya chini ya malipo msingi inahitaji mkia hasi mzito zaidi |
| pointi msingi 120 | −3,5 | Thamani inayotumiwa katika uigaji mkuu wa kina |
| pointi msingi 130 | −3,0 | Skewness hasi ya wastani zaidi inatosha |
| pointi msingi 157 | −2,0 | Kwa variansi msingi kubwa ya muda mrefu, skewness isiyo kali sana inatosha |
Kwa volatiliti ya bei inayozalishwa na suluhisho hizi, chanzo kinaripoti \(RMS(\zeta)=14,8\%\). Thamani hii iko karibu na mwisho wa chini wa safu ya kawaida ya S&P %15–17 inayotajwa na mwandishi.
Suluhisho wakilishi la kina
Kwa uchunguzi wa kina zaidi, chanzo huchagua vigezo:
\[ (\sigma_{LT}^2,s,\sigma_B,\lambda,\gamma) = (0.012,-3.5,0.06,1.0,2) \]
.
Katika suluhisho hili, imani katika rejimu ya high-drift huwa juu sana kwa muda mwingi. Kwa stationary distribution:
- uwezekano wa \(p>0.99\) ni takriban %50,
- uwezekano wa \(p<0.50\) ni takriban %4,9,
- uwezekano wa \(p<0.10\) ni takriban %1,5.
Hata hivyo, vipindi hivi nadra vya shaka vina athari kubwa sana kwenye uwekaji bei.
Kielelezo 5 — imani, uwiano wa bei/malipo na premia ya hatari
Katika Kielelezo 5 kwenye ukurasa wa 21 wa PDF ya chanzo, mhimili mlalo ni imani \(p\) katika rejimu ya ukuaji wa juu. Mhimili wima wa kushoto unaonyesha uwiano wa bei/malipo \(Q\), na mhimili wima wa kulia premia ya hatari \(r_p\) kwa pointi msingi.
\(Q\) huongezeka kutoka takriban 35 hadi 50 na wastani wake ni takriban 48. Eneo la \(p>0.8\) linajumuisha takriban %90 ya muda; hapa ulinganifu wa ukaribiaji wa log-lineer wa \(Q\) ni \(R^2=0.999\).
| Imani \(p\) | \(r_p\) |
|---|---|
| Mipaka \(p\to0\) au \(p\to1\) | Msingi wa takriban pointi msingi 72 |
| \(p=0.99\) | pointi msingi 156 |
| \(p=0.95\) | pointi msingi 692 |
| \(0.36<p<0.84\) | Zaidi ya pointi msingi 2500 |
| Kilele | Zaidi kidogo ya pointi msingi 4000 |
Utaratibu mkuu wa chanzo unaonekana wazi hapa: premia ya hatari hufikia viwango vya juu zaidi si wakati soko linaamini kwa uhakika kuwa liko katika rejimu mbaya, bali katika eneo la kati ambako lina shaka zaidi kuhusu rejimu iliyopo.
Kielelezo 6 — uigaji wa miaka 40
Kielelezo 6 kwenye ukurasa wa 22 wa PDF ya chanzo kinaonyesha njia ya miaka 40 ya \(Q\) na volatiliti ya bei \(\zeta\) iliyozalishwa na modeli hiyo hiyo. Volatiliti imelainishwa kwa mzizi wa mraba wa variansi ya wastani unaosogea kwa eksponenti unaolingana na kipindi cha siku 21.
Katika uigaji, vipindi virefu vya utulivu hukatizwa na vipindi vifupi vya hofu; tathmini hushuka haraka mara kwa mara, na ingawa kushuka kwingi hurudi haraka, baadhi hudumu zaidi. Volatiliti huwa ndogo katika nyakati nzuri, kubwa katika vipindi vibaya, na yenyewe pia hubadilika sana.
Lakini kielelezo hiki pia kinafanya kasoro moja ya msingi ya modeli ionekane. Kwa kuwa \(p\) mara nyingi iko karibu sana na 1, \(\zeta\) inaweza kushuka hadi \(\sigma_B\) katika vipindi tulivu. Chanzo kinaeleza wazi kwamba msingi huu uko chini sana kuliko msingi wa kawaida wa volatiliti wa zaidi ya %10 unaozingatiwa katika S&P halisi, na kwamba hii ni artefact ya modeli ya rejimu mbili. Mwandishi anasema modeli tajiri zaidi za hali nyingi zinaweza kupunguza tatizo hili na analiweka kwa utafiti wa baadaye.
Matokeo ambayo utafiti unaunga mkono na usiyounga mkono
| Utafiti unaunga mkono | Utafiti pekee hauungi mkono |
|---|---|
| Kuepuka hatari kwa kiwango cha chini chenye ufanisi na ERP ya juu vinaweza kuzalishwa pamoja ndani ya modeli fulani ya kujifunza kwa mantiki. | Hitimisho kwamba wawekezaji wote wa soko halisi wana \(\gamma=2\). |
| Skewness hasi ya drift, kutokuwa na uhakika wa imani na kiwango cha punguzo cha ndani vinaweza kuzalisha volatiliti kubwa ya bei kupita kiasi. | Hitimisho kwamba anguko zote za kihistoria za soko la hisa zinaelezwa tu na utaratibu huu. |
| Modeli inaweza kuzalisha premia ya hatari ya wastani ya zaidi ya pointi msingi 400 na mkusanyiko wa volatiliti unaofanana na soko. | Hitimisho kwamba modeli hii inatabiri mapato ya S&P ya baadaye au tarehe za migogoro. |
| Variansi ya faida ya muda mrefu inaweza kuwa juu kuliko makadirio ya kawaida ya kihistoria. | Hitimisho kwamba \(\sigma_{LT}^2\) halisi ni hasa pointi msingi 140 au 157. |
| Algoriti mbili za suluhisho la kihesabu kimsingi hutoa matokeo yale yale. | Hitimisho kwamba ubainishaji wa modeli ndio modeli pekee sahihi ya kiuchumi. |
| Kujifunza kwa mantiki kunaweza kuzalisha harakati za bei zinazofanana na mwonekano wa kitabia wa “irrational exuberance”. | Hitimisho kwamba upendeleo wa kitabia hauna umuhimu au haupo katika masoko halisi. |
Nguvu kuu
- Kuunganisha kitendawili cha ERP na kitendawili cha excess-volatility chini ya utaratibu mmoja.
- Kuzalisha premia ya hatari kwa njia ya ndani kutokana na kutokuwa na uhakika wa imani badala ya kuitoa kama kigezo thabiti.
- Kuchanganya kujifunza kwa mantiki, majanga nadra, fractional Kelly na kiwango cha punguzo kinachobadilika kwa muda katika modeli moja.
- Kukagua suluhisho la modeli kwa algoriti mbili tofauti za kihesabu.
- Kuchunguza kutokuwa na uhakika wa makadirio ya variansi ya muda mrefu kwa uigaji 2.500 wa Monte Carlo.
- Kuripoti wazi matokeo yasiyolingana na modeli, kama skewness ya mapato ya kila mwaka.
Vikwazo vya msingi
Kizuizi cha hali mbili: Modeli hugawanya drift ya ukuaji katika rejimu mbili tu, ya juu na ya chini. Kwa hiyo, janga linapotengwa, kutokuwa na uhakika halisi wa ulimwengu unaobaki kuhusu drift ya sasa kunaweza kuwa kidogo kupita kiasi kwa njia ya bandia.
Mean reversion ya muda mfupi iko nje: Chanzo kinakubali kwamba kuna vipengele vikubwa vya mean-reverting katika malipo halisi, lakini modeli haivijumuishi moja kwa moja. Inadhaniwa kuwa wawekezaji wanaweza kuvitenganisha na habari za drift ya kudumu.
Maarifa ya vigezo vya kimuundo: Inadhaniwa kuwa wawekezaji wanajua vigezo vya kimuundo \(\{\mu,\pi,\lambda\}\). Kutokuwa na uhakika halisi wa kielimu ni mpana zaidi.
Tafsiri iliyounganishwa ya \(\gamma\): \(\gamma\) haitenganishi kuepuka hatari kwa upande wa kisaikolojia na upunguzaji wa tahadhari wa fractional-Kelly dhidi ya kutokuwa na uhakika wa modeli.
Kutokuwa na uhakika mkubwa wa makadirio ya variansi: Hata sampuli ya kihistoria ya miaka 154 haitoshi kubainisha variansi ya muda mrefu kwa kipindi finyu cha kujiamini; standard error ya uigaji ni kubwa sana.
Kutolingana kwa skewness: Ingawa modeli inaweza kulinganisha takriban skewness ya mapato ya kila mwezi, inaweza kuzalisha skewness ya mapato ya kila mwaka iliyo hasi kupita kiasi ikilinganishwa na S&P halisi. Chanzo kinaacha tatizo hili bila kutatuliwa.
Uigaji ≠ utabiri: Njia za bei za miaka 40 zinaonyesha tabia ya modeli; si utabiri wa njia ya soko la baadaye.
Maelezo ya Chanzo na Mbinu
Utafiti asili: Reconciling High Equity Risk Premia with Low Risk Aversion.
Mwandishi: Kent Osband.
Tarehe ya PDF: July 2026.
Taarifa ya mawasiliano katika PDF: kosband@risktick.com.
Taasisi/ushirika: Hakuna ushirika wa kitaasisi uliobainishwa kwenye ukurasa wa kichwa wa PDF iliyopakiwa.
Shukrani: Mwandishi anamshukuru John Cochrane kwa maoni yenye manufaa.
Maneno muhimu: equity risk premium; drift uncertainty; risk aversion; Kelly criterion; asset pricing.
JEL: G12, D81, D53.
Aina ya chanzo: Utafiti wa kinadharia na wa kihesabu wa uwekaji bei wa mali; hutumia data ya kihistoria ya S&P na uigaji wa Monte Carlo/modeli.
Hali ya mapitio ya rika: PDF haina taarifa ya jarida lililopitiwa na rika, juzuu, toleo au mchapishaji. Toleo la mwisho la jarida lililopitiwa na rika halikuweza kuthibitishwa kwa kujitegemea; kwa hiyo utafiti haupaswi kuainishwa katika Verianla kama makala iliyopitiwa na rika.
DOI: Rekodi ya bibliografia ya pili ya ResearchGate inatoa 10.2139/ssrn.6185899. Kwa kuwa ukurasa rasmi wa SSRN wa DOI hiyo haukupatikana kama matokeo ya utafutaji yanayofikika wakati wa uthibitishaji huu, DOI inapaswa kubaki katika hali ya “imethibitishwa kwa metadata ya pili, haijathibitishwa kikamilifu kwa rekodi rasmi”.
Tofauti ya tarehe: ResearchGate inaonyesha January 2026 kwa kichwa hicho hicho, wakati PDF iliyopakiwa ina tarehe ya July 2026. Kwa maudhui ya kisayansi ya Verianla, toleo la PDF lililopakiwa limetumiwa kama source-of-truth.
Leseni: PDF iliyopakiwa haionyeshi Creative Commons ya wazi wala leseni nyingine ya matumizi tena. Kwa kuwa leseni rasmi ya toleo kamili haijathibitishwa, vielelezo vya chanzo havipaswi kutumiwa tena kama vilivyo.
Ufadhili: PDF iliyopakiwa haina tamko tofauti la ufadhili.
Mgongano wa maslahi: PDF iliyopakiwa haina tamko tofauti la mgongano wa maslahi. Kwa hiyo hitimisho la “hakuna mgongano wa maslahi” halijadhaniwa.
Upatikanaji wa data: Hakuna sehemu tofauti ya Data Availability. Uchambuzi wa kihistoria wa gawio, faida na mapato ya S&P unategemea mfululizo wa data mtandaoni wa Robert Shiller; chanzo pia kinarejea mfululizo wa BEA na Federal Reserve.
Mbinu kuu: Mfumo wa premia ya hatari wa CRRA/Merton; tafsiri ya fractional-Kelly; modeli ya stokastiki ya payout-drift ya hali mbili; Bayesian filtering ya muda-endelevu ya aina ya Wonham; premia ya hatari ya ndani na mlinganyo tofauti wa usawa wa price-to-payout; finite-difference numerical solution; suluhisho mbadala la log-odds/Lamperti; stationary distribution; hesabu ya variansi ya muda mrefu ya Green–Kubo; unyeti wa vigezo; uigaji 2.500 wa Monte Carlo.
Matokeo makuu ya kisayansi: Chanzo kinaonyesha kwamba hata chini ya kuepuka hatari kwa ufanisi katika kiwango cha \(\gamma\leq2\), ikiwa mrejesho kati ya skewness hasi ya drift, kujifunza kwa mantiki na kiwango cha punguzo cha ndani una nguvu ya kutosha, ERP ya wastani ya zaidi ya pointi msingi 400 inaweza kuzalishwa ndani ya modeli.
Kikomo kikuu cha tafsiri: Huu si uthibitisho kwamba ERP ya juu ina utaratibu mmoja tu katika ulimwengu halisi. Vigezo na muundo wa hali mbili ni dhana za modeli; mwandishi pia anakubali wazi kwamba baadhi ya makadirio yanahitaji kutathminiwa upya.
Ujenzi upya wa taswira: Ulinganisho wa variansi ya muda mrefu katika Kielelezo 2, uhusiano wa skewness–kizidishi cha variansi katika Kielelezo 3, na muundo wa \(p\)–\(Q\)–\(r_p\) katika Kielelezo 5 unaweza kujengwa upya kutoka thamani za chanzo au milinganyo ya modeli kama grafu asili za Verianla. Kwa kuwa random seed haijatolewa kwa njia nasibu ya miaka 40 ya Kielelezo 6, haipaswi kuchorwa upya kwa kufanana kabisa.
Verianla Live: Live Equation inafaa kwa milinganyo 8–10, Live Process kwa mrejesho belief → valuation → volatility → risk premium, na Live Compare kwa ulinganisho wa vigezo. Kiolesura cha uigaji kinachomruhusu mtumiaji kubadilisha kigezo cha kisayansi hakipaswi kuundwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *